

A IBM lançou o Granite 4.2 em 25 de agosto de 2026: uma família de modelos de raciocínio com pesos abertos em três tamanhos, 3B, 8B e 30B, todos sob a licença Apache 2.0. A principal mudança é o "pensamento" nativo: o raciocínio passo a passo agora vem embutido no modelo e pode ser alternado entre completo, de baixo esforço e desligado.
Os modelos são pequenos, baratos e honestos sobre para que servem: trabalho agêntico corporativo, chamadas de ferramentas e tarefas estruturadas que você pode rodar no seu próprio hardware. O piso é gratuito porque os pesos são abertos, e a tarifa hospedada mais barata que consegui confirmar é a do 8B na Replicate, a US$ 0,06/US$ 0,25 por milhão de tokens. Em benchmarks, o de 30B é realmente forte (57,0 no SWE-Bench Verified), embora o pessoal dos LLMs locais ainda recorra ao Qwen quando só importa a capacidade bruta de programação.
Uma coisa que vale dizer logo de início, porque eu construo IA de suporte para viver: um modelo não é um produto. O Granite 4.2 é um motor excelente. Se o que você realmente quer é um agente de IA que resolva tickets, o modelo é os 10% fáceis; o conhecimento, as integrações e as barreiras de segurança são os outros 90%. Mais sobre isso no final.
O que é o IBM Granite 4.2?
O Granite é a família de modelos abertos da IBM para empresas, e o 4.2 é a versão focada em raciocínio. Ele chegou como três checkpoints, granite-4.2-3b, granite-4.2-8b e granite-4.2-30b, cada um pós-treinado a partir do modelo base do Granite 4.1 correspondente. Junto com eles, a IBM também lançou dois minúsculos modelos de transcrição Granite Speech 5.0, mas o nome "4.2" se refere realmente a estes três modelos de linguagem.
Passei os últimos anos colocando IA em filas de suporte ao vivo, e o que olho primeiro em qualquer modelo aberto novo não é o benchmark principal, e sim a licença e como ele é implantado. O Granite vai bem aqui: os pesos são Apache 2.0, os modelos são assinados criptograficamente e certificados ISO, e a família recebeu uma nota máxima no Foundation Model Transparency Index de Stanford. Para uma equipe regulada que precisa rodar o modelo dentro de casa, essa combinação importa mais do que alguns pontos de benchmark.
O argumento da IBM é "competitivo com modelos de pensamento maiores, por uma fração do custo". É uma aposta interessante e vale a pena verificar em vez de repetir, então vamos olhar a linha real.
A linha de modelos: 3B, 8B e 30B
Veja como os três tamanhos se comparam nas especificações que decidem onde cada um pode rodar. Todos são transformers densos somente decodificadores, então a contagem de parâmetros que você vê é o modelo inteiro; não há truque de mistura de especialistas escondendo um tamanho ativo menor.
| Modelo | Parâmetros | Camadas | Contexto | Modelo base | Melhor para |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B (denso) | 40 | 128K | granite-4.1-3b-base | Notebooks e edge, tarefas simples e rápidas |
| granite-4.2-8b | 8B (denso) | 40 | 128K | granite-4.1-8b-base | Trabalho corporativo de uso geral |
| granite-4.2-30b | 30B (denso) | 64 | 128K (512K estendido) | granite-4.1-30b-base | Raciocínio complexo e agentes |
Todos os tamanhos lidam nativamente com uma janela de contexto de 128K tokens, e o de 30B pode ser estendido para 512K. A IBM também distribui builds quantizados oficiais de cada tamanho (fp8, mxfp4, nvfp4) que reduzem o uso de memória, além de conversões GGUF da comunidade para llama.cpp e LM Studio. Se você quiser uma camada de segurança, os model cards apontam para o Granite Guardian 4.1 8B, separado, para detecção de riscos.
A parte mais difícil para a maioria das pessoas é simplesmente escolher um tamanho. Aqui vai um guia rápido conforme o que você está otimizando.
O que realmente há de novo: raciocínio nativo que você pode alternar
A verdadeira novidade do 4.2 é que o raciocínio agora vem embutido. Os modelos Granite anteriores respondiam diretamente; o 4.2 pode primeiro trabalhar um problema dentro de tags <think>...</think> antes de se comprometer com uma resposta, o que ajuda com matemática, programação e qualquer lógica de várias etapas. O que o torna prático é que a IBM tornou o raciocínio alternável em um único modelo, então você não precisa manter checkpoints separados de "raciocínio" e de "chat".
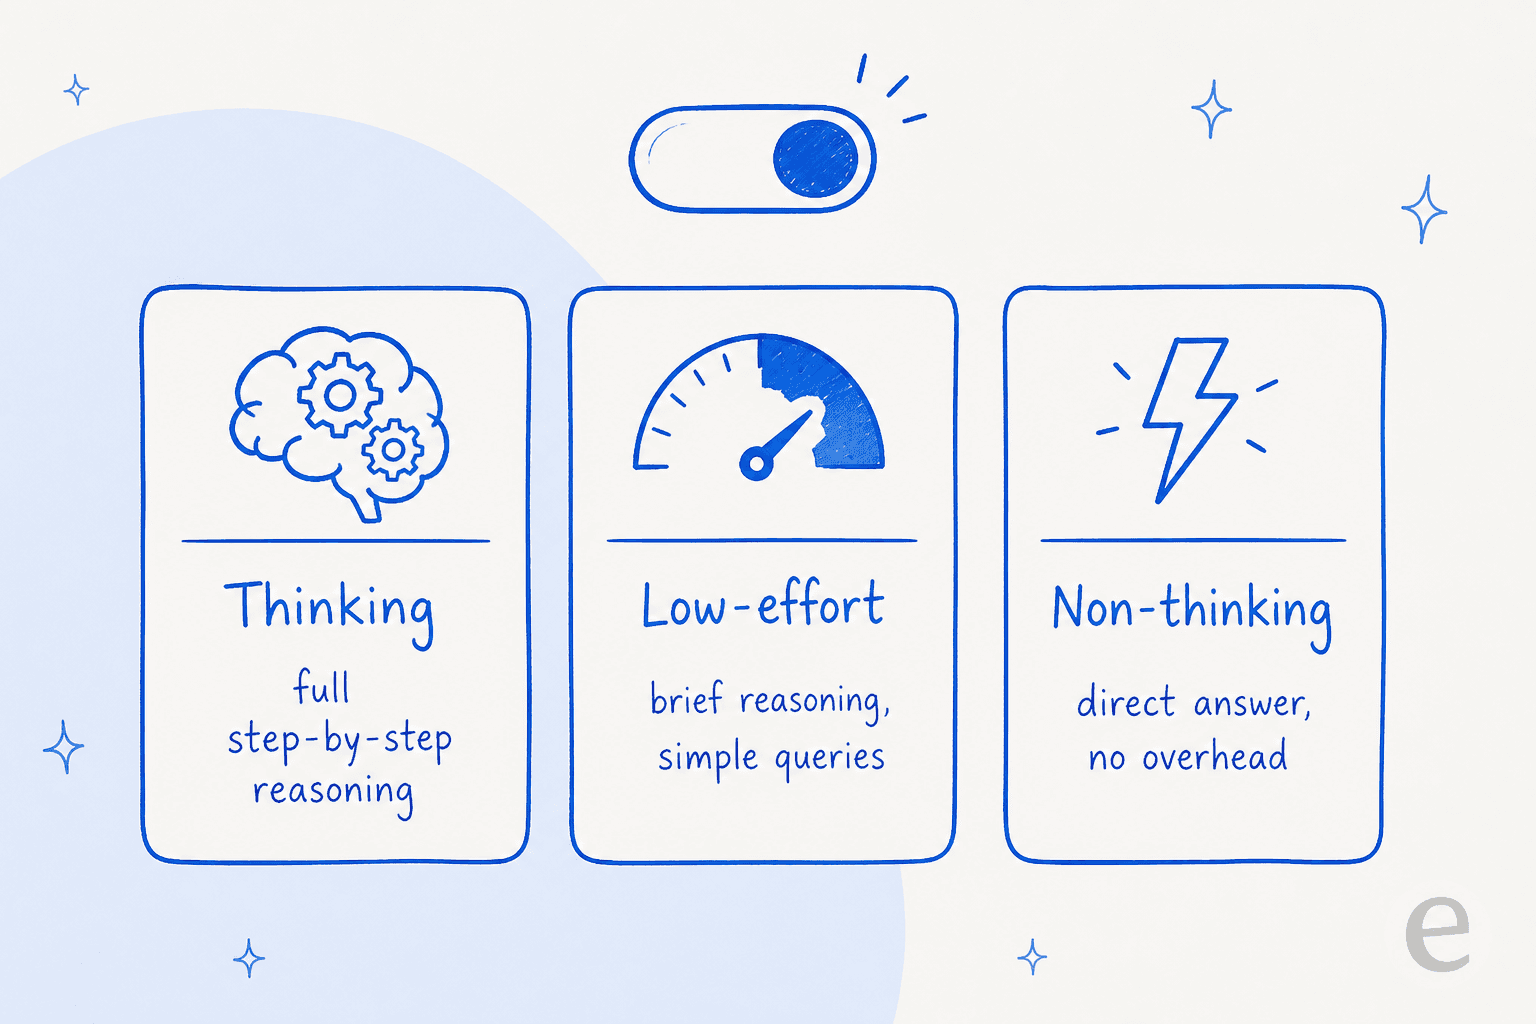
Há três modos, e escolher o certo é principalmente uma decisão de custo:
- Thinking (o padrão): cadeia de pensamento completa. Melhor para raciocínio difícil, pior para latência e gasto de tokens.
- Low-effort: uma passada breve de raciocínio para consultas mais simples, um meio-termo que mantém parte da precisão sem toda a sobrecarga.
- Non-thinking: uma resposta direta sem nenhum token de raciocínio, para quando você só precisa de velocidade.
No Ollama você alterna entre eles com /set think e /set nothink. Isso é realmente útil em produção, porque "sempre raciocinar" é caro e "nunca raciocinar" é burro, e a maioria das cargas reais quer misturar os dois conforme a consulta. Se você já ajustou um bot de suporte, é o mesmo dilema de decidir quando escalar e quando responder automaticamente.
Chamadas de ferramentas com raciocínio
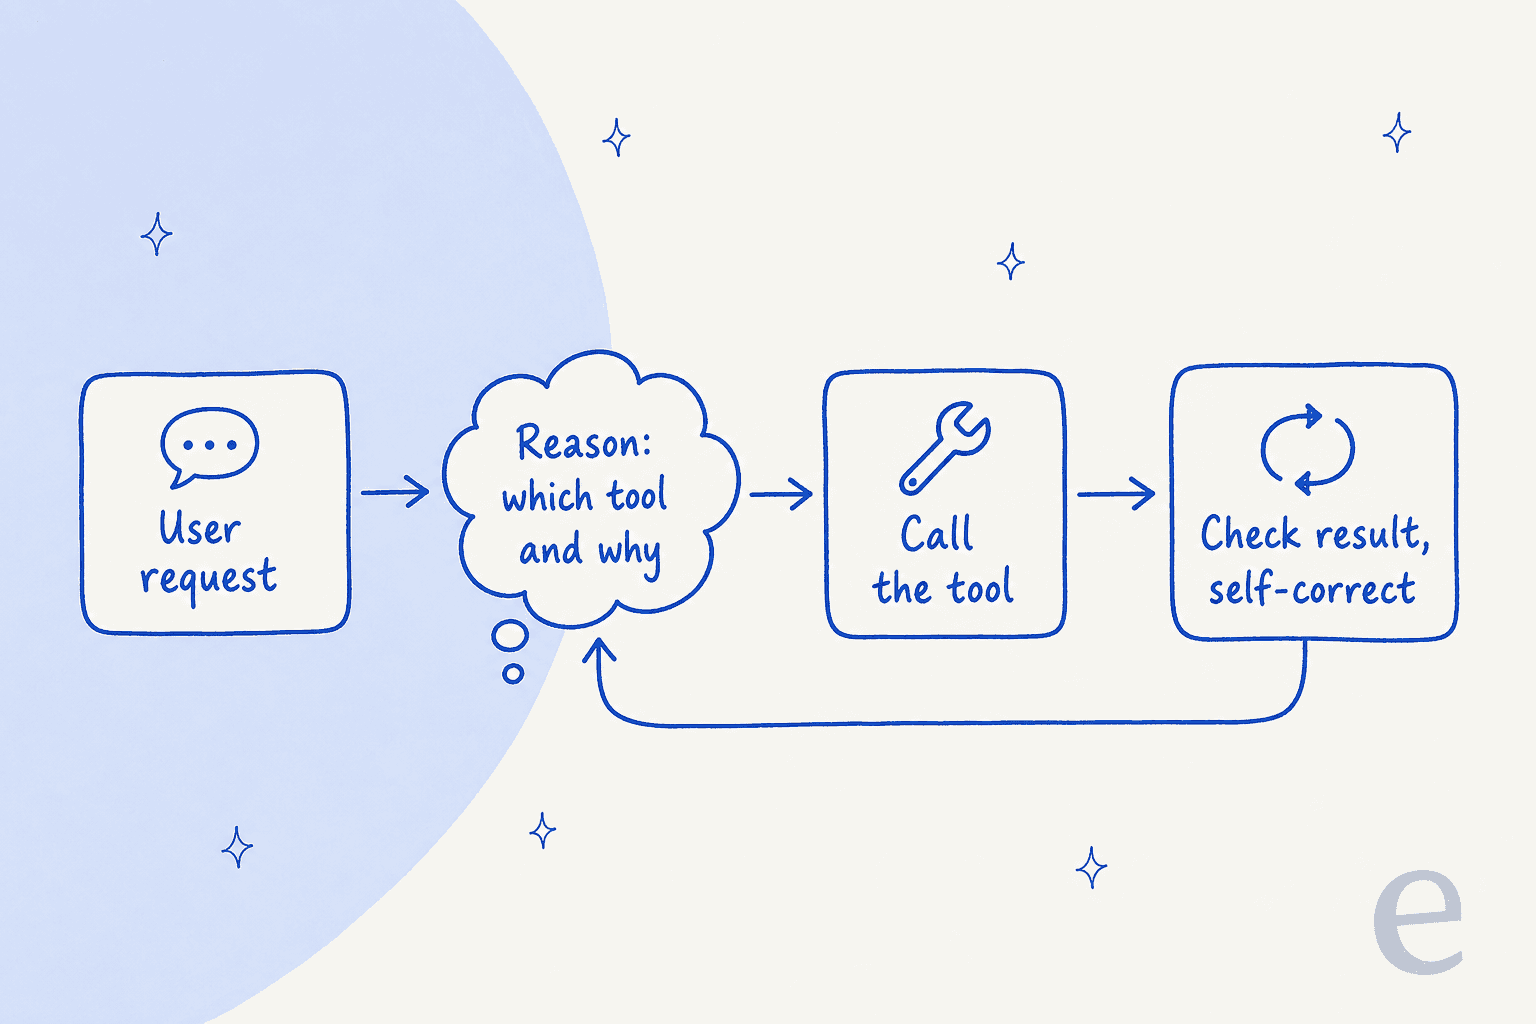
A outra melhoria, e a que a IBM claramente mais valoriza, são as chamadas de ferramentas. O Granite 4.2 foi treinado para raciocinar sobre qual ferramenta chamar e por quê antes de fazer a chamada, em vez de apenas casar padrões com o nome de uma função. Na prática, o modelo planeja, chama uma ferramenta, verifica o resultado e pode se autocorrigir.
Ele expõe uma API compatível com a OpenAI e funciona de imediato com arneses agênticos de programação como OpenCode, Pi e OpenHands, e é otimizado para vLLM (v0.20+) e SGLang para servir. É essa parte que faz o 4.2 parecer voltado diretamente ao público de agentes de IA e não ao de chatbots. Também vale ser realista: chamadas de ferramentas confiáveis em uma demo não são o mesmo que chamadas de ferramentas confiáveis nos seus sistemas de produção bagunçados, e é exatamente por isso que simulamos cada implantação com dados históricos reais antes que ela toque um cliente ao vivo.
Denso, não híbrido: a mudança em relação ao Granite 4.0
Esta é uma nuance que confunde as pessoas, então merece um parágrafo. O Granite 4.0 usava uma arquitetura híbrida Mamba-2/transformer com uma camada de mistura de especialistas (MoE), que a IBM promovia pelo menor uso de memória e pela inferência mais rápida. O Granite 4.2 segue o caminho oposto: é um transformer denso, somente decodificador, simples, pós-treinado a partir da base densa do Granite 4.1.
Por que isso importa para você? Com um modelo denso não há divisão entre parâmetros "ativos e totais", então um modelo denso de 30B usa aproximadamente o custo computacional de 30B parâmetros em cada token. Isso é mais pesado por token do que um MoE comparável, mas é mais simples de raciocinar, amplamente compatível com ferramentas padrão e previsível de implantar. A própria formulação da IBM é que "its dense architecture supports broad compatibility", uma forma justa de dizer que troca um pouco de eficiência por muito menos atrito na implantação.
Como o Granite 4.2 se sai nos benchmarks
Aqui estão os números que a IBM publicou nos model cards, usando os valores em que as duas tabelas oficiais da IBM concordam. Mantive só os benchmarks com que um comprador realmente se importa.
| Benchmark | 3B | 8B | 30B |
|---|---|---|---|
| SWE-Bench Verified (programação) | NA | 47.67 | 57.00 |
| Terminal-Bench 2.1 | NA | 20.56 | 29.24 |
| AIME25 (raciocínio matemático) | 78.33 | 86.67 | 89.17 |
| GPQA | 54.80 | 64.14 | 66.41 |
| MMLU-Pro | 67.84 | 74.04 | 77.60 |
| Arena-Hard-V2 | 34.96 | 65.19 | 67.93 |
| RULER 128K (contexto longo) | 55.30 | 71.41 | 81.38 |
São resultados fortes para esses tamanhos, especialmente o de 30B em programação e matemática. Mas aqui quero ser direto com você, porque é a coisa mais útil desta seção: a IBM compara o Granite principalmente com versões anteriores do Granite, e posiciona os novos modelos frente ao Nemotron 3 Super e ao Gemma 4 em vez de frente aos modelos que a maioria realmente roda localmente. Isso é um limite real para o quanto essas tabelas dizem.
A leitura da comunidade é mais cética, e com razão. Como um comentarista do Hacker News colocou após o lançamento do 4.1:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."

Então encare os benchmarks como "o Granite ficou muito melhor que o Granite anterior", o que é verdade e útil, e não como "o Granite supera tudo do seu tamanho", o que as tabelas não mostram de fato.
O que as pessoas estão dizendo
As análises práticas e independentes do 4.2 em particular ainda são escassas, já que ele tem apenas alguns dias, mas a opinião sobre o Granite 4.x está bem estabelecida e é consistente. O elogio é real: os modelos pequenos rodam rápido em hardware comum e são discretamente excelentes em trabalho estruturado e fundamentado.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
A crítica é igualmente consistente e vem em dois sabores. Primeiro, em capacidade bruta, a comunidade de LLMs locais ainda avalia o Qwen mais alto para programação e raciocínio agêntico:
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
Segundo, há um detalhe prático que vale conhecer antes de baixar o 8B: várias pessoas viram o consumo de memória dele inflar muito além do tamanho do download ao carregar, por causa do cache KV da longa janela de contexto.
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"

A solução geralmente é limitar o tamanho do contexto ao carregar, mas é uma armadilha real se você assume que o tamanho do download é o tamanho na memória.
Quanto custa e como rodar
Como os pesos são abertos, a forma mais barata de rodar o Granite 4.2 é de graça: baixe com o Ollama ou o Hugging Face e pague apenas pelo seu próprio poder de computação. Veja o que cada caminho realmente custa.
| Caminho | O que você paga | Observações |
|---|---|---|
| Hospedagem própria (Ollama / Hugging Face / vLLM) | US$ 0 de licença | Apache 2.0; você cobre o hardware. O 3B é um download de 2,2 GB, do tamanho de um notebook |
| Replicate (granite-4.2-8b) | US$ 0,06 / 1M de entrada, US$ 0,25 / 1M de saída | Tarifa hospedada por token confirmada mais barata; ~US$ 0,0014 por execução típica |
| IBM watsonx.ai | Pago por uso por 1M de tokens + hospedagem por hora | Plano Standard ~US$ 1.050/mês; cobrado em Resource Units (1 RU = 1.000 tokens) |
Uma observação sobre o watsonx: a tabela de preços ao vivo para o item do Granite 4.2 estava retornando um erro quando conferi, então não consegui confirmar diretamente um valor exato por token para o 4.2. A tarifa confirmada mais próxima da família Granite-4 na documentação da IBM é de cerca de US$ 0,06 por 1M de entrada e US$ 0,27 por 1M de saída, e o modelo de preços (pago por uso por milhão de tokens mais hospedagem por hora) está confirmado. No momento da escrita, o OpenRouter ainda listava apenas o Granite 4.0 e o 4.1, não o 4.2.
Para uma comparação de custo real, hospedar o 3B por conta própria em hardware que você já tem é o mais próximo de inferência gratuita que você vai conseguir, o que é uma grande razão pela qual equipes que se preocupam com privacidade de dados gostam da família Granite. Se você está comparando com um produto hospedado, nosso detalhamento da taxa de resolução da IA é uma régua melhor do que o preço bruto por token.
Quem deve realmente usar o Granite 4.2?
Depois de analisar tudo, esta é a minha leitura honesta.
Escolha o Granite 4.2 se você precisa de um modelo aberto e licenciável que possa rodar on-prem, se importa com tarefas estruturadas e fundamentadas (chamadas de ferramentas, resumo, extração, etiquetagem) e quer raciocínio alternável sem ficar fazendo malabarismo com dois checkpoints. O 8B é um padrão fantástico para automação corporativa, e o 3B é um modelo legitimamente bom para "rodar no notebook". Ele também combina naturalmente com uma camada de recuperação, já que esses modelos brilham quando estão ancorados nos seus próprios documentos em vez de responder de memória.
Procure outra opção se sua única prioridade é a melhor programação ou o melhor raciocínio agêntico a qualquer custo, onde o consenso da comunidade ainda aponta para o Qwen, ou se você quer um produto gerenciado e completo em vez de um modelo para construir em cima. O Granite é um excelente modelo, não uma aplicação pronta, e a distância entre essas duas coisas é onde a maioria dos projetos de IA de suporte realmente dá certo ou errado.
Do modelo ao colega de equipe: onde o eesel entra
Esta é a parte que mais me importa, porque é o erro que vejo as equipes cometerem repetidamente. Um modelo bruto como o Granite 4.2 é um motor. Um motor muito bom. Mas um motor não é uma contratação.
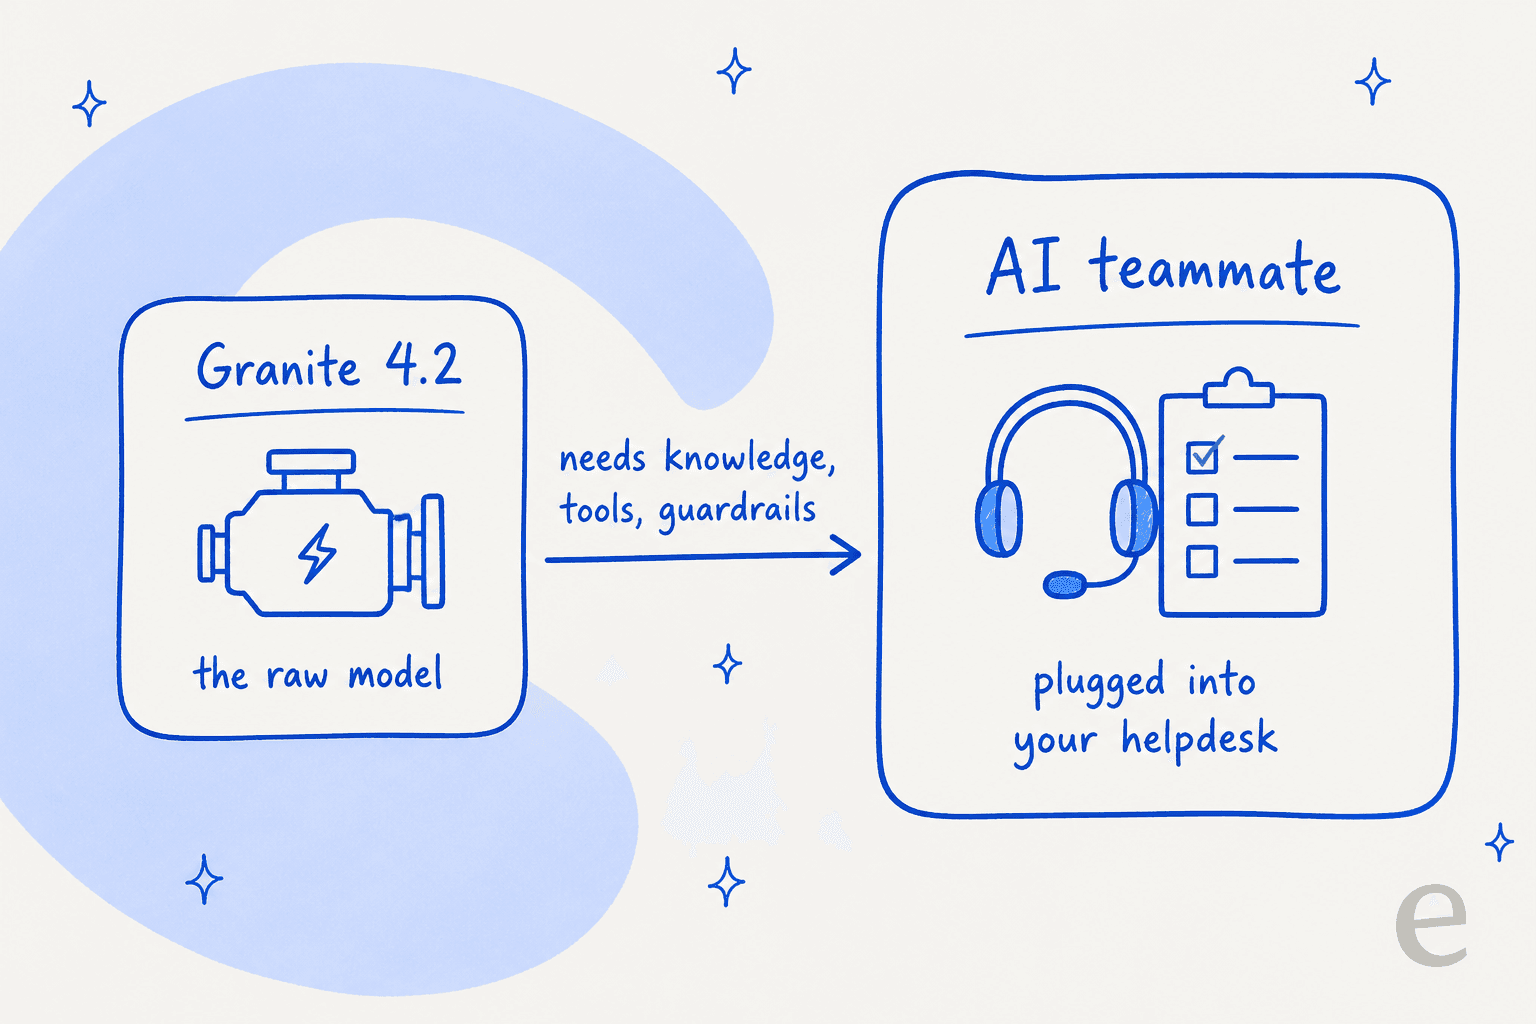
O eesel vende o colega de equipe pronto, não o motor. O colega de equipe de IA para helpdesk se conecta ao helpdesk que você já usa, seja o Zendesk, o Freshdesk, o Gorgias ou uma caixa de entrada compartilhada, aprende com seus tickets passados e sua base de conhecimento, e redige ou envia respostas dentro das suas ferramentas existentes. O que o Granite 4.2 oferece, raciocínio nativo e chamadas de ferramentas, aqui é o mínimo exigido; os 90% difíceis são o contexto da empresa, as integrações e a rede de segurança ao redor.

E a parte sem a qual eu não lançaria um bot de suporte: o eesel permite simular o colega de equipe com milhares dos seus tickets históricos reais antes que ele fale com um cliente, para que você veja a taxa de resolução e as respostas exatas antes de entrar no ar, em vez de virar uma chave e torcer. Construímos isso porque já vimos bots que soam confiantes darem respostas erradas em silêncio, e testar com seus próprios tickets é a única coisa que detecta isso.
Se você está avaliando o Granite 4.2 porque quer automatizar o suporte, esse é o atalho que vale conhecer: você pode experimentar o eesel de graça, conectar seu helpdesk em poucos minutos e ver como um colega de equipe pronto para trabalhar lida com seus tickets reais, sem precisar montar e cuidar de um modelo por conta própria. E se escrever é o trabalho, a mesma ideia também move o colega de equipe redator de blog com IA.
Perguntas frequentes
O que é o IBM Granite 4.2?
O IBM Granite 4.2 é uma família de modelos de linguagem de raciocínio com pesos abertos, lançada em 25 de agosto de 2026 em três tamanhos: 3B, 8B e 30B parâmetros. Os três são distribuídos sob a licença Apache 2.0, suportam uma janela de contexto de 128K e adicionam raciocínio nativo em cadeia de pensamento que você pode ligar ou desligar. Foram feitos para IA no atendimento ao cliente, programação e uso agêntico de ferramentas.
Quanto custa rodar o Granite 4.2?
O piso é gratuito: os pesos são Apache 2.0, então você pode hospedar por conta própria via Ollama ou Hugging Face e pagar apenas pelo seu próprio hardware. A tarifa hospedada confirmada mais barata é o granite-4.2-8b da Replicate, a US$ 0,06 por 1M de tokens de entrada e US$ 0,25 por 1M de saída. O watsonx.ai, da própria IBM, cobra por milhão de tokens mais hospedagem por hora, com um plano Standard de cerca de US$ 1.050/mês.
O Granite 4.2 é bom para programação e agentes?
O modelo de 30B marca 57,0 no SWE-Bench Verified e adiciona chamadas de ferramentas com raciocínio, então é crível para trabalho agêntico e de programação. Em capacidade bruta de programação, a comunidade de LLMs locais ainda tende a avaliar o Qwen mais alto. Se o seu objetivo é um agente de IA que resolva tickets de suporte, o modelo é só o motor: você ainda precisa de conhecimento, ferramentas e barreiras de segurança ao redor dele.
Como o Granite 4.2 é diferente do Granite 4.0?
O Granite 4.0 usava um design híbrido Mamba-2/transformer com uma camada de mistura de especialistas. O Granite 4.2 é um transformer denso, somente decodificador, pós-treinado a partir da base do Granite 4.1, e sua principal novidade é o raciocínio nativo alternável. Denso significa que não há divisão entre parâmetros ativos e totais: o tamanho que você baixa é o tamanho que roda.
Posso usar o Granite 4.2 comercialmente de graça?
Sim. A licença Apache 2.0 permite uso comercial e de pesquisa irrestrito, ajuste fino e hospedagem própria, sem taxa de licença por token. Você é responsável pelo poder de computação em que o executa. Para uma implantação de suporte, combiná-lo com uma camada de agente de IA para helpdesk como o eesel é o que transforma o modelo bruto em algo que realmente dá conta da sua fila.