

O Qwen 3.8 Flash Next é um ótimo brinquedo e uma dependência de produção instável. É a prévia de pesos abertos da Alibaba da arquitetura Qwen4, que a própria Qwen chama de propositalmente pouco treinada, servida por um único provedor de API e prolixa o suficiente para inflar as contas de saída. Então, se você gostou do preço e da velocidade, mas precisa de algo mais finalizado, aqui está onde olhar:
- O gêmeo finalizado de pesos abertos: GLM 5.3 Flash, que a comunidade trata como pronto para produção e que custa $0.075/$0.25 na promoção.
- O piso de orçamento: DeepSeek V4 Flash (licença MIT) ou Granite 4.2 8B auto-hospedado, a $0.06/$0.25 hospedado.
- Ficar na família: Qwen 3.8 Max, o irmão maior, estável e hospedado.
- Gerenciado e multimodal: Gemini 3.7 Flash ou GPT-5.6 Luna se você quer a confiabilidade de um grande provedor.
E o ponto que mais importa se você está procurando "IA barata" para suporte: o modelo são os 10% fáceis. Transformar qualquer um desses em algo que realmente resolva tickets são os outros 90%, e isso é trabalho de plataforma, não uma escolha de modelo.
Por que as pessoas estão deixando o Qwen 3.8 Flash Next
Eu construo agentes de IA na eesel, então vejo a faixa de modelos baratos se renovar a cada poucas semanas, e o Qwen 3.8 Flash Next foi um dos lançamentos mais barulhentos do verão. O tópico no Hacker News chegou a 698 pontos e o r/LocalLLaMA teve um megatópico com mais de 650 comentários. A empolgação é real: ativação esparsa e uma tabela N-gram de 51B descarregável permitem rodar um modelo de 125B em um notebook com memória unificada.
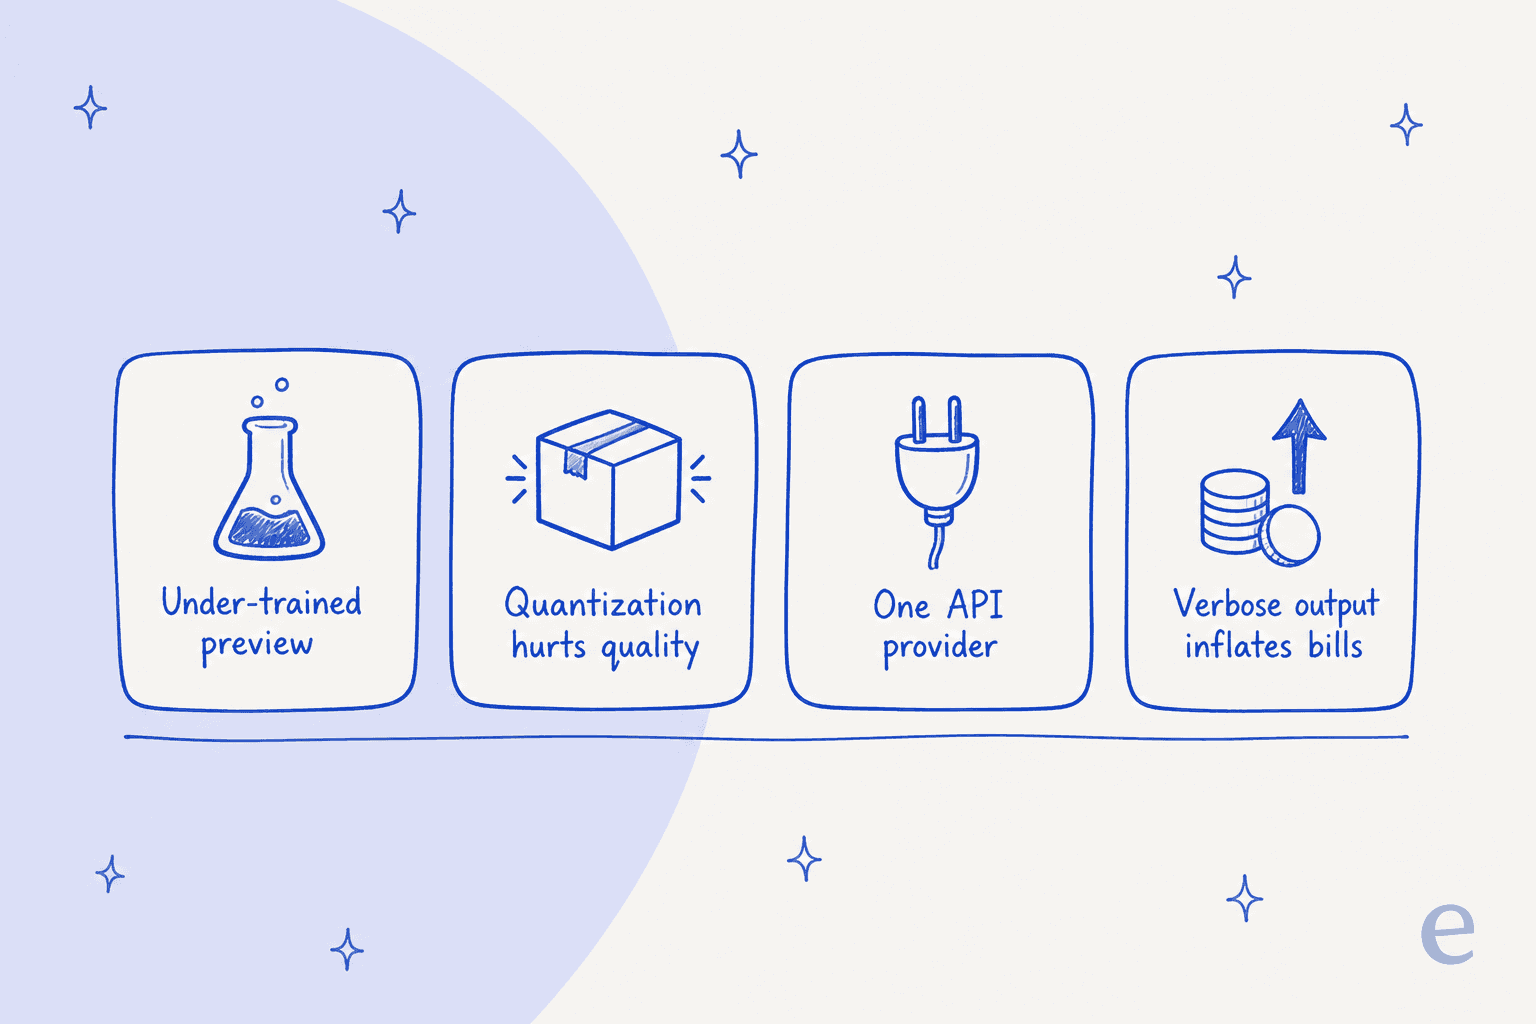
Mas, lendo além dos gráficos do lançamento, surge uma lista clara de motivos para trocar. Esta é a versão honesta do que você está assumindo:
A voz mais clara sobre o que "Next" realmente significa veio do tópico do lançamento:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Depois há o imposto da quantização. Simon Willison rodou o modelo em vários níveis de raciocínio em um DGX Spark e acabou preferindo o modelo denso menor, culpando a quantização de poucos bits necessária para caber. Além disso, a API hospedada do Qwen3.8-Flash tem hoje um único provedor, a Alibaba Cloud International, então não há failover. E testes independentes da Artificial Analysis o classificam como "very verbose": queima 200M de tokens de saída para concluir seu Index contra uma mediana de 110M, o que infla discretamente qualquer conta com muita saída.
Nada disso faz dele um modelo ruim. Faz dele uma prévia. Se você quer algo em que possa confiar neste trimestre, os oito abaixo são para onde essa mesma turma está indo.
Como escolhi essas alternativas
Limitei a lista a modelos que resolvem pelo menos um dos quatro problemas do Flash Next acima e, sempre que existem, preferi números independentes a tabelas de fabricantes. Na prática, cada escolha precisava passar por alguns critérios:
- Preços reais e verificáveis. Uma tarifa publicada por token ou pesos abertos gratuitos, não "fale com vendas".
- Um lançamento com cara de finalizado, ou uma nota honesta onde não for o caso.
- Uma pontuação independente verificável onde existir (principalmente o Intelligence Index da Artificial Analysis), para eu não apenas citar um blog de lançamento.
- Uma função distinta. Nenhum par de escolhas é "o mesmo, só um pouco mais barato", cada uma vence em um caso de uso diferente.
Uma coisa que não fiz foi fingir que um benchmark é um agente de suporte. Mais sobre isso no final.
Alternativas ao Qwen 3.8 Flash Next num relance
Aqui está a lista completa em um só lugar. Os preços são tarifas de API hospedada por 1M de tokens (entrada/saída); todo modelo de pesos abertos também pode ser auto-hospedado de graça se você tiver o hardware.
| # | Modelo | Ideal para | Tipo | Contexto | Preço ent./saída (por 1M) | Licença |
|---|---|---|---|---|---|---|
| 1 | GLM 5.3 Flash | Gêmeo finalizado de pesos abertos | Aberto + hospedado | 1M | $0.075 / $0.25 (promo) | Pesos abertos |
| 2 | DeepSeek V4 Flash | Piso de orçamento, MIT | Aberto + hospedado | 1M | $0.22 / $0.66 (fora do pico) | MIT |
| 3 | Qwen 3.8 Max | Ficar na família Qwen | Aberto + hospedado | 1M | $2.00 / $6.00 | Licença Qwen |
| 4 | Kimi K3 | Trabalho agêntico de longo prazo | Aberto + hospedado | 1M | $3.00 / $15.00 | Pesos abertos |
| 5 | Gemini 3.7 Flash | Multimodal gerenciado | Hospedado | ~1M | $0.75 / $3.75 (promo) | Fechado |
| 6 | GPT-5.6 Luna | Confiabilidade de ecossistema fechado | Hospedado | Grande | $0.20 / $1.20 | Fechado |
| 7 | Granite 4.2 | Empresarial / on-prem | Aberto + hospedado | 128K | $0.06 / $0.25 (Replicate 8B) | Apache 2.0 |
| 8 | LongCat 2.0 | Grande MoE MIT curinga | Aberto + hospedado | 256K | $0.30 / $1.20 (promo) | MIT |
Um exemplo rápido, porque as tarifas de tabela escondem a diferença real. Digamos que uma carga agêntica mensal use 50M de tokens de entrada e 15M de saída. Na promoção do GLM 5.3 Flash isso dá cerca de $7.50; no Granite 4.2 8B via Replicate, aproximadamente $6.75; no próprio Qwen3.8-Flash hospedado, cerca de $14.55; no Gemini 3.7 Flash, perto de $94; e no Kimi K3, em torno de $375. Mesmo trabalho, uma diferença de 50x. Os tokens de saída, não os de entrada, são onde os modelos de raciocínio enterram o custo sem ninguém notar.
1. GLM 5.3 Flash, o gêmeo finalizado de pesos abertos
Ideal para: equipes que gostaram da classe econômica de pesos abertos do Flash Next, mas precisam de algo que já pareça pronto.
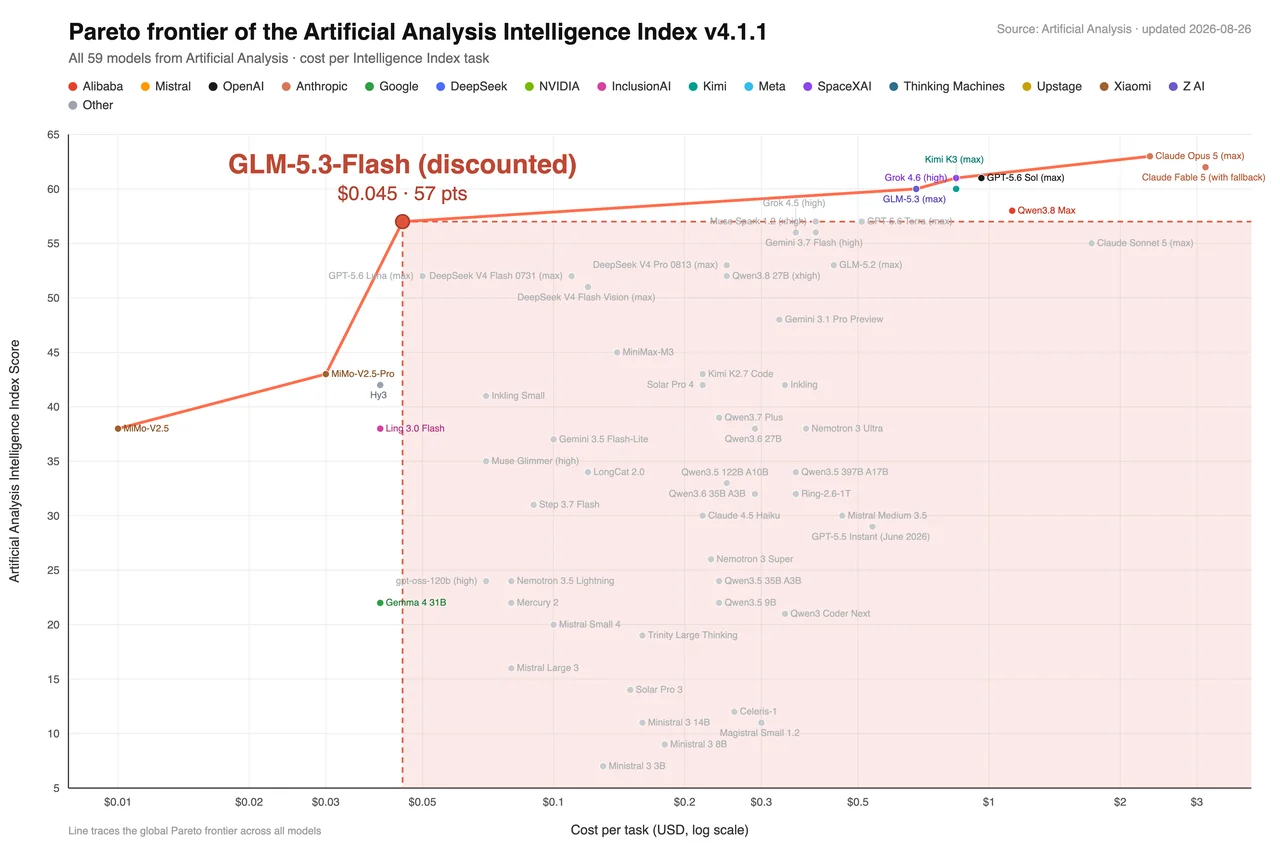
Este é o modelo para o qual a comunidade continua apontando quem experimenta o Flash Next, e com razão. O GLM 5.3 Flash, da Z.ai (Zhipu), foi lançado na mesma semana, em 26 de agosto de 2026, como o primeiro modelo GLM-5 nativamente multimodal: 320B no total com 18B ativos em um design de mistura de especialistas, contexto de 1M de tokens e pesos abertos no Hugging Face. Sob o codinome "ox-alpha", ficou brevemente em primeiro lugar no OpenRouter por volume de tokens.
O ponto crucial: ele pontua como um modelo finalizado. A Artificial Analysis lhe dá um Intelligence Index de 57 a cerca de $0.045 por tarefa, e os primeiros testadores foram francos sobre o valor:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Prós: nível de produção apesar do preço baixo, realmente multimodal, pesos abertos e um GLM Coding Plan dedicado a $18/$80/$168 por mês se você vive em uma IDE.
Contras: só pensa, então você não pode desligar o raciocínio para economizar latência, e a API própria é lenta (cerca de 49 tokens/segundo), por isso usuários intensivos passam por provedores como a Databricks para ganhar velocidade.
Preços: promo $0.075 de entrada / $0.25 de saída por 1M (tabela $0.15/$0.50), entrada em cache $0.015, com a promoção valendo até 9 de setembro de 2026.
Veredito: se você quer a experiência do Flash Next sem o asterisco de "prévia", comece aqui. É o mais próximo de uma atualização equivalente nesta lista.
2. DeepSeek V4 Flash, o piso de orçamento
Ideal para: quem é obcecado por preço e também quer uma licença permissiva.
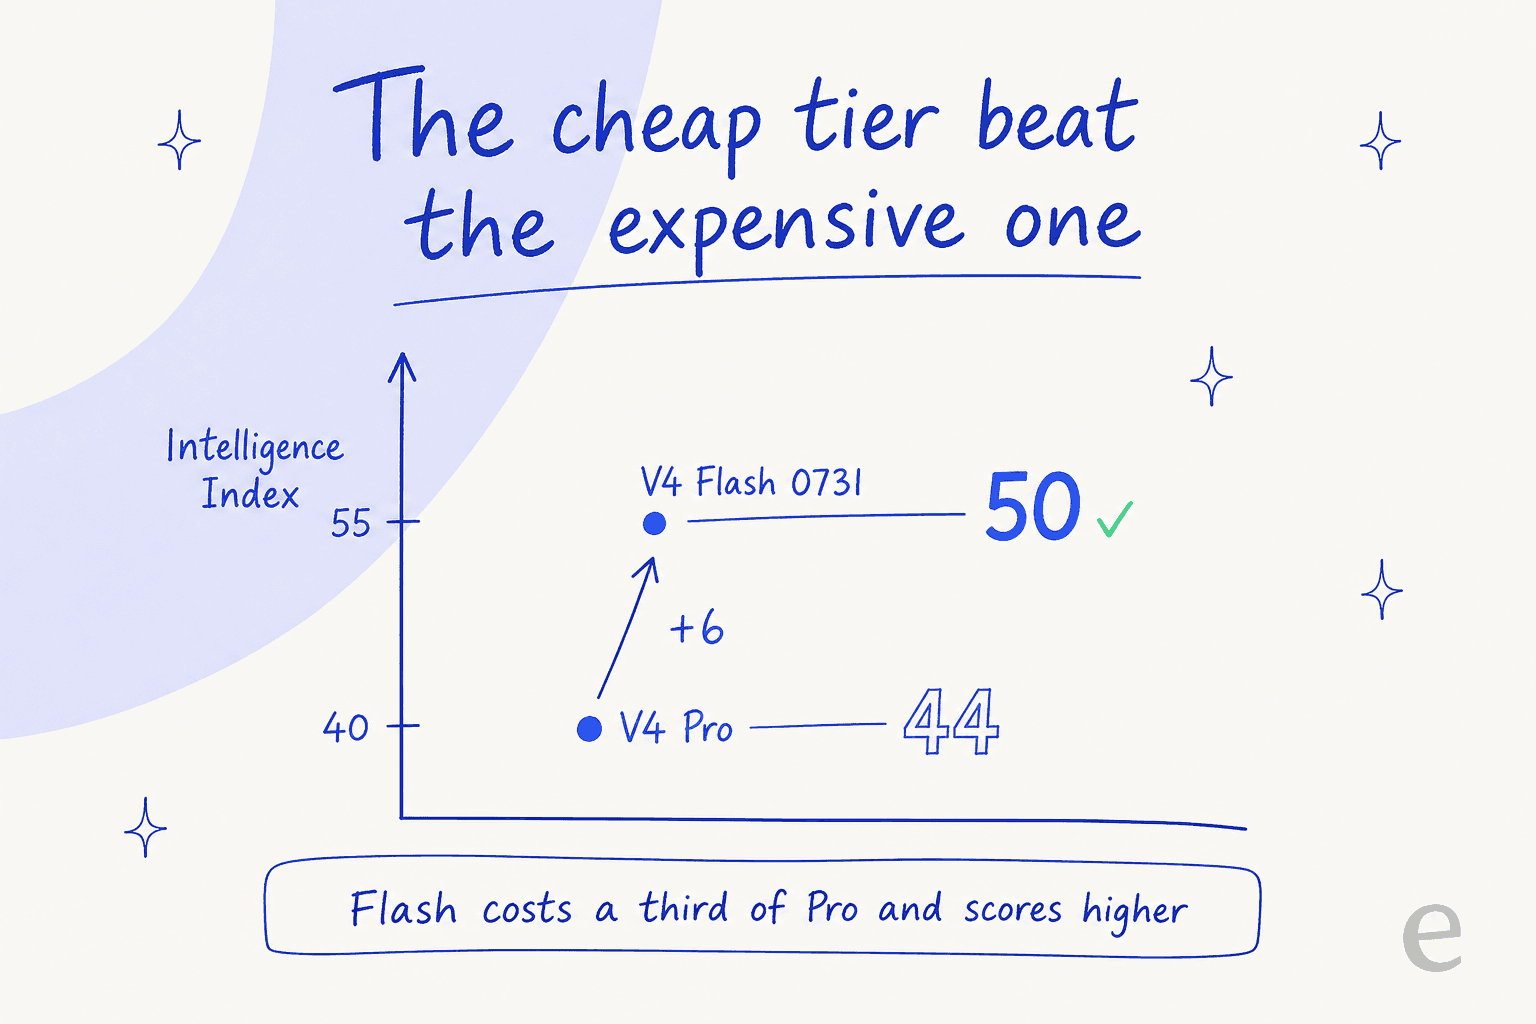
O DeepSeek V4 Flash é um MoE de 284B no total e 13B ativos, com contexto de 1M e, de forma incomum nesta classe, pesos abertos MIT de verdade (cerca de 167GB, com dezenas de quantizações da comunidade). O truque que faz as pessoas o adorarem: testes independentes mostram o nível Flash, mais barato, na verdade superando o V4 Pro, mais caro, em tarefas agênticas de longo prazo, ponto que um engenheiro líder resumiu bem:
"DeepSeek V4 Flash is the most cost effective model we've tested... Pro is slower and smarter in one-shot reasoning problems, but less effective with tools and therefore less performant in long horizon agentic tasks."
Há duas pegadinhas honestas. A DeepSeek reajustou os preços em agosto de 2026 e agora aplica um acréscimo de horário de pico/fora de pico, com picos em 01:00-04:00 e 06:00-10:00 UTC. Assim, uma fila dos EUA ou da UE é cobrada em sua maioria fora do pico, mas um job em lote agendado no horário comercial chinês paga o dobro. E ele alucina mais do que você gostaria; um usuário disse sem rodeios:
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Prós: o menor custo real por token entre os modelos hospedados aqui, pesos MIT e um bom perfil de uso de ferramentas.
Contras: prolixo (cerca de 210M de tokens de saída para rodar o Index), só texto (nenhuma entrada de imagem documentada), e os termos da API paga são omissos sobre uso em treinamento, então não serve como substituto direto para dados de clientes. Para a comparação completa, veja nosso comparativo DeepSeek vs Kimi K3.
Preços: fora do pico/pico, entrada sem cache $0.22/$0.44, saída $0.66/$1.32, entrada com acerto de cache a partir de $0.007.
Veredito: o rei do custo-benefício, desde que você modele os tokens de saída e mantenha dados de clientes fora do endpoint próprio.
3. Qwen 3.8 Max, a escolha para ficar na família
Ideal para: quem gosta do ecossistema Qwen, mas precisa do carro-chefe finalizado e hospedado em vez de uma prévia.
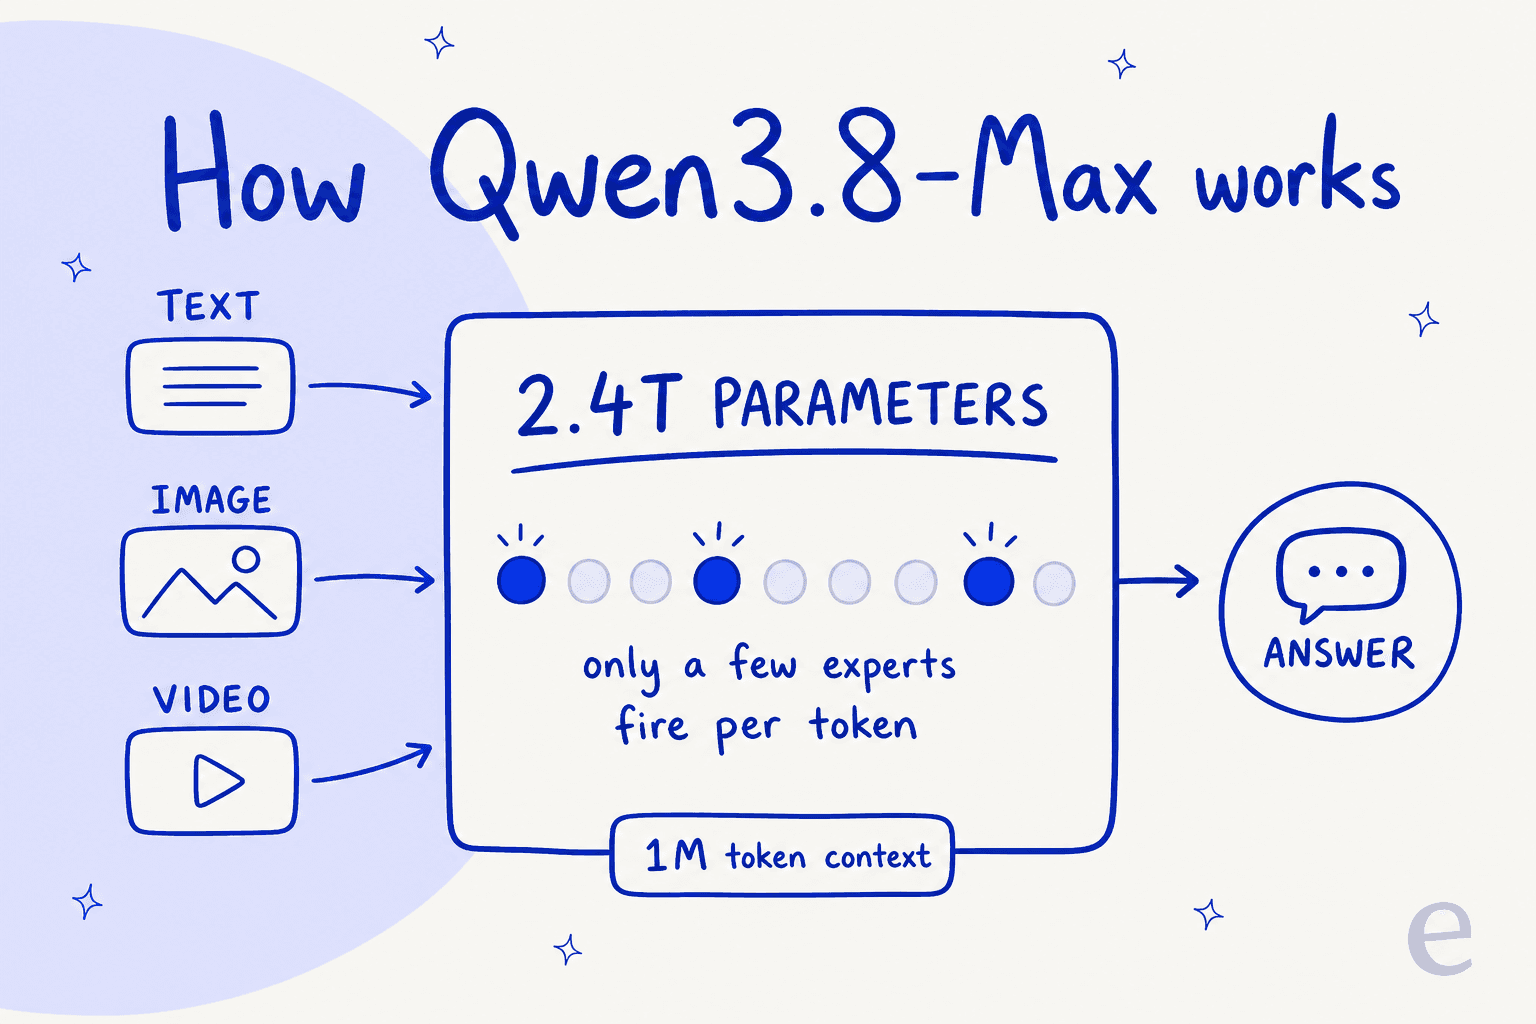
Se o Flash Next é a prévia de pesquisa, o Qwen 3.8 Max é o produto entregue. Ficou em disponibilidade geral em 2 de agosto de 2026: um MoE de 2.4T no total e 95B ativos, com contexto de 1M, 131,072 de saída máxima e extras hospedados que faltam na base aberta (entrada de visão, um modo sem raciocínio e ferramentas integradas). Os pesos também saíram em agosto, embora sob a licença Qwen e não Apache.
No ranking independente ele se sustenta: a Artificial Analysis o lista na posição 6 com um Intelligence Index em torno de 58 a cerca de $1.13 por tarefa, e na LMArena ele está entre os cinco primeiros em texto e em segundo em visão. Se você quer um único número, não queira; o composto automatizado e a preferência humana apontam em direções ligeiramente diferentes, o que já é um lembrete útil de não confiar em um único benchmark.
Prós: estável, hospedado, realmente multimodal e mantém você dentro de ferramentas que talvez já use com o Flash Next.
Contras: uma ordem de grandeza mais caro que o nível Flash, e os pesos abertos não são equivalentes em recursos à versão hospedada.
Preços: $2 de entrada / $6 de saída por 1M, com leituras de cache implícito a $0.25.
Veredito: a escolha sem drama para os fãs da Qwen que precisam mais de estabilidade em produção do que do preço mínimo do Flash. Se estiver em dúvida, nosso guia de acesso percorre as opções.
4. Kimi K3, a escolha agêntica de longo prazo
Ideal para: execuções de agentes complexas e em várias etapas, em que capacidade importa mais que custo.
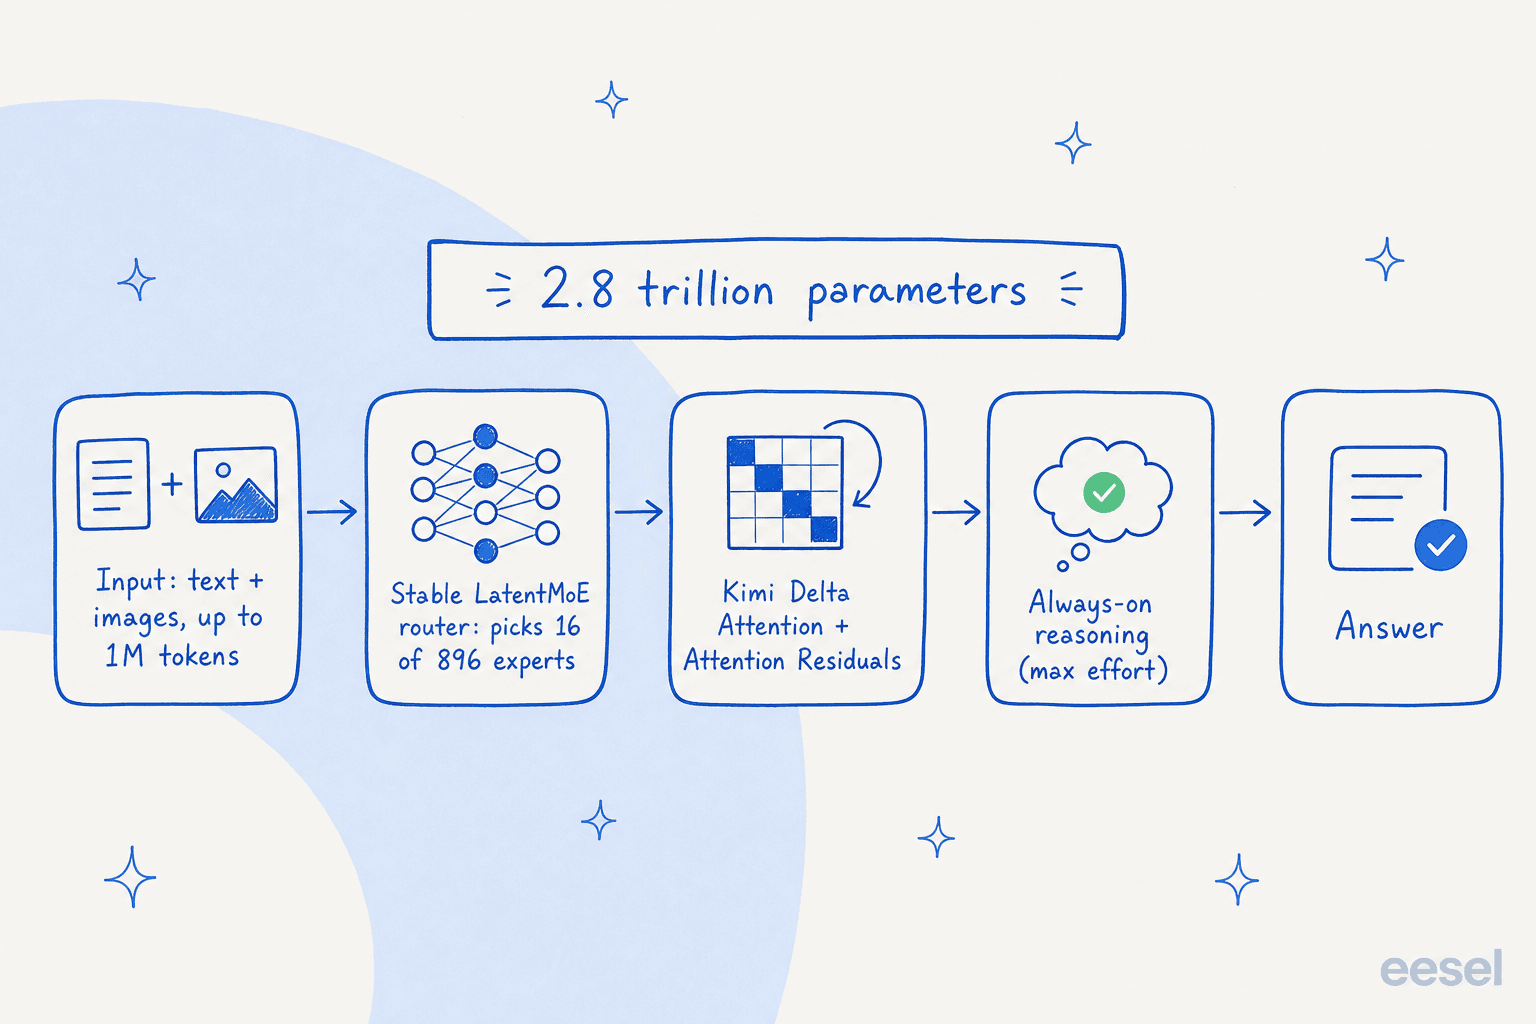
O Kimi K3, da Moonshot, é o peso-pesado desta lista: 2.8T de parâmetros no total com 104B ativos, contexto de 1M, visão nativa e pesos abertos que saíram no prazo em 27 de julho de 2026. Seu Intelligence Index da Artificial Analysis de 57 o coloca em quarto no geral, e é um modelo agêntico e de programação realmente forte.
O problema é o preço. O K3 custa $3 de entrada / $15 de saída por 1M, a mesma faixa de um modelo fechado de ponta e cerca de 50x a tarifa de saída do DeepSeek V4 Flash. O raciocínio também não pode ser desligado, então até uma chamada simples paga o imposto de pensar; o menor nível de esforço pontua pior e custa mais por tarefa que o DeepSeek. Isso não é uma alternativa econômica ao Flash Next; é uma alternativa de capacidade.
Prós: desempenho agêntico de primeira linha, um contexto enorme, pesos abertos e visão nativa.
Contras: preço de modelo de ponta, raciocínio sempre ativo, e a API de visão recusa URLs públicas de imagem (só base64 ou um ID de arquivo).
Preços: $3 de entrada / $15 de saída por 1M, entrada com acerto de cache $0.30.
Veredito: recorra ao K3 quando a tarefa for difícil o bastante para justificar a conta. Para o trabalho cotidiano barato e rápido, é a ferramenta errada.
5. Gemini 3.7 Flash, a escolha multimodal gerenciada
Ideal para: equipes que querem a confiabilidade de um grande provedor, boa entrada multimodal e nenhum auto-hospedagem.
Se toda a história de auto-hospedagem parece um hobby para o qual você não tem tempo, o Gemini 3.7 Flash é a resposta gerenciada. Entrou em disponibilidade geral em 13 de agosto de 2026 e é o modelo mais rápido já medido pela Artificial Analysis, com 340 tokens/segundo (posição #1 de 188). O que vale saber ao comprar: o nível de esforço de raciocínio que você escolhe altera muito custo e qualidade. Em low ele marca 50.9 no Index a $0.16 por tarefa; em high chega a 56.0, mas salta para $0.40. Deixar o padrão medium costuma ser pagar a mais.
Duas ressalvas o mantêm honesto. O Google removeu o nível de pensamento minimal que fazia dos Flash anteriores o piso mais barato para OCR e classificação. E a taxa de alucinação regrediu para 64.5% dos 55.6% do 3.6 Flash, mesmo com a precisão melhorando, exatamente o tipo de coisa que você quer detectar antes de lançar.
Prós: gerenciado e confiável, a maior vazão da categoria, boas pontuações em contexto longo e uso de computador, e um preço promocional que hoje iguala o do 3.6 Flash.
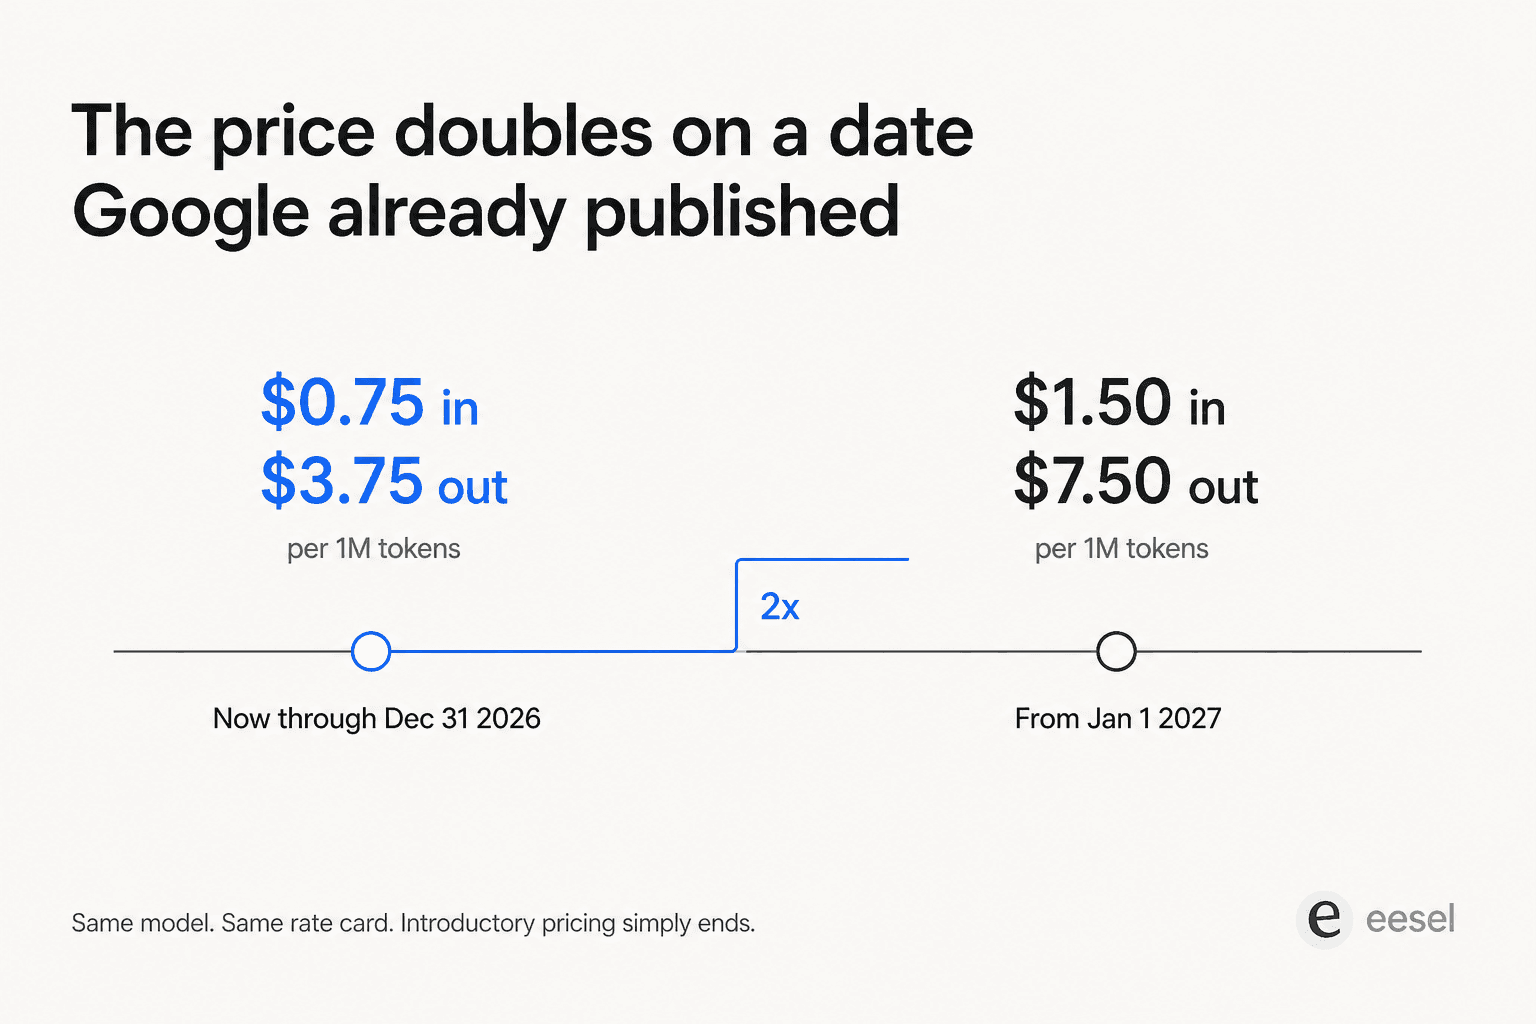
Contras: pesos fechados, uma taxa de alucinação maior que a do antecessor e um preço que dobra em janeiro de 2027.
Preços: $0.75 de entrada / $3.75 de saída por 1M como preço introdutório até 31 de dezembro de 2026, depois $1.50 / $7.50.
Veredito: a escolha quando você prefere pagar uma plataforma a cuidar de uma GPU. Só não deixe o seletor de esforço no padrão.
6. GPT-5.6 Luna, a escolha de confiabilidade em ecossistema fechado
Ideal para: equipes já padronizadas na OpenAI que querem um nível barato sem sair do stack.
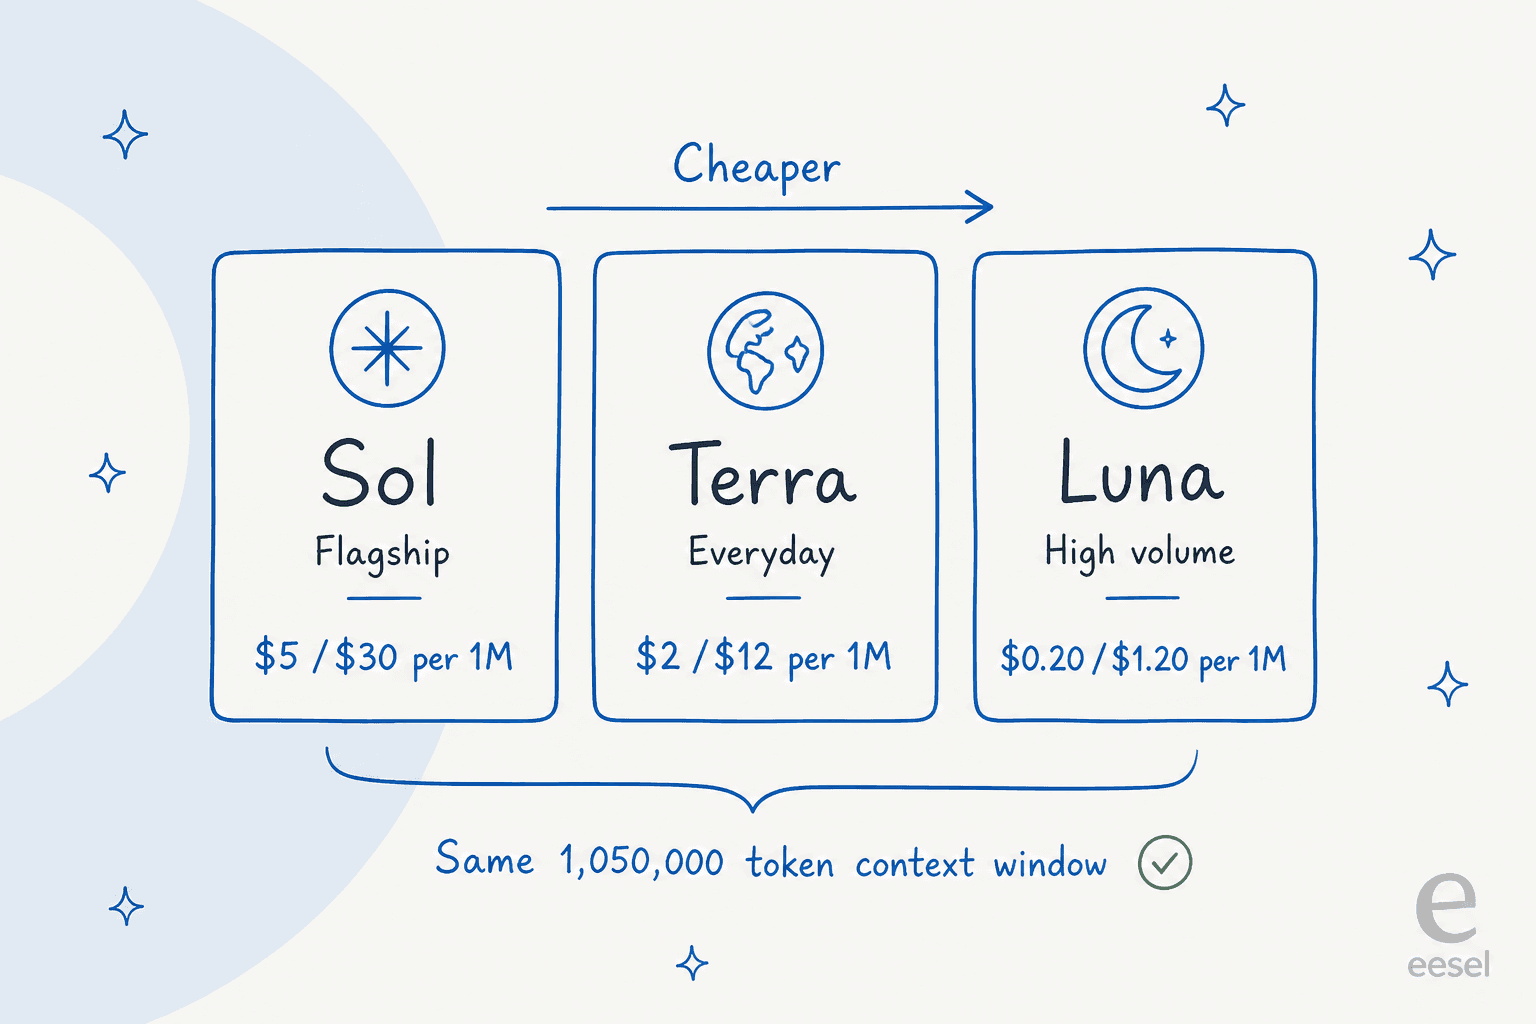
O Luna é o degrau econômico da escada do GPT-5.6 (os outros dois são o Terra e o carro-chefe Sol). A $0.20 de entrada / $1.20 de saída por 1M, ele é competitivo em preço com os modelos chineses de pesos abertos e ainda entrega as ferramentas, SDKs e a confiabilidade da OpenAI. Para uma equipe cuja infraestrutura já pressupõe a API da OpenAI, esse custo de troca economizado é real.
A contrapartida é a que todo modelo fechado carrega aqui: sem pesos, sem auto-hospedagem, e a OpenAI cobra um nível de contexto longo que dobra a tarifa além da janela de contexto curto (o Luna vai para $0.40/$1.80). Anthropic e Google não cobram esse degrau, então vale verificar se os seus comprimentos de contexto cruzam a linha.
Prós: um provedor confiável, ecossistema maduro e um nível de entrada realmente barato.
Contras: pesos fechados, um acréscimo de 2x para contexto longo e menos abertura do que os modelos com que compete em preço.
Preços: $0.20 de entrada / $1.20 de saída por 1M em contexto curto; $0.40 / $1.80 em contexto longo; entrada em cache $0.02.
Veredito: o padrão barato sensato se você já é uma casa OpenAI e valoriza o ecossistema acima dos pesos abertos.
7. IBM Granite 4.2, a escolha empresarial / on-prem
Ideal para: empresas que precisam de licenciamento permissivo, hardware comum e chamadas de ferramentas fundamentadas.
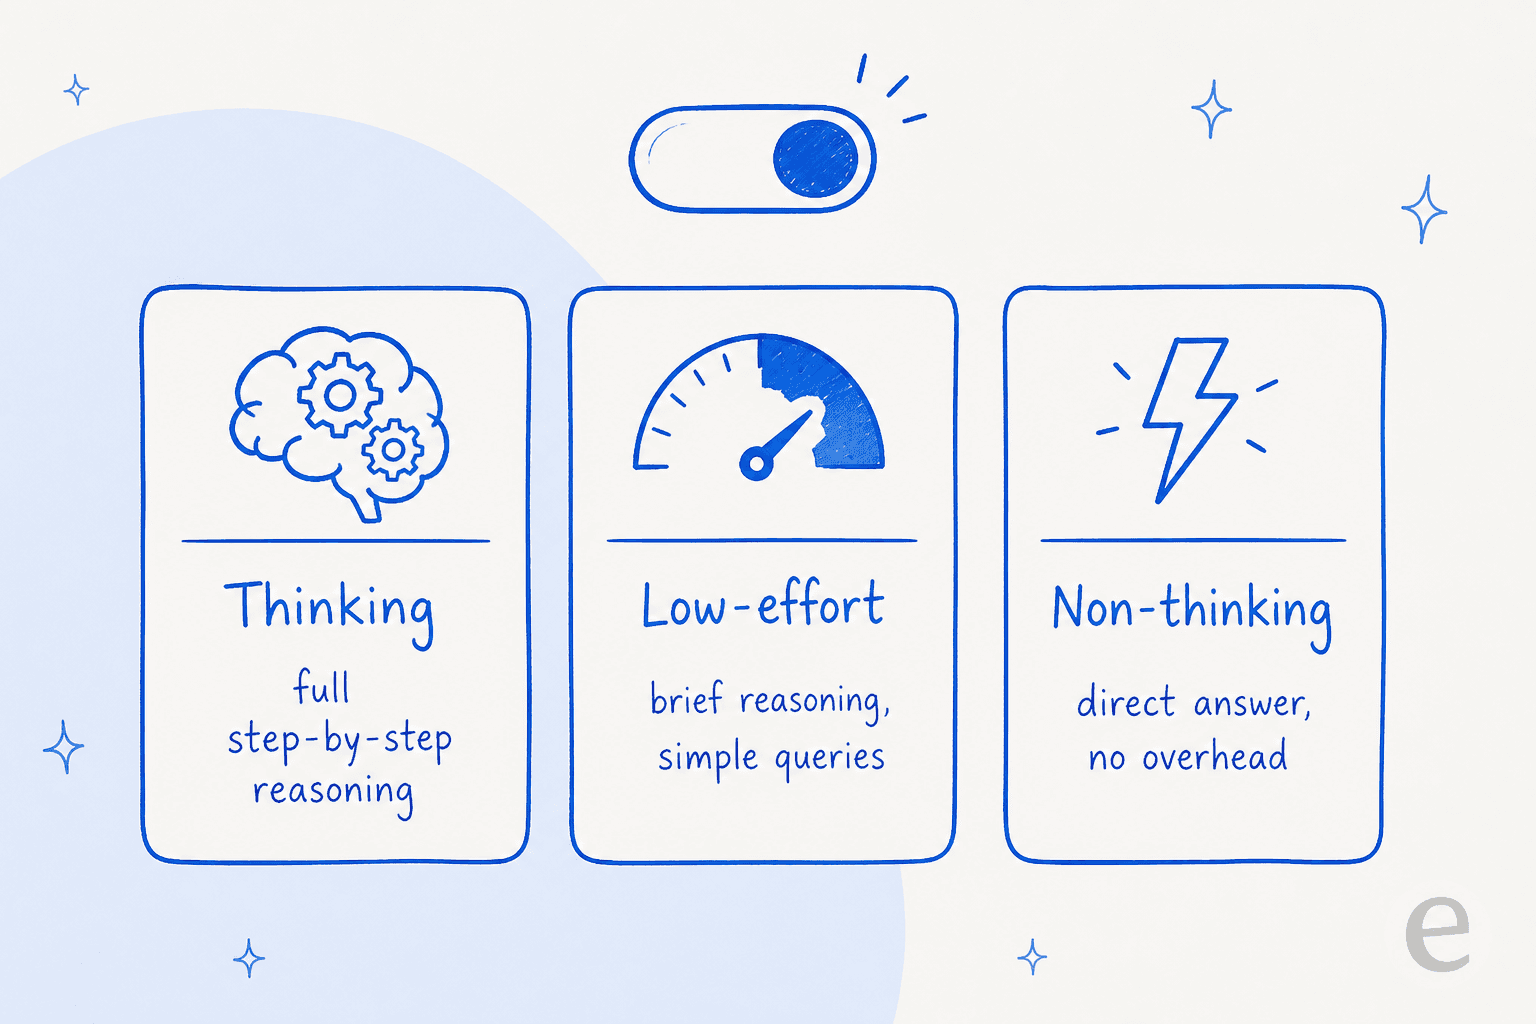
O Granite 4.2 é o modelo que suas equipes jurídica e de segurança realmente vão aprovar. A IBM o lançou em 25 de agosto de 2026 como três modelos densos Apache 2.0 (3B, 8B e um carro-chefe de 30B) com contexto de 128K e, ao contrário do Flash Next, raciocínio alternável: pensamento completo, esforço baixo ou totalmente desligado. Ele é ajustado para extração fundamentada e chamadas de ferramentas, não para vitórias em benchmarks, e os testadores gostam da praticidade:
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
Seja claro sobre o que ele não é. Ele não lidera os rankings brutos de programação, e a mesma comunidade diz isso diretamente: "Qwen still wins on raw capability, especially for coding." Também há uma peculiaridade de memória: o download de 5.3GB do modelo 8B incha para cerca de 27GB quando o cache KV é carregado, então dimensione sua GPU de acordo.
Prós: Apache 2.0 de verdade (não apenas "pesos disponíveis"), raciocínio alternável, dados de treinamento recentes e roda rápido em hardware modesto.
Contras: fica atrás da Qwen em programação bruta, os benchmarks da IBM comparam principalmente com Granites anteriores em vez de com os líderes chineses, e o inchaço de memória ao carregar surpreende as pessoas.
Preços: auto-hospedado grátis (o 8B é um download de 5.3GB); o hospedado confirmado mais barato é o 8B da Replicate a $0.06 de entrada / $0.25 de saída por 1M.
Veredito: a escolha segura para empresas. Se licenciamento e controle on-prem pesam mais que os últimos pontos de benchmark, o Granite é difícil de bater.
8. LongCat 2.0, o curinga MoE MIT de grande porte
Ideal para: os aventureiros que querem um MoE muito grande com licença MIT e aguentam as ferramentas.
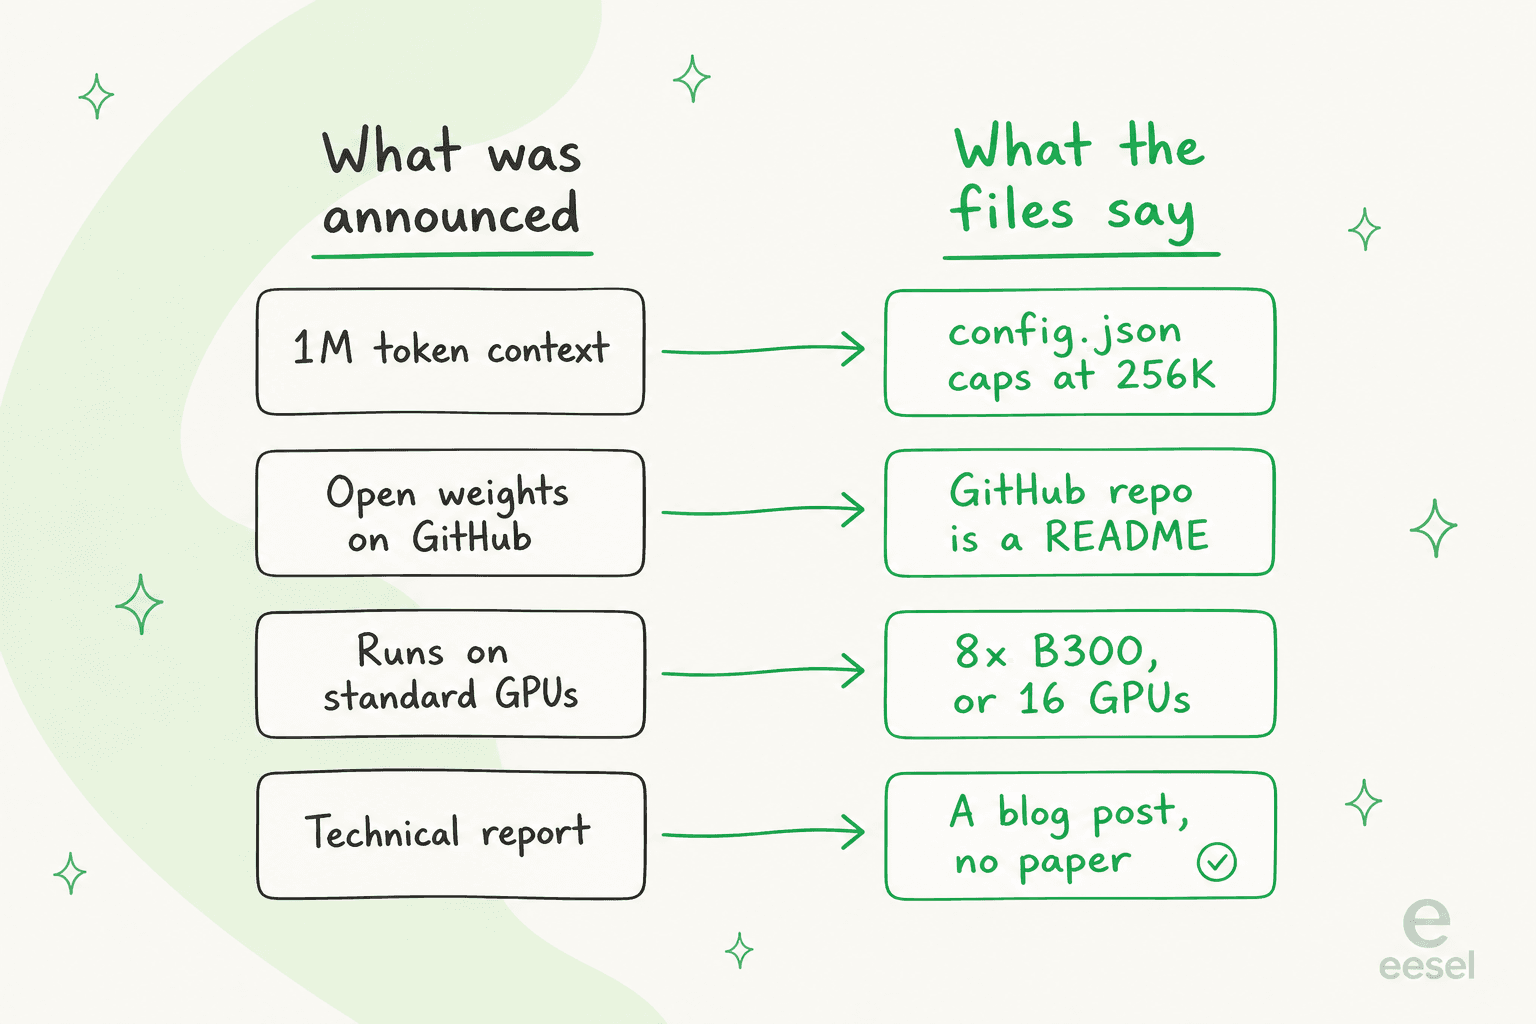
O LongCat 2.0, da Meituan, é o primo arquitetônico da família DeepSeek: um MoE de 1.6T com cerca de 48B ativos por token, pesos MIT simples e preços promocionais que ficam abaixo da maioria desta lista. É realmente capaz, com um SWE-bench Pro autoavaliado de 59.5 que supera por pouco o GPT-5.5.
Mas vem com mais asteriscos do que qualquer outro aqui, e todos são verificáveis. O "contexto de 1M" anunciado é uma alegação de treinamento; a configuração publicada limita as posições a 256K. O repositório do GitHub tem só README, sem paper, o SGLang é o único motor, e o auto-hospedagem exige realisticamente 8x GPUs B300, já que não há GGUF para Ollama ou LM Studio. O pagamento fora da China continental é feito por Alipay ou WeChat Pay, não por cartão. E para suporte especificamente, o FAQ da plataforma é omisso sobre retenção de dados e treinamento, que é o verdadeiro bloqueio, não o preço.
Prós: realmente grande e capaz, licença MIT limpa e preços promocionais agressivos.
Contras: ferramentas escassas, um contexto real de 256K (não 1M), uma exigência brutal de auto-hospedagem, pagamento complicado e nenhum compromisso sobre tratamento de dados.
Preços: promo $0.30 de entrada / $1.20 de saída por 1M (tabela $0.75/$2.95), sem escalonamento por tamanho de contexto.
Veredito: um curinga fascinante para pesquisadores, mas as lacunas de ferramentas e de dados o tornam o mais difícil desta lista de colocar em produção.
Qual alternativa você deve escolher?
Se você cruzar essas opções com as duas coisas que realmente o afastaram do Flash Next, "está finalizado?" e "quero rodar por conta própria?", a lista se organiza rápido.
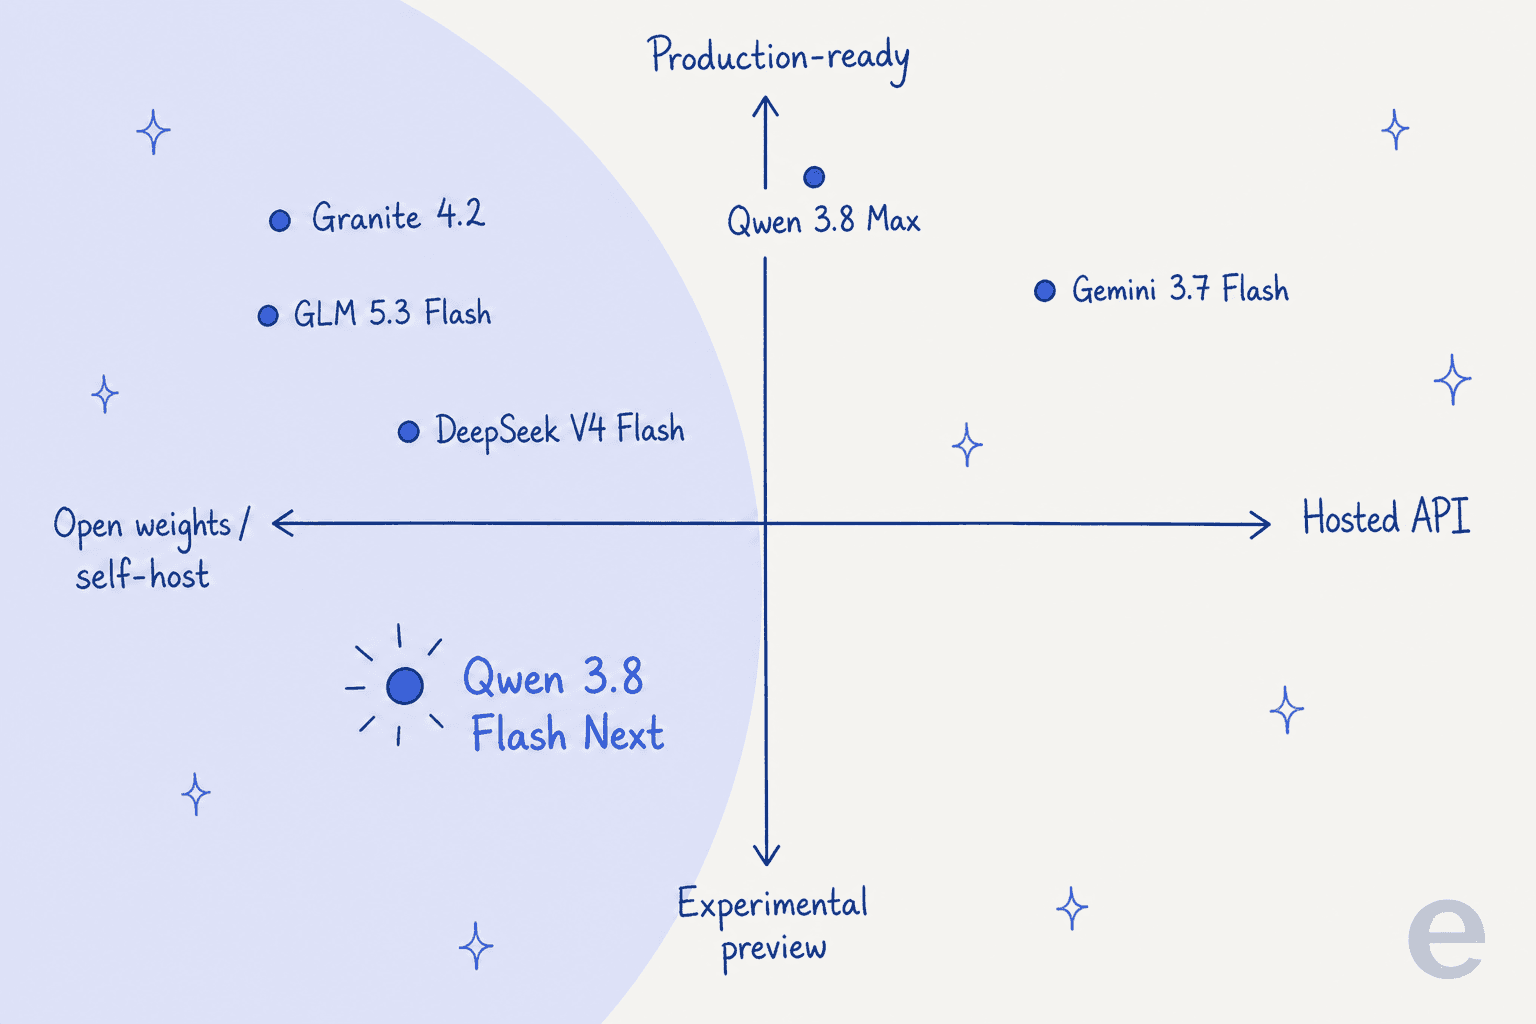
Decisões rápidas:
- Quer a mesma coisa, só que finalizada? GLM 5.3 Flash.
- Quer a conta real mais barata? DeepSeek V4 Flash, ou Granite 4.2 auto-hospedado.
- Quer ficar no mundo Qwen, mas estável? Qwen 3.8 Max.
- Não quer encostar em uma GPU? Gemini 3.7 Flash ou GPT-5.6 Luna.
- Precisa de licenciamento empresarial e on-prem? Granite 4.2.
O padrão por trás de tudo isso
Aqui está o que eu sempre preciso dizer às equipes que chegam a um post como este. Todo modelo acima é um componente. Um modelo bruto recebe tokens e devolve tokens. Ele não conhece sua política de reembolso, não consegue ler o histórico de pedidos de um cliente, não vai redigir uma resposta dentro do seu helpdesk e não faz ideia se sua resposta confiante está correta. O modelo é infraestrutura; quem faz o trabalho é o funcionário.
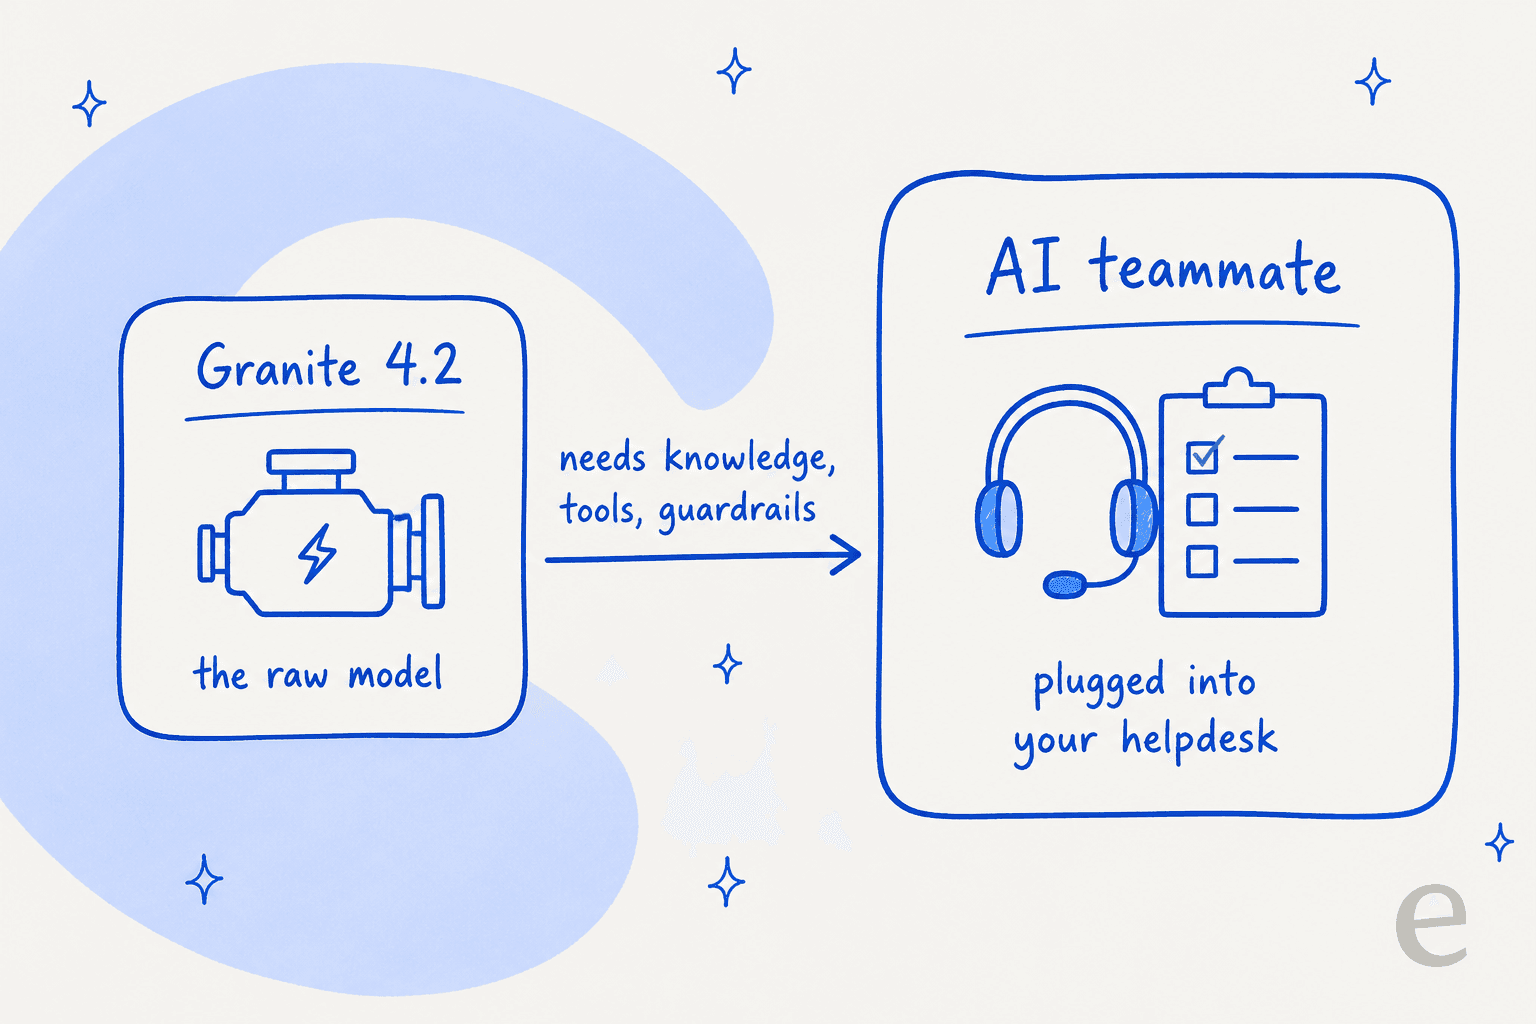
É por isso que "qual modelo barato devo usar para suporte?" é a primeira pergunta errada. Escolher o modelo são os 10% fáceis. Os 90% que decidem se os tickets realmente são resolvidos são a camada ao redor: recuperação sobre sua base de conhecimento, ações dentro do seu helpdesk, salvaguardas e testes com histórico real antes de qualquer coisa chegar a um cliente. Isso vale quer o modelo por baixo seja o Flash Next, o GLM 5.3 Flash ou um funcionário de IA que você construa internamente.
Experimente a eesel
Se você chegou aqui avaliando um modelo barato para uma carga de suporte, o conselho honesto é parar de procurar um modelo e começar a testar com seus próprios tickets. Essa camada de funcionário é o que eu construo na eesel: uma plataforma de colegas de IA em que você contrata colegas prontos para trabalhar em funções específicas, atualmente um colega de IA para helpdesk e um redator de blog de IA. Cada um chega com as habilidades, integrações e contexto da empresa para o seu papel, de modo que o modelo rodando por baixo vira um detalhe de implementação e não um problema seu.

A parte que eu destacaria com mais força são os testes, porque um modelo de prévia recém-lançado como o Flash Next é exatamente o tipo de coisa que você quer atrás de um portão. O colega de helpdesk da eesel simula cada lançamento com seus tickets históricos antes de tocar em um cliente real, para você ver a taxa de resolução e as respostas exatas que ele teria enviado em conversas passadas reais, e então decidir o que automatizar. Escolha o modelo que vencer o seu benchmark; só prove primeiro com os seus próprios tickets. É grátis para experimentar.