

A Gimlet Labs opera o que chama de primeira "nuvem de inferência multi-silício". Em termos simples: um software que divide uma carga de trabalho de IA entre diferentes tipos de chip, de modo que cada fase de um modelo rode no hardware que melhor a executa. Em 4 de setembro de 2026, ela captou uma Série B de US$ 300 milhões liderada pela Andreessen Horowitz, com avaliação de US$ 3 bilhões, e a Arm e o braço de venture capital da Microsoft entraram na rodada.
O motivo de isso valer US$ 3 bi é o mesmo pelo qual me interesso, como alguém que constrói agentes de IA para viver: cargas de trabalho agênticas quebram a premissa de "um modelo, uma GPU". Um agente encadeia uma dúzia de chamadas sequenciais ao modelo, e cada chamada exige uma parte diferente do hardware. A aposta da Gimlet é rotear cada parte para o chip mais rápido nela.
A promessa é uma inferência de 3 a 10 vezes mais rápida com a mesma energia. Esse número vem da própria empresa e merece uma boa dose de ceticismo, sobre o que falarei adiante. Mas o problema de fundo é real, e eu o sinto a cada lançamento.
O que é a Gimlet Labs?
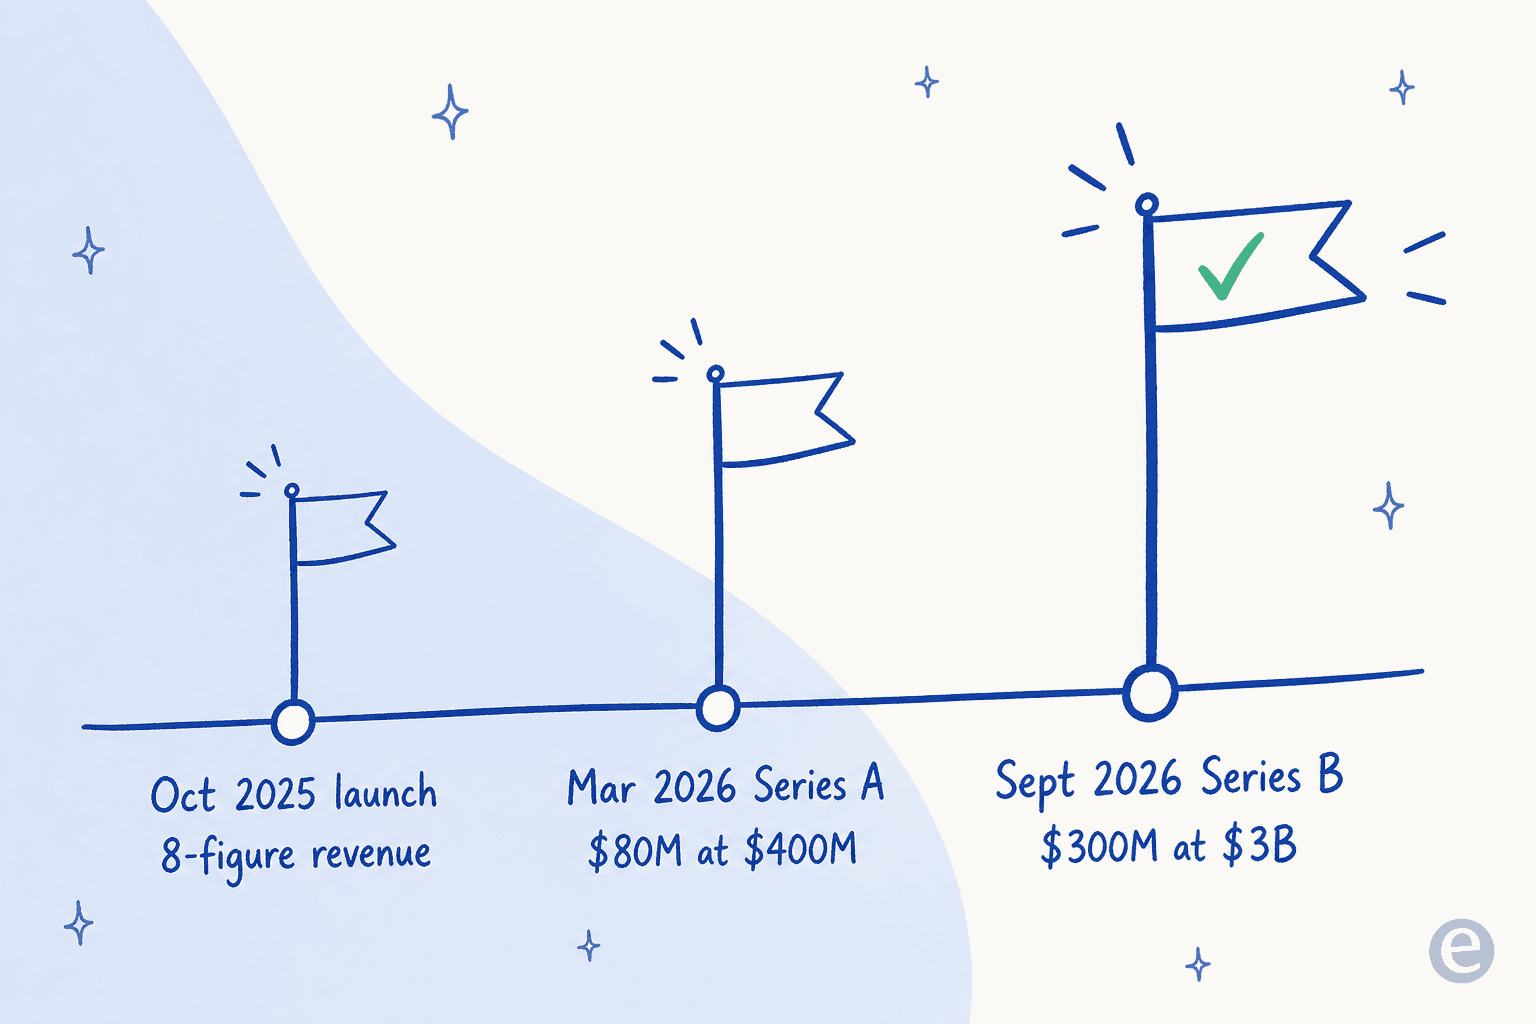
A Gimlet Labs é uma empresa de pesquisa aplicada e de produtos em IA. Foi lançada publicamente em outubro de 2025 com, segundo ela mesma, receita de oito dígitos já de saída, algo incomum para uma empresa tão jovem.
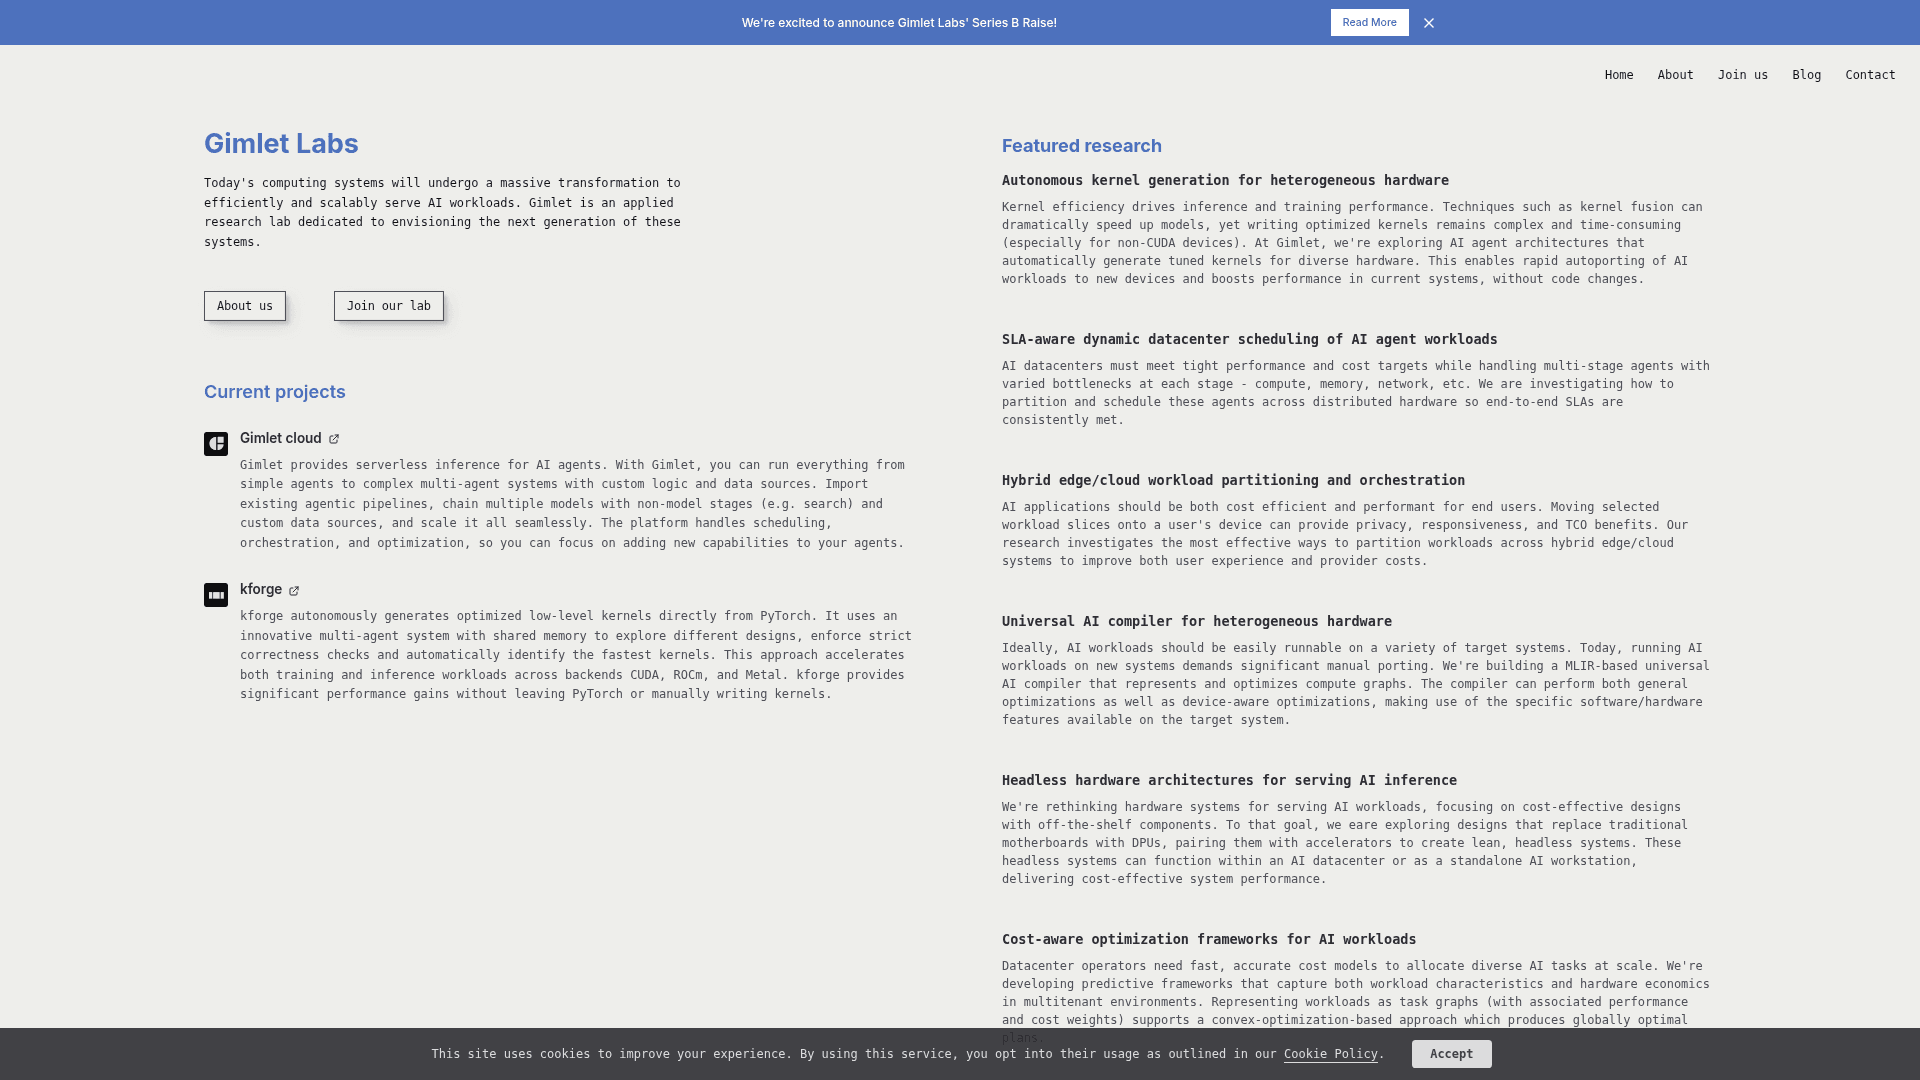
A página inicial resume a visão em uma frase: "Today's computing systems will undergo a massive transformation to efficiently and scalably serve AI workloads." Todo o resto decorre disso. Em vez de aceitar que um modelo rode na GPU que você aluga, a Gimlet constrói a camada que espalha o modelo por muitos tipos de chip ao mesmo tempo.
Há dois produtos por trás da proposta:
- Gimlet Cloud é uma plataforma de inferência serverless voltada a agentes de IA. Você importa um pipeline agêntico existente, encadeia vários modelos com etapas que não são modelos, como busca, e a plataforma cuida do agendamento e da orquestração.
- kforge é a peça de nível mais baixo. Ele gera automaticamente kernels otimizados direto do PyTorch para os backends CUDA, ROCm e Metal, usando um sistema multiagente que explora projetos de kernel e verifica sua correção, para que os engenheiros obtenham ganhos de velocidade sem escrever kernels à mão.
O problema: os agentes quebraram a inferência em um único chip
Esta é a parte que faz tudo fazer sentido, e é por isso que acho que isto é mais do que uma notícia de captação.
Um grande modelo de linguagem não faz um único tipo uniforme de trabalho. Ao responder, ele primeiro lê o seu prompt (a fase de prefill), que é limitada por computação e quer vazão bruta de cálculo. Depois gera tokens um a um (a fase de decode), que é limitada pela largura de banda de memória e passa o tempo movendo dados para dentro e para fora da memória. E um agente de IA moderno não para aí: ele chama ferramentas, acessa APIs e busca documentos, o que é limitado pela rede.
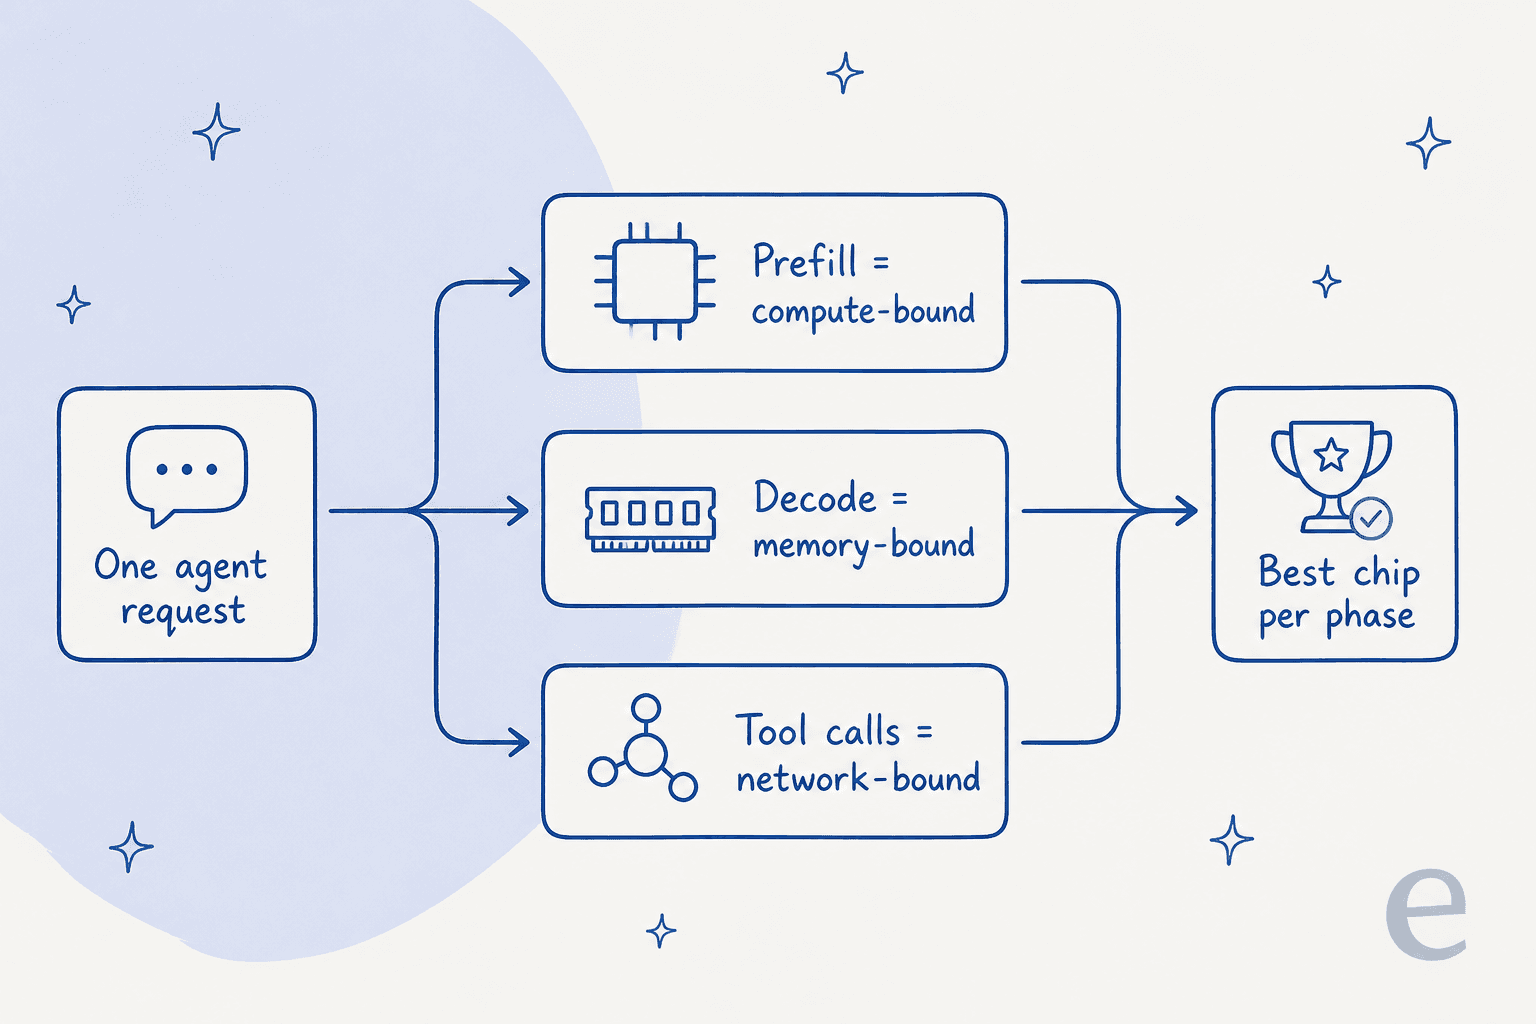
Rode tudo isso em um cluster homogêneo de GPUs e sempre sobra algo ocioso. Durante o decode, sua computação cara fica meio usada. Durante as chamadas de ferramentas, o acelerador inteiro espera pela rede. O argumento da Gimlet, direto do seu post da Série B, é que hardware homogêneo sozinho não atende às necessidades de velocidade e eficiência das cargas de trabalho agênticas. Quanto mais etapas um agente encadeia, mais esse desperdício se acumula.
Para mim isso não é uma preocupação abstrata. Na eesel, construo agentes de IA que resolvem tickets de suporte, e uma única resolução é uma cadeia: ler o ticket, pesquisar na base de conhecimento, raciocinar sobre o que foi encontrado, às vezes chamar uma API de consulta de pedidos e depois escrever uma resposta. Cada uma dessas etapas tem um gargalo diferente. Quando perguntam por que produtos agênticos podem parecer lentos, essa é boa parte da resposta.
Como funciona a nuvem multi-silício
A solução da Gimlet é a desagregação. Ela separa as fases e executa cada uma no silício mais adequado: o prefill em um conjunto de dispositivos ajustado para computação, o decode em outro ajustado para largura de banda de memória, e assim por diante. Soma a isso a decodificação especulativa e a separação entre atenção e feed-forward, e reequilibra dinamicamente conforme o hardware é liberado.
Para tornar isso possível, a Gimlet faz parcerias em toda a indústria de chips em vez de escolher um lado. Ela trabalha com chips da NVIDIA ao lado de AMD, Intel, Arm, Cerebras e d-Matrix. O software é o produto; o silício é intercambiável. É o oposto da história habitual de "compre o nosso acelerador", e é por isso que a Arm investiu na rodada em vez de tratar a Gimlet como ameaça.
O ganho anunciado pela Gimlet é de 5 a 10x dentro do mesmo envelope de potência, ou a mesma vazão com menor latência. Para a IA agêntica em particular, em que uma requisição pode precisar de dezenas de chamadas sequenciais ao modelo, tirar latência de cada chamada é onde o efeito composto joga a seu favor em vez de contra você.
A história do financiamento e quem está apostando
O dinheiro mostra quem acredita nisso. A Série B foi liderada pela Andreessen Horowitz, com uma longa lista de participantes que inclui Menlo Ventures (que liderou a Série A), Arm, M12, Samsung Ventures, Tiger Global e XTX Markets. A Gimlet diz que acrescentou bilhões em receita contratada desde março e tem um pipeline de data centers medido em gigawatts.
A trajetória é íngreme: uma Série A de US$ 80 milhões em março de 2026, com avaliação de cerca de US$ 400 milhões, e depois um salto para US$ 3 bilhões seis meses depois. Num mercado em que todo laboratório persegue uma inferência de LLM mais barata, a tese de que a eficiência, e não só modelos maiores, é o próximo campo de batalha claramente ressoa entre os investidores.
As ressalvas honestas
Quero ser justo, porque uma avaliação de US$ 3 bi e uma promessa de 10x convidam exatamente o tipo de exagero que tento evitar.
Primeiro, os números de desempenho são da própria Gimlet. Quando a empresa publicou um texto sobre kernels Metal gerados por IA, um engenheiro do PyTorch no Hacker News fez uma objeção direta e razoável:
"I work on PyTorch and there are many things that make me suspicious about these results. My TL;DR is unless we get a zip file of all the kernels with how they're benchmarked results like this are almost impossible to verify."

Isso não é uma demolição, e a equipe da Gimlet respondeu no tópico. Mas é o enquadramento certo: ganhos de velocidade em benchmarks são uma afirmação a verificar na sua própria carga de trabalho, não um resultado consolidado. Segundo, a Gimlet não nomeou seus clientes publicamente, descrevendo-os apenas como "a major model maker" e "an extremely large cloud computing company". E terceiro, isto é infraestrutura para laboratórios e data centers. Se você está construindo um produto, provavelmente nunca vai tocar na Gimlet diretamente; só a sentirá como uma inferência mais rápida e barata por baixo das ferramentas que você realmente usa.
O que isso significa se você constrói com IA
Então, onde isso deixa você se não administra um laboratório de ponta?
A Gimlet é um bom lembrete do bolo em camadas. Há o silício na base, a camada de inferência que a Gimlet luta para dominar no meio, os modelos e, por cima, os funcionários de verdade que você contrata. A Gimlet é infraestrutura. Ela faz o motor funcionar melhor; não é ela quem faz o seu trabalho.
É exatamente assim que penso na eesel. A eesel é uma plataforma de colegas de equipe com IA: você contrata colegas prontos para trabalhar em tarefas específicas, e hoje o time é um colega de helpdesk com IA e um redator de blog com IA. O colega de helpdesk entra na sua fila de suporte atual, aprende com seus tickets anteriores e sua central de ajuda e resolve conversas dentro do Zendesk, Freshdesk ou Gorgias. O redator de blog faz o mesmo com conteúdo. Seja qual for a nuvem de inferência por baixo, o colega de equipe é quem leva o trabalho até o fim.

E como todo o mundo da Gimlet é agêntico e programável, vale dizer que a eesel também encontra esse leitor onde ele está. A CLI da eesel controla o mesmo colega de helpdesk a partir de um terminal: uma pessoa pode executá-la à mão, scripts podem automatizá-la, e agentes de programação como o Claude Code ou o Cursor podem operá-la pela CLI e pelo servidor MCP, de modo que simular um rollout com tickets históricos ou disparar uma execução vira um único comando em vez de um clique no painel. Se você prefere ver a eesel resolvendo tickets reais a ler mais uma ficha técnica, pode experimentar a eesel de graça e apontá-la para a sua própria central de ajuda em poucos minutos.
Se você está no começo da jornada e só compara opções, os guias sobre os melhores agentes de IA e a classificação de tickets com IA são um ponto de partida melhor do que uma nuvem de inferência de US$ 3 bi.
Conclusão
A Gimlet Labs é uma empresa interessante que resolve um problema real e pouco glamoroso: o hardware por baixo da IA combina mal com a forma como os agentes realmente rodam, e alguém precisava construir o software para consertar isso. A avaliação de US$ 3 bi é uma aposta de que a eficiência da inferência será a próxima grande disputa e, dado o ritmo de crescimento da IA agêntica, não é uma aposta absurda.
Só mantenha as promessas de velocidade com cautela até que sejam testadas de forma independente, e lembre-se de qual camada você está de fato comprando. A Gimlet deixa o motor mais rápido. O colega de equipe por cima continua sendo quem faz o trabalho.