

O Groq 3 LPX é o novo acelerador de inferência em escala de rack da NVIDIA para a plataforma Vera Rubin e entrou em produção total em 24 de agosto de 2026. Cada rack reúne 256 chips Groq 3 LPU que trabalham ao lado das GPUs Vera Rubin NVL72. As GPUs cuidam do trabalho de contexto, que consome muita memória; as LPUs cuidam da tarefa sensível à latência de gerar tokens rapidamente. O objetivo dessa divisão é fazer a IA agêntica parecer rápida sem abrir mão da vazão.
O nome é confuso de propósito. A NVIDIA licenciou a tecnologia LPU da Groq (não exclusiva) e contratou seu fundador e membros-chave da equipe, então este é um produto da NVIDIA construído sobre o design da Groq, usando o nome Groq sob licença. A empresa Groq continua independente, e a GroqCloud continua funcionando.
Sobre os números de destaque: a NVIDIA cita 3.400 tokens por segundo no Gemma 4 31B com 100K de contexto, além de uma projeção de 35x de vazão por megawatt e 10x de receita por watt em relação à geração anterior. São alegações do fabricante medidas contra as próprias bases de comparação da NVIDIA, então leia-as como uma meta, não como um resultado independente testado. Se você constrói agentes ou automatiza suporte, a conclusão prática é mais simples: você quase certamente não vai comprar este rack, vai consumir a velocidade que ele libera por meio de um modelo ou de uma nuvem, e o que você realmente implanta é um colega de equipe como a eesel rodando por cima.
O que o Groq 3 LPX realmente é
A NVIDIA descreve o Groq 3 LPX como "o acelerador de inferência de IA interativa para o NVIDIA Vera Rubin". Em termos mais simples: é um rack completo de chips especializados cuja única função é gerar tokens rápido, e ele se encaixa na plataforma de data center mais nova da NVIDIA ao lado das GPUs de uso geral.
A NVIDIA usa um dilema clássico de três vias. Por anos, o hardware de inferência entregava duas de três propriedades ao mesmo tempo: inteligência mais vazão, ou inteligência mais interatividade, mas nunca as três a baixo custo. Modelos grandes são lentos para conversar; modelos rápidos são pequenos. O Groq 3 LPX é apresentado como a peça que permite que um modelo grande continue responsivo, entregando a parte sensível à latência de cada token a um chip feito exatamente para isso.
Vale ser preciso sobre o que ele não é. Não é um produto independente que se encaixa em qualquer servidor, nem um substituto da GPU. É uma extensão co-projetada do Vera Rubin NVL72 que roda ao lado das GPUs Rubin, e as duas calculam juntas cada camada do modelo para cada token de saída. A NVIDIA chega a chamar a LPU de "o sétimo chip" da plataforma Vera Rubin.
Espera, é a startup Groq?
Esta é a reação mais comum que vi, e é justa. A Groq passou anos como a startup de inferência ousada cuja LPU era o contraexemplo de "é só usar mais GPUs". Agora "Groq 3 LPX" é uma linha de produtos da NVIDIA. Uma pessoa no X resumiu bem o clima:
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Aqui está a versão correta, direto das fontes primárias. A Groq firmou um acordo de licenciamento não exclusivo com a NVIDIA para sua tecnologia de inferência, a mesma por trás dos preços da GroqCloud e de sua linha de alternativas à Groq. Como parte do acordo, o fundador Jonathan Ross e outros membros da equipe da Groq se juntaram à NVIDIA para ajudar a escalar o design licenciado. A Groq permanece independente sob um novo CEO, Simon Edwards, e a GroqCloud continua operando. A própria página de imprensa da NVIDIA traz no rodapé a linha "Groq and LPU are used under license from Groq, Inc."
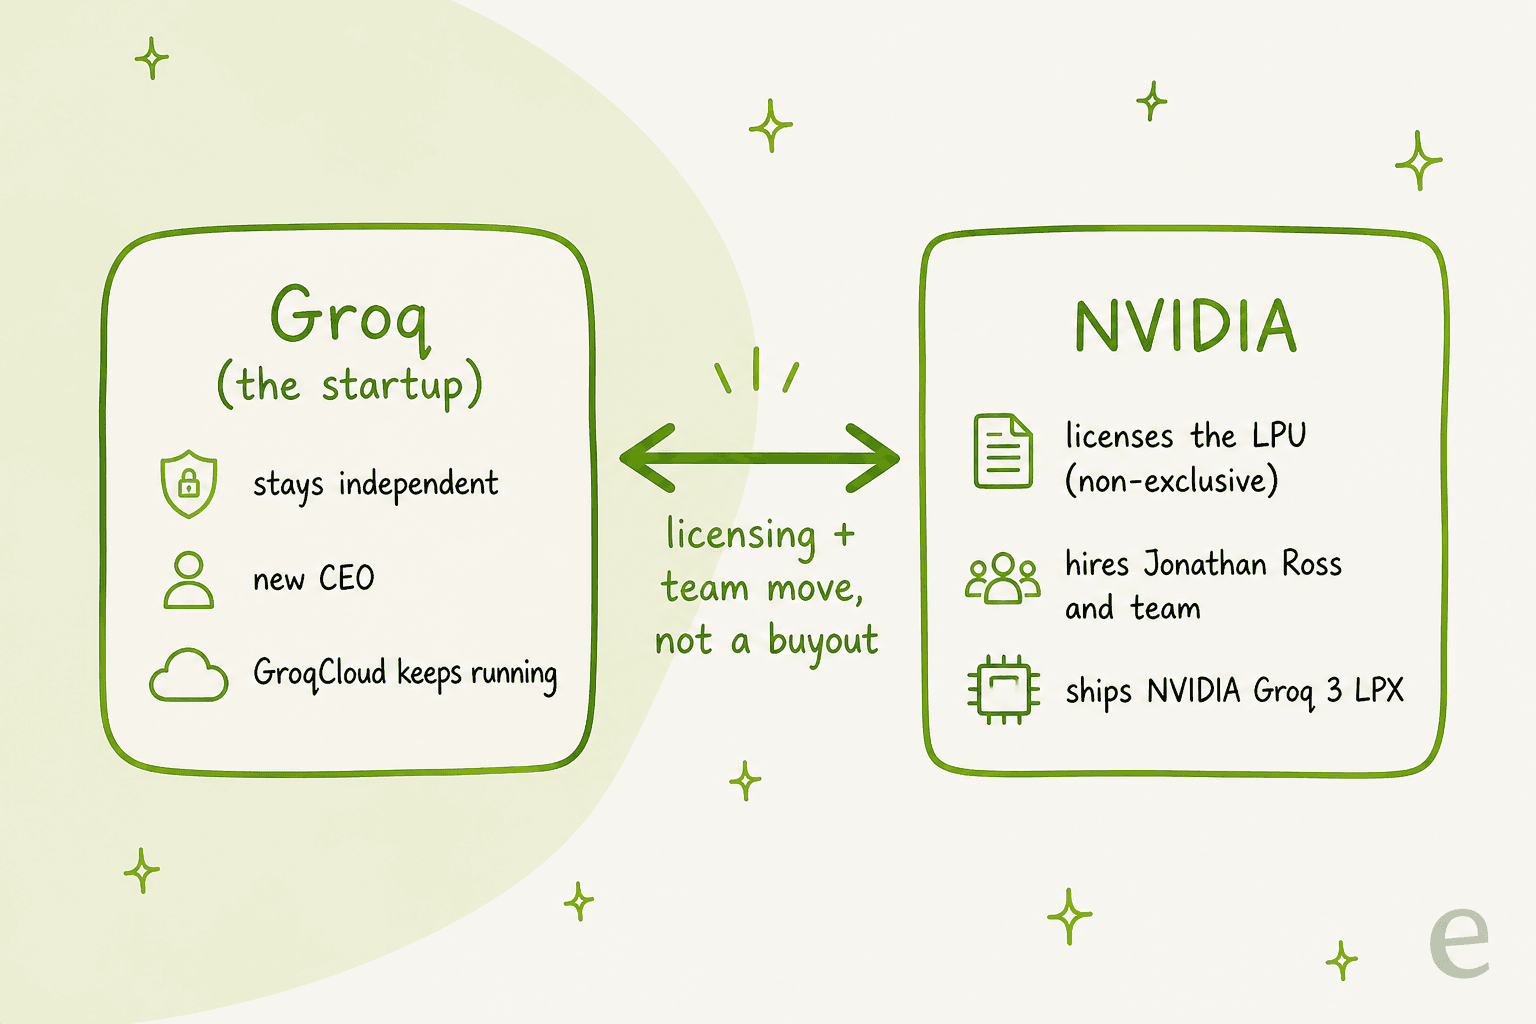
Então, quando você ler "NVIDIA Groq 3 LPX", pense em uma licença e uma contratação de equipe, não em uma aquisição limpa. Há cifras altas circulando na imprensa sobre o acordo, mas esses números não aparecem nas declarações de nenhuma das empresas, então os deixei de fora. O que o registro primário sustenta é a estrutura acima, e é isso que importa para entender o produto.
Tudo isso em um único rack
As especificações são a parte divertida, porque são realmente incomuns. Veja o que a NVIDIA lista para um único rack Groq 3 LPX.
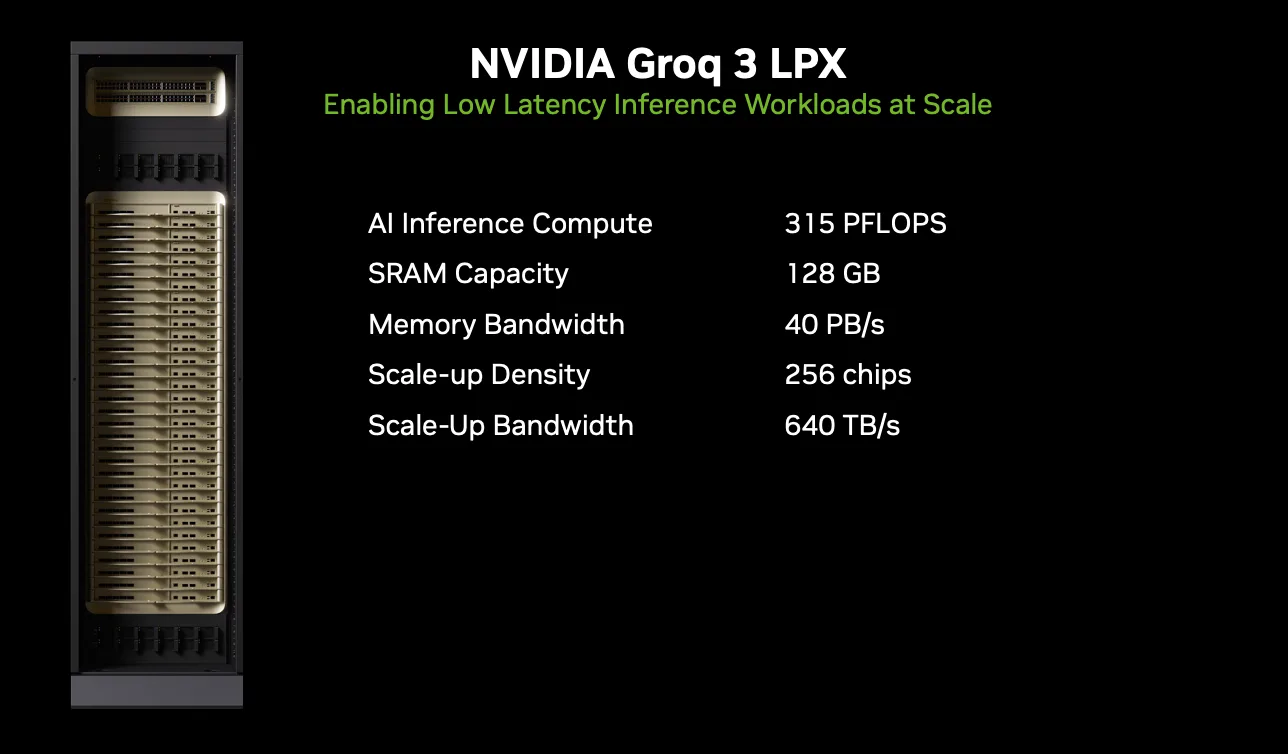
| Especificação em nível de rack | NVIDIA Groq 3 LPX |
|---|---|
| Chips por rack | 256 aceleradores Groq 3 LPU |
| Computação de inferência de IA | 315 PFLOPS (FP8) |
| Capacidade total de SRAM | 128 GB |
| Largura de banda da SRAM no chip | 40 PB/s |
| Largura de banda de scale-up | 640 TB/s |
| Construção | 32 bandejas de computação 1U com refrigeração líquida, 8 LPUs cada |
O número que chama a atenção é 40 petabytes por segundo de largura de banda de SRAM no chip. Não é erro de digitação, e é toda a tese do design em uma única cifra. Em vez de alimentar os chips com memória externa mais lenta, a LPU mantém os dados de trabalho no chip e os move a uma largura de banda que uma configuração de memória convencional não alcança. A contrapartida é a capacidade: 128 GB de SRAM em um rack é pouquíssimo perto dos terabytes de HBM de um rack de GPU, e é exatamente por isso que as LPUs precisam das GPUs ao lado.
Por que construir um chip totalmente novo?
Para entender por que a NVIDIA se deu a esse trabalho, ajuda colocar os dois chips lado a lado. O diagrama da própria NVIDIA faz isso com clareza.
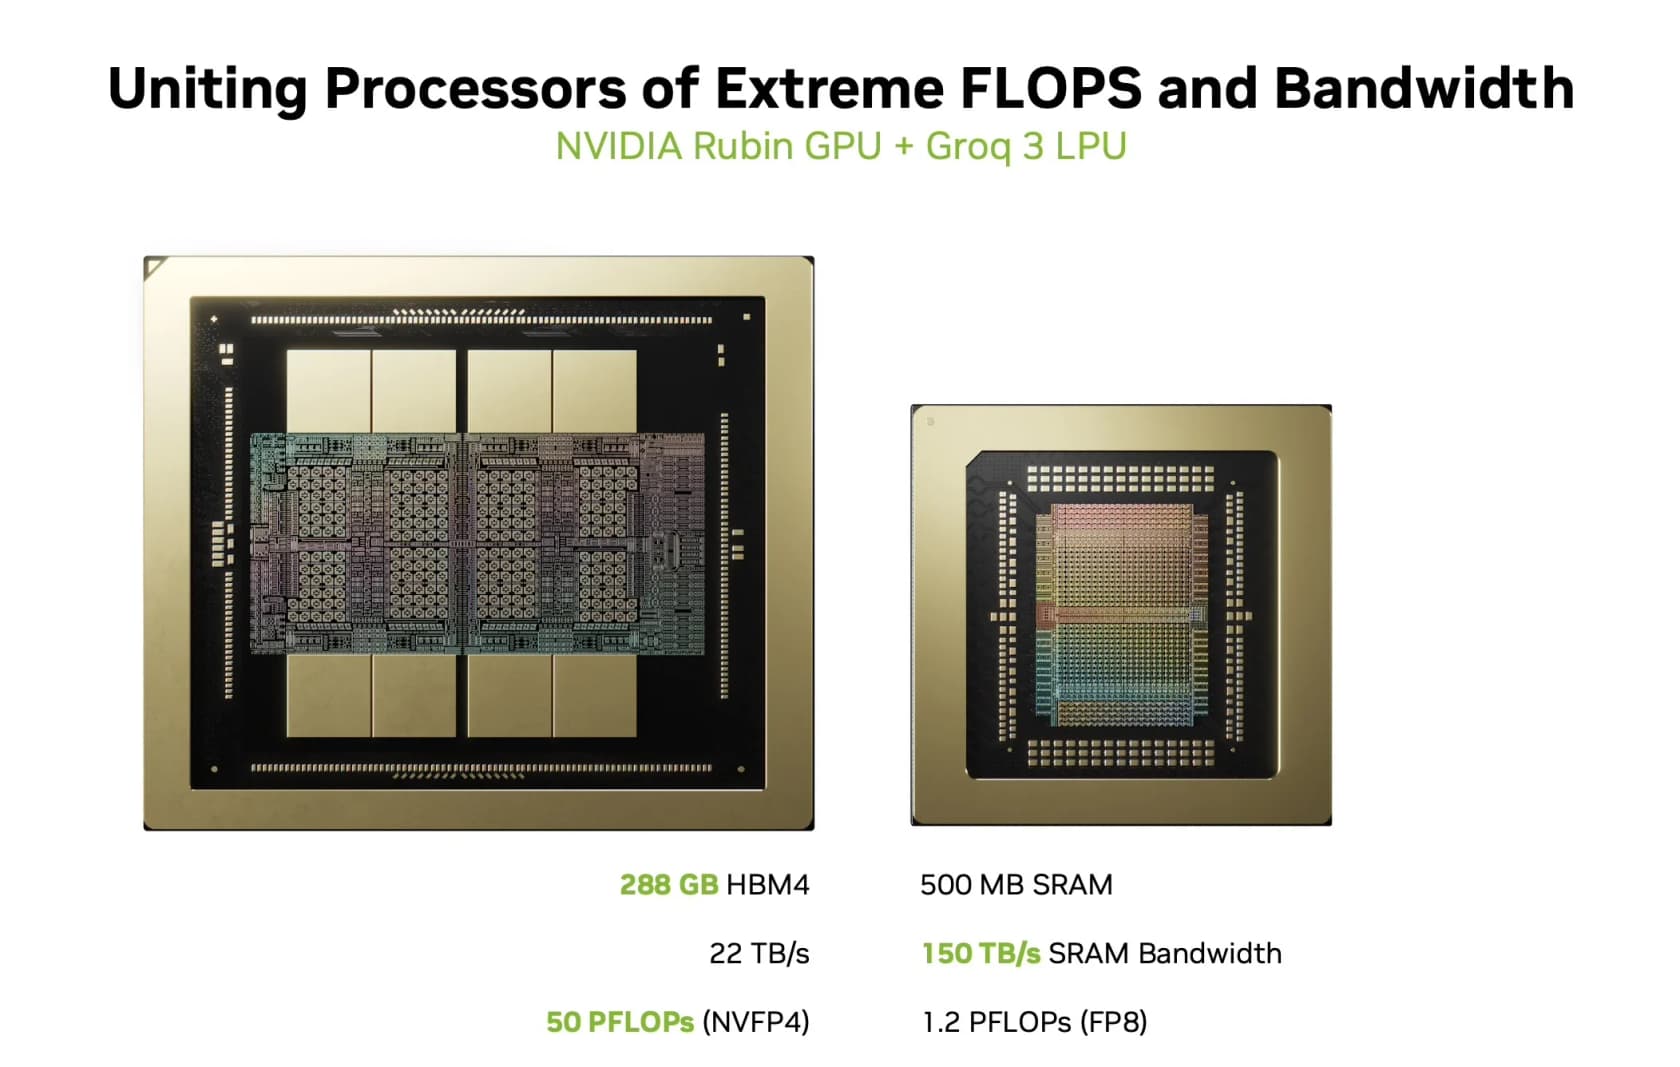
Uma GPU Rubin traz cerca de 288 GB de HBM4, aproximadamente 22 TB/s de largura de banda de memória e cerca de 50 PFLOPs de computação. Uma única Groq 3 LPU traz 500 MB de SRAM, mas a 150 TB/s de largura de banda, com 1,2 PFLOPs de computação FP8. A GPU é uma máquina de trabalho pesado, otimizada para vazão máxima e muita memória. A LPU é otimizada para uma coisa só: manter um fluxo de tokens correndo com latência baixa e previsível.
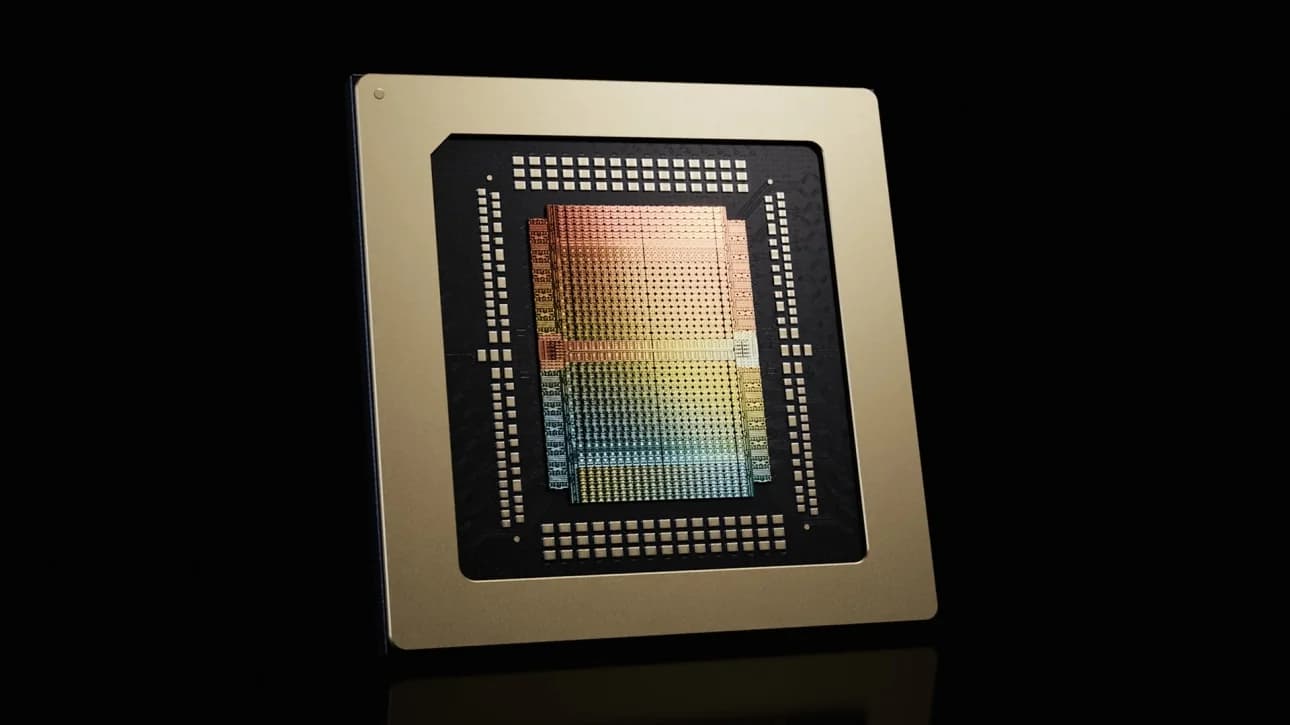
As escolhas de design por baixo dos panos são o que torna a LPU diferente de uma GPU, e acho-as realmente interessantes porque invertem coisas que programadores de GPU dão como certas:
- A SRAM é a memória principal, não um cache. Há 500 MB de SRAM no chip por LPU, e ela guarda diretamente os pesos ativos, as ativações e o estado KV. Não há HBM no chip.
- Sem caches gerenciados por hardware. O compilador e o runtime posicionam e movem os dados explicitamente, em vez de depender de heurísticas de cache. Isso reduz paradas imprevisíveis e mantém a latência estável.
- Execução determinística agendada pelo compilador. O chip se baseia no modelo de execução espacial da Groq, em que computação, movimentação de dados e sincronização são agendadas com antecedência. A NVIDIA descreve um protocolo de hardware que cancela a deriva de clock para que centenas de LPUs atuem como um sistema coordenado.
- Movimentação de dados explícita e centrada em tensores. Tudo opera em vetores fixos de 320 bytes por meio de unidades dedicadas de matriz, vetor e switch, de modo que o agendamento permanece previsível.
Se você já pensou em por que os custos de inferência de LLMs são tão sensíveis à latência, esta é a resposta em hardware: construir um chip cujo tempo é conhecido e depois ligar centenas deles sem perder essa propriedade.
Como funciona de fato: um ciclo de dois motores
É aqui que tudo se encaixa. A sacada da NVIDIA é que a inferência não é uma carga de trabalho uniforme. Uma requisição tem duas fases muito diferentes, e elas pedem hardware diferente.
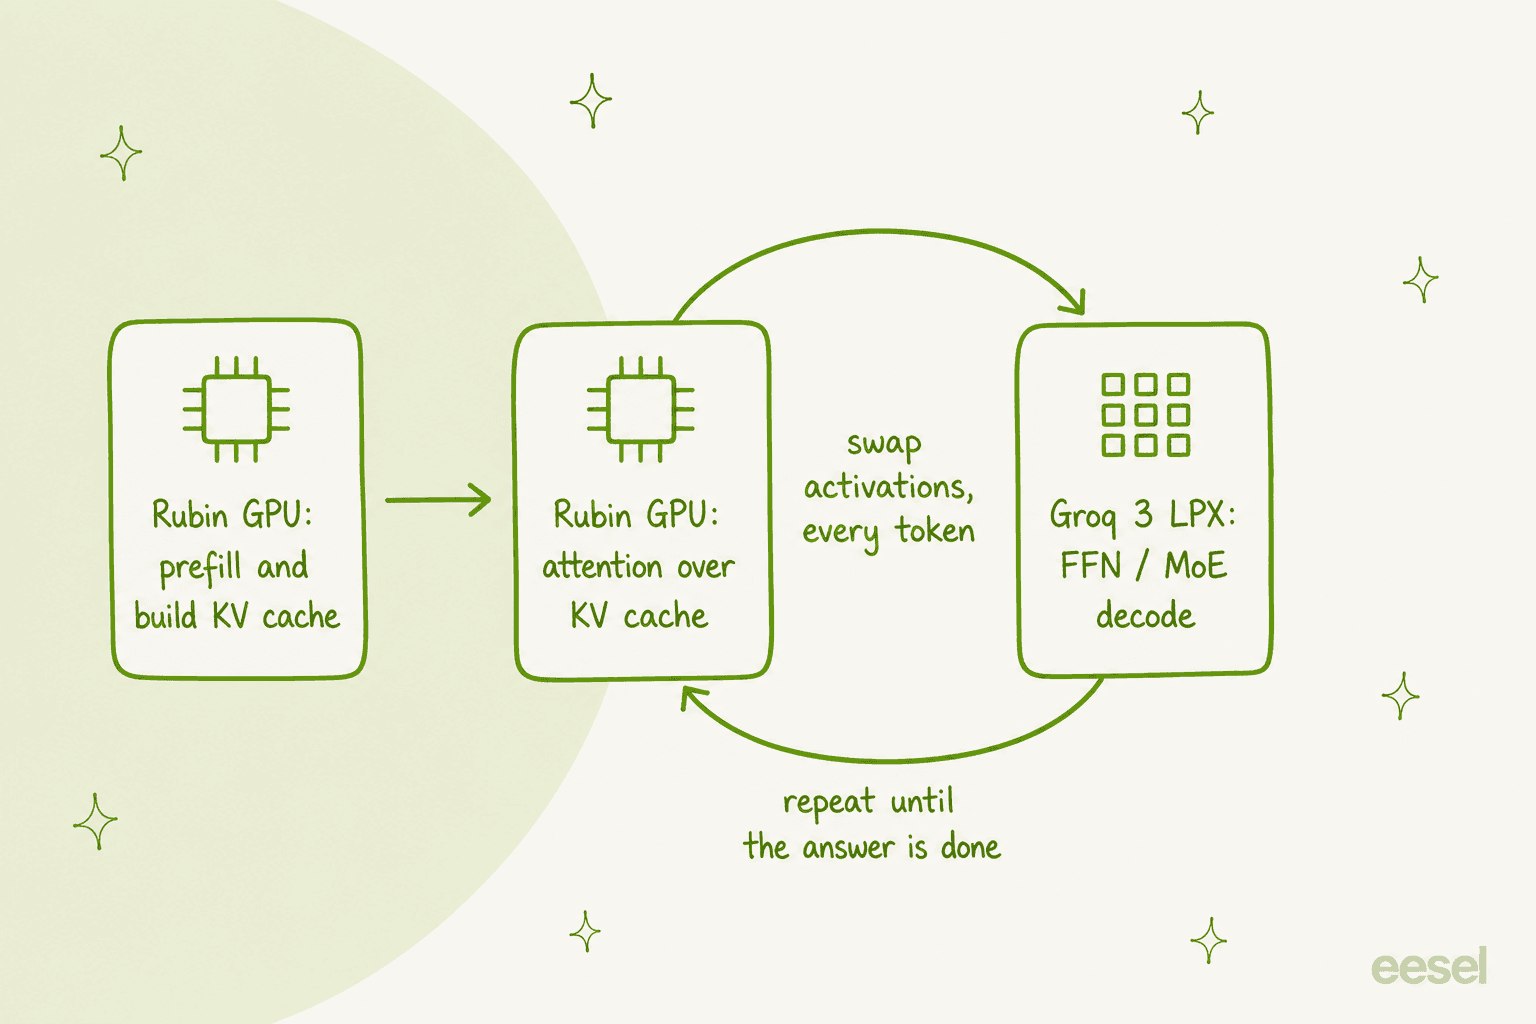
A primeira fase, o prefill, ingere seu prompt e constrói o cache KV. É um trabalho denso, paralelo e faminto por memória, e combina muito bem com a GPU. A segunda fase, o decode, gera a resposta um token por vez em um ciclo. A NVIDIA divide esse ciclo entre os dois chips, em uma técnica que chama de desagregação attention-FFN: as GPUs Rubin executam a atenção sobre o contexto acumulado, e o Groq 3 LPX cuida das contas de feed-forward e mixture-of-experts, que são as mais sensíveis à latência. Para cada token, os dois trocam ativações intermediárias.
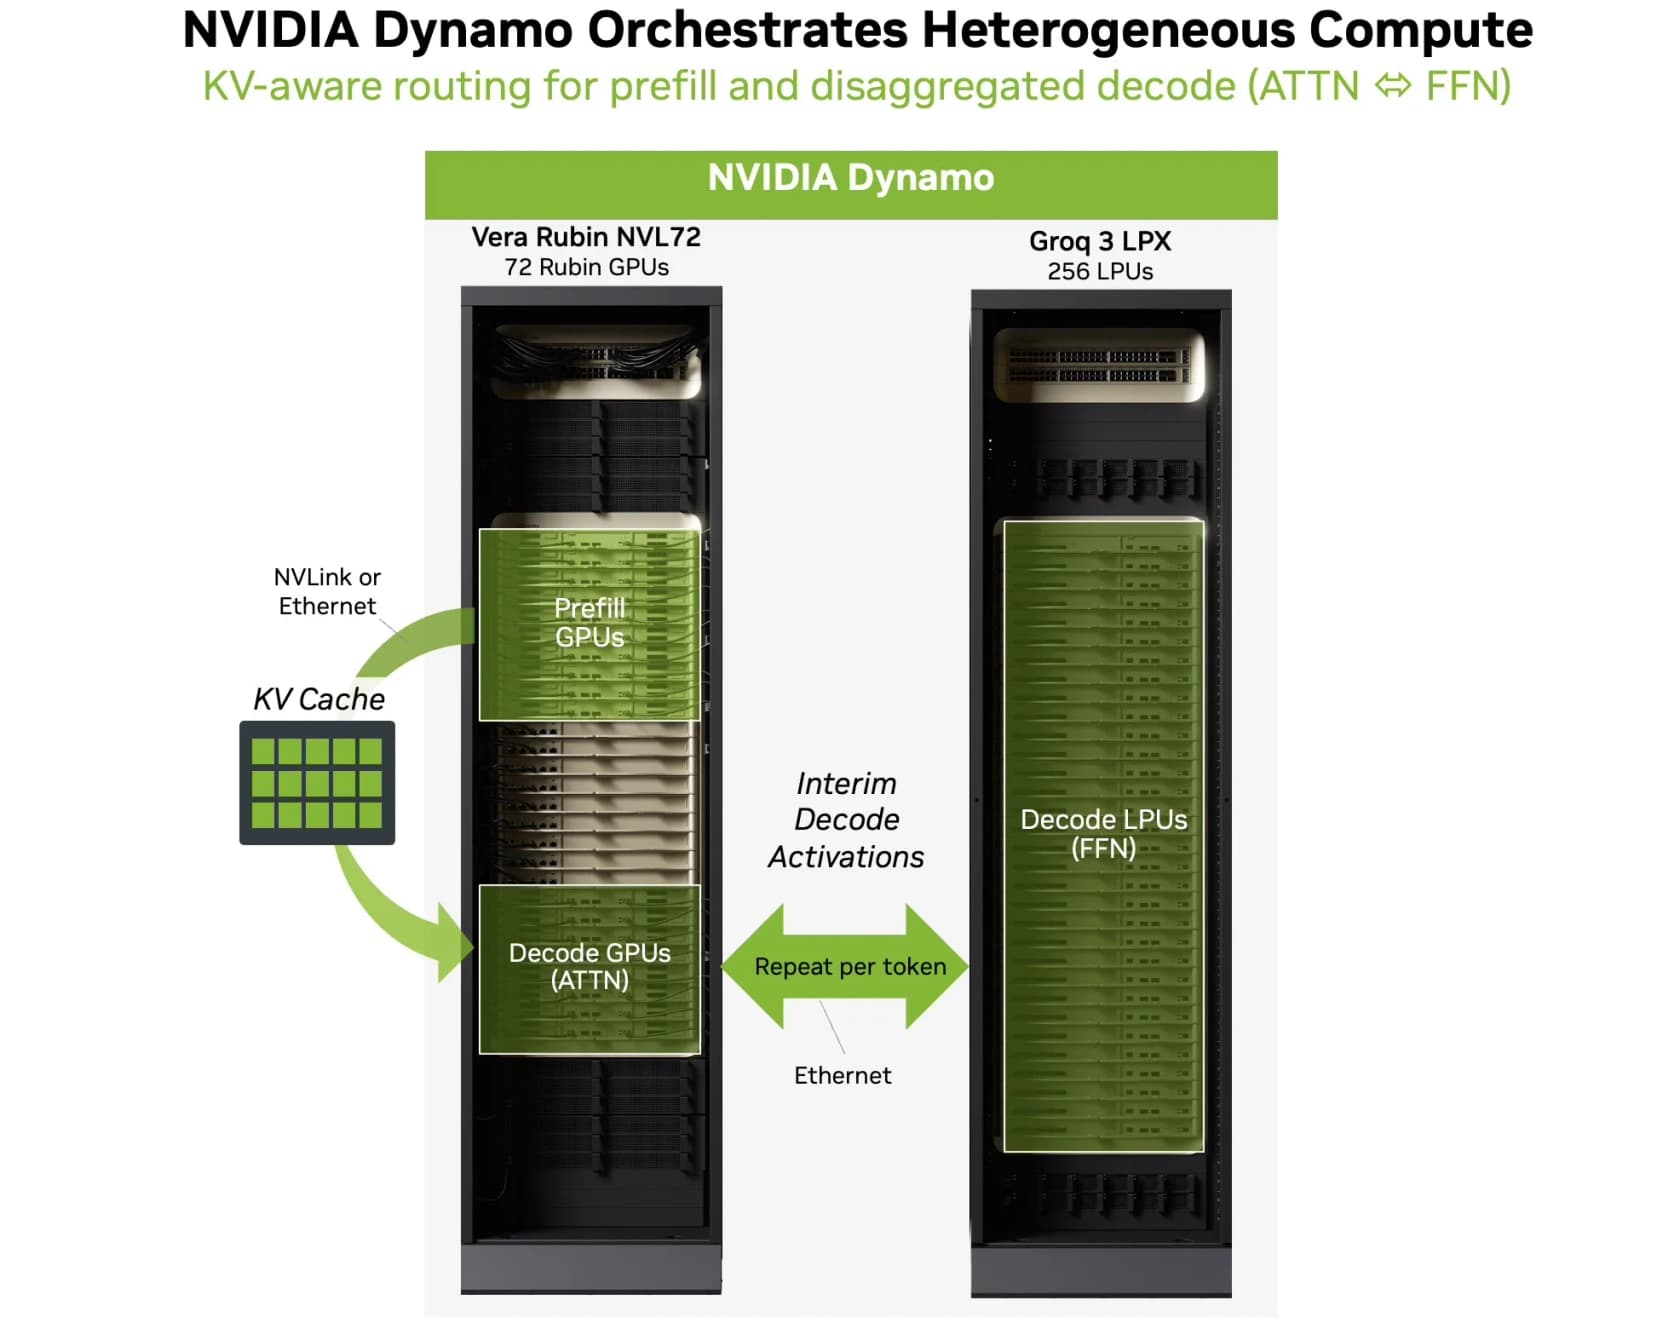
O guarda de trânsito de tudo isso é o NVIDIA Dynamo, a camada de orquestração que encaminha o prefill para workers de GPU, move as ativações por token entre os motores e agenda tudo conforme metas de latência para que uma sessão interativa não fique presa atrás de um job em lote.
O LPX desempenha mais um papel que vale conhecer: atua como motor de rascunho para a decodificação especulativa. Sua execução determinística e a enorme largura de banda de SRAM permitem que ele produza tokens de rascunho rapidamente, à frente da GPU, que os verifica. É mais uma forma de os dois chips dividirem o trabalho em vez de duplicá-lo.
Dentro do rack
Se você gosta de ver onde as peças ficam fisicamente, o diagrama da bandeja de computação da NVIDIA é a visão mais clara. Um rack tem 32 dessas bandejas 1U com refrigeração líquida, e cada bandeja abriga oito LPUs.
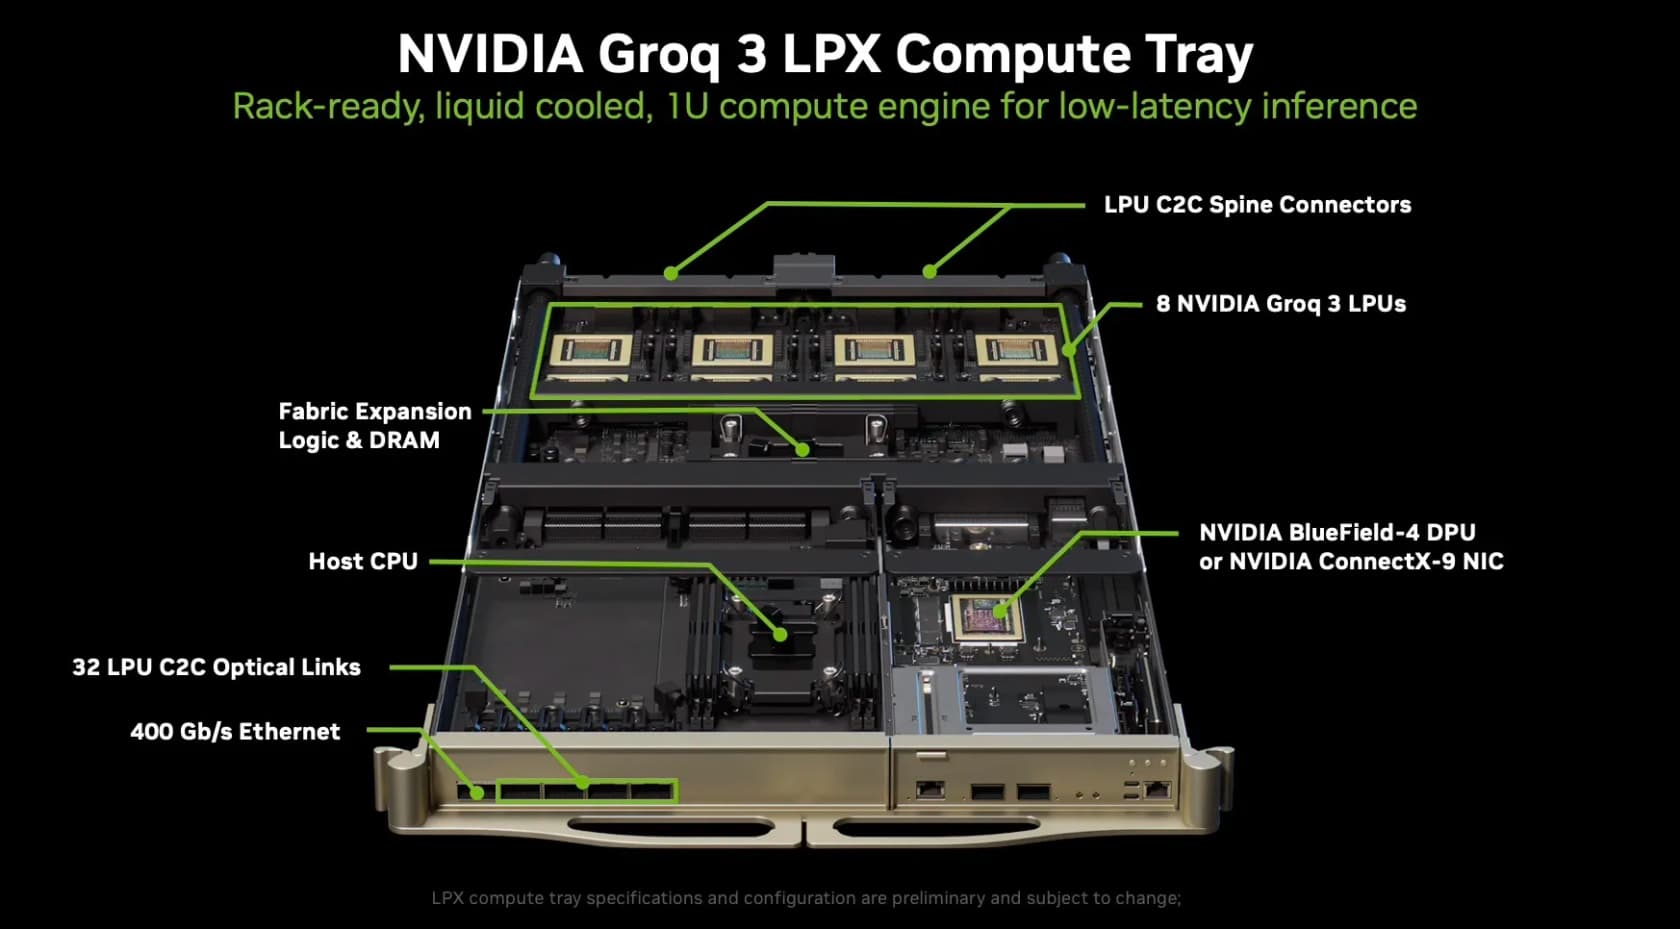
Algumas coisas se destacam nesse layout. Cada LPU se conecta por 96 links chip a chip a 112 Gbps, somando 2,5 TB/s de largura de banda de scale-up por chip, e é assim que 256 delas se comportam como uma única máquina. Cada bandeja também carrega uma DPU BlueField-4 e uma CPU host, e tudo é sem cabos e com refrigeração líquida. Ele usa a arquitetura de rack MGX da NVIDIA, de modo que um data center pode planejar um design de rack comum para toda a sua implantação Vera Rubin, em vez de uma configuração sob medida para o caminho de inferência.
As alegações de desempenho e como lê-las
Agora os números que todo mundo cita. A manchete da NVIDIA é até 35x mais vazão por megawatt para modelos de trilhões de parâmetros quando o Vera Rubin NVL72 é combinado com o LPX, em comparação com a geração anterior GB200, medido a 400 tokens por segundo por usuário. A empresa também projeta até 10x mais receita por watt para as cargas mais sensíveis à latência. A imagem mais clara é o próprio gráfico de Pareto da NVIDIA.
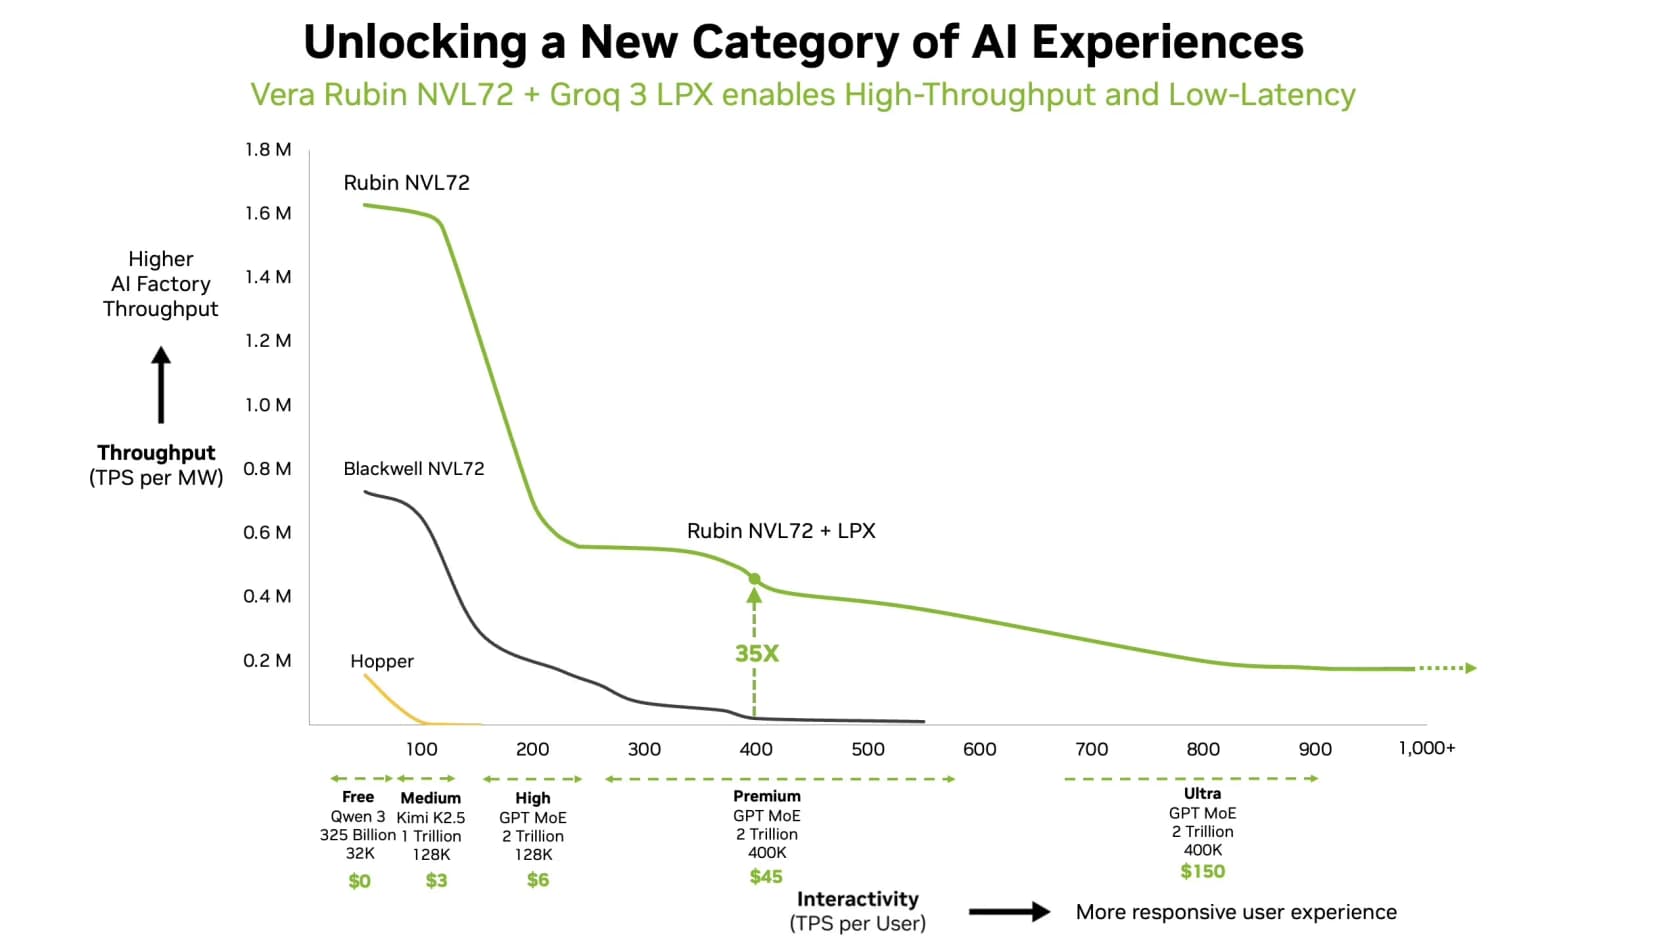
Lido com honestidade, o gráfico diz algo real: a distância entre a linha verde (Rubin mais LPX) e os sistemas mais antigos se abre dramaticamente no lado direito, onde cada usuário recebe tokens rápido. Com baixa interatividade todos parecem semelhantes; com alta interatividade, o caminho LPX se mantém alto enquanto as linhas só de GPU despencam. Essa é a alegação de fato, e é coerente.
A ressalva honesta é quem mediu. São números da NVIDIA contra as bases de comparação da própria NVIDIA, e o cenário "premium" modelado é um modelo específico de 2 trilhões de parâmetros com 400K de contexto. O único dado de sabor independente que encontrei é um benchmark da Artificial Analysis citado pela NVIDIA, de 3.400 tokens por segundo no Gemma 4 31B com 100K de contexto. É um número forte, mas quase toda a conversa pública até agora repete os slides da NVIDIA em vez de testar o hardware, porque a Nebius é apenas a primeira nuvem a implantá-lo. No Hacker News, uma das poucas opiniões substanciais o leu à luz do histórico da Groq, e não do marketing:
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Minha leitura: a arquitetura é genuinamente engenhosa, o benchmark é promissor, e o número de 35x é uma cifra de marketing do melhor cenário que você deve segurar com cautela até que terceiros a executem.
Por que agora: a inferência virou a parte cara
O motivo de um chip assim existir é que o formato das cargas de trabalho de IA mudou. Quando a maior parte da inferência era uma única resposta de chatbot, a latência de decode quase não importava. Os sistemas agênticos quebraram isso. Eles geram tokens ao longo de centenas ou milhares de etapas, e a NVIDIA cita dados mostrando que cargas agênticas consomem cerca de 15x mais tokens do que uma simples requisição de chat. Cada pequeno atraso por token agora se multiplica ao longo de uma cadeia longa.
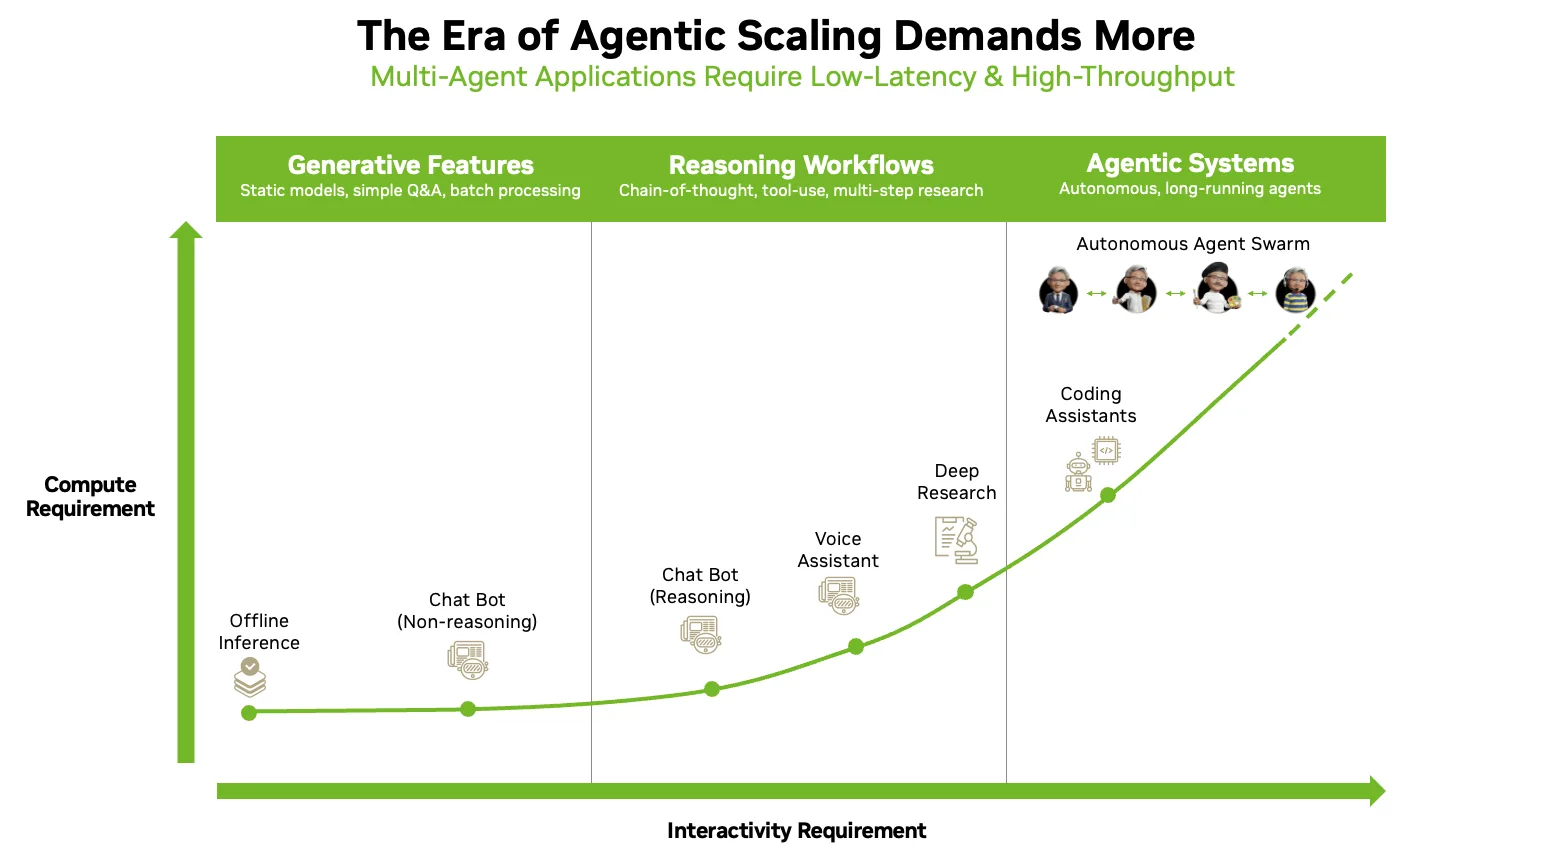
Dá para ver a mesma mudança em para onde vai o dinheiro do mercado. O negócio de data center da NVIDIA está surfando forte essa onda: a empresa reportou US$ 96,2 bilhões em receita no trimestre encerrado no fim de julho de 2026, alta de 106% em relação ao ano anterior. A inferência, não o treinamento, é agora o motor de crescimento, e um chip feito especificamente para geração de baixa latência e em várias etapas é uma aposta direta nisso. Uma análise no X resumiu bem o ângulo estratégico:
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
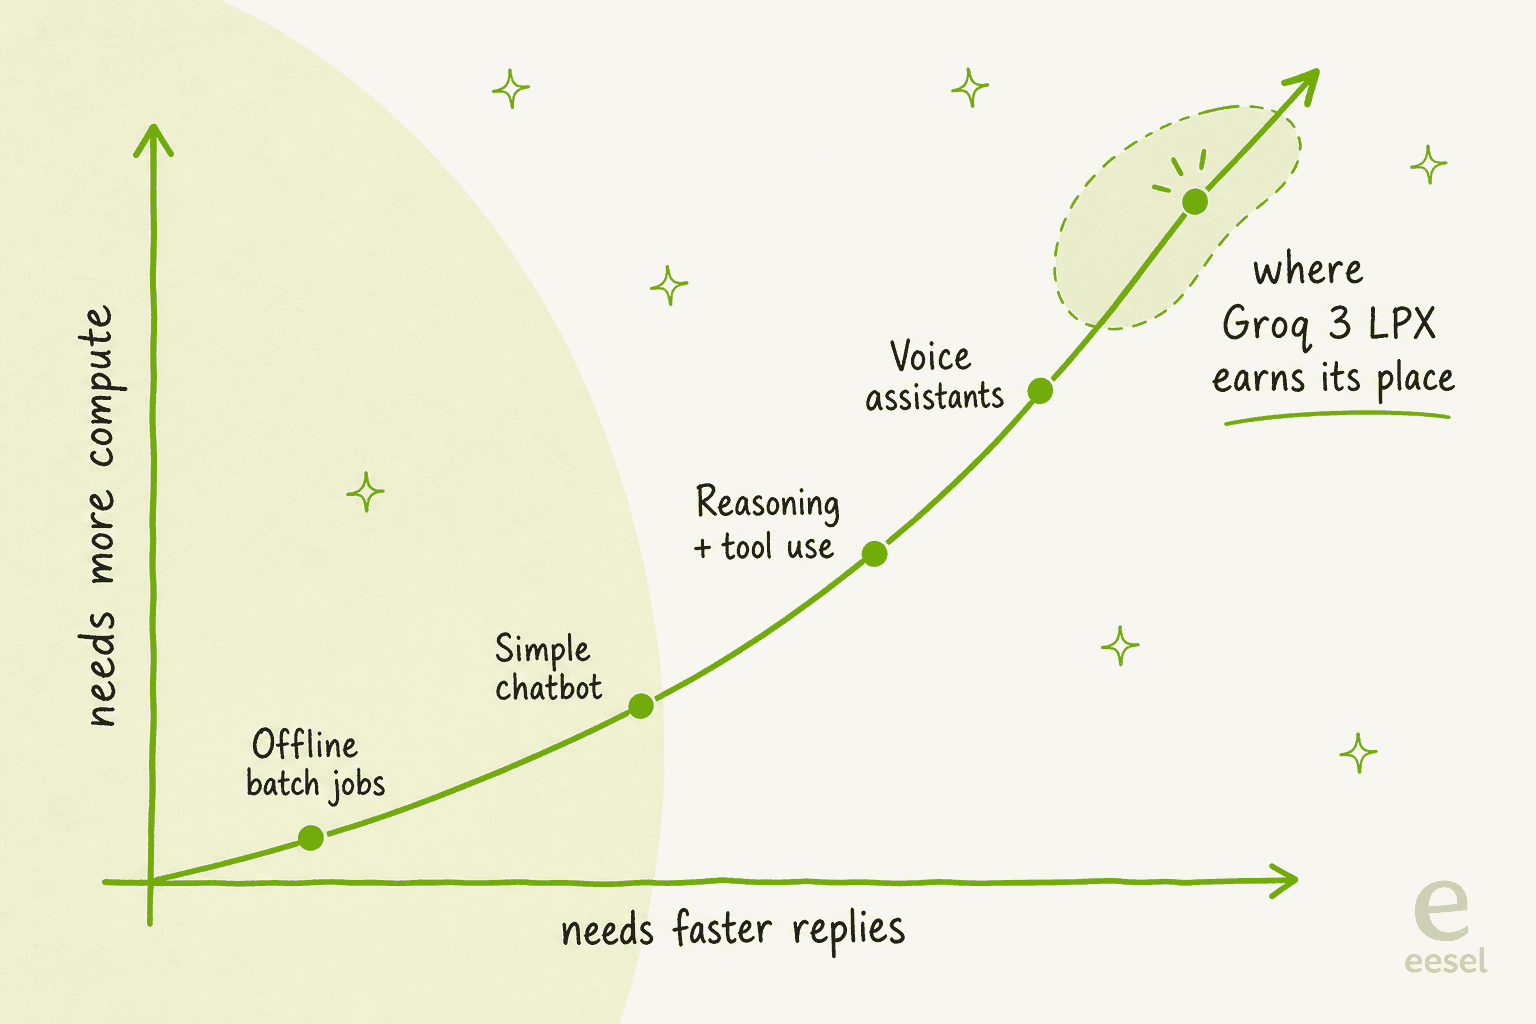
O modelo mental que ajuda: quanto mais sua carga de trabalho se inclina para "muitos turnos rápidos", mais importa um motor dedicado de baixa latência. Jobs em lote não se importam. Assistentes de programação, enxames de agentes e voz se importam muito.
O que isso significa se você constrói com IA
Aqui está a parte em que quero ser direto, porque é fácil se deixar levar pela ficha técnica. A menos que você opere uma nuvem ou uma plataforma de IA muito grande, você não vai comprar um rack Groq 3 LPX. É infraestrutura que fica várias camadas abaixo de onde a maioria das equipes trabalha. Você vai senti-la como tokens mais rápidos e baratos aparecendo nas APIs de modelos e nas nuvens que já usa, do mesmo jeito que você nunca comprou uma GPU para usar um agente de IA.
E esse é o reenquadramento útil. O chip é o motor; o que você realmente implanta é o trabalhador que anda por cima. Inferência mais rápida torna os agentes mais ágeis e baratos de executar, reduz a barreira para colocar automação de verdade em produção e muda a conta de custos em relação a um atendente humano, seja um agente de programação, um agente de pesquisa ou um agente de helpdesk com IA trabalhando sua fila de suporte. A corrida do hardware é para tornar essa camada viável em escala. O valor continua na camada.
Onde a eesel se encaixa
Chips como o Groq 3 LPX são a tubulação. A eesel é quem você contrata para fazer o trabalho por cima. A eesel é uma plataforma de colegas de equipe de IA: você não provisiona inferência nem monta um pipeline, você traz um colega pronto para trabalhar em uma função específica e o conecta aos seus apps. O elenco atual inclui um colega de helpdesk com IA que entra na sua fila de suporte e é mais do que um simples chatbot de suporte, e um redator de blog com IA que produz conteúdo como este texto.

A diferença concreta está em onde caem os tokens rápidos. Um colega de suporte que responde em um segundo em vez de oito é toda a experiência para quem está esperando, e os anos que passamos rodando IA em filas de suporte reais nos ensinaram a metade nada glamorosa: velocidade só ajuda se a resposta estiver certa, e por isso a eesel simula um rollout contra seus tickets antigos antes de responder a um cliente real. Todo o silício do mundo não conserta uma resposta errada dita com confiança. Se você quer ver o colega de equipe em vez do rack, pode experimentar a eesel de graça.