

O MiniCPM5-2B é o novo modelo aberto de 2B da OpenBMB, e é realmente impressionante para o tamanho. É um modelo denso, somente texto, de 2,52B de parâmetros, com janela de contexto de 128K e pesos Apache-2.0, feito para rodar no dispositivo: celulares, notebooks e mini-PCs, não em um data center. Na suíte própria da OpenBMB, ele tem média de 53,9 em 34 benchmarks, o que eles chamam de estado da arte open source da classe 2B e, no conjunto de comparação deles, à frente do Qwen3.5-4B, maior (51,1).
O porém que vale saber de antemão: ele é somente texto (sem visão), as pontuações chamativas são informadas pelo fabricante, e um número de destaque é inconsistente entre as fontes. Rastreadores independentes colocam o Artificial Analysis Intelligence Index dele em 15, o mais alto entre os modelos de pesos abertos de 4B ou menos; o post de lançamento da própria OpenBMB afirma 23. Os dois são citados abaixo.
Se você constrói coisas, o MiniCPM5-2B é um ótimo motor local de raciocínio e uso de ferramentas. Se você quer responder tickets de clientes, lembre-se de que o modelo é só o motor. Um agente de suporte que funcione precisa, por cima, do conhecimento da sua empresa, de integrações, barreiras de segurança e testes, que é a camada que uma plataforma como a eesel oferece.
O que o MiniCPM5-2B realmente é
O MiniCPM5-2B é o segundo modelo da linha MiniCPM5 da OpenBMB (o grupo de modelos abertos também conhecido como ModelBest), lançado por volta de 6 e 7 de setembro de 2026, depois do MiniCPM5-1B em maio. A proposta é estreita e clara: um modelo denso e pequeno, bom o bastante em raciocínio, programação e uso de ferramentas para ser útil, e pequeno o bastante para rodar onde os dados já estão.
Essa parte do "onde os dados estão" é a interessante. A maioria dos modelos sobre os quais você lê este ano são APIs na nuvem que você aluga por token. O MiniCPM5-2B vai no sentido oposto: você baixa os pesos e os roda em um notebook, um celular ou uma placa Rockchip no chão de fábrica. O cartão do modelo no HuggingFace o descreve como um modelo denso de 2B "built for on-device, local deployment, and resource-constrained scenarios", voltado a "local assistants, coding agents, tool-use workflows, and reasoning scenarios where a compact model is preferred."
Esta é a página do próprio modelo, onde você realmente começaria se quisesse baixá-lo.
Uma limitação honesta para calibrar expectativas: este é um modelo somente texto. Não há visão nem áudio neste checkpoint, e testadores da comunidade observam que ele lida apenas com inglês e chinês. Se você precisa de multimodal, a OpenBMB mantém isso na linha separada MiniCPM-V, e a reação "sem visão aqui" foi uma das mais altas no lançamento (mais sobre isso abaixo).
As especificações que importam
Para um modelo de 2B, as surpresas estão na ficha técnica. Ele usa uma arquitetura LlamaForCausalLM simples, tem 128K de contexto completo e vem sob uma licença realmente permissiva.
| Campo | Valor |
|---|---|
| Parâmetros totais | 2.516.756.480 (~2,52B) |
| Parâmetros sem embeddings | 1.981.982.720 |
| Arquitetura | LlamaForCausalLM padrão (sem kernels personalizados) |
| Camadas | 42 |
| Atenção | GQA, 16 cabeças de consulta, 2 cabeças KV |
| Tamanho do contexto | 131.072 tokens (128K) |
| Modalidade | Somente texto (inglês / chinês) |
| Licença | Apache-2.0 (pesos e repositório) |
| Tipo de tensor | BF16 (mais versões GGUF, MLX-4bit, GPTQ-4bit) |
Todos os números ali vêm do bloco "Model Information" do cartão do modelo. Dois deles pesam mais que o resto.
O primeiro é a arquitetura padrão. A OpenBMB fez questão de construir o MiniCPM5-2B sobre um LlamaForCausalLM simples para que, nas palavras deles, "mainstream inference engines can load it directly: no custom kernels, no model-code fork." Parece nota de rodapé, mas é o motivo de o suporte de runtimes desde o dia 0 (abaixo) ser tão amplo. Um modelo que precisa de um kernel sob medida sai para dois runtimes no dia do lançamento; um modelo de arquitetura padrão aparece em todos ao mesmo tempo.
O segundo é a licença Apache-2.0 no repositório e nos pesos. O uso comercial é permitido, e não há uma licença comunitária separada restringindo-o, algo que nem todo lançamento "aberto" pode dizer. Se você está construindo um produto em cima dele, isso importa mais do que um ou dois pontos de benchmark.
Ele também tem um modo de raciocínio profundo de verdade: o exemplo do transformers passa enable_thinking=True, e a OpenBMB enquadra o orçamento de tokens de uma tarefa em cerca de 21K tokens (14K de raciocínio mais 7K de resposta), com amostragem recomendada de temperature=1.0, top_p=0.95.
Como ele pontua
Esta é a manchete que fez o MiniCPM5-2B ser notado: na avaliação da OpenBMB, ele tem média de 53,9 em 34 benchmarks, que eles apresentam como estado da arte open source da classe 2B e, no conjunto de comparação deles, à frente do melhor modelo da classe 4B, o Qwen3.5-4B com 51,1. Um modelo de 2B superando um de 4B é o tipo de afirmação que merece uma segunda olhada.
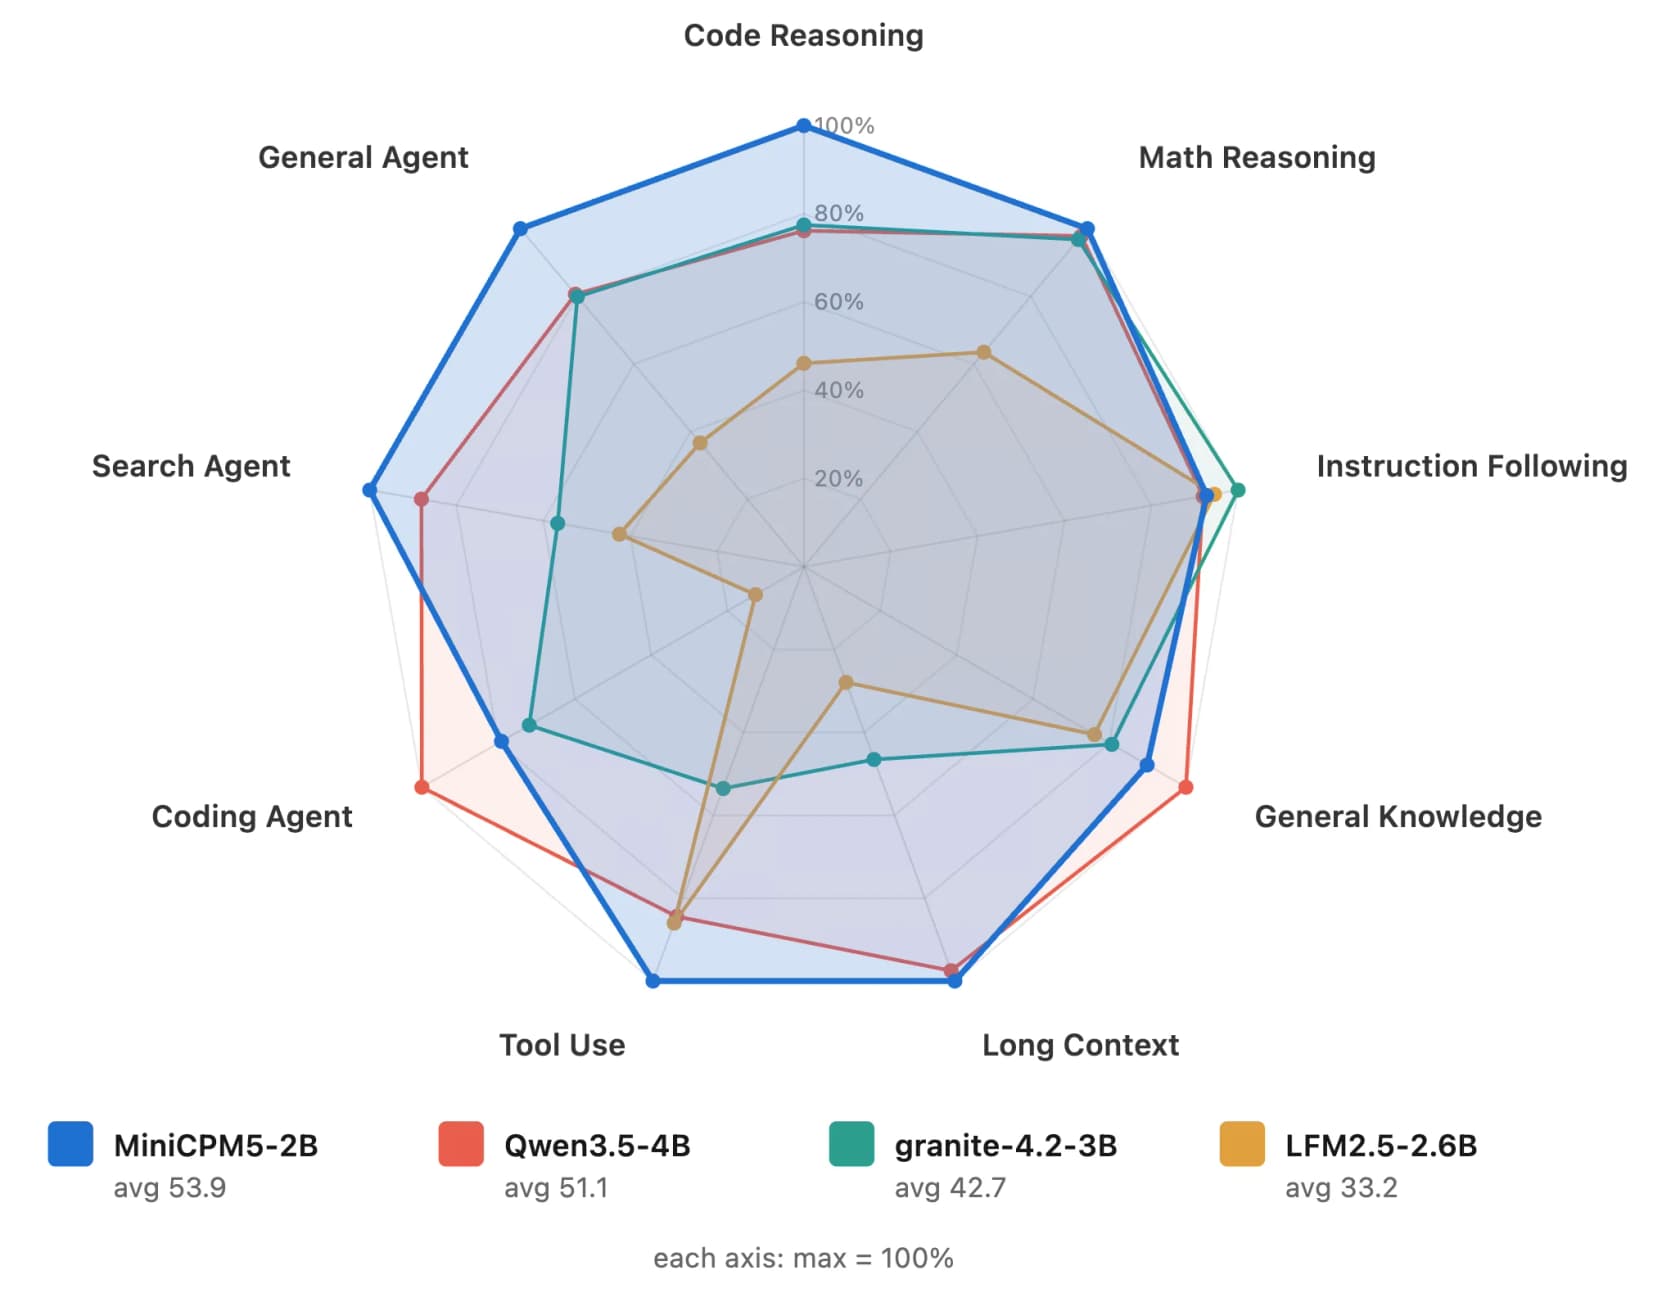
O radar mostra onde a história de tamanho versus pontuação se sustenta e onde não. O MiniCPM5-2B lidera em tarefas de agentes e busca e continua competitivo em matemática e contexto longo, enquanto o modelo de 4B da Qwen ainda ganha em trabalho puro de agente de programação. É um perfil irregular, não uma vantagem uniforme, que é a forma honesta de ler.
Vale olhar a tabela completa com calma, porque a "média de 53,9" esconde alguns números individuais realmente grandes:
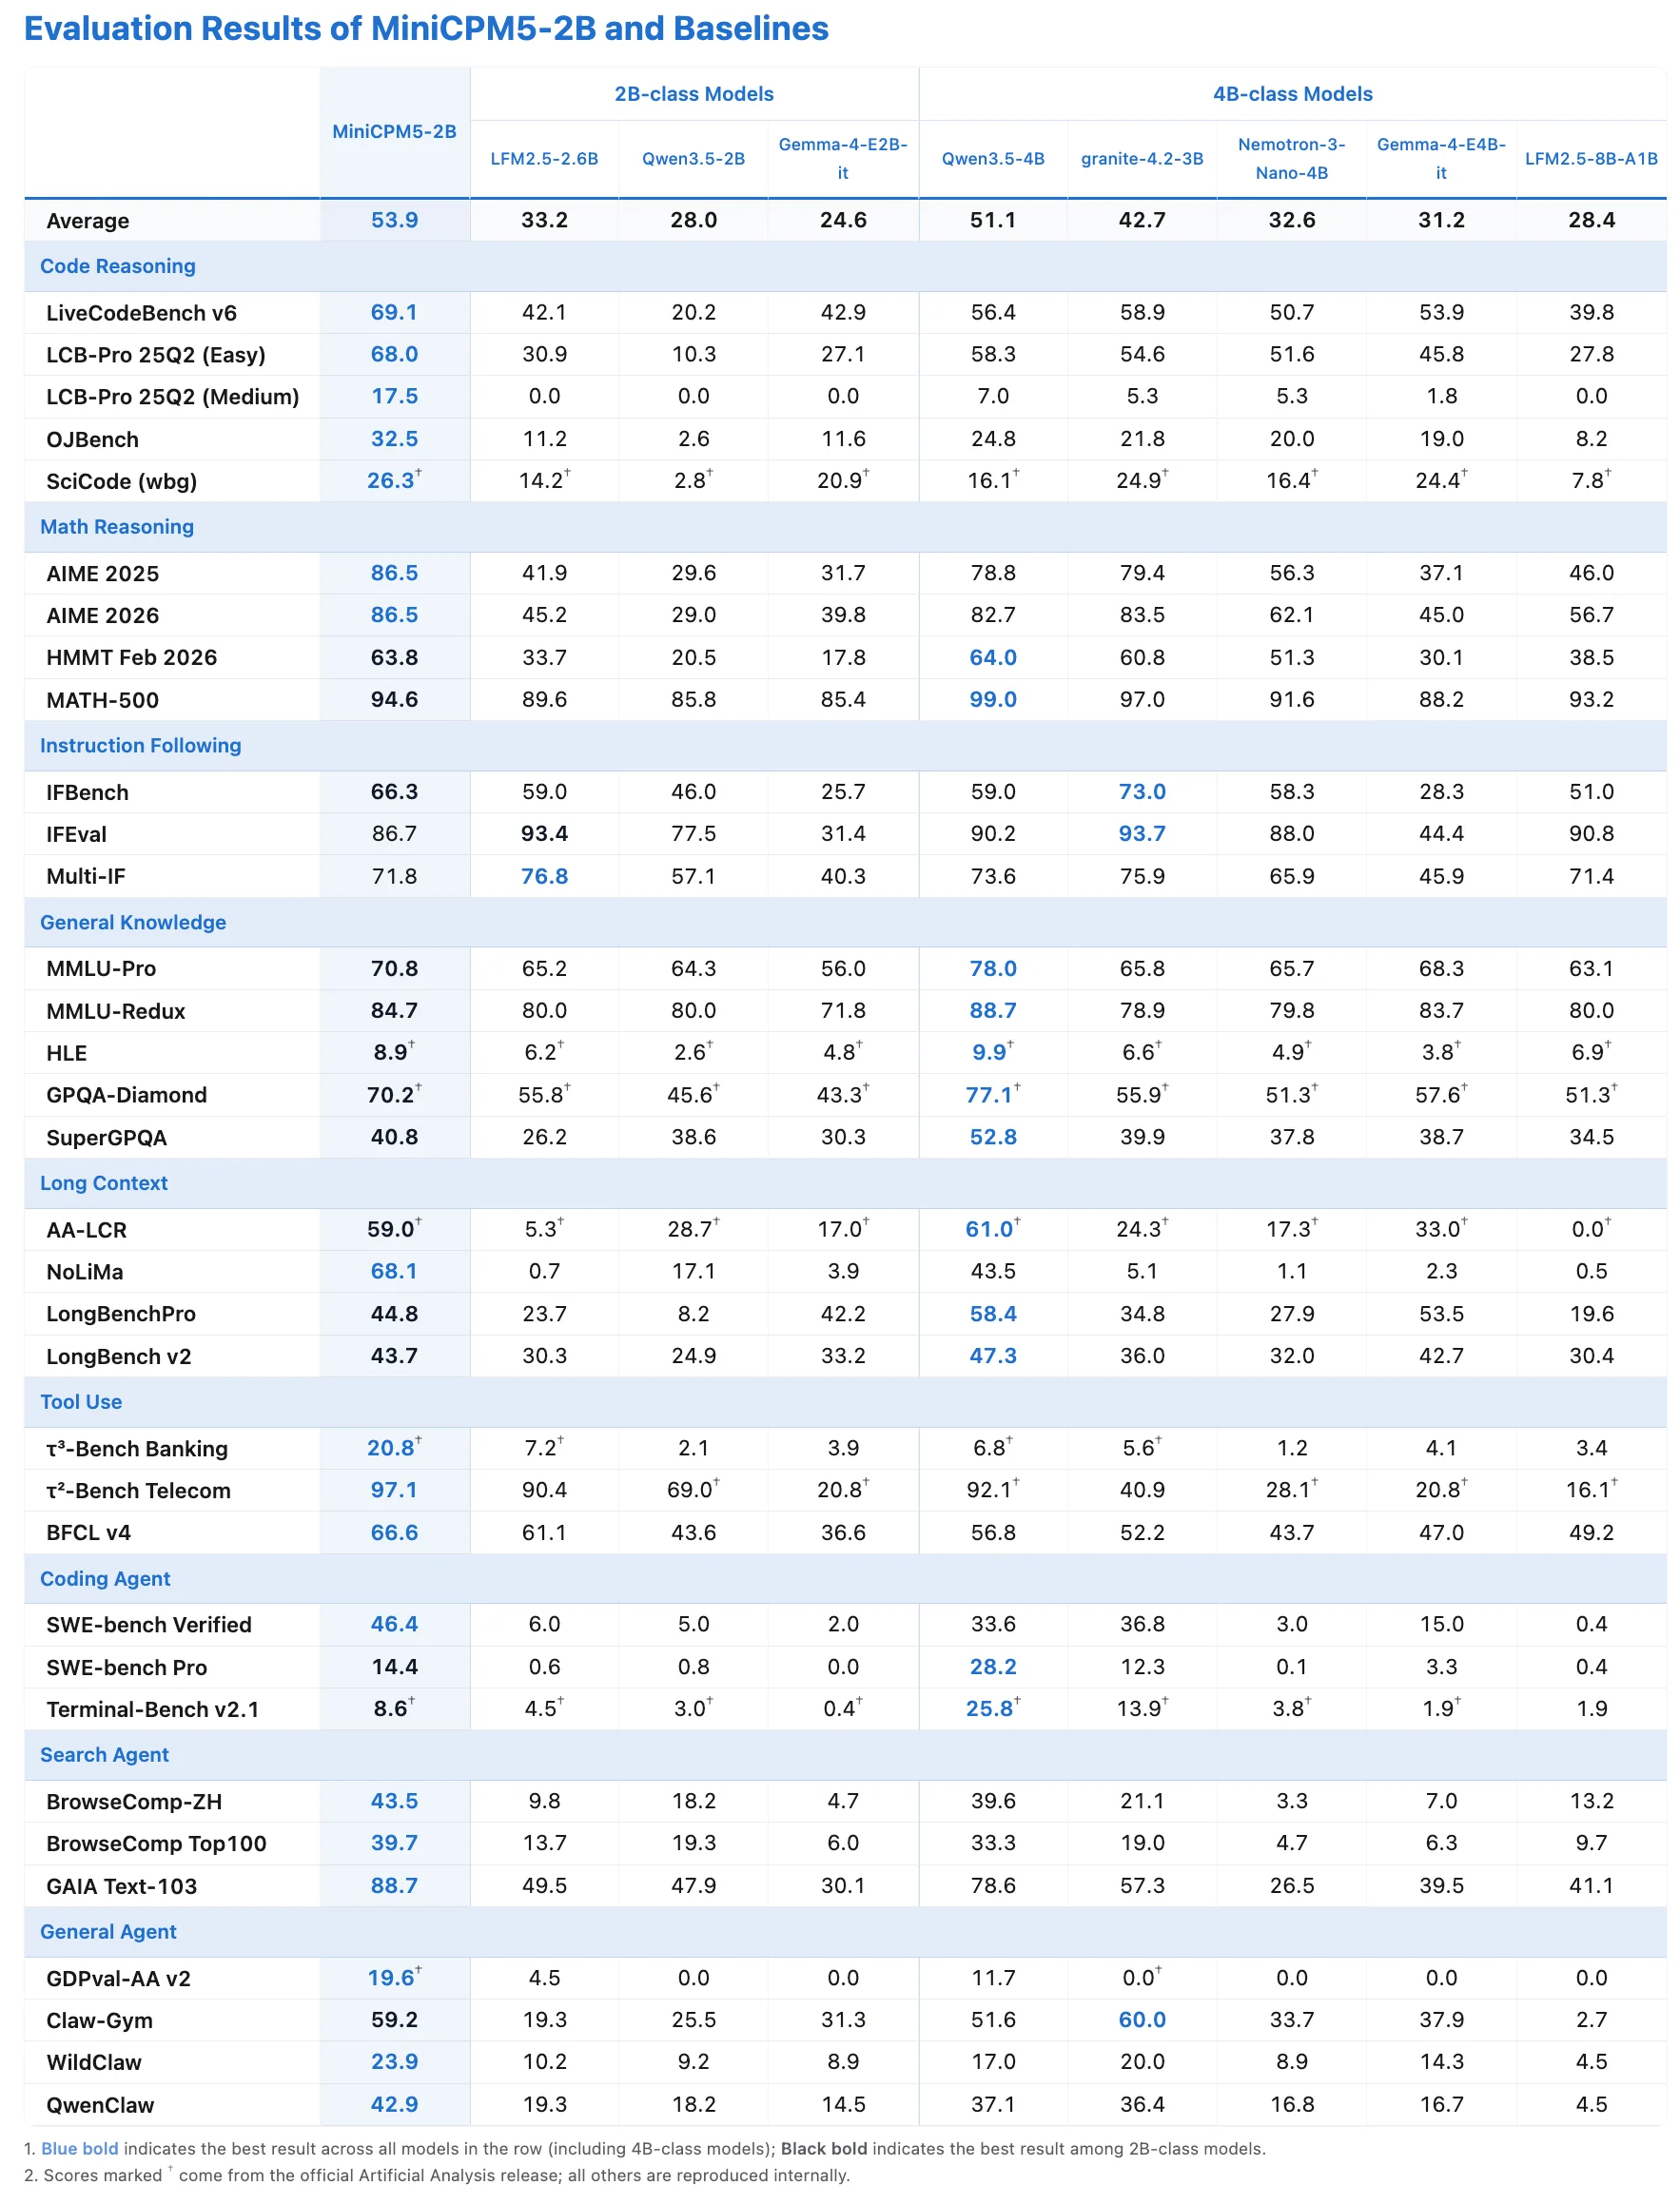
Os destaques, todos dessa tabela: MATH-500 com 94,6, AIME 2026 com 86,5, LiveCodeBench v6 com 69,1, SWE-bench Verified com 46,4, τ²-Bench Telecom com 97,1 e GAIA Text-103 com 88,7. Em conhecimento geral, marca MMLU-Pro 70,8. Para um modelo que roda em um notebook, esses números de programação e uso de ferramentas são os que fazem os desenvolvedores prestarem atenção.
Duas ressalvas mantêm isso honesto. Primeiro, são os números informados pela própria OpenBMB (algumas linhas foram reproduzidas internamente, outras vieram do lançamento oficial da Artificial Analysis), então trate-os como um bom ponto de partida e teste com as suas próprias tarefas, em vez de um veredito independente. Segundo, um número de destaque se contradiz entre as fontes: o tópico de lançamento no r/LocalLLaMA e o dataconomy informam ambos um Artificial Analysis Intelligence Index de 15, "the highest of any open weights model at 4B parameters or below", enquanto o post de lançamento da própria OpenBMB afirma uma pontuação de 23 mais um 20 no Agentic Index. Não consigo conciliar os dois, então ambos ficam registrados aqui. E note o que falta: a OpenBMB não publica MMLU clássico, GSM8K nem HumanEval para este modelo, então, se você esperava alinhá-lo a rankings mais antigos, esses números não existem nas fontes oficiais.
Como a OpenBMB o treinou
A outra razão para o MiniCPM5-2B ser interessante é que a OpenBMB abriu a maior parte da receita, não só os pesos. Se você quer saber como um modelo pequeno fica tão capaz, o pipeline é a resposta.
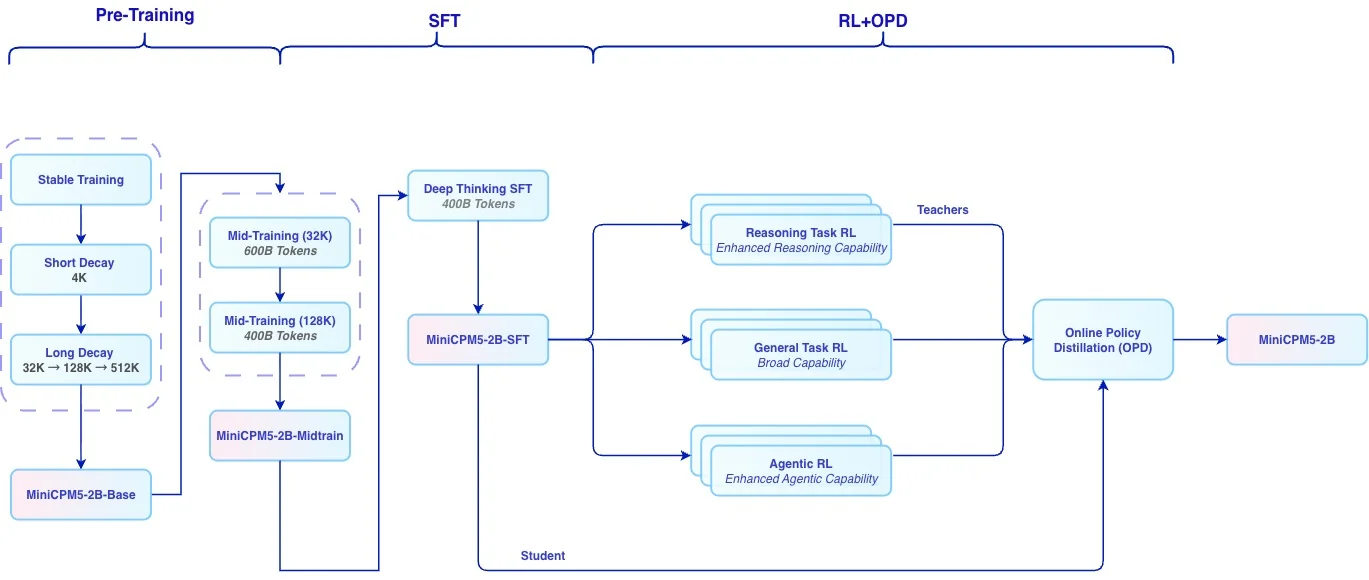
Ele segue em três etapas, descritas no cartão do modelo. O treinamento base usa o Ultra-FineWeb da OpenBMB e conjuntos de dados UltraData relacionados. O treinamento intermediário adapta o modelo às capacidades-alvo. Depois, o pós-treinamento faz o trabalho pesado: 400B de tokens de SFT de raciocínio profundo, aprendizado por reforço com professores especializados em tarefas de matemática, código, agentes e escrita (usando o algoritmo baseado em crítico JustRL II) e, por fim, On-Policy Distillation, que funde 16 modelos especialistas no único checkpoint lançado.
A OpenBMB informa que apenas a etapa de RL mais OPD acrescentou 10,96 pontos em benchmarks de raciocínio e gerais e 6,96 pontos em tarefas de agentes. Reproduzindo ou não esses ganhos, publicar os conjuntos de dados e o framework de RL é o tipo de movimento que chama a atenção da comunidade de modelos abertos, porque é repetível em vez de uma caixa-preta.
Rodando na borda
A razão de existir de um modelo de 2B é rodar onde um de 200B não consegue. Então, para o MiniCPM5-2B, a pergunta é menos "quão inteligente ele é" e mais "o que rodar localmente realmente me traz".
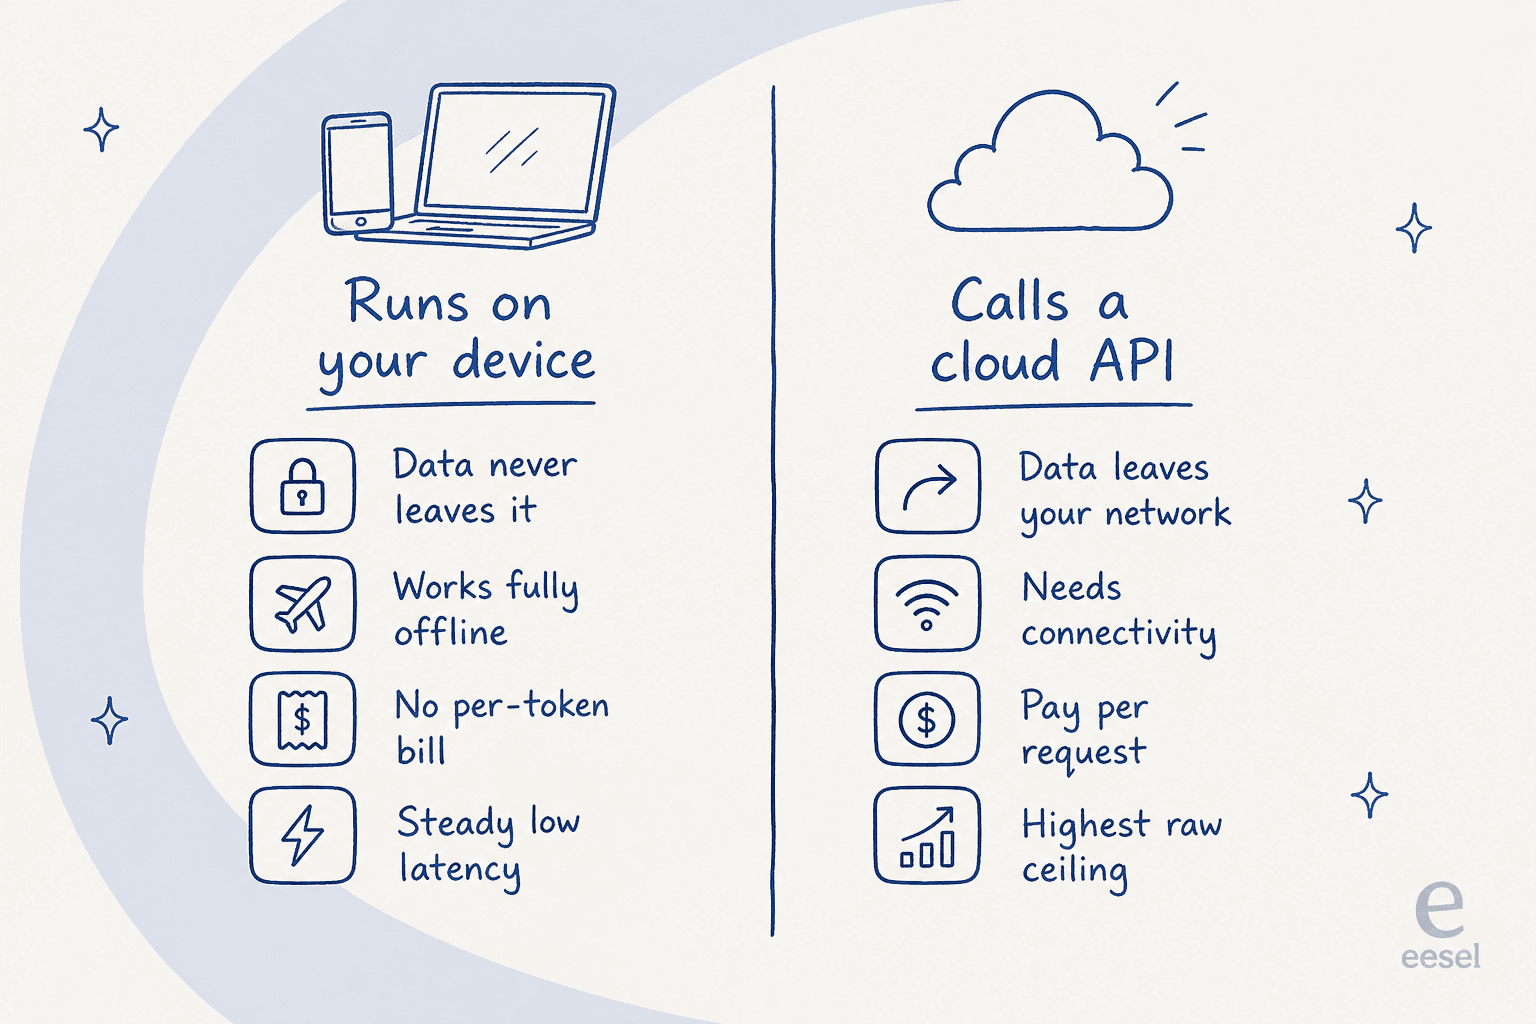
A troca é real nos dois sentidos. Rodando no dispositivo, seus dados nunca saem da máquina, funciona sem conexão e não há conta por token: para trabalho sensível à privacidade ou offline, essa combinação é difícil de bater. Abrir mão da nuvem também significa abrir mão do teto de capacidade de um modelo de fronteira. O MiniCPM5-2B aposta que, para um conjunto crescente de tarefas, um modelo local pequeno que é "bom o bastante" e privado vence um enorme e remoto ao qual você precisa confiar seus dados.
O lado prático se sustenta. Uma listagem da comunidade coloca a versão GGUF em cerca de 1,6 GB (um número de terceiros, não oficial), e a OpenBMB recompartilhou uma demo dele rodando em um MacBook de 16 GB fazendo busca na web no dispositivo. Ele também foi adaptado desde o dia 0 para Intel Core Ultra com OpenVINO, Arm v9 com SME2 (onde informa cerca de 1,7x mais prefill e 1,2x mais decode) e as placas RK3588 e RK1828 da Rockchip.
Aquela decisão de arquitetura padrão compensa aqui. O mesmo checkpoint carrega em uma grande variedade de runtimes no dia do lançamento, em vez de chegar aos poucos em um ou dois.
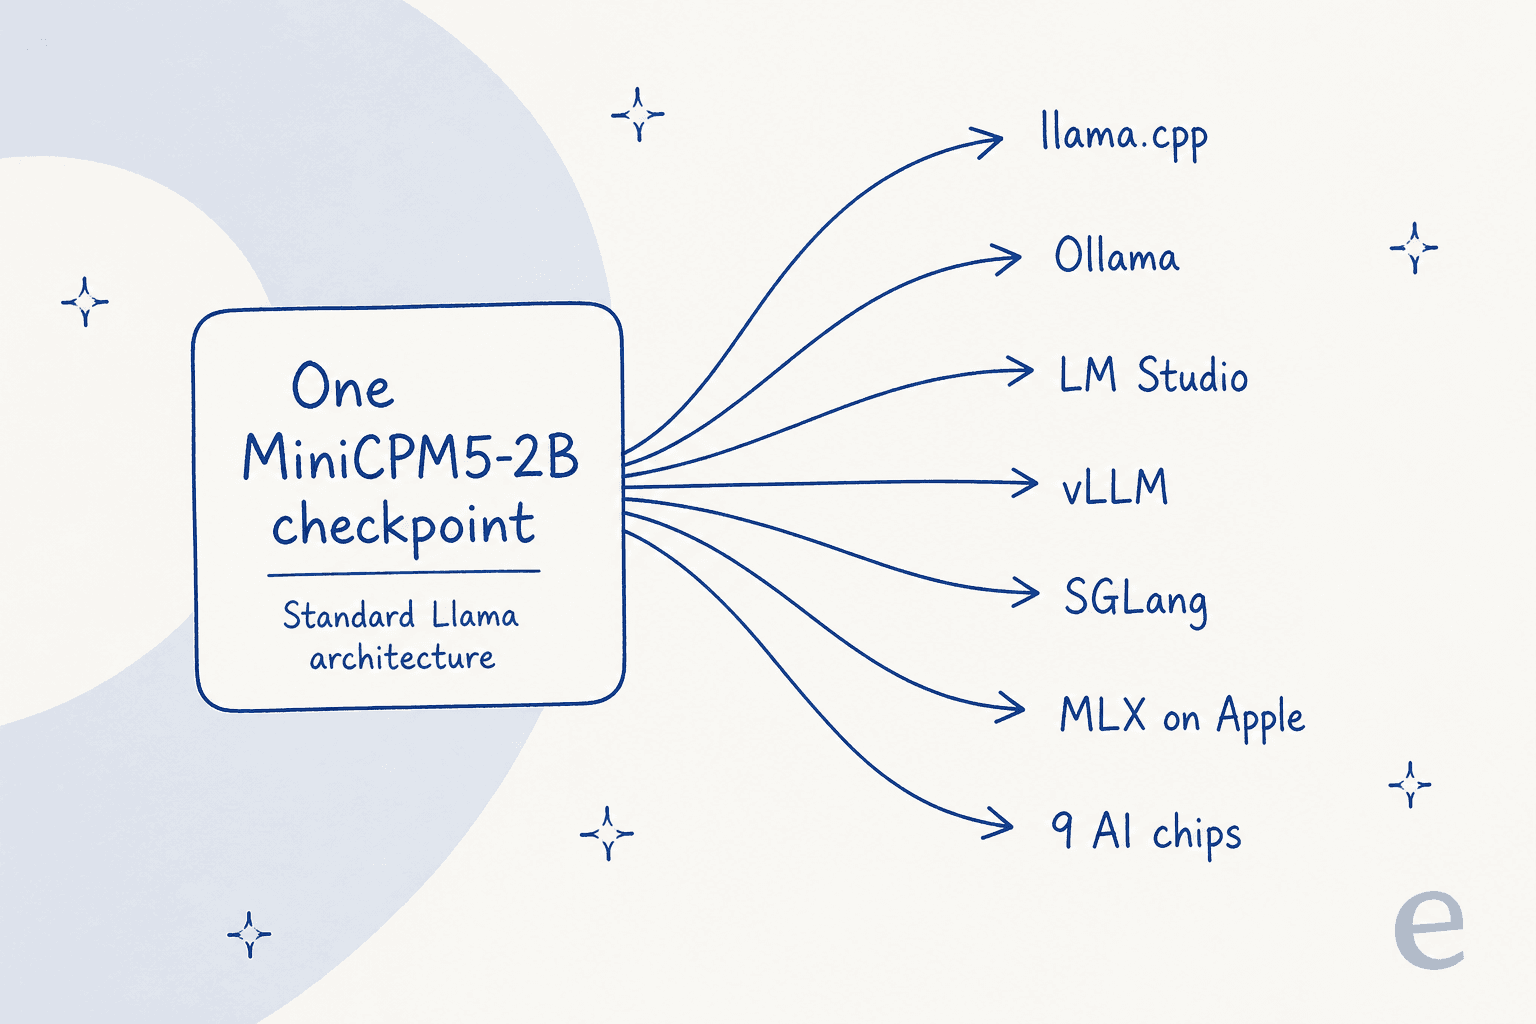
Segundo a tabela de implantação do cartão do modelo, ele roda em transformers, vLLM, SGLang, llama.cpp, Ollama, LM Studio, MLX para Apple Silicon e FlagOS, que o adapta a nove chips de IA diferentes. Para chamada de ferramentas, o SGLang é o backend recomendado: o modelo emite chamadas de ferramentas em estilo XML e o parser minicpm5 embutido do SGLang as converte em tool_calls compatíveis com a OpenAI. Há até um modelo rascunho DSpark para decodificação especulativa, se você quiser extrair mais velocidade sem mudar as saídas.
O que a comunidade está dizendo
As reações no lançamento se agruparam em dois campos, e ambos são sinais úteis.
O primeiro é o entusiasmo direto com a relação entre tamanho e capacidade. O post oficial de lançamento passou de 2.200 curtidas em um dia, e um testador relatou ter rodado 32 subagentes simultâneos em um único DGX Spark a 931 tokens por segundo em média, com pico de 1.364. Para um modelo de 2B hospedado localmente, essa vazão é o tipo de coisa que dá vontade de construir com ele.
O segundo campo é mais cético, e vale ouvir justamente porque não é marketing. A reclamação recorrente mais alta foi a falta de suporte a visão:
"Sad that there is no vision though."

E alguns desenvolvedores questionaram se as pontuações de benchmark se traduzem em trabalho real, especialmente em harnesses de programação:
"you get some likes here, but useful code? I don't think so"
Essa lacuna entre uma linha forte de benchmark e o bom comportamento dentro de um loop de agente real é justamente o que não dá para ler numa ficha técnica. É também o que mais importa no momento em que você tenta colocar qualquer modelo para trabalhar em tarefas reais.
Um modelo aberto é um motor, não um funcionário
Aqui está o reenquadramento que vale levar, e é a parte que construtores e compradores mais costumam pular. O MiniCPM5-2B é um ótimo motor. Sozinho, não é um trabalhador. Baixar um bom modelo de pesos abertos é o começo de um projeto, não o fim, e a distância entre os dois é maior que o modelo.
Eu trabalho na IA da eesel, e essa é a distinção em que vivemos todos os dias. Passamos anos colocando agentes de IA em filas de suporte ao vivo, e a lição recorrente é que a qualidade bruta do modelo raramente decide se um lançamento dá certo. O que decide é tudo o que envolve o modelo.
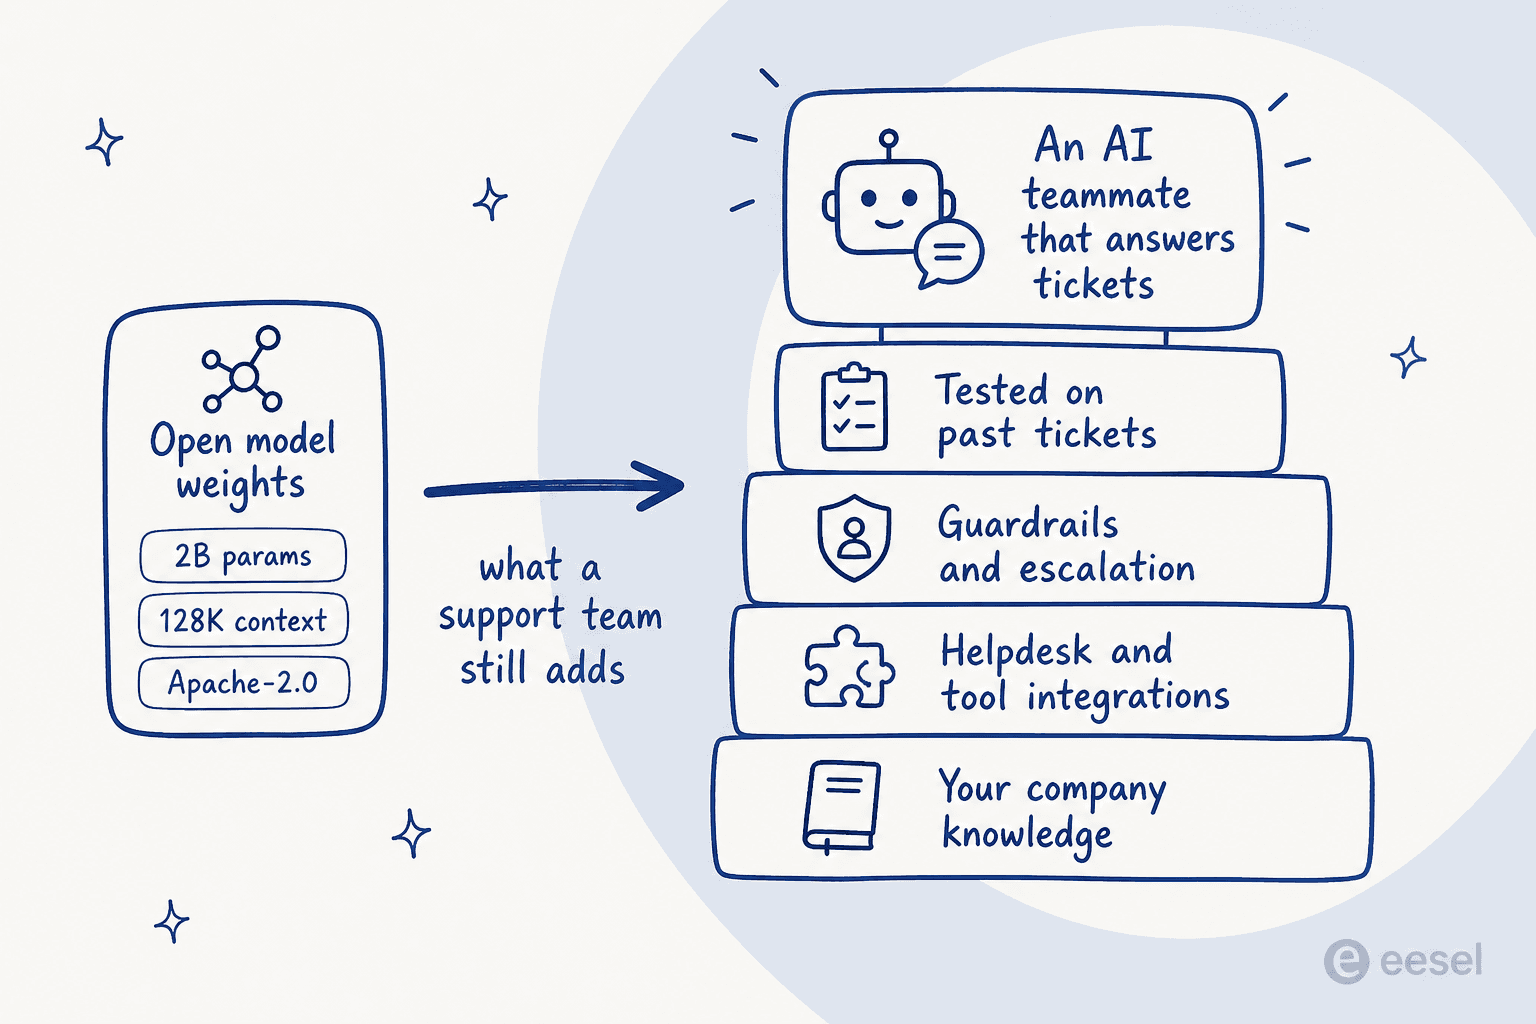
Tome o suporte ao cliente como caso concreto. Para transformar um modelo como o MiniCPM5-2B em algo capaz de responder a um ticket real, é preciso alimentá-lo com o conhecimento real da sua empresa, ligá-lo ao helpdesk e às ferramentas de que precisa para agir, adicionar barreiras de segurança para que escale em vez de chutar, e testá-lo com conversas passadas reais antes que toque em um cliente ao vivo. Essa última parte é onde vimos bots de aparência confiante darem respostas erradas em silêncio, e por isso hoje simulamos cada implantação com tickets históricos antes de ir ao ar. O modelo é talvez 20% disso. Os outros 80% são o andaime chato e essencial, e ele não vem no download.
Isso não é um argumento contra modelos abertos. É um argumento para ter clareza sobre o que você tem em mãos. O MiniCPM5-2B é um motor compacto realmente bom para construir. Mas, se o que você quer construir é um agente de suporte, pode montar você mesmo esses 80% ou contratá-los prontos.
Experimente a eesel
Se o seu objetivo real é responder perguntas de clientes, e não rodar um modelo, é exatamente o problema que a eesel existe para resolver. A eesel contrata para a sua fila atual um colega de helpdesk com IA pronto para trabalhar: ele aprende com os seus tickets passados e a sua central de ajuda, conecta-se em minutos a ferramentas como Zendesk, Freshdesk e Slack e, principalmente, simula com os seus tickets históricos reais para que você veja como ele vai se comportar antes de responder a alguém ao vivo.

E se você gosta de operar perto do metal, como faria com um modelo local, a eesel tem uma CLI pública e um servidor MCP, então o mesmo colega que você configura no painel pode ser conduzido a partir de um terminal, automatizado em scripts ou entregue a um agente de programação como o Claude Code ou o Cursor. Você leva o trabalhador pronto e a superfície programável, sem precisar construir os 80% sozinho. É grátis para experimentar.