

O veredicto em um minuto
Passei os últimos anos colocando IA em filas de suporte ao vivo, então leio todo lançamento de modelo do mesmo jeito: não "o benchmark está bonito?", mas "eu poderia entregar um trabalho real a isso amanhã?". Nesse teste, o Step 5 se mostra uma preview forte e uma compra fraca, e a distância entre as duas é a análise inteira.
Aqui está o placar antes do detalhe.
| O que avaliei | Minha leitura | Nota |
|---|---|---|
| Preço por inteligência | Melhor da faixa mais barata | 9/10 |
| Contexto longo (1M) | Um ponto forte real e utilizável | 9/10 |
| Qualidade em programação | No nível dos abertos, atrás da fronteira fechada | 7/10 |
| Credibilidade dos benchmarks | Autoavaliados, sem paper, um teste caseiro | 4/10 |
| Disponibilidade | Só API, pesos ainda não lançados | 5/10 |
| Pronto para um trabalho real | É um motor, não uma contratação | 4/10 |
Se você levar só uma frase: a história do preço é legítima, a dos benchmarks precisa de execuções independentes, e "modelo barato" e "produto pronto" não são a mesma compra.
O que o StepFun Step 5 Preview realmente é
A StepFun (阶跃星辰) é um laboratório de Xangai que lança a família "Step" em texto, visão e áudio há alguns anos, com uma boa presença de pesos abertos no Hugging Face. O Step 5 Preview é o novo carro-chefe, descrito na página do produto como um modelo de fronteira "for complex work and agentic tasks", com forte inclinação para engenharia de software e finanças.
O enquadramento a que a StepFun sempre volta é "advancing the Pareto frontier", a linha dos melhores equilíbrios possíveis entre inteligência e dinheiro. O gráfico de lançamento dela diz isso com clareza: igualar a faixa aberta mais barata em inteligência e superá-la em custo.
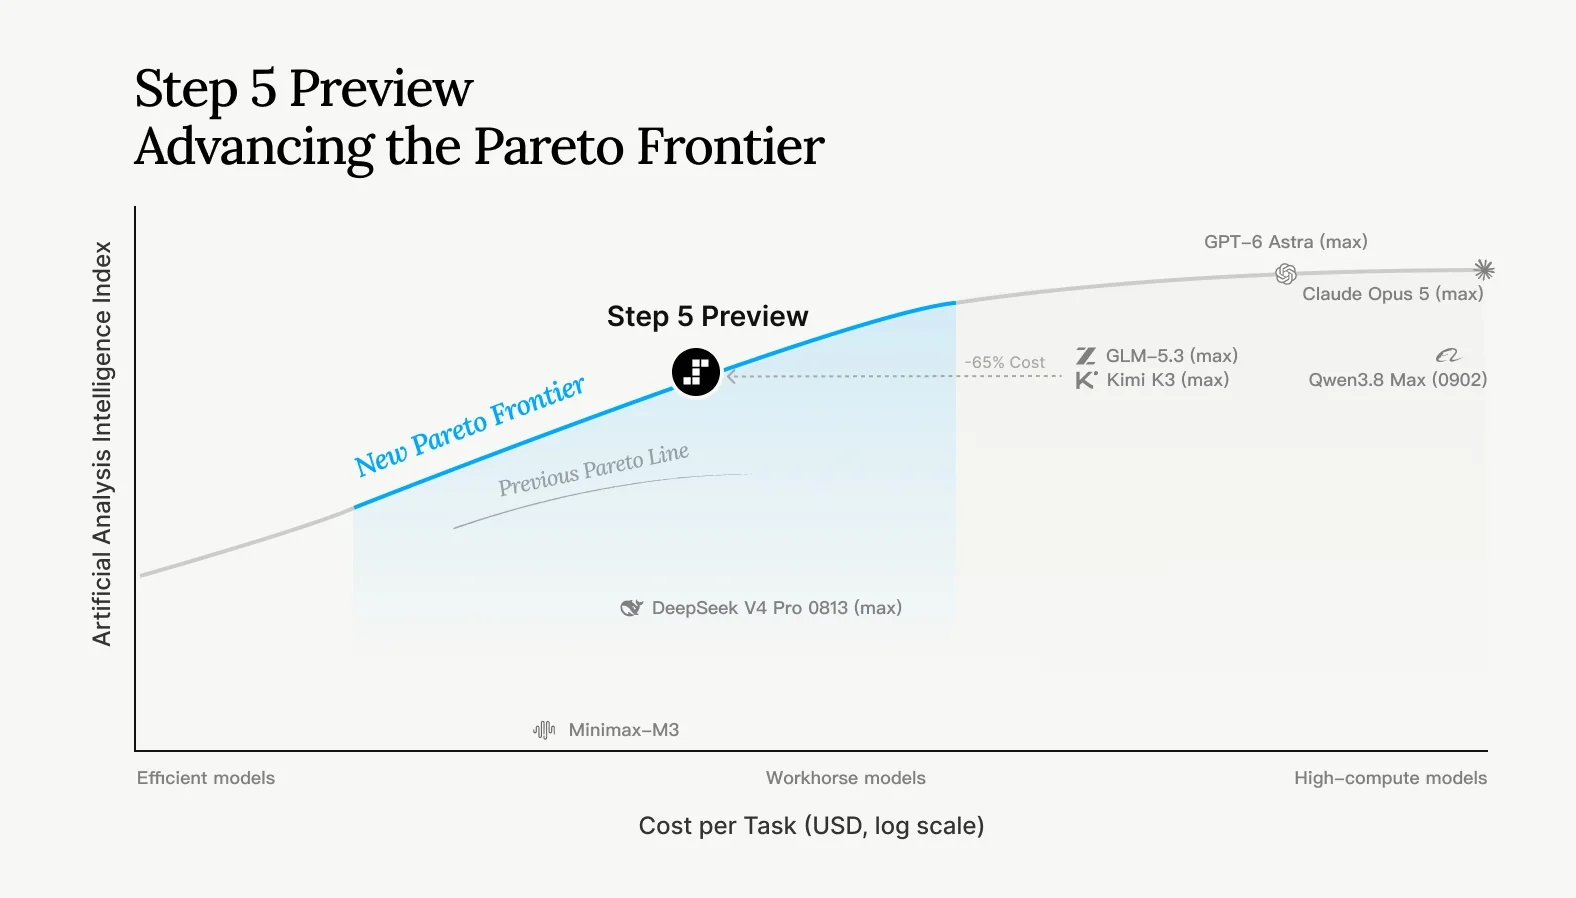
Repare na afirmação embutida nesse gráfico: um custo 65% menor que o GLM-5.3 e o Kimi K3 com nível de inteligência comparável. É um gráfico do fornecedor, então leio como a proposta e não como o veredicto, mas pelo menos é uma proposta coerente.
A arquitetura: 600B no total, 27B ativos
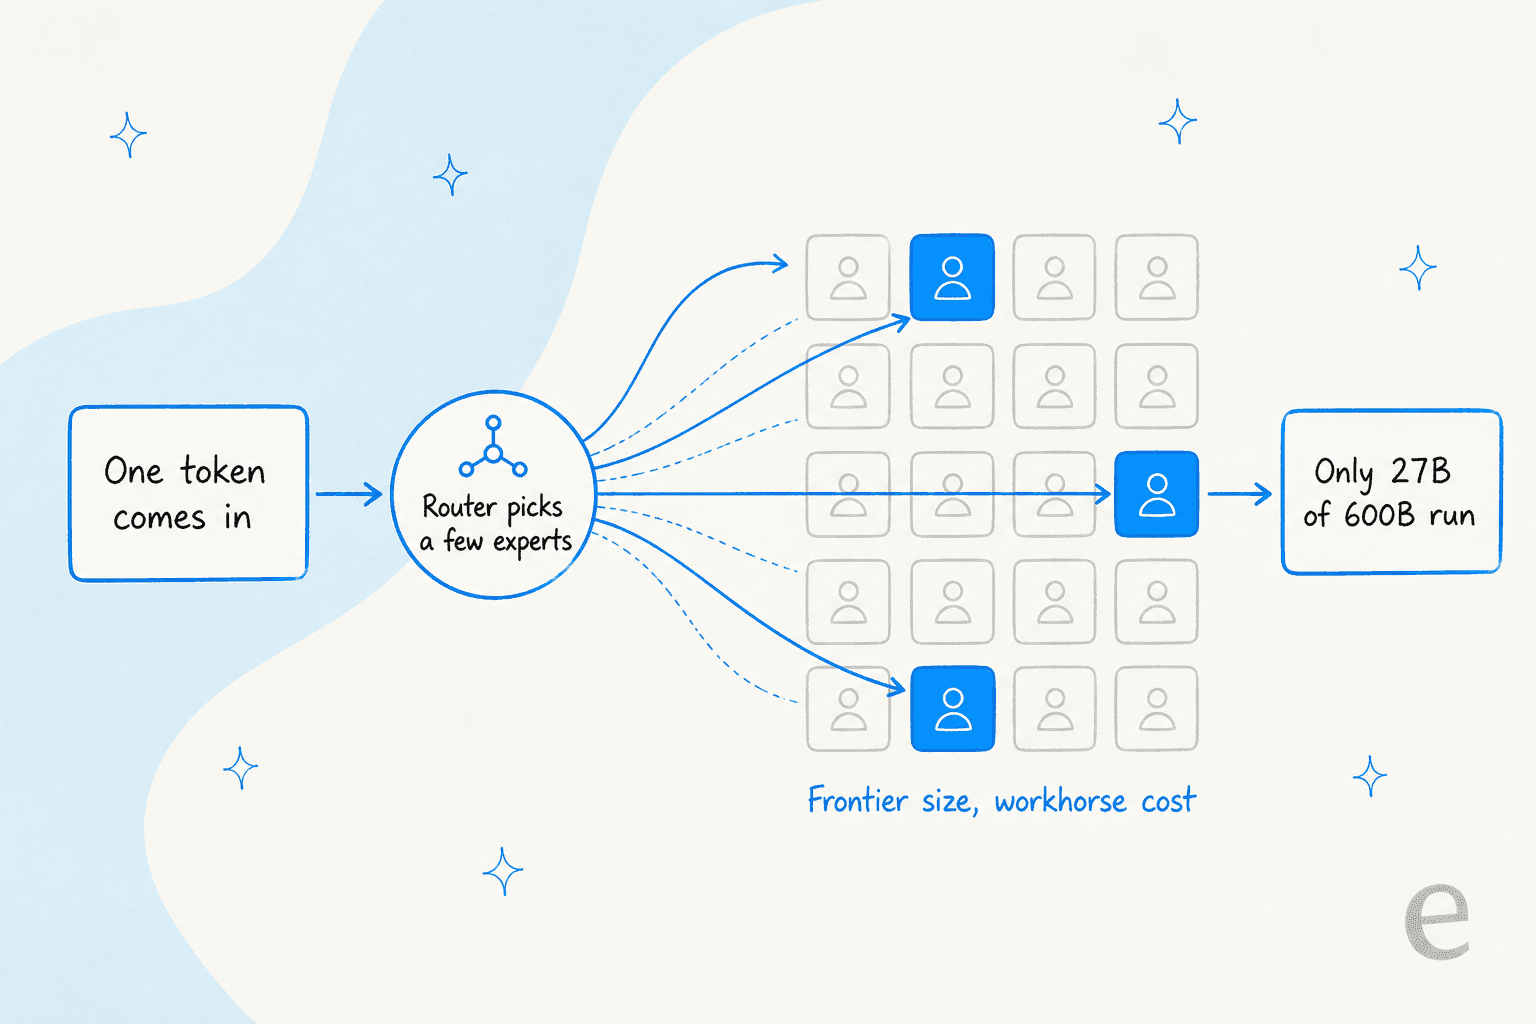
A especificação principal em que todos se fixaram é o formato do modelo: 600B de parâmetros no total, 27B ativos por token, segundo a página do produto. É um design de mistura esparsa de especialistas, e é toda a história do custo em um único número.
Em um modelo denso, todo parâmetro roda para cada token. Em um modelo de mistura de especialistas, um pequeno roteador escolhe um punhado de sub-redes "especialistas" por token, então só uma fatia do modelo dispara. O Step 5 mantém na memória 600B de tamanho de fronteira, mas acende só 27B por vez, e é por isso que a StepFun consegue precificá-lo como um modelo de faixa intermediária.
Nem todos acham que a conta fecha a favor do Step 5. O número de parâmetros ativos apareceu rápido no Hacker News:
"600b-a27b doesn't sound enticing. Also with the higher number of active parameters compared to GLM 5.3 flash and DeepSeek V4/4.1 flash, I don't see how they want to be more efficient at inference."

É um desafio justo. 27B ativos é mais pesado que algumas faixas "flash" rivais, então o ganho de eficiência é na verdade sobre a inteligência por parâmetro ativo, não sobre a contagem de ativos isoladamente. É exatamente o tipo de coisa que benchmarks de inferência independentes vão resolver, e os gráficos da própria StepFun não.
É um modelo de raciocínio, com um controle reasoning_effort que vai de low a medium e high. Mais esforço significa um rastro de pensamento interno mais longo e, como os tokens de saída são cobrados incluindo esse rastro, o esforço é um marcador direto de custo. Guarde isso, importa na seção de preços.
Preços: a parte de que eu realmente gostei
O preço é a coisa mais fácil de gostar neste lançamento. Da página de preços da StepFun, por 1M de tokens:
| Unidade de cobrança | Entrada (cache miss) | Entrada (cache hit) | Saída |
|---|---|---|---|
step-5-preview | US$ 1,00 | US$ 0,05 | US$ 2,70 |
step-3.7-flash (para contexto) | US$ 0,20 | US$ 0,04 | US$ 1,15 |
O desconto de 95% em cache hit na entrada é o destaque, e é muito importante para cargas agênticas que reenviam um prompt de sistema grande e quase estático a cada passo. A saída a US$ 2,70 cobre tanto o rastro de raciocínio quanto a resposta final, então uma execução tagarela de alto esforço custa dinheiro de verdade.
Como esse custo de saída mais raciocínio é fácil de subestimar, aqui vai um estimador rápido em que você pode colocar seus próprios números.
Há também um nível V0 gratuito para testar (5 de concorrência, 10 requisições por minuto), com limites de taxa que escalam conforme o quanto você recarregou. Em preço puro por token, é um dos melhores negócios da classe de modelos de raciocínio hoje. Ele joga na mesma faixa de orçamento do DeepSeek V4 Flash e não na faixa premium, e fica abaixo da maior parte dela.
Benchmarks, e a ressalva que domina esta análise
A StepFun publicou uma comparação completa contra pares abertos (Kimi K3, GLM-5.3) e a fronteira fechada (GPT-6 Astra, Claude Opus 5). Aqui está o formato dela, com todos os números da própria página do produto da StepFun.
| Benchmark | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
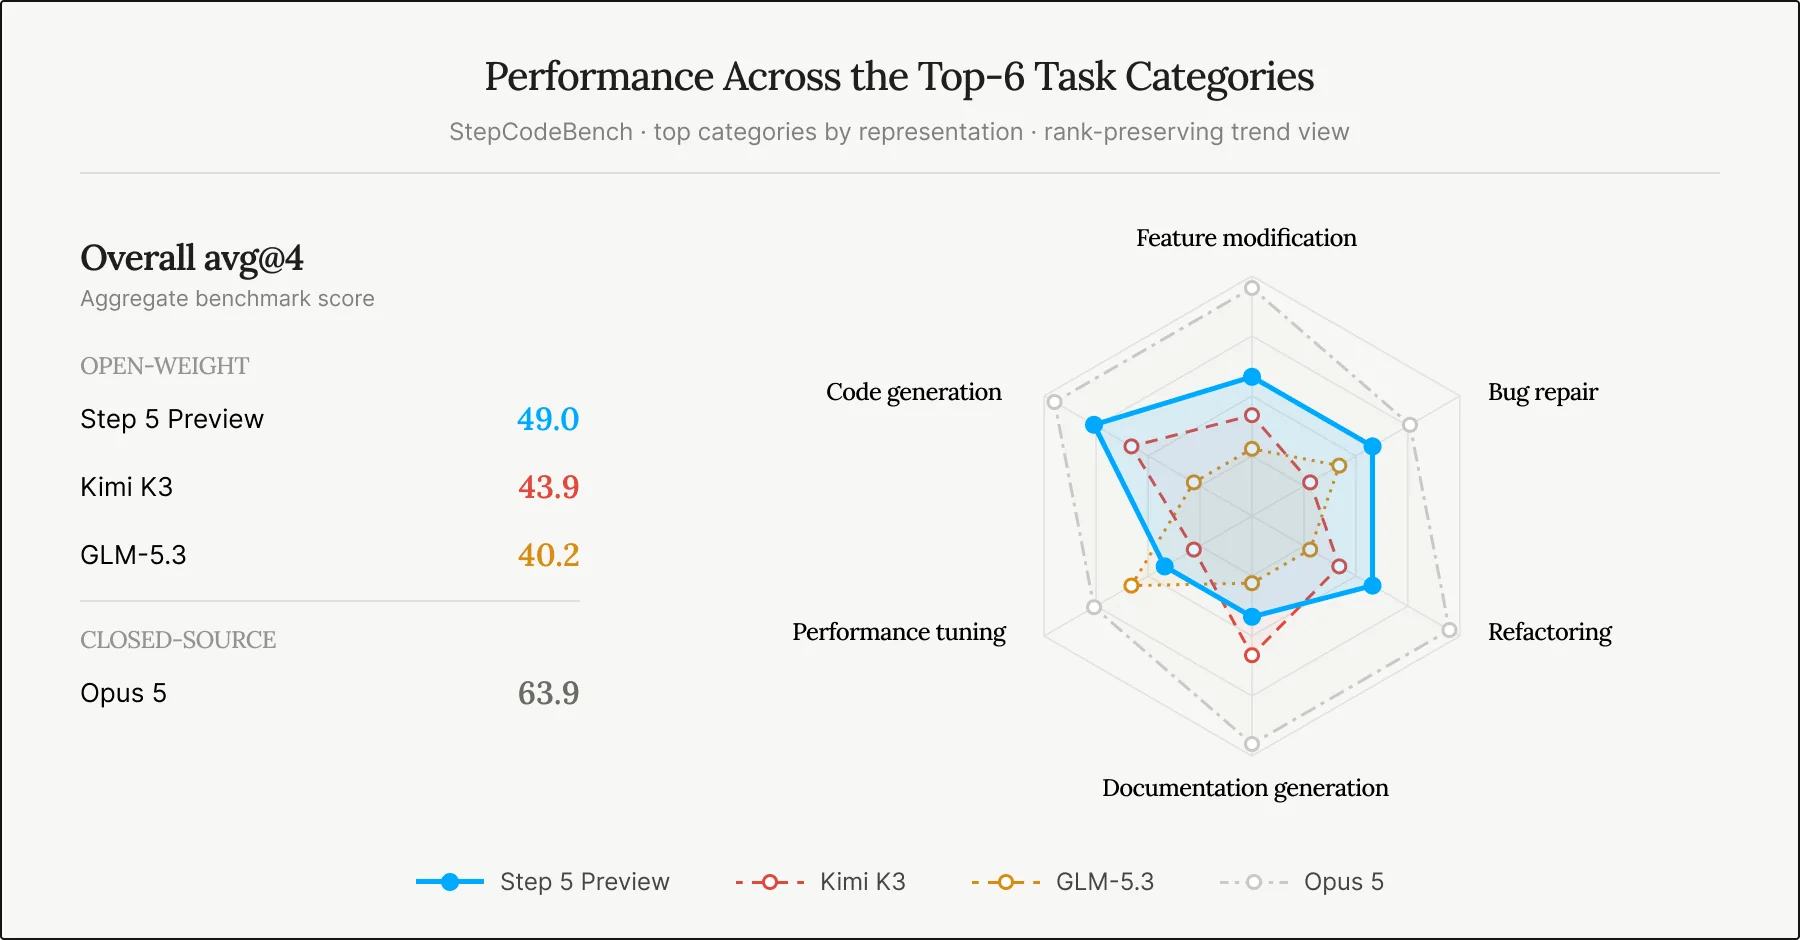
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
A leitura é consistente: o Step 5 está em paridade com os outros modelos abertos líderes e atrás dos melhores modelos fechados em qualidade bruta de programação, enquanto vence em custo. Ele fica mais atrás do Claude Opus 5 nos testes difíceis de programação. Finanças é o destaque, onde supera os pares abertos e vence o GPT-6 Astra. O próprio radar do StepCodeBench conta a mesma história contra a faixa aberta.
Agora a ressalva, e é o motivo de minha nota de credibilidade dos benchmarks ser 4. Todo número acima é autorreportado, ainda não há relatório técnico nem paper, e o StepCodeBench é o benchmark da própria StepFun (553 repositórios, 33 linguagens). Um modelo tende a se sair bem no teste que a própria equipe projetou. A comunidade apontou rápido os pontos mais fracos, especialmente a prolixidade:
"Based on the examples, it's like the thing took a writing class from Claude, but isn't quite as smart, kind of worst of both worlds. The 'Interactive Reporting' one is particularly terrible. A huge amount of waffly padding around a thesis that may or may not exist."
E um comentarista percebeu a demo de lançamento se entregando, exatamente o tipo de coisa que me faz querer rodar minhas próprias avaliações antes de confiar em um gráfico de lançamento:
"In their first demo video, to make a 3D render of the photo, the thinking trace gives away the game [...] I'm always astounded how little effort is put into checking the AI answers displayed in these announcements."
Nada disso faz do Step 5 um modelo ruim. Faz dele um modelo não comprovado, o que é diferente. A resposta correta é simulá-lo com a sua própria carga de trabalho em vez de aceitar o gráfico de lançamento ao pé da letra, e esse instinto vale igualmente para como você deve confiar em qualquer IA no atendimento ao cliente.
Onde ele brilha: contexto longo e finanças
Dois pontos fortes se sustentaram em tudo que li. O contexto de 1M de tokens é a especificação em que eu mais me apoiaria. É suficiente para jogar uma base de código inteira, um trimestre de transcrições de suporte ou uma pilha de PDFs em uma única chamada e pedir raciocínio entre documentos. No lado multimodal, você pode passar até 60 imagens por requisição mais vídeo curto, embora a saída seja só texto.
A StepFun também aposta forte na história da programação. Ela afirma que o Step 5 pode ir "from software engineering and visual applications to programmable hardware", e que, em avaliações de especialistas, cerca de 70% dos participantes o consideraram capaz de resolver de forma autônoma tarefas de programação de complexidade moderadamente alta, segundo a página do produto. Há uma integração com o Claude Code por meio do "Step Plan" que expõe o contexto completo de 1M, um lugar inteligente para encontrar desenvolvedores. O resultado em finanças no FrontierFinance é o único benchmark em que ele claramente lidera o grupo, modelos fechados incluídos.
Prós e contras
Resumindo a análise nas duas listas que eu realmente uso para decidir se vou testar algo:
O que é bom
- Melhor preço por inteligência da faixa mais barata, a US$ 1,00 / US$ 2,70 por 1M de tokens.
- Um contexto real de 1M de tokens, não um número de marketing limitado na prática a 128k.
- Desconto de 95% em cache hit que premia cargas agênticas com prompts repetidos.
- Posicionamento honesto: ele diz "o melhor da faixa mais barata", não "superamos a fronteira".
- Um lançamento de pesos abertos no roteiro, com precedente de Apache 2.0 na linha Flash.
O que me dá pausa
- Todo benchmark é autorreportado, sem relatório técnico e com um teste caseiro.
- A comunidade percebe saída prolixa, que infla silenciosamente a conta de tokens de saída.
- 27B ativos é mais pesado que algumas faixas flash rivais, então o ganho de eficiência está indefinido.
- Só API hoje; os pesos que tornam interessante a proposta "aberta" ainda não chegaram.
- É um modelo bruto, então o trabalho de transformá-lo em produto é inteiramente seu.
Para quem é o Step 5 e quem deve esperar
Aqui é onde eu chego. Se você é um desenvolvedor ou um laboratório que quer um modelo capaz, barato e de contexto longo para construir em cima, principalmente para programação, finanças ou pesquisa em grandes conjuntos de documentos, o Step 5 Preview vale um teste de verdade. A história do preço por inteligência é legitimamente boa, e a promessa de pesos abertos o torna ainda mais interessante.
Se você está esperando um modelo consolidado e comprovado, espere. É uma preview, os benchmarks são autoavaliados, e a primeira leitura da comunidade é "promissor, mas prolixo e não comprovado". Até um comentarista simpático descreveu o padrão com delicadeza:
"The previous Step models were pretty decent, but unfortunately for them, their model reasons too much and too long [...] Hopefully this doesn't reason too long to get to the answer. I welcome any open model, the more the merrier."
Dou crédito à StepFun pelo que a maioria dos lançamentos erra, que é saber o que são:
"Their posisitoning is nice. Instead of saying they are cheaper and a bit less performant (in terms of intelligence), they say they are best among the cheaper and a bit less performant ones."
Onde um modelo bruto termina e uma colega começa
Há um enquadramento que vale contestar, e não é culpa da StepFun, vale para todo lançamento de modelo. Um modelo não é uma solução. O Step 5 Preview é um motor. Ele lhe dá uma API, uma conta de tokens e capacidade bruta. Transformar isso em algo que responde aos seus clientes significa que você constrói o app, conecta seus dados, escreve as proteções e cuida da manutenção.
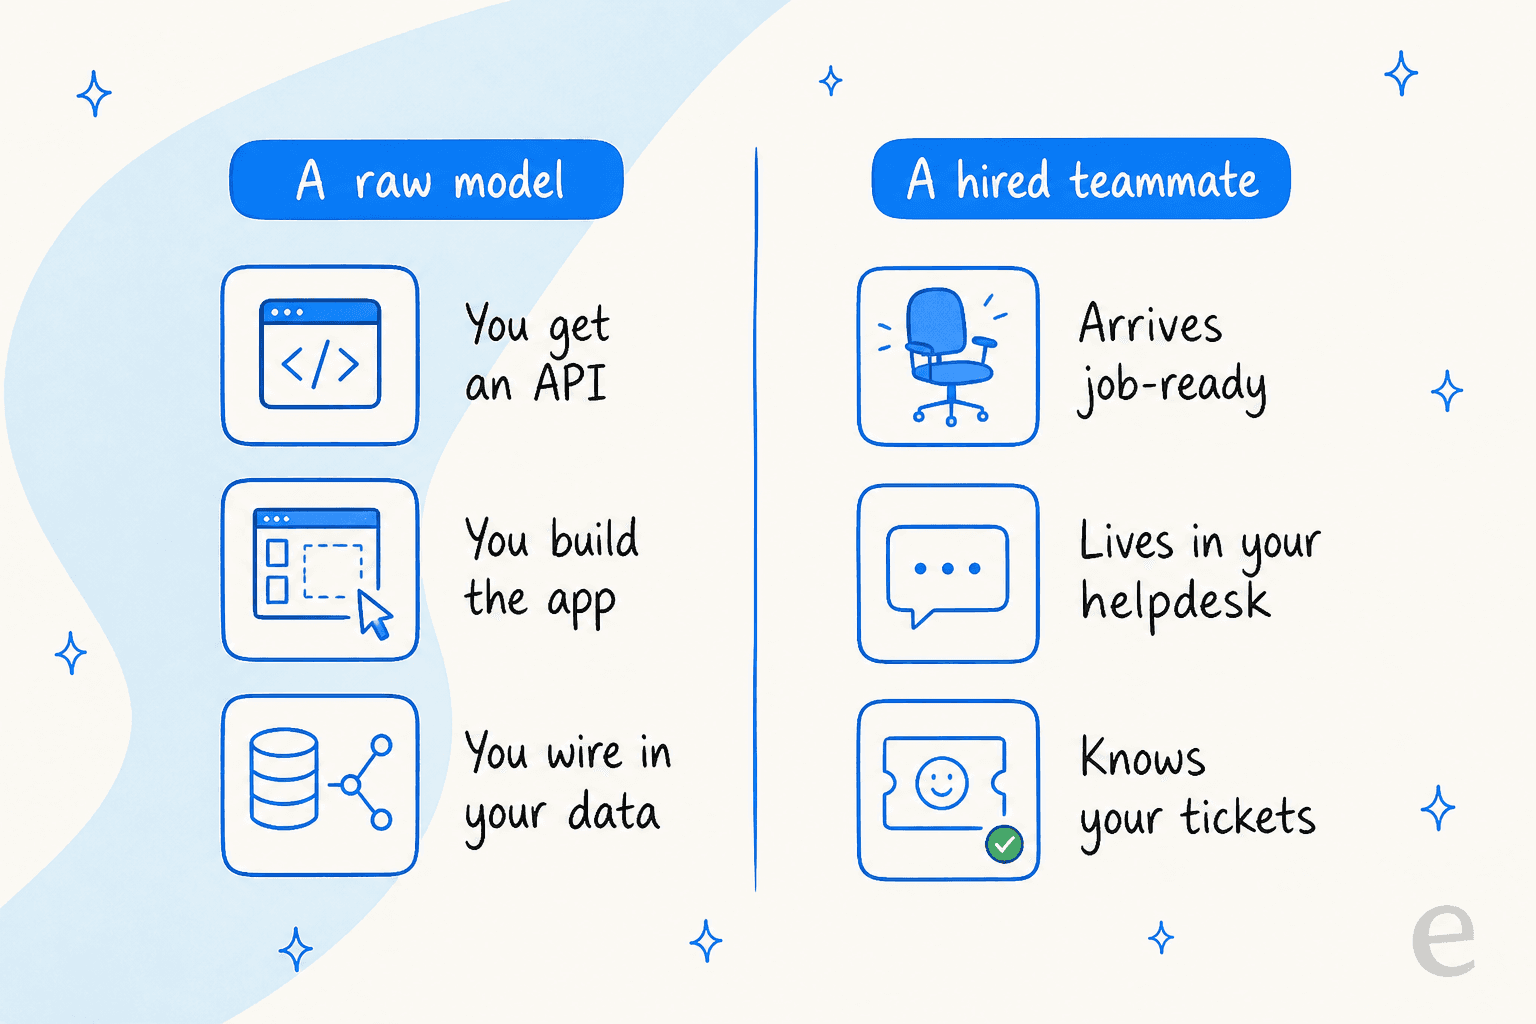
Essa lacuna é o motivo de a eesel existir. Em vez de um modelo bruto, você contrata uma colega pronta para trabalhar em uma função específica. A colega de IA para o helpdesk entra na sua fila atual, treina com seus tickets antigos e sua central de ajuda, e redige ou envia respostas dentro do helpdesk que você já usa, seja o Zendesk, o Freshdesk ou o Gorgias. O preço é uma tarifa fixa por resolução, sem taxa por usuário, então o custo acompanha o trabalho feito e não os tokens queimados.

A parte que mais me importa, dado o problema dos benchmarks autorreportados acima, é que você pode simular a colega em milhares dos seus próprios tickets antigos antes que ela toque em um cliente real, e ver a taxa de resolução verdadeira na sua carga de trabalho em vez do gráfico de um fornecedor. E se você prefere operá-la por um terminal em vez de um painel, a eesel oferece uma CLI real e um servidor MCP para que agentes de programação como o Claude Code operem diretamente a mesma colega. Modelos novos como o Step 5 são infraestrutura empolgante. Uma colega é quem de fato aparece para o turno. Você pode experimentar a eesel grátis.