

O Groq 3 LPX é o acelerador de inferência de baixa latência em escala de rack da NVIDIA para a plataforma Vera Rubin. É genuinamente impressionante, mas também não é algo que a maioria das equipes possa simplesmente comprar. Ele vem como parte de uma implantação Vera Rubin, é infraestrutura em escala de rack e, até agora, apenas nuvens como a Nebius o têm em produção. Então, se você procurou alternativas, quase certamente está fazendo uma de duas perguntas reais: qual opção de inferência rápida posso usar de verdade agora, ou em qual silício minha plataforma deveria apostar.
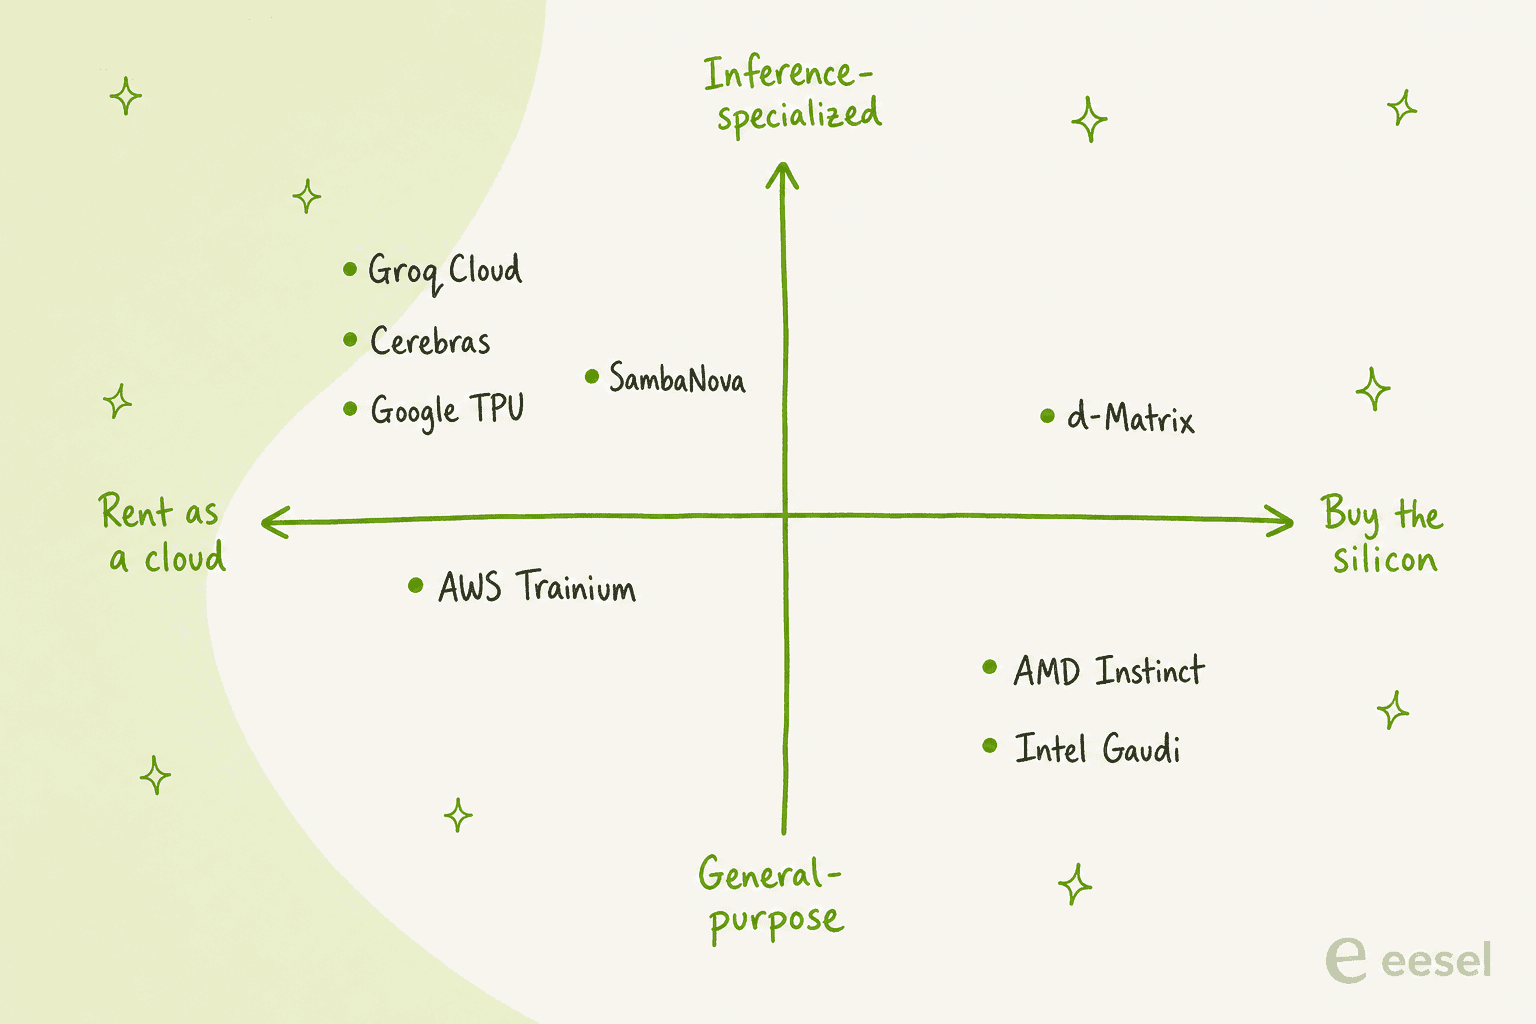
Estas são as oito que eu consideraria, agrupadas pela forma de acesso:
- Use hoje por API: Cerebras (velocidade pura de fluxo único), SambaNova (maiores modelos abertos e cargas de agentes) e a nuvem independente da Groq (a LPU da Groq, sem esperar pelos racks da NVIDIA).
- Alugue silício de hiperescaladores: Google TPU Ironwood (Google Cloud, focada em inferência) e AWS Trainium (melhor economia de tokens dentro da AWS).
- Tenha o hardware próprio: AMD Instinct (mais memória por GPU, software aberto) e Intel Gaudi (custo-benefício e Ethernet padrão).
- Aposte cedo em um especialista: d-Matrix Corsair (computação em memória feita para baixa latência).
A reformulação honesta, e o que mais quero que você leve daqui: a menos que você opere uma nuvem, não vai comprar nenhum destes. Você vai senti-los como tokens mais rápidos e baratos nas APIs que já usa, e o que você realmente implanta é o trabalhador por cima, como um agente de IA para helpdesk. É aí que a eesel se encaixa.
Por que olhar além do Groq 3 LPX
Vou começar sendo justo com o incumbente, porque é uma peça séria de engenharia. O Groq 3 LPX é o acelerador de inferência da NVIDIA para o Vera Rubin, construído sobre o design de LPU da Groq sob uma licença não exclusiva. Cada rack reúne 256 chips LPU que trabalham ao lado de GPUs Rubin, e a NVIDIA cita um benchmark de 3.400 tokens por segundo no Gemma 4 31B com 100K de contexto. É rápido, e a arquitetura é inteligente.
Então por que olhar outras opções? Alguns motivos bem práticos:
- Você não pode simplesmente comprá-lo. O LPX é uma extensão em escala de rack do Vera Rubin NVL72, não uma placa que você coloca em um servidor. É um compromisso de data center, não uma decisão de compra para a maioria das equipes.
- A disponibilidade é escassa. A NVIDIA anunciou a produção plena em agosto de 2026, mas a Nebius é apenas a primeira nuvem a implantá-lo. Se você quer capacidade hoje, a fila é curta e a lista de provedores é ainda mais curta.
- Os números são da própria NVIDIA. O número de destaque de 35x de vazão por megawatt é medido contra a geração anterior da NVIDIA. É uma afirmação coerente, mas é uma afirmação do fornecedor, e testes independentes ainda estão chegando.
- Dependência do fornecedor. O LPX só faz sentido dentro de uma estrutura Vera Rubin. Se sua stack, sua nuvem ou seu orçamento apontam para outro lado, é uma dependência rígida.
Nada disso torna o LPX ruim. Só significa que "devo usar o Groq 3 LPX?" é a pergunta errada para a maioria das pessoas. A melhor é "de onde devo tirar inferência rápida?", e há muitas boas respostas.
Como escolhi e como ler esta lista
Eu trabalho no lado de produto, então meu viés é para o que você pode de fato adotar, não para o que se sai melhor em um slide. Li a documentação, os preços e as fichas técnicas de cada fornecedor e, onde existe um número de velocidade, usei o do fornecedor e deixei isso claro. Três fatores moldaram o ranking:
- Dá para usar agora? Uma API que você pode chamar esta tarde vale mais do que um rack em que você vai entrar na fila. A acessibilidade tem peso forte.
- Qual é a carga de trabalho real? Chat rápido de fluxo único, modelos abertos enormes ou serviço em lote barato são trabalhos diferentes que premiam chips diferentes.
- Quanto custa conviver com ele? Alugar versus comprar, o software ao qual você se prende e o custo total de propriedade importam mais que o pico de FLOPS.
Uma ressalva que vale dizer com clareza: a opinião da comunidade sobre exatamente esta geração de hardware ainda é escassa, porque quase nada dela esteve em uso por muito tempo. Então as análises abaixo se apoiam em especificações primárias e nos poucos benchmarks reais existentes, não em anos de avaliações de usuários. Onde há uma voz real, eu a citei.
Aqui está o campo todo de relance antes de aprofundarmos.
| Alternativa | Tipo | Como acessar | Número de inferência de destaque (declarado pelo fornecedor) | Sinal aproximado de custo | Melhor para |
|---|---|---|---|---|---|
| Groq (GroqCloud) | Nuvem de inferência LPU + chips | API hoje, por token | Mais rápida em modelos pequenos/médios | Por token, publicado | Velocidade da LPU da Groq sem esperar pelos racks da NVIDIA |
| Cerebras | Escala de wafer (WSE-3) | API + compra de CS-4/CS-3 | ~3.000 tok/s (GPT OSS 120B) | US$ 0,35 ent. / US$ 0,75 saída por M | Velocidade pura de fluxo único |
| SambaNova | RDU, memória de três níveis | API + racks on-prem | ~850 tok/s (MiniMax M2.7) | US$ 0,22 ent. / US$ 0,59 saída por M (gpt-oss-120b) | Maiores modelos abertos, agentes, on-prem |
| Google TPU (Ironwood) | ASIC próprio | Aluguel somente no Google Cloud | 4.614 FP8 TFLOPs/chip | A partir de US$ 12,00/chip-hora | Equipes já no GCP, serviço em hiperescala |
| AWS Trainium | ASIC próprio | Aluguel somente na AWS | Trn2: 30-40% melhor preço-desempenho vs. H200 | Inf2 a partir de US$ 0,76/h | Tokens mais baratos dentro da AWS |
| AMD Instinct | GPU (CDNA) | Compra, ou via parceiros de nuvem | MI355X: 288 GB HBM3E, 8 TB/s | Compra de capital / cotação | Silício próprio, modelos que usam muita memória, sem dependência |
| Intel Gaudi 3 | Acelerador de IA | Compra, ou via IBM Cloud | 128 GB HBM, 1.200 GB/s Ethernet | Posicionamento de "metade do custo" | Compradores de custo-benefício, ambientes nativos em Ethernet |
| d-Matrix Corsair | Computação em memória (DIMC) | Somente compra de hardware | 60.000 tok/s (Llama3 8B, servidor) | Compra de capital | Obcecados por latência que apostam cedo |
| Groq 3 LPX (incumbente) | Rack LPU + GPU | Via nuvens (Nebius) | 3.400 tok/s (Gemma 4 31B) | Escala de data center | Inferência agêntica em hiperescala |
Não sabe qual linha é a sua? Este seletor leva você a uma lista curta com um clique.
1. Groq (GroqCloud): a LPU da Groq que você pode usar hoje
Melhor para: equipes que querem a velocidade de baixa latência da LPU da Groq por API agora, sem esperar os racks da NVIDIA chegarem à sua nuvem.
Aqui está a reviravolta que confunde muita gente. A empresa Groq ainda existe, ainda opera o GroqCloud e ainda vende a mesma velocidade de LPU que a tornou famosa. Quando a NVIDIA licenciou a tecnologia da Groq, foi um acordo não exclusivo mais uma transferência de equipe, não um encerramento. A Groq continuou independente sob um novo CEO, e o GroqCloud seguiu operando sem interrupção. Uma reação no X capturou a confusão perfeitamente:
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Então, se o que atraiu você no LPX foi a velocidade da LPU, a "alternativa" mais direta costuma ser simplesmente a original: o GroqCloud. Você obtém uma API compatível com OpenAI, geração de tokens determinística e de baixa latência, e pode começar hoje em vez de esperar por uma implantação Vera Rubin perto de você. No Hacker News, um dos comentários mais afiados leu o benchmark do LPX como uma continuação da força já conhecida da Groq:
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Prós: disponível hoje, API familiar, forte em modelos pequenos e médios e a mesma linhagem de LPU que a NVIDIA licenciou. Contras: a confusão de marca é real, e os maiores modelos são melhor atendidos em outro lugar. Se quiser o quadro completo de custos, detalhamos separadamente os preços da Groq e o conjunto mais amplo de alternativas à Groq.
Preços e acesso: autoatendimento, pagamento por token via GroqCloud. Veredito: se "Groq 3 LPX" chamou sua atenção por causa da LPU, comece aqui antes de qualquer outra. É o caminho mais curto até a coisa de verdade.
2. Cerebras: o mais próximo de um rival de velocidade pura
Melhor para: velocidade pura de tokens em fluxo único em modelos pequenos e médios, seja por API ou no seu próprio sistema.
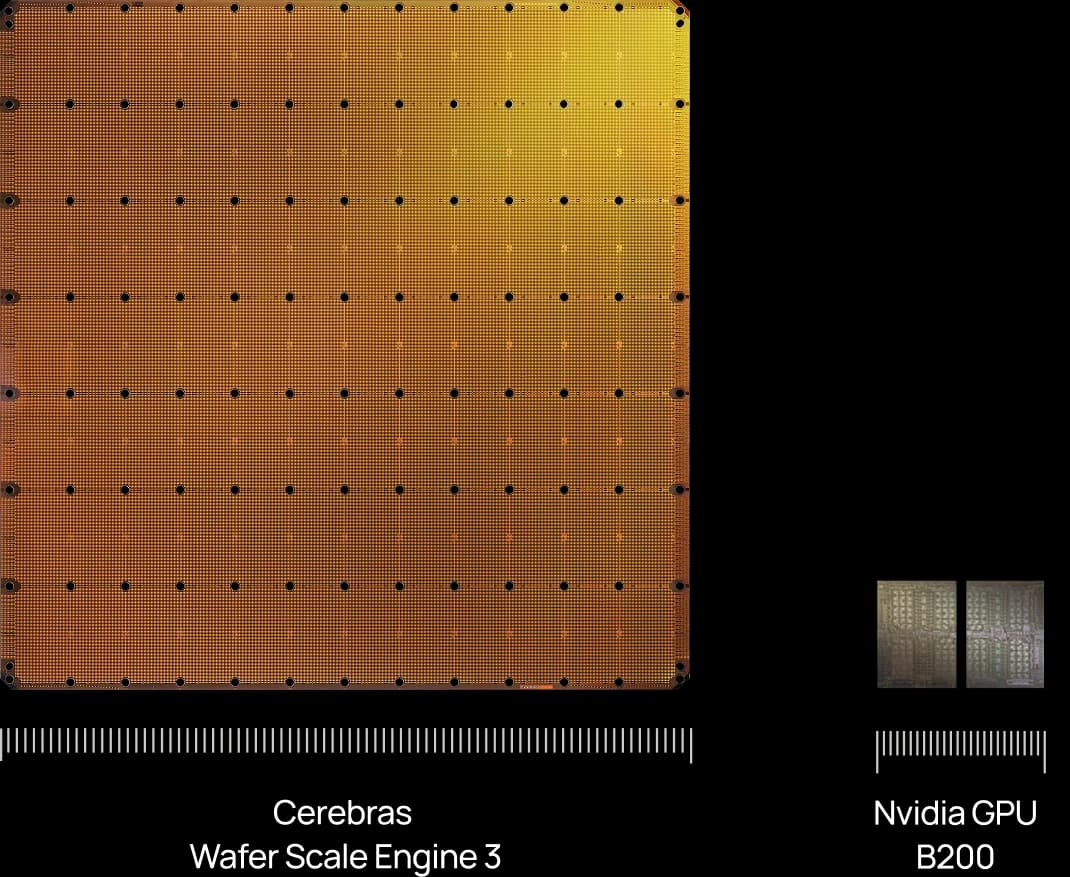
A Cerebras é o outro nome que sempre aparece na conversa sobre "inferência mais rápida", e com razão. Seu Wafer-Scale Engine é um único chip do tamanho de um prato: 4 trilhões de transistores, 900.000 núcleos e 125 petaflops em uma só peça de silício. A Cerebras diz que são 19 vezes mais transistores que uma NVIDIA B200. Toda a filosofia de design é o oposto de um cluster de chips pequenos conversando por uma rede.
A parte que você realmente usa é o Cerebras Inference, uma nuvem compatível com OpenAI que aposta pesado em velocidade: a página de preços afirma ser 20 vezes mais rápida que OpenAI e Anthropic, e o novo sistema CS-4 promete "inferência até 30x mais rápida em comparação com GPUs". Na prática, a Cerebras cita cerca de 3.000 tokens por segundo no GPT OSS 120B e aproximadamente 1.800 no Gemma 4 31B.
Prós: velocidade de fluxo único realmente líder da categoria, uma API limpa de pagamento por token e usuários conhecidos como OpenAI, Meta e Perplexity. Contras: sistemas em escala de wafer são uma compra pesada se você for on-prem, e a tabela pública lista apenas alguns modelos, então orçar uma carga específica exige uma conversa com vendas.
Preços e acesso: US$ 5 em créditos gratuitos para começar, depois um plano Developer a partir de US$ 10 com tarifas por token publicadas (GPT OSS 120B a US$ 0,35 de entrada / US$ 0,75 de saída por milhão de tokens), além de Enterprise e sistemas CS-4/CS-3 à venda. Veredito: se a única coisa que importa para você é tokens por segundo em um modelo que a Cerebras atende, é a alternativa mais forte desta lista e compete de frente com a Groq.
3. SambaNova: feita para grandes modelos abertos e agentes
Melhor para: rodar rápido os maiores modelos abertos, manter muitos modelos residentes para cargas de agentes ou servir inferência dentro do seu próprio data center.
Todo o discurso da SambaNova para 2026 é a "inferência premium", e seu diferencial é a memória. Enquanto o design da Groq aposta em enorme largura de banda de SRAM com capacidade minúscula por chip, a SN50 RDU usa três níveis: 432 MB de SRAM no chip, 64 GB de HBM2E e até 512 GB de DDR5. Isso permite que vários modelos grandes permaneçam carregados e alternem com latência mínima, o que o cofundador Kunle Olukotun chama de "zona Goldilocks" para agentes.
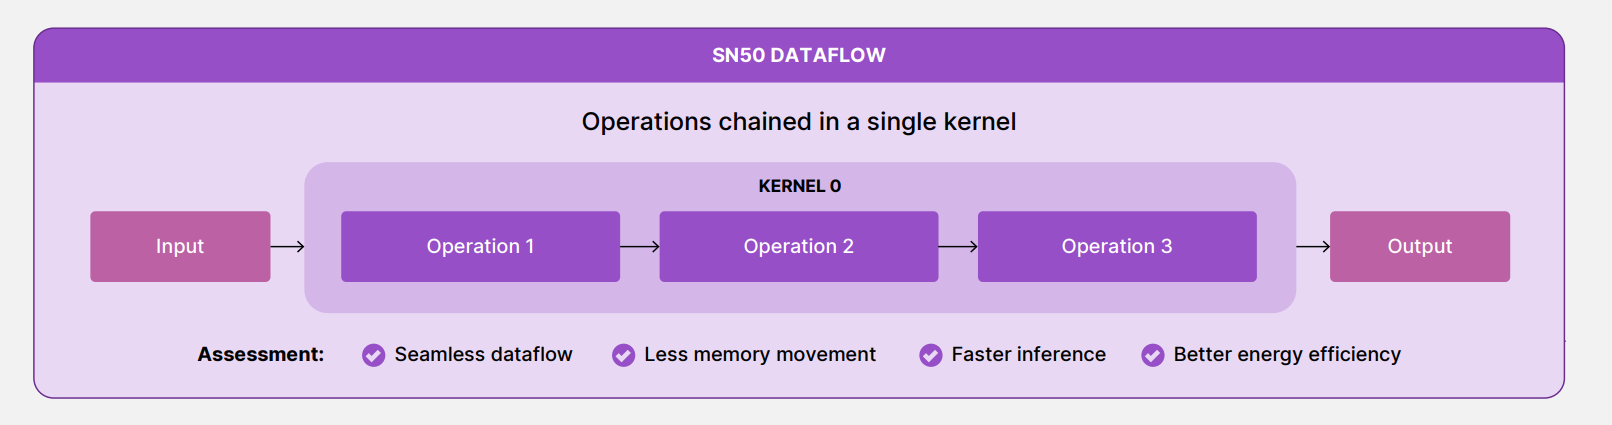
A prova de velocidade em que mais confio é de terceiros: a Artificial Analysis mediu o SN50 rodando o MiniMax M2.7 a até 850 tokens por segundo em contexto curto e mais de 450 em contexto longo, chamando-o de o MiniMax mais rápido do mundo. Há também uma nuance inteligente: a SambaNova cada vez mais se combina com a NVIDIA em vez de combatê-la, usando GPUs para a fase de prefill, intensiva em computação, e RDUs para a fase de decode, limitada por memória.
Prós: a memória de três níveis serve a modelos enormes e cargas de agentes multimodelo, tarifas publicadas para modelos abertos, uma história on-prem real para implantações soberanas e corporativas e uma recente captação de US$ 1 bilhão com valuation de US$ 11 bilhões. Contras: é menos uma aposta pura em "o menor modelo mais rápido" do que Groq ou Cerebras, e as maiores implantações são sob contato com vendas.
Preços e acesso: a SambaNova Cloud é uma API de pagamento por token (gpt-oss-120b a US$ 0,22 de entrada / US$ 0,59 de saída por milhão de tokens; DeepSeek-V3.1 a US$ 3,00 / US$ 4,50), com sistemas SambaRack para on-prem. Veredito: a escolha quando sua carga são grandes modelos abertos ou um agente que maneja vários modelos ao mesmo tempo, e mais ainda se você precisa dele no seu próprio data center.
4. Google TPU (Ironwood): a resposta dos hiperescaladores
Melhor para: equipes que já estão no Google Cloud e quem precisa de capacidade de serviço em hiperescala em vez de uma única caixa de baixa latência.
Se o Groq 3 LPX representa "o chip da NVIDIA focado em inferência", o Ironwood é a versão do Google da mesma ideia. O Google chama o Ironwood de sua TPU de sétima geração e "a primeira projetada especificamente para inferência", feita para a "era da inferência" e para modelos de raciocínio. Cada chip entrega 4.614 TFLOPs FP8 e 192 GB de HBM a cerca de 7,37 TB/s, e um superpod completo liga 9.216 chips refrigerados a líquido em 42,5 ExaFLOPs compartilhando 1,77 petabyte de HBM.
O contraste mais nítido com a Groq é o modelo de compra: você não pode comprar uma TPU. É somente aluguel, somente no Google Cloud, cobrado por chip-hora. A história de escala, porém, é real. O principal cliente do Google é a Anthropic, que planeja acessar até 1 milhão de TPUs para treinar e servir o Claude.
Prós: design focado em inferência, escala enorme de pods, forte preço-desempenho em escala e um caminho de portabilidade (o vLLM em TPU permite alternar entre GPU e TPU com pequenas mudanças de configuração). Contras: dependência total do Google Cloud, nenhuma placa para comprar, e o Ironwood sob demanda não é barato.
Preços e acesso: alugada por chip-hora, a partir de US$ 12,00 sob demanda em us-central1, caindo para US$ 5,40 com compromisso de três anos. Veredito: se você já vive no Google Cloud ou precisa de uma frota de serviço em vez de uma única caixa rápida, o Ironwood é a alternativa natural. Se você quer silício que controla, é o oposto.
5. AWS Trainium: a melhor economia de tokens dentro da AWS
Melhor para: equipes na AWS que querem tokens mais baratos e se contentam em servir via Bedrock ou EC2 em vez de perseguir a velocidade máxima.
O argumento da AWS não é "a mais rápida", é "a mais barata por token", e esse é um eixo realmente diferente. O Trainium agora é posicionado tanto para inferência quanto para treinamento: a AWS afirma que as instâncias Trn2 entregam 30-40% melhor preço-desempenho do que suas instâncias P5e e P5en baseadas em NVIDIA H200, e o Trainium3 anunciado (seu primeiro chip de IA de 3 nm) promete até 4,4x o desempenho dos UltraServers Trn2. A linha mais antiga Inferentia2 afirma 40% melhor preço-desempenho e 50% melhor desempenho por watt nas instâncias Inf2.
A principal prova é a Anthropic, citada diretamente na página do Trainium: um Claude 3.5 Haiku otimizado para latência que roda 60% mais rápido no Trainium2 via Bedrock, e o Project Rainier, um cluster de centenas de milhares de chips Trainium2.
Prós: economia real de custos dentro da AWS, integração profunda com Bedrock e SageMaker e UltraServers em escala de rack (64 chips no Trn2, 144 no Trn3) para os maiores trabalhos. Contras: somente AWS e somente aluguel, e roda no Neuron SDK em vez de CUDA, então cargas comuns de PyTorch e vLLM migram com facilidade, mas kernels CUDA escritos à mão precisam ser portados.
Preços e acesso: aluguel via EC2 ou consumo pelo Bedrock. O Inf2 tem tarifas por hora publicadas de US$ 0,76 a US$ 12,98 sob demanda; os UltraServers Trn2 e Trn3 são sob cotação. Veredito: se sua infraestrutura já vive na AWS, esta é a aposta em preço-desempenho, especialmente para serviço constante em que o custo por token importa mais que os últimos milissegundos.
6. AMD Instinct: tenha o silício e fique com mais memória
Melhor para: equipes que querem comprar silício de mercado, manter modelos grandes residentes na memória e evitar uma stack só da NVIDIA.
Se você quer uma GPU de verdade que possa ter, a AMD é a principal alternativa à NVIDIA, e todo o seu argumento para inferência é a memória. A MI355X já à venda traz 288 GB de HBM3E a 8 TB/s e 10,1 PFLOPs de MXFP4, e a série MI400 anunciada chega a 432 GB de HBM4 a 23,3 TB/s. A AMD afirma que suas MI455X e MI430X oferecem 50% mais capacidade de memória que a GPU Vera Rubin da NVIDIA, o que importa quando um modelo maior ou um cache KV mais longo cabe em um chip em vez de ser dividido.
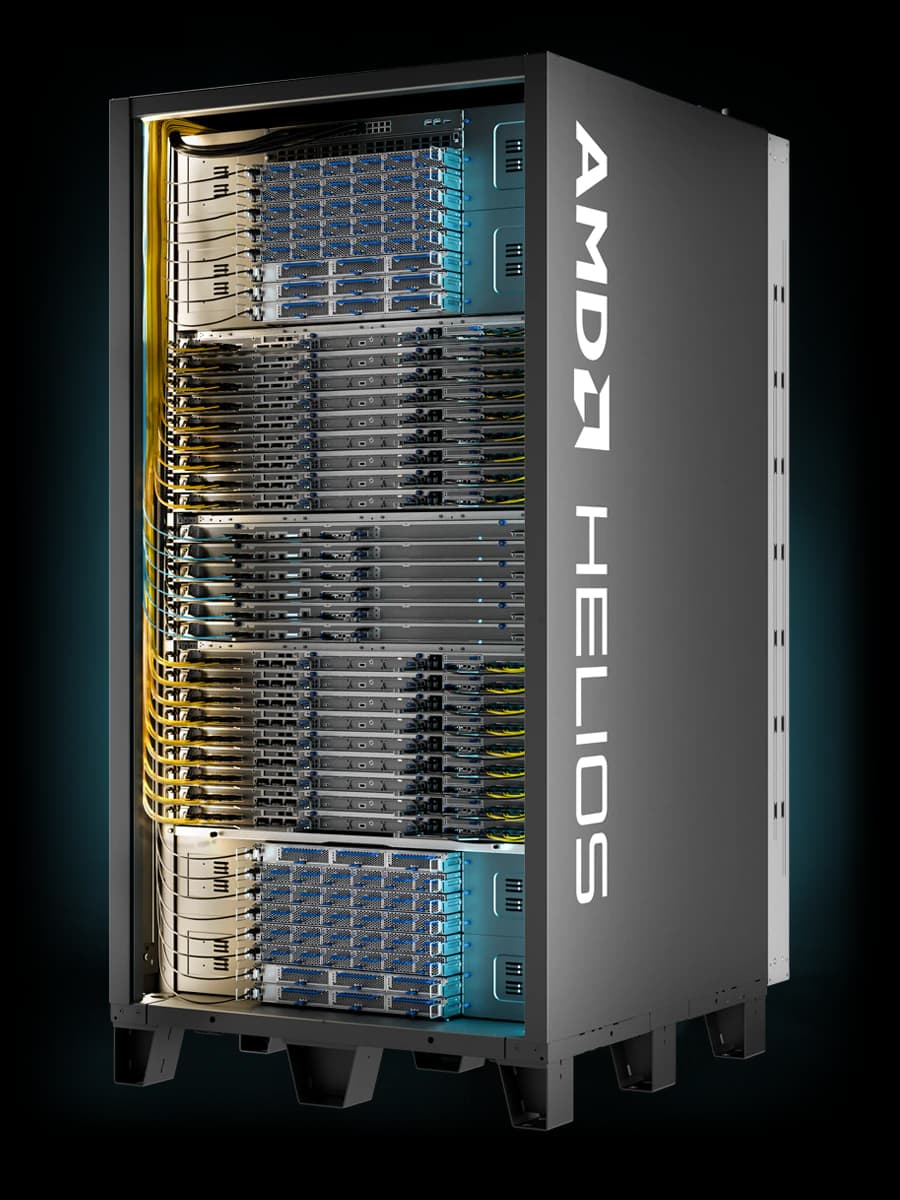
Em escala de rack, o sistema AMD Helios reúne 72 GPUs MI455X para até 2,9 exaFLOPS de MXFP4 e 31 TB de HBM4. O software roda na stack aberta ROCm, agora na versão ROCm 10.0, com vLLM e SGLang para servir.
Prós: mais HBM por GPU que o equivalente da NVIDIA, uma stack de software aberta, opções reais em escala de rack e nenhuma dependência de rede proprietária. Contras: o ROCm recuperou muito terreno, mas a crítica honesta ainda é a maturidade do ecossistema em relação ao CUDA, e algumas das melhores especificações estão na geração MI400, que ainda não é vendida.
Preços e acesso: compre por OEMs ou teste a MI300X na AMD Developer Cloud via parceiros como DigitalOcean e Vultr. Veredito: a escolha padrão se você quer ter silício de inferência, rodar modelos famintos por memória e manter as opções de software abertas. Compete em capacidade e abertura, não em ser o fluxo único mais rápido.
7. Intel Gaudi 3: custo-benefício e Ethernet padrão
Melhor para: compradores sensíveis a custo que querem um acelerador capaz e preferem escalar sobre Ethernet padrão em vez de uma rede proprietária.
O Gaudi 3 da Intel joga a carta do custo-benefício, e sua aposta característica é a rede. Cada acelerador Gaudi 3 tem 24 portas de 200 GbE RoCE integradas à placa, para 1.200 GB/s de largura de banda bidirecional sobre Ethernet padrão. O enquadramento da Intel é direto sobre a troca que ela quer que você faça: evitar "tecnologias proprietárias e fechadas como NVLink, NVSwitch e InfiniBand" e usar o equipamento de rede que você já tem. Em computação, traz 128 GB de HBM a 3,7 TB/s e 1,8 PFLOPS de FP8.
Vale saber sobre o roadmap: o Gaudi 3 está no fim de sua linha. O chip de inferência que a Intel declara como futuro é uma nova GPU, a "Crescent Island", construída na arquitetura Xe3P com 160 GB de LPDDR5X e refrigeração a ar, com amostras para clientes previstas para o segundo semestre de 2026. Então, se você compra o Gaudi 3 hoje, compre pelo custo-benefício agora, não por um roadmap longo.
Prós: posicionamento agressivo de preço, bastante HBM por placa e Ethernet padrão que evita a dependência de interconexão proprietária. Contras: compete em custo e não em velocidade pura, e o roadmap claramente migra para outra linha de chips, então é uma compra de custo-benefício, não uma aposta de longo prazo.
Preços e acesso: compre via OEMs como Dell, HPE e Supermicro, ou use na IBM Cloud, que o vende com o lema de "metade do custo". Veredito: uma escolha sensata se o orçamento é apertado e seu data center é nativo em Ethernet. Só entre sabendo que o Crescent Island é o verdadeiro futuro de inferência da Intel.
8. d-Matrix Corsair: o especialista apostando na memória
Melhor para: equipes obcecadas por latência que podem implantar o próprio hardware e querem apostar cedo em uma arquitetura de inferência feita sob medida.
A d-Matrix é a carta coringa e mira exatamente o problema que o LPX ataca: geração de tokens de latência ultrabaixa e lotes pequenos para cargas agênticas e de raciocínio. Sua placa Corsair usa Digital In-Memory Compute, colocando a computação bem ao lado da SRAM do chip para driblar o muro da memória. Os números de destaque chamam a atenção: 60.000 tokens por segundo a 1 ms por token para o Llama3 8B em um único servidor, e 30.000 tokens por segundo a 2 ms para o Llama3 70B em um rack, com a d-Matrix afirmando cerca de 10x a velocidade interativa e até 5x a eficiência energética de uma H100 (projeções próprias).
A Corsair entrou em produção plena em junho de 2026, e a empresa levantou uma Série C de US$ 275 milhões em novembro de 2025 (com valuation reportado de cerca de US$ 2 bilhões), com investidores como a M12 da Microsoft e a Temasek.
Prós: uma arquitetura projetada do zero para inferência de baixa latência, fortes alegações de eficiência e financiamento sério por trás. Contras: é somente hardware, sem API pública, seus números são projeções do fornecedor e não testes independentes, e apostar no silício de uma startup é um risco diferente de alugar de um hiperescalador.
Preços e acesso: compre as placas, servidores ou sistemas SquadRack; não há endpoint de nuvem de autoatendimento. Veredito: a aposta arriscada mais interessante desta lista. Se você tem a equipe para montar silício e quer chegar cedo à computação em memória, vale um olhar sério. Para todo mundo, é uma para acompanhar.
A diferença real entre esses chips é a aposta na memória
Se você se afastar do marketing, as oito alternativas se dividem em três campos por uma única decisão: como lidam com a memória. Essa escolha explica a maior parte das diferenças nas fichas técnicas que você acabou de ler.
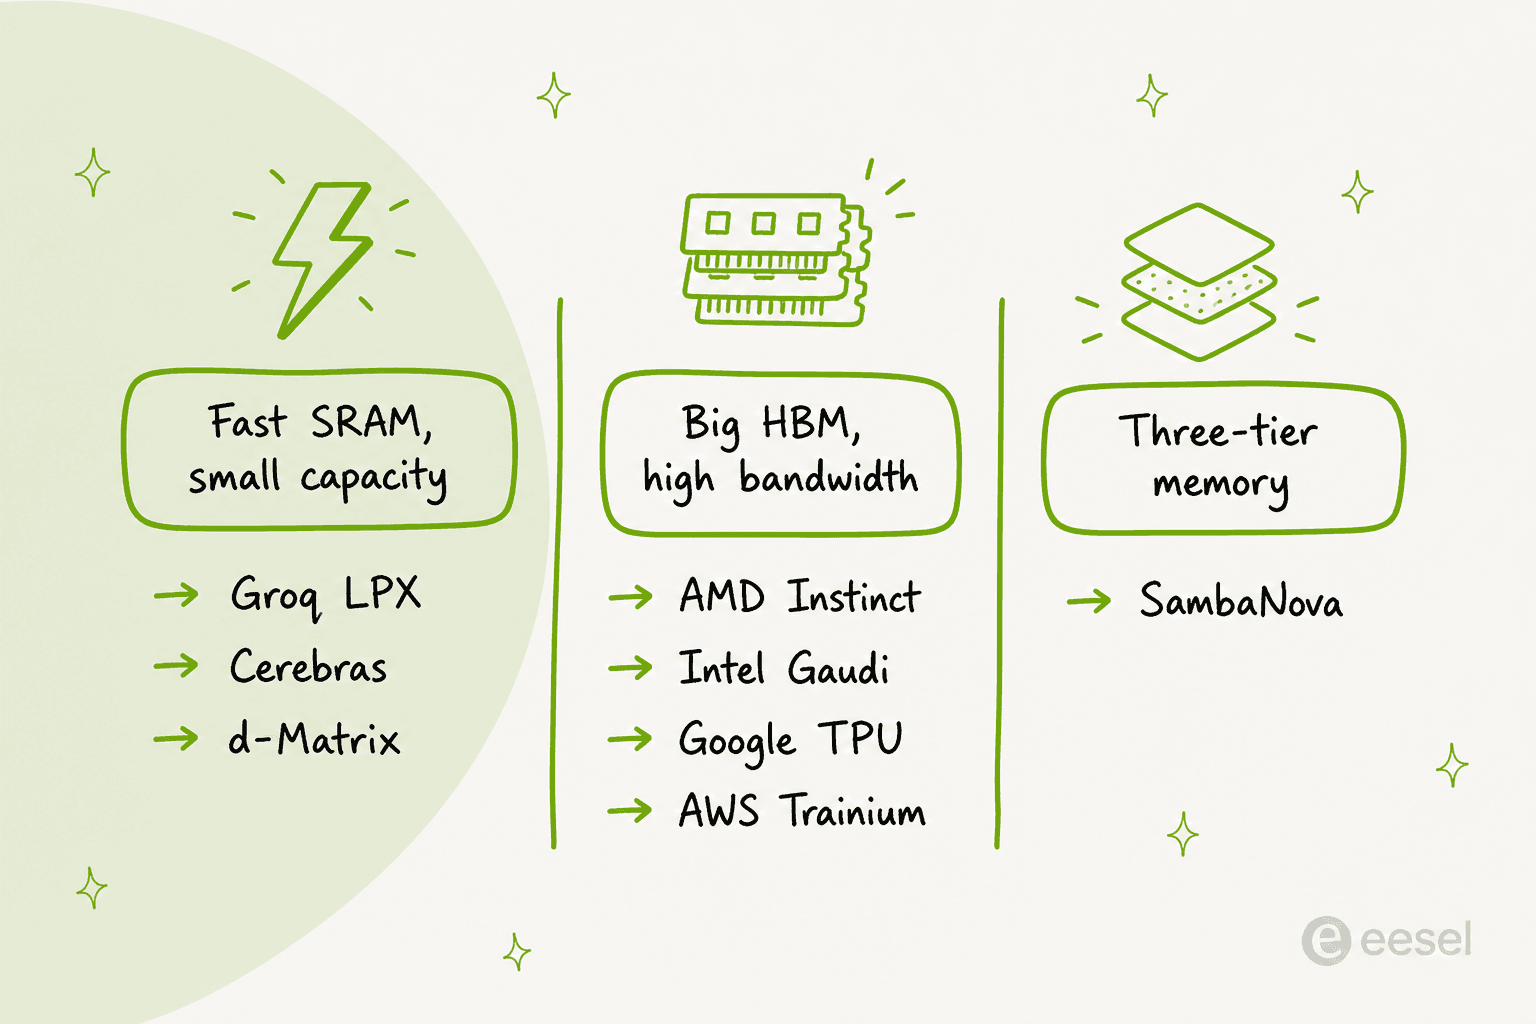
- SRAM rápida, pouca capacidade. Groq, Cerebras e d-Matrix mantêm os dados de trabalho em SRAM ultrarrápida no chip. Isso faz a geração de tokens parecer instantânea, mas cada chip guarda muito pouco, então você precisa de muitos para caber um modelo grande.
- HBM grande, alta largura de banda. AMD, Intel, Google e AWS carregam bastante memória de alta largura de banda por acelerador. Isso permite que um modelo grande e um cache KV longo caibam em menos chips, e é por isso que a AMD insiste tanto na vantagem de memória por GPU.
- Memória de três níveis. A SambaNova fica no meio-termo com SRAM, HBM e DDR5, podendo manter muitos modelos grandes residentes e alternar entre eles rapidamente, uma propriedade que as cargas de agentes valorizam.
Não existe resposta universalmente certa aqui. Se sua carga é chat rápido em um modelo pequeno, o campo da SRAM vence. Se é um modelo gigante ou um agente multimodelo, a capacidade vence. Dizer em qual campo você está mostra qual das oito pré-selecionar mais rápido que qualquer benchmark.
A pergunta maior: você provavelmente não vai comprar um rack
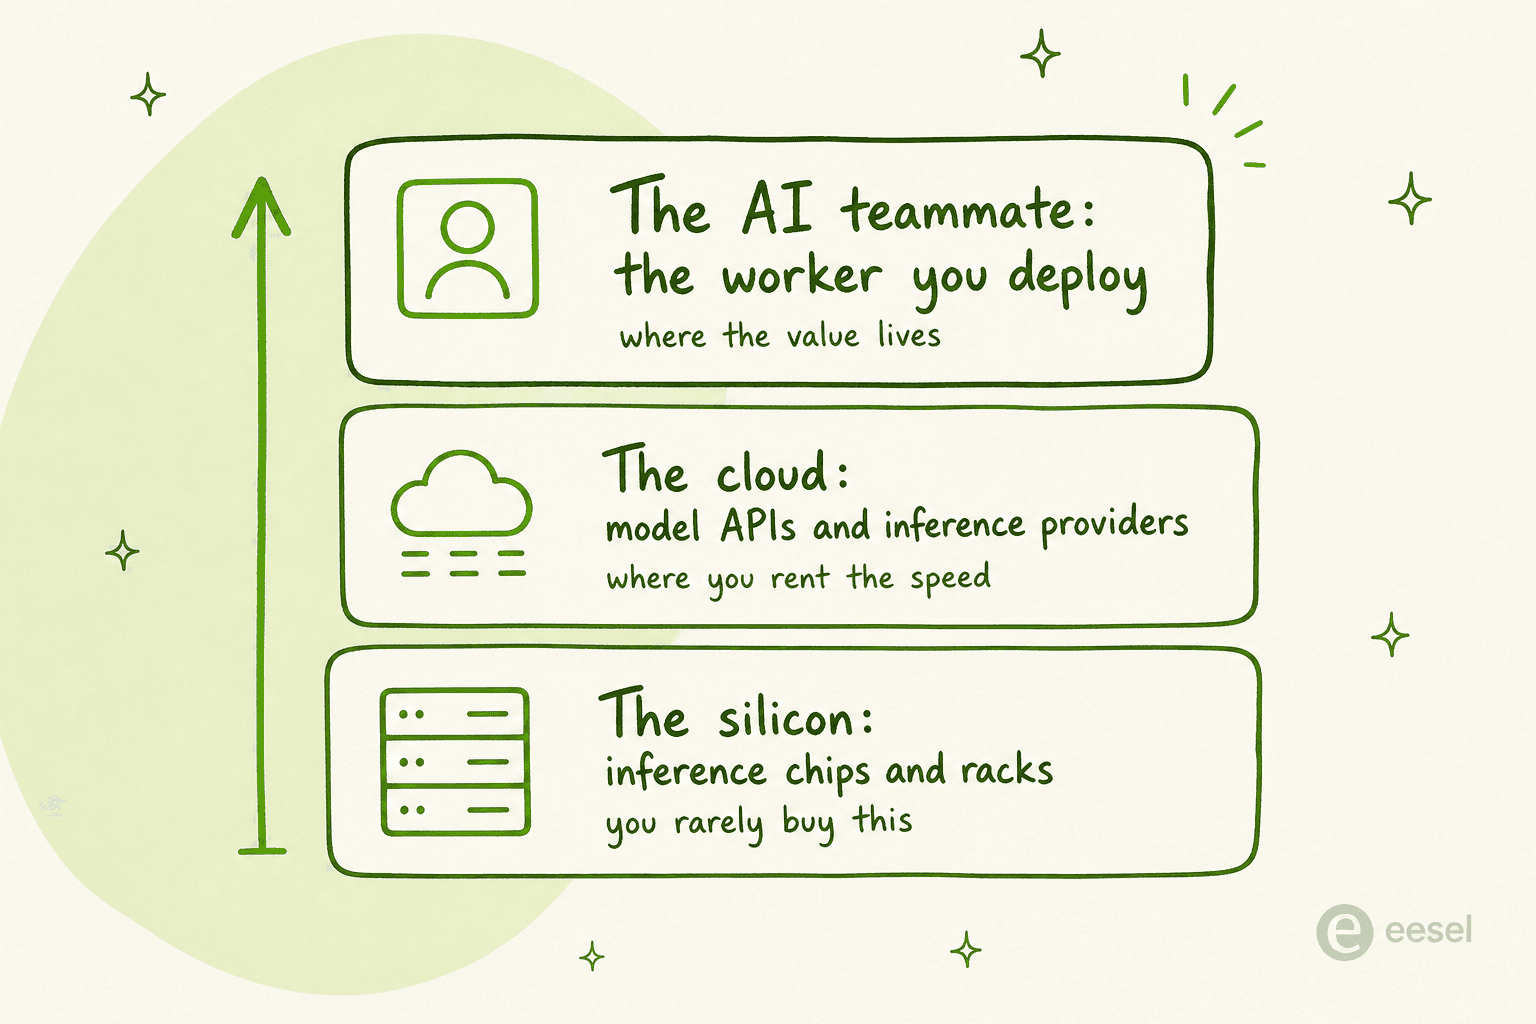
Esta é a parte em que mais quero ser direto, porque é fácil se perder em petaflops. A menos que você opere uma nuvem ou uma plataforma de IA muito grande, você não vai comprar o Groq 3 LPX nem a maioria de suas alternativas. Esta é uma infraestrutura que fica várias camadas abaixo de onde o trabalho realmente acontece. Você vai senti-la como tokens mais rápidos e baratos nas APIs de modelos e nuvens que já usa, do mesmo jeito que você nunca comprou uma GPU para usar um agente de IA.
E essa mudança nas cargas de trabalho é exatamente o motivo de todo esse silício existir. Como um analista disse no X:
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
A reformulação útil é que o chip é o motor, e o que você realmente implanta é o trabalhador montado em cima dele. Inferência mais rápida torna os agentes mais ágeis e baratos de rodar, o que reduz a barreira para colocar automação real em produção e desloca a conta de custos contra fazer o trabalho à mão, seja um agente de programação, um agente de pesquisa ou um agente de IA para helpdesk atendendo sua fila de suporte. A corrida do hardware serve para tornar essa camada viável em escala. O valor continua na camada. Se quiser entender por que a latência é tão sensível, analisamos separadamente os custos de inferência de LLMs.
Onde a eesel se encaixa, e por que ela não liga para qual chip você escolheu
Todo chip desta lista é tubulação. A eesel é o que você contrata para fazer o trabalho por cima. A eesel é uma plataforma de colegas de IA: em vez de provisionar inferência ou montar um pipeline, você traz um colega pronto para trabalhar em uma função específica e o conecta aos seus apps. O elenco atual inclui um colega de IA para helpdesk que entra na sua fila de suporte como muito mais que um simples chatbot de suporte, e um redator de blog com IA que produz conteúdo como este artigo.

O motivo de a escolha do chip não afetar você de verdade é que a eesel roda sobre qualquer inferência que esteja por baixo, e o que decide se ela é boa não é tokens por segundo. É precisão. Os anos que passamos rodando IA em filas de suporte reais nos ensinaram a metade pouco glamorosa: um colega de suporte que responde em um segundo em vez de oito é toda a experiência para o cliente que espera, mas a velocidade só ajuda se a resposta estiver certa. Essa é a diferença entre um agente que realmente desvia tickets de nível 1 e um que só frustra as pessoas, e é por isso que a eesel simula uma implantação com seus tickets passados antes de responder a um cliente ao vivo. Todo o silício do mundo não conserta uma resposta errada dita com confiança. Se você prefere implantar o colega a procurar um rack, pode experimentar a eesel de graça.