

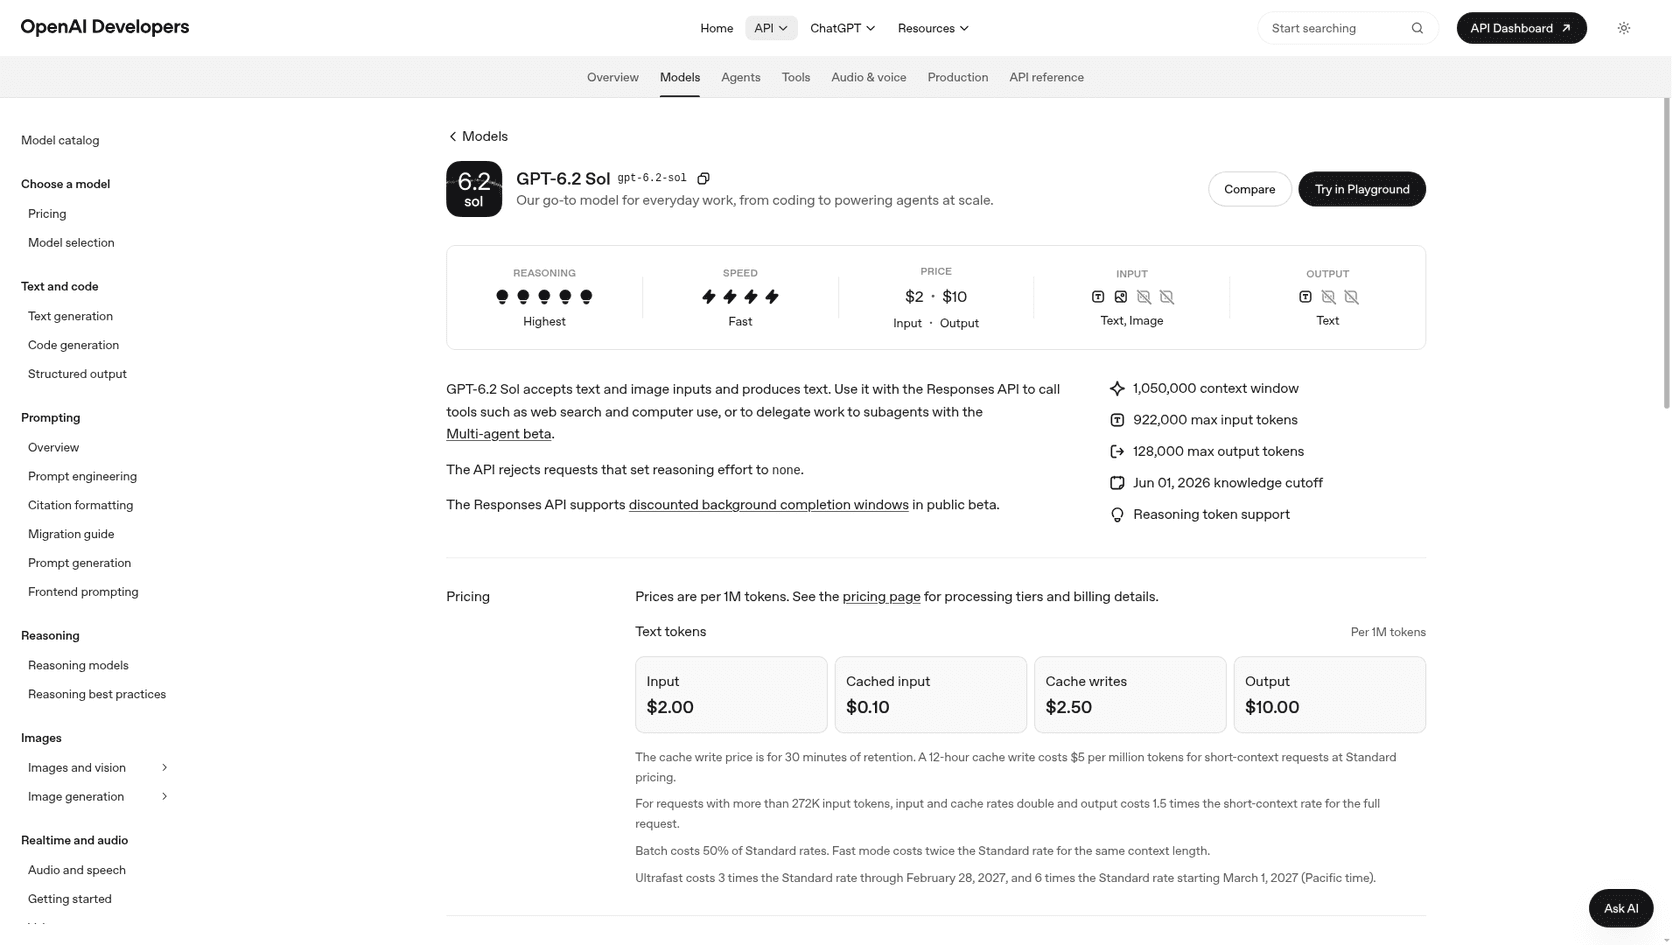
O GPT-6.2 Sol é o modelo com a melhor relação custo-benefício que a OpenAI vende agora: $2/$10 por milhão de tokens, 57 no Artificial Analysis, no mesmo nível do antigo GPT-6 Astra, e cerca de três vezes mais rápido por tarefa que o GPT-6.1 Sol. A crítica é real, mas específica: desenvolvedores dizem que ele ainda projeta código em excesso, e o Artificial Analysis mediu uma queda de 3 pontos em código.
Nos meus 77 testes, ele nunca inventou um fato sobre a empresa. O hábito dele é adicionar coisas que os dados nunca continham, como links de rastreamento da FedEx e contagens de dias. Isso é inofensivo em um rascunho e arriscado em uma resposta ao cliente. Para o suporte, um colega de equipe de IA de helpdesk bem fundamentado como o eesel importa mais do que o modelo por baixo.
O que é o GPT-6.2 Sol, e como eu o testei?
O GPT-6.2 Sol é o modelo do dia a dia da OpenAI, lançado em 17 de novembro de 2026 junto com o GPT-6.2 Astra. O post de lançamento da OpenAI o chama de "our efficient, versatile model for everyday work". Ele substitui o GPT-6.1 Sol pelo mesmo preço, e a visão geral do GPT-6.2 Sol traz todos os detalhes do lançamento.
Eu construo integrações e a infraestrutura de API na eesel, então leio uma análise de modelo como leria um changelog de API: o que ele realmente faz quando meu código o chama? Os gráficos de lançamento não respondem a isso, então nesta semana executei 77 chamadas ao GPT-6.2 Sol pela Responses API em três pequenos testes, todos com esforço medium, salvo indicação contrária:
- 15 tickets de suporte, com esforço low e medium, avaliados manualmente contra uma política de reembolso (30 execuções). Os resultados estão na visão geral do GPT-6.2 Sol.
- 19 execuções sobre as queixas levantadas a respeito do Astra: escrita curta, falhas silenciosas de ferramentas e fatos inventados sobre a empresa. Essas foram executadas junto com o Astra na análise do GPT-6.2 Astra.
- 28 novas execuções para esta análise, contra 28 no GPT-6.1 Sol: seis perguntas de política que cada uma precisa de dois ou três fatos para uma resposta completa, repetidas três vezes, mais dois tickets de rastreamento de pedidos repetidos cinco vezes.
É um teste pequeno e lido manualmente, não um benchmark. Se você quiser repetir isso na sua própria configuração, a CLI do eesel permite que um agente de programação faça o mesmo tipo de perguntas de teste a um agente de helpdesk do eesel e verifique as respostas antes de qualquer coisa ir ao ar. Cada execução passa pelo documento de política de uma empresa SaaS fictícia e por uma ferramenta lookup_order padronizada, construída com chamadas de função. Isso mostra como o modelo se comporta em trabalho de suporte limpo e cotidiano, que é a maior parte do suporte.
Qual é o meu veredito sobre o GPT-6.2 Sol?
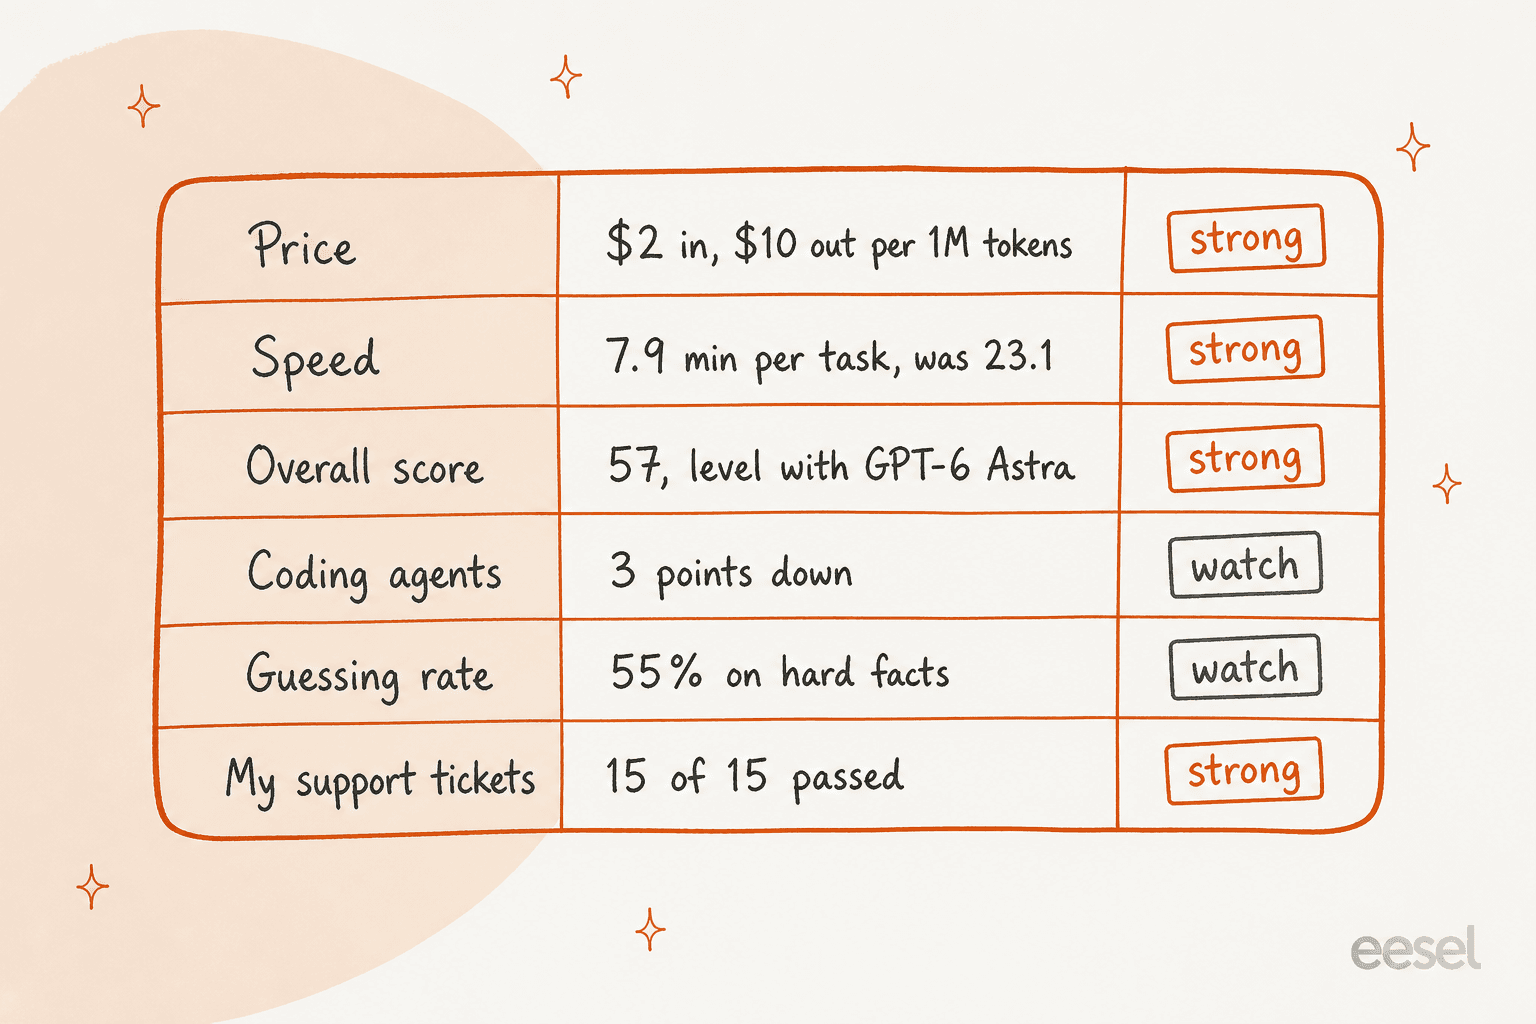
O GPT-6.2 Sol é uma ótima opção padrão para trabalho de rotina, a um preço que nada na sua categoria alcança, com dois hábitos a gerenciar: ele projeta código em excesso e adiciona detalhes em torno dos fatos. Aqui está o placar:
| O que verifiquei | GPT-6.2 Sol | Fonte |
|---|---|---|
| Preço por 1M de tokens | $2 entrada, $0.10 em cache, $10 saída | Preços da OpenAI |
| Intelligence Index (esforço máximo) | 57, subindo de 55 | Artificial Analysis |
| Custo por tarefa de benchmark (máx.) | $1.01, caindo de $1.27 | Artificial Analysis |
| Tempo por tarefa de benchmark (máx.) | 7,9 min, caindo de 23,1 | Artificial Analysis |
| Coding Agent Index | 3 pontos abaixo do GPT-6.1 Sol | Artificial Analysis |
| Taxa de alucinação (AA-Omniscience) | 55% | Artificial Analysis |
| Meus 15 tickets de suporte | 15/15 com low e medium | Meu teste |
| Respostas de política com vários fatos | 18/18 completas | Meu teste |
| Fatos inventados sobre a empresa | 0 de 10 | Meu teste |
| Links adicionados que a ferramenta nunca enviou | 7 de 14 respostas de pedidos | Meus testes |
O upgrade a partir do 6.1 é fácil de recomendar. Mesmo preço, nota um pouco mais alta, e as execuções com esforço máximo que antes levavam 23 minutos agora levam 8. Quem já paga pelo GPT-6.1 Sol tem poucos motivos para ficar.
O que as pessoas gostam no GPT-6.2 Sol?
A relação preço-nota. No tópico de lançamento no Hacker News, que passou de 600 comentários, quem defendia o lançamento defendia principalmente o Sol, e na maioria das vezes pelo custo:
"Whatever you’re doing, it’s unlikely to be what most users are doing. Fable and Astra aren’t in my price range so I’m paying attention to Sol."

O outro ponto recorrente é que os níveis de esforço mais altos fecham a maior parte da distância para o modelo maior e mais antigo:
"6.2 Sol xhigh and max show the results comparable to Astra 6 max, and Astra 6.2 only shows any improvement on 'max' reasoning effort level."
Isso combina com o Artificial Analysis, que coloca o Sol em 57 contra 57 do GPT-6 Astra, por cerca de 15% do custo por tarefa. Alguns desenvolvedores também descreveram uma divisão que eu copiaria: um modelo mais forte planeja, e o Sol faz o volume.
"I have hilariously started to just have an opus thread maintain Sol subagents to get the best of both worlds."
De que as pessoas reclamam?
Principalmente do excesso de engenharia, e quase tudo em código. A queixa não é nova nesse lançamento, o que a torna mais incômoda:
"It's still overengineering especially Sol. This was the biggest complaint by everybody who has been using Sol since GPT 5.6. OpenAI is not listening to us."
Em uma base de código grande, um desenvolvedor mediu a diferença para o Astra no trabalho de correção:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
Os números confirmam a direção, embora não a magnitude. O Artificial Analysis diz que o Sol "loses 3 points relative to GPT-6.1 Sol" no seu Coding Agent Index, impulsionado por uma queda de 14 pontos no SWE-Atlas-QnA-AA, onde o modelo é "more likely than its predecessor to omit key facts in its responses". Uma dica prática do tópico: outro desenvolvedor descobriu que o excesso de engenharia piora conforme o esforço aumenta, então, se o seu agente de programação continua construindo estruturas que ninguém pediu, tente um nível mais baixo antes de trocar de modelo.
Depois há a reação mais ruidosa de quem teve acesso antecipado. Matt Shumer disse no X que achou a dupla "essentially unusable" e que não as analisaria. A maior parte da crítica detalhada inicial, sobre escrita demasiado seca e execuções de código que paravam antes da hora, era sobre o Astra. Testei essas afirmações na análise do Astra, e no Sol a escrita estava boa: seu artigo de ajuda ao cliente ficou entre 168 e 170 palavras e cobriu toda a política.
O GPT-6.2 Sol deixa fatos de fora?
Não nos meus testes. Como o Artificial Analysis havia apontado omissões, escrevi seis perguntas que cada uma precisa de dois ou três fatos de política para uma resposta completa. Um administrador pode restaurar um espaço de trabalho excluído? (Sim, dentro de 14 dias, mas só o proprietário pode fazer isso.) Os assentos removidos são reembolsados? (Não, eles se tornam um crédito na próxima fatura.)
Ambos os Sol responderam às 18 execuções por completo, depois que li cada uma manualmente. A verificação por palavras-chave que programei primeiro apontou 11 falhas no 6.2 e 9 no 6.1, e cada uma delas foi um falso alarme causado por frases como "14-day window" ou um apóstrofo curvo. Isso é um alerta justo sobre avaliações automatizadas em geral: um avaliador que compara strings diria que o 6.2 Sol omite mais fatos, e não é o caso. Revisar conversas de suporte com IA manualmente continua sendo a única verificação em que confio numa amostra pequena.
O teste de falhas silenciosas foi igual. Quando uma de três buscas de pedidos retornou um {} vazio sem erro, o Sol sinalizou aquele pedido e escalou em 5 de 5 execuções. O system card da OpenAI avisa que ambos os novos modelos "were more likely to omit known obstacles when reporting their work", então eu manteria a observabilidade em qualquer agente que o execute. No trabalho de suporte curto, não consegui fazê-lo pular nenhuma vez.
O GPT-6.2 Sol inventa coisas?
Ele não inventou fatos. Mas adicionou coisas. Isso é o mais útil que aprendi sobre esse modelo.
O Artificial Analysis coloca a taxa de alucinação do Sol em 55%, a parcela de perguntas factuais difíceis às quais ele responde errado em vez de dizer que não sabe. No meu teste, com uma política que não cobria nenhuma das perguntas, questionei sobre auditorias SOC 2, residência de dados na UE, horário de atendimento por telefone, limites de taxa da API e um acordo HIPAA. O Sol não inventou nada em 10 execuções, com um prompt estrito ou um prompt vago de "seja útil". Com o prompt vago, ele disse que não tinha "informação verificada" e ofereceu conselhos gerais.
Os extras apareceram em torno dos fatos:
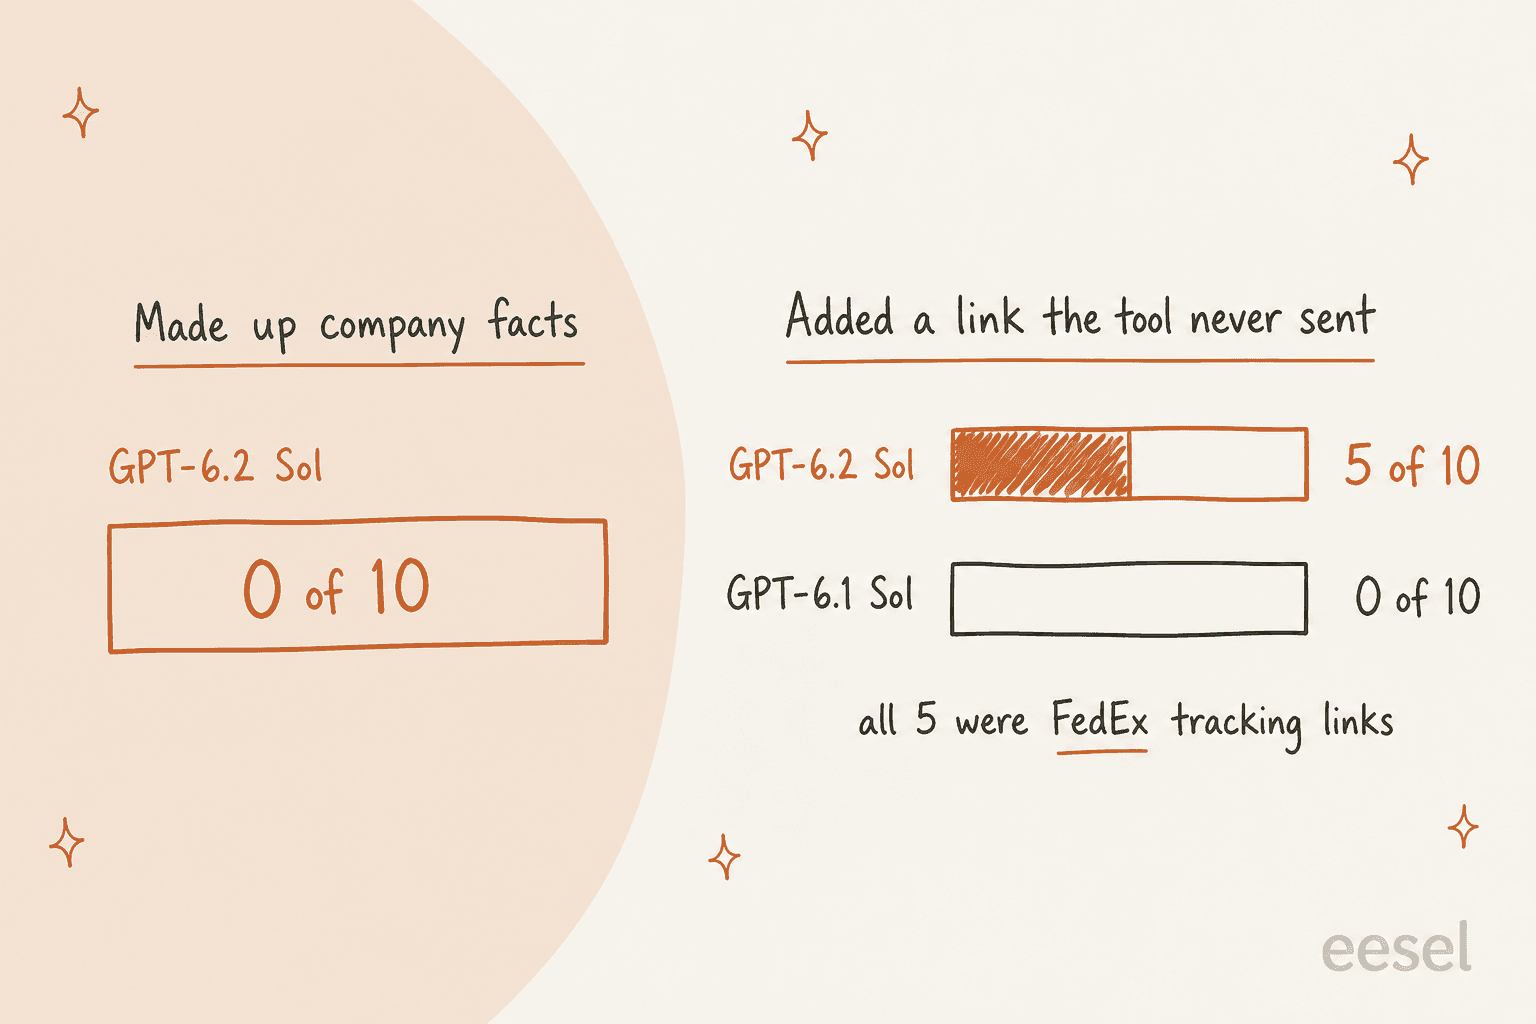
- Links de rastreamento. Minha ferramenta
lookup_orderretorna uma transportadora e um número de rastreamento, sem URL. Quando um cliente perguntou como rastrear um pedido da FedEx, o GPT-6.2 Sol construiu um link de rastreamentofedex.comem 5 de 5 execuções. O GPT-6.1 Sol sempre imprimiu o número por conta própria. No ticket simples da UPS "onde está meu pedido", o 6.2 mencionou a página de rastreamento da UPS sem link. No meu teste de tickets anterior, ele construiu linksups.comem ambos os tickets de pedidos com esforço medium, e nenhum com esforço low. Nos dois testes juntos, são 7 links em 14 respostas de pedidos, contra nenhum do 6.1. - Aritmética que nenhum pediu. Na pergunta sobre o espaço de trabalho excluído, o 6.2 Sol adicionou "restam cerca de 5 dias" nas três execuções. Isso está correto (14 menos 9) e é útil. No meu primeiro teste, ele também declarou um reembolso como "10/12 do que foi pago" sem verificar como a política conta um mês parcial, o que era uma suposição disfarçada de fato.
Nenhum dos links que verifiquei estava errado. O problema é o padrão: um modelo que constrói uma URL de transportadora a partir de um número de rastreamento vai, um dia, construir um link para um portal de devoluções ou de pagamento a partir de outra coisa. Em uma resposta ao cliente, qualquer link que suas ferramentas não retornaram é uma afirmação sem fonte. A solução é uma linha nas instruções que limite os links aos que vêm de resultados de ferramentas ou do seu centro de ajuda, mais um teste que verifique isso. Permissões do agente de suporte de IA cobre a mesma ideia para ações. Para dinheiro, veja as barreiras de reembolso.
O GPT-6.2 Sol vale o preço?
Sim, e não é nem de perto, dentro da linha da OpenAI. Veja quanto custaram meus testes de suporte nas tarifas padrão:
| Teste (esforço medium) | GPT-6.2 Sol | GPT-6.1 Sol | GPT-6.2 Astra |
|---|---|---|---|
| 15 tickets de suporte, por 1.000 | $1.42 | $1.35 | $5.79 |
| Perguntas de política e rastreamento, por 1.000 | $1.55 | $1.49 | não testado |
| Tamanho médio da resposta (perguntas de política) | 44 palavras | 40 palavras | não testado |
| Tokens médios de raciocínio (perguntas de política) | 4 | 9 | não testado |
O 6.2 Sol custa cerca de 4% a 5% mais que o 6.1 por ticket nesses testes, porque suas respostas são um pouco mais longas. Ele raciocina menos em perguntas fáceis e escreve um pouco mais, e os tokens de saída são onde o dinheiro vai. Contra o GPT-6.2 Astra, é cerca de um quarto do custo pela mesma taxa de sucesso em tickets rotineiros.
Duas coisas movem a conta mais do que a escolha do modelo. O esforço vem primeiro: o Artificial Analysis contou 14,6 milhões de tokens de saída com esforço medium contra 60,9 milhões com máximo, para 53 pontos contra 57. Depois, as rotas de desconto: o Batch reduz o preço à metade, mas ainda não há um nível Flex para esse modelo. A visão geral do GPT-6.2 Sol tem a tabela de preços completa, incluindo a sobretaxa de contexto longo acima de 272.000 tokens de entrada.
Quem deveria usar o GPT-6.2 Sol, e quem deveria pular?
A maioria das equipes deveria torná-lo o padrão e isolar as exceções:
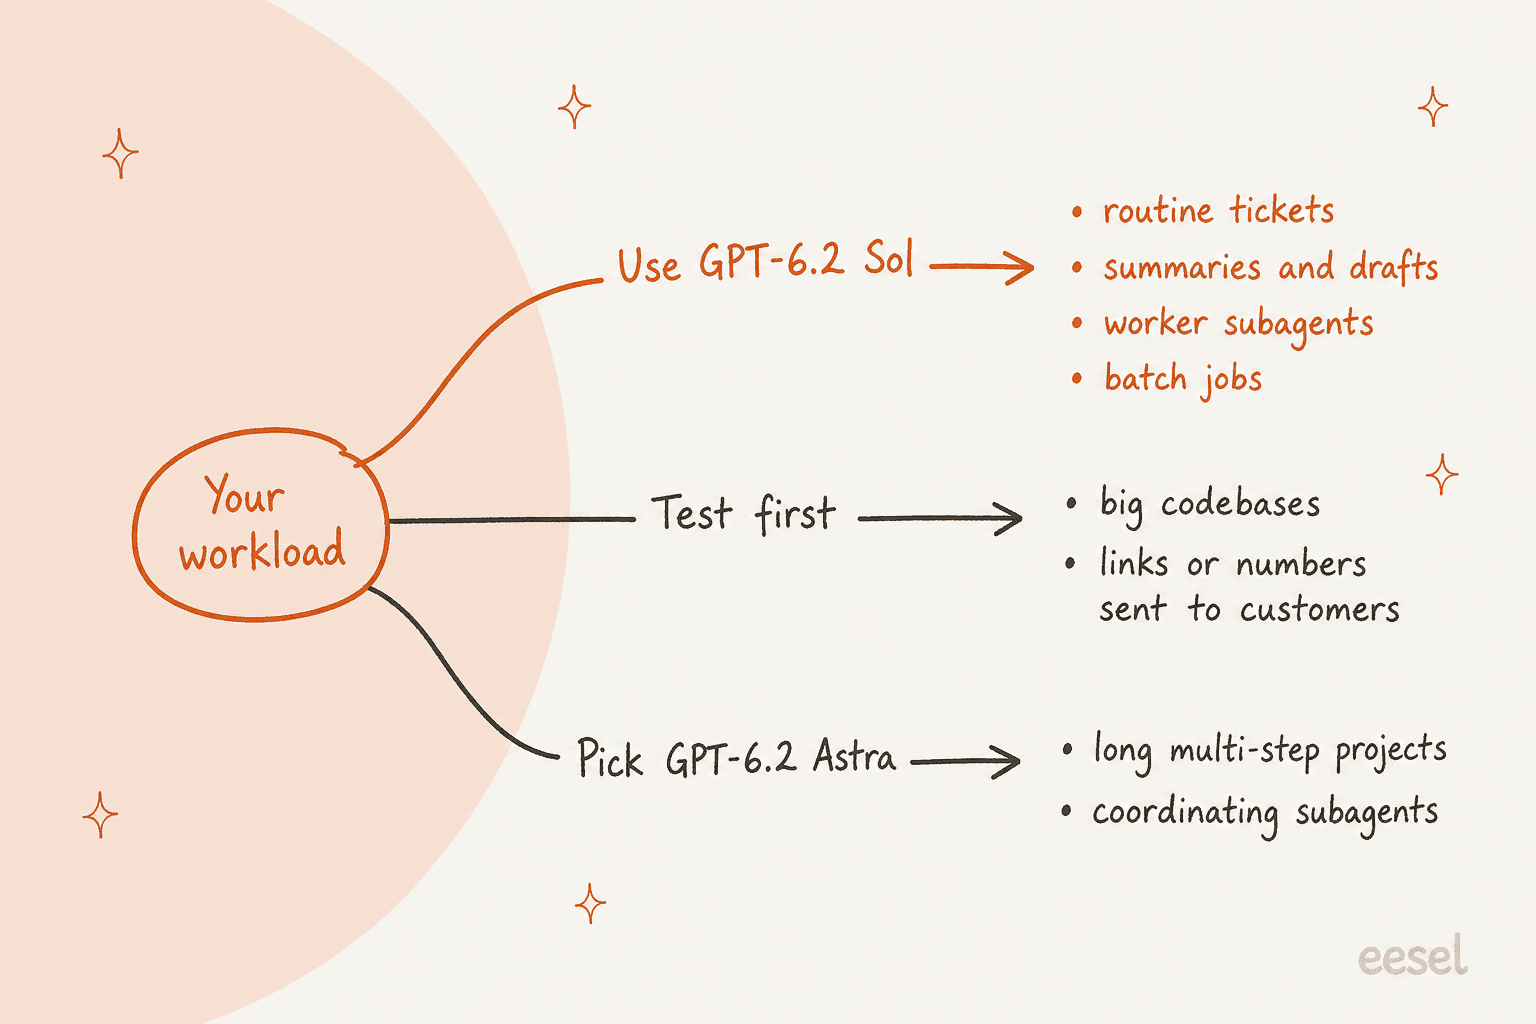
| Se você está... | Minha opinião |
|---|---|
| No GPT-6.1 Sol ou no GPT-6 Sol | Troque. Mesmo preço, mais rápido, um pouco mais inteligente. Execute suas avaliações de código novamente primeiro. |
| Executando um agente de programação em um repositório grande | Teste antes de trocar. O índice de código caiu e as queixas de excesso de engenharia são consistentes. Mantenha o Codex no Astra para as tarefas difíceis. |
| Executando respostas de suporte ou rascunhos | Use-o, com uma regra sobre links e números e um conjunto de testes dos seus próprios tickets. |
| Construindo um orquestrador e trabalhadores | Sol como trabalhador, um modelo mais forte como planejador. |
| Comparando com o Claude Sonnet 5.5 ou o Claude Opus 5.5 | Passe seus próprios tickets por ambos. Benchmarks não vão te dizer nada sobre tom ou aderência à política. |
| Priorizando preço e aberto a outros laboratórios | Veja o resumo de alternativas ao GPT-6.1 Sol e o DeepSeek V4 Flash. |
O artigo sobre o melhor LLM para atendimento ao cliente compara o campo mais amplo, caso o Sol não seja a escolha certa.
O que isso significa para uma equipe de suporte?
Um modelo mais barato e mais rápido é melhor infraestrutura, não um agente de suporte melhor. Meu teste mostra a lacuna com clareza: o Sol sabe que não deve inventar o status do seu SOC 2, mas ainda assim entregará a um cliente um link que seus sistemas nunca produziram. O que fecha essa lacuna é a camada em torno do modelo: o que ele pode consultar, o que pode dizer e o que repassa para uma pessoa.
A STIL Classics, uma marca de agendas e papelaria no Gorgias e no Shopify, opera o eesel com essa regra incorporada. Antes de redigir, o eesel consulta o pedido no Shopify, seu status de envio e o estoque em tempo real, e nunca afirma uma data de envio, uma estimativa de entrega ou uma especificação de produto que não verificou. Se não encontra o pedido, sinaliza isso para a equipe em vez de dizer ao cliente. Em um mês, preparou cerca de 320 tickets do Gorgias e consultou cerca de 230 pedidos do Shopify, e cada rascunho passa por uma pessoa para revisar e enviar.
É isso que o eesel constrói: colegas de equipe de IA que você contrata para tarefas específicas, um colega de equipe de IA de helpdesk para sua fila e um redator de blog com IA para conteúdo. O modelo por baixo pode mudar de 6.1 para 6.2 sem que suas regras mudem com ele. A partir de um terminal, um agente de programação como o Claude Code ou o Codex pode enviar macros e artigos de ajuda aprovados pela CLI e reforçar as instruções do agente (por exemplo, "só compartilhar links retornados por uma consulta"). Conectar o próprio helpdesk ainda exige que alguém com acesso de administrador aprove.
Se você está escolhendo um modelo para suporte, teste-o nos seus próprios tickets antigos antes que ele toque em um ao vivo. A comparação de modelos para tickets de suporte coloca os números em contexto. Os benchmarks de custo por ticket mostram onde o gasto com modelo se encaixa em um ticket completo, e o resumo do melhor software de helpdesk com IA compara as ferramentas que permitem fazer esse teste.
Testar o eesel
Se o GPT-6.2 Sol te fez pensar em IA na sua fila, a parte que decide se os extras dele chegam a um cliente é o colega de equipe em torno dele. O eesel se conecta ao seu helpdesk, aprende com seus tickets antigos e seu centro de ajuda, e permite que você o execute contra seus tickets históricos para ler as respostas dele, links incluídos, antes de entrar no ar. Os planos são pacotes fixos de créditos a partir de $299 por 500 créditos, então a conta não se move com os preços dos tokens nem com o tamanho das respostas.

Você pode testar o eesel de graça em uma parte da sua fila, ou ler como ele se compara a usar o ChatGPT diretamente se ainda estiver pesando construir por conta própria.