
Resumo
O GPT-6.1 Sol foi lançado na DevDay da OpenAI em 29 de setembro de 2026, exatamente uma semana depois do GPT-6 Sol. O Sol da semana passada foi um corte de preço com número de versão novo. Este é o oposto: mesmo preço de $2/$10, um salto real de capacidade.
- Chega perto do Astra. A OpenAI reporta que ele iguala o GPT-6 Astra em programação no DeepSWE a cerca de um quinto do custo, e fica a 2.1 pontos do Astra no OSWorld 2.0 (uso do computador) a aproximadamente um sétimo do custo por tarefa.
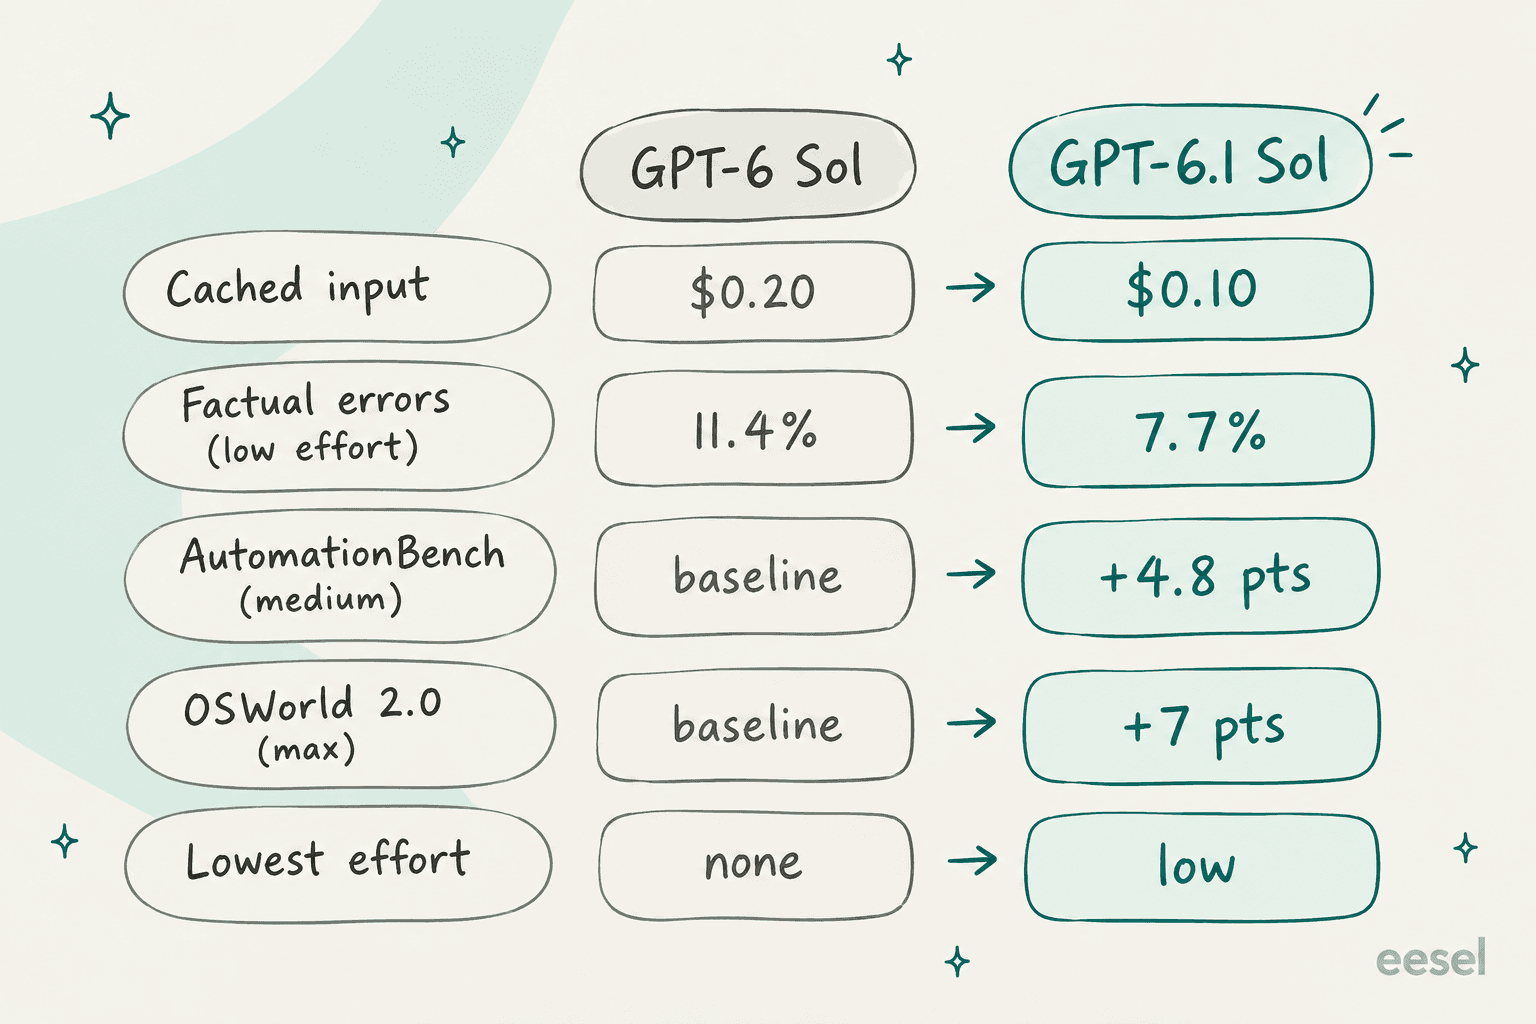
- O preço quase não mexeu, e uma parte ficou mais barata. O preço padrão da API continua em $2 de entrada e $10 de saída por milhão de tokens, mas a entrada em cache cai pela metade, para $0.10 por milhão.
- As pegadinhas são pequenas, mas reais. O esforço de raciocínio
nonesaiu, o Chat Completions funciona sem chamadas de ferramentas, ainda não está no Chat comum do ChatGPT e o nível Ultrafast está "chegando em breve".
Minha leitura: para a maioria das equipes, o GPT-6.1 Sol faz do Astra uma ferramenta de especialista, não a escolha padrão. Se você cuida de uma fila de suporte, um modelo mais esperto continuará sem saber a sua política de reembolso. O que move a taxa de resolução é o agente de IA para helpdesk montado em volta dele, que é o trabalho do eesel, testado primeiro nos seus próprios tickets antigos.
O que o GPT-6.1 Sol realmente é
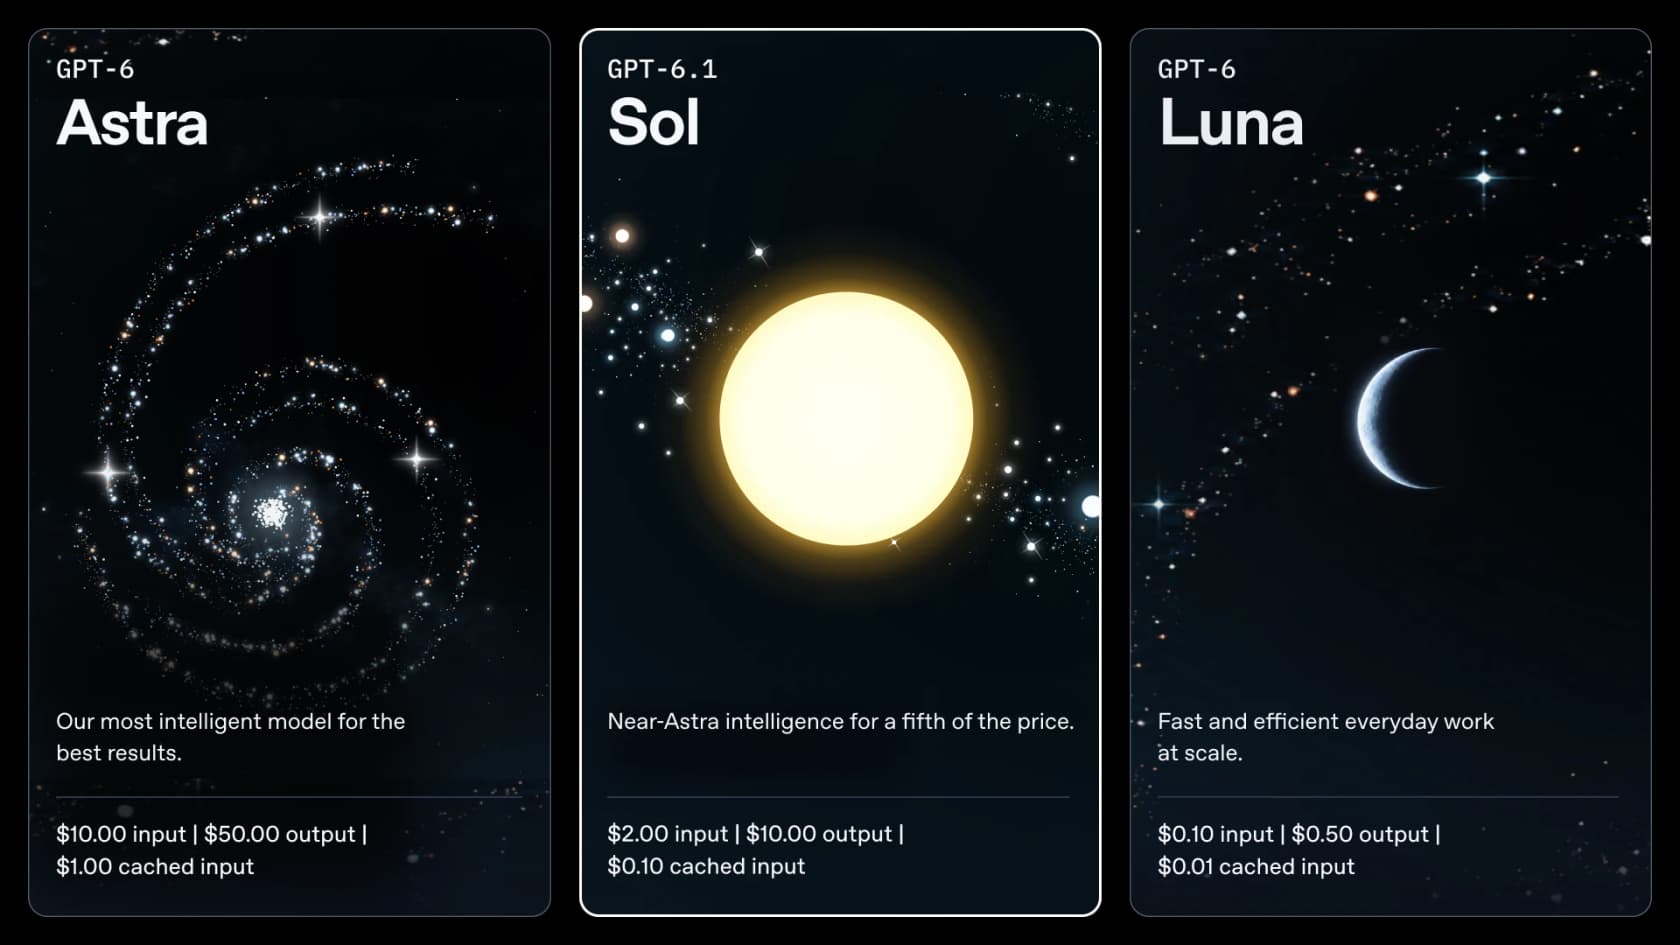
O GPT-6.1 Sol é uma atualização do modelo intermediário da família GPT-6 da OpenAI. Assim, a família agora fica assim: o Astra no topo, o 6.1 Sol no meio e o GPT-6 Luna lá embaixo. O slogan que a OpenAI escolheu é "Inteligência quase de Astra por um quinto do preço", e essa frase também aparece impressa nos cartões de preço do lançamento.
Boa parte do que escrevo sobre modelos de IA vem do lado das buscas, e a intenção de busca aqui é fácil de ler. Quem pesquisa "GPT-6.1 Sol" um dia depois do lançamento não está perguntando o que é um modelo de linguagem, está perguntando uma coisa só: ainda preciso pagar pelo Astra? Foi em torno dessa pergunta que montei este texto.
Na página do modelo, a ficha técnica é quase igual à do antecessor. O id do modelo é gpt-6.1-sol, com janela de contexto de 1,050,000 tokens, 128,000 tokens de saída máxima e data de corte de conhecimento em 30 de abril de 2026 (dez dias depois dos 20 de abril do GPT-6 Sol). A entrada pode ser texto ou imagem, e o retorno é texto. Na Responses API, ele aceita busca na web, busca em arquivos, interpretador de código, shell hospedado, apply patch, skills, uso do computador, busca de ferramentas e MCP. Há também residência de dados nos EUA e na UE, embora, se você escolher a residência na UE, o modo Fast não esteja disponível.
O que mudou em relação ao GPT-6 Sol, uma semana depois
Quando o GPT-6 Sol saiu, em 22 de setembro, o resumo honesto era "a mesma inteligência do GPT-5.6 Sol pela metade do preço". A Artificial Analysis o colocou apenas cerca de um ponto acima do GPT-5.6 Sol no seu Intelligence Index, e não muito mais. O GPT-6.1 Sol é o lançamento em que a capacidade realmente começa a se mover.
Segundo o post de lançamento da OpenAI, estas são as diferenças em relação ao GPT-6 Sol:
- Programação: no DeepSWE v1.1, supera a melhor pontuação do GPT-6 Sol em 6.4 pontos percentuais, com menor esforço de raciocínio e menor custo.
- Fluxos de trabalho empresariais: no AutomationBench, sobe 4.8 pontos em relação ao GPT-6 Sol com esforço médio.
- Uso do computador: no conjunto offline do OSWorld 2.0, supera o GPT-6 Sol por 7 pontos com esforço máximo, a menos da metade do custo.
- Ciência: no Terminal-Bench Science 0.1, mais do que dobra a pontuação do GPT-6 Sol com esforço máximo.
- Factualidade: com esforço baixo, a parcela de respostas com erro factual cai de 11.4% para 7.7%, uma redução de cerca de 32%.
Algo também mudou na segurança. O adendo ao system card reporta que, quando uma ferramenta de busca está quebrada, o GPT-6.1 Sol deixa de avisar o usuário em 2.08% dos casos, contra 4.92% do GPT-6 Sol. Se o que você constrói é voltado ao cliente, um modelo que "admite quando não consegue consultar algo" vale mais do que alguns pontos de benchmark.
Uma coisa pequena piorou, e volto a ela na seção das pegadinhas: o menor ajuste de raciocínio agora é low, não none.
Quão perto chega do Astra?
Esta é a parte que decide se você continua pagando pelo modelo principal ou não. A OpenAI usa o termo "quase iguala", e na maior parte os números sustentam isso.
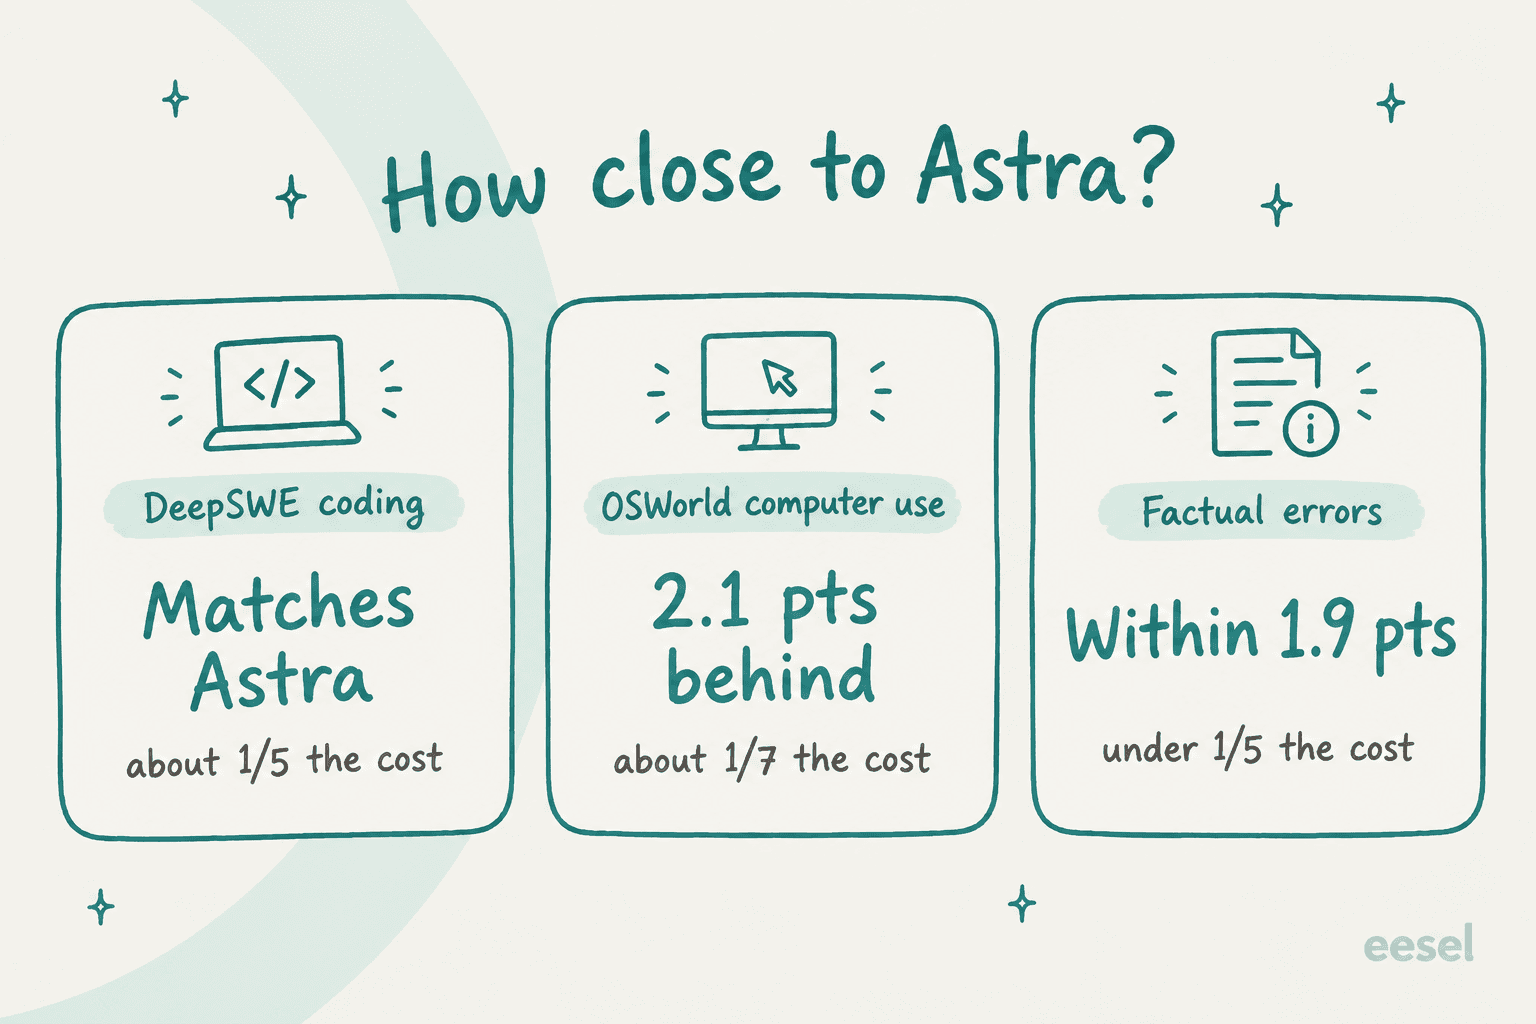
No DeepSWE v1.1, a OpenAI diz que o 6.1 Sol iguala o GPT-6 Astra a cerca de um quinto do custo. No OSWorld 2.0, fica a 2.1 pontos do Astra com esforço máximo por cerca de um sétimo do custo por tarefa. E em todos os ajustes de raciocínio testados, a taxa de erro factual fica a menos de 1.9 ponto da do Astra, a menos de um quinto do custo por tarefa.
Contra a Anthropic ele também se sai bem. No GDP.pdf, um teste de responder perguntas profissionais a partir de PDFs complexos, a OpenAI reporta que o 6.1 Sol pontua mais do que o Claude Opus 5.5 com fallbacks, a menos da metade do custo por tarefa. E no AutomationBench fica 2.2 pontos acima do Opus 5.5 com esforço médio, por cerca de um terço do custo.
Onde a diferença de custo mais se alarga é no trabalho científico. Com esforço máximo no Terminal-Bench Science, a OpenAI coloca o 6.1 Sol em $5.47 por tarefa em média, contra $23.21 do Opus 5.5 e $23.80 do Astra.
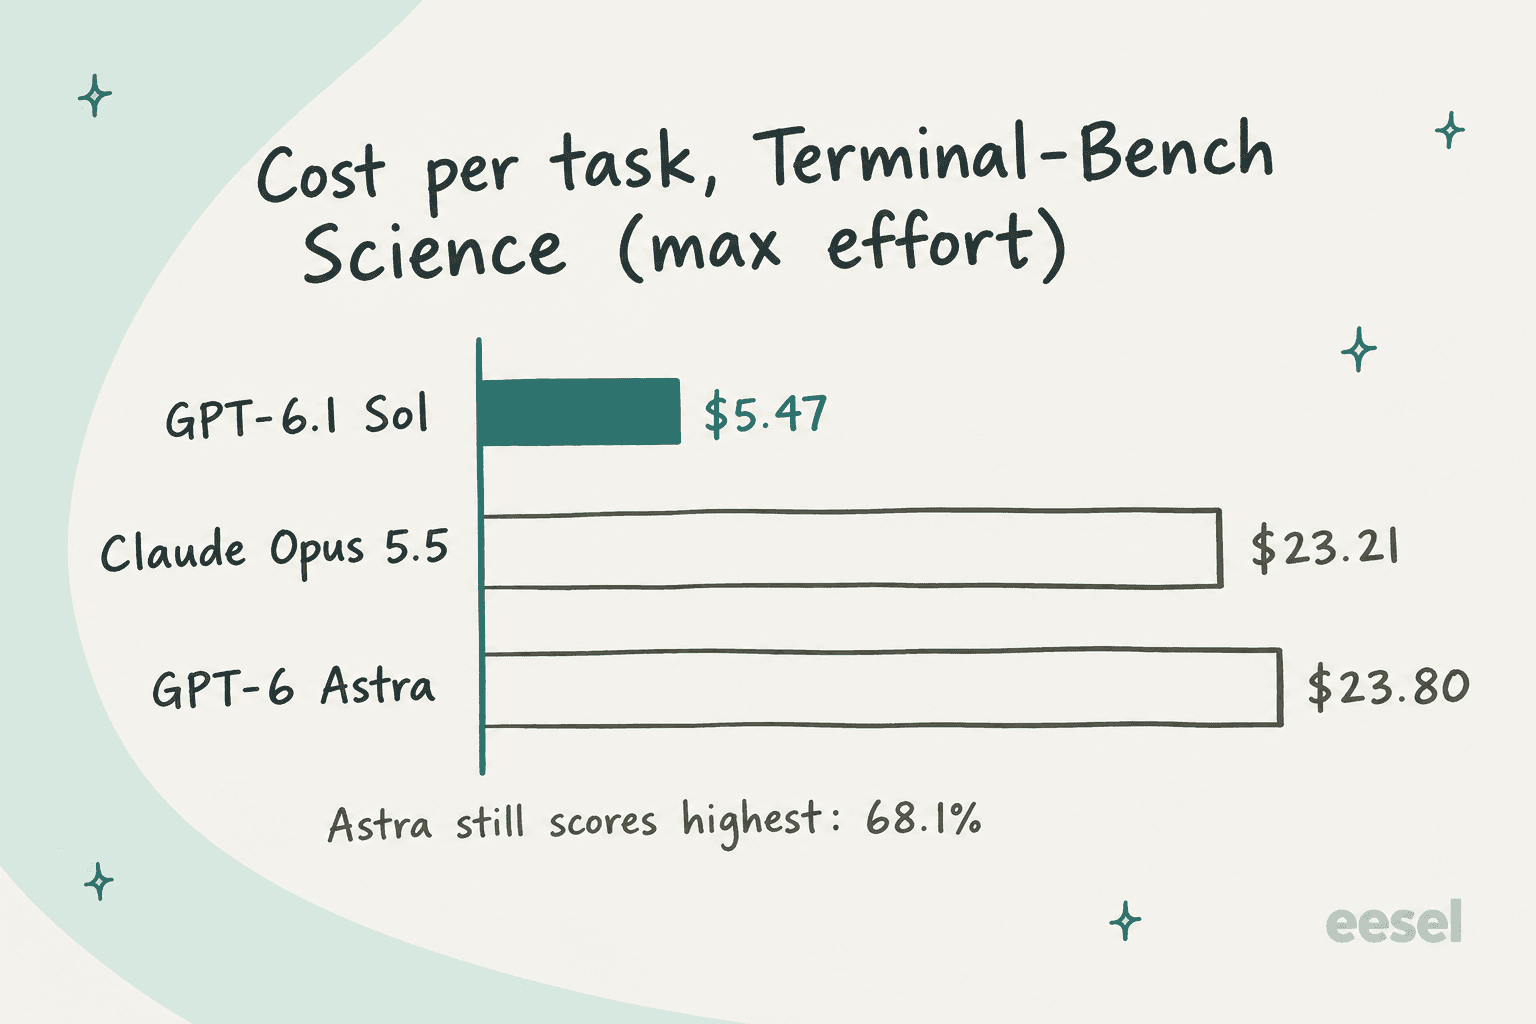
Há uma ressalva justa a fazer sobre tudo isso. Cada número acima é uma avaliação da própria OpenAI, e as cifras dos concorrentes vêm de "relatórios publicamente disponíveis", segundo a nota de rodapé do post de lançamento. A OpenAI também diz que o Astra ainda registra a maior pontuação científica, 68.1%, e "deve ser usado para as tarefas de pesquisa científica mais difíceis". Então a diferença é pequena, mas não é zero. A boa notícia é que os números independentes abaixo contam mais ou menos a mesma história.
O que dizem os testes independentes e os primeiros usuários
A Artificial Analysis já tinha números no dia do lançamento e, para ser sincero, eles sustentam o destaque da OpenAI mais do que eu esperava. Com esforço máximo, o GPT-6.1 Sol marca 51.8 no Intelligence Index, contra 47.5 do GPT-6 Sol e 52.7 do GPT-6 Astra. Chega lá a $0.72 por tarefa contra $3.26 do Astra, o que dá cerca de 22% do custo do modelo principal por aproximadamente um ponto a menos.
"GPT-6.1 Sol replaces GPT-6 Sol after just 7 days. It scores 1 point below GPT-6 Astra in the Intelligence Index at less than one quarter of the Cost per Task"
Para mim, a coisa mais útil nos dados deles é a tabela por nível de esforço, porque a curva achata bastante quando se chega ao topo:
| Esforço | Intelligence Index | Custo por tarefa | Tempo por tarefa |
|---|---|---|---|
| low | 42.1 | $0.13 | 56s |
| medium | 47.8 | $0.21 | 131s |
| high | 50.2 | $0.32 | 205s |
| xhigh | 51.0 | $0.39 | 271s |
| max | 51.8 | $0.72 | 569s |
Fonte: Artificial Analysis. Com xhigh, você chega a um ponto do max por cerca de metade do custo, e metade da espera também. A Artificial Analysis também descobriu que o xhigh superou o max por 3 pontos no seu Coding Agent Index, ficando 1 ponto acima do Astra "for less than 15% of the Cost per Task". Então, se o que você roda são agentes de programação, o xhigh parece o ponto ideal.
Os mesmos dados trazem também duas ressalvas honestas. Primeiro, ele é mais lento que o GPT-6 Sol: 67 contra 76 tokens por segundo, e 569 contra 408 segundos por tarefa no máximo, porque escreve mais tokens de saída. Segundo, a taxa de alucinação melhorou de 60% para 54%, o que é melhor, embora ainda não chegue aos 51% do modelo principal.
No tópico de lançamento do Hacker News, o pessoal foi em geral positivo quanto ao custo e mais dividido quanto ao acabamento, com o preço do cache gerando a reação mais forte:
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

Um desenvolvedor rodou a mesma tarefa de imagem para HTML no 6.1 Sol e no Claude Opus 5.5, e voltou com um veredito justo e dividido:
"Overall, opus executes a bit better than 6.1 sol, which surprises me. [...] It's not bad by any means, but I think where Opus really wins is the motion animation of the svgs / final polish [...] Still, it executed quick and was quite cheap to run."
No X, a opinião que mais vi repetida foi uma mais direta:
"OpenAI just launched GPT-6.1 Sol, and for coding it can replace Astra outright at 1/5 the price."
A nota azeda teve mais a ver com assinaturas do que com o modelo em si. Um comentarista no Hacker News disse que as cotas dos planos do ChatGPT foram cortadas ao mesmo tempo, então "even in the best case scenario it's about 2.5 times cheaper for Codex users." É uma afirmação de um usuário e não um número da OpenAI, mas se você usa o Sol por um plano em vez da API, vale conferir o seu próprio medidor de uso antes de assumir uma economia de 5x.
Preços do GPT-6.1 Sol
O destaque aqui é simples: nada subiu. Na página de preços da API, o GPT-6.1 Sol substitui o GPT-6 Sol na tabela principal com a mesma tarifa padrão de $2/$10. Só uma linha mudou, a entrada em cache, que cai de $0.20 para $0.10 por milhão, 5% da tarifa sem cache.
| Nível | Entrada | Entrada em cache | Gravações em cache | Saída |
|---|---|---|---|---|
| Standard (até 272K de entrada) | $2.00 | $0.10 | $2.50 | $10.00 |
| Standard (acima de 272K de entrada) | $4.00 | $0.20 | $5.00 | $15.00 |
| Batch / Flex | $1.00 | $0.05 | $1.25 | $5.00 |
| Fast | $4.00 | $0.20 | $5.00 | $20.00 |
| Ultrafast | Em breve |
Todos os preços por 1M de tokens. Fonte: preços da API da OpenAI. O processamento regional (residência de dados) acrescenta 10% de sobretaxa.
Esse corte na entrada em cache importa mais do que parece à primeira vista. Um agente reutiliza o mesmo prompt de sistema longo e as mesmas definições de ferramentas em toda chamada, mais o histórico da conversa por cima, então a fatia em cache da entrada tende a ser grande. A OpenAI destaca isso diretamente no post: o corte dá aos desenvolvedores "more room to build and run capable agents that reuse context across requests."
Olhando a família toda, a saída sobe 20x de Luna para Sol e 5x de Sol para Astra:
| Modelo | Entrada / Saída (por 1M) | Entrada em cache | Melhor para |
|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | Tarefas de alto volume e baixo risco |
| GPT-6.1 Sol | $2.00 / $10.00 | $0.10 | O novo padrão para trabalho real |
| GPT-6 Astra | $10.00 / $50.00 | $1.00 | A pesquisa mais difícil e tarefas de longo prazo |
Fonte: preços da API da OpenAI. Para o catálogo completo, incluindo modelos de imagem e áudio, o guia de preços da API da OpenAI tem tudo.
Sol ou Astra: qual usar?
Ao escolher entre os dois para um projeto real, a resposta depende de quão difícil é o trabalho e de quanto tempo ele roda, não de qual é o modelo mais novo. Escolha a opção mais próxima do seu caso.
Qual é o trabalho?
As pegadinhas que ninguém coloca no título
O lançamento é forte, mas há quatro detalhes que vão fazer tropeçar quem migrar uma integração existente.
- Sem esforço de raciocínio
none. A página do modelo diz que o esforço aceitalow,medium(o padrão),high,xhighemax, e quenoneeminimalnão são aceitos. O GPT-6 Sol aceitavanone. Então, se você montou um caminho crítico em latência sobre raciocínio zero, teste antes de trocar. - O Chat Completions não tem chamadas de ferramentas. A OpenAI diz para usar a Responses API para chamadas de ferramentas; o Chat Completions é aceito sem elas. Qualquer código de agente antigo que viva no Chat Completions vai precisar ser movido.
- Ainda não está no Chat comum do ChatGPT. Está no ChatGPT Work e no Codex para Plus, Pro, Business, Enterprise e Edu, mas a OpenAI diz que "not yet available in Chat." Usuários Free e Go não o recebem.
- O Ultrafast é uma promessa, não um produto. O resumo da DevDay diz que o Ultrafast roda até 8x mais rápido (300 tokens por segundo) no Codex e até 6x na API, e que "GPT-6.1 Sol Ultrafast is coming soon." Hoje, só o Astra tem preço de Ultrafast.
Nenhum desses pontos é um impeditivo isoladamente. São o tipo de mudança pequena que transforma uma migração de "só trocar o id do modelo" em meio dia de depuração, se ninguém avisou antes.
Como obter acesso
- API: use o id de modelo
gpt-6.1-solna Responses API. Não há nível gratuito, então o Tier 1 é o piso, com 500 requisições e 500,000 tokens por minuto, escalando até 15,000 requisições e 40 milhões de tokens por minuto no Tier 5. O guia de limites de uso explica como os níveis sobem. - ChatGPT Work e Codex: disponível para usuários Plus, Pro, Business, Enterprise e Edu desde o dia do lançamento. Se você vive no Codex para programação com agentes, este é o modelo para o qual trocar, e o detalhamento de preços do Codex cobre as cotas dos planos.
- Business e Enterprise: os workspaces do ChatGPT Enterprise e Business o recebem no ChatGPT Work e no Codex desde o primeiro dia, igual ao Plus e ao Pro.
O que significa para quem constrói
Se você já usa o GPT-6 Sol, este é o upgrade mais fácil do ano: o preço continua o mesmo e você ganha mais capacidade, além de contexto em cache mais barato. Confira primeiro as quatro pegadinhas acima e depois aponte sua integração para gpt-6.1-sol.
A decisão maior é a do Astra. Uma semana atrás, recorrer ao Astra para agentes de programação ainda era fácil de defender. Hoje, com o Sol igualando-o no DeepSWE, a maioria das equipes que paga 5x pelo Astra deveria rodar o próprio conjunto de testes nos dois e ver onde o Sol realmente fica aquém. Em tarefas longas, o custo de um agente de IA é sobretudo tokens de saída, e a saída é exatamente onde mora a diferença de 5x.
Se você prefere conduzir esse tipo de fluxo de trabalho a partir de um terminal, vale conhecer a CLI do eesel. Ela opera o mesmo colega do eesel e o mesmo workspace que o painel: você pode rodar eesel chat na mão, automatizar eesel activity para ler o que o agente fez em cada execução, usar --dry-run para ver exatamente o que uma escrita enviaria antes de enviar, e deixar agentes de programação como Claude Code, Codex e Cursor chamá-la diretamente. Além disso, todo workspace expõe um servidor MCP, o que significa que uma sessão do Codex rodando o GPT-6.1 Sol pode operar o seu colega de suporte como uma ferramenta, em vez de você clicar por uma interface.
O que significa se você lidera uma equipe de suporte
Agora vem a parte contraintuitiva. Um modelo estar quase no nível do Astra em benchmarks de programação muda menos para uma fila de suporte do que o lançamento sugere.
A melhor factualidade é real e bem-vinda, já que menos respostas erradas ditas com confiança é exatamente o que o suporte precisa. Mas, no suporte, a maioria das respostas erradas não vem de o modelo inventar coisas, e sim do conhecimento que lhe foi dado de início. Uma equipe de suporte B2B de telemática veicular que configurou o eesel no Zendesk esbarrou nisso cedo: o bot respondia sim a "vocês suportam o modelo do meu carro?" para marcas que não estavam na base de dados, porque a central de ajuda dizia "suportamos todos os modelos". O modelo leu a fonte com fidelidade; a fonte é que estava errada. Nenhum upgrade de modelo resolve isso, e a equipe descreveu a configuração inicial como tentativa e erro.
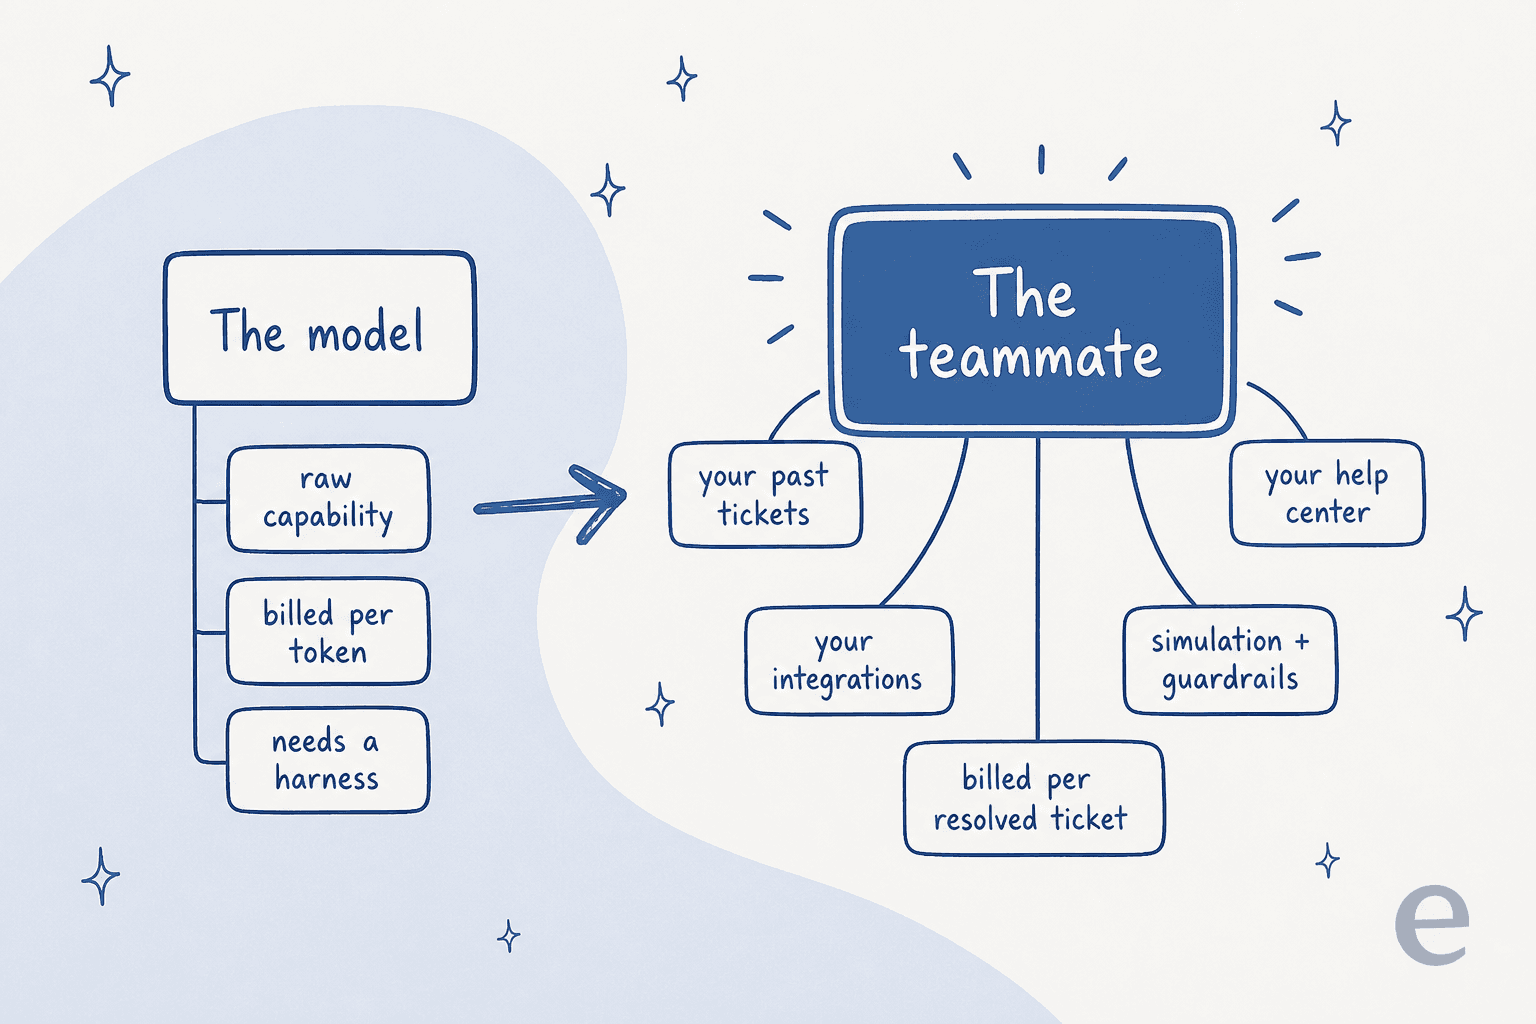
É por isso que eu colocaria um modelo novo no fim da lista de prioridades de uma equipe de suporte. O que move a taxa de resolução é a camada ao redor do modelo, ou seja, treinar com seus tickets antigos, conectar o helpdesk que você já usa e ainda testar as respostas contra o seu próprio histórico antes de entrar no ar. Se a preocupação são as alucinações, a solução também está em grande parte nessa camada. Os melhores agentes de IA são flexíveis quanto ao modelo, então, quando sai um modelo melhor como o GPT-6.1 Sol, você o herda em vez de trocar de plataforma.
Experimente o eesel
Se o que você realmente quer do GPT-6.1 Sol são menos tickets na fila, não precisa construir a estrutura por conta própria. O GPT-6.1 Sol é infraestrutura; o eesel é o funcionário. O colega de IA para helpdesk do eesel aprende com seus tickets antigos e sua central de ajuda, se conecta ao Zendesk, Freshdesk, Gorgias e aos outros helpdesks que você já usa, e roda uma simulação nos seus tickets antigos reais para que você compare as respostas dele com o que sua equipe realmente enviou antes que ele responda um único cliente.
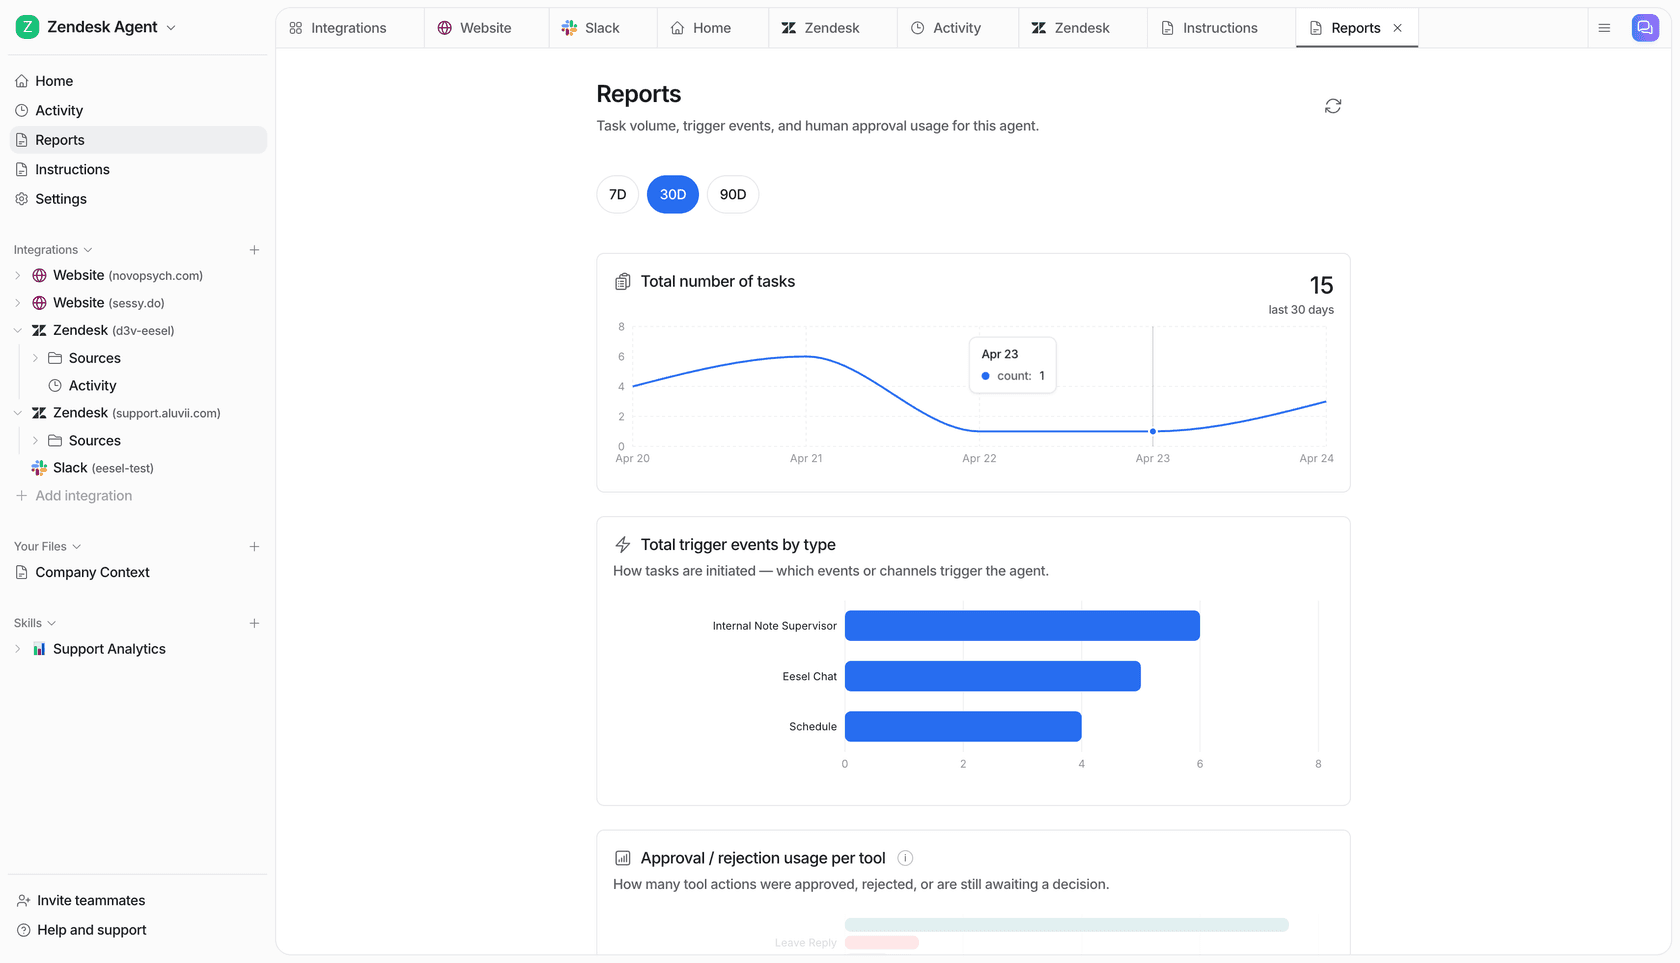
O preço é um plano de créditos mensal fixo em que um ticket ou chat é um crédito, com todos os recursos e usuários ilimitados incluídos, e um plano gratuito com 100 créditos e sem cartão. Não há cobrança por token, então, seja o modelo por baixo o GPT-6.1 Sol ou o próximo lançamento, a conta continua previsível. Experimente o eesel em uma fatia da sua fila e veja as respostas nos seus próprios tickets.
Perguntas frequentes
O que é o GPT-6.1 Sol?
Quanto custa o GPT-6.1 Sol?
Qual é a diferença entre o GPT-6 Sol e o GPT-6.1 Sol?
none saiu, então low agora é o piso. O texto original sobre o GPT-6 Sol cobre o modelo anterior.O GPT-6.1 Sol é tão bom quanto o GPT-6 Astra?
O GPT-6.1 Sol está disponível no ChatGPT?
gpt-6.1-sol, sem acesso no nível gratuito.O GPT-6.1 Sol tem modo Ultrafast?
Quais são os limites de uso do GPT-6.1 Sol?
Devo usar o GPT-6.1 Sol para automatizar o suporte ao cliente?

Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.