
Preços do GPT-6.1 Sol em resumo
O GPT-6.1 Sol foi lançado no DevDay da OpenAI em 29 de setembro de 2026, e na página de preços da API ele simplesmente herdou a linha do GPT-6 Sol. Eu construo integrações na eesel. Sempre que um modelo é lançado, acabo refazendo a mesma planilha de custos para algum cliente, então desta vez transformei a planilha em um artigo.
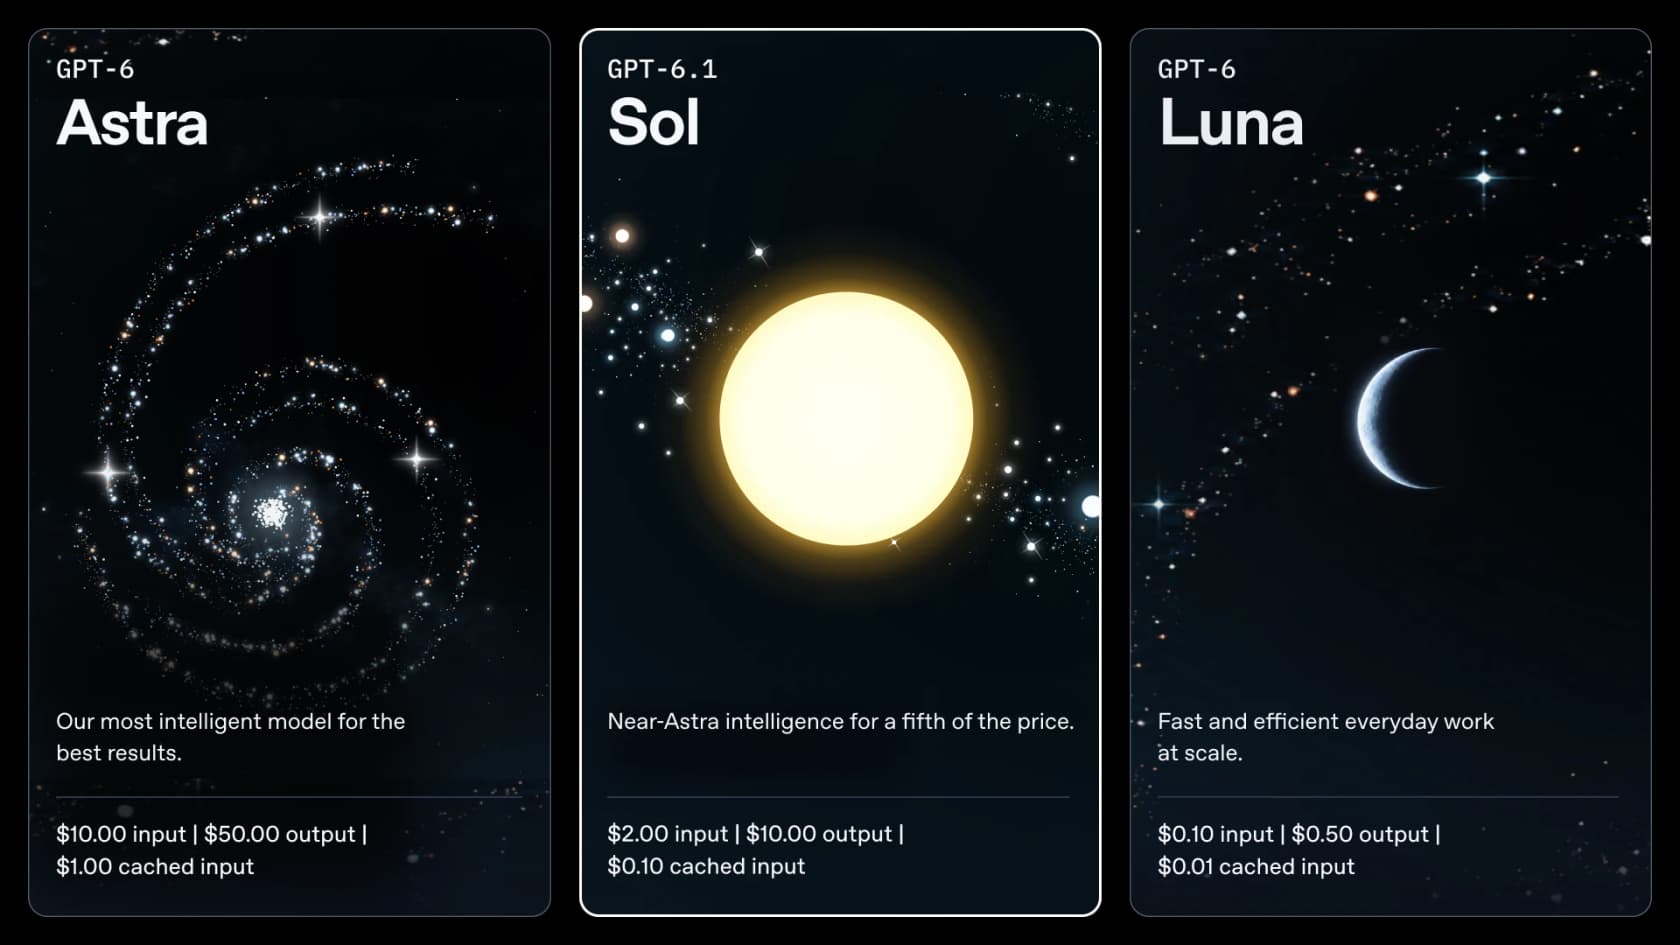
Abaixo está a tabela completa do nível padrão, com as duas faixas de contexto:
| Nível padrão (por 1M de tokens) | Contexto curto (até 272K de entrada) | Contexto longo (mais de 272K de entrada) |
|---|---|---|
| Entrada | $2.00 | $4.00 |
| Entrada em cache | $0.10 | $0.20 |
| Gravações em cache | $2.50 | $5.00 |
| Saída (inclui raciocínio) | $10.00 | $15.00 |
Fonte: preços da API da OpenAI, reconferido em 1 de outubro de 2026. A página do modelo detalha as proporções por trás desses números: a entrada em cache é 5% da tarifa sem cache, as gravações em cache são 1.25x, e prompts longos custam "2x input and cache rates and 1.5x output for the full request."
É o modelo do meio da linha de modelos da OpenAI, e alguns detalhes técnicos importam quando você começa a orçar. O id do modelo é gpt-6.1-sol, com janela de contexto de 1,050,000 tokens e 128,000 tokens de saída máxima. A API não tem nível gratuito, então o Tier 1 (500 requisições e 500,000 tokens por minuto) é o piso.
O que mudou em relação aos preços do GPT-6 Sol
No papel, quase nada. Esta é a diferença toda:
| Item | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| Entrada (por 1M) | $2.00 | $2.00 |
| Entrada em cache | $0.20 | $0.10 |
| Saída | $10.00 | $10.00 |
| Menor esforço de raciocínio | none | low |
| Tokens de saída por tarefa (AA, max) | 31.1K | 38.1K |
| Custo por tarefa (AA, max) | $1.05 | $0.72 |
Fontes: preços da API da OpenAI, Artificial Analysis. O artigo de preços do GPT-6 Sol traz o panorama completo da semana passada.
Dois desses números puxam em sentidos opostos. O GPT-6.1 Sol escreve mais saída. A Artificial Analysis mediu "~10-30% more output tokens than GPT-6 Sol" nos níveis de esforço. Mesmo assim, ele saiu 31% mais barato por tarefa no esforço máximo, porque conclui o trabalho com menos execuções falhas e sua entrada em cache custa metade. Paridade por token não é paridade por tarefa. Aqui, pelo menos, o número por tarefa se moveu a seu favor.
A mudança que realmente pode aumentar uma conta é o piso de raciocínio. O GPT-6 Sol permitia rodar com esforço none, o que significava zero tokens de raciocínio. No 6.1 Sol, a página do modelo diz que none e minimal "are not supported", então low é a configuração mais barata. Se você tinha um classificador de alto volume em none, ele agora vai cobrar alguma saída de raciocínio em cada chamada, então eu testaria isso antes de trocar o id do modelo.
O corte na entrada em cache é a verdadeira mudança de preço
Esta é a parte dos preços do GPT-6.1 Sol que deveria ter sido a manchete, e o pessoal do tópico do dia do lançamento percebeu na hora:
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

O motivo é simples. Os agentes reenviam o mesmo material em toda chamada: o prompt de sistema, as definições de ferramentas e um histórico de conversa que não para de crescer. Esse prefixo repetido fica em cache. Em um agente de longa duração, a maior parte da entrada passa a ser cobrada na tarifa de cache em vez dos $2 de tabela. Então o seu preço real de entrada é uma mistura, e o que define a mistura é sobretudo a sua taxa de acerto de cache.
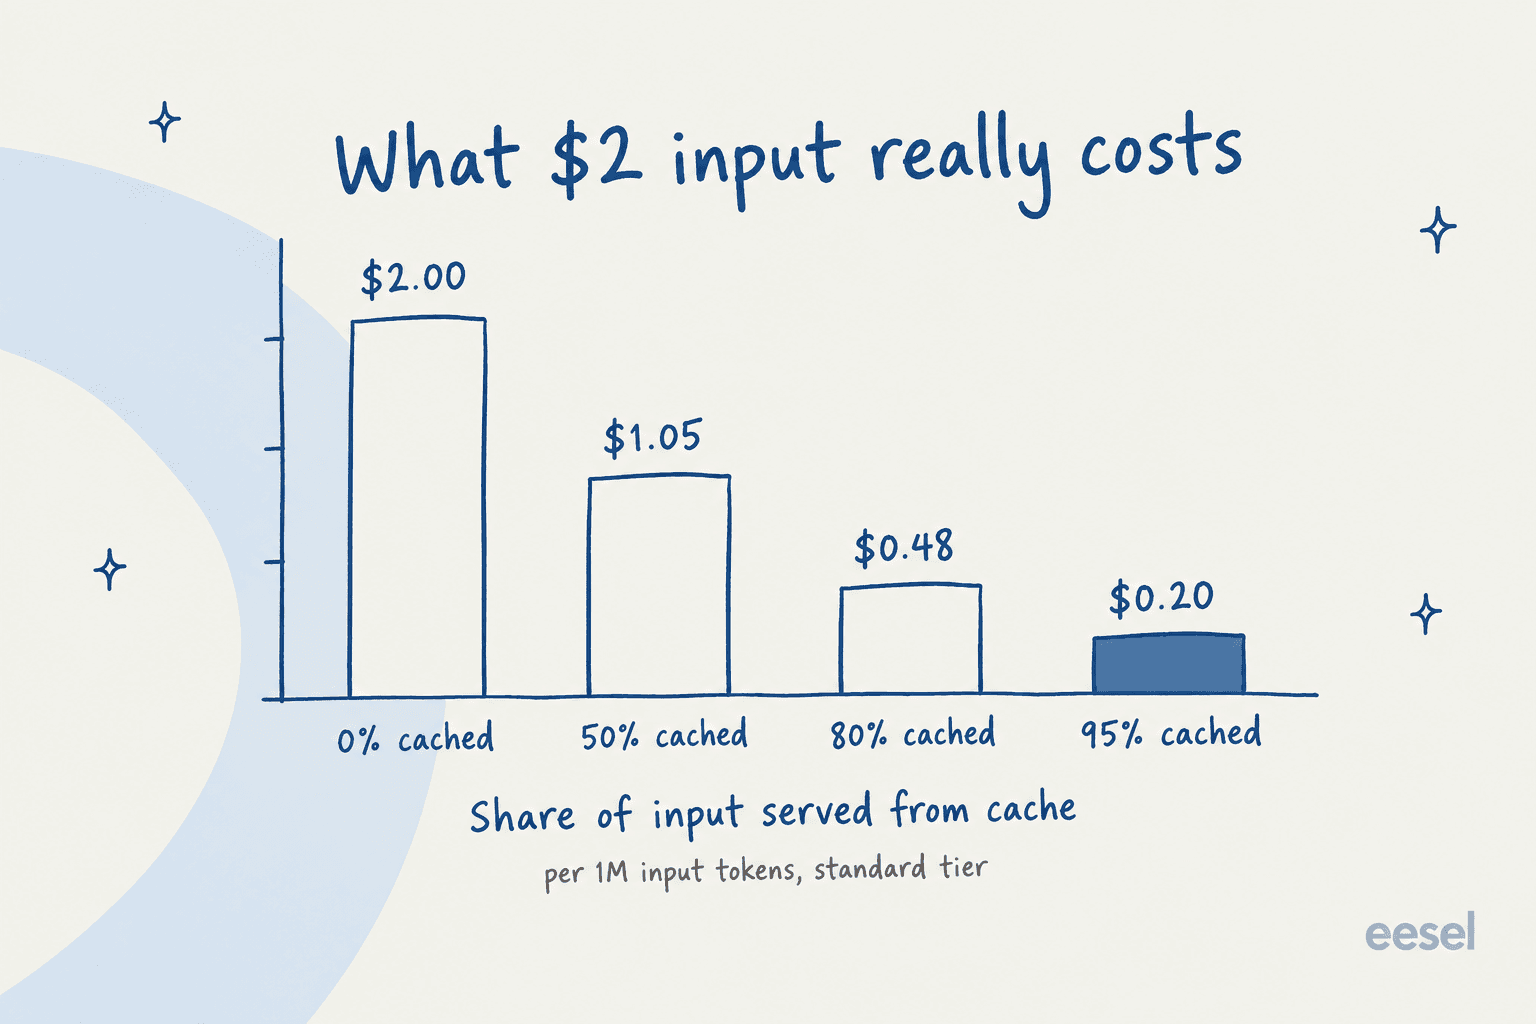
Faça a mesma conta para a família toda e dá para ver quanto o corte no cache ampliou a distância para o modelo principal:
| Parcela da entrada em cache | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 0% | $2.00 | $2.00 | $10.00 |
| 50% | $1.05 | $1.10 | $5.50 |
| 80% | $0.48 | $0.56 | $2.80 |
| 95% | $0.20 | $0.29 | $1.45 |
Preço efetivo de entrada por 1M de tokens, nível padrão, calculado a partir da tabela da OpenAI. Com 80% de acerto de cache, a entrada do GPT-6.1 Sol custa cerca de um sexto da do Astra, e o artigo de preços do GPT-6 Astra traz o cartão completo do modelo principal. Há duas ressalvas. As gravações em cache custam $2.50 por milhão, 1.25x a tarifa normal de entrada, o que significa que a primeira chamada que armazena um prefixo custa um pouco mais do que uma sem cache. O cache também só ajuda enquanto o prefixo permanecer idêntico byte a byte. Coloque um carimbo de data e hora no topo do prompt de sistema e o desconto cai a zero sem aviso.
Níveis de serviço: Batch, Flex, Fast e o Ultrafast que falta
É um modelo com quatro preços, e o nível escolhido mexe mais na conta do que qualquer ajuste de prompt:
| Nível (por 1M, contexto curto) | Entrada | Entrada em cache | Gravações em cache | Saída | Entrada / saída em contexto longo |
|---|---|---|---|---|---|
| Batch | $1.00 | $0.05 | $1.25 | $5.00 | $2.00 / $7.50 |
| Flex | $1.00 | $0.05 | $1.25 | $5.00 | $2.00 / $7.50 |
| Standard | $2.00 | $0.10 | $2.50 | $10.00 | $4.00 / $15.00 |
| Fast | $4.00 | $0.20 | $5.00 | $20.00 | $8.00 / $30.00 |
| Ultrafast | Em breve |
Fonte: preços da API da OpenAI. O que cada um significa na prática:
- Batch e Flex custam metade do padrão. O Batch é para trabalhos que você envia e coleta depois; o Flex é para requisições que podem rodar mais devagar. Se um trabalho não precisa de resposta em segundos, é o lugar dele.
- Fast dobra o preço em troca de menor latência. A página de preços observa que o processamento prioritário "was renamed Fast mode on July 30, 2026."
- Ultrafast não está disponível para o Sol. O resumo do DevDay diz "GPT-6.1 Sol Ultrafast is coming soon." Hoje apenas o GPT-6 Astra tem preço Ultrafast, a $60/$300 por milhão.
- Residência de dados acrescenta 10%. Os endpoints de processamento regional têm um acréscimo de 10% para modelos lançados depois de 5 de março de 2026, e a página do modelo acrescenta que o Fast não está disponível com residência de dados na UE.
É na combinação que a economia realmente aparece. Um trabalho que pode ir em batch, com um prefixo grande em cache, roda a $1 de entrada, $0.05 em cache e $5 de saída. Comparado à tarifa padrão do Astra, isso é 90% de corte só na saída.
O penhasco dos 272K
A regra de contexto longo é a linha mais fácil de passar despercebida na tabela. Também é a mais cara para tropeçar. Quando um prompt passa de 272K tokens de entrada, a requisição inteira é cobrada na tarifa longa, não só os tokens além do limite.
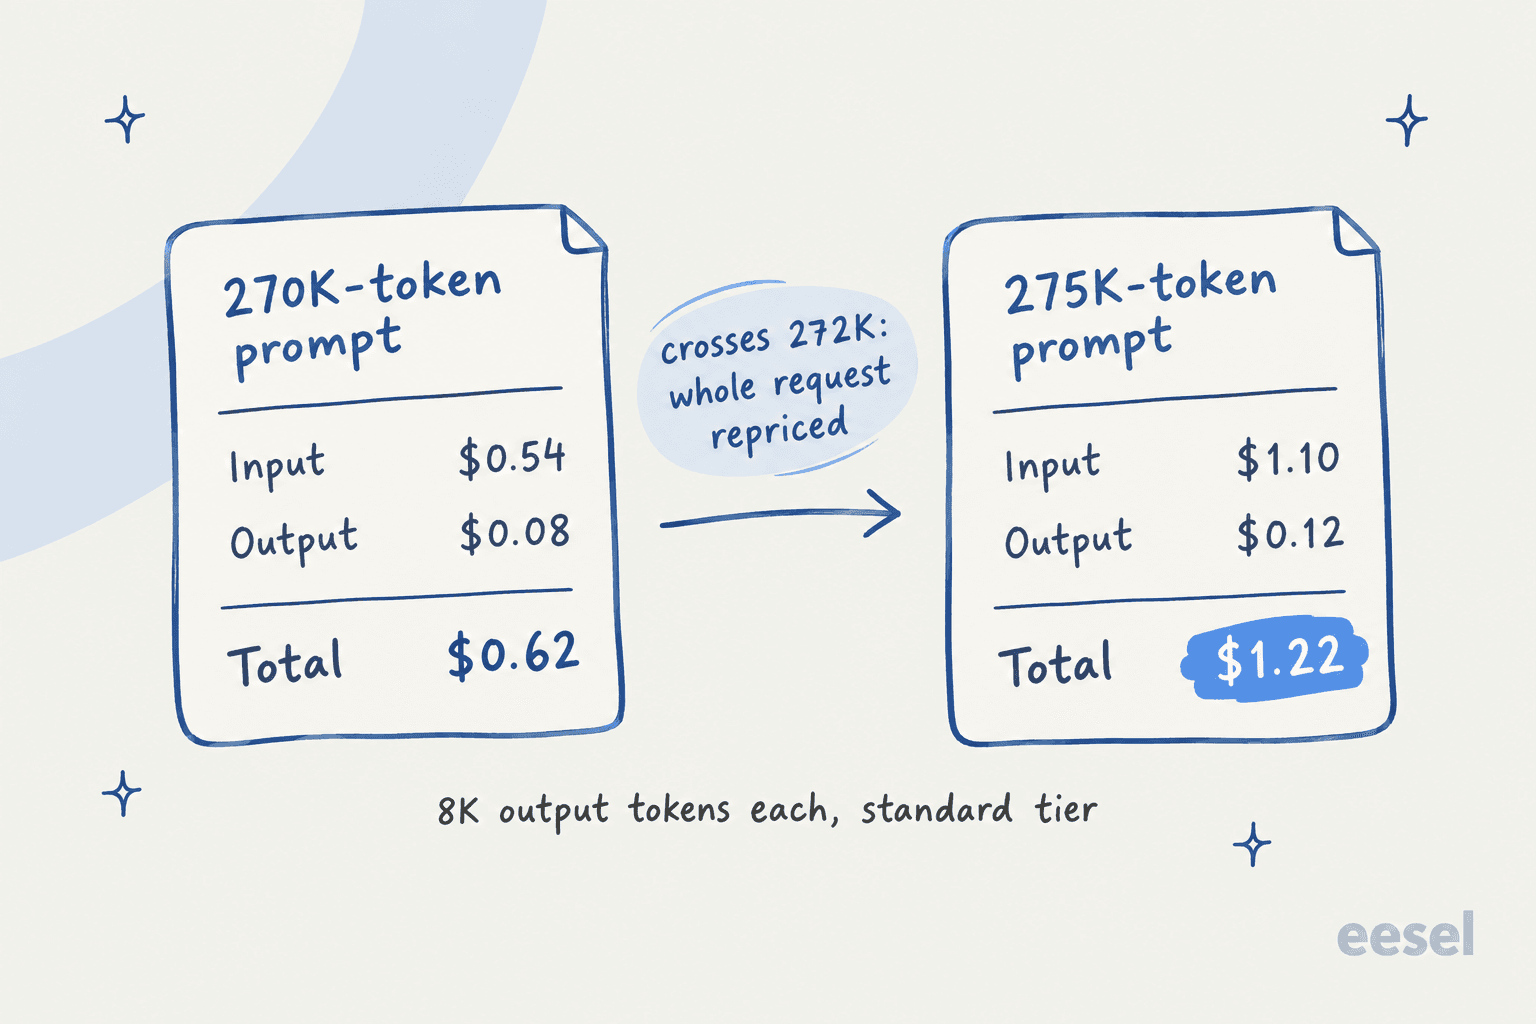
Essa imagem é a armadilha inteira: 5,000 tokens de entrada a mais quase dobram a requisição, de $0.62 para $1.22. A janela de 1,050,000 tokens é real. Só que há um degrau de preço mais ou menos um quarto do caminho. Quem faz análise de documentos ou tarefas de programação em repositórios inteiros deveria checar onde seus prompts caem. Dividir um trabalho de 400K em duas chamadas de 200K costuma ser melhor do que enviá-lo inteiro. Uma recuperação que envia só os trechos relevantes vence as duas.
Custo por tarefa: o número que realmente importa
Uma tarifa por token dá o preço do combustível. Ela não diz quanto combustível a viagem precisa. Com modelos de raciocínio, esse segundo número pode variar mais de 5x conforme o esforço, e é por isso que eu faço meu orçamento a partir dele.
A Artificial Analysis executou seu Intelligence Index completo uma vez por nível de esforço:
| Esforço | Intelligence Index | Custo por tarefa | Tokens de saída por tarefa | Tempo por tarefa |
|---|---|---|---|---|
| low | 42.1 | $0.13 | 4.0K | 56s |
| medium | 47.8 | $0.21 | 8.1K | 131s |
| high | 50.2 | $0.32 | 13.2K | 205s |
| xhigh | 51.0 | $0.39 | 17.6K | 271s |
| max | 51.8 | $0.72 | 38.1K | 569s |
Fonte: Artificial Analysis. Perto do topo, a curva fica quase plana. Passar de xhigh para max quase dobra o custo, e você ganha 0.8 ponto.
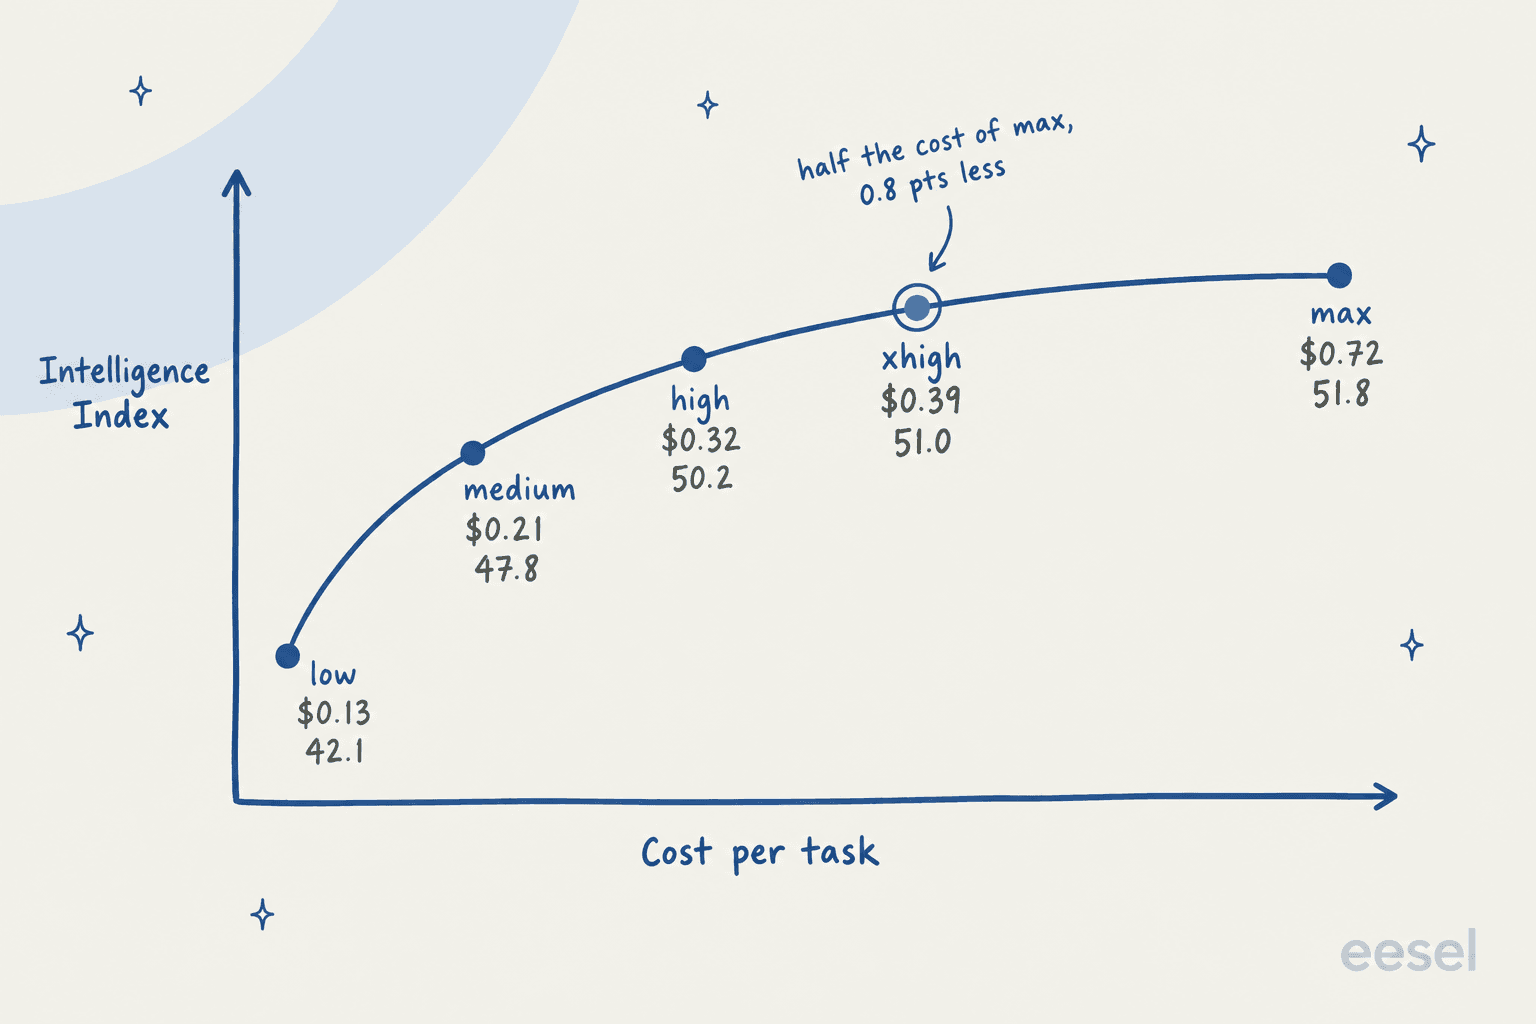
Para programação, o xhigh fica ainda melhor. A Artificial Analysis informou que o xhigh superou o max por 3 pontos no seu Coding Agent Index, ficando 1 ponto acima do GPT-6 Astra "for less than 15% of the Cost per Task." Meu padrão inicial é medium para o trabalho do dia a dia e xhigh para agentes de programação. Eu só recorreria ao max quando um teste mostrasse que vale o custo extra.
Olhar por tarefa também reorganiza a comparação dos modelos de aparência barata. Um desenvolvedor no tópico do lançamento fez esse ponto com números da Artificial Analysis:
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens, making the Chinese models come out costlier and slower per actual task performed end-to-end."
Conferi os números desse comentário na Artificial Analysis e eles se sustentam: o 6.1 Sol no medium sai a $0.21 por tarefa com 8.1K tokens de saída, enquanto o comentarista cita o DeepSeek V4.1 Flash no max com $0.27 e 89K tokens gerados.
Os itens de custo que não estão na tabela
Alguns custos ficam fora da tabela por token, e todos aparecem em faturas reais:
- Tokens de raciocínio são saída. Cada token de raciocínio é cobrado na tarifa de saída de $10. No
max, a Artificial Analysis mediu 38.1K tokens de saída por tarefa, e a maior parte é raciocínio, não resposta. - As ferramentas integradas têm preços próprios. Na página de preços, a busca na web custa $10 por 1,000 chamadas mais os tokens de conteúdo de busca nas tarifas do modelo, as chamadas à ferramenta de busca de arquivos custam $2.50 por 1,000, e os contêineres de shell hospedado ou interpretador de código vão de $0.03 por sessão de 20 minutos (1 GB) até $1.92 (64 GB).
- Chamar ferramentas exige a Responses API. A página do modelo diz que o Chat Completions funciona "without tool calling." Isso não é uma linha na fatura, mas migrar código de agente antigo ainda custa tempo de engenharia.
- Marketplaces de nuvem cobram separadamente. Se você roda modelos da OpenAI pelo Amazon Bedrock ou pelo Microsoft Azure, esses serviços definem e cobram a tarifa, segundo a página de preços da OpenAI.
Estime sua conta do GPT-6.1 Sol
Coloque aqui o formato do seu próprio tráfego, de requisições por mês e tokens por requisição até a sua taxa de acerto de cache e o nível. Se uma requisição passar de 272K, o estimador muda sozinho para a tarifa de contexto longo. Ele também mostra quanto o mesmo tráfego custaria no GPT-6 Astra e no GPT-6 Luna.
De saída, os valores padrão modelam um agente de programação com um grande prefixo em cache. Arraste o controle de cache até zero e a linha de entrada dispara. Depois, defina os tokens de saída em 20,000 e você verá quanto custa o hábito do esforço max. Na maioria das vezes, é na saída que o dinheiro vai. Para imagem, áudio e modelos mais antigos, o guia de preços da API da OpenAI traz o resto do catálogo.
Exemplos de cálculo em três tamanhos
As tarifas de tabela fazem mais sentido quando ganham um formato de tráfego real. Estes são três que encontro com frequência, todos calculados a partir da tabela. As contagens de tokens são suposições minhas para ilustrar, não medições, então coloque seus próprios números no estimador acima.
| Carga de trabalho | Formato do tráfego | GPT-6.1 Sol | Comparação |
|---|---|---|---|
| Laço de agente de programação | 30,000 chamadas/mês, 60K de entrada (50K em cache), 3K de saída, padrão | $1,650/mês | Astra: $9,000. GPT-6 Sol: $1,800 |
| Extração noturna de documentos | 20,000 documentos/mês, 40K de entrada (nenhum em cache), 2K de saída, Batch | $1,000/mês | O mesmo trabalho no padrão: $2,000 |
| Triagem de tickets de suporte | 100,000 tickets/mês, 2.5K de entrada (2K em cache), 600 de saída, padrão | $720/mês | Luna: $37. Astra: $3,700 |
Algumas coisas saltam dessa tabela:
- O agente de programação é basicamente uma conta de saída. Dos $1,650, $900 são saída e apenas $150 são os 1.5 bilhão de tokens de entrada em cache. Em relação ao GPT-6 Sol, o corte no cache economizou $150 por mês. O resto depende da configuração de esforço.
- Batch é a linha mais barata que você vai mudar. Troque um parâmetro e o trabalho de extração custa metade, sem mudança de qualidade.
- Triagem é trabalho para o Luna. Para rótulos curtos e de baixo risco em volume, o GPT-6 Luna faz o mesmo formato por cerca de 5% do preço. Eu reservaria o Sol para as respostas que precisam estar certas. O artigo de preços do GPT-6 Luna traz a tabela completa dele.
Preços do GPT-6.1 Sol no ChatGPT e no Codex
Usar o GPT-6.1 Sol por assinatura em vez da API funciona de outro jeito: você paga um preço mensal fixo e consome uma franquia. A OpenAI diz que ele está disponível "to all Plus, Pro, Business, Enterprise, and Edu users in ChatGPT Work and Codex," e "not yet available in Chat."
| Plano | Preço mensal | GPT-6.1 Sol | Observações |
|---|---|---|---|
| Free | $0 | Não | GPT-5.6 Luna para o chat do dia a dia |
| Go | $8 | Não | Pode incluir anúncios |
| Plus | $20 | Sim | Uso ampliado do Codex |
| Pro 100 | $100 | Ampliado | Sem Ultrafast |
| Pro 200 | $200 | Ampliado | Mais uso que o Pro 100 |
| Pro 500 | $500 | Ampliado | Maior franquia, inclui Ultrafast |
| Business / Enterprise / Edu | Por usuário | Sim | No ChatGPT Work e no Codex |
Fontes: preços do ChatGPT, About ChatGPT Pro tiers e o post de lançamento. O guia de preços do ChatGPT cobre todos os planos, preços do ChatGPT Work aprofunda o Work, e o ChatGPT Enterprise trata dos acordos por usuário.
As assinaturas trazem uma pegadinha que a API não tem. A página de ajuda do Pro da OpenAI diz que as novas assinaturas Pro 200 "include a lower usage allowance than previously offered", e que os assinantes atuais mantêm a franquia antiga só até 29 de outubro de 2026. O resumo do DevDay coloca o Pro 500 em "25 times the ChatGPT Plus allowance." Ao atingir o limite, a mesma página de ajuda diz que o uso elegível do Codex e do ChatGPT Work pode consumir créditos comprados.
Alguns dos primeiros usuários calcularam o que isso significa para o Codex:
"They have also cut allowances for subscriptions in half. So even in the best case scenario it's about 2.5 times cheaper for Codex users."
É a estimativa de um usuário, não um número da OpenAI. Ainda assim, é um aviso justo. Um modelo 5x mais barato que o Astra na API não vira 5x mais trabalho dentro de um plano. Se você vive no Codex, eu acompanharia seu próprio medidor de uso por uma semana antes de contar com a economia.
Como os preços do GPT-6.1 Sol se comparam
No preço de tabela, o GPT-6.1 Sol iguala exatamente o Claude Sonnet 5.5 e fica bem abaixo de tudo que está acima:
| Modelo | Entrada / saída (por 1M) | Acerto de cache | Custo por tarefa (AA) | Intelligence Index (AA) |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | n/d | n/d |
| GPT-6.1 Sol (medium) | $2 / $10 | $0.10 | $0.21 | 47.8 |
| GPT-6.1 Sol (max) | $2 / $10 | $0.10 | $0.72 | 51.8 |
| Claude Sonnet 5.5 (high) | $2 / $10 | $0.20 | $1.08 | 47 |
| Claude Opus 5.5 (medium) | $4 / $20 | $0.20 | $1.34 | 51 |
| GPT-6 Astra (max) | $10 / $50 | $1.00 | $3.26 | 52.7 |
| Claude Opus 5.5 (max) | $4 / $20 | $0.20 | $5.98 | 58 |
Fontes: preços da OpenAI, preços da Anthropic e Artificial Analysis para custo por tarefa e pontuações.
Minha leitura tem duas partes. Com pontuação equivalente, o GPT-6.1 Sol é muito mais barato por tarefa: 47.8 por $0.21 contra 47 por $1.08 do Sonnet 5.5, e 51.8 no max por cerca de metade do que o Opus 5.5 cobra no medium por 51. A Artificial Analysis foi direta: "for a given level of intelligence, there is no cheaper model."
O que ele não faz é chegar ao topo. O Opus 5.5 e o Sonnet 5.5 no max pontuam mais, e em uma comparação prática no tópico do lançamento, um desenvolvedor achou que o Opus 5.5 "executes a bit better" no acabamento final. Isso faz a escolha depender da pontuação de que você precisa, não do preço de tabela. Se de 48 a 52 neste índice resolve o seu trabalho, o GPT-6.1 Sol é o jeito mais barato de chegar lá. Precisa do topo do gráfico? Vai pagar por isso em outro lugar. A comparação entre a API da OpenAI e a da Anthropic aprofunda essa troca.
O que os preços do GPT-6.1 Sol significam para uma equipe de suporte
Esta parte vai contra a intuição. Em uma fila de suporte, um modelo mais barato é a menor linha do projeto, enquanto a conta de tokens é a mais difícil de prever.
Pense no que move os números acima: tamanho do prompt, taxa de acerto de cache, esforço de raciocínio, novas tentativas, chamadas de ferramentas e se um prompt passou de 272K. Nenhum deles se traduz em "tickets atendidos". Um líder de suporte não consegue entregar ao financeiro um orçamento que diga "entre $400 e $2,000 dependendo de quão tagarela o modelo estiver". Isso aparece em avaliações reais da eesel. Um comprador no Freshdesk chegou a 200 interações em um único dia de teste e logo começou a projetar o custo em 9,000 por mês. O que o preocupava não era a tarifa. Era não saber o total.
Depois vem a tentação de construir você mesmo, que fica mais forte a cada vez que um modelo fica mais barato. Um cliente de médio porte que saiu, após uma integração quebrada, para uma ferramenta mais barata, disse assim em resposta ao fundador da eesel:
"We switched to a system [...] that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
É um plano razoável, e o GPT-6.1 Sol a $2/$10 realmente barateia a parte do modelo. Mas o modelo nunca foi a parte cara. O trabalho está na camada ao redor: treinar com seus tickets antigos, conectar o helpdesk que você já usa, ações seguras e testar as respostas contra o histórico real antes de entrar no ar. Se o receio são as alucinações, a correção também está nessa camada, não na tabela de preços. É por isso que os melhores agentes de IA para suporte são flexíveis quanto ao modelo: quando sai um mais barato, você herda em vez de reconstruir. O detalhamento do custo de agentes de IA mostra para onde esse dinheiro realmente vai.
Experimente a eesel
Se o que você realmente quer do GPT-6.1 Sol é menos tickets na fila, não precisa precificar tokens. A eesel é uma plataforma de colegas de IA, e o colega de IA para helpdesk é o indicado para esse trabalho. O GPT-6.1 Sol é infraestrutura; a eesel é o funcionário. Ela aprende com seus tickets antigos e sua central de ajuda, se conecta ao Zendesk, Freshdesk, Gorgias e aos outros helpdesks que você já usa, e roda uma simulação com seus tickets antigos reais para você comparar as respostas dela com o que sua equipe realmente enviou.
A cobrança funciona ao contrário de um medidor de tokens. Os preços da eesel são um plano mensal fixo de créditos, a partir de $299 por 500 créditos, em que um ticket ou chat atendido é um crédito. Todos os recursos e usuários ilimitados estão incluídos, e um plano gratuito dá 100 créditos sem cartão. Seja qual for o modelo por baixo, a sua conta de automação de suporte é o mesmo número todo mês.
Como este é um artigo de preços para desenvolvedores, há mais uma coisa que eu apontaria. A CLI da eesel opera, a partir de um terminal, o mesmo colega e o mesmo espaço de trabalho que o painel. Você conecta um helpdesk com eesel integrations connect, lê cada execução com eesel activity e coloca ações de risco atrás do eesel approvals. Todos os comandos imprimem JSON, e o --dry-run mostra a chamada exata que uma escrita faria antes de enviar. Além disso, cada espaço de trabalho é um servidor MCP, então uma sessão do Codex rodando o GPT-6.1 Sol pode comandar seu colega de suporte como ferramenta, no mesmo padrão de qualquer configuração de MCP para suporte. Você tem o controle por scripts que gostaria de um agente que você mesmo constrói, com a cobrança por ticket que você consegue colocar em um orçamento.
Perguntas frequentes
Quanto custa o GPT-6.1 Sol na API?
O GPT-6.1 Sol é mais caro que o GPT-6 Sol?
Qual é o preço de contexto longo do GPT-6.1 Sol?
O GPT-6.1 Sol é gratuito no ChatGPT?
Quanto custa o GPT-6.1 Sol no Codex?
Quanto custa o GPT-6.1 Sol por tarefa?
O GPT-6.1 Sol é mais barato que o Claude Sonnet 5.5?
O que os preços do GPT-6.1 Sol significam para uma equipe de suporte?

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.