Preços da API do GPT-6 Astra: o nível padrão
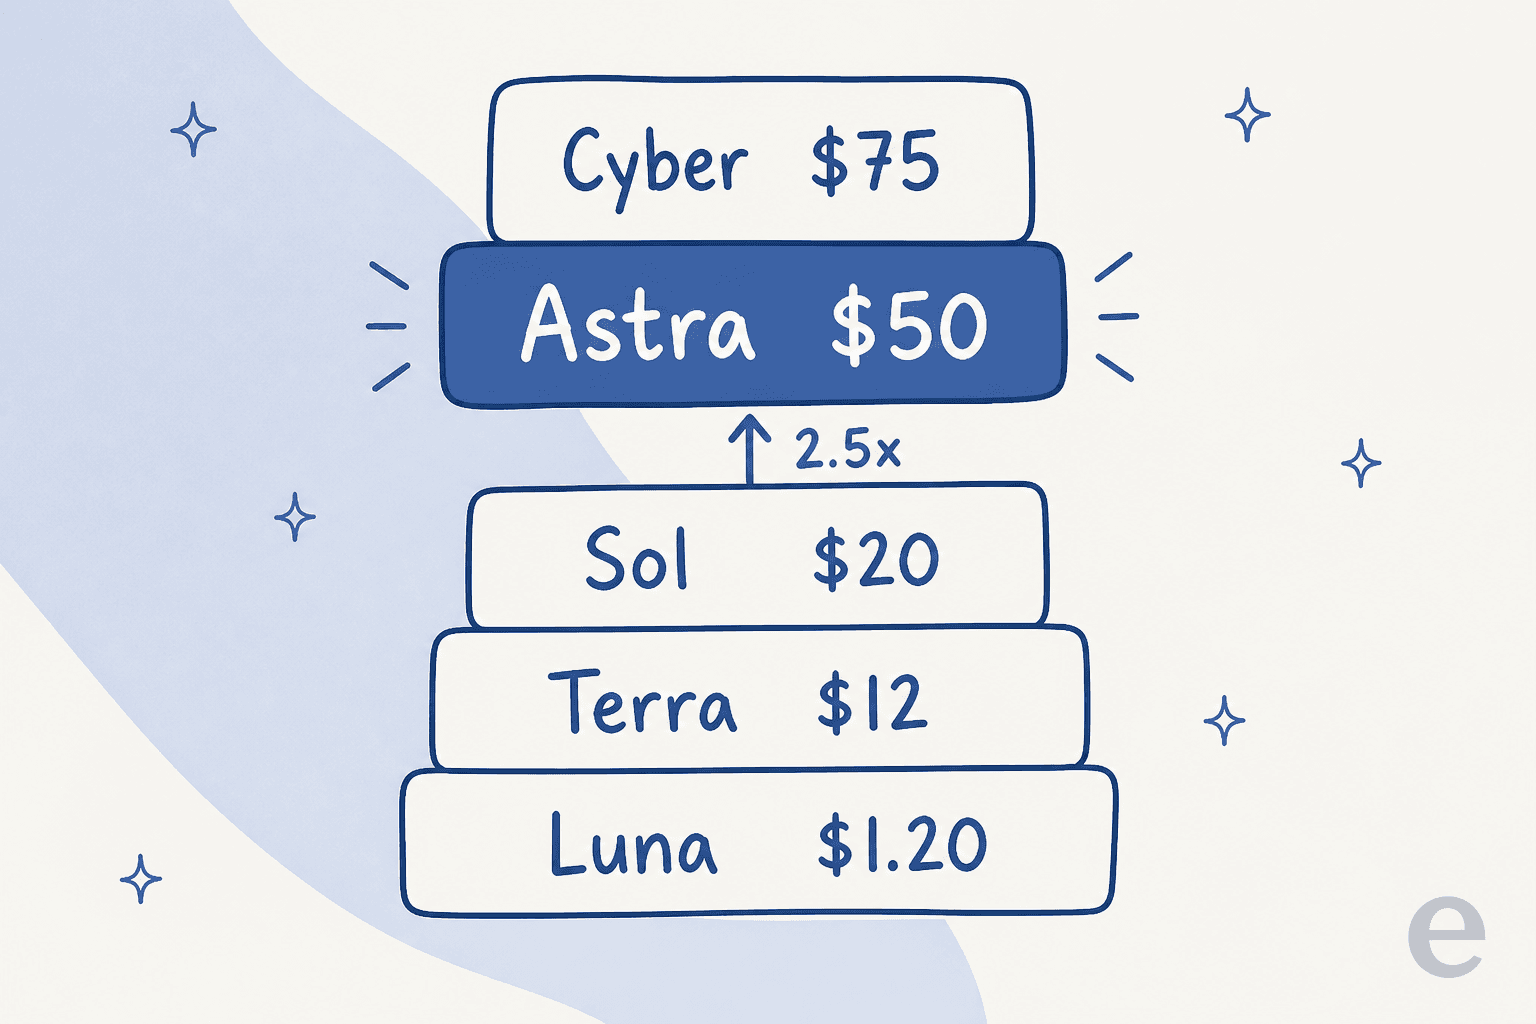
Aqui está o número pelo qual a maioria veio. Na página de preços da API, o preço padrão do GPT-6 Astra é $10,00 por milhão de tokens de entrada e $50,00 por milhão de tokens de saída. A entrada em cache cai para $1,00, e as gravações em cache custam $12,50 por milhão.
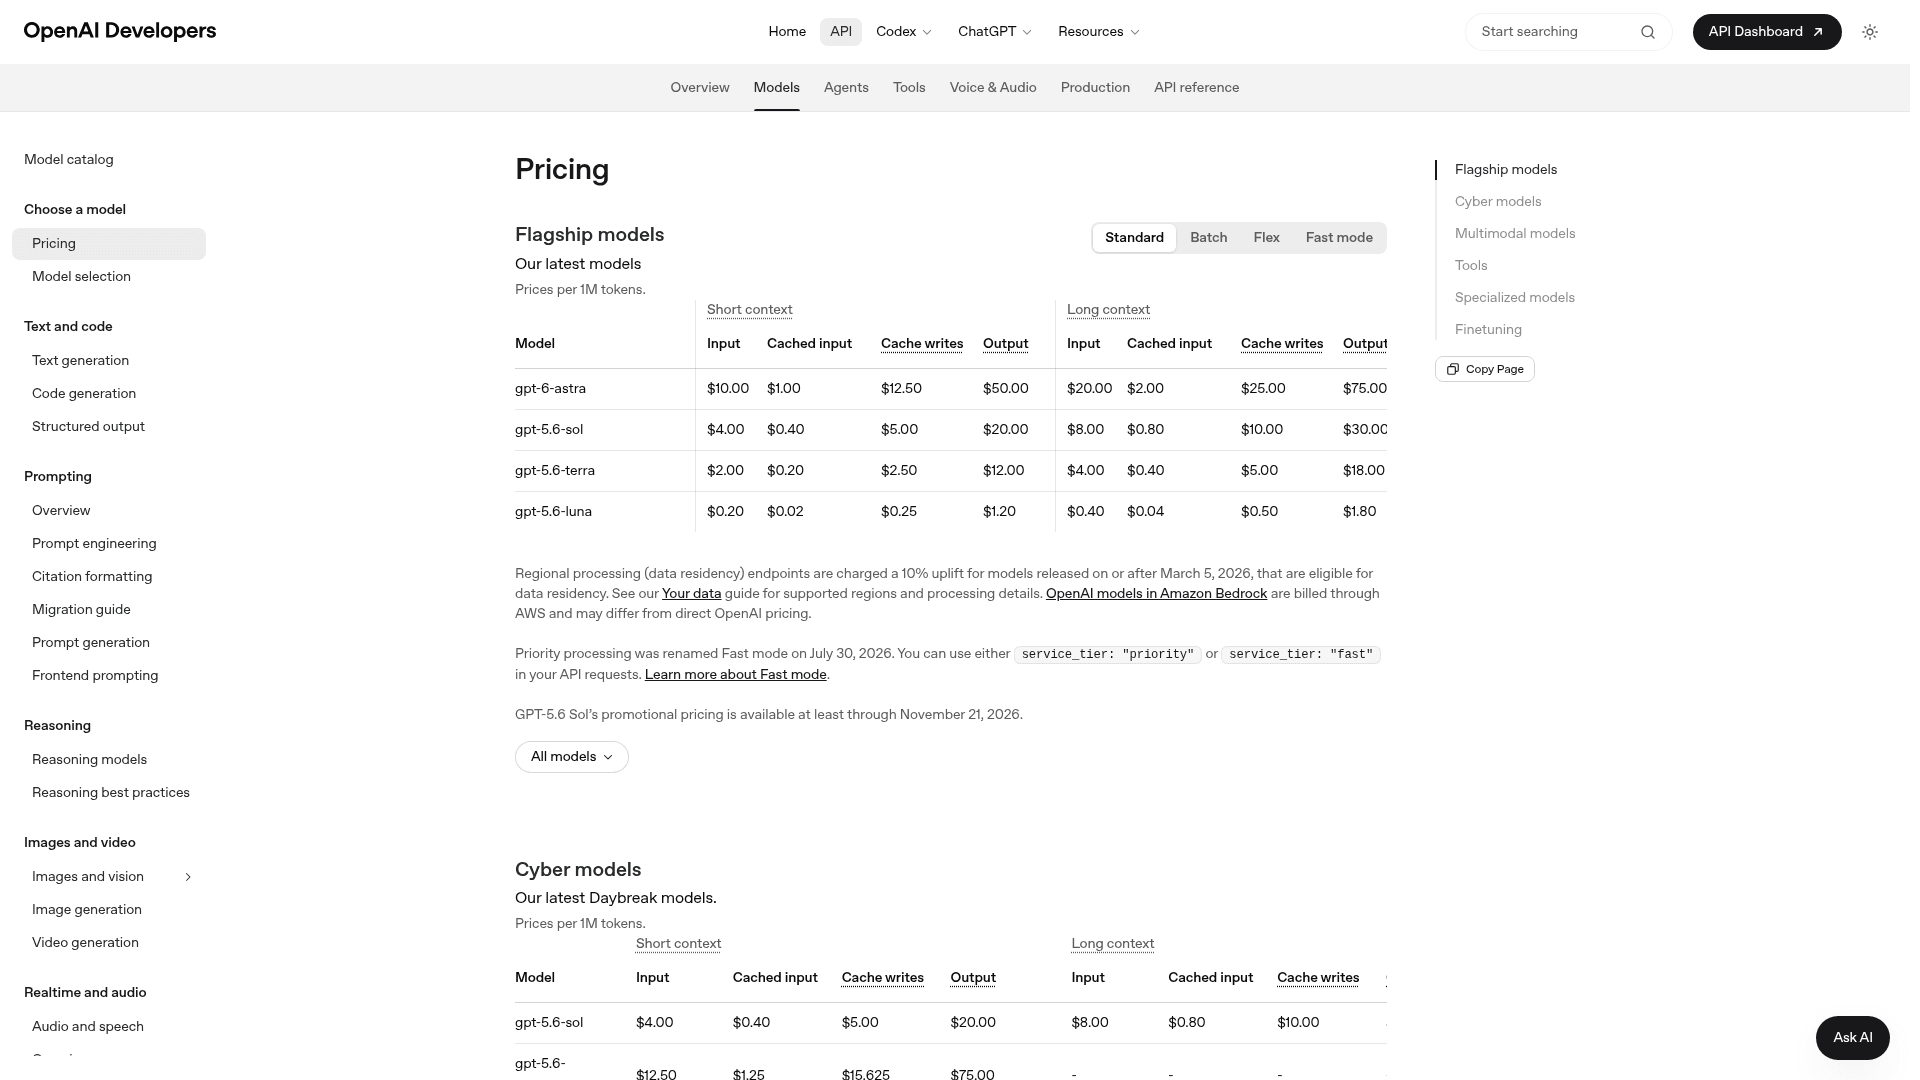
Para contextualizar, esse é um salto real em relação ao restante da linha de modelos da OpenAI. O Astra é agora o segundo modelo mais caro vendido pela OpenAI, atrás apenas do especialista gpt-5.6-cyber. Veja onde cada modelo principal se posiciona no nível padrão, contexto curto:
| Modelo | Entrada (por 1M) | Entrada em cache | Saída (por 1M) | Posição |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Novo modelo principal |
| gpt-5.6-sol | $4.00 | $0.40 | $20.00 | Modelo principal anterior (promo) |
| gpt-5.6-terra | $2.00 | $0.20 | $12.00 | Nível intermediário |
| gpt-5.6-luna | $0.20 | $0.02 | $1.20 | Mais barato |
| gpt-5.6-cyber | $12.50 | $1.25 | $75.00 | Especialista (Daybreak) |
Fonte: Preços da API da OpenAI. Um detalhe com data que vale a pena destacar: o $4/$20 do GPT-5.6 Sol é preço promocional garantido pelo menos até 21 de novembro de 2026, então a diferença de "2,5x" é medida contra um desconto que pode não durar.
Essa paridade de preço com o Fable 5.1 da Anthropic não passou despercebida entre profissionais. Como colocou um comentarista do Hacker News, a OpenAI "finalmente encontrou uma forma de parar de vender barato e lucrar com o cliente de alta demanda, como a Anthropic faz". A consequência mais silenciosa que alguns notaram: com os dois laboratórios de ponta agora a $10/$50, a opção de comparar preços entre eles simplesmente desapareceu.
Níveis de serviço: a variação de 4x que quase todo mundo ignora
A taxa padrão é um ponto de partida, não a história completa. O GPT-6 Astra roda em quatro níveis de serviço, e a diferença entre o mais barato e o mais caro é de 4x para exatamente o mesmo modelo. Essa é a maior alavanca que você tem sobre o custo, mais importante que qualquer otimização de prompt.
| Nível | Entrada (por 1M) | Entrada em cache | Saída (por 1M) | Contrapartida |
|---|---|---|---|---|
| Batch | $5.00 | $0.50 | $25.00 | 50% mais barato, assíncrono, até 24h |
| Flex | $5.00 | $0.50 | $25.00 | 50% mais barato, mais lento, pode entrar em fila |
| Standard | $10.00 | $1.00 | $50.00 | Latência padrão |
| Fast mode | $20.00 | $2.00 | $100.00 | 2x, menor latência |
Fonte: Preços da API da OpenAI. Algumas coisas a saber antes de escolher:
- Batch e Flex custam o mesmo, mas servem para tarefas diferentes. O Batch é para cargas assíncronas que você envia e coleta depois; o Flex é para solicitações interativas que você aceita ver rodar mais devagar ou entrar em fila. Ambos reduzem sua conta pela metade.
- O modo Fast foi renomeado de Priority em 30 de julho de 2026. Você ainda pode passar
service_tier: "priority"ouservice_tier: "fast". Ele dobra a taxa para a menor latência. - O modo Fast tem uma pegadinha regional. Ele não está disponível para o GPT-6 Astra com residência de dados na UE; essas solicitações caem de volta para o padrão.
Se uma carga de trabalho pode tolerar latência, definir Batch ou Flex como padrão corta efetivamente pela metade seu gasto com o Astra sem alterar a qualidade da saída. Isso é a primeira coisa que eu verificaria em qualquer pipeline de alto volume.
As pegadinhas: contexto longo e acréscimo regional
Duas sobretaxas se escondem nas letras miúdas da página do modelo, e ambas podem reformular um orçamento silenciosamente.
Primeiro, contexto longo é cobrado a uma taxa mais alta para a solicitação inteira. A janela de contexto do Astra é enorme, 1.050.000 tokens, mas qualquer prompt acima de 272K tokens de entrada muda toda a solicitação para a taxa de contexto longo: $20 por milhão de entrada e $75 por milhão de saída no nível padrão. Isso é 2x a entrada e 1,5x a saída, e se aplica a cada token da solicitação, não apenas aos que ultrapassam o limite.
| Nível padrão | Contexto curto (≤272K) | Contexto longo (>272K) |
|---|---|---|
| Entrada (por 1M) | $10.00 | $20.00 |
| Entrada em cache | $1.00 | $2.00 |
| Saída (por 1M) | $50.00 | $75.00 |
Segundo, o processamento regional traz um acréscimo de 10%. Endpoints de residência de dados para modelos lançados a partir de 5 de março de 2026 são cobrados 10% a mais. Se você está preso a uma região específica por conformidade, leve isso em conta além de tudo o mais.
E um piso para lembrar: o Astra não está no nível gratuito em lugar nenhum, então o uso Tier 1 é o ponto de entrada para desenvolvedores.
Estime sua conta da API do GPT-6 Astra
Preços de tabela são abstratos até você colocar seus próprios números. Informe os milhões de tokens de entrada e saída que você espera por mês, escolha um nível de serviço, e isso calcula o custo mensal. A sobretaxa de contexto longo é considerada automaticamente.
O padrão que a maioria das equipes observa é que os tokens de saída dominam a conta, já que a saída custa 5x a taxa de entrada. Se sua carga de trabalho gera respostas longas, é para lá que o dinheiro vai, e é ali que mudar um trabalho compatível com lote para o nível Batch se paga mais rápido.
Preços do GPT-6 Astra no ChatGPT
Se você não está chamando a API, o GPT-6 Astra chega até você pelos planos do ChatGPT, e a página de preços traça uma linha clara sobre quem tem acesso.
| Plano | Preço | Acesso ao GPT-6 Astra |
|---|---|---|
| Free | $0 | Não (apenas Luna) |
| Go | $8/mês | Não |
| Plus | $20/mês | Sim |
| Pro | A partir de $100/mês | Ampliado, mais uma variante Pro |
| Business / Enterprise | Por assento | Sim (Enterprise desativado por padrão) |
Fonte: Preços do ChatGPT. Alguns pontos de destaque:
- O Astra começa no Plus. O plano Plus de $20/mês é o ponto de entrada para usuários do ChatGPT. Nem o Free nem o plano Go de $8 o incluem, e os usuários do Free ficam limitados ao GPT-5.6 Luna.
- O Pro dá mais espaço. O Pro, a partir de $100/mês, oferece 5x ou 20x mais uso e um modo de raciocínio Pro de maior esforço, alimentado pelo Astra.
- O Enterprise tem um interruptor. No Business e Enterprise, o Astra está disponível por assento, mas no lançamento vem desativado por padrão por workspace, então um administrador precisa habilitá-lo. Organizações sem fins lucrativos podem obter até 75% de desconto no Business ou Enterprise.
Como o preço do GPT-6 Astra se compara
Olhando de mais longe, onde o Astra se posiciona em relação ao restante da fronteira? Resumindo, a OpenAI parou de competir por preço no topo.
- Contra sua própria linha: a $10/$50, o Astra custa 2,5 vezes mais que o GPT-5.6 Sol e cerca de 4 vezes mais que o GPT-5.6 Terra. Para a maioria das tarefas do dia a dia, Terra ou Luna entregam a maior parte do valor por uma fração do custo.
- Contra a Anthropic: o Astra empata exatamente com o Fable 5.1 a $10/$50, então os dois modelos principais agora têm o mesmo preço.
- Contra o Google: fica bem acima dos preços do Gemini em níveis comparáveis, e muito acima de opções mais leves como o Gemini 3 Flash.
A ansiedade da comunidade com o preço tinha menos a ver com o valor de tabela e mais com o consumo. Um usuário assinante do Codex alertou que o Sol já é "um modelo faminto por tokens" e temia que o Astra, a 2,5x a taxa, consumisse as cotas mais rápido. A nuance: o Astra usa menos tokens por tarefa agêntica, então os dois efeitos se cancelam parcialmente. É exatamente por isso que o custo de um agente de IA nunca é só a taxa por token. O consumo é a outra metade da equação, e você só consegue ver isso no seu próprio tráfego.
O que o preço do GPT-6 Astra significa se você lidera uma equipe de suporte
Aqui eu quero ser útil em vez de apenas listar taxas, porque construo produtos nesse espaço e a resposta honesta é um pouco contraintuitiva.
Se você lidera suporte ao cliente ou operações internas, a chegada de um modelo de fronteira mais forte e mais caro muda menos do que as manchetes sugerem. Um modelo bruto como o Astra é infraestrutura. É um motor espetacular, mas de fábrica ele não conhece sua política de reembolso, não consegue ver seus últimos 50.000 tickets, não tem acesso ao seu sistema de pedidos e não tem uma forma segura de ser testado contra sua fila real antes de começar a responder clientes. Ele é cobrado por token por pensar, não por problema resolvido. A maioria confunde "o modelo ficou mais inteligente e mais caro" com "minha conta de suporte mudou", e são dois projetos diferentes.
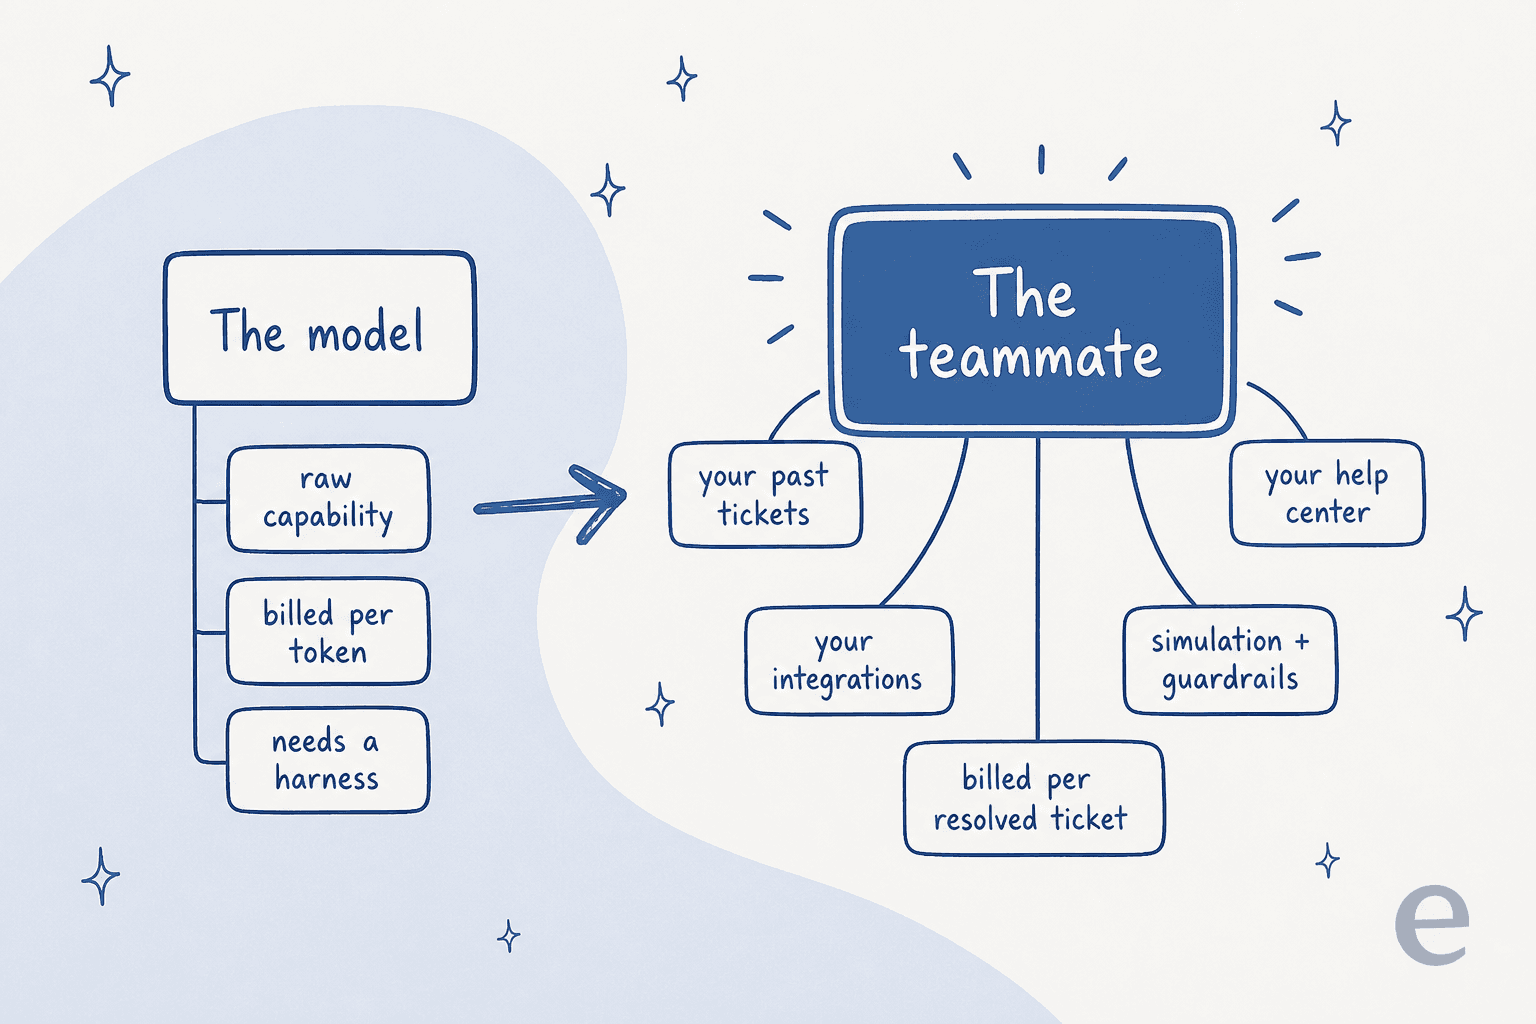
A unidade que realmente importa para uma equipe de suporte é custo por resolução, não custo por token. Uma conta de tokens é imprevisível: ela varia com o tamanho do prompt, retentativas e o quanto o modelo é falante em determinado dia. Passamos anos colocando agentes de IA em filas de suporte ao vivo, e a lição que se repete é que as equipes querem saber quanto custa atender um ticket, ponto final, não quanto custa um milhão de tokens de saída antes mesmo de descobrir quantos tokens um ticket sequer consome. Essa é a diferença entre um modelo e um sistema construído ao redor dele: seu conhecimento, suas integrações, ações seguras e uma forma de simulá-lo sobre seu histórico antes de entrar em produção.
Isso também é o motivo pelo qual eu não trocaria de plataforma na sua automação de suporte na semana em que um novo modelo é lançado. Os melhores agentes de helpdesk de IA e ferramentas de atendimento ao cliente são projetados para serem flexíveis quanto ao modelo, então, quando um modelo genuinamente melhor surge, você herda a melhoria sem reconstruir nada e sem renegociar seu orçamento em torno de uma nova taxa por token.
Experimente o eesel
Se seu interesse no preço do Astra na verdade é "quanto uma IA vai me custar para realmente resolver tickets", essa é a tarefa para a qual um colega de equipe de IA é feito, e é aí que entra o eesel. O GPT-6 Astra é o motor; o eesel é o funcionário que você contrata para conduzi-lo. O agente de helpdesk de IA treina com seus tickets passados e sua central de ajuda, se conecta ao helpdesk que você já usa em vez de substituí-lo, e permite que você o simule contra milhares dos seus tickets históricos reais, para que veja exatamente como ele vai performar, e quanto vai custar, antes de tocar em uma conversa ao vivo.
A cobrança conta a história que o preço por token do Astra não consegue contar. Em vez de pagar por token para pensar, você paga 40 centavos por ticket realmente atendido, sem taxas por assento e sem mínimo de plataforma, então o custo acompanha os resultados em vez do burburinho do modelo. Você pode começar de graça com $50 de uso e sem cartão de crédito, apontá-lo para uma fatia da sua fila e ver os números de resolução nos seus próprios tickets, o que é muito mais útil para decisão do que qualquer gráfico de preço por milhão de tokens.

O preço do GPT-6 Astra é um salto real, e para uso autônomo de computador e trabalho de segurança o prêmio pode valer a pena. Mas para a maioria das equipes de suporte, a taxa por token nunca foi o número que importava. Trazer um colega de equipe testado, conectado e responsável para dentro do seu fluxo de trabalho existente, cobrado pelo resultado, é a parte que vale a pena gastar seu orçamento.
Perguntas frequentes
Quanto custa o GPT-6 Astra na API?
Por que o preço do GPT-6 Astra é mais alto que o do GPT-5.6 Sol?
O GPT-6 Astra está disponível no nível gratuito?
O que é a sobretaxa de contexto longo do GPT-6 Astra?
Quanto custa o GPT-6 Astra no ChatGPT?
O que Batch, Flex e o modo Fast mudam no preço do GPT-6 Astra?
GPT-6 Astra vs GPT-5.6 Sol em preço: qual devo usar?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.