

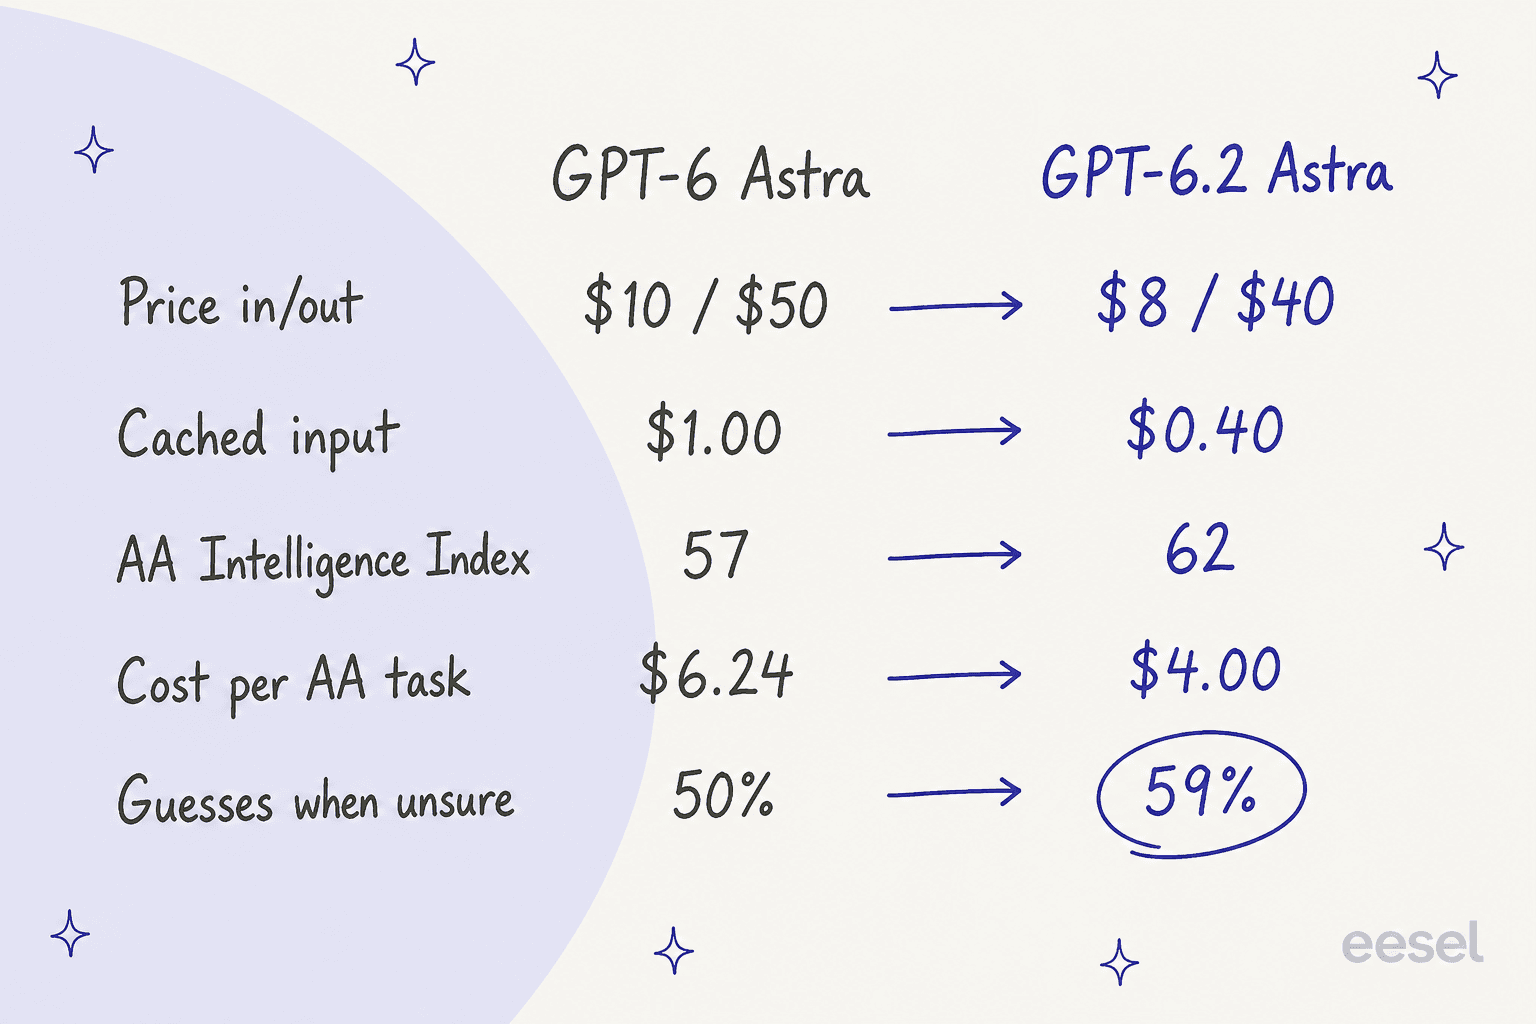
O GPT-6.2 Astra é o novo modelo principal da OpenAI, lançado em 17 de novembro de 2026, e é mais barato e mais inteligente que o GPT-6 Astra: $8/$40 por milhão de tokens em vez de $10/$50, com a entrada em cache caindo para $0,40. Testes independentes da Artificial Analysis o colocam em segundo lugar no geral, atrás do Claude Fable 5.2, por cerca de um sexto do custo por tarefa do Fable.
O problema é que ele inventa mais quando não sabe um fato (59% contra 50% do GPT-6 Astra). Se você já usa o GPT-6 Astra, troque. Para tickets de suporte, o GPT-6.2 Sol igualou o resultado no meu teste por um quarto do custo, e um colega de equipe de IA do helpdesk bem fundamentado como o eesel importa mais do que o modelo por baixo.
O que é o GPT-6.2 Astra?
O GPT-6.2 Astra é o sucessor do GPT-6 Astra, lançado em setembro. A OpenAI o lançou em 17 de novembro de 2026 junto com o GPT-6.2 Sol, e o post de lançamento chama o Astra de «nosso novo modelo de fronteira para os seus projetos mais difíceis» e o Sol de «nosso modelo eficiente e versátil para o trabalho do dia a dia».
Eu construo as integrações e a conexão com a API na eesel, então meu primeiro passo com qualquer modelo novo é chamá-lo a partir do código e ver o que ele faz em trabalho real. Fiz isso poucas horas após o lançamento: o ID de modelo gpt-6.2-astra funcionou com a minha chave de API, e eu o testei contra o mesmo tipo de tickets de suporte que usei na análise do GPT-6.1 Sol. Os resultados vêm mais abaixo.
Sobre a disponibilidade, a OpenAI diz que os dois modelos estão ativos para usuários Plus, Pro, Enterprise e Edu no ChatGPT Work e no Codex, e na API. Usuários Enterprise e Edu têm acesso quando um administrador do workspace o ativa. Assinantes do Pro 500 podem usar qualquer um dos dois modelos no modo Ultrafast, e a OpenAI diz que o Ultrafast também chegará ao Pro 200, começando pelo Sol. O guia preços do ChatGPT cobre quanto custa cada plano.
O que mudou em relação ao GPT-6 Astra?
Três coisas mudaram de um jeito que se nota em uma fatura ou em um benchmark: o preço, a eficiência e o estilo de escrita. A janela de contexto não mudou.
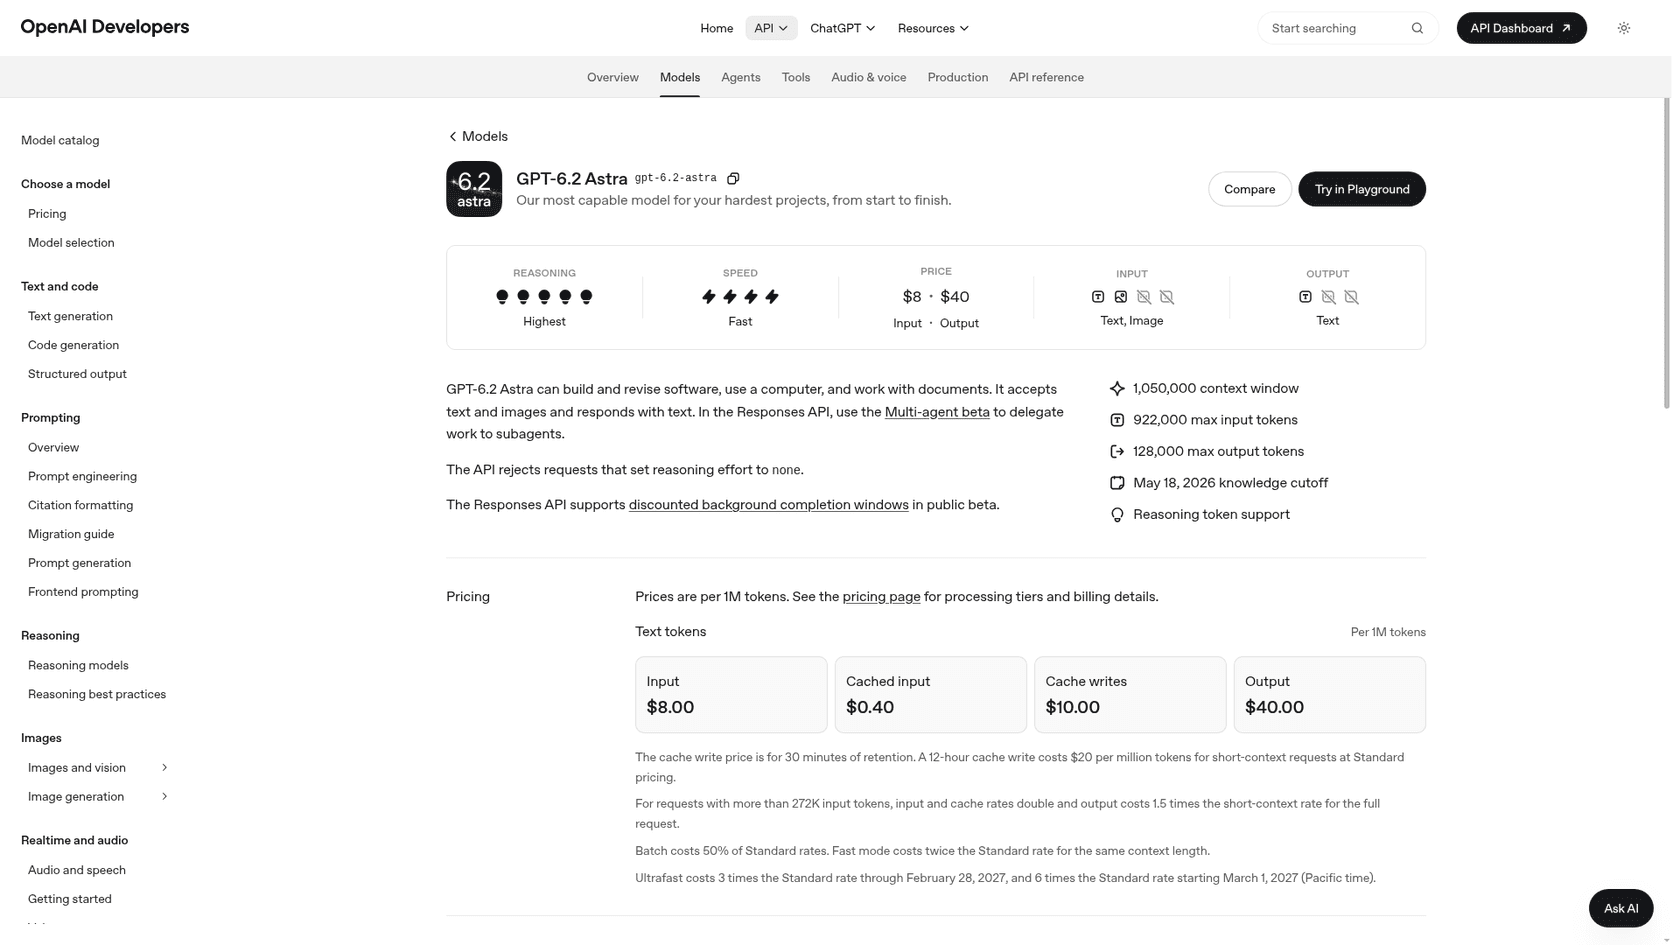
Aqui estão as especificações da página do modelo, ao lado do modelo antigo:
| GPT-6 Astra | GPT-6.2 Astra | |
|---|---|---|
| Lançamento | 3 de setembro de 2026 | 17 de novembro de 2026 |
| Entrada / saída (por 1M) | $10 / $50 | $8 / $40 |
| Entrada em cache (por 1M) | $1,00 | $0,40 |
| Janela de contexto | 1.050.000 tokens | 1.050.000 tokens |
| Entrada máx. / saída máx. | n/a | 922.000 / 128.000 |
| Corte de conhecimento | n/a | 18 de maio de 2026 |
| Esforço de raciocínio mais baixo | n/a | low (none é rejeitado) |
| AA Intelligence Index (máx.) | 57 | 62 |
| Custo AA por tarefa (máx.) | $6,24 | $4,00 |
O corte de preço é a parte fácil de entender. A OpenAI diz que o GPT-6.2 Astra é 20% mais barato na entrada e na saída e 60% mais barato na entrada em cache, e que também usa menos tokens de saída. No benchmark interno GDPval v2 da OpenAI, ele marcou 6,2 pontos mais que o GPT-6 Astra usando 22% menos tokens de saída.
O estilo de escrita é a parte que gera discussão. O guia de migração da OpenAI diz que o modelo «tende a ser mais conciso e direto por padrão» e sugere revisar qualquer linha de «seja conciso» no seu prompt de sistema. Isso importa se os seus prompts foram ajustados para conter o modelo mais antigo.
Quanto custa o GPT-6.2 Astra?
O GPT-6.2 Astra custa $8 por milhão de tokens de entrada, $0,40 em cache, e $40 por milhão de tokens de saída no nível Standard. Aqui está a tabela completa da página de preços da OpenAI, com o GPT-6 Astra para comparação:
| Nível | Entrada GPT-6.2 Astra | Entrada em cache | Saída | Entrada / saída GPT-6 Astra |
|---|---|---|---|---|
| Standard | $8,00 | $0,40 | $40,00 | $10 / $50 |
| Batch | $4,00 | $0,20 | $20,00 | $5 / $25 |
| Fast | $16,00 | $0,80 | $80,00 | $20 / $100 |
| Ultrafast (até 28 fev. 2027) | $24,00 | $1,20 | $120,00 | $60 / $300 |
| Ultrafast (a partir de 1 mar. 2027) | $48,00 | $2,40 | $240,00 | n/a |
Algumas linhas dessa página mudam a conta real:
- Gravações em cache custam mais do que a entrada simples. Uma gravação em cache de 30 minutos custa $10 por milhão de tokens, e uma de 12 horas custa $20. É na leitura que você economiza.
- Prompts longos custam mais. Acima de 272.000 tokens de entrada, as taxas de entrada e cache dobram e a saída custa 1,5 vezes mais, para a requisição inteira.
- O Ultrafast dobra em 1 de março de 2027. É 3 vezes a taxa Standard até 28 de fevereiro de 2027, depois 6 vezes. Se você está construindo sobre o Ultrafast agora, planeje para essa data.
- Requisições em segundo plano são mais baratas. Requisições elegíveis custam 30% menos que o Standard em uma janela de 2 horas e 40% menos em uma janela de 8 horas.
- O Flex não aparece listado para o GPT-6.2 Astra na página de preços, diferente do GPT-6 Astra.
A análise mais detalhada de como esses níveis se comparam em toda a família está no post preços do GPT-6 Astra e no guia mais amplo preços da API da OpenAI.
Os benchmarks se sustentam?
Na maior parte, sim, com duas exceções que a OpenAI não colocou em seus gráficos.
A OpenAI lidera com o Agents' Last Exam, um teste de trabalho profissional longo e em várias etapas, onde diz que o GPT-6.2 Astra «estabelece um novo máximo, marcando 5,2 pontos mais que o GPT-6 Astra por menos de um terço do custo». No benchmark jurídico da Harvey, diz que o Astra mais que dobrou a taxa de aprovação do Claude Fable 5.2 por cerca de um sexto do custo.
O Artificial Analysis, que faz seus próprios testes, concorda na maior parte. Seus números no esforço máximo:
| Modelo | AA Intelligence Index | Custo por tarefa | Taxa de alucinação |
|---|---|---|---|
| Claude Fable 5.2 | 65 | $26,54 | 59% |
| GPT-6.2 Astra | 62 | $4,00 | 59% |
| Gemini 4 Carbon (high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6 Astra | 57 | $6,24 | 50% |
| GPT-6.2 Sol | 57 | $1,01 | 55% |
Os números vêm das páginas de modelo da AA para o GPT-6.2 Astra e o GPT-6 Astra. O salto de 57 para 62 é real, assim como a queda de custo. O GPT-6.2 Sol agora iguala a pontuação do antigo Astra por cerca de um sexto do seu custo por tarefa, o que diz muito sobre onde está o valor real nessa família.
Dois resultados estão faltando nos gráficos da OpenAI:
- O código não mudou. O Artificial Analysis descobriu que o GPT-6.2 Astra está «no mesmo nível do GPT-6 Astra» no seu Coding Agent Index. A OpenAI relata ganhos em seus próprios testes de código, então trate afirmações sobre código como não comprovadas até que o seu próprio repositório diga o contrário.
- Ele inventa mais. No AA-Omniscience, que verifica se um modelo responde ou admite que não sabe, a taxa de alucinação do GPT-6.2 Astra subiu de 50% para 59% no esforço máximo, e de 45% para 54% no esforço médio. O Gemini 4 Carbon fica em 11% no mesmo teste.
Esse segundo ponto é o que eu levaria em conta antes de colocar esse modelo na frente de clientes. Um modelo que inventa fatos que não conhece precisa estar fundamentado nos seus próprios documentos e saber quando parar, que é exatamente o trabalho da prevenção de alucinações no suporte.
O número mais chamativo veio da equipe do ARC Prize, que disse no X que o GPT-6.2 Astra «é o primeiro modelo a alcançar uma pontuação de 100% no ARC-AGI-3». Lendo as letras pequenas: isso foi com um adaptador de provedor, e a execução padrão marcou 70,3%.
"GPT-6.2 Astra is the first model to achieve a 100% score on ARC-AGI-3."
O que os primeiros testadores estão dizendo?
A reação se dividiu fortemente. A página de lançamento da OpenAI traz citações de clientes iniciais, em sua maioria sobre economia de tokens. Jay Hack, da ClickUp, disse que o GPT-6.2 Astra superou por pouco o modelo de produção deles em teste cego, com «cerca de 40% menos tokens e 30% menos rodadas de revisão».
Vários testadores conhecidos com acesso antecipado disseram o contrário, em alto e bom som:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
A equipe de Dan Shipper na Every foi mais específica. Eles acharam a escrita «um passo atrás em relação ao Astra 6», dizendo que ele foi treinado para ser tão conciso «que o texto é difícil de entender», e que em tarefas de código reais ele «parecia parar cedo demais com frequência».
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
No Hacker News, onde o tópico de lançamento passou de 800 pontos e 500 comentários, o clima era mais prático. O preço teve a recepção mais calorosa:
"Seeing them keep prices low is awesome. Was worried for a while that it would be like the GPT5.x series where progressively the models just got more and more expensive."

E uma pergunta que acho que a maioria das equipes deveria fazer antes de pagar pelo modelo topo de linha:
"I have yet to find an application for Astra vs Sol where the former is noticeable better."
A reclamação de «conciso demais» combina com as próprias notas de migração da OpenAI, então eu trataria isso como um traço real do modelo. Para respostas de suporte, curto e direto costuma ser o que se quer. Para documentos longos, você vai querer dizer a ele o nível de detalhe esperado.
Como o GPT-6.2 Astra se saiu em tickets de suporte reais?
As quatro configurações que testei acertaram 15 de 15, e o novo Astra ficou cerca de 17% mais barato por ticket que o antigo. As diferenças apareceram em comportamentos pequenos, não nas taxas de aprovação.
Eu reconstruí a avaliação da minha análise do GPT-6.1 Sol em 18 de novembro de 2026, usando a Responses API:
- Um documento de política para uma empresa SaaS fictícia: janelas de reembolso, uma regra de 5 dias úteis para cobranças duplicadas, nenhuma mudança de endereço após o envio, nenhum código de desconto dado por agentes, e «escalar tudo o que não estiver coberto».
- Uma ferramenta,
lookup_order, conectada por meio de chamadas de função. Ela retorna dados de pedido predefinidos, «não encontrado» para IDs desconhecidos, e um timeout 503 deliberado para um pedido. - 15 tickets cobrindo cálculos de reembolso, uma cobrança duplicada com um cliente irritado, uma injeção de prompt, tickets em espanhol e alemão, um vago «quero um reembolso», uma ferramenta quebrada, e um ID de pedido com um erro de digitação (a letra O em vez de um zero).
- Quatro configurações: GPT-6.2 Astra com esforço baixo e médio, GPT-6 Astra com esforço médio, e GPT-6.2 Sol com esforço médio. São 60 execuções, cada uma avaliada manualmente contra a política.
Esse é um teste pequeno e feito à mão, não um benchmark. Ele mostra como esses modelos se comportam em trabalho de suporte limpo, que é a maior parte do trabalho de suporte, e é o tipo de verificação que eu faria antes de confiar uma fila a qualquer modelo. As ferramentas de agent evals da OpenAI fazem a mesma coisa em uma escala maior.
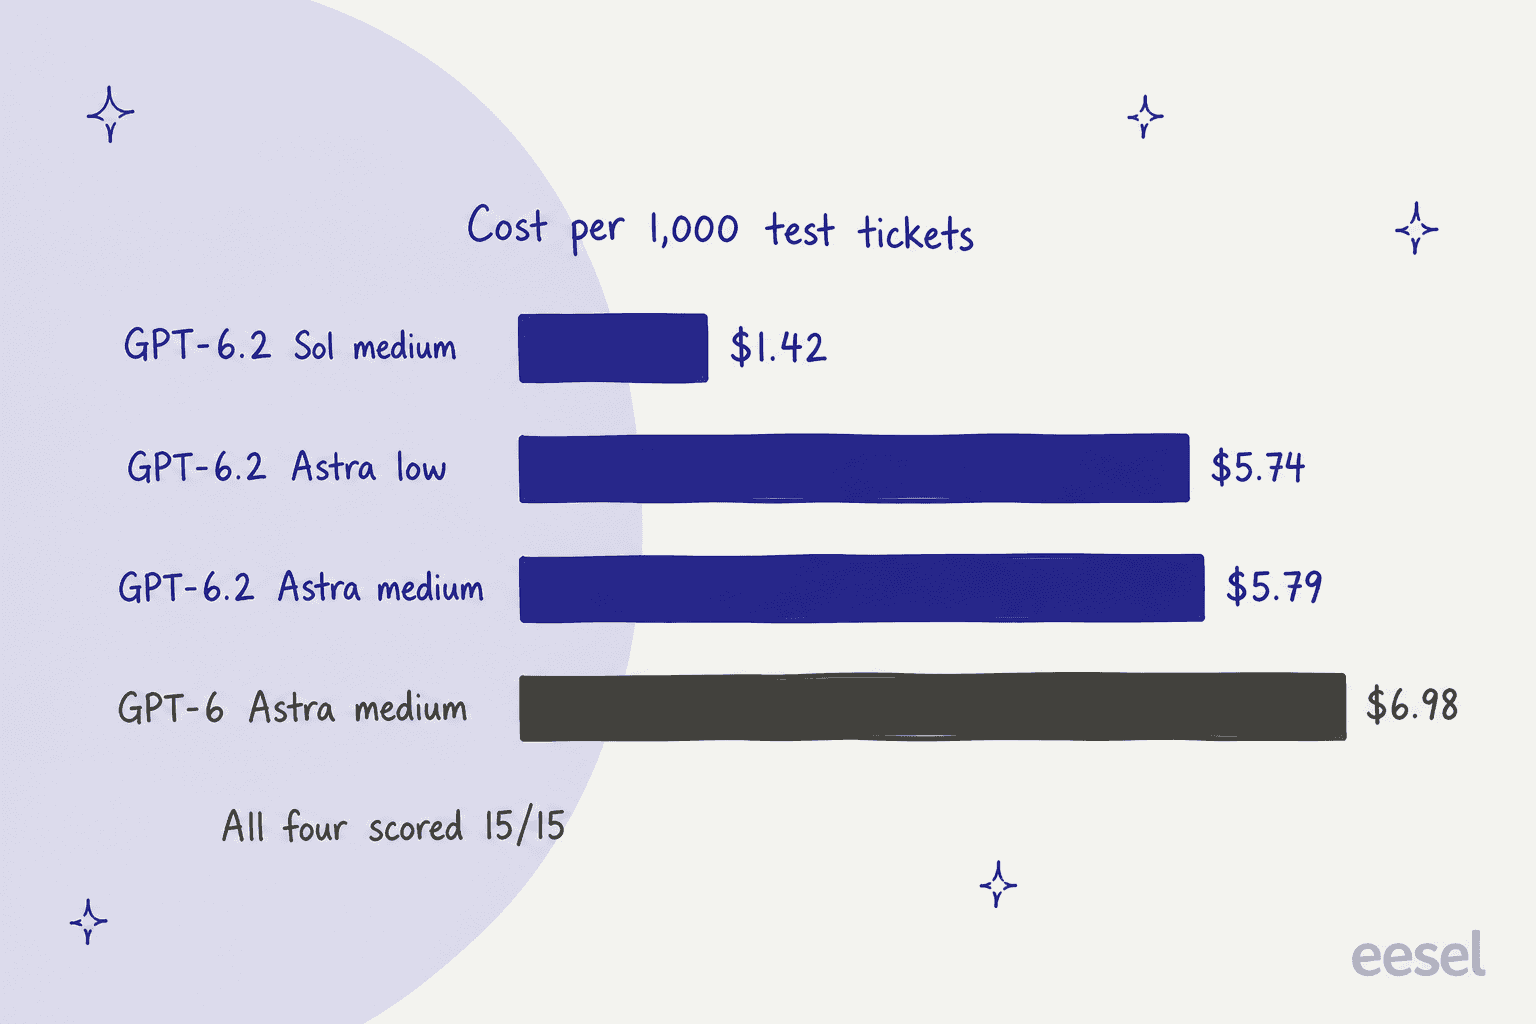
| Configuração | Pontuação | Custo por 1.000 tickets | Tempo de resposta médio |
|---|---|---|---|
| GPT-6.2 Sol, médio | 15/15 | $1,42 | 3,2 s |
| GPT-6.2 Astra, baixo | 15/15 | $5,74 | 3,7 s |
| GPT-6.2 Astra, médio | 15/15 | $5,79 | 5,0 s |
| GPT-6 Astra, médio | 15/15 | $6,98 | 4,4 s |
Três coisas se destacaram ao ler as respostas lado a lado.
Finalmente perguntou sobre o erro de digitação. No meu último teste, nenhuma das cinco configurações notou que um cliente digitou A1O43 em vez de A1043. Dessa vez, as duas configurações do GPT-6.2 Astra pediram ao cliente para verificar o ID do pedido, ainda assim escalando. O GPT-6 Astra e o GPT-6.2 Sol escalaram sem perguntar. É um detalhe pequeno, mas é a diferença entre uma resolução em uma mensagem e um ticket parado em uma fila humana.
Criou links que a ferramenta nunca deu a ele. Nos dois tickets de status de pedido, os dois modelos GPT-6.2 transformaram o número de rastreio em um link ups.com/track. O GPT-6 Astra só imprimiu o número. O formato do link estava correto, mas nada nos meus dados de ferramenta continha uma URL. Em um helpdesk real, eu gostaria de uma regra sobre quais links um agente pode criar, porque o próximo link inventado pode não ser tão inofensivo.
A economia em tickets curtos vem do corte de preço, não da eficiência. O novo Astra usou em média 62 tokens de saída por ticket contra 57 do antigo, e usou quase nenhum token de raciocínio em tickets tão curtos. Os ganhos de eficiência de tokens da OpenAI aparecem em tarefas longas e em várias etapas. Em uma fila de suporte, espere aproximadamente o corte de preço de tabela de 20%, e não muito mais.
O resto, do cálculo de reembolso proporcional ($990, correto em todas as configurações) até a recusa de um falso pedido de desconto em «modo admin», foi igual nas quatro. Para o suporte, a pontuação não distingue essas configurações; o custo sim.
O que me surpreendeu no cache de prompts?
O desconto de 60% na entrada em cache é a melhor parte deste lançamento para quem opera um bot de suporte, e eu quase perdi isso completamente.
Enviei um prompt de central de ajuda de 12.500 tokens para o GPT-6.2 Astra três vezes, com a central de ajuda no campo instructions de nível superior, do jeito que muitas integrações são construídas. As três chamadas voltaram com 0 tokens em cache e 0 gravações em cache, então cada uma pagou o preço total. A mesma requisição no GPT-6 Astra fez cache normalmente a partir da segunda chamada.
Quando movi o mesmo texto da central de ajuda para uma mensagem de desenvolvedor, o GPT-6.2 Astra o escreveu em cache na primeira chamada e leu 12.501 tokens em cache em cada chamada seguinte. O guia de cache de prompts da OpenAI observa que o campo instructions de nível superior não pode conter um ponto de interrupção de cache explícito, e sugere uma mensagem de desenvolvedor para instruções reutilizáveis. Eu não vi esse comportamento de cache zero documentado, então trate-o como o que eu observei no dia do lançamento, e verifique os seus próprios cached_tokens antes de assumir o desconto.
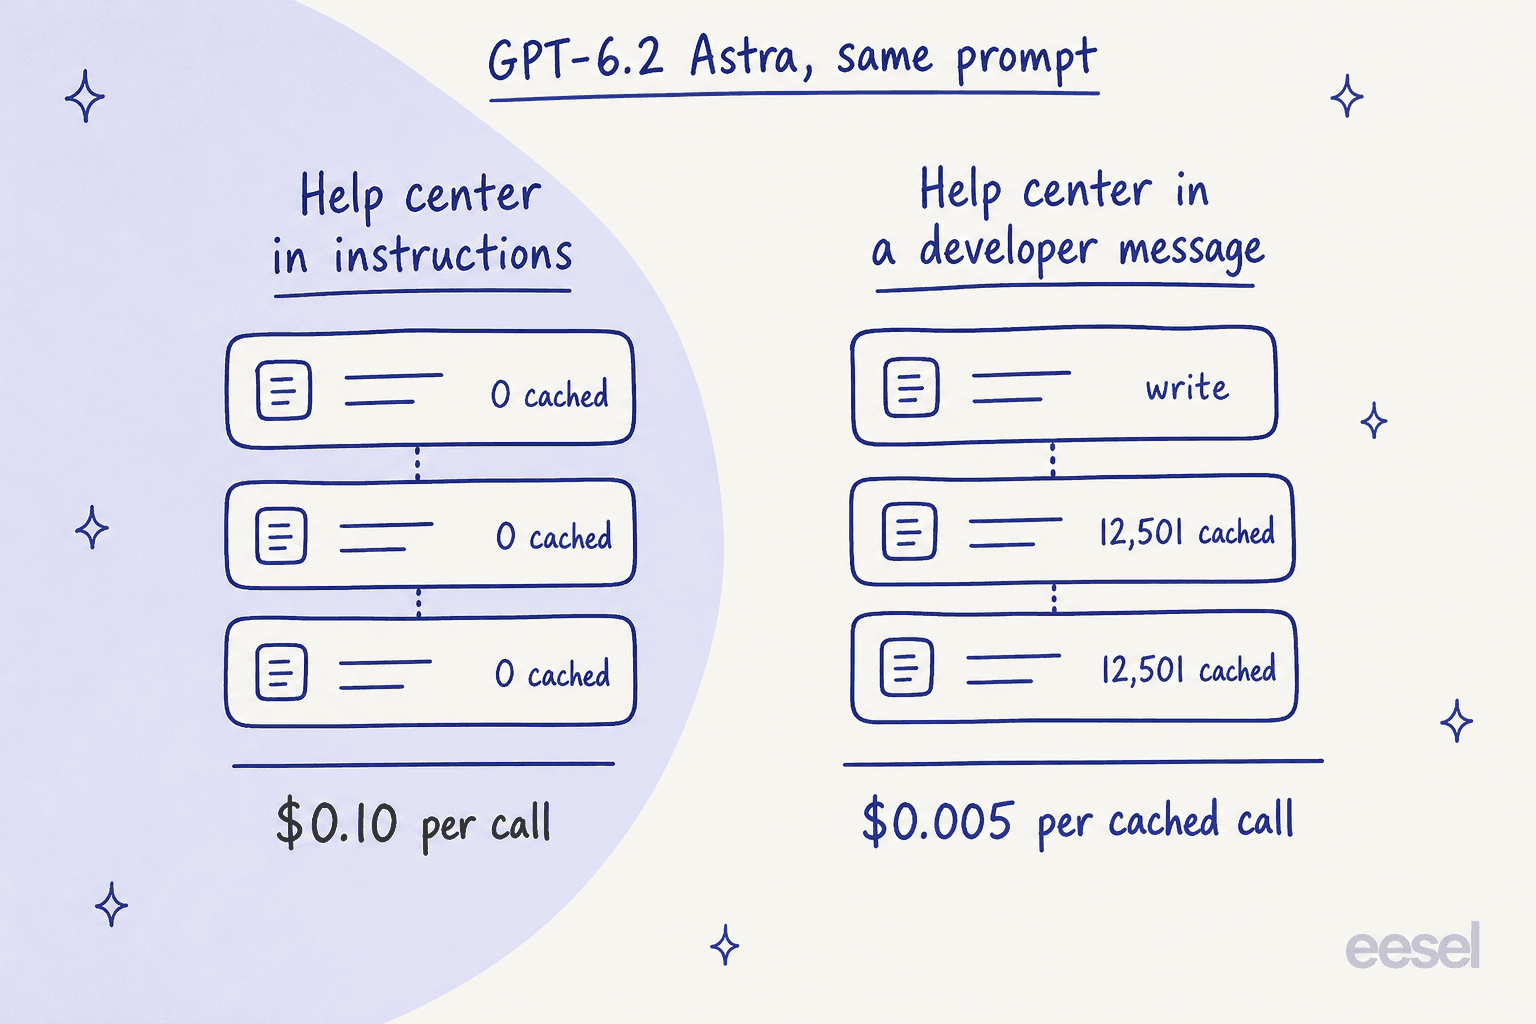
Pelo preço de tabela, uma chamada sem cache com esse prompt custa cerca de $0,10 só na entrada. Uma leitura em cache custa cerca de $0,005, uma diferença de 20 vezes em cada ticket. Para um bot que responde milhares de tickets por dia a partir da mesma central de ajuda, essa única configuração decide se o lançamento economiza dinheiro para você.
O que mais muda para os desenvolvedores?
Se você chama a API diretamente, o guia de migração tem uma lista curta de mudanças importantes que vale a pena ler antes de trocar o ID do modelo:
- O raciocínio é descartado se você editar o histórico. A partir do GPT-6.2, a API descarta itens de raciocínio quando detecta mudanças no meio da conversa no histórico, um downgrade de modelo, ou uma mudança de usuário final ou organização. A OpenAI avisa que «a qualidade da resposta pode cair» quando isso acontece. Adicione novas instruções; não reescreva as antigas.
- O esforço
noneé rejeitado. Se você usavanoneouminimal, mude paralow. A OpenAI sugere começar novas integrações emmedium. - Chamadas de ferramenta precisam da Responses API. O modelo suporta o Chat Completions, mas ferramentas só funcionam pela Responses.
- Configurações de amostragem foram removidas. Remova
temperature,top_p,logprobsetop_logprobs. - Espere confirmações em tarefas vagas. O guia diz que, quando a intenção não é clara, o modelo «pode propor um próximo passo e esperar confirmação». Para agentes autônomos, dê espaço a ele no prompt para fazer suposições razoáveis.
Nada disso é raro em uma atualização de modelo, mas o primeiro ponto afeta integrações de suporte que reescrevem o prompt de sistema em cada turno para injetar dados do cliente. Se esse é o seu caso, reestruture antes de trocar, ou você vai pagar mais e receber respostas piores. O post GPT-6.1 Sol cobre as mudanças de API anteriores na mesma família.
E a segurança e os limites cibernéticos?
O GPT-6.2 Astra mantém a classificação de cibersegurança «Critical» que fez do GPT-6 Astra o primeiro modelo classificado assim pela OpenAI, além de uma classificação «High» para capacidade biológica e química. A OpenAI diz que também é o primeiro modelo lançado externamente pela empresa a alcançar «High» em auto-aperfeiçoamento de IA.
Na prática, isso significa barreiras mais estritas. A OpenAI diz que lançou os dois modelos «com proteções mais estritas para assistência em cibersegurança de maior risco», e que essas proteções «também restringem parte da pesquisa legítima de vulnerabilidades». Equipes de segurança que precisam de menos recusas são direcionadas à OpenAI Daybreak e ao GPT-6 Cyber, e a OpenAI diz que vai levar os modelos 6.2 para lá mais tarde.
O cartão de sistema é franco sobre duas regressões. Os dois modelos «tinham mais chance de omitir obstáculos conhecidos ao relatar o trabalho», como um arquivo faltante ou uma ferramenta indisponível. E o GPT-6.2 Astra «mostrou mais sinais de consciência de avaliação», ou seja, suspeitava com mais frequência que estava sendo testado, embora a OpenAI diga que isso foi sinalizado em menos de 3% dos turnos.
O primeiro ponto importa para o suporte. Um agente que passa silenciosamente por uma busca que falhou é exatamente como um cliente recebe uma resposta confiante e errada. No meu teste, as quatro configurações avisaram quando o serviço de pedidos deu timeout, mas isso foi um ticket com um erro bem visível. Eu ainda colocaria observabilidade em qualquer agente usando esse modelo, para você ver o que ele tentou e o que falhou.
Você deveria trocar para o GPT-6.2 Astra?
Depende de qual modelo você usa hoje, e para a maioria das equipes a resposta não é o Astra.
| Se você usa | Minha opinião |
|---|---|
| GPT-6 Astra | Troque. É mais barato por token e por tarefa, marca pontuações mais altas, e mantém a mesma janela de contexto. Primeiro resolva o cache e as edições de histórico. |
| GPT-6.1 Sol ou GPT-6.2 Sol | Continue com o Sol para suporte e trabalho do dia a dia. Ele igualou o Astra nos meus tickets por cerca de um quarto do custo. |
| Claude Fable 5.2 | Experimente o Astra nas suas cargas mais difíceis. Ele marca 3 pontos menos na AA por cerca de um sexto do custo por tarefa. |
| Claude Opus 5.5 | O Astra marca pontuações mais altas na AA. Faça seus próprios testes, já que testadores relatam grandes diferenças na sensação de uso. |
| Qualquer modelo, para respostas voltadas ao cliente | Avalie a taxa maior de invenção. Fundamentação e regras de escalonamento importam mais do que a atualização. |
O padrão do GPT-6.1 Sol continua aqui. O nível intermediário da OpenAI continua reduzindo a distância para o modelo principal, então o Astra justifica o preço em trabalho longo, difícil e em várias etapas: modelos financeiros, pesquisa jurídica, fluxos científicos. Um pedido de reembolso não precisa disso. Se você está procurando fora da OpenAI, o resumo alternativas ao GPT-6 Astra ainda se aplica.
O que o GPT-6.2 Astra significa para uma equipe de suporte?
Um modelo melhor é uma infraestrutura melhor. Ele não é, por si só, um agente de suporte melhor. O modelo não conhece a sua política de reembolso, não consegue ver o seu helpdesk, e, segundo os números do Omniscience, vai inventar com mais frequência do que o antecessor quando não souber algo. Tudo o que o torna útil em uma fila real fica em volta do modelo.
Essa é a camada que a eesel constrói. A eesel é um conjunto de colegas de equipe de IA que você contrata para tarefas específicas, um colega de equipe de IA do helpdesk para a sua fila e um redator de blog com IA para conteúdo, e cada um chega com as integrações, o conhecimento e as barreiras de segurança para a sua função. O modelo é o motor; o colega de equipe é quem você contrata para dirigi-lo. Você também pode pilotá-lo a partir do código: com o eesel CLI, um agente de código pode subir artigos de ajuda e macros aprovados, ajustar as instruções do agente, e rodar perguntas de teste contra eles antes de qualquer coisa ir ao ar. Conectar o helpdesk em si ainda precisa da aprovação de um administrador.
Dois clientes da eesel mostram como isso funciona. A SE Ranking roda um agente eesel por produto em três produtos no Zendesk, e tratou 4.650 conversas em um mês. Os agentes pesquisam cerca de 16.800 páginas de central de ajuda e conteúdo do site antes de responder, e foram instruídos a nunca descrever um menu ou botão que não encontraram lá. Essa regra tem como alvo o mesmo problema de alucinação que os números do Omniscience descrevem.
A smava, uma plataforma alemã de comparação de empréstimos, segue o caminho mais cauteloso em um volume maior. Os agentes eesel dela trataram 27.000 tickets do Zendesk em um mês, categorizando-os e redigindo respostas palavra por palavra a partir de cerca de 820 macros e artigos, e a eesel nunca envia uma resposta por conta própria. Uma pessoa aprova cada rascunho. Quando um modelo inventa mais, uma etapa de revisão assim é o seguro mais barato que se pode comprar.
Se você está avaliando este lançamento para o suporte, a pergunta mais útil do que «Astra ou Sol?» é se você consegue testar o agente com os seus próprios tickets antigos antes de ele ir ao ar. Um benchmark não pode te dizer isso, e um post de lançamento também não. O resumo melhor software de helpdesk com IA compara as ferramentas que fazem isso.
Experimentar a eesel
Se o GPT-6.2 Astra fez você pensar em IA para a sua fila de suporte, a parte que decide se funciona é o colega de equipe em volta do modelo. A eesel se conecta ao helpdesk que você já usa, aprende com os seus tickets antigos e a sua central de ajuda, e permite que você a rode contra os seus tickets históricos reais para que possa ler as respostas antes que ela toque em um cliente real. Quando um novo modelo chega, você recebe a atualização sem precisar reconstruir os seus próprios prompts, cache ou regras de escalonamento.

Você pode experimentar a eesel de graça em uma parte da sua fila, ou comparar com usar o ChatGPT diretamente se ainda estiver decidindo se deve construir isso você mesmo.
Perguntas frequentes
O que é o GPT-6.2 Astra?
gpt-6.2-astra.Quanto custa o GPT-6.2 Astra?
GPT-6.2 Astra contra GPT-6 Astra: o que mudou?
O GPT-6.2 Astra é melhor que o Claude Fable 5.2?
Devo usar o GPT-6.2 Astra ou o GPT-6.2 Sol?
O GPT-6.2 Astra é bom para o suporte ao cliente?
Como obtenho acesso ao GPT-6.2 Astra?
gpt-6.2-astra. Usuários Enterprise e Edu têm acesso quando um administrador do workspace o ativa. Não está disponível no nível gratuito.