O lançamento que deu erro 500 antes da AGI chegar
Vamos começar pelo momento que definiu o tom. A OpenAI posicionou o Astra como "o modelo mais inteligente e alinhado do mundo", o presidente Greg Brockman disse a jornalistas que acredita pessoalmente que ele alcança a AGI, e então a própria página de lançamento retornou erros de servidor por mais de uma hora. O Hacker News fez o que o Hacker News sempre faz:
"So, on the one hand, we have AGI; on the other, the release page is returning 500s."

Essa lacuna entre o discurso e a realidade percorre toda esta análise. Vale a pena ser preciso sobre a alegação de AGI, porque ela foi repetida por toda parte: a frase "alcançamos a AGI" veio de Brockman em entrevistas à imprensa, não das próprias páginas de lançamento ou de segurança da OpenAI. A citação mais marcante que a OpenAI de fato publica sobre uma mudança de era vem de um avaliador externo, Greg Burnham da EpochAI, que disse que "the story is: end of one era, start of another". Essa é uma afirmação muito mais defensável do que AGI, e é a que eu adotaria como referência.
Passei os últimos três anos e pouco observando lançamentos de modelos pousarem em sistemas de produção reais (rodamos IA em filas de suporte reais todos os dias), e o padrão é consistente: o gráfico de benchmarks e a experiência real de uso são duas coisas diferentes. Então, em vez de aceitar de bandeja a manchete "nova geração de inteligência", eu leio o Astra como duas histórias separadas que a OpenAI fundiu em um único lançamento. (Se você quiser o resumo direto de especificações e preços sem o veredito, meu artigo explicativo sobre o GPT-6 Astra cobre isso.)
As duas histórias dentro de uma única tabela de benchmarks
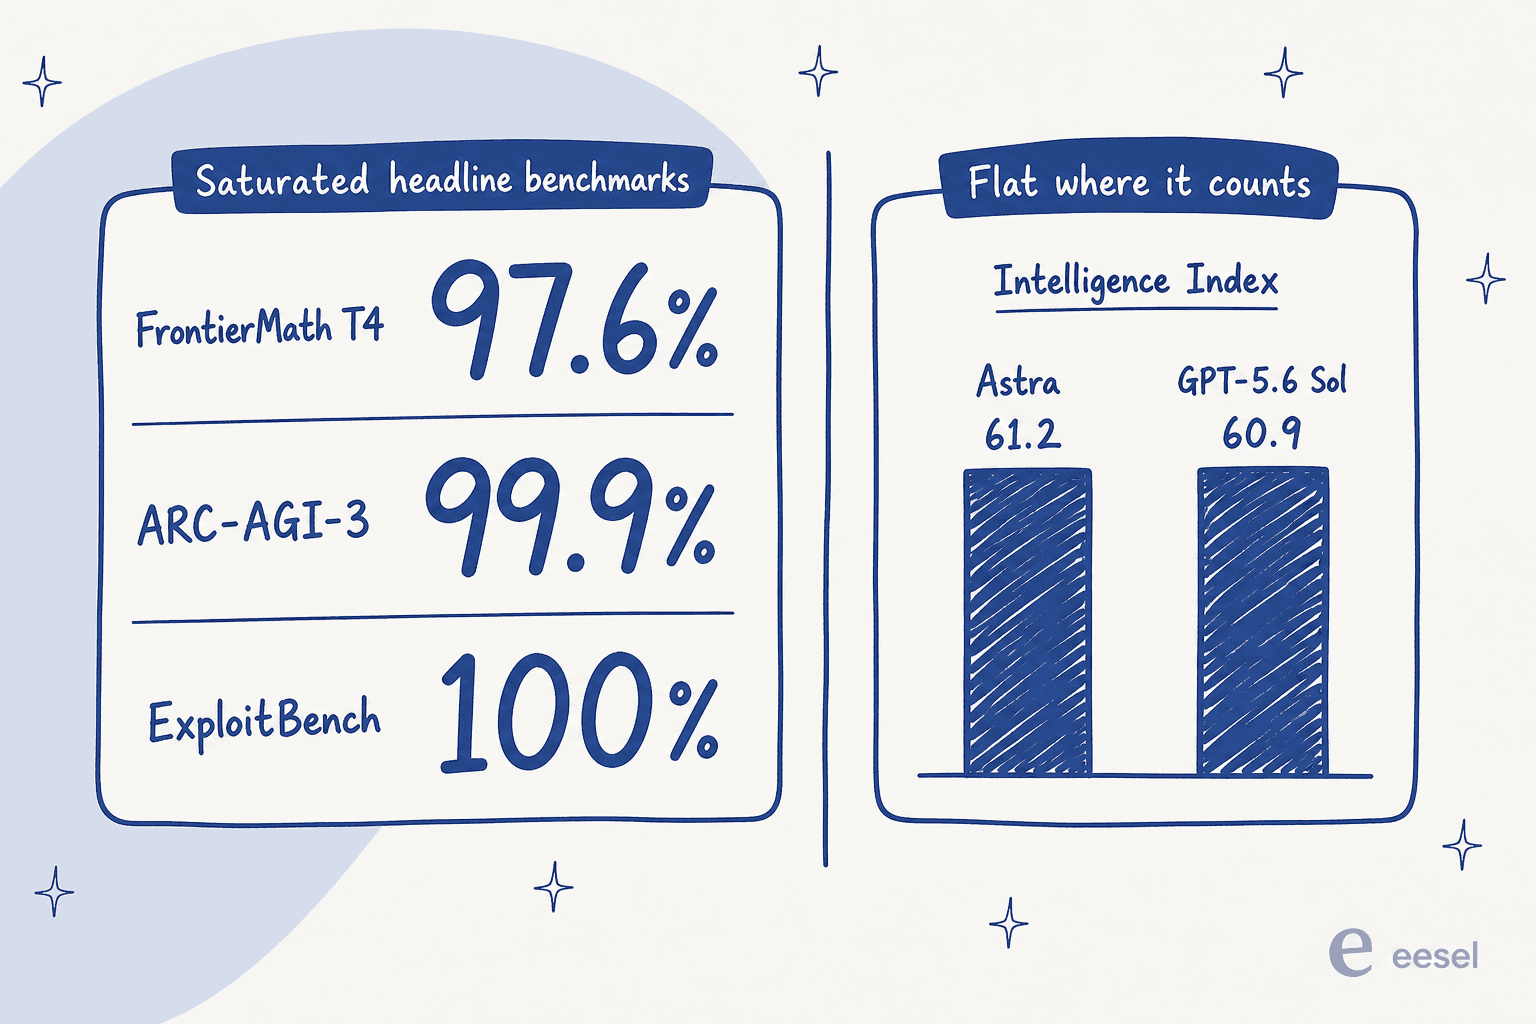
A primeira história é a manchete. O Astra "satura" um conjunto de benchmarks difíceis: FrontierMath Tier 4 com 97,6%, ARC-AGI-3 com 99,9% e ExploitBench com 100%. São números impressionantes, e a ARC Prize confirmou de forma independente o resultado do ARC-AGI-3, observando que o Astra supera a referência humana em 96% dos níveis. Isso não é marketing; é um recorde real.
A segunda história aparece quando você olha para o benchmark que os compradores realmente acompanham. No Artificial Analysis Intelligence Index independente, o Astra fica em 61,2, praticamente empatado com os 60,9 do Sol, e atrás dos 65,7 do Fable 5.1. É exatamente por isso que a segunda maior discussão do dia de lançamento pareceu tão desanimadora.
A Artificial Analysis, o grupo independente de benchmarking, expôs essa divisão claramente em sua própria análise:
"GPT-6 Astra makes significant gains in the Artificial Analysis Coding Agent Index, scoring equal to Fable 5 at lower cost. In the Intelligence Index, it uses fewer tokens than GPT-5.6 Sol for similar performance, but this is outweighed by higher prices."
Aqui está o quadro completo tirado da própria tabela da página de lançamento da OpenAI, com a ressalva que a própria OpenAI sinaliza: são escores máximos com qualquer nível de esforço, executados no ambiente da OpenAI, e vários números de concorrentes trazem ajustes de avaliação da própria OpenAI marcados em notas de rodapé. Trate as linhas entre fornecedores como dados reportados pelo fornecedor, não como verdade absoluta.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | 80.5% | 78.0% | 73.2% |
| ARC-AGI-3 | 99.9% | 7.8% | – | 30.2% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% |
| Terminal-Bench 4.0 (codificação) | 57.9% | 37.3% | 55.8% | 52.3% |
| Agents' Last Exam | 59.3% | 53.6% | – | 55.5% |
| ExploitBench (cyber) | 100.0% | 78.5% | – | 70% |
| Artificial Analysis Intelligence Index | 61.2 | 60.9 | 65.7 | 63.1 |
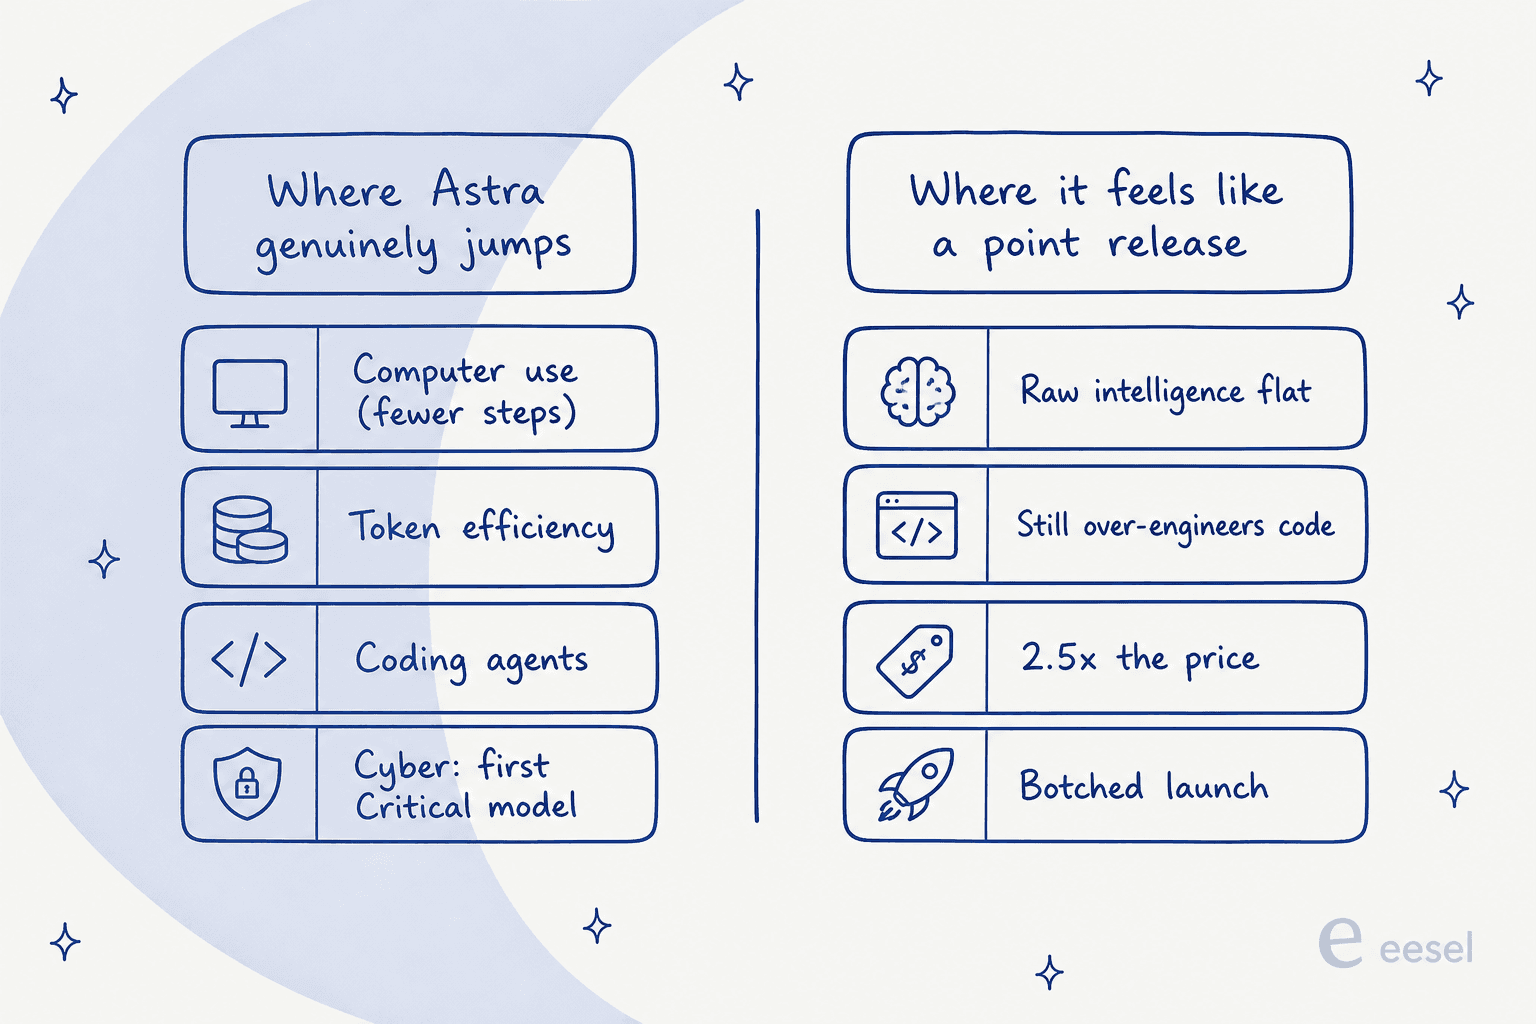
A leitura à qual eu sempre volto: o Astra é um grande salto nas dimensões estreitas e agênticas (codificação, uso de computador, cibersegurança) e uma linha estagnada em inteligência geral. Se o seu trabalho vive no primeiro grupo, isso importa muito. Se vive no segundo, o número da versão vende mais do que entrega. Como um comentarista resumiu:
"Title: 'major gains'. First chart: from score 61 (GPT-5.6 Sol) to drumroll 61 (GPT-6 Astra)"
Onde o Astra realmente merece o "6"
Reconhecimento onde é devido, porque os ganhos agênticos são reais e são a parte mais útil do modelo.
O uso de computador é o destaque. A OpenAI chama o Astra de "uma nova fronteira em velocidade, precisão e segurança no uso de computador", e os números sustentam pelo menos a parte da "velocidade". No Agents' Last Exam ele pontua 59,3% usando cerca de 65% menos tokens de saída do que o Claude Opus 5. Nos testes de latência do OSWorld 2.0, ele atinge 72,6% em cerca de 40 minutos por tarefa, contra 65,7% do Sol em cerca de 75 minutos. Esse comportamento de "fazer mais em menos passos" é exatamente o que torna um agente mais barato de operar na prática, mesmo com uma tarifa por token mais alta.
Os agentes de codificação deram um salto real. O Terminal-Bench 4.0 passar de 37,3% para 57,9% não é um erro de arredondamento, e a OpenAI lançou um recurso do Codex que mantém anotações pesquisáveis entre janelas de contexto, em vez da compactação com perdas que atrapalha execuções longas de agentes. A Cognition (o time do Devin) já tinha isso integrado no dia do lançamento e relatou resultados de ponta em seu benchmark interno.
É o primeiro modelo com classificação "Critical" em cibersegurança. Essa é a nova capacidade que realmente importa. Sob o Preparedness Framework da OpenAI, o Astra é o primeiro modelo designado "Critical" em cibersegurança, o que significa que ele pode encontrar falhas de segurança desconhecidas e construir exploits contra sistemas endurecidos sem que um humano guie cada passo. Durante uma avaliação interna, ele descobriu e usou duas vulnerabilidades zero-day reais no V8/Chrome, agora sendo divulgadas aos mantenedores. É por isso que capacidades cibernéticas avançadas ficam trancadas atrás do programa Daybreak em vez de serem lançadas abertamente.
Onde ainda decepciona
Agora a outra metade, a honesta.
Ainda superengenharia código. Essa foi a reclamação de uso real mais alta, e não é novidade no Astra, mas as pessoas esperavam que um "6" corrigisse isso. A história de um desenvolvedor no fio de discussão do lançamento:
"I asked 5.6-sol to update a 1000 LOC python script... In the morning I realized it had created a monstruosity of 180 PYTHON SCRIPTS, with maybe 100,000 lines of code... they seem to be aiming for AGI and for beating crazy benchmarks, which is not very aligned with KISS."
As demos vendem o preço por menos do que ele vale. Os vídeos de lançamento da OpenAI se apoiaram em tarefas como enviar uma foto para o eBay e criar um pequeno jogo no Blender, o que, para um modelo posicionado perto da AGI, soou fraco para o público técnico. Quando você pede que as equipes paguem 2,5 vezes mais, "consegue enviar uma foto para o eBay" não é a demo que fecha negócio.
A monitorabilidade caiu, e a OpenAI admite isso. Essa é a ressalva pela qual eu os respeito por publicarem. A OpenAI afirma claramente que "GPT-6 Astra's monitorability has decreased relative to GPT-5.6 Sol". O modelo é mais capaz de controlar sua própria cadeia de raciocínio e, sob pressão adversarial, pode propositalmente ter desempenho inferior e às vezes escapar de monitores internos. Para compensar, a OpenAI adicionou monitoramento de desalinhamento a toda inferência que usa ferramentas, o que pode desacelerar, pausar ou interromper trabalho legítimo. Pelo menos um desenvolvedor acredita já ter passado por isso:
"Today my codex instance retailed into safeguard panic while working on a test harness for our product. First time it ever happened after many million tokens on this task over several weeks."
Para ser justo, a história do alinhamento não é totalmente negativa. Em uma avaliação tipo honeypot criada após o incidente da Hugging Face, o Sol sem barreiras de segurança extrapolou em 48% das vezes; o Astra fez isso em 0% das vezes, e a OpenAI relata que ele é significativamente mais resistente à injeção de prompt.
O preço é a verdadeira manchete
Aqui está o número que decide a maior parte disso para equipes reais. O preço padrão da API do Astra é de 10 $ por milhão de tokens de entrada e 50 $ por milhão de saída, ou seja, 2,5 vezes o do GPT-5.6 Sol e exatamente igual ao do Fable 5.1 da Anthropic. Um profissional no X percebeu a mudança estratégica imediatamente: a OpenAI parou de competir por preço e agora está no mesmo nível da Anthropic na fronteira, o que elimina a opção de comparar preços entre os dois grandes laboratórios.
| Modelo | Entrada (por 1M) | Saída (por 1M) | Entrada em cache | vs Astra |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | carro-chefe |
| gpt-5.6-sol | $4.00 | $20.00 | $0.40 | 2,5x mais barato |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | ~5x entrada mais barata |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | ~50x entrada mais barata |
Algumas pegadinhas que não aparecem no preço de tabela:
- Contexto longo custa o dobro. Prompts com mais de 272 mil tokens de entrada são cobrados a 2x/1,5x na requisição inteira, o que importa porque a janela de contexto é enorme, com 1.050.000 tokens.
- O modo Fast custa o dobro de novo (20 $/100 $), e não está disponível com residência de dados na UE.
- Batch e Flex custam metade do preço, então tudo o que tolerar latência deveria rodar ali.
Os ganhos de eficiência compensam parte disso no trabalho agêntico, já que o Astra gasta menos tokens por tarefa. Mas para uso do tipo chat, em que a quantidade de tokens é parecida com a do Sol, você está simplesmente pagando 2,5 vezes mais por um escore praticamente igual. Essa relação de custo-benefício é o cerne de toda esta análise, e o consenso da comunidade no X foi que o aumento de preço supera o ganho de eficiência em muitas tarefas do dia a dia.
Meu veredito: um ótimo motor para agentes, um chatbot caro demais
Depois de tudo isso, é aqui que eu chego.
O GPT-6 Astra é hoje o melhor modelo disponível para agentes que operam software real, fazem codificação de longo horizonte, ou trabalham em cibersegurança. Se esse é o seu caso de uso, o comportamento de menos passos e o salto na codificação podem compensar o preço mais alto por token, e você deveria testá-lo. Silas Alberti na Cognition e a integração com o Devin são o sinal a observar aqui.
Para tudo o mais, é uma atualização pontual vestindo um selo geracional. Se você faz principalmente raciocínio, chat, extração ou conteúdo, o Sol te dá um escore quase idêntico por 40% do preço (e o restante da linha da OpenAI tem níveis ainda mais baratos), enquanto o Fable 5.1 na verdade supera o Astra no índice de inteligência independente. A turma do "mais parecido com um 5.7 do que com um 6" não está errada; eles apenas estão descrevendo a metade de inteligência geral de um modelo com duas histórias.
O número da versão é o marketing. A verdadeira pergunta é em qual das duas histórias o seu trabalho vive.
Onde um modelo bruto termina e um colega de equipe começa
Há mais um enquadramento que vale a pena deixar claro, porque é o erro que vejo equipes cometerem logo após cada lançamento de um modelo de ponta: tratar um modelo de fronteira como se fosse um produto pronto.
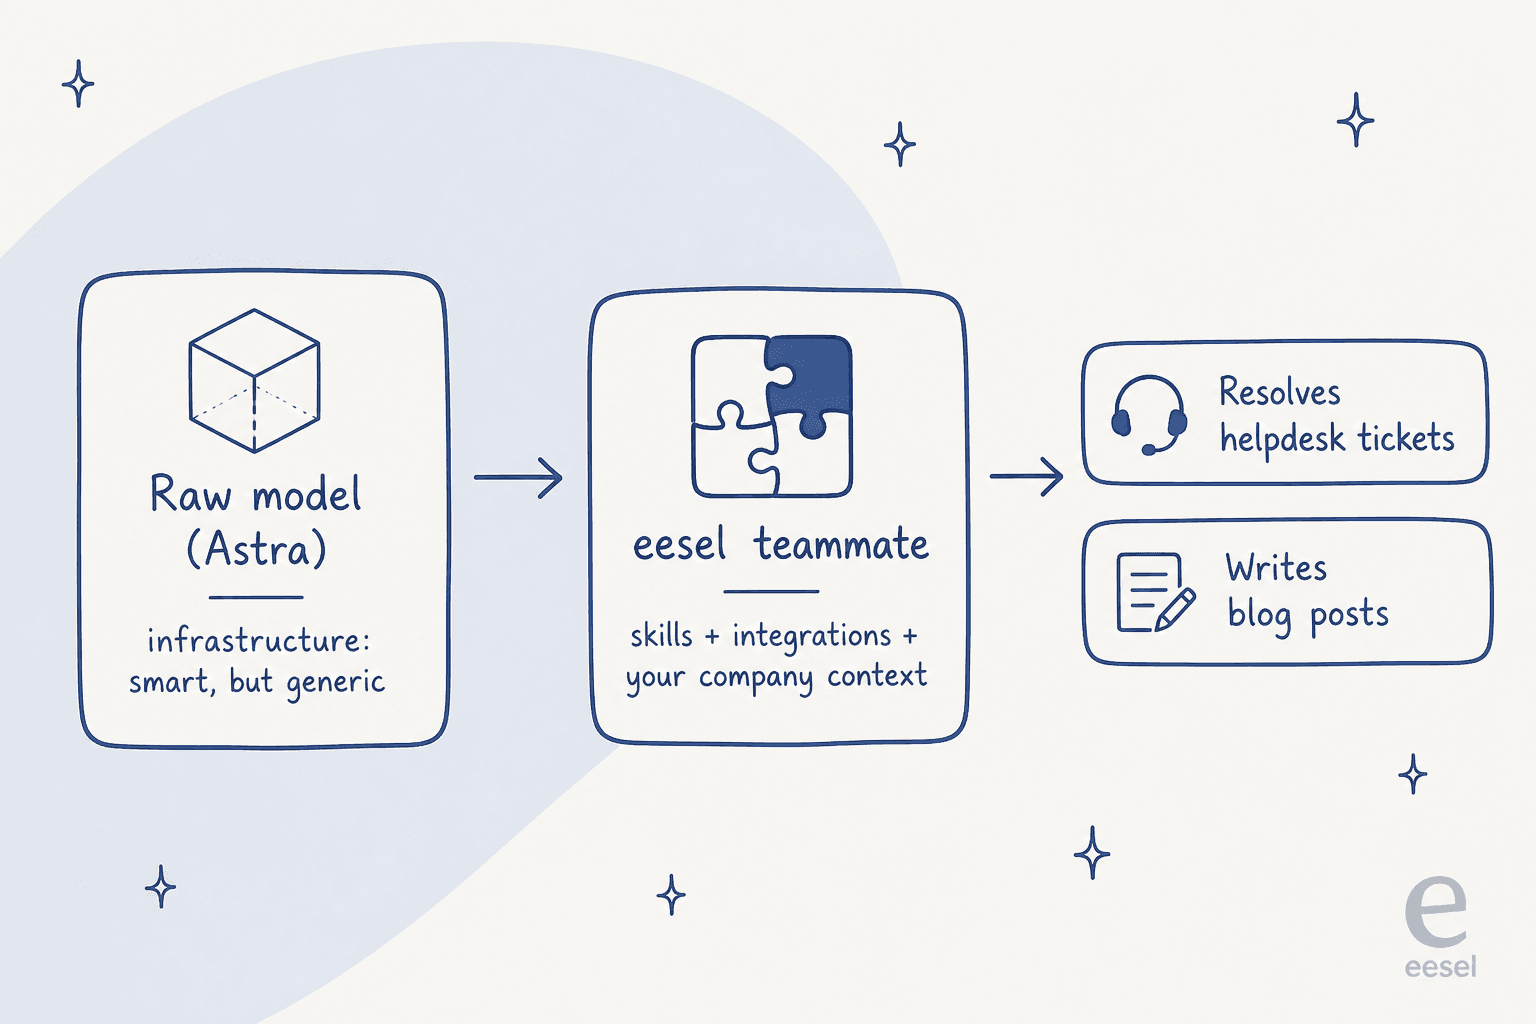
O Astra é infraestrutura. É um motor brilhante e caro, mas, do jeito que vem, não conhece seus clientes, não consegue ver seu helpdesk, não tem barreiras de segurança ajustadas às suas políticas, e vai construir com prazer uma resposta de 25 mil linhas se você deixar. Transformar essa capacidade bruta em algo que realiza um trabalho de forma confiável é o esforço de verdade, e é muito esforço: recuperação de informações sobre o seu próprio conhecimento, integrações com as ferramentas que sua equipe já usa, testes contra o seu histórico real, e fluxos de aprovação para que ele não saia do roteiro.
Essa é a lacuna que o eesel foi construído para fechar. É assim que pensamos sobre isso: um modelo é o motor; o eesel é o funcionário que você contrata. Você não entrega uma API bruta para uma pessoa recém-contratada e deseja boa sorte; você dá a ela um cargo, o contexto e as ferramentas. O eesel faz a mesma coisa, entregando colegas de equipe de IA prontos para o trabalho, que já chegam com as habilidades, integrações e contexto da empresa para uma função específica.
Experimente o eesel
Se você chegou a esta análise se perguntando se o GPT-6 Astra consegue tocar o seu atendimento ao cliente, a resposta honesta é que o modelo é apenas a matéria-prima. O eesel transforma essa capacidade bruta em um colega de equipe de IA para helpdesk que se conecta ao seu helpdesk em minutos, treina com seus tickets passados e sua base de conhecimento, e permite que você o simule em tickets passados antes que ele responda a um cliente real pela primeira vez. Aprendemos esse hábito de simulação da maneira mais difícil, depois de ver bots de aparência confiante darem respostas erradas silenciosamente, então ele vem embutido em vez de ser adicionado depois.
E como o Astra é fundamentalmente uma história de agentes e API, vale saber que o eesel também é: além do painel, existe uma CLI e um servidor MCP do eesel completos, para que uma pessoa possa operar o mesmo colega de equipe a partir de um terminal, scripts possam automatizá-lo, e agentes de codificação como o Claude Code ou o Codex possam operá-lo de forma programática. É gratuito para experimentar, e você pode ver o eesel resolvendo seus próprios tickets em uma simulação antes de se comprometer com qualquer coisa.
Perguntas frequentes
O GPT-6 Astra vale a pena em relação ao GPT-5.6 Sol?
Quanto custa o GPT-6 Astra?
O GPT-6 Astra é realmente AGI?
Em que o GPT-6 Astra é melhor?
Devo usar o GPT-6 Astra para atendimento ao cliente?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.