O que o GPT-6 Sol realmente é
Deixe-me situar o contexto antes dos benchmarks. A OpenAI lançou o GPT-6 Sol e o GPT-6 Luna juntos em 22 de setembro, posicionando-os abaixo do carro-chefe Astra, que chegou em 3 de setembro. A frase que a OpenAI usou foi "construa com o Sol, escale com o Luna": o Sol é o modelo intermediário capaz contra o qual você desenvolve, e o Luna é o nível ultrabarato para o qual você migra em alto volume.
Se você só quer o resumo direto de especificações e preço, sem veredito, meus posts visão geral do GPT-6 Sol e preços do GPT-6 Sol cobrem isso. Esta análise é sobre se ele é realmente bom.
No papel, o Sol é um modelo sério. Ele tem uma janela de contexto de 1.050.000 tokens, saída máxima de 128K, corte de conhecimento em abril de 2026, e o conjunto completo de ferramentas da Responses API: busca na web e em arquivos, interpretador de código, um shell hospedado, uso do computador e MCP. O esforço de raciocínio funciona em seis níveis, de none até max, com medium como padrão. Ele recebe texto e imagem, e produz texto.
Eu construo agentes de IA profissionalmente, então a especificação que mais me importa não é o número de contexto que vira manchete, e sim como o modelo se comporta dentro de um loop de agente. É aí que mora a parte interessante desta análise, porque a história dos benchmarks e a história do comportamento apontam em direções ligeiramente diferentes.
Passei os últimos três anos e pouco colocando IA em filas de suporte reais, vendo modelo após modelo chegar à produção. O padrão quase nunca muda: o gráfico do lançamento diz uma coisa, e a experiência real diz outra. Então, em vez de aceitar o discurso de "a próxima geração" ao pé da letra, leio o GPT-6 Sol como duas coisas separadas empacotadas em um único lançamento: uma pequena atualização de inteligência e uma grande atualização de preço.
As duas histórias dentro de um único lançamento
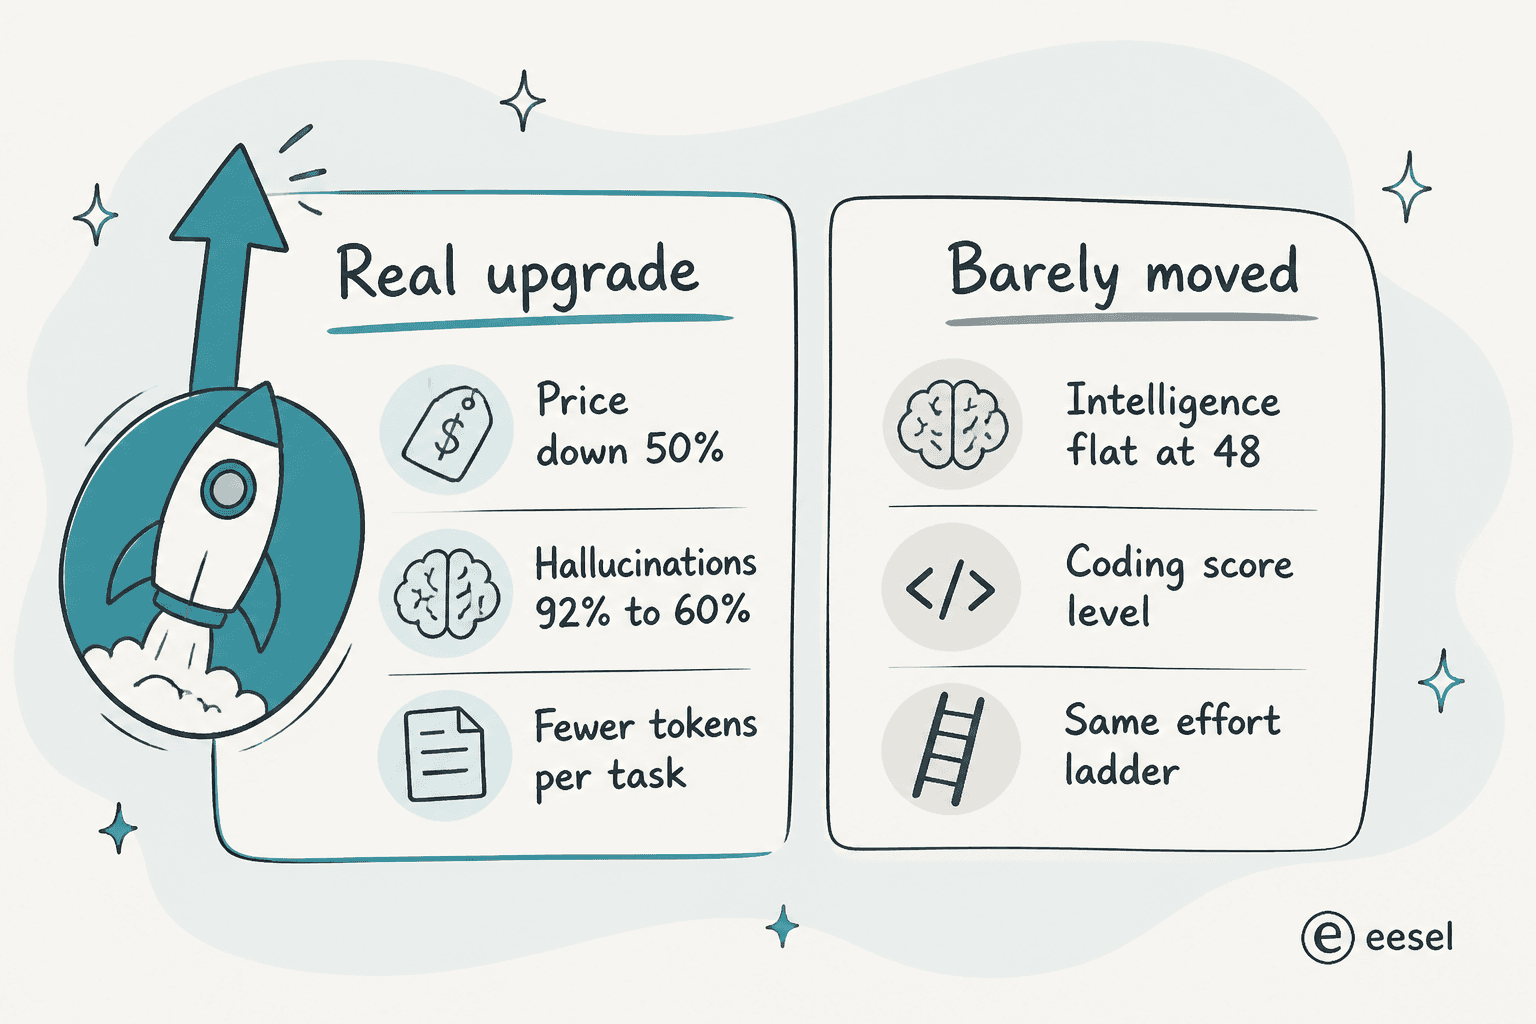
A primeira história é a que a OpenAI destaca: o Sol ficou dramaticamente mais barato. A US$ 2/US$ 10, ele fica na metade do preço do GPT-5.6 Sol, e a Artificial Analysis mediu o custo de rodar todo o Intelligence Index em US$ 1,06 por tarefa, cerca de 50% a menos que os US$ 1,99 do GPT-5.6 Sol. A entrada em cache cai para US$ 0,20, um desconto de 90%. Para quem roda volume de verdade, esse é o argumento inteiro, e é forte.
A segunda história está enterrada na mesma tabela de benchmarks: a inteligência não se moveu de verdade. No AA Intelligence Index, o GPT-6 Sol em esforço máximo pontua 48, o que a AA descreve como no mesmo nível do GPT-5.6, "progresso em algumas avaliações, retrocesso em outras". O Coding Agent Index conta a mesma história: praticamente estável, por um preço menor.
Há um ganho de capacidade real, e vale a pena nomeá-lo claramente porque é fácil passar batido: precisão factual. A OpenAI diz que o Sol comete cerca de metade dos erros do GPT-5.6 Sol, e a taxa de alucinação em esforço máximo da AA confirma isso, caindo de cerca de 92% para 60%. Para quem usa o modelo para responder perguntas reais em vez de escrever código descartável, ter menos respostas erradas ditas com confiança vale, possivelmente, mais do que mais um ponto ou dois de raciocínio bruto.
"No geral, acho que para a maioria das pessoas a vencedora de hoje foi a Anthropic. Eu pessoalmente prefiro o Opus 5.5 em medium em vez do GPT-6 Sol Max, em testes muito, muito iniciais. Faixa de preço parecida, mais capacidade."

Esse comentário é justo, e é o contraponto honesto ao Sol: se você tem orçamento, existe um modelo mais inteligente. Mas ele também compara o Sol em esforço máximo com o Opus em medium, e como outro leitor apontou em resposta, esses não são ajustes equivalentes. O que me leva à parte desta análise que considero mais importante.
Como ele realmente se comporta em um agente
Pontuações brutas não capturam como é trabalhar com um modelo. Dois comportamentos apareceram repetidamente na reação dos desenvolvedores, e ambos batem com o que vi ao integrar modelos da OpenAI em loops de agente.
O primeiro é eficiência de tokens. O GPT-6 Sol usa cerca de 31 mil tokens de saída por tarefa no índice da AA, contra cerca de 119 mil do Opus 5.5. Isso é perto de 4x menos tokens para chegar a uma resposta de qualidade parecida, o que explica boa parte da sensação de velocidade e da conta baixa. É também o motivo silencioso pelo qual um modelo "mais barato por token" pode acabar sendo ainda mais barato por tarefa concluída do que o preço de tabela sugere.
O segundo é o excesso de zelo, e aqui o Sol tem uma desvantagem genuína:
"Os modelos da OpenAI também são muito mais eufóricos que os da Anthropic, que ficam mais para o lado preguiçoso. Sem supervisão, Sol/Astra vai tentar construir um foguete verificado com sha256 se você pedir para consertar uma condição de corrida no seu app de lista de tarefas."
Eu ri disso porque é exato. Aponte o Sol para uma tarefa pequena sem um escopo bem fechado e ele vai super-engenhar com alegria. Em um agente, isso significa que você vai depender mais das suas instruções e barreiras de segurança do que dependeria com um modelo mais preguiçoso. Não é exatamente um defeito, é uma personalidade, mas é uma personalidade que exige projeto em torno dela.
O outro lado dessa personalidade é a prosa. Dan Shipper, da Every, resumiu a diferença de escrita com clareza:
"O Sol melhora em relação ao GPT-5.6 — incluindo código Ruby melhor nos testes de @kieranklaassen —, mas o Opus 5.5 tem o teto mais alto para builds longos e autônomos."
A avaliação completa dele é o resumo mais claro de todo esse confronto que já li: o Sol escreve prosa limpa e mínima e coloca a ideia importante primeiro, enquanto é o Opus que tem o teto mais alto para trabalho autônomo longo. Essa é a troca em uma frase.
A escada de esforço é a decisão de verdade
Aqui está o que a maioria das análises do Sol ignora: com seis níveis de raciocínio, "quão bom é o GPT-6 Sol" é a pergunta errada. A certa é "quão bom em qual esforço, por qual custo."
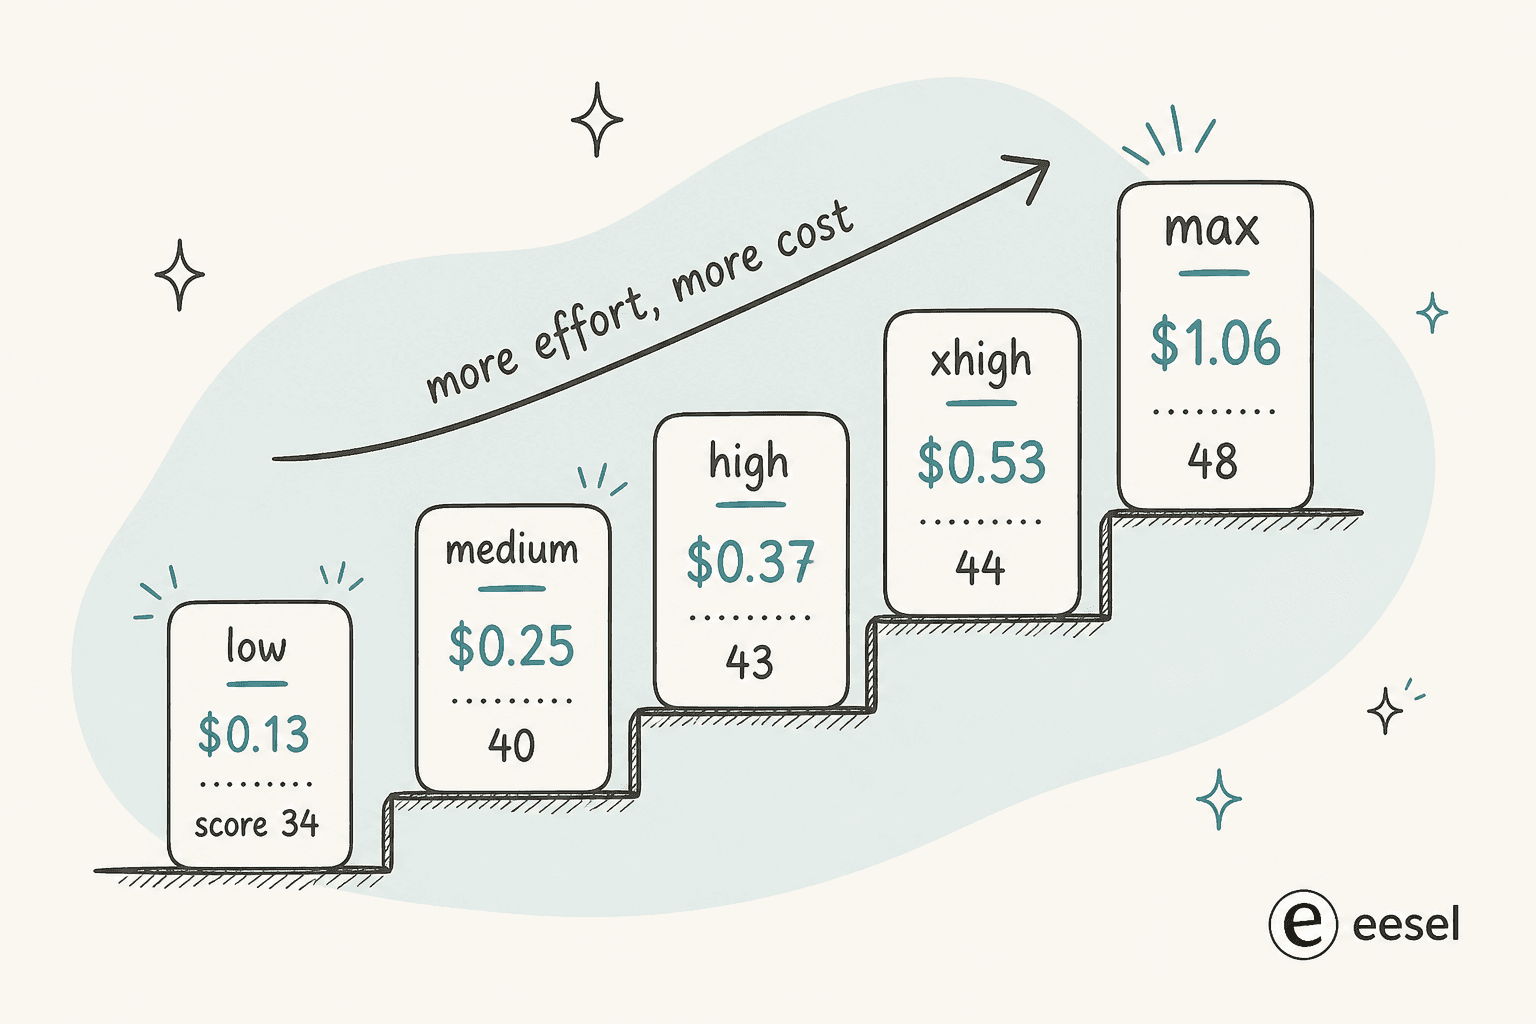
A AA publicou a curva de esforço completa, e a variação é grande. Esforço baixo pontua 34 a US$ 0,13 por tarefa; esforço máximo pontua 48 a US$ 1,06. Isso é uma variação de custo de 8x para 14 pontos de índice. Para boa parte do trabalho real, o meio dessa escada é o ponto ideal, não o topo. O seletor abaixo é o modelo mental que uso para decidir qual nível escolher.
Qual nível de esforço do GPT-6 Sol?
Escolha a tarefa. As pontuações e o custo por tarefa vêm do Artificial Analysis Intelligence Index.
É aqui também que mora a ressalva honesta sobre o teto. Mesmo no máximo, o 48 do Sol fica abaixo do 58 do Opus 5.5 e abaixo do próprio Astra da OpenAI. Se seu trabalho realmente precisa do topo do mercado, o Sol não é a escolha. Mas a maior parte do trabalho não precisa, e essa diferença é exatamente o que você economiza pela metade do preço.
Preços: o motivo real para se importar
Vou ser direto: o preço é a análise. Veja como o Sol se posiciona em relação aos irmãos e ao rival mais próximo.
| Modelo | Entrada/saída (por 1M) | Entrada em cache | AA Intelligence | Custo por tarefa AA |
|---|---|---|---|---|
| GPT-6 Luna | US$ 0,10 / US$ 0,50 | US$ 0,01 | não listado | n/d |
| GPT-6 Sol | US$ 2 / US$ 10 | US$ 0,20 | 48 | US$ 1,06 |
| GPT-6 Astra | US$ 10 / US$ 50 | US$ 1,00 | ~61 | maior |
| Claude Opus 5.5 | US$ 4 / US$ 20 | US$ 0,20 | 58 | US$ 5,98 |
Duas coisas se destacam. Primeiro, o Sol custa metade do preço do Opus 5.5 em tokens, algo que um leitor usou para argumentar que eles nem estão na mesma categoria. Segundo, e isso me surpreendeu: como o Sol consome bem menos tokens de saída, seu custo por tarefa concluída (US$ 1,06) fica mais perto de um quinto do Opus 5.5 (US$ 5,98), não da metade. A diferença por token subestima a diferença real.
Duas ressalvas mantêm isso honesto. O modo Fast dobra a taxa para US$ 4/US$ 20, e entradas acima de 272 mil tokens recebem uma sobretaxa de contexto longo, que, como um leitor observou, reduz a vantagem de preço do Sol assim que você alimenta contextos enormes. Se o seu fluxo de trabalho for realmente pesado em contexto longo, refaça as contas. Meu post sobre preços do GPT-6 Sol tem a tabela completa por nível, e o guia de preços do Codex explica como isso se traduz dentro da assinatura em vez da API.
Quem deveria realmente usá-lo
Depois de tudo isso, aqui vai minha recomendação direta.
Use o GPT-6 Sol se você passa o dia no Codex ou na API fazendo programação cotidiana, rascunhos e perguntas e respostas, e quer um modelo rápido, barato e previsível que não desperdiça tokens. Se você estava no GPT-5.6 Sol, isso é um upgrade direto: mesma inteligência, metade do custo, menos alucinações. É minha escolha como padrão para alto volume.
Procure outra opção se você precisa do teto mais alto para builds longos, autônomos e de várias horas, caso em que o Opus 5.5 ou o Astra merecem o preço premium, ou se seu trabalho é fortemente de contexto longo, onde a sobretaxa come a economia. E se você constrói agentes de IA, lembre-se de que o excesso de zelo do Sol exige escopo e barreiras de segurança mais rígidos, não menos.
Para um confronto completo sobre a questão de fronteira, meu comparativo GPT-6 Sol vs. Opus 5.5 e a crítica análise do GPT-6 Astra vão mais fundo do que eu posso ir aqui, e a lista de modelos da OpenAI mapeia toda a linha.
A diferença entre um modelo e uma contratação
Aqui está a armadilha em que vejo times caindo em toda semana de lançamento, e vale a pena terminar com ela. Um modelo campeão de benchmark não é um colega de equipe funcional. O GPT-6 Sol é um motor rápido, barato e capaz, mas continua sendo só um motor: aponte a API bruta para sua fila de suporte e você fica com a recuperação de informações, as barreiras de segurança, a integração com o helpdesk, os testes e cada resposta errada que ele entrega com confiança no primeiro dia.
Essa última parte é onde ganhei minhas cicatrizes. Já vimos um bot que soava confiante dar respostas erradas silenciosamente em uma fila ao vivo, que é exatamente por isso que todo rollout hoje é simulado contra milhares de tickets históricos antes de tocar em um cliente real. Um modelo puro não te dá nada disso.
É essa a distinção sobre a qual o eesel é construído: um modelo é infraestrutura, o eesel é o funcionário. O eesel é uma plataforma de colegas de equipe de IA, e você contrata colegas prontos para o trabalho em funções específicas. O time atual é um colega de IA para helpdesk e um redator de blog com IA, cada um chegando com as habilidades, integrações e contexto da empresa para sua função. O colega de helpdesk entra na sua fila existente, aprende com seus tickets passados e cobra por resolução, para que você possa medi-lo contra o custo de um agente humano em vez de adivinhar. Essa é a diferença entre um experimento bruto de IA conversacional e uma economia real de custos de suporte que você pode colocar em números.

E se você é o tipo de desenvolvedor que curtiu o Sol justamente por ele viver em um terminal, o eesel também te encontra lá. A CLI do eesel opera o mesmo colega de equipe e o mesmo workspace pela linha de comando: uma pessoa pode rodá-la interativamente, scripts podem automatizá-la, e agentes de código como Claude Code, Codex ou Cursor podem operá-la sem interface. Você pode conectar fontes, enviar instruções, rodar uma simulação sobre tickets históricos e checar a atividade, tudo sem abrir o painel. É a mesma superfície amigável a agentes e pronta para MCP que você gostaria de ter se estivesse construindo sobre o Sol você mesmo, exceto que a recuperação de informações e as barreiras de segurança já estão prontas. Você pode testar o eesel grátis.
Perguntas frequentes
O bloco de perguntas frequentes acima responde às dúvidas mais comuns sobre a análise do GPT-6 Sol, desde preço até como ele se compara ao Astra e ao Opus 5.5. Se você está decidindo entre modelos, comece com o comparativo GPT-6 Sol vs. Opus 5.5, depois veja o ranking dos melhores agentes de IA se você está construindo algo que realmente resolva tickets em vez de só responder prompts.
Perguntas frequentes
O GPT-6 Sol vale a pena em relação ao GPT-5.6 Sol?
Quanto custa o GPT-6 Sol?
O GPT-6 Sol é melhor que o Claude Opus 5.5?
Em que o GPT-6 Sol é mais forte?
Qual a diferença entre o GPT-6 Sol e o GPT-6 Astra?
Posso usar o GPT-6 Sol para atendimento ao cliente?
O GPT-6 Sol está disponível no plano gratuito?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.