Por que as pessoas procuram uma alternativa ao GPT-6 Luna
Deixa eu começar sendo justo com o Luna, porque ele merece. Quando a OpenAI lançou o Sol e o Luna em 23 de setembro de 2026, a manchete foi um corte plano de 50% no preço em relação à geração GPT-5.6. Simon Willison resumiu o clima na thread de lançamento:
"GPT-6 Luna being half the price of GPT-5.6 Luna is a really big deal."

Com $0.10/$0.50 por 1M de tokens, uma janela de contexto de 1,05M de tokens e entradas de imagem, o Luna é muito modelo pelo dinheiro. Ele também é o modelo barato padrão para milhões de pessoas, já que é o único modelo GPT-6 no ChatGPT Free e Go. Outro comentarista resumiu o valor com clareza:
"6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model."
Então, por que pesquisar outras opções? Três motivos reais aparecem repetidamente:
- Preço em volume. Se você está passando milhões de tokens por dia por um classificador, um resumidor ou um pipeline em lote, até a pequena taxa de saída do Luna se acumula, e alguns modelos têm preços mais baixos.
- Pesos abertos. O Luna é fechado e só via API. Se você precisa hospedar por conta própria por privacidade, soberania ou controle de custos, precisa deixar a OpenAI completamente.
- Um ponto forte específico. Entradas multimodais mais ricas (áudio, vídeo, PDF), tempos de resposta mais rápidos para um widget de chat ao vivo, ou uma política de dados que mantém tudo em infraestrutura ocidental. O Luna é um generalista forte, não o líder em nenhum desses pontos.
Aqui está onde as oito alternativas realmente se posicionam no número que a maioria das pessoas usa para começar: o preço de saída por 1M de tokens.
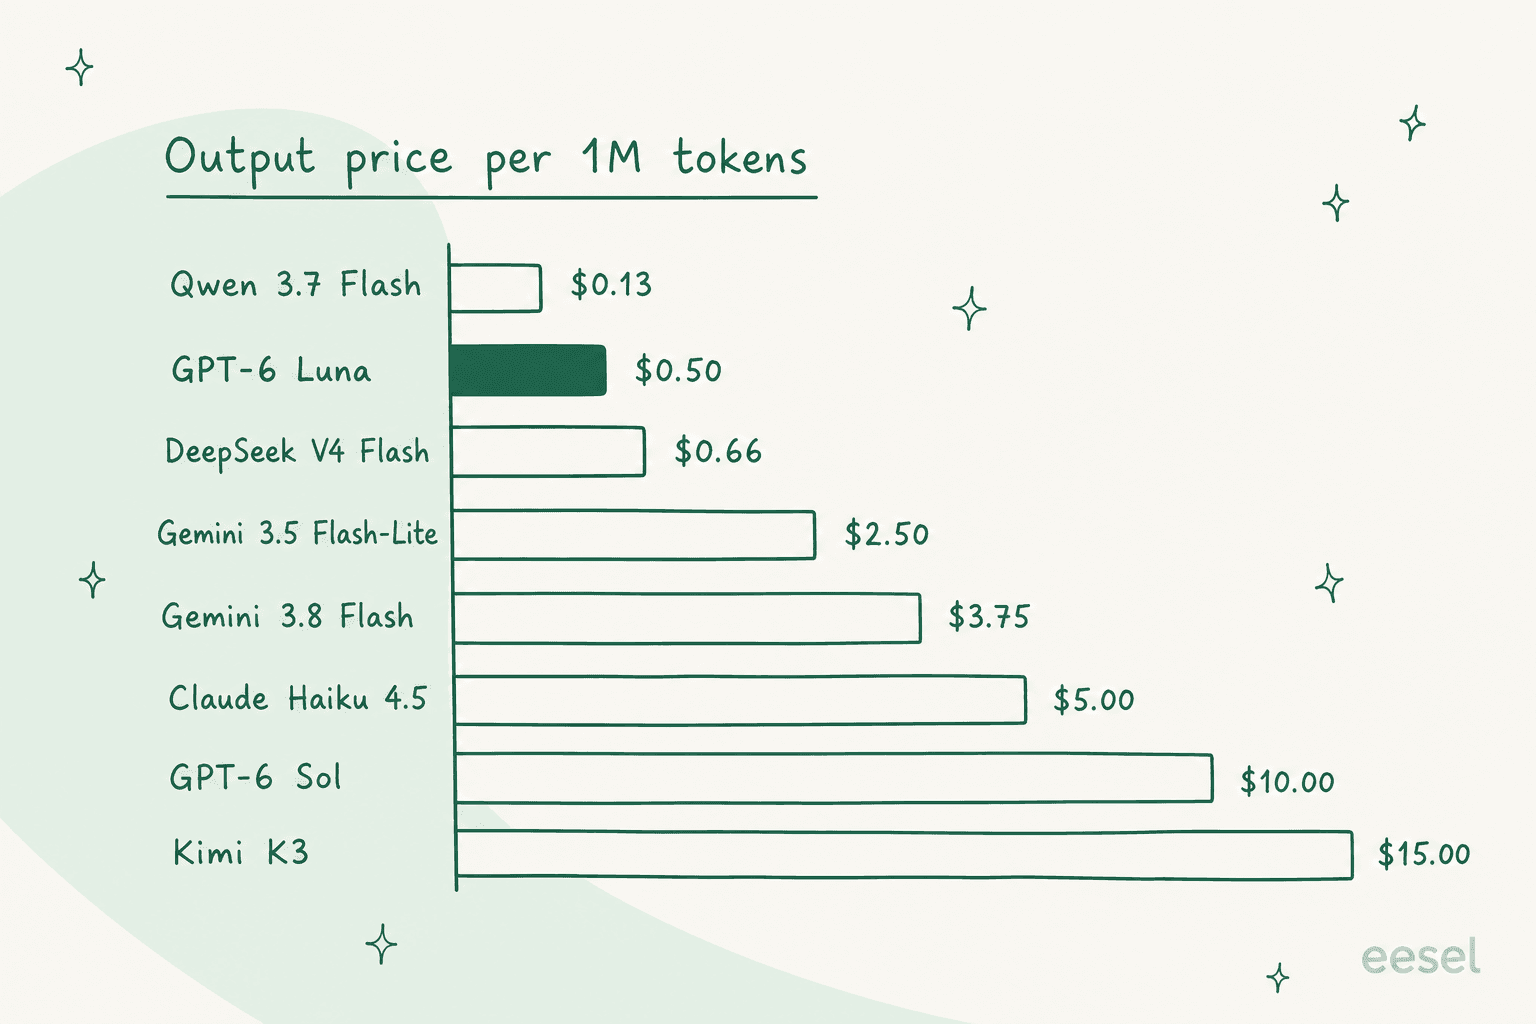
Como escolhi essas alternativas
Mantive a lista limitada a modelos que estão genuinamente na categoria de peso do Luna: baratos, rápidos e feitos para trabalho de alto volume ou leve, não os carros-chefe de ponta da lista de modelos da OpenAI que você usaria para escrever código o dia todo. Não incluí o GPT-6 Astra nem o Claude Opus aqui, porque um modelo de 20 a 100 vezes o preço de saída do Luna não é uma "alternativa", é um orçamento diferente. (Se um motor de ponta é o que você realmente quer, meu panorama de alternativas ao GPT-6 Astra é a leitura melhor.)
Para cada modelo, analisei o preço real por token na própria tabela de preços do fornecedor, a janela de contexto, se os pesos são abertos, o que ele aceita como entrada, e onde ele realmente brilha ou falha. Tudo abaixo tem preços de fontes primárias, e onde o preço de um modelo é incomum (faixas, sobretaxas de pico/fora de pico, um aumento programado) eu destaquei, porque essas peculiaridades são exatamente o que transforma um modelo "mais barato" em uma fatura surpresa.
Aqui está todo o cenário rapidamente.
| Modelo | Melhor para | Entrada $/1M | Saída $/1M | Contexto | Pesos abertos | Entrada de imagem |
|---|---|---|---|---|---|---|
| GPT-6 Luna (atual) | A escolha padrão equilibrada | $0.10 | $0.50 | 1.05M | Não | Sim |
| Gemini 3.8 Flash | Trabalho multimodal em lote | $0.75 | $3.75 | 1M | Não | Sim |
| Gemini 3.5 Flash-Lite | A multimodal mais barata | $0.30 | $2.50 | 1M | Não | Sim |
| Claude Haiku 4.5 | Confiabilidade por dólar | $1.00 | $5.00 | 200K | Não | Sim |
| DeepSeek V4 Flash | Os pesos abertos mais baratos | $0.22 (off-peak) | $0.66 (off-peak) | 1M | Sim (MIT) | Não |
| Qwen 3.7 Flash | Menor taxa em prompts pequenos | $0.03-$0.20 | $0.13-$0.80 | 1M | Não | Sim |
| Kimi K3 | Peso pesado de pesos abertos | $3.00 | $15.00 | 1M | Sim | Sim |
| GPT-6 Sol | Ficar na OpenAI, mais margem | $2.00 | $10.00 | 1.05M | Não | Sim |
| Grok 4.7 | Loops de agentes e tempo real | $2.00 | $6.00 | 500K | Não | Sim |
Agora, os modelos em si.
1. Gemini 3.8 Flash
Ideal para: equipes que querem entradas multimodais e um throughput enorme para trabalho noturno e não interativo.
O Gemini 3.8 Flash é o modelo Flash mais novo do Google, e a abordagem honesta é a que o próprio Google dá: ele é construído diretamente sobre o Gemini 3.7 Flash, não sobre uma nova base. O model card diz isso, em tantas palavras, em quatro seções separadas. O que você ganha pelo mesmo preço do 3.7 é um modelo que "trabalha mais", executando passos de raciocínio extras e chamando ferramentas com mais frequência, o que é ótimo para tarefas difíceis e um desperdício para as fáceis.
Onde ele claramente supera o Luna é nas entradas: texto, imagem, áudio, vídeo e PDF entram todos, contra o texto-e-imagem do Luna. Ele também registra um forte índice de inteligência da Artificial Analysis de 59, bem acima da mediana da classe.
Prós:
- Entradas totalmente multimodais (áudio, vídeo, PDF), que o Luna não aceita.
- Throughput bruto genuinamente rápido: 302 tokens/seg., próximo ao topo da tabela de velocidade da Artificial Analysis.
- Um nível gratuito e uma janela de contexto de 1M de tokens.
Contras:
- O número pouco reportado é o tempo até o primeiro token: a Artificial Analysis mediu
13.3scontra uma mediana de classe de cerca de3s. Isso desqualifica qualquer coisa que um humano esteja esperando, como uma resposta de chat, e é irrelevante para um trabalho em lote noturno. - O preço dobra em 1º de janeiro de 2027, para
$1.50/$7.50. O próprio Google diz a desenvolvedores focados em eficiência para ficarem no 3.7 Flash.
Preço: $0.75 de entrada / $3.75 de saída por 1M até 31 de dezembro de 2026, depois exatamente 2x a partir de janeiro de 2027. Batch e Flex têm 50% de desconto. Veja o detalhamento completo dos preços do Gemini para os níveis.
Minha opinião: escolha o Gemini 3.8 Flash em vez do Luna quando precisar alimentá-lo com áudio ou vídeo e o trabalho não for interativo. Para um widget de chat ao vivo, esse número de tempo até o primeiro token o descarta, e eu olharia para o Flash-Lite ou o Luna em vez disso.
2. Gemini 3.5 Flash-Lite
Ideal para: a forma mais barata de conseguir as entradas multimodais do Google em alto volume.
Se o Gemini 3.8 Flash é o modelo que "trabalha mais", o Flash-Lite é o que quer "só ser barato e rápido". É o membro econômico e de alto throughput da linha Gemini 3.5, e é a resposta mais direta do Google ao Luna. Ele aceita o mesmo conjunto rico de entradas (texto, imagem, vídeo, áudio, PDF) e retorna texto, com uma janela de contexto de aproximadamente 1M de tokens. Vale a pena dar uma olhada no campo mais amplo de alternativas ao Gemini se você quiser mais opções do Google.
A especificação que se destaca é a velocidade: a Artificial Analysis o coloca perto do topo do campo em velocidade de saída, cerca de 490 tokens/seg., um mundo diferente do problema de latência do 3.8 Flash. A troca é a inteligência: seu índice de inteligência fica em 36, então é um cavalo de batalha para classificação, extração e roteamento, não para tarefas que exigem muito raciocínio.
Prós:
- Entradas multimodais a um preço genuinamente baixo.
- Saída muito rápida, o que o torna viável para uso interativo onde o 3.8 Flash não é.
- Mais barato que o Claude Haiku 4.5 em ambas as métricas, segundo a própria comparação do Google.
Contras:
- Uma lacuna funcional real que vale a pena conhecer: a página do modelo lista o uso de computador como não suportado, então não é o modelo para construir um agente que controla navegador.
- Inteligência bruta menor que o Luna, então é uma ferramenta mais estreita.
Preço: $0.30 de entrada / $2.50 de saída por 1M (Standard). Batch e Flex reduzem isso pela metade, para $0.15/$1.25. O nível gratuito treina com seu conteúdo, então não é para dados sensíveis.
Minha opinião: esse é o Gemini que eu realmente colocaria cara a cara com o Luna para trabalho de texto e imagem barato e de alto volume. Seu preço de saída é maior que o do Luna, mas para qualquer coisa com uma imagem, o suporte multimodal e a velocidade podem valer a diferença.
3. Claude Haiku 4.5
Ideal para: equipes que querem a confiabilidade e a capacidade de seguir instruções da família Claude a um preço de nível rápido.
O Claude Haiku 4.5 é o modelo pequeno e rápido da Anthropic, e é o mais caro do verdadeiro nível "barato" aqui, com $1.00/$5.00. O que você paga é a reputação da Anthropic por seguir instruções com cuidado e uma tendência menor de sair dos trilhos, o que importa muito quando a saída do modelo alimenta algo automatizado.
É uma janela de contexto menor que o restante (200K em vez de 1M), o que é bom para a maioria das tarefas e uma restrição real para quem coloca uma base de código ou base de conhecimento inteira em um único prompt.
Prós:
- Capacidade de seguir instruções forte e previsível ao estilo Claude.
- Respostas rápidas, então funciona para usos interativos.
- O ecossistema, as ferramentas e a documentação do Claude são excelentes.
Contras:
- Dez vezes a taxa de saída do Luna, então em puro volume é a escolha cara deste grupo.
- 200K de contexto é o menor aqui.
- Sem pesos abertos, e sem uma opção de contexto gigante como os modelos de 1M de tokens.
Preço: $1.00 de entrada / $5.00 de saída por 1M de tokens. Descontos de cache de prompt e em lote se aplicam e reduzem a taxa efetiva em cargas de trabalho repetitivas.
Minha opinião: se confiabilidade é o que tira seu sono, e seus prompts cabem em 200K, o Haiku vale o prêmio sobre o Luna. Se você busca a menor conta, não é o escolhido, e um dos modelos abertos chineses abaixo fará o mesmo trabalho de rotina por uma fração do custo.
4. DeepSeek V4 Flash
Ideal para: a opção mais barata com pesos abertos que você realmente pode baixar e hospedar você mesmo.
O DeepSeek V4 Flash é a escolha campeã de orçamento, e aquela em que as notas de rodapé sobre preços mais importam. É um modelo de mistura de especialistas com 284B de parâmetros totais / 13B ativos, lançado sob uma licença MIT com pesos para download, então você pode rodá-lo no seu próprio hardware.
Duas coisas para saber antes de se animar com o preço de tabela. Primeiro, é só texto, então nenhuma entrada de imagem está documentada. Segundo, a API própria usa preços de pico e fora de pico: $0.22/$0.66 por 1M fora de pico, subindo para $0.44/$1.32 no pico. Os horários de pico são de 01:00 às 10:00 UTC (horário comercial chinês), então uma fila dos EUA ou da Europa é cobrada majoritariamente na taxa mais barata fora de pico, o que é uma peculiaridade boa e também frágil.
Também há uma armadilha de custo mais sutil que surgiu diretamente na thread de lançamento do Luna. Um comentarista comparou suas próprias contas do DeepSeek e do Luna, e alguém rebateu:
"This isn't right. You're comparing cost per token, but DeepSeek V4 Flash uses more tokens. Artificial Analysis found GPT 6 Luna to be significantly cheaper than DeepSeek."
Essa é a categoria inteira em uma única troca: o DeepSeek é verboso, e um modelo tagarela gasta mais tokens para terminar o mesmo trabalho, então a taxa mais baixa por token nem sempre significa uma fatura mais baixa.
Prós:
- Pesos abertos sob MIT, então você pode hospedar você mesmo e manter os dados internos.
- A menor taxa por token publicada entre qualquer modelo capaz aqui (fora de pico).
- Contexto enorme de 1M de tokens e raciocínio embutido.
Contras:
- Só texto, sem entrada de imagem documentada.
- A saída verbosa pode apagar a economia por token em tarefas reais.
- Os termos da API paga são silenciosos, não explicitamente permissivos, quanto ao uso para treinamento, e os dados ficam sob a lei da RPC, então não é um substituto direto para dados de clientes.
Preço: fora de pico $0.22 de entrada / $0.66 de saída, no pico $0.44/$1.32, tudo por 1M. Tokens de raciocínio são cobrados na taxa de saída, e o "thinking" vem ativado por padrão, então é preciso orçar para isso.
Minha opinião: se você quer pesos abertos e o piso absoluto de custo, o DeepSeek V4 Flash é o que vale testar, mas teste com seus prompts reais e meça a contagem de tokens, não só a taxa. Para dados de clientes, trate a política "silenciosa" de treinamento como um motivo para hospedar você mesmo em vez de usar a API própria.
5. Qwen 3.7 Flash
Ideal para: a menor taxa de destaque em prompts pequenos, se você conseguir conviver com documentação escassa.
O Qwen 3.7 Flash da Alibaba tem o menor número de toda a tabela, $0.03/$0.13 por 1M, mas há um asterisco que você não pode ignorar: o preço é dividido por faixas de tamanho de prompt. Essa taxa barata só vale abaixo de 32K tokens. Ela sobe para $0.10/$0.40 de 32K a 256K, e $0.20/$0.80 de 256K a 1M. Então a taxa de "modelo de visão mais barato" e o "contexto de 1M" não podem ser verdadeiros ao mesmo tempo na mesma chamada.
A outra observação honesta é que quase nada sobre esse modelo é verificado de forma independente. A Alibaba não publicou benchmarks, arquitetura, nem contagem de parâmetros, e os pesos são fechados. A única avaliação de terceiros, o teste de visão da Roboflow, o classifica em 22º de 23 no geral, mas em 1º de 23 em custo. E "Flash" aqui significa barato, não rápido: roda a cerca de 59 tokens/seg., bem mais lento que o Flash-Lite do Gemini.
Prós:
- A menor taxa de entrada por token aqui, em prompts pequenos.
- Aceita entrada de imagem, ao contrário do DeepSeek.
- Contexto de 1M de tokens disponível (na faixa de preço mais alta).
Contras:
- Preço em faixas significa que a taxa barata evapora em prompts grandes (6,7x mais na entrada na faixa mais alta).
- Saída lenta e documentação escassa e não verificada.
- Pesos fechados, fornecedor único, então sem hospedagem própria e sem roteamento alternativo.
Preço: três faixas por tamanho de prompt, de $0.03/$0.13 abaixo de 32K até $0.20/$0.80 em 256K-1M. Compare com o panorama completo de preços do Qwen antes de decidir.
Minha opinião: o Qwen 3.7 Flash é uma ótima escolha para tarefas de visão de alto volume e prompt curto, onde o custo é tudo e você pode validar a qualidade por conta própria. Para qualquer coisa que precise de contexto grande ou benchmarks documentados, eu passaria. Meu texto sobre alternativas ao Qwen tem a família Qwen mais ampla, se você quiser mais margem.
6. Kimi K3
Ideal para: equipes que querem um peso pesado genuinamente de pesos abertos e vão pagar por isso.
O Kimi K3 é a exceção nesta lista, e eu o incluí de propósito. A $3/$15 por 1M ele não é barato; está na mesma faixa do Claude Sonnet, e é cerca de 30 vezes a taxa de saída do Luna. Então por que ele está aqui? Porque é o modelo de pesos abertos ao qual as pessoas recorrem quando querem possuir um modelo capaz por completo, e seus pesos realmente foram lançados no Hugging Face no prazo.
É um modelo de mistura de especialistas com 2,8T de parâmetros totais / 104B ativos, com visão nativa, contexto de 1M de tokens, e um índice de inteligência da Artificial Analysis de 57, o que o coloca perto do topo de todo o campo, não só da ponta barata.
Prós:
- Pesos abertos que foram lançados como prometido, verificáveis no Hugging Face.
- Alta inteligência, bem acima do resto desta lista.
- Visão nativa e contexto de 1M de tokens.
Contras:
- Não é um modelo econômico. É uma alternativa ao Luna apenas no sentido de "aberto e capaz", não no sentido de "barato".
- O raciocínio não pode ser desligado, e o padrão é esforço máximo, então a latência e o gasto de tokens são altos.
Preço: $3 de entrada / $0.30 de acerto de cache / $15 de saída por 1M. Os níveis do app para consumidor vão de um plano gratuito até $199/mês. Meu panorama de alternativas ao Kimi K2.5 cobre o campo mais amplo de modelos abertos.
Minha opinião: se o que você realmente queria de "uma alternativa ao Luna" era um modelo aberto e capaz para hospedar você mesmo, o Kimi K3 é a escolha, e o DeepSeek V4 Flash é o primo mais barato. Se você queria a menor conta, o Kimi é completamente a árvore errada.
7. GPT-6 Sol
Ideal para: ficar dentro da OpenAI quando a margem do Luna se esgota.
Às vezes a melhor alternativa ao Luna é o modelo um degrau acima na mesma família. O GPT-6 Sol é o modelo GPT-6 de nível médio da OpenAI, a $2/$10, e existe justamente para o momento em que as respostas do Luna param de ser boas o suficiente, mas você não quer trocar de fornecedor, SDKs ou acordos de dados.
A própria abordagem da OpenAI é "construa com o Sol, escale com o Luna", e a história dos benchmarks é honesta: os índices de Inteligência e Codificação do Sol estão mais ou menos no nível do GPT-5.6, então isso é mais um corte de preço do que um salto de capacidade, com uma vitória real em veracidade factual (a OpenAI relata cerca de metade dos erros do Sol anterior).
Prós:
- Mesma API, ferramentas e termos de dados do Luna, então trocar é uma mudança de uma linha.
- Conjunto completo de ferramentas da Responses API: busca na web, interpretador de código, shell hospedado, uso de computador, MCP.
- Significativamente mais capaz que o Luna em tarefas difíceis, com um grande ganho em veracidade factual.
Contras:
- 20 vezes o preço de saída do Luna, então é um aumento de custo, não uma economia.
- Não está nos planos Free ou Go; você precisa do Plus, Pro, Business ou da API.
Preço: $2 de entrada / $10 de saída por 1M no padrão, com Batch e Flex com 50% de desconto. A página completa de preços do GPT-6 Sol tem as taxas de contexto longo e modo rápido.
Minha opinião: o Sol não é uma alternativa para quem está comparando por preço, é o caminho natural de upgrade quando a qualidade do Luna é o gargalo. Recorra a ele quando a falha que você está tentando corrigir é precisão, não custo.
8. Grok 4.7
Ideal para: rodar loops de agentes em volume e tarefas que querem dados em tempo real ou do X.
O Grok 4.7 da xAI é o mais caro das opções de nível médio, a $2/$6, mas é feito para um trabalho específico: tarefas agênticas longas de várias horas. Ele roda em um modelo base novo e maior que o 4.6, com uma execução de aprendizado por reforço mais longa e ponderada para trabalho multietapas, e entende nativamente o próprio arnês de agentes da xAI.
O argumento de venda é "quase de ponta a um preço amigável ao volume". Nas próprias tabelas da xAI, ele registra pontuações agênticas e de terminal fortes, embora as coroas de melhor codificação e terminal ainda pertençam a modelos como o Fable 5.1. É justo notar que ele também perde em alguns benchmarks, como o HealthBench, onde tanto o GPT-6 Sol quanto o Fable o superam.
Prós:
- Forte em tarefas agênticas de longo alcance, com uma API de compactação de contexto para execuções muito longas.
- Acesso a dados em tempo real e do X através das ferramentas da xAI.
- Um modelo capaz ao preço do Grok 4.6.
Contras:
- A opção de nível médio mais cara aqui, e a taxa de contexto longo (
$4/$12acima de 200K tokens de prompt) se aplica a cada token da solicitação, não só ao excedente. - Contexto de 500K, menor que os modelos de 1M de tokens.
- Os medidores fora de token (busca, execução de código) se acumulam em loops de agentes.
Preço: $2 de entrada / $6 de saída abaixo de 200K tokens de prompt, $4/$12 acima, tudo por 1M. Chamadas de ferramentas são cobradas separadamente, por exemplo, busca na web e no X a $5/1.000 chamadas.
Minha opinião: o Grok 4.7 não é realmente um concorrente do Luna para tarefas de texto baratas. É a escolha quando o trabalho é uma execução agêntica longa, especialmente uma que precise de dados em tempo real. Para resumir ou classificar de forma simples e em alto volume, é exagero e caro demais perto do Luna.
As duas perguntas que realmente decidem
Tire os nomes dos modelos e toda essa comparação se resume a duas perguntas.
A primeira é aberto ou fechado. A maioria aqui são modelos fechados, só via API. Se hospedagem própria é um requisito rígido, sua lista curta encolhe rápido.
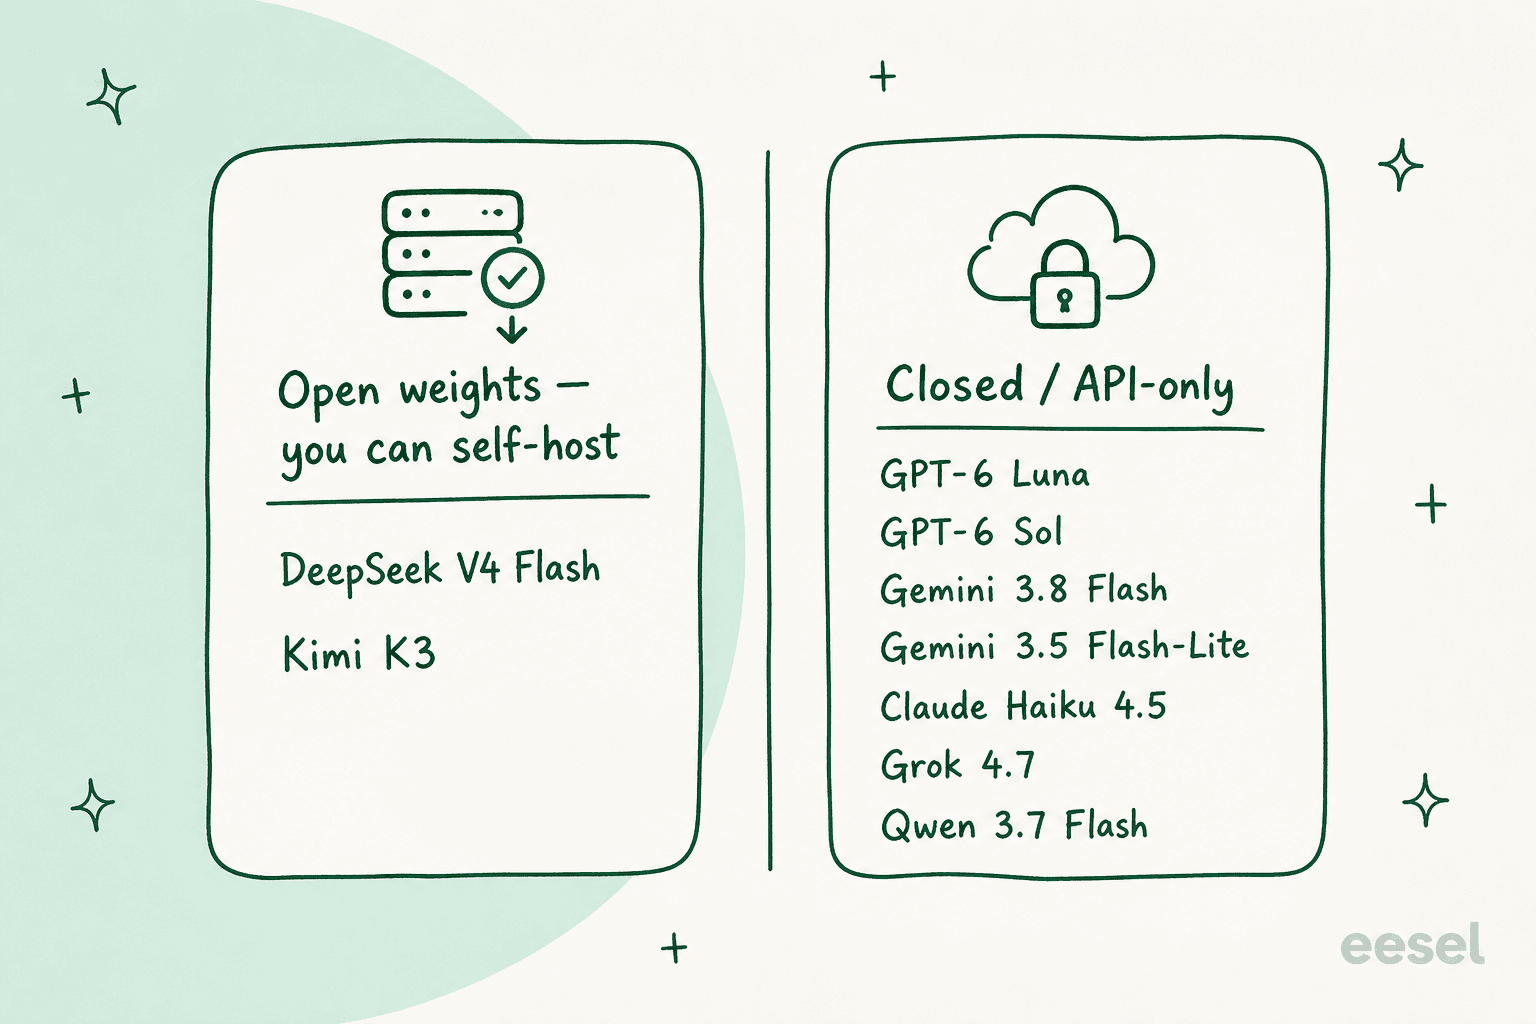
Essa mesma troca aparece sempre que você compara os melhores agentes de IA: a licença decide sua arquitetura antes dos benchmarks. A segunda pergunta é a que trava toda planilha: o mais barato por token não é o mais barato por tarefa. Um modelo que custa um terço do preço do Luna, mas escreve o dobro de tokens para terminar o mesmo trabalho, não está te economizando nada. A única forma de saber é rodar seus prompts reais em dois ou três candidatos e comparar a conta real, não a tabela de preços. É também por isso que a assinatura do ChatGPT pode silenciosamente vencer todas essas taxas de API para uso individual, já que uma mensalidade fixa evita completamente o preço por token.
A parte que o modelo não resolve
Aqui está a coisa que eu gostaria de ouvir se fosse eu lendo isso. Se você está escolhendo um modelo barato para alimentar um trabalho real e recorrente, e para a maioria das equipes que leem um texto como este esse trabalho é atendimento ao cliente, então escolher o modelo é os 10% fáceis do trabalho.
Passei os últimos anos vendo equipes colocarem IA em filas de suporte ao vivo, e o padrão é sempre o mesmo. O modelo bruto é tokens entrando, texto saindo. Antes que ele possa responder com segurança a um cliente, alguém ainda precisa construir a recuperação de informação para que ele conheça sua central de ajuda, os guardrails para que ele não invente com confiança uma política de reembolso, as integrações para que ele possa consultar um pedido, os testes para que você descubra como ele se comporta antes de um cliente descobrir, e o caminho de escalonamento para quando ele deve passar para um humano. Um copiloto de IA para atendimento ao cliente precisa resolver cada um desses pontos. Isso são os 90%.
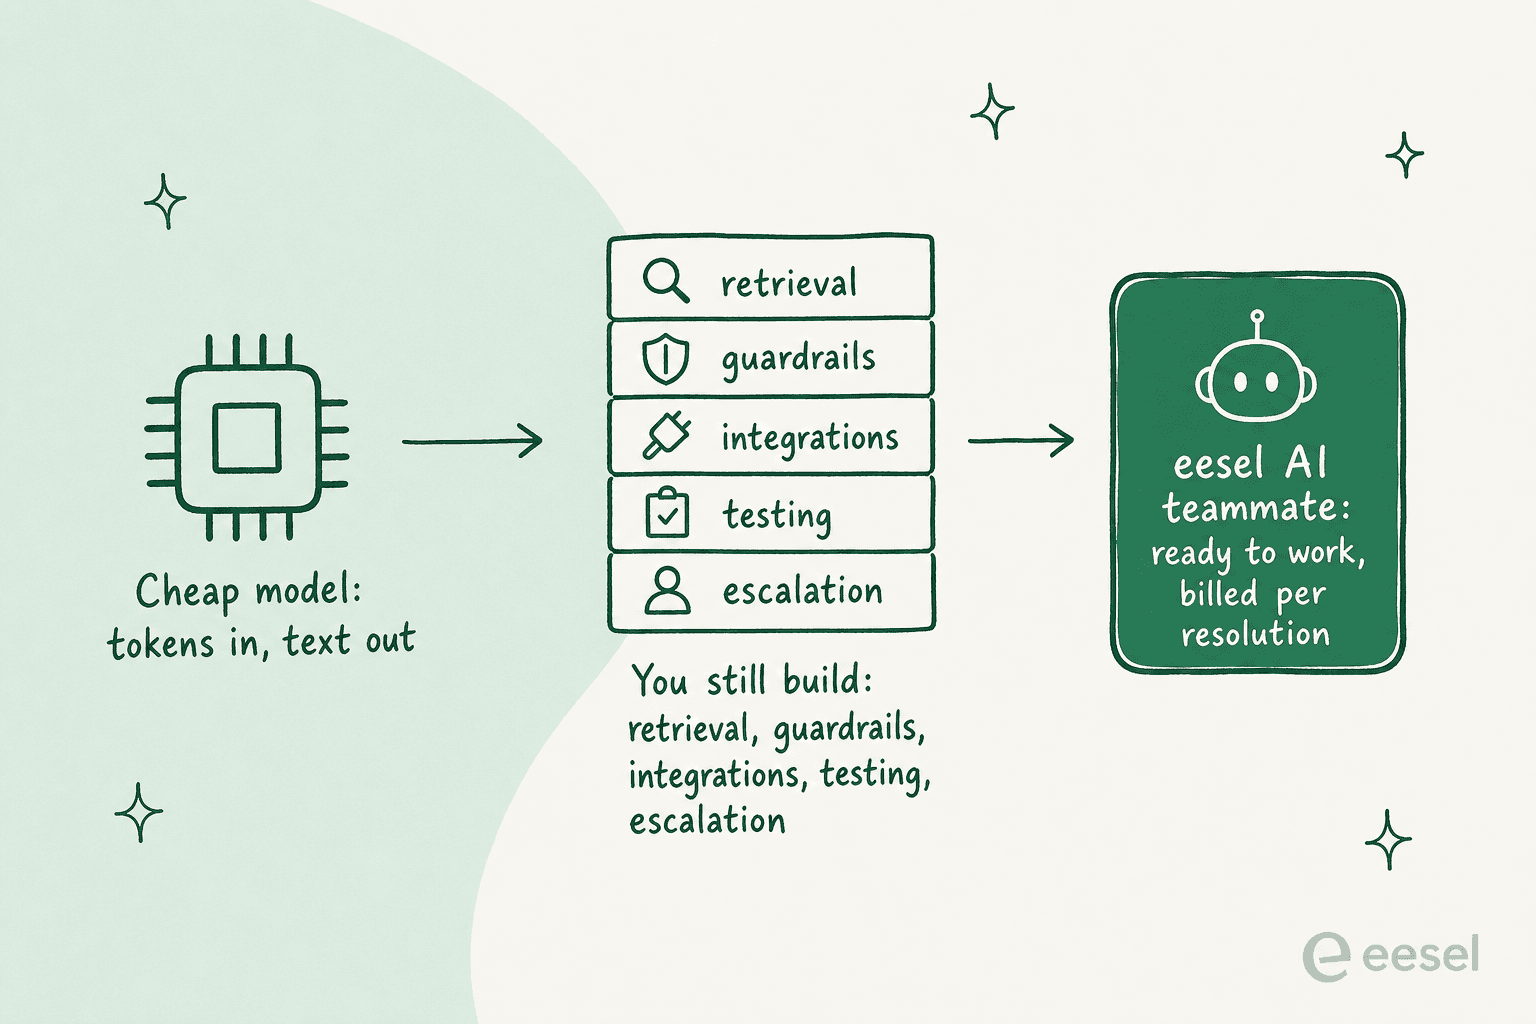
O erro mais caro que vejo é uma equipe que coloca um modelo barato direto na fila, vê ele dar uma resposta errada com confiança a um cliente real, e só então vai procurar os 90% que faltam. É por isso que todo rollout em que eu confiaria é simulado primeiro contra tickets históricos, para que você veja as respostas erradas antes que elas jamais cheguem a uma pessoa.
Experimente a eesel AI
Aqui é onde posso ser direto sobre o que eu construo. Os modelos acima são infraestrutura. A eesel AI é o funcionário que roda em cima deles. Em vez de vender a você um modelo e um monte de peças, entregamos colegas de equipe de IA prontos para trabalhar para tarefas específicas, e o que a maioria das pessoas lendo isso quer é o colega de equipe de IA para o helpdesk.

Ele entra na sua fila existente, aprende com seus tickets passados e sua central de ajuda, e é cobrado por resolução, então você paga por trabalhos feitos em vez de tokens queimados. E porque você pode simulá-lo contra seus próprios tickets históricos antes que ele toque uma fila ao vivo, você consegue ver exatamente como ele teria tratado clientes reais primeiro.
Se você preferir controlar tudo isso a partir de um terminal ou um script, também existe a CLI da eesel. É uma forma amigável a agentes de operar o mesmo colega de equipe e workspace: uma pessoa pode rodá-la manualmente, scripts podem automatizá-la, e agentes de codificação como Claude Code, Codex e Cursor podem controlá-la diretamente. Você pode conectar uma fonte, enviar instruções, iniciar uma simulação, disparar uma execução e ler a atividade de volta, tudo sem abrir o painel. Se o motivo pelo qual você está comparando APIs de modelos brutos é que você quer controle programático e sem interface, essa é a superfície construída para isso, sobre um colega de equipe que já lida com os 90% que o modelo não resolve.
Você pode experimentar a eesel AI gratuitamente, e se o suporte é o trabalho, esse é um caminho muito mais curto do que conectar você mesmo um modelo barato.
Perguntas frequentes
Quais são as melhores alternativas ao GPT-6 Luna em 2026?
Existe uma alternativa mais barata ao GPT-6 Luna?
Qual é o modelo GPT-6 mais barato?
Qual alternativa ao GPT-6 Luna é melhor para o atendimento ao cliente?
As alternativas ao GPT-6 Luna têm pesos abertos?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.