Por que olhar além do GPT-6 Sol
Deixe-me ser justo com o Sol primeiro, porque ele merece. Foi lançado em 23 de setembro de 2026 como o nível intermediário da família GPT-6, entre o GPT-6 Luna e o topo de linha GPT-6 Astra. A proposta da OpenAI é simples e honesta: a mesma inteligência geral do GPT-5.6 Sol, com cerca de metade dos erros factuais, pela metade do preço da API. Ele tem uma janela de contexto de 1.050.000 tokens, busca na web, interpretador de código, um shell hospedado, uso de computador e suporte a MCP integrado. Para a maior parte do chat cotidiano, extração e redação, ele entrega uma resposta muito boa por um preço razoável.
Então por que alguém procuraria alternativas? Algumas razões concretas aparecem sempre.
Primeiro, o preço em alto volume. Os 2$ de entrada e 10$ de saída por milhão de tokens do Sol ficam na média, não são baratos. Quando você roda um modelo dentro de um loop de agente que o chama milhares de vezes por dia, o preço de saída é o número que decide sua conta, e vários modelos abaixo cobram uma fração dos 10$ do Sol.
Segundo, ele está preso à OpenAI. O Sol tem pesos fechados e, na API, não está em nenhum nível gratuito, então o Tier 1 é o seu piso. Se sua conformidade exige auto-hospedagem, ou você simplesmente quer evitar o risco de depender de um único fornecedor, o Sol não ajuda nisso.
Terceiro, é um lançamento de custo-benefício, não um salto de capacidade. Em inteligência geral, ele fica praticamente no mesmo nível do modelo que substitui. Se você realmente precisa de um modelo mais inteligente para programação difícil ou trabalho de agentes de longo prazo, precisa olhar mais para cima na linha, não para o lado.
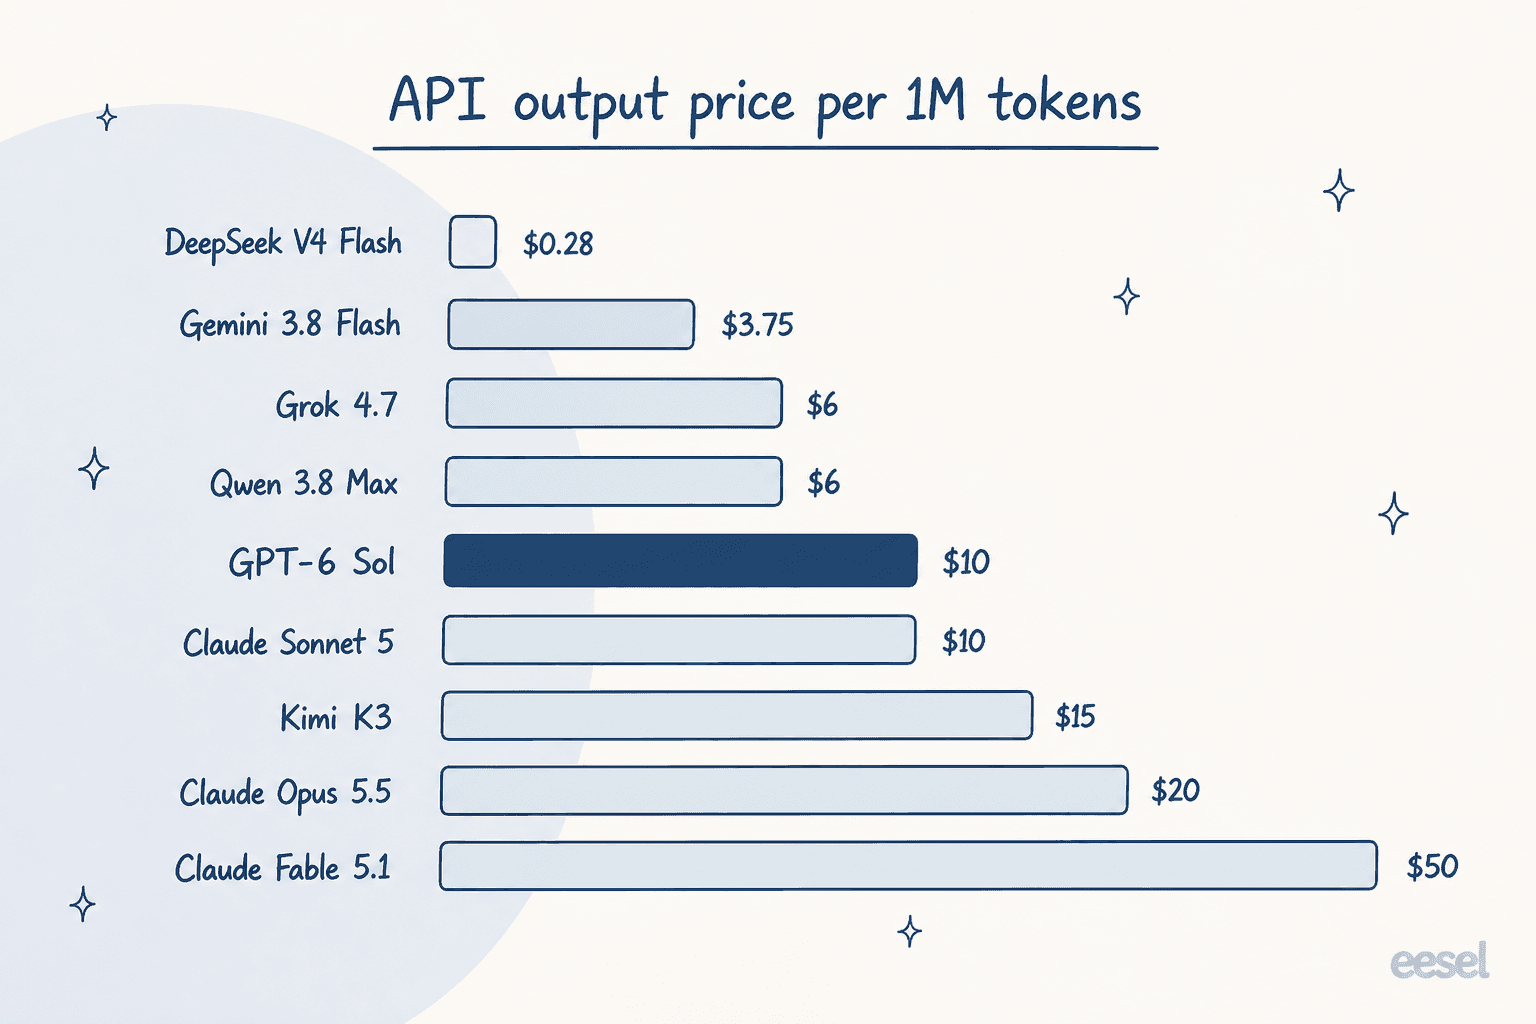
Essa diferença no preço de saída conta a história inteira em uma imagem. Os 10$ do Sol ficam bem no meio, com modelos econômicos uma ordem de grandeza mais baratos de um lado e modelos de fronteira cinco vezes mais caros do outro. Para qual direção você se move depende inteiramente do trabalho.
Como escolhi essas alternativas
Mantive a lista com modelos que são reais, geralmente disponíveis e que uma equipe realmente poderia colocar em produção hoje. Considerei quatro coisas:
- Preço, com honestidade. Taxas reais de entrada e saída por milhão de tokens, além das pegadinhas (sobretaxas de contexto longo, preços de cache, tarifas promocionais que expiram).
- Capacidade pelo preço. Onde o modelo fica em benchmarks públicos e medições independentes como a Artificial Analysis, não apenas no gráfico do próprio fornecedor.
- Abertura. Apenas API fechada, ou pesos abertos que você pode baixar e hospedar.
- Adequação ao trabalho. Modelo equilibrado do dia a dia, teto de fronteira, orçamento e velocidade, ou auto-hospedagem. Ninguém precisa de oito modelos; precisa do modelo certo para a sua situação.
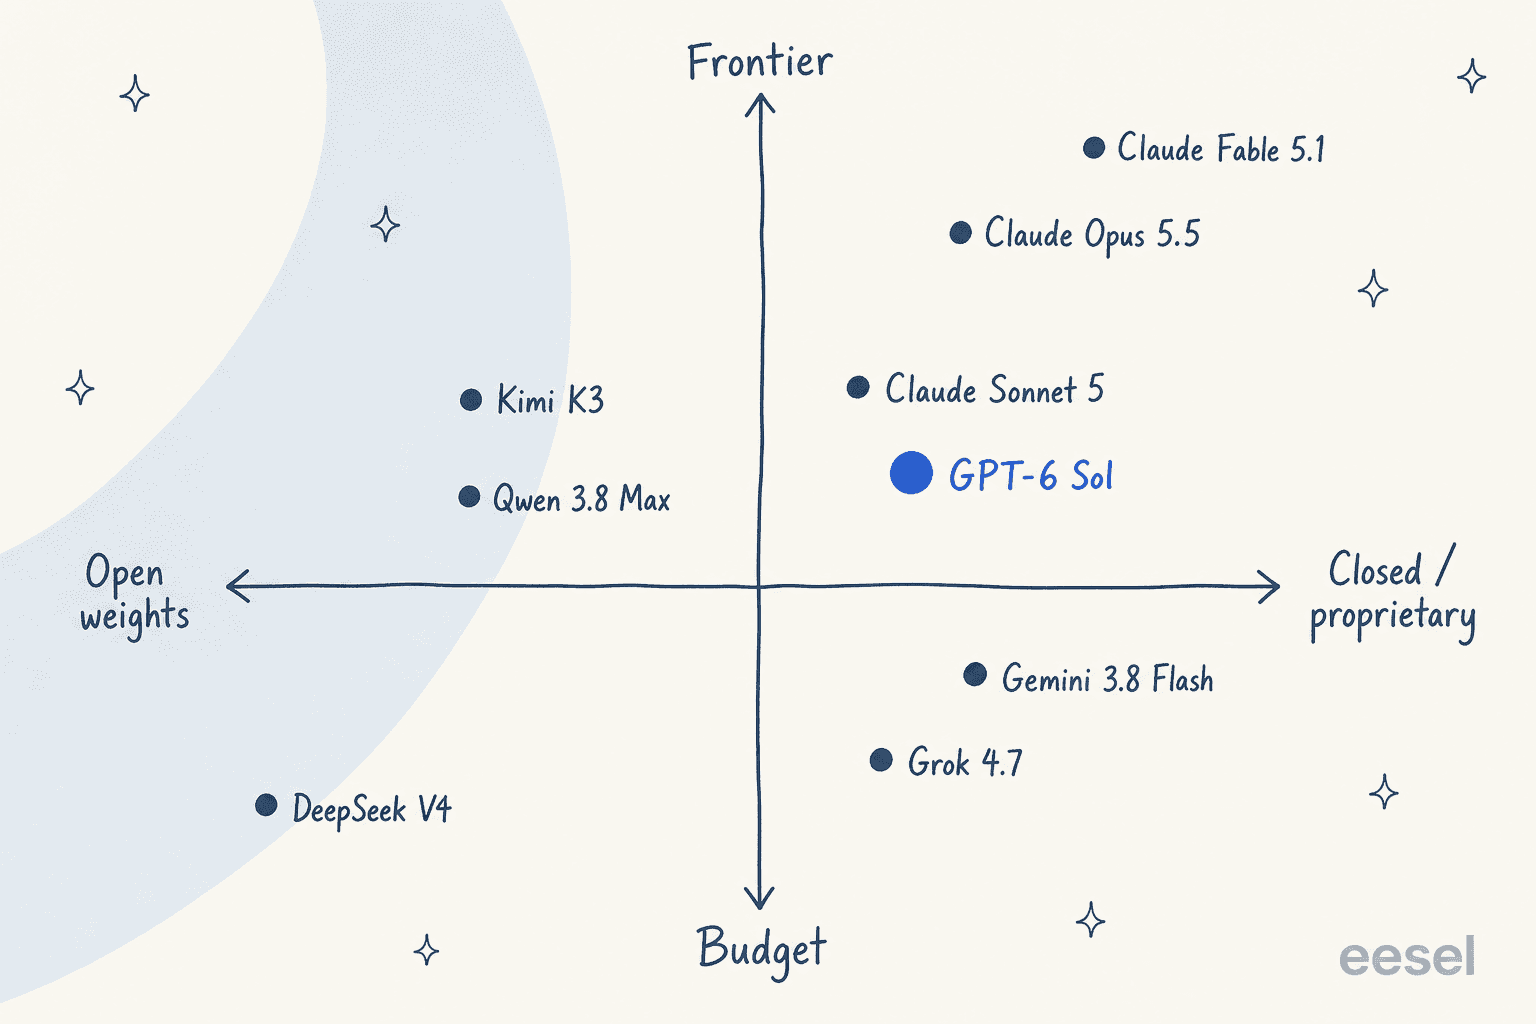
Aqui está o campo inteiro de relance antes de passarmos por eles um a um.
| Modelo | Melhor para | Preço da API (entrada/saída por 1M) | Contexto | Pesos |
|---|---|---|---|---|
| Claude Sonnet 5 | Substituição pelo mesmo preço | $2 / $10 | 1M | Fechado |
| Claude Opus 5.5 | Um teto mais alto, ajustável pelo esforço | $4 / $20 | 1M | Fechado |
| Google Gemini 3.8 Flash | Opção rápida mais barata em escala | $0.75 / $3.75 | 1M | Fechado |
| Grok 4.7 | Saída mais barata em loops de agentes | $2 / $6 | 500K | Fechado |
| Kimi K3 | Modelo de pesos abertos de topo de linha | $3 / $15 | 1M | Aberto |
| DeepSeek V4 | Orçamento mínimo + auto-hospedagem | $0.14 / $0.28 (Flash) | ~1M | Aberto |
| Qwen 3.8 Max | Ecossistema aberto, multilíngue | $2 / $6 | 1M | Aberto (base) |
| Claude Fable 5.1 | Teto de fronteira para trabalho difícil | $10 / $50 | 1M | Fechado |
Uma nota rápida sobre essa pergunta de "quem é mais inteligente", já que ela sempre surge. Na captura do Artificial Analysis Intelligence Index feita no dia em que tanto o Sol quanto o Opus 5.5 foram lançados, o Opus 5.5 ficou em 58 (primeiro lugar entre 212 modelos) contra 48 do Sol. Essa é uma diferença real. Mas a AA reescala seu índice periodicamente, então evitei colar um único número de índice ao lado de cada modelo aqui; comparar uma pontuação de uma captura de uma semana com a de outra é exatamente como as pessoas acabam publicando bobagem sem querer. Onde eu cito um benchmark abaixo, é numa base em que confio.
1. Claude Sonnet 5 – o substituto direto pelo mesmo preço
Melhor para: equipes que querem um modelo equilibrado do dia a dia pelo preço exato do Sol, sem ficar presas à OpenAI.
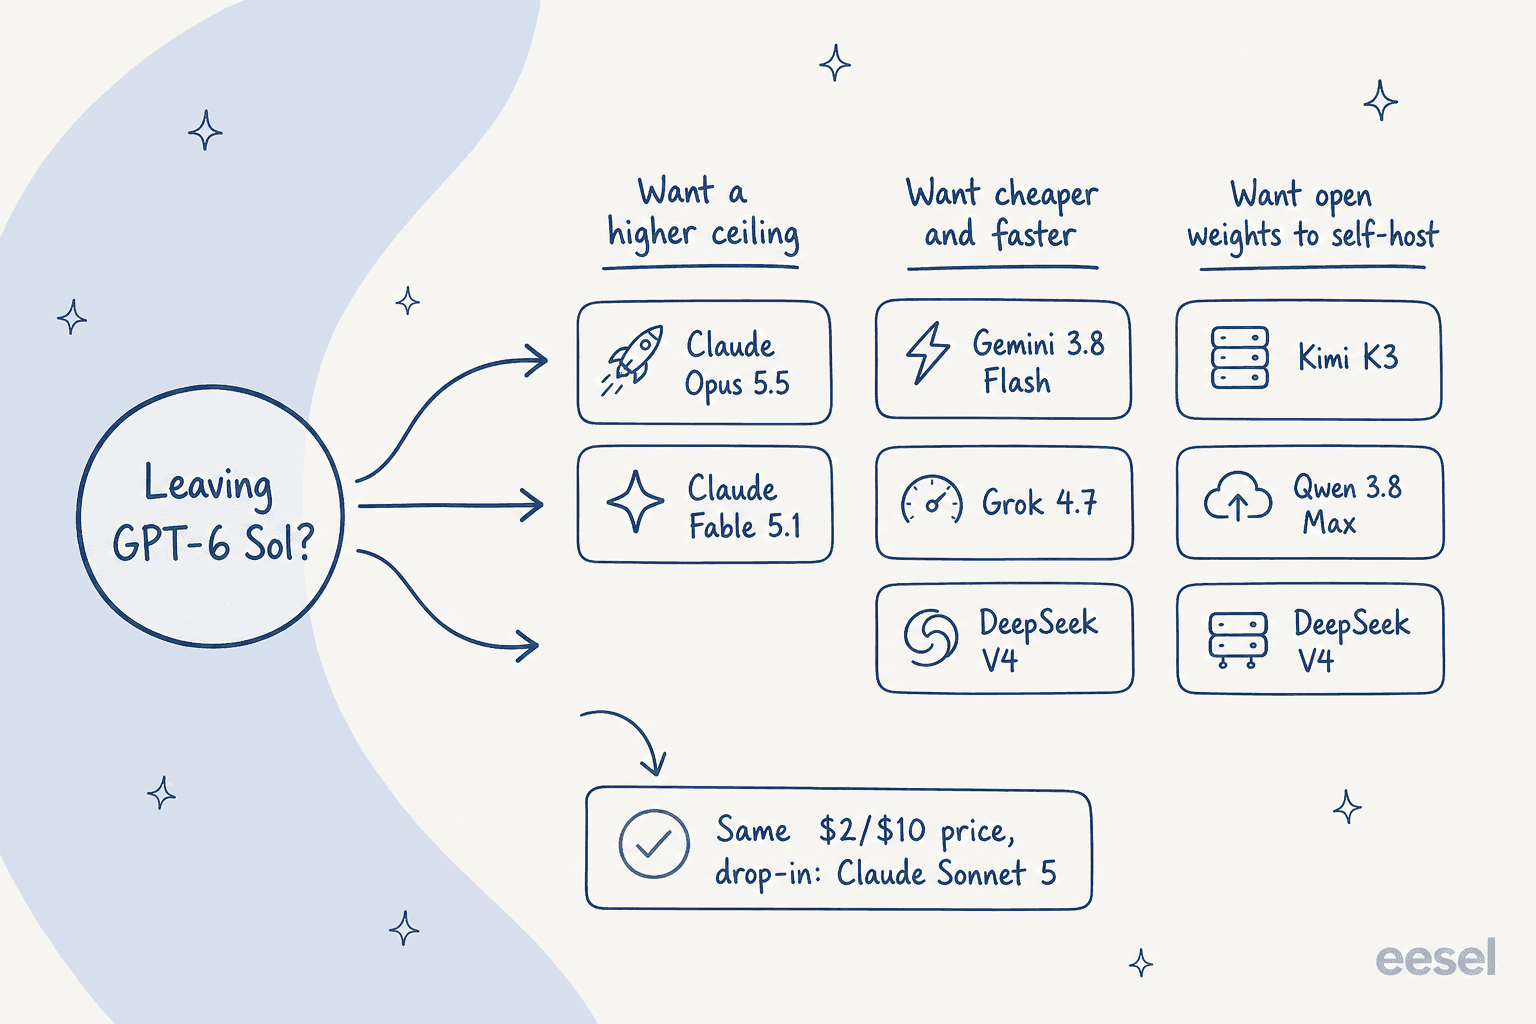
Se o Sol é o modelo equilibrado do dia a dia, o Claude Sonnet 5 é o mesmo posto vindo do outro grande laboratório. E o preço não é apenas parecido, é idêntico: 2$ de entrada e 10$ de saída por milhão de tokens, com leituras de cache a 0,20$. Esse 2$/10$ foi por um breve período uma tarifa de introdução programada para subir para 3$/15$, mas a Anthropic cancelou o aumento em agosto de 2026, então agora é o preço padrão permanente, não uma promoção que vai expirar.
O que você ganha pelo mesmo dinheiro é um conjunto diferente de pontos fortes. O Sonnet 5 tem uma janela de contexto de 1M de tokens e uma reputação de prosa longa mais limpa e sessões de programação longas mais estáveis. Onde ele fica atrás é na atualidade do conhecimento: seu corte de treinamento é janeiro de 2026, mais antigo que o do Sol, e a Anthropic publicou menos números de benchmarks diretos em texto simples do que a OpenAI.
Prós: preço idêntico de 2$/10$; escrita e programação fortes; contexto de 1M; uma proteção de segundo fornecedor contra o risco de depender só da OpenAI.
Contras: corte de conhecimento mais antigo; menos benchmarks publicados para conferir; sem nível gratuito integrado na API.
Minha opinião: se o único motivo de você estar no Sol é "era a escolha padrão sensata", o Sonnet 5 é a primeira alternativa a experimentar, porque a troca não custa nada em preço e compra opcionalidade. Escolha-o se você valoriza qualidade de prosa ou quer evitar dependência de um único fornecedor; fique no Sol se você depende muito do ecossistema de ferramentas da OpenAI.
2. Claude Opus 5.5 – um salto real no teto
Melhor para: equipes que precisam de mais capacidade bruta do que o Sol e estão dispostas a ajustar o esforço para controlar o custo.
O Opus 5.5 é o interessante, porque a leitura ingênua erra. No papel, ele custa mais que o Sol: 4$ de entrada, 20$ de saída por milhão, o dobro da tarifa por token do Sol. Ele também liderou aquele índice da Artificial Analysis no dia do lançamento, com 58 contra 48 do Sol. Então ele é mais inteligente e mais caro, e você assumiria que a conta por tarefa segue a etiqueta de preço.
Mas não segue, e essa é a parte não óbvia que vale a pena internalizar. Como você ajusta o Opus 5.5 pelo esforço de raciocínio, o custo ajustado pelo esforço pode inverter a comparação. No confronto direto, o Opus 5.5 em esforço médio marcou 51 pontos por cerca de 1,34$ por tarefa, superando o Sol em esforço máximo, que marcou 48 por 1,06$, com uma margem de qualidade ampla por um pequeno acréscimo de custo. No topo absoluto, o Sol é bem mais barato por tarefa (1,06$ contra 5,98$ do Opus no máximo), porque o Opus consome muito mais tokens de saída. A duração da tarefa e o esforço são o ponto de virada, não o nome do modelo.
O Opus 5.5 também é o primeiro Opus da Anthropic a ficar mais barato que seu antecessor, um corte de 20%, e a Anthropic agora recomenda começar por ele para a maioria dos trabalhos. A leitura da comunidade é mais dividida quanto à verbosidade:
writes like gemini, a drastic improvement over the opus 5.1 claudeisms

Prós: salto claro de capacidade sobre o Sol; o ajuste de esforço permite comprar qualidade barata em tarefas mais curtas; corte de preço de 20% sobre o Opus 5; corte de conhecimento de junho de 2026.
Contras: caro por tarefa em esforço máximo; ainda pode ser verboso; exagero para extração simples ou chat.
Minha opinião: escolha o Opus 5.5 quando as respostas do Sol não forem boas o suficiente e você realmente for ajustar o nível de esforço. Se você vai rodar tudo no máximo e nunca mexer no ajuste, vai pagar por uma capacidade que não usa.
3. Google Gemini 3.8 Flash – o barato e rápido
Melhor para: cargas de trabalho de alto volume em que custo e vazão superam tudo o mais.
Se o seu gargalo é o orçamento, o Gemini 3.8 Flash é o movimento óbvio. Ele custa 0,75$ de entrada e 3,75$ de saída por milhão até 31 de dezembro de 2026, e depois exatamente o dobro a partir de 1º de janeiro de 2027 (1,50$/7,50$). Mesmo na tarifa de 2027, ele fica abaixo do preço de saída do Sol. Tem uma janela de entrada de 1M de tokens, um nível gratuito, e na Artificial Analysis ocupa o terceiro lugar entre 196 modelos em velocidade bruta de saída.
Duas ressalvas honestas. Primeiro, não é um modelo base novo; a própria ficha do modelo do Google diz quatro vezes que ele é "baseado no Gemini 3.7 Flash", e o Google literalmente diz aos desenvolvedores focados em eficiência para ficarem no 3.7. Segundo, vazão não é o mesmo que responsividade: a AA mediu o tempo até o primeiro token em 13,3 segundos contra uma mediana de classe de 3 segundos. Isso é aceitável para um trabalho em lote noturno e um problema real para qualquer coisa que um humano esteja esperando, como uma resposta de chat ao vivo.
Prós: a opção rápida mais barata aqui; contexto enorme; nível gratuito; vazão excelente.
Contras: latência lenta do primeiro token; não é um modelo genuinamente novo; pode ser verboso e consumir tokens extras.
Minha opinião: recorra ao Gemini 3.8 Flash para trabalhos grandes em lote e em segundo plano em que o custo por token domina. Para qualquer coisa sensível à latência, seu primeiro token lento o desqualifica, e eu olharia para o Grok ou o Sonnet em vez disso.
4. Grok 4.7 – saída mais barata para loops de agentes
Melhor para: cargas de trabalho agênticas que chamam o modelo constantemente e se importam com o preço de saída.
O Grok 4.7 da xAI chegou em 21 de setembro de 2026 e iguala o Sol na entrada (2$) enquanto fica abaixo dele na saída: 6$ por milhão contra 10$ do Sol, abaixo de um prompt de 200K tokens. Ele é construído sobre um modelo base novo e maior que o Grok 4.6, com uma execução de aprendizado por reforço mais longa e voltada para tarefas agênticas de várias horas, e apresenta um salto real em benchmarks de agentes, quase dobrando sua pontuação no Terminal-Bench 4.0 em relação ao 4.6.
Fique de olho em duas coisas. O preço de contexto longo é uma armadilha que vale a pena ler duas vezes: acima de 200K tokens de prompt, a tarifa salta para 4$/12$ e se aplica a todos os tokens da solicitação, não apenas ao excedente. E em algumas avaliações o Grok 4.7 realmente perde para o Sol; no HealthBench Professional ele marca 56,7 contra 60,5 do Sol, então não é uma vitória limpa em tudo.
Prós: saída mais barata que o Sol; grande melhoria agêntica sobre o 4.6; pilha de segurança forte; contexto de 500K.
Contras: um penhasco de preço punitivo em contexto longo; perde para o Sol em alguns domínios; a variante "Fast" é só para Cursor e Grok Build, não para a API pública.
Minha opinião: o Grok 4.7 tem preço pensado para rodar em alto volume em loops de agentes, e é exatamente aí que eu o usaria. Basta manter as solicitações abaixo da linha de 200K tokens, ou a tarifa de contexto longo apaga a economia.
5. Kimi K3 – o modelo de pesos abertos de topo de linha
Melhor para: equipes que querem um modelo de classe de fronteira que possam realmente baixar.
O Kimi K3 da Moonshot AI é o destaque se abertura importa. É um modelo de mistura de especialistas com 2,8 trilhões de parâmetros (104B ativos), com contexto de 1M de tokens, e, crucialmente, os pesos foram lançados no prazo no Hugging Face, onde o índice safetensors confirma a contagem total de 2,8T de fora do comunicado de imprensa. Você pode rodá-lo você mesmo.
Na API hospedada, custa 3$ de entrada e 15$ de saída por milhão, a mesma faixa do Claude Sonnet, então essa não é a barganha que o K2 foi; o valor está nos pesos abertos, não na tarifa da API. Em benchmarks, ele supera a geração anterior de modelos de fronteira e fica atrás da classe alta atual, como o Fable 5.1 e o GPT-5.6 Sol. Uma peculiaridade a saber: o raciocínio não pode ser desligado em nenhum nível, então sua configuração mais barata é um controle de latência, não um nível de custo de verdade.
Prós: pesos genuinamente abertos, verificados no Hugging Face; qualidade próxima da fronteira; contexto de 1M; visão nativa.
Contras: preço da API é de nível médio, não barato; raciocínio sempre ativo; URLs de imagens públicas não são aceitas (apenas base64).
Minha opinião: se seu motivo para deixar o Sol é que ele é fechado, o Kimi K3 é o modelo de pesos abertos de topo de linha mais forte para auto-hospedar. Se você só quer uma API hospedada mais barata, os 3$/15$ dele não são a resposta, e eu olharia para o DeepSeek em vez disso.
6. DeepSeek V4 – o rei do orçamento que você pode hospedar
Melhor para: a opção por token absolutamente mais barata, com o bônus de pesos abertos.
O DeepSeek V4 é onde o gráfico de preços despenca. O nível Flash custa 0,14$ de entrada e 0,28$ de saída por milhão, cerca de um trinta e cinco avos do preço de saída do Sol, com pesos abertos de bônus. Há uma reviravolta genuinamente estranha que vale a pena conhecer: depois de um retreinamento no fim de julho, o nível Flash, mais barato, atualmente supera o nível Pro, mais caro em todos os nove benchmarks agênticos que a DeepSeek publica, e a Artificial Analysis coloca o Flash à frente do Pro em seu próprio índice. O nível caro é simplesmente a versão mais antiga no momento.
Onde o Pro ainda se justifica é em recall e em encontrar detalhes em contexto longo, em coisas como SimpleQA-Verified e recuperação de 1M de tokens. E uma ressalva justa: no ranking de preferência humana do LMArena, o Pro ainda fica acima do Flash, então o índice automatizado e os votantes humanos discordam. Leia os dois antes de se comprometer.
Prós: de longe o mais barato aqui; pesos abertos; o Flash entrega muito acima do seu preço.
Contras: a nomenclatura dos níveis está genuinamente confusa agora; o raciocínio do Pro não pode ser reduzido de forma barata; ecossistema menor que o dos grandes laboratórios.
Minha opinião: para trabalho de alto volume e sensível a custo, o DeepSeek V4 Flash é imbatível em preço e surpreendentemente capaz. Comece pelo Flash, não pelo Pro, apesar dos nomes, e faça benchmark na sua própria tarefa antes de supor que o nível barato é pior.
7. Qwen 3.8 Max – a aposta no ecossistema aberto
Melhor para: equipes que querem uma base aberta, forte desempenho multilíngue e uma grande nuvem por trás.
O Qwen 3.8 Max da Alibaba ficou geralmente disponível em 2 de agosto de 2026. É um modelo de mistura de especialistas com 2,4 trilhões de parâmetros (95B ativos) com contexto de 1M, com preço de 2$ de entrada e 6$ de saída por milhão, igualando o Sol na entrada e superando-o na saída. No LMArena ele é forte: quinto no ranking de Texto e segundo no de Visão no momento da checagem.
A história da abertura tem um asterisco. Os pesos base de fato foram lançados como Qwen3.8-2.4T-A95B, mas sob uma licença personalizada qwen3.8-max, não a Apache 2.0, e a base aberta não é equivalente em recursos ao Max hospedado (que adiciona visão, modo sem pensamento e ferramentas integradas). Se você quer um Qwen com licença permissiva, o menor Qwen3.8-27B é o de Apache 2.0. Então leia a licença antes de construir sobre ele.
Prós: saída mais barata que o Sol; forte no LMArena, especialmente em visão e multilíngue; pesos base abertos disponíveis.
Contras: licença do Max é personalizada, não Apache; a base aberta carece dos recursos hospedados; rankings automatizados e humanos apontam em direções diferentes.
Minha opinião: o Qwen 3.8 Max é uma boa escolha se você quer viver em um ecossistema aberto e valoriza trabalho multilíngue e de visão. Só não presuma que "aberto" significa "substituto licenciado em Apache para o Max hospedado", porque não é.
8. Claude Fable 5.1 – o teto de fronteira
Melhor para: a programação mais difícil e o trabalho de agentes de longo prazo, em que qualidade supera custo sem rodeios.
Quando o Sol não é inteligente o suficiente e o ajuste de esforço do Opus 5.5 ainda não basta, o Fable 5.1 é o topo da família Claude 5 da Anthropic. Ele é caro, 10$ de entrada e 50$ de saída por milhão, cinco vezes o preço de saída do Sol, e não finge o contrário. O que você compra é o teto: ele lidera o grupo em Terminal-Bench-Science (52,6%), CursorBench (73,4%) e HLE-with-tools (65%), e liderou a própria tabela GDPval Elo da equipe do Grok, à frente de todos os rivais que listaram.
As execuções do mundo real são a parte que fica na memória: a Anthropic cita uma sessão de agente sem supervisão de 38 horas na Ramp, e uma equipe de pesquisa resolvendo um problema de anos. A única mudança que suaviza o preço é o corte das leituras de cache para 0,25$ por milhão, mais barato por token em cache do que o Opus 5.5. Vale saber antes de construir com ele: o Fable 5.1 removeu o uso forçado de ferramentas (tool_choice any/tool agora retorna erro 400) e adiciona uma marca d'água estatística de texto a toda a saída para conformidade com a Lei de IA da UE.
Prós: qualidade genuinamente de fronteira; grandes execuções agênticas do mundo real; leituras de cache baratas; contexto de 1M.
Contras: de longe o modelo mais caro aqui; marca d'água e falsos positivos de recusa frustram alguns desenvolvedores; exagero para tarefas cotidianas.
Minha opinião: o Fable 5.1 não é um substituto do Sol para a maioria das cargas de trabalho, é o modelo para o qual você escala nos 5% dos trabalhos que são genuinamente difíceis. Direcione seu tráfego fácil para algo barato e reserve o Fable para o trabalho que realmente precisa dele.
A pergunta que ninguém que troca de modelo realmente faz
Isso é no que eu sempre esbarro, e é o motivo pelo qual escrevi o final antes da lista. A maioria das pessoas que comparam alternativas ao GPT-6 Sol para um produto real, especialmente atendimento ao cliente, está fazendo a pergunta errada. Elas estão otimizando o motor quando o que decide se funciona é tudo que envolve o motor.
Passei os últimos anos colocando agentes de IA em filas de suporte ao vivo em milhares de empresas, e o padrão nunca muda. O modelo raramente é o gargalo. O gargalo é: ele tem o contexto real da sua empresa, consegue realizar ações reais no seu helpdesk, e você pode confiar nele antes de tocar em um cliente real? Aprendemos isso da forma difícil, por isso todo lançamento da eesel agora simula contra seus tickets históricos primeiro, para que você veja a taxa de resolução e as respostas exatas em tickets reais do passado antes de qualquer coisa entrar no ar. Uma API de modelo puro não te dá nada disso. Ela te dá um endpoint de completude de texto muito inteligente e uma conta.
Trocar o Sol pelo Sonnet 5 ou pelo Gemini Flash muda o seu custo por token. Isso, por si só, não te dá um agente de suporte. Essa é uma camada diferente, e é nela que eu realmente focaria a decisão.
Experimente a eesel

É assim que penso nisso: um modelo é infraestrutura, e a eesel é o funcionário que você contrata para rodar em cima dela. Você não escolhe a eesel em vez de GPT-6 Sol ou Claude ou Gemini; você escolhe o colega de equipe, e ele usa o modelo certo para o trabalho por baixo dos panos. Hoje, esse time é um colega de equipe de IA para helpdesk pronto para trabalhar que entra na sua fila de suporte existente já conhecendo sua central de ajuda e os tickets passados, e um redator de blog de IA para conteúdo. Cada um chega com as habilidades, integrações e contexto da empresa para sua função, e é cobrado por resolução, não por token, então um modelo tagarela não explode sua conta.
Se você é o tipo de pessoa que compara APIs de modelos, a CLI da eesel provavelmente é a forma mais rápida de ver isso. É uma interface amigável a agentes sobre o mesmo colega de equipe e workspace: você pode operá-la a partir de um terminal, automatizá-la em scripts, e deixar agentes de programação como Claude Code, Codex e Cursor operá-la diretamente, junto com o servidor MCP, webhooks e controles de acesso de rede. O mesmo agente do painel, só que headless. Você pode experimentar a eesel de graça e simulá-la nos seus próprios tickets antes de se comprometer com qualquer coisa.
Perguntas frequentes
Qual é a melhor alternativa ao GPT-6 Sol em 2026?
Existe uma alternativa mais barata ao GPT-6 Sol?
Qual é uma boa alternativa de pesos abertos ao GPT-6 Sol?
O GPT-6 Sol é melhor que o Claude Sonnet 5?
As alternativas ao GPT-6 Sol funcionam para automação de atendimento ao cliente?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.