Preços da API do GPT-6 Luna: o nível padrão
Aqui está o número pelo qual a maioria das pessoas veio. Na página de preços da API, os preços padrão do GPT-6 Luna são $0.10 por milhão de tokens de entrada e $0.50 por milhão de tokens de saída. A entrada em cache cai para $0.01, e as gravações de cache custam $0.125 por milhão.
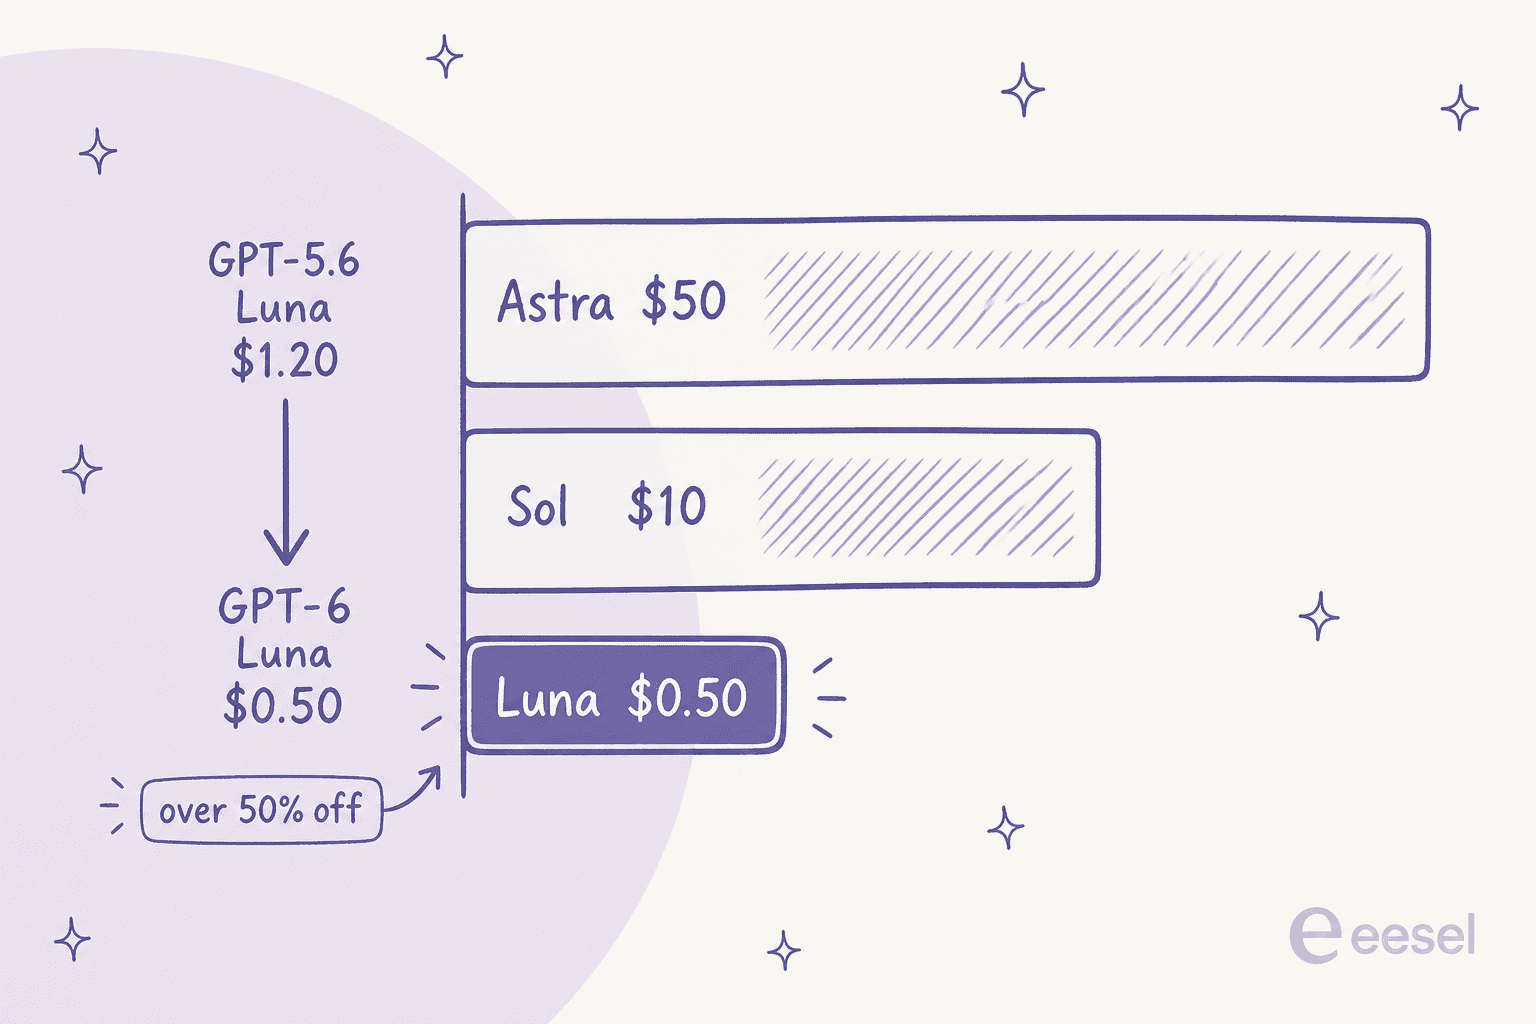
Isso coloca o Luna na base da lista de modelos da OpenAI: bem abaixo do Sol, de nível intermediário, e um erro de arredondamento perto do carro-chefe Astra. É assim que a família GPT-6 se posiciona no nível padrão de contexto curto, com o GPT-5.6 Luna, que está saindo de linha, como referência:
| Modelo | Entrada (por 1M) | Entrada em cache | Saída (por 1M) | Posição |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Carro-chefe |
| gpt-6-sol | $2.00 | $0.20 | $10.00 | Nível intermediário |
| gpt-6-luna | $0.10 | $0.01 | $0.50 | Mais barato (novo) |
| gpt-5.6-luna | $0.20 | $0.02 | $1.20 | Nível leve anterior |
Fonte: preços da API da OpenAI. A história que a tabela conta é simples: o GPT-6 Luna é o antigo GPT-5.6 Luna, com a entrada reduzida pela metade e a saída cortada bem mais da metade. A OpenRouter confirmou as tarifas da família no dia do lançamento. O próprio posicionamento da OpenAI no post de lançamento é "Build with Sol. Scale with Luna", que mostra exatamente onde o Luna deve ficar: o modelo para o qual você aponta trabalho simples e de alto volume.
O corte de preço: o que mudou e o que não mudou
Um corte de preço desse tamanho normalmente vem acompanhado de uma história de capacidade. Neste caso, na maior parte, não veio, e vale a pena ser honesto sobre isso.
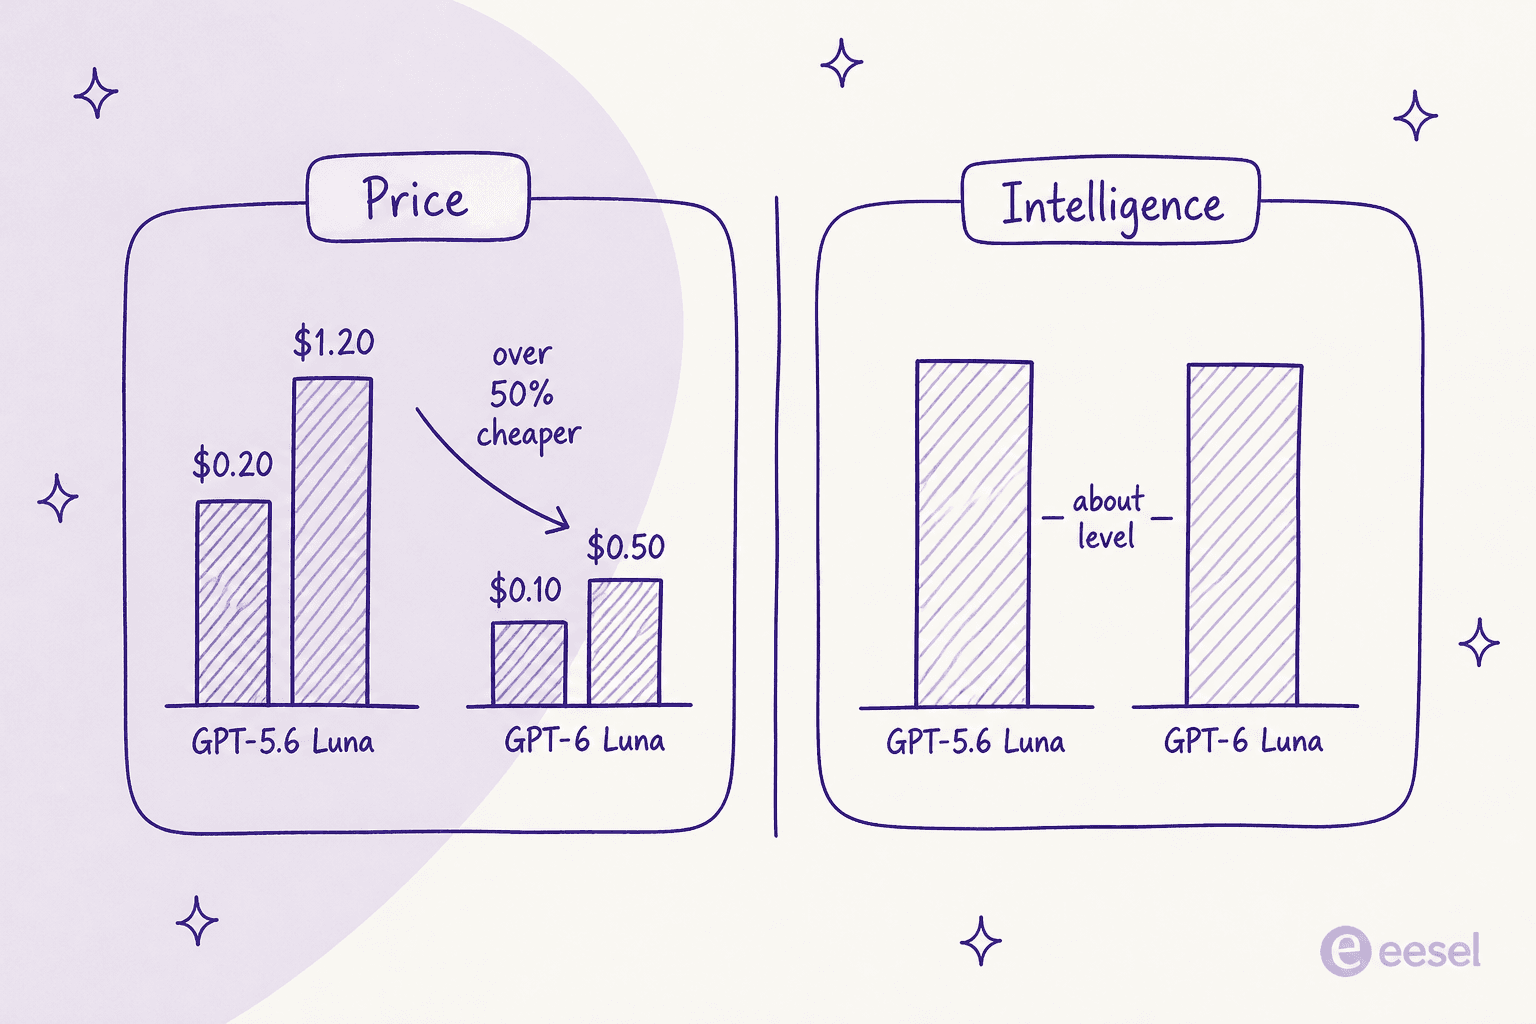
Na medida bruta de inteligência, a Artificial Analysis relatou que o GPT-6 Sol e o Luna "empurram a fronteira de eficiência de custo ao cortar o custo pela metade", enquanto o Intelligence Index e o Coding Agent Index "permanecem no nível do GPT-5.6, com progresso em algumas avaliações e retrocessos em outras". Então o resumo é: o preço se moveu muito, a inteligência quase não se moveu.
Onde o Luna melhorou de fato foi na confiabilidade, e a OpenAI se apoiou nisso:
- Factualidade. A OpenAI relata que a família GPT-6 comete menos erros factuais que seus antecessores GPT-5.6. A Artificial Analysis registrou a taxa de alucinação do Luna com esforço máximo caindo de 93% para 77%, uma melhora real, embora ainda maior que a do Sol no mesmo teste.
- Fronteira de eficiência de custo. O objetivo do Luna é taxa de transferência por dólar, e é aí que ele se move: a mesma inteligência leve por cerca de metade do custo por token.
- Avaliações agênticas. A família registrou pequenos ganhos em AutomationBench e Terminal-Bench, mas o Luna não é o modelo que você escolhe para trabalho agêntico difícil. Esses são Sol e Astra.
A comunidade interpretou da mesma forma. Na discussão de lançamento, um desenvolvedor resumiu bem a troca:
"Eu preferiria um desempenho melhor pelo dobro do preço do que um desempenho ~igual por metade do preço."

Esse é o quadro honesto para os preços do GPT-6 Luna. Se você já usava o GPT-5.6 Luna, isso é um corte de fatura de graça. Se você esperava que o "6" significasse um salto na inteligência bruta, as pontuações de benchmark pedem para moderar essa expectativa.
Níveis de serviço: a variação de 4x que quase todo mundo perde
A tarifa padrão é um ponto de partida, não a história toda. O GPT-6 Luna roda nos mesmos níveis de serviço que o resto da família, e a diferença entre o mais barato e o mais caro é de 4 vezes para exatamente o mesmo modelo. Para um modelo de alto volume como o Luna, essa é a maior alavanca isolada sobre o custo.
| Nível | Entrada (por 1M) | Entrada em cache | Saída (por 1M) | Contrapartida |
|---|---|---|---|---|
| Batch | $0.05 | $0.005 | $0.25 | 50% de desconto, assíncrono, até 24h |
| Flex | $0.05 | $0.005 | $0.25 | 50% de desconto, mais lento, pode entrar em fila |
| Padrão | $0.10 | $0.01 | $0.50 | Latência padrão |
| Modo Fast | $0.20 | $0.02 | $1.00 | 2x, menor latência |
Fonte: preços da API da OpenAI. Algumas coisas para saber antes de escolher:
- Batch e Flex têm o mesmo preço, mas são para trabalhos diferentes. O Batch é para trabalho assíncrono que você envia e coleta depois; o Flex é para solicitações interativas que você está disposto a deixar rodar mais devagar ou entrar em fila. Os dois cortam sua fatura pela metade.
- O modo Fast dobra a tarifa para a menor latência, e aceita
service_tier: "priority"ouservice_tier: "fast". - O modo Fast tem uma pegadinha regional. Para residência de dados na UE, ele pode voltar ao padrão, então não assuma que funciona em todo lugar.
Se uma carga de trabalho tolera latência, definir Batch ou Flex como padrão corta seu gasto com o Luna pela metade de novo. Isso se soma ao corte de preço em relação ao GPT-5.6: um trabalho compatível com lote no GPT-6 Luna roda a $0.05/$0.25, que é onde vivem os trabalhos de classificação e extração realmente baratos e de alto volume.
As pegadinhas: contexto longo e a ficha técnica
Dois detalhes se escondem nas letras miúdas da página do modelo, e ambos podem remodelar um orçamento silenciosamente.
Primeiro, o contexto longo é cobrado a uma taxa mais alta para a solicitação inteira. A janela de contexto do Luna é grande, 1.050.000 tokens, mas qualquer prompt com mais de 272K tokens de entrada muda a solicitação inteira para a taxa de contexto longo: $0.20 por milhão de entrada e $0.75 por milhão de saída no nível padrão. Isso é 2x na entrada e 1,5x na saída, aplicado a cada token da solicitação, não apenas aos que ultrapassam o limite.
| Nível padrão | Contexto curto (≤272K) | Contexto longo (>272K) |
|---|---|---|
| Entrada (por 1M) | $0.10 | $0.20 |
| Entrada em cache | $0.01 | $0.02 |
| Saída (por 1M) | $0.50 | $0.75 |
Segundo, vale a pena conhecer a ficha técnica antes de se comprometer. O GPT-6 Luna aceita até 922.000 tokens de entrada e retorna até 128.000, com data de corte de conhecimento em 18 de maio de 2026, um mês depois do Sol. Ele aceita texto e imagem como entrada, texto como saída, e expõe esforço de raciocínio de none até max, com medium como padrão. Também traz o conjunto completo de ferramentas da Responses API: busca na web, interpretador de código, shell hospedado, uso de computador e MCP. O piso de limite de taxa é o Tier 1 com 500 solicitações e 500K tokens por minuto, escalando para 30.000 solicitações e 180M tokens por minuto no Tier 5.
Estime sua fatura da API do GPT-6 Luna
Os preços de tabela são abstratos até você colocar seus próprios números. Informe os milhões de tokens de entrada e saída que você espera por mês, escolha um nível de serviço, e isto calcula o custo mensal. A sobretaxa de contexto longo é considerada automaticamente.
O padrão que a maioria dos times encontra é que os tokens de saída dominam a fatura, já que a saída custa 5x a tarifa de entrada. Para as cargas de trabalho de alto volume do Luna, essa conta escala rápido, e mover um trabalho compatível com lote para o Batch é onde a economia se paga mais rápido.
Preços do GPT-6 Luna no ChatGPT e no Codex
Se você não está chamando a API, o GPT-6 Luna chega até você pelo ChatGPT e pelo Codex, e é aí que a história do Luna se diferencia do resto da família: é o modelo que todo mundo recebe.
| Plano | Preço | Acesso ao GPT-6 Luna |
|---|---|---|
| Free | $0 | Sim (aplicativo de desktop) |
| Go | $8/mês | Sim (aplicativo de desktop) |
| Plus | $20/mês | Sim |
| Pro | A partir de $100/mês | Sim |
| Business / Enterprise / Edu | Por assento | Sim |
Fonte: anúncio de lançamento da OpenAI. Algumas coisas se destacam:
- O Luna chega ao Free. Essa é a manchete para quem não é desenvolvedor: o plano Free e o plano Go de $8 recebem o GPT-6 Luna no aplicativo de desktop. Nenhum dos dois inclui o Sol, que começa no plano Plus de $20/mês. Se você já usou um modelo GPT-6 sem pagar pelo ChatGPT, era o Luna.
- Os planos pagos empilham o Sol por cima. Plus e acima mantêm o Luna e adicionam o GPT-6 Sol, então pagar mais não tira o Luna; amplia o seu menu de modelos.
- O Codex também recebe o Luna. A OpenAI lançou os dois modelos no Codex nos mesmos níveis, então usuários de agentes de codificação podem selecionar o Luna para execuções mais baratas e leves.
Nem todo mundo ficou convencido de que a economia na assinatura corresponde ao corte da API. Um desenvolvedor observou que mudanças no limite de mensagens sugeriam que o corte de 50% na API se traduziu em algo mais próximo de um corte de um terço dentro dos planos do ChatGPT, então verifique sua própria cota em vez de assumir que o desconto de tabela se aplica diretamente.
Como os preços do GPT-6 Luna se comparam
Olhando de longe, onde o Luna se posiciona em relação ao resto da fronteira? A versão curta é que a OpenAI usou o Luna para fixar o piso de preço de um modelo realmente útil.
- Frente ao próprio portfólio: a $0.10/$0.50, o Luna custa um quinto do preço do GPT-6 Sol ($2/$10) e um centésimo do GPT-6 Astra na saída ($50). Para trabalho simples e de alto volume, o Luna é a escolha óbvia; para raciocínio difícil ou trabalho agêntico de longo alcance, você sobe para Sol ou Astra.
- Frente à Anthropic: o Luna fica bem abaixo da ponta leve do portfólio da Anthropic em preço bruto por token, exatamente o posicionamento que a OpenAI queria na base do mercado.
- Frente ao Google: ele compete diretamente com as opções mais leves do Gemini como o Gemini 3 Flash numa base de preço por inteligência, que é a verdadeira disputa nesse nível.
O panorama mais amplo no tópico de lançamento foi que os modelos fechados continuam ficando mais baratos sem ficarem muito mais inteligentes, algo que vários desenvolvedores descreveram como uma corrida para o fundo no preço. Isso é uma boa notícia se você está comprando tokens. É um lembrete, porém, de que um modelo mais barato não muda a parte mais difícil de colocar IA em um fluxo de trabalho real, que é tudo ao redor do modelo.
O que os preços do GPT-6 Luna significam se você lidera um time de suporte
Aqui é onde eu quero ser útil em vez de apenas somar tarifas. Eu construo o produto do eesel, então passo meu tempo pensando em como esses modelos realmente se encaixam num fluxo de trabalho ao vivo, e a resposta honesta é um pouco contraintuitiva.
Se você lidera atendimento ao cliente ou operações internas, um modelo de fronteira mais barato muda menos do que a manchete sugere. Um modelo bruto como o Luna é infraestrutura. É um motor capaz e barato, mas, direto da caixa, ele não conhece sua política de reembolso, não consegue ver seus últimos 50.000 tickets, não tem acesso ao seu sistema de pedidos e não tem uma forma segura de ser testado contra sua fila real antes de começar a responder clientes. Ele é cobrado por token para pensar, não por problema resolvido. Um preço por token bem baixo é real, mas é um desconto na parte mais barata do projeto.
A unidade que realmente importa para um time de suporte é o custo por resolução, não o custo por token. Uma fatura de tokens é imprevisível: ela se move com o tamanho do prompt, tentativas repetidas e o quanto o modelo está "conversador" em um determinado dia. Ao longo de anos colocando IA em filas de suporte ao vivo, já vimos bots que soam confiantes darem respostas erradas silenciosamente, e é exatamente por isso que todo lançamento deveria ser simulado contra seus próprios tickets históricos antes de chegar perto de um cliente. Essa é a diferença entre um modelo e um sistema construído ao redor dele: seu conhecimento, suas integrações, ações seguras e uma forma de testá-lo primeiro no seu histórico.
É também por isso que eu não trocaria de plataforma a sua automação de suporte na semana em que um novo modelo é lançado. Os melhores agentes de IA para helpdesk e ferramentas de atendimento ao cliente são flexíveis quanto ao modelo por design, então quando um modelo mais barato ou mais inteligente chega, você herda a atualização sem reconstruir nada, e sem renegociar seu orçamento em torno de uma nova tarifa de token.
Experimente o eesel
Se o seu interesse no preço do Luna é na verdade "quanto uma IA vai me custar para realmente resolver tickets", essa é a tarefa para a qual um colega de equipe de IA é construído, e é aí que o eesel entra. O GPT-6 Luna é o motor; o eesel é o funcionário que você contrata para dirigi-lo. O agente de IA para helpdesk treina com seus tickets passados e sua central de ajuda, se conecta ao helpdesk que você já usa em vez de substituí-lo, e permite que você o simule contra milhares dos seus tickets históricos reais para que você veja como ele vai performar, e quanto vai custar, antes de ele tocar em uma conversa ao vivo.
A cobrança conta a história que uma taxa de token não consegue contar. Em vez de pagar por token para pensar, você paga 40¢ por ticket que ele realmente resolve, sem taxas por assento e sem mínimo de plataforma, então o custo acompanha os resultados em vez da conversa do modelo. Você pode começar de graça com $50 de uso e sem cartão de crédito.

E como esta é uma pergunta de preços voltada para desenvolvedores, vale a pena saber que todo o workspace do eesel pode ser controlado pelo terminal, não apenas por um painel. O CLI do eesel (npx @eesel/cli) permite que uma pessoa, um script ou um agente de codificação como Claude Code, Codex ou Cursor opere o mesmo colega de equipe: conectar um helpdesk, ler e editar as instruções vigentes, rodar eesel activity para inspecionar execuções passadas, e bloquear mudanças atrás de eesel approvals. Todo comando imprime JSON, e --dry-run mostra exatamente a chamada ao servidor que uma escrita faria antes de enviá-la. Então a mesma cobrança por resolução que você modelaria nesta calculadora é algo que você pode integrar nas suas próprias ferramentas, não só clicar em uma interface.
Os preços do GPT-6 Luna são, agora, a forma mais barata de rodar um modelo capaz, e para trabalho simples e de alto volume o preço vale a pena. Mas, para a maioria dos times de suporte, a tarifa de token nunca foi o número que importava. Conseguir um colega de equipe testado, conectado e responsável dentro do seu fluxo de trabalho existente, cobrado pelo resultado, é a parte que vale a pena gastar o seu orçamento.
Perguntas frequentes
Quanto custa o GPT-6 Luna na API?
O GPT-6 Luna é mais barato que o GPT-5.6 Luna?
O GPT-6 Luna está disponível no plano gratuito?
O que é a sobretaxa de contexto longo do GPT-6 Luna?
Quanto custa o GPT-6 Luna no ChatGPT e no Codex?
O que Batch e o modo Fast mudam nos preços do GPT-6 Luna?
Preços do GPT-6 Luna vs GPT-6 Sol: qual devo usar?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.