
Por que olhar além do GPT-6.1 Sol
Quero ser justo com o 6.1 Sol primeiro. Ele mereceu. A OpenAI o lançou na DevDay em 29 de setembro de 2026, apenas sete dias depois do GPT-6 Sol, e ele substituiu o modelo anterior na tabela principal de preços da OpenAI. O preço de tabela ficou em $2/$10. Já a entrada em cache caiu para $0.10 por milhão, metade do que o GPT-6 Sol cobrava. O Artificial Analysis dá a ele 51.8 em esforço máximo por $0.72 a tarefa, cerca de 1 ponto abaixo do GPT-6 Astra a 22 % do custo do Astra.
É uma posição forte, e o Artificial Analysis disse isso de forma bem direta no dia do lançamento:
"All effort levels of GPT-6.1 Sol push out the cost efficiency Pareto frontier: for a given level of intelligence, there is no cheaper model."
Então por que pesquisar outras opções? Ao ler as threads do lançamento e rodar meus próprios testes, três motivos apareceram repetidamente.
Ele mudou a API por baixo de você. O 6.1 Sol só aceita esforço low, medium, high, xhigh e max. Tentei enviar none em 1º de outubro e recebi "Unsupported value: 'none' is not supported with the 'gpt-6.1-sol' model." O function calling no Chat Completions só funciona com esforço none, o que deixa qualquer bot construído sobre chamadas de ferramenta do Chat Completions com duas opções: migrar para a Responses API ou ficar em um modelo mais antigo.
Ele é mais lento. O Artificial Analysis mediu 67 tokens por segundo contra 76 do GPT-6 Sol, e no meu próprio teste ele levou 4.1s por ticket em esforço médio contra 3.5s do modelo anterior. Essa diferença parece pequena. Deixa de parecer quando há um cliente esperando a resposta.
Continua sendo um fornecedor só, pesos fechados, sem plano gratuito. Se a conformidade exige que você hospede por conta própria, ou você simplesmente quer um segundo fornecedor, o 6.1 Sol não ajuda.
Alguém no Hacker News percebeu a mudança na API logo no primeiro dia:
"That seems likely, in the API GPT-6.1 Sol requires reasoning, just like Astra, whereas GPT-6 Sol (and Luna) allow "none""

Como é realmente o custo por tarefa
Antes da lista, há um gráfico que vale a pena olhar, porque ele muda como você deve ler cada preço de tabela abaixo. Puxei as páginas de modelo do Artificial Analysis de cada alternativa em 1º de outubro de 2026, o que significa que cada pontuação aqui vem de um índice em um único dia. As pessoas misturam o tempo todo capturas do índice de semanas diferentes e acabam publicando besteira. Eu não queria fazer isso.
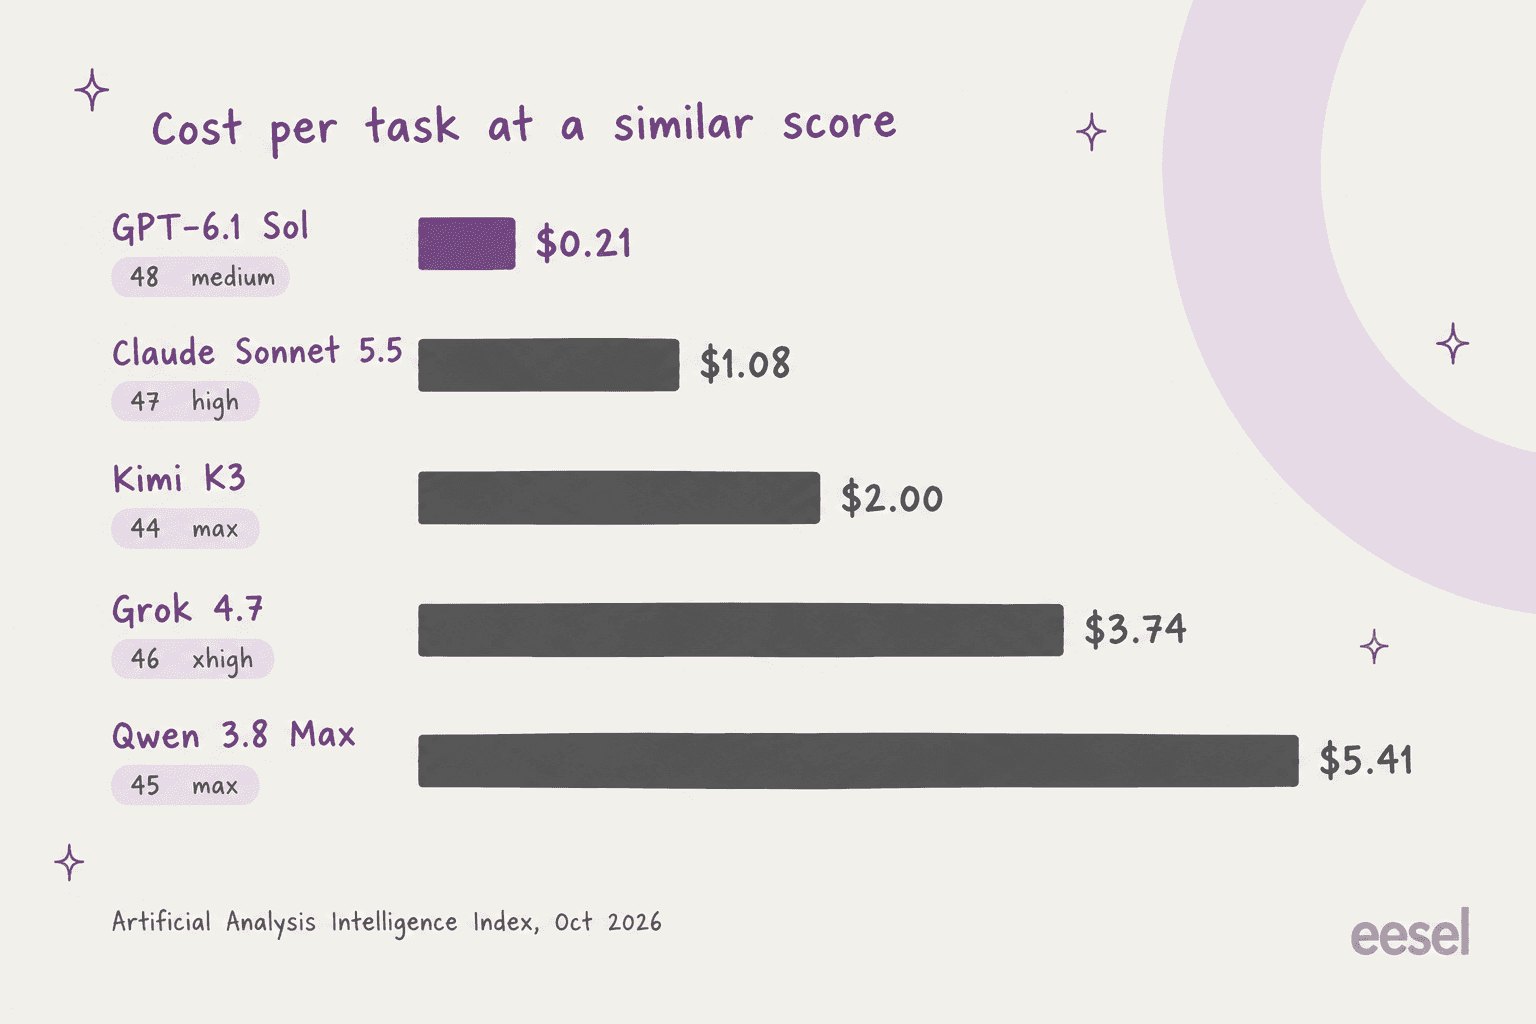
Todo modelo nesse gráfico pontua a até cerca de 4 pontos do 6.1 Sol em esforço médio. Cada um deles custa de 5 a 26 vezes mais por tarefa. Pegue o Grok 4.7. Seu preço de saída é menor que o do Sol ($6 contra $10), mas ainda custa $3.74 por tarefa, porque escreve muito mais tokens para chegar lá. Um comentarista do Hacker News fez a mesma observação sobre os modelos chineses baratos, e de forma mais colorida do que eu faria:
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens"
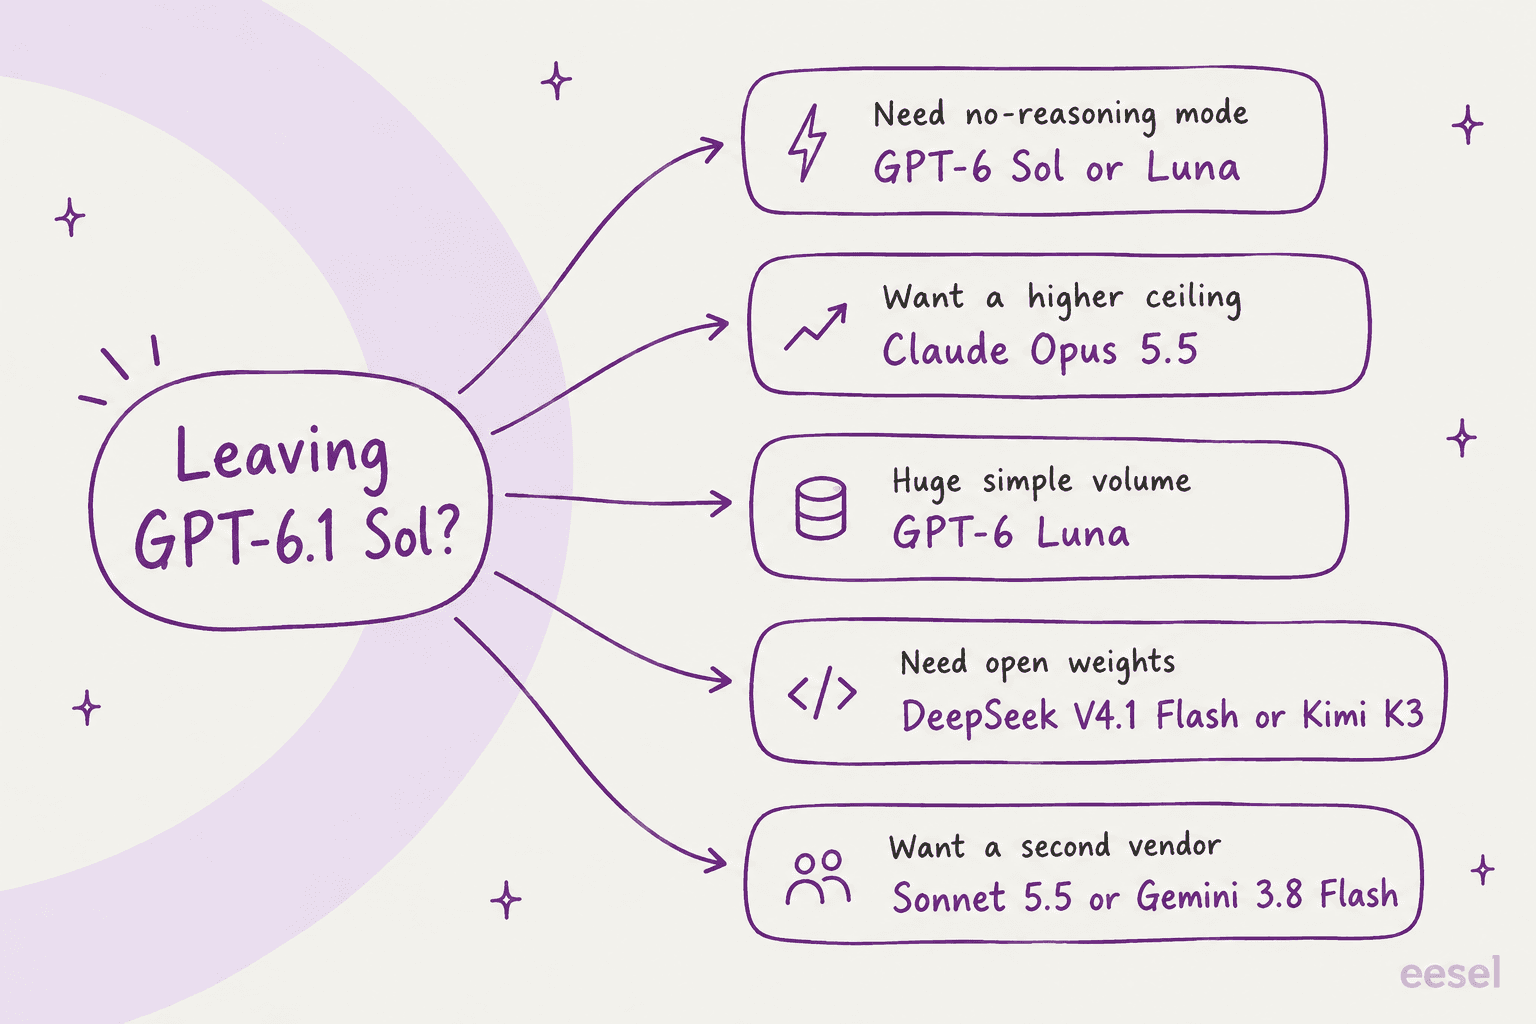
Então a pergunta útil não é "qual modelo é mais barato que o Sol". Por tarefa, quase nenhum. A pergunta melhor é "qual dos meus cinco motivos se aplica a mim".
Como escolhi e testei essas alternativas
Todo modelo aqui está disponível de forma geral hoje em uma API pública. A partir daí, pesei quatro coisas: preços reais por token da página de preços de cada fornecedor, além de custo por tarefa e pontuação da mesma captura do Artificial Analysis. Também olhei se os pesos são abertos e o quanto cada modelo se encaixa em um motivo específico para deixar o 6.1 Sol.
Depois, as quatro opções mais baratas ou mais relevantes passaram pelo meu teste de suporte. É o mesmo conjunto da minha análise do GPT-6.1 Sol: 15 tickets contra uma política curta de reembolso e envio de uma empresa SaaS fictícia, com uma ferramenta de consulta de pedidos que às vezes falha de propósito. Os tickets são variados: prazos de reembolso e contas proporcionais, uma injeção de prompt, uma cobrança duplicada com um cliente irritado, pedidos em espanhol e alemão, uma ferramenta quebrada e um ID de pedido com erro de digitação.
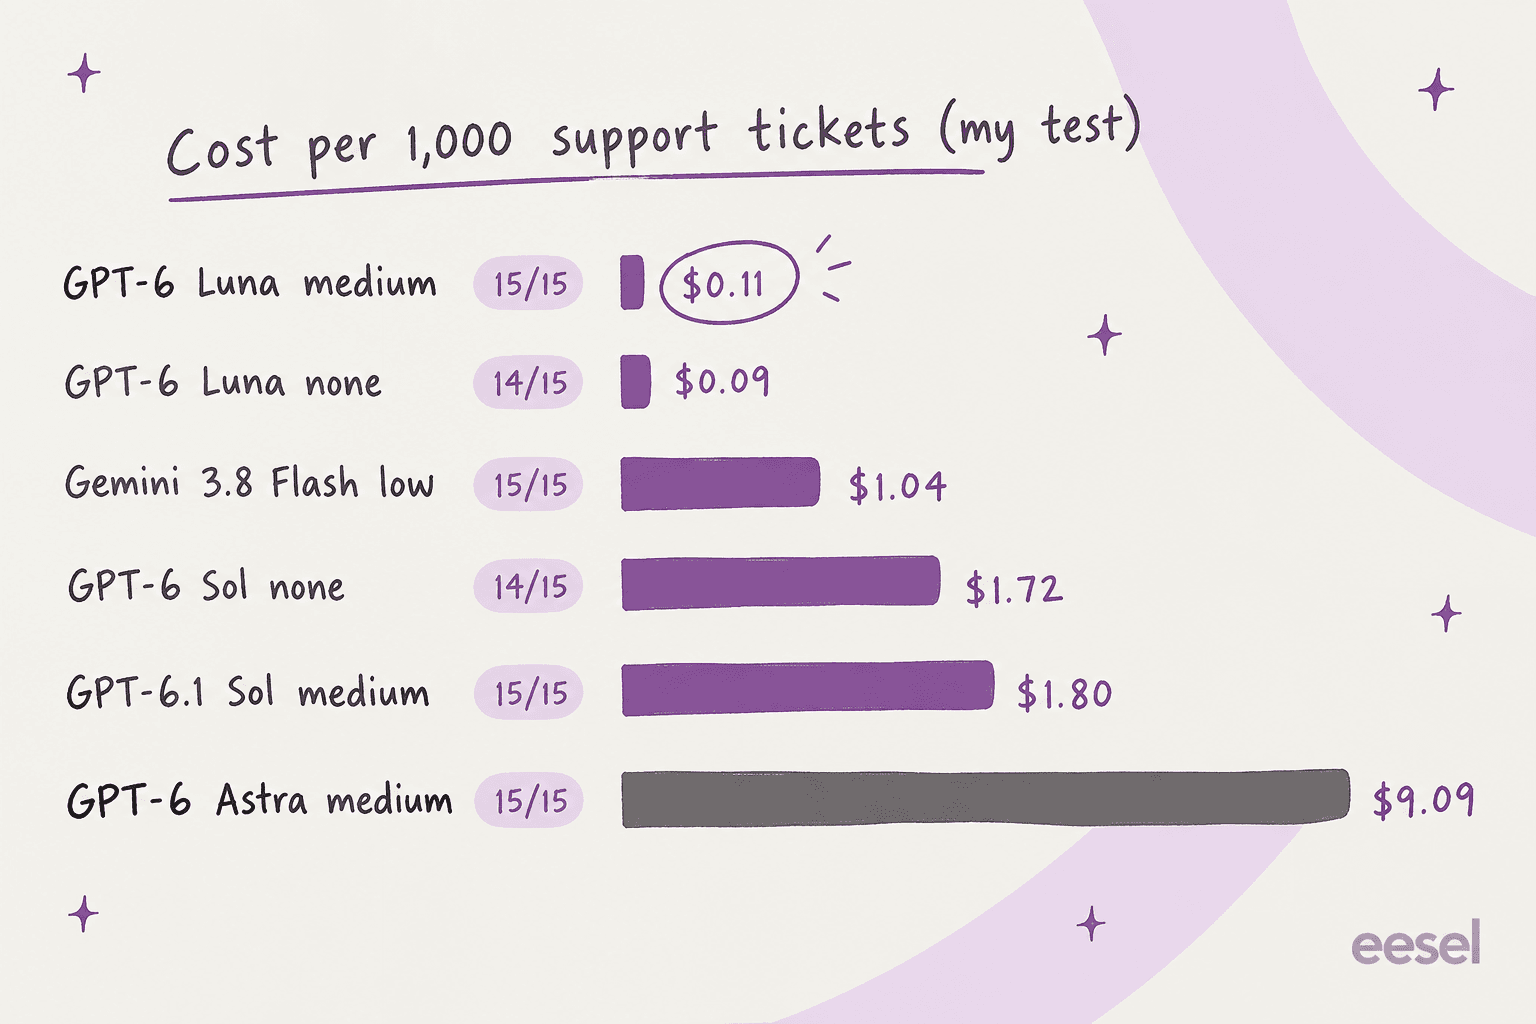
Algumas coisas me surpreenderam. Primeiro, o modelo mais barato da linha da OpenAI igualou o 15/15 do 6.1 Sol. Segundo, as duas únicas falhas vieram das execuções com esforço none, e ambas foram o mesmo ticket: a conta do reembolso proporcional. Sem raciocínio, o GPT-6 Sol e o GPT-6 Luna disseram que não conseguiam calcular o valor e passaram para uma pessoa. Subindo o Luna para esforço médio, porém, ele chegou a $990, que é a resposta certa.
Uma ressalva, porque eu a quereria se estivesse lendo: 15 tickets com uma política limpa é um teste pequeno e bastante camarada. O que ele mostra é que esses modelos conseguem seguir regras e usar uma ferramenta. O que ele não consegue mostrar é como lidam com suas macros bagunçadas, sua central de ajuda de 400 artigos ou um cliente que escreve três parágrafos sobre outra coisa antes.
Aqui está o campo todo lado a lado.
| Modelo | Melhor motivo para trocar | Preço da API (entrada / cache / saída por 1M) | Pontuação AA / custo por tarefa | Contexto | Pesos | Meu teste |
|---|---|---|---|---|---|---|
| GPT-6.1 Sol (referência) | - | $2 / $0.10 / $10 | 47.8 / $0.21 (medium) | 1.05M | Fechados | 15/15, $1.80 por 1k |
| GPT-6 Luna | Grande volume simples | $0.10 / $0.01 / $0.50 | 29.5 / $0.018 (medium) | 1.05M | Fechados | 15/15, $0.11 por 1k |
| GPT-6 Sol | Precisa do esforço none | $2 / $0.20 / $10 | 39.8 / $0.25 (medium) | 1.05M | Fechados | 14/15, $1.72 por 1k |
| Claude Opus 5.5 | Teto mais alto | $4 / $0.20 / $20 | 57.6 / $5.98 (max) | 1M | Fechados | - |
| Claude Sonnet 5.5 | Segundo fornecedor, mesmo preço | $2 / $0.20 / $10 | 46.7 / $1.08 (high) | 1M | Fechados | - |
| GPT-6 Astra | Ultrafast hoje | $10 / $1 / $50 | 52.7 / $3.26 (max) | 1.05M | Fechados | 15/15, $9.09 por 1k |
| Gemini 3.8 Flash | Plano gratuito, stack do Google | $0.75 / $0.075 / $3.75 | 40.9 / $1.24 (high) | 1M | Fechados | 15/15, $1.04 por 1k |
| Grok 4.7 | Tarifa de saída mais barata | $2 / $0.50 / $6 | 46.4 / $3.74 (xhigh) | 500K | Fechados | - |
| DeepSeek V4.1 Flash | Pesos abertos, MIT | $0.15 / $0.003 / $0.60 (fora do pico) | 39.5 / $0.27 (max) | 1M | Abertos | - |
| Kimi K3 | Pesos abertos de ponta | $3 / $0.30 / $15 | 43.6 / $2.00 (max) | 1M | Abertos | - |
Por que você está deixando o GPT-6.1 Sol?
Escolha o motivo que melhor se encaixa em você.
none e permitem function calling no Chat Completions. O 6.1 Sol rejeita os dois. Planeje a migração para a Responses API mesmo assim, porque o GPT-6 Sol já foi substituído na tabela principal de preços.1. GPT-6 Luna: o que eu testaria primeiro para volume de suporte
Melhor para: trabalho de alto volume baseado em regras, como respostas de tickets, etiquetagem e roteamento, onde velocidade e custo importam mais que o raciocínio de ponta.
Este mudou meu próprio padrão. O GPT-6 Luna é o modelo GPT-6 mais barato da OpenAI, $0.10 de entrada e $0.50 de saída por milhão de tokens, e em esforço médio ele acertou 15 de 15 dos meus tickets de suporte. Ele consultou a ferramenta de pedidos e recusou a injeção de prompt. Na cobrança duplicada, citou a regra de 5 dias úteis em vez de prometer "hoje". Também respondeu em espanhol e alemão e depois calculou o reembolso proporcional de $990. A execução inteira saiu a $0.11 por 1.000 tickets, enquanto o 6.1 Sol em medium custou $1.80.
Nada do que testei foi mais rápido também: 3.0s por ticket em esforço médio e 2.3s em none. Sua página de modelo lista a mesma janela de contexto de 1.050.000 tokens do Sol, um corte de conhecimento em maio de 2026 e a faixa completa de esforço de none a max.
Onde o Luna fica aquém é no índice do Artificial Analysis, não no meu teste. O Luna pontua 29.5 em medium e 37.3 em max, contra 47.8 do 6.1 Sol em medium. Meus tickets eram curtos e a política era organizada, então essa diferença nunca teve chance de aparecer. Coloque o Luna em uma base de conhecimento mais bagunçada ou em uma tarefa de agente com vários passos e ela aparece.
Prós: cerca de 16 vezes mais barato que o 6.1 Sol por ticket no meu teste; respostas mais rápidas; mantém o esforço none e as chamadas de ferramenta do Chat Completions; mesma janela de contexto.
Contras: pontuação bem mais baixa em raciocínio difícil; em esforço none ele pulou a conta proporcional; pesos fechados, um fornecedor.
Preços: $0.10 de entrada, $0.01 em cache, $0.50 de saída por 1M de tokens; Batch e Flex com 50 % de desconto. Detalhamento completo em preços do GPT-6 Luna.
Minha opinião: para uma fila de suporte, comece com o Luna em esforço médio e mande para o 6.1 Sol tudo o que ele escalar. Assim a maior parte do seu volume fica em um modelo que custa quase nada, e você paga a tarifa do Sol só nos tickets que realmente precisam.
2. GPT-6 Sol: o que ainda faz none
Melhor para: equipes cujo código de produção depende do esforço none ou de function calling no Chat Completions, e que precisam de um modelo equivalente enquanto migram.
Para algumas equipes, a melhor alternativa ao 6.1 Sol é simplesmente o modelo que ele substituiu. O GPT-6 Sol saiu da tabela principal de preços, mas sua página de modelo continua no ar, ainda em $2/$10, e ainda diz "reasoning.effort supports none." Também diz "Chat Completions supports function calling only with reasoning_effort set to none", e essa é exatamente a combinação que o 6.1 Sol removeu. Quando olhei a página de descontinuações da OpenAI em 1º de outubro, não havia data de encerramento listada para o GPT-6 Sol.
No meu teste em esforço none, ele fez 14/15 a $1.72 por 1.000 tickets e 3.6s por ticket, um pouco mais rápido que o 6.1 Sol. A única falha foi a conta proporcional: ele disse "the policy doesn't specify how to count unused full months" e escalou. É uma falha segura em vez de uma resposta errada. Ainda assim, é um ticket a mais que uma pessoa precisa tocar.
Em qualidade, o 6.1 Sol vence. O Artificial Analysis dá ao GPT-6 Sol 39.8 por $0.25 a tarefa em medium, contra 47.8 por $0.21 do 6.1 Sol. A entrada em cache também custa o dobro, $0.20. Se quiser se aprofundar, a análise do GPT-6 Sol do meu colega cobre o assunto.
Prós: mantém o esforço none; o único modelo GPT-6 de $2/$10 com chamadas de ferramenta no Chat Completions; não exige mudança de código.
Contras: pontuações mais baixas que o 6.1 Sol em todos os esforços; entrada em cache custa o dobro; já substituído na tabela de preços, então trate como uma ponte.
Preços: $2 de entrada, $0.20 em cache, $10 de saída por 1M de tokens; prompts acima de 272K tokens de entrada cobram a requisição inteira a 2x de entrada e 1.5x de saída. Mais em preços do GPT-6 Sol.
Minha opinião: fique no GPT-6 Sol só pelo tempo que levar para mover suas chamadas de ferramenta para a Responses API. Para none no longo prazo, o Luna é a aposta mais segura. É o modelo barato atual, não o que foi substituído.
3. Claude Opus 5.5: um salto real no teto
Melhor para: programação difícil e tarefas longas de agente em que as respostas do 6.1 Sol são boas, mas não boas o bastante.
Saindo do 6.1 Sol porque quer um modelo mais inteligente? Então é no Claude Opus 5.5 que eu olharia. Ele pontua 57.6 em esforço máximo no Artificial Analysis, cerca de 6 pontos acima do melhor resultado do 6.1 Sol, e marca 66.4 % no Terminal-Bench 4.0 segundo o post de lançamento da Anthropic. Também é o primeiro Opus que ficou mais barato que o anterior, a $4/$20 por milhão.
A pegadinha, como sempre, é o custo por tarefa. Em esforço máximo, sai a $5.98 a tarefa, oito vezes os $0.72 do 6.1 Sol em max. O esforço médio é o melhor negócio: 51.2 por $1.34, que é a pontuação máxima do 6.1 Sol por cerca do dobro do dinheiro. A comparação GPT-6 Sol vs Opus 5.5 explica essa conta do esforço em detalhes.
A maioria dos relatos práticos que encontrei no HN fica do lado do Opus quando o código fica difícil:
"I've implemented multiple features side by side with Opus 5.5 and 6 Sol, and the Opus 5.5 results always have fewer high severity bugs and require fewer rounds of fixes to get it over the finish line."
Esse comentário compara o Opus ao GPT-6 Sol, não ao 6.1, e a mesma thread diz que o 6.1 fecha parte da diferença. Mesmo assim, bate com o que ouço dos engenheiros daqui.
Prós: maior pontuação desta lista; forte em benchmarks de terminal e programação; $0.20 para leituras de cache; 1M de contexto sem sobretaxa de contexto longo.
Contras: mais caro por tarefa em max; exagero para chat simples ou extração; mais um fornecedor para gerenciar.
Preços: $4 de entrada, $0.20 de leitura de cache, $20 de saída por 1M de tokens; Batch com 50 % de desconto, segundo a documentação de preços da Anthropic. Veja preços do Claude Opus 5.5.
Minha opinião: escolha o Opus 5.5 em esforço médio quando o 6.1 Sol continuar errando nas suas tarefas mais difíceis. Só não o deixe em max por padrão. Você acaba pagando por tokens de que nunca precisou.
4. Claude Sonnet 5.5: mesmo preço de tabela, outro fornecedor
Melhor para: equipes que querem um modelo de $2/$10 de um segundo laboratório, principalmente para programação e trabalho de agente.
O Claude Sonnet 5.5 foi lançado em 28 de setembro de 2026, um dia antes do 6.1 Sol, pelos mesmos $2 de entrada e $10 de saída. Pelos números da própria Anthropic, ele até supera o Opus 5.5 no Terminal-Bench 4.0 (70.6 % contra 66.4 %). No Artificial Analysis ele chega a 56.0 em esforço máximo, bem acima dos 51.8 do 6.1 Sol.
O custo por tarefa é onde você precisa prestar atenção. Em esforço máximo, o Sonnet 5.5 custa $7.60 a tarefa, mais que o Opus 5.5. Em esforço alto ele pontua 46.7 por $1.08, que é aproximadamente a pontuação do 6.1 Sol em medium por cinco vezes o custo. A própria Anthropic diz que a economia está no esforço baixo. A análise do Sonnet 5.5 do meu colega chegou à mesma conclusão.
Bots de suporte têm uma armadilha extra aqui. O Sonnet 5.5 retorna um 400 com tool_choice forçado (any ou uma ferramenta nomeada), então um bot que força uma consulta de pedido em todo ticket precisa ser reescrito. É o mesmo tipo de mudança incompatível que está afastando as pessoas do 6.1 Sol, só que em outro lugar.
Na thread do 6.1 Sol, alguns desenvolvedores acham que a Anthropic está à frente nesta rodada:
"I suspect they didn't show the benchmarks and test results because it would have been embarrassing to reveal that their flagship model can't compete with the capabilities of Sonnet 5.5."
Prós: mesmo preço de $2/$10 de um segundo fornecedor; pontuação máxima maior que o 6.1 Sol; muito forte em programação de terminal; 1M de contexto.
Contras: bem mais caro por tarefa com pontuações iguais; a escolha forçada de ferramenta agora retorna erro; o esforço máximo pode queimar quantidades enormes de tokens.
Preços: $2 de entrada, $0.20 de leitura de cache, $10 de saída por 1M de tokens; Batch $1/$5. Veja preços do Claude Sonnet 5.5.
Minha opinião: o Sonnet 5.5 é a jogada certa se você quer um segundo fornecedor para programação e vai manter o esforço em low ou medium. Se o seu caso é resposta de suporte em volume, o 6.1 Sol ou o Luna custarão menos por ticket.
5. GPT-6 Astra: só se você precisa de Ultrafast agora
Melhor para: equipes que já estão na OpenAI e precisam hoje do modo de geração mais rápido, ou do último ponto de pontuação.
O GPT-6 Astra é o carro-chefe da OpenAI. O problema é que o 6.1 Sol tornou difícil justificá-lo. O Artificial Analysis dá ao Astra 52.7 por $3.26 a tarefa, contra 51.8 por $0.72 do 6.1 Sol. No meu teste de suporte, o Astra igualou o 15/15 do 6.1 Sol a cinco vezes o custo, $9.09 por 1.000 tickets contra $1.80. Também foi mais lento, com 5.2s por ticket.
Neste mês há realmente um único motivo para escolhê-lo, e é o Ultrafast. A página de preços da OpenAI lista tarifas de Ultrafast apenas para o Astra, $60 de entrada e $300 de saída por milhão, com o 6.1 Sol "coming soon". Precisa dessa faixa de velocidade agora? O Astra é o único modelo GPT-6 que tem.
Prós: maior pontuação da OpenAI; Ultrafast disponível agora; menor taxa de alucinação da família GPT-6 no AA.
Contras: cerca de 4,5 vezes o custo por tarefa do 6.1 Sol por 1 ponto a mais; mais lento no meu teste; o Ultrafast é muito caro.
Preços: $10 de entrada, $1 em cache, $50 de saída por 1M de tokens; Batch e Flex com 50 % de desconto. Veja preços do GPT-6 Astra.
Minha opinião: para a maioria das equipes, o 6.1 Sol substituiu o Astra e não o contrário. Eu manteria o Astra para o trabalho raro em que um ponto extra importa, ou em que esperar o Ultrafast chegar ao Sol não é opção.
6. Gemini 3.8 Flash: a opção do Google com plano gratuito
Melhor para: equipes na stack do Google Cloud, protótipos no plano gratuito e trabalhos em lote em que o preço por token importa.
O Gemini 3.8 Flash passou no meu teste 15/15 em esforço baixo por $1.04 a cada 1.000 tickets, e acertou os $990 proporcionais mostrando o raciocínio. As respostas levaram em média 3.0s. Ele também usou mais formatação do que qualquer outro que testei. Uma resposta de status de pedido que precisava de duas linhas voltou com listas de marcadores e rótulos em negrito.
No preço, leia as letras miúdas. A página de preços do Gemini lista $0.75 de entrada e $3.75 de saída "through December 31, 2026", depois $1.50 e $7.50 a partir de 1º de janeiro de 2027. Compradores lembram desse tipo de dobra. Um comprador atento ao orçamento, em uma ligação de vendas da eesel, disse que o preço de um fornecedor anterior tinha "more than doubled" e pediu uma garantia contratual de preço antes de qualquer outra coisa.
No Artificial Analysis, o Gemini 3.8 Flash em esforço alto pontua 40.9 por $1.24 a tarefa, abaixo do 6.1 Sol e com seis vezes o seu custo por tarefa. Ele também não é um modelo base novo. O model card do Google diz que ele é baseado no Gemini 3.7 Flash.
Prós: plano gratuito; passou no meu teste com a conta correta; bom throughput; Batch e Flex com 50 % de desconto.
Contras: o preço dobra em 1º de janeiro de 2027; mais caro por tarefa que o 6.1 Sol no AA; respostas prolixas.
Preços: $0.75 de entrada, $0.075 de leitura de cache, $3.75 de saída por 1M de tokens até 31 de dezembro de 2026, depois $1.50/$0.15/$7.50. Veja preços do Gemini 3.8 Flash.
Minha opinião: se você já roda no Google Cloud, é um segundo fornecedor sensato. Calcule pela tarifa de 2027, não pela atual, para que a conta não surpreenda você em janeiro.
7. Grok 4.7: tarifa de saída mais barata, não tarefas mais baratas
Melhor para: loops de agente que ficam abaixo de 200K tokens por requisição e equipes que já constroem sobre a xAI.
O Grok 4.7 tem um preço que, à primeira vista, parece um matador do Sol: $2 de entrada e $6 de saída por milhão, 40 % abaixo da tarifa de saída do Sol, segundo a página de modelos da xAI. Ele é construído sobre um modelo base maior que o Grok 4.6, com um treinamento mais longo voltado a tarefas de agente de várias horas, e seu corte de conhecimento é maio de 2026.
O gráfico de custo por tarefa diz outra coisa. O Artificial Analysis dá ao Grok 4.7 em esforço xhigh 46.4 por $3.74 a tarefa, uma pontuação um pouco menor que o 6.1 Sol em medium por cerca de 18 vezes o custo. O motivo é simples: ele escreve muitos tokens. Fique de olho também nos preços de contexto longo: acima de 200K tokens de prompt, a tarifa salta para $4/$12 para cada token da requisição, não apenas para o excedente.
Prós: tarifa de saída menor que a do Sol; grandes ganhos de agente sobre o Grok 4.6; 500K de contexto; uma ferramenta gratuita, o Grok Build, para programar.
Contras: custo por tarefa muito maior que o 6.1 Sol no AA; precipício de contexto longo em 200K; o Grok 4.7 Fast só está no Cursor e no Grok Build, não na API pública.
Preços: $2 de entrada, $0.50 em cache, $6 de saída por 1M de tokens abaixo de 200K; $4/$1/$12 acima. Veja a análise do Grok 4.7 para notas práticas.
Minha opinião: o Grok 4.7 faz sentido se você já vive nas ferramentas da xAI. Mas se a tarifa de saída menor é o seu único motivo, faça primeiro seu próprio teste de custo por tarefa. No índice, ele cai no sentido oposto.
8. DeepSeek V4.1 Flash: pesos abertos e uma conta minúscula
Melhor para: equipes que precisam de pesos com licença MIT para hospedar por conta própria, ou do menor preço de API para trabalho em segundo plano.
O DeepSeek V4.1 Flash é o modelo capaz mais barato desta lista e o mais fácil de ter por completo. Os pesos estão no Hugging Face sob MIT. A API usa o nome de modelo deepseek-flash, e o nome antigo deepseek-v4-flash agora redireciona para o V4.1. Ele suporta visão, chamadas de ferramenta, uma janela de contexto de 1M e até 384K tokens de saída, segundo a página de preços da DeepSeek.
Há uma peculiaridade de fuso horário no preço. Fora do pico são $0.15 de entrada e $0.60 de saída por milhão; no pico, exatamente o dobro. O horário de pico é de 01:00 a 04:00 e de 06:00 a 10:00 UTC em dias úteis, então uma fila de suporte dos EUA fatura em sua maior parte a tarifa fora do pico, e uma fila em horário asiático em sua maior parte não.
Por tarefa, ele fica mais perto do 6.1 Sol do que o preço de tabela sugere. O Artificial Analysis dá ao V4.1 Flash em esforço máximo 39.5 por $0.27 a tarefa, contra 47.8 por $0.21 do 6.1 Sol em medium. Se há dados de clientes envolvidos, verifique também onde ele roda: a API própria da DeepSeek é hospedada na China e seus termos de API não dizem nada sobre uso para treinamento, então muitas equipes hospedam por conta própria ou usam um host de terceiros com acordo de dados.
Prós: pesos abertos MIT; menor preço de API por token daqui; agora aceita imagens; 1M de contexto.
Contras: pontuação menor que o 6.1 Sol e custo por tarefa um pouco maior; preço de horário de pico; a hospedagem própria do fornecedor é difícil de justificar para dados de clientes.
Preços: $0.003 acerto de cache, $0.15 de entrada, $0.60 de saída por 1M de tokens fora do pico; o dobro no pico. Veja preços do DeepSeek V4.1 Flash.
Minha opinião: escolha o V4.1 Flash para hospedar por conta própria ou para trabalho em lote noturno. Como substituto direto do 6.1 Sol em um bot interativo, porém, ele não vai economizar dinheiro por tarefa.
9. Kimi K3: pesos abertos de ponta
Melhor para: equipes que precisam do modelo de pesos abertos mais forte que possam baixar e rodar.
O Kimi K3, da Moonshot AI, é um modelo de mistura de especialistas de 2,8 trilhões de parâmetros com 104B ativos, janela de contexto de 1M e visão nativa. Os pesos completos estão no Hugging Face sob uma licença própria, então você pode rodá-lo por conta própria, supondo que tenha o hardware.
Na API hospedada, custa $3 de entrada, $0.30 em cache e $15 de saída por milhão, segundo a página de preços do Kimi. Isso é mais que o Sol tanto na entrada quanto na saída. O Artificial Analysis dá 43.6 em esforço máximo por $2.00 a tarefa. O raciocínio não pode ser desligado em nenhum nível, o que faz da configuração mais baixa mais um controle de velocidade do que um nível mais barato.
Prós: os pesos abertos para download mais fortes desta lista; 1M de contexto; entrada de imagem e vídeo.
Contras: a API hospedada custa mais que o 6.1 Sol por token e por tarefa; licença própria, não MIT nem Apache; raciocínio sempre ligado.
Preços: $3 de entrada, $0.30 acerto de cache, $15 de saída por 1M de tokens. Veja preços do Kimi K3.
Minha opinião: o Kimi K3 é uma escolha para hospedar por conta própria. Se você só quer uma API hospedada, o 6.1 Sol é mais barato e pontua mais alto.
O que meu teste diz sobre trocar de modelo no suporte
Esta é a parte a que sempre volto. Em 135 execuções e nove configurações, de $0.09 a $9.09 por 1.000 tickets, as falhas foram do mesmo tipo todas as vezes. Toda configuração, o Astra inclusive, escalou o ID de pedido com erro de digitação ("A1O43") em vez de pedir ao cliente que o conferisse. As execuções com none desistiram de contas que poderiam ter feito. Subir de nível não resolveu nada disso. O que resolve (ou teria resolvido) é uma linha nas instruções, mais testes com tickets reais.
Isso bate com o que ouço dos compradores. Um líder de CX com cerca de 7.000 tickets por mês disse à equipe da eesel em uma ligação de vendas que a IA só deveria responder tickets de que tenha confiança e deixar discretamente o resto para as pessoas. Isso é uma regra de repasse, não um recurso do modelo. Você define essa regra na camada ao redor do modelo e depois a confere contra seu próprio histórico antes que qualquer cliente a veja.
Então, se você está trocando o 6.1 Sol pelo Luna para economizar em uma fila de suporte, acho uma decisão inteligente. Teste antes com seus tickets antigos, porém, e mantenha um caminho claro para uma pessoa em tudo de que ele não tiver certeza. O guia de escalonamento com IA explica como configurar isso.
Experimente a eesel

Se você compara alternativas ao GPT-6.1 Sol porque quer automatizar o suporte, o modelo é o motor, e a eesel é o colega que você contrata para dirigi-lo. O agente de helpdesk com IA entra na sua fila existente no Zendesk, Freshdesk ou Gorgias, aprende com sua central de ajuda e tickets antigos, e roda uma simulação sobre seu histórico de tickets para que você veja as respostas e a taxa de resolução antes que ele responda a qualquer pessoa. Aquela falha do ID com erro de digitação do meu teste? É exatamente o tipo de lacuna que a simulação pega.
Se você trabalha em um terminal, a CLI da eesel controla o mesmo colega e o mesmo workspace do painel. Você pode automatizar um teste com um lote de tickets antigos, levar os resultados para suas próprias ferramentas ou deixar um agente de programação como Claude Code, Codex ou Cursor gerenciar a configuração para você. É o mesmo colega nos dois casos, só que sem interface. Você pode experimentar a eesel grátis e rodá-la com seus próprios tickets antes de escolher um modelo ou um plano.
Perguntas frequentes
Qual é a melhor alternativa ao GPT-6.1 Sol em 2026?
Existe uma alternativa mais barata ao GPT-6.1 Sol?
Por que o GPT-6.1 Sol removeu o esforço de raciocínio none?
none retorna erro. O GPT-6 Sol e o GPT-6 Luna ainda aceitam none e são os únicos modelos GPT-6 que permitem function calling no Chat Completions. Minha análise do GPT-6.1 Sol cobre as mudanças na API.O GPT-6.1 Sol é melhor que o Claude Sonnet 5.5?
Qual é uma boa alternativa de pesos abertos ao GPT-6.1 Sol?
Devo trocar do GPT-6.1 Sol para o GPT-6 Astra?
As alternativas ao GPT-6.1 Sol funcionam para atendimento ao cliente?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.