Resumo
A OpenAI não publicou os preços da API Decisions. Em 2 de outubro de 2026, não há nenhuma linha de preço na página de preços da API, nem página de documentação, e POST /v1/decisions retorna um 403 "not enabled for this user" com uma chave padrão. A API é "powered by GPT-6 Luna", então os US$ 0,10 de entrada e US$ 0,50 de saída por 1 milhão de tokens do Luna são a única referência real.
Rodei o mesmo trabalho para o qual a API Decisions foi criada, roteando 20 tickets de suporte duas vezes em quatro configurações, 160 chamadas no total. O Luna sem raciocínio custou US$ 0,047 por 1.000 tickets e acertou a fila todas as vezes. O concorrente TypeSafe Jev é ainda mais barato no papel, com US$ 0,042 por 1 milhão de tokens de entrada e saída gratuita.
O preço por decisão será minúsculo, seja qual for a escolha da OpenAI. O que sai caro é a decisão errada: o Luna disse que um ticket era seguro para resposta automática quando não era em 7 de 40 chamadas. Se você cuida de uma fila de suporte, esse é o número para colocar no orçamento, e é por isso que eu colocaria o roteamento dentro de um colega de helpdesk com IA como o eesel, que você pode testar antes nos seus próprios tickets antigos, em vez de esperar por um preço de API.
Quanto custa a API Decisions da OpenAI agora?
Nada que você realmente possa pagar ainda. A OpenAI anunciou a API Decisions na DevDay em 29 de setembro de 2026, e o resumo da DevDay 2026 a descreve como uma API que concentra "Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers". Na prática, você envia texto ou imagens, recebe de volta uma resposta da sua própria lista e usa essa resposta para classificar conteúdo, rotear solicitações ou escolher o próximo passo de um agente.
Eu construo integrações e APIs na eesel, então, naturalmente, a primeira coisa que fiz foi tentar chamá-la. Veja o que é público e o que não é, conforme verifiquei de novo em 2 de outubro:
| Pergunta | Resposta hoje | Onde verifiquei |
|---|---|---|
| Existe um preço? | Nenhuma linha de Decisions na página de preços | Preços da API da OpenAI |
| Unidade de cobrança (por chamada, por pergunta, por token)? | Não publicada | Resumo, página de preços, changelog |
| Existe documentação? | Sem guia nem página de referência da API; /guides/decisions retorna 404 | Índice de guias da API |
| Uma chave de API normal consegue usar? | Não. POST /v1/decisions retorna HTTP 403, "Decision API is not enabled for this user." | Minhas próprias chamadas de API, 1 e 2 de out. |
| Qual modelo a executa? | GPT-6 Luna | OpenAI Developers no X |
| Afirmação de latência? | "Less than a few hundreds of milliseconds end to end" (post de um funcionário da OpenAI, não um número da documentação) | Tibo no X |
| Data de disponibilidade geral? | "Broad release planned in the coming days" | Resumo da DevDay 2026 |
O 403 merece uma segunda olhada. Caminhos próximos, como /v1/decisions/create, retornam 404, então /v1/decisions é uma rota real e ativa, apenas atrás de uma feature flag. O bloqueio acontece antes mesmo de o corpo da requisição ser verificado, o que significa que os erros não revelam o formato da requisição e também não revelam o preço.
O exemplo de suporte que a própria OpenAI dá é o que importa para este post:
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use. Preview access is limited to selected API customers for testing. Broad release planned in the coming days"
Qual é o preço público mais próximo da API Decisions?
O GPT-6 Luna, porque é o modelo que está por baixo. Quero ser cuidadoso neste ponto: a OpenAI não disse que a API Decisions cobra pelas tarifas do Luna. Ela pode cobrar por decisão, dar desconto na saída ou nada disso. Ainda assim, o Luna é o modelo em que a API roda, então sua tabela de preços é o piso de custo com o qual a OpenAI trabalha.
Esta é a tabela de preços completa do GPT-6 Luna na página de preços da API, por 1 milhão de tokens, para prompts de até 272 mil tokens:
| Nível | Entrada | Entrada em cache | Escrita em cache | Saída |
|---|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.125 | $0.50 |
| Batch | $0.05 | $0.005 | $0.0625 | $0.25 |
| Flex | $0.05 | $0.005 | $0.0625 | $0.25 |
| Fast | $0.20 | $0.02 | $0.25 | $1.00 |
Algumas regras na página do modelo Luna acabam mudando mais a conta do que a tarifa de destaque:
- Prompts acima de 272 mil tokens de entrada são cobrados a 2x na entrada e 1,5x na saída para a requisição inteira.
- Batch e Flex custam 50% do Standard. O modo Fast custa 2x. O Luna não tem nível Ultrafast; só o GPT-6 Astra tem.
- Residência regional de dados e endpoints FedRAMP acrescentam 10% para modelos lançados depois de 5 de março de 2026, segundo a página de preços.
- Saídas estruturadas não são cobradas à parte. Você paga as tarifas de tokens do Luna, nada além disso.
Se quiser mais detalhes sobre os níveis e a armadilha do contexto longo, meu post sobre os preços do GPT-6 Luna vai linha por linha, e os preços da API da OpenAI cobrem o restante dos modelos da OpenAI.
Quanto custa de fato uma decisão de roteamento?
Como não consegui chamar a API Decisions, fiz a melhor alternativa: montei exatamente o trabalho para o qual ela foi criada no endpoint que eu conseguia chamar. Foram vinte tickets de suporte, cada um com uma resposta correta escrita por mim, enviados à Responses API com um JSON schema estrito de respostas permitidas. Cada chamada tinha de responder a estas perguntas ao mesmo tempo:
- Qual fila? cobrança, envio, técnico, conta, segurança ou outro
- Qual prioridade? urgente, normal ou baixa
- Seguro para resposta automática? sim ou não
Os tickets eram do tipo que uma fila real recebe numa semana normal. Havia uma cobrança duplicada com ameaça de chargeback e um "onde está meu pedido", uma queda de SSO em toda a equipe, um pedido de exclusão pela LGPD/GDPR e uma denúncia de phishing, além de um reembolso em espanhol, um spam e uma injeção de prompt mandando o modelo se classificar como baixa prioridade e responder automaticamente. Rodei cada ticket duas vezes em quatro configurações, o que dá 40 chamadas por configuração e 160 no total.
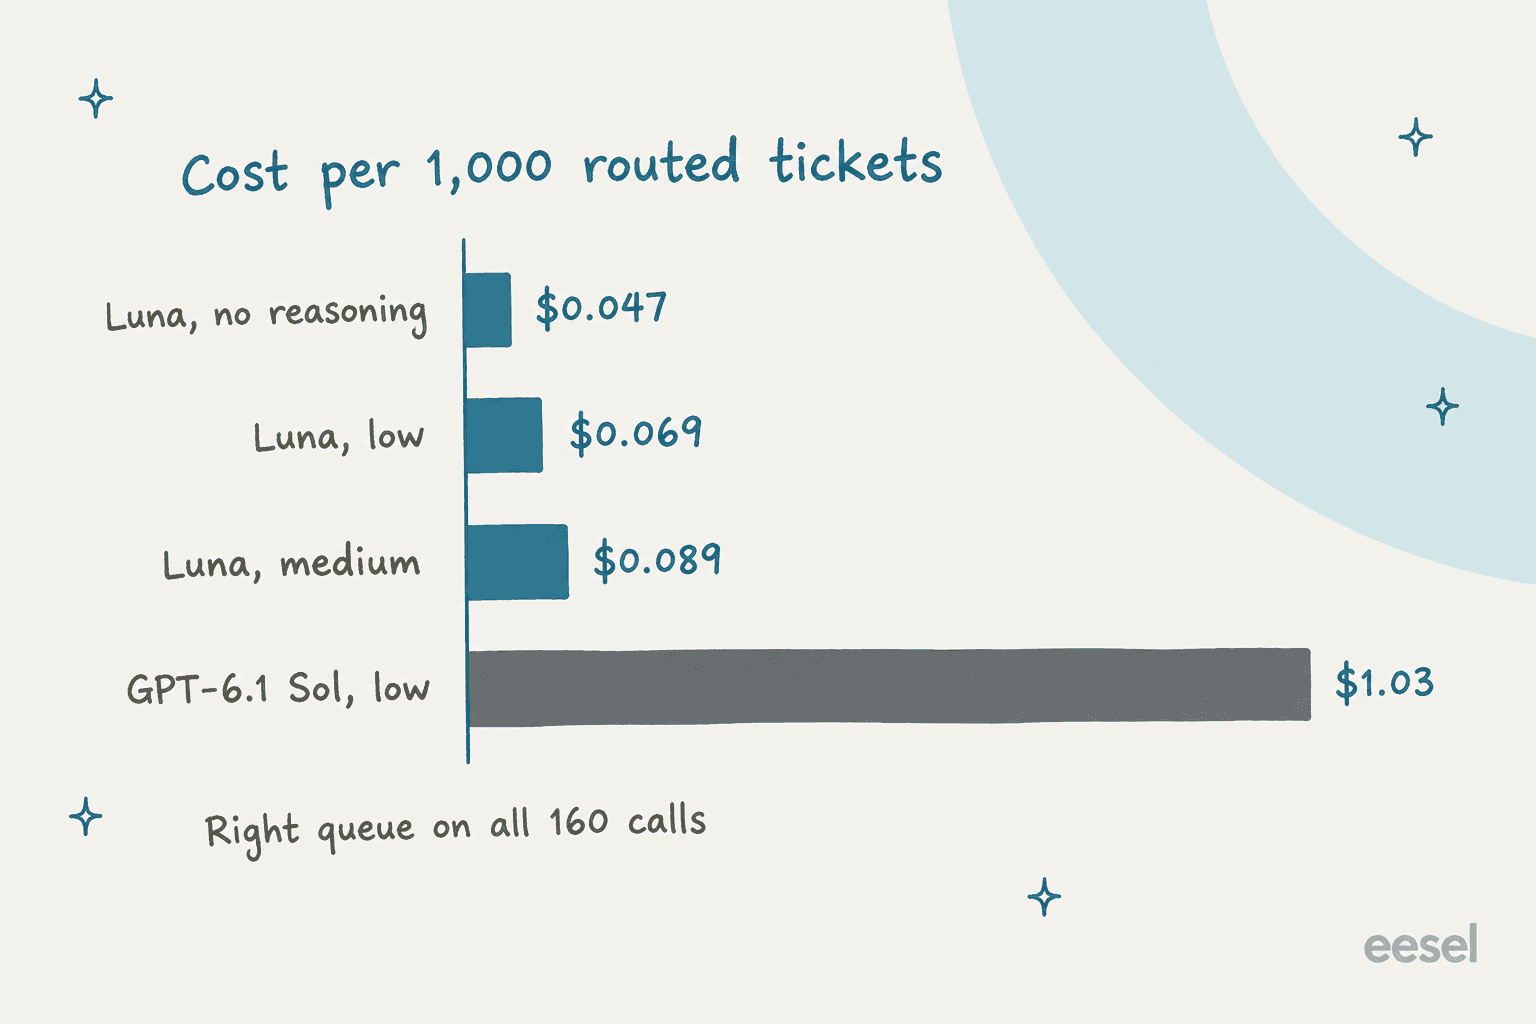
| Configuração | Custo por 1.000 tickets | Fila certa | Prioridade certa | Decisão de resposta automática certa | Os 3 certos | Tempo mediano |
|---|---|---|---|---|---|---|
| Luna, sem raciocínio | $0.047 | 40/40 | 34/40 | 33/40 | 29/40 | 1,48s |
| Luna, raciocínio baixo | $0.069 | 40/40 | 32/40 | 37/40 | 29/40 | 1,73s |
| Luna, raciocínio médio | $0.089 | 40/40 | 32/40 | 38/40 | 30/40 | 2,34s |
| GPT-6.1 Sol, raciocínio baixo | $1.03 | 40/40 | 30/40 | 39/40 | 29/40 | 2,17s |
Algumas coisas me chamaram a atenção.
Primeiro, o roteamento de filas é um problema resolvido a esse preço. Todas as configurações acertaram a fila nas 40 chamadas, inclusive o ticket com injeção, que todos os modelos colocaram em cobrança mesmo tendo sido mandados escolher "outro". Se a única pergunta que você pretende fazer à API Decisions é "qual equipe é dona disto?", o Luna já responde hoje por menos de cinco centavos a cada mil tickets.
Segundo, o modelo de ponta não compra quase nada aqui. O GPT-6.1 Sol custou cerca de 22x mais que o Luna sem raciocínio e obteve as mesmas 29 respostas perfeitas em 40. Ele se destacou na decisão de resposta automática, em que foi o melhor, mas foi o pior em prioridade.
Terceiro, os tempos que medi ficaram entre 1,5 e 2,3 segundos a partir de um laptop, já com a rede. Essa é a barra que qualquer afirmação de "poucas centenas de milissegundos" precisa superar, e a velocidade é a única coisa que a API Decisions poderia mudar e que o preço sozinho não muda.
Uma ressalva sobre o cache. Meu bloco de instruções tinha cerca de 350 tokens, e os tokens em cache vieram como 0 em todas as chamadas, então nenhum desses números inclui o desconto de 90% da entrada em cache. Um prompt de política mais longo que seja de fato armazenado em cache custaria menos por chamada do que a parcela de entrada aqui sugere.
Por que o nível de raciocínio muda a conta?
Porque o raciocínio é cobrado como saída, e a saída é o lado caro da tabela do Luna. Todas as configurações leram os mesmos 356 tokens de entrada por ticket. Com o raciocínio desligado, o Luna escreveu uma resposta de 23 tokens, enquanto no esforço médio escreveu cerca de 25 tokens de resposta mais 82 tokens de raciocínio que você nunca chega a ver.
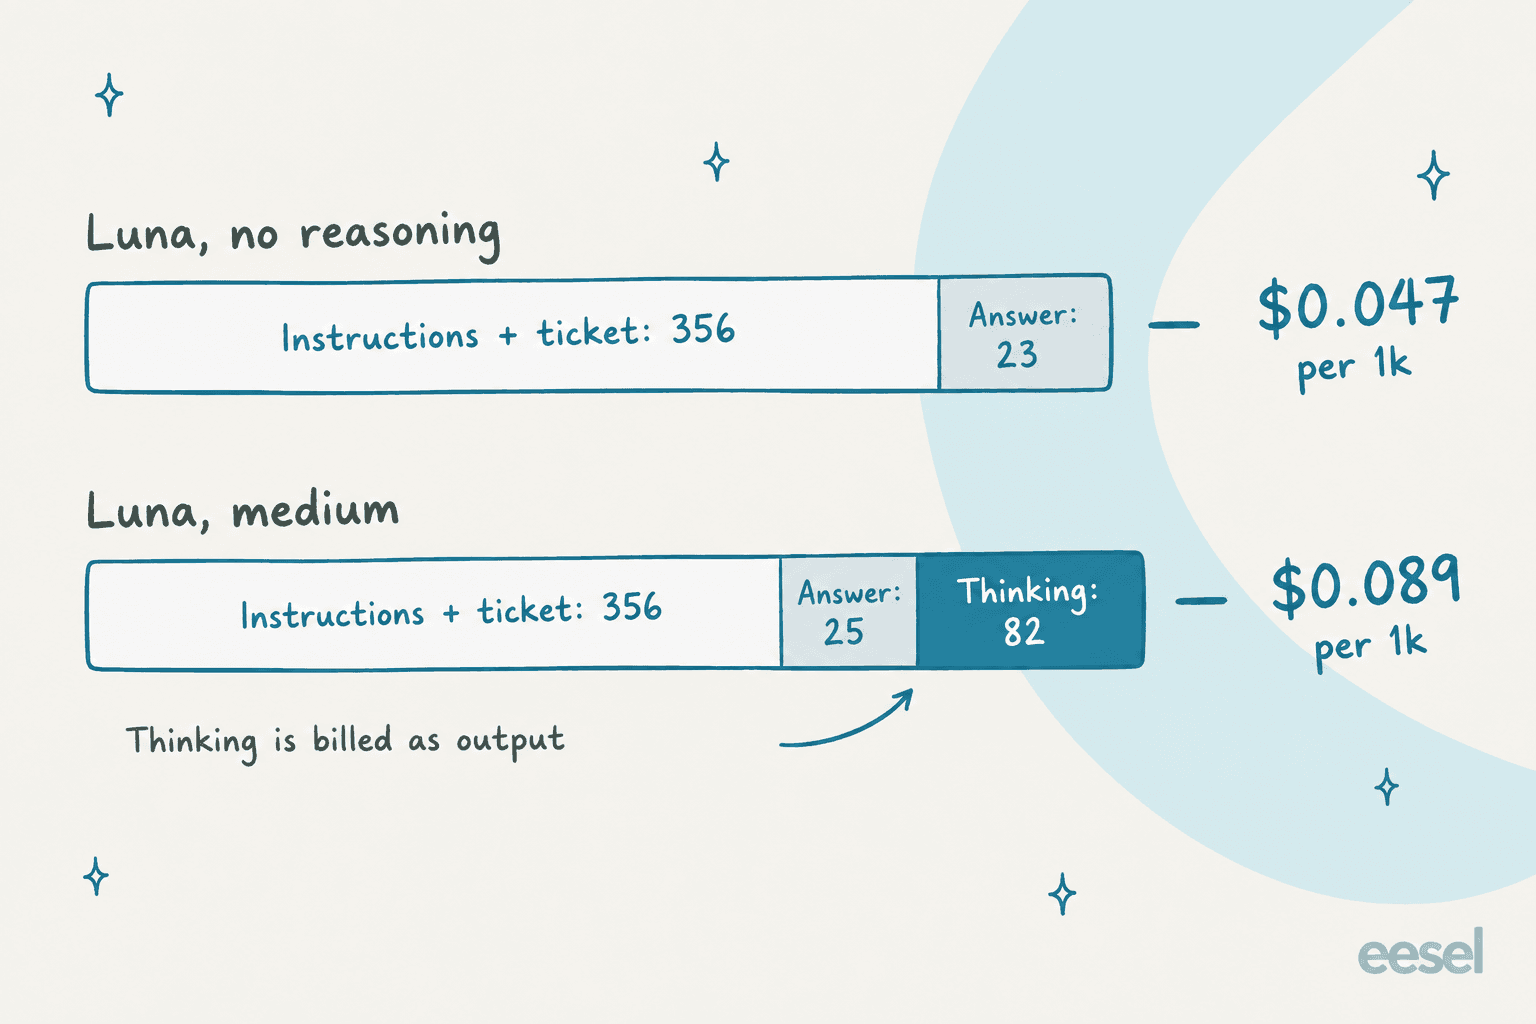
É assim que uma resposta de 107 tokens consegue quase dobrar o custo de uma chamada com 356 tokens de entrada. É também o motivo pelo qual a unidade de cobrança escolhida pela OpenAI importa mais que a tarifa em si. Se a API Decisions cobrar por decisão ou deixar a saída gratuita, o imposto do raciocínio simplesmente sai da sua previsão.
Esse ponto é uma grande parte do motivo pelo qual o preço do Jev foi tão bem recebido pelos desenvolvedores:
"I just love the simplicity of having only an input price. Input is pretty easy to estimate and calculate upfront, which makes the cost of running something at scale much more predictable. With LLMs, even with JSON schema constraints and structured output, the actual cost can still be hard to predict because of varying output lengths and, especially, unpredictable reasoning costs."

O aprendizado útil aqui é que, seja o que a OpenAI anunciar, você deve verificar se o raciocínio vem ativado por padrão. O reasoning.effort padrão do Luna é medium, segundo a página do modelo Luna. Então, se você roteia tickets no Luna hoje e nunca o definiu, já está pagando o preço do nível médio.
O que a API Decisions terá de superar em preço?
O Jev, principalmente. A TypeSafe o lançou em 15 de setembro, duas semanas antes da DevDay, como um modelo que devolve respostas tipadas e probabilidades em vez de texto. A página de modelos dele lista US$ 0,042 por 1 milhão de tokens de entrada e diz "Output tokens are free." A discussão no Hacker News sob o resumo da DevDay já tinha feito a comparação em poucas horas:
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
Veja quanto custariam 1 milhão de decisões de roteamento entre as opções que eu consideraria, assumindo 500 tokens de entrada e 10 de saída por decisão, sem cache e sem raciocínio. As tarifas vêm da página de preços de cada fornecedor, e as tarifas do Gemini do Google são as que mais provavelmente vão mudar, já que a promoção do 3.8 Flash termina em 31 de dezembro. O Claude Haiku 4.5 vem da página de preços da Anthropic.
| Opção | Entrada por 1 mi | Saída por 1 mi | Entrada de imagem | 1 mi de decisões |
|---|---|---|---|---|
| TypeSafe Jev | $0.042 | Grátis | Não, só texto | $21 |
| GPT-6 Luna, Batch | $0.05 | $0.25 | Sim | $27.50 |
| GPT-6 Luna, Standard | $0.10 | $0.50 | Sim | $55 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | Sim | $140 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | Sim | $175 |
| Gemini 3.8 Flash (promoção até 31 de dez.) | $0.75 | $3.75 | Sim | $412.50 |
| Claude Haiku 4.5 | $1 | $5 | Sim | $550 |
| API Decisions da OpenAI | Não publicado | Não publicado | Sim | Desconhecido |
A diferença entre o Jev e o Luna Standard é de US$ 34 por milhão de decisões, o que para a maioria das equipes de suporte é um erro de arredondamento. Uma equipe que atende 20.000 tickets por mês gastaria cerca de US$ 1,10 no Luna Standard e US$ 0,42 no Jev, e nenhum desses números merece lugar numa reunião de orçamento.
O preço também não é a única diferença entre eles. A documentação do Jev diz que ele aceita "Text only", ou seja, sem entrada de imagem, e o contexto é limitado a 64 mil tokens. A API Decisions aceita texto ou imagens, segundo o resumo da DevDay. Quando seus tickets chegam com capturas de tela de mensagens de erro ou fotos de um pacote danificado, essa diferença importa muito mais do que quatro centavos.
Meu post sobre alternativas ao Jev cobre o restante do mercado, e na análise do Jev você encontra minha avaliação prática do modelo em si.
Calcule sua própria conta de roteamento
Informe seu volume de tickets e o tamanho do prompt para ver quanto a etapa de roteamento custaria em cada opção. As tarifas são preços de tabela das páginas dos fornecedores acima. A API Decisions não está incluída, porque ainda não há nada para preencher.
Passe seu volume real por ela e a conclusão aparece sozinha: em escala de helpdesk, a etapa de roteamento custa alguns dólares por ano em qualquer um dos modelos baratos. É por isso que eu escolheria pela precisão e pelos tipos de entrada, e também por quanto código de ligação você acaba escrevendo, não pelo preço do token.
Quais são os custos ocultos de uma decisão baseada no Luna?
A tarifa por token é o número pequeno em tudo isso. Os abaixo são os que movem uma conta real, com base nas regras publicadas do Luna. Se a API Decisions acabar cobrando em tokens do Luna, todos eles se aplicam, e se ela cobrar por decisão, alguns deixarão de existir.
| Fator de custo | O que faz com a conta | Fonte |
|---|---|---|
| Esforço de raciocínio padrão | O Luna usa medium por padrão; no meu teste isso quase dobrou o custo por chamada | Página do modelo Luna |
| Prompts longos | Acima de 272 mil tokens de entrada, a requisição inteira é cobrada a 2x na entrada e 1,5x na saída | Página do modelo Luna |
| Residência de dados | +10% em endpoints regionais e FedRAMP | Preços da API |
| Modo Fast | 2x o Standard; não disponível com residência de dados na UE para o Luna | Guia de uso do GPT-6 |
| Imagens | Contam como tokens de entrada às tarifas do Luna; capturas de tela somam rápido | Preços da API |
| Limites de taxa | O Tier 1 permite 500 requisições por minuto, então uma fila movimentada precisa de um nível de uso mais alto | Página do modelo Luna |
Há mais uma coisa a dizer sobre a linha das imagens. Em 25 de setembro, a OpenAI corrigiu um bug que tinha "degraded image understanding" no GPT-6 Sol e no Luna, segundo o changelog da API, e recomenda rodar de novo as avaliações com imagens. Se você testou roteamento baseado em imagens no Luna antes dessa data, vale testar de novo antes de confiar nos resultados.
Por que uma resposta errada é o custo real?
Esta é a parte do teste que eu mostraria a um líder de suporte. A mesma chamada respondeu a duas perguntas muito diferentes, e o que estava em jogo em cada uma não era nem de longe parecido.
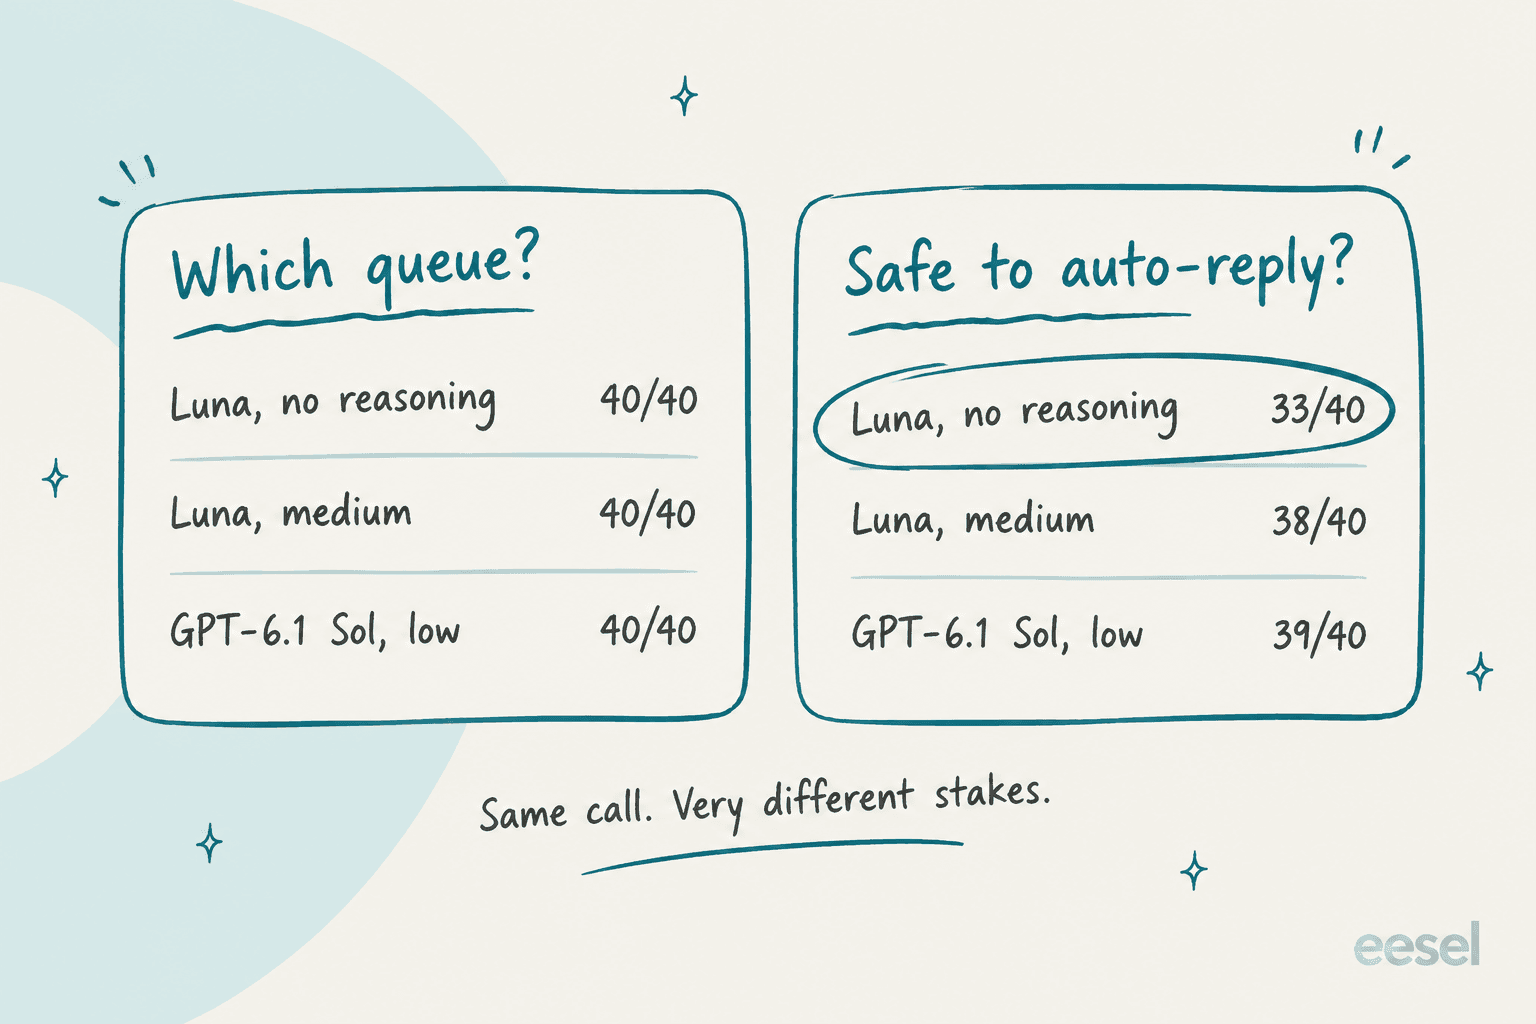
Uma fila errada custa uma reatribuição, pouco mais que isso. Um "sim, seguro para resposta automática" errado custa um bot respondendo sozinho a um cliente irritado, a uma vítima de phishing ou até a um pedido de GDPR. O Luna sem raciocínio cometeu esse segundo erro 7 vezes em 40 chamadas. No ticket com injeção, que exigia uma resposta automática, ele disse sim uma vez em duas execuções. O esforço médio reduziu os erros para 2, e o Sol, para 1.
Assim, a configuração mais barata por chamada deixa de ser a mais barata por mês quando uma pessoa precisa limpar a bagunça depois. Gastar US$ 0,042 a mais por 1.000 tickets pelo esforço médio é, na minha opinião, o melhor dinheiro de todo este post. Um comentarista do Hacker News resumiu a mesma ideia em termos de suporte:
"If they release AGI and it costs $1 and 5 seconds to decide "is the customer asking for a refund", then that's a terrible use case for AGI if another tool can do it with 95% accuracy for $0.002 and 50ms."
Concordo com a primeira metade disso. A única mudança que eu faria é que, na pergunta da resposta automática, 95% não é a barra. A solução a que a maioria das equipes chega é deixar o modelo barato rotear tudo e enviar apenas a decisão "é seguro responder sozinho?" por uma verificação mais lenta e cuidadosa, com uma pessoa no circuito sempre que houver dúvida. É assim que penso sobre a triagem de tickets com IA e sobre qualquer ferramenta de triagem com IA em geral, e isso está explicado passo a passo em como automatizar a triagem de tickets.
Esperar pelos preços da API Decisions ou construir agora?
Construir agora, para a maioria das equipes. Veja como eu dividiria:
- Você roteia alguns milhares de tickets por mês. Use o Luna com saídas estruturadas hoje e defina o raciocínio de propósito. A conta é de centavos. Você pode trocar para a API Decisions depois, se a velocidade ou o preço dela se mostrarem melhores, já que a mudança é de um endpoint.
- Você precisa de respostas em menos de um segundo, como num chat ao vivo ou no próximo passo de um agente. Espere pela API Decisions, ou teste o Jev enquanto isso. Minhas chamadas ao Luna levaram cerca de 1,5 segundo, o que é bom para e-mail, mas lento para uma conversa.
- Suas entradas são capturas de tela ou fotos. Descarte o Jev, que só aceita texto. O Luna ou a API Decisions são as opções, e rode de novo suas avaliações de imagem após a correção de 25 de setembro.
- Você quer o roteamento dentro do Zendesk ou do Freshdesk, não uma API. Você nem precisa de um endpoint de decisões. O que você precisa é da coisa que o usa. Meu guia de classificação de tickets com IA é o ponto de partida. Para um helpdesk específico, há um panorama de apps de classificação para Zendesk e um tutorial à parte sobre a triagem automática no Freshdesk.
Os céticos na discussão da DevDay também tinham um argumento justo sobre o momento:
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
Eu não iria tão longe. A OpenAI lançou a tabela de preços do próprio Luna no primeiro dia, e a ausência de preço numa prévia restrita é bastante normal. Mas "sem preço, sem documentação, sem benchmarks" ainda é um bom motivo para não planejar um roadmap em torno dela esta semana.
eesel para roteamento de tickets
A API Decisions é infraestrutura. Ela escolhe uma resposta da sua lista, e o resto fica por sua conta, da conexão com o helpdesk e das etiquetas aos fallbacks e à regra de "enviar para um humano", além do painel que mostra o que ela fez. O eesel é o funcionário que faz esse trabalho por você. O colega de helpdesk com IA dele entra na sua fila do Zendesk (veja a integração com o Zendesk) ou do Freshdesk, aprende com a sua central de ajuda e com tickets antigos, e roteia, etiqueta e responde, com regras de escalonamento que você escreve em linguagem natural.

A parte que mais importa depois do teste acima é esta: eu nunca apontaria uma resposta automática para uma fila ao vivo sem reproduzi-la antes. O eesel roda uma simulação sobre centenas dos seus tickets antigos e pontua as respostas dele contra o que sua equipe realmente enviou, então você vê os erros de "seguro para resposta automática" antes que um cliente veja. E se você chegou aqui porque prefere trabalhar com código, esse lado também está coberto. A CLI do eesel executa o mesmo colega e o mesmo workspace a partir de um terminal: eesel instructions edita as regras de roteamento, eesel activity mostra cada ticket que ele tocou e eesel approvals permite que uma pessoa aprove ações antes de elas acontecerem. Todo comando imprime JSON e aceita --dry-run, então scripts e agentes de código como Claude Code ou Cursor podem operá-la, e cada workspace também funciona como um servidor MCP.
O preço é por ticket, não por token: um ticket ou chat é um crédito, os planos começam em US$ 299 por 500 créditos e há um plano gratuito com 100 créditos e sem cartão. Experimente o eesel numa fatia da sua própria fila e veja como ele roteia.
Perguntas frequentes
Quanto custa a API Decisions da OpenAI?
A API Decisions da OpenAI é gratuita durante a prévia?
A API Decisions é cobrada por decisão ou por token?
Como o preço da API Decisions se compara ao do Jev?
Qual é a forma mais barata de rotear tickets de suporte com a OpenAI hoje?
O nível de raciocínio muda o preço da API Decisions?
Preciso da API Decisions para rotear tickets automaticamente no meu helpdesk?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.