Resumo
O Bedrock Managed Agents (BMA) cobra $0 pelo serviço em si durante a prévia pública, aberta em 29 de setembro de 2026. O que você realmente paga são três coisas: tokens de modelos da OpenAI na tarifa in-Region do Bedrock (10% acima dos preços da própria OpenAI), CPU e memória do AgentCore Runtime se você o usar, e cerca de $33 por mês pelo NAT gateway da pilha de exemplo da AWS, que é cobrado mesmo quando nada está rodando.
Em uma tarefa típica de 10 minutos (200K tokens de entrada, 20K de saída) com o GPT-5.6 Luna no AgentCore, chego a cerca de $0.09 por tarefa. Trocando para o GPT-5.6 Sol, a mesma tarefa custa cerca de $1.34. Ou seja, o modelo escolhido move a conta em aproximadamente 15 vezes, enquanto o acréscimo da AWS nessa tarefa com Luna é de cerca de meio centavo. E a AWS diz que o preço "is subject to change" na GA.
Minha opinião: o preço do BMA é justo para equipes que precisam manter agentes da OpenAI dentro da AWS. Só oriente o orçamento pelo modelo, não pela manchete de $0. Se o agente que você está precificando é de suporte, a eesel é a opção pronta: um plano mensal fixo de créditos, com a integração ao helpdesk e os testes com o histórico de tickets já feitos.
Quanto custa o Bedrock Managed Agents?
A linha de preços da AWS para a prévia é uma frase só: "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New).
Dois anos de SEO me ensinaram uma coisa sobre buscas de preço: a palavra "grátis" leva mais gente a uma conclusão errada do que qualquer outra. Quem pesquisa "bedrock managed agents pricing" quer o número que o financeiro vai ver, e esse número nunca é $0. A documentação para desenvolvedores detalha o que os "recursos subjacentes" cobrem: "You incur charges for model inference and the AWS resources that your application uses," e o exemplo do AgentCore "can continue to incur charges when no BMA turn is running" (AWS docs).
Se o serviço é novidade para você, meu guia do Bedrock Managed Agents explica como sessões, exec server e ambientes de execução se encaixam. Este artigo trata só da fatura.
Aqui está cada linha que pode aparecer, em uma tabela:
| Item de custo | Preço na prévia | Unidade cobrada | Quando se aplica |
|---|---|---|---|
| Tarifa do serviço BMA | $0 | n/a | Sempre (sujeito a mudança na GA) |
| Tokens de modelos da OpenAI | Tarifa in-Region, ex.: $0.22 entrada / $1.32 saída para o GPT-5.6 Luna | Por 1M de tokens de entrada, em cache e de saída | Em cada turno |
| CPU do AgentCore Runtime v2 | $0.1276 por vCPU-hora | Por segundo, apenas CPU ativa | Se o AgentCore for seu ambiente de execução |
| Memória do AgentCore Runtime v2 | $0.0169 por GB-hora | Por segundo, memória ociosa recuperada após 120 segundos | Se o AgentCore for seu ambiente de execução |
| NAT gateway | $0.045 por hora + $0.045 por GB | Por hora (horas parciais são cobradas como inteiras) | Pilha de exemplo do AgentCore da AWS |
| S3, S3 Files, CloudWatch | Tarifas padrão da AWS | Armazenamento e requisições | Skills, saídas e logs |
| Computação auto-hospedada | O que o seu host custar | Sua fatura atual | Se você rodar o codex exec-server por conta própria |
Esse é o desenho completo. Mas nem todas as linhas pesam igual, então o resto do artigo trata das que importam.
Linha 1: tokens do modelo e o acréscimo in-Region de 10%
Todo modelo da OpenAI no Bedrock lista seus preços na própria ficha do modelo. O detalhe que importa para o BMA está nas limitações da prévia: a inferência entre regiões não é suportada. Ou seja, toda solicitação do BMA paga a tarifa in-Region, e a AWS diz isso claramente: "Commercial In-Region prices include a 10% fee over OpenAI rates" (ficha do GPT-5.6 Luna).
Estas são as tarifas do nível Standard, contexto curto (272K tokens de entrada ou menos), por milhão de tokens, para os modelos da OpenAI que eu consideraria para um agente, todas das fichas do Bedrock na página de modelos da OpenAI da AWS:
| Modelo | Entrada (tarifa BMA) | Escrita em cache | Leitura de cache | Saída (tarifa BMA) | Tarifa própria da OpenAI (ent. / saída) |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.11 | $0.1375 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-5.6 Luna | $0.22 | $0.275 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6.1 Sol | $2.20 | $2.75 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $2.75 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $5.50 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $13.75 | $1.10 | $55.00 | $10.00 / $50.00 |
Quatro detalhes dessas fichas mudarão sua estimativa mais do que a tabela sugere:
- Contexto longo dobra a entrada. Quando uma solicitação passa de 272,000 tokens de entrada, a tarifa de contexto longo vale "to the full request," não só para o excedente (ficha do GPT-6.1 Sol). No GPT-5.6 Sol são $8.80 de entrada e $33.00 de saída. Um agente que arrasta uma grande janela de contexto em cada turno chega lá rápido.
- Sem descontos Priority nem Flex. Todas as fichas acima dizem que os níveis Priority e Flex não são suportados, então não há um nível mais barato, tipo lote, para trabalhos noturnos. Só existe o Standard.
- O cache não é uniforme. A ficha do GPT-6.1 Sol lista preços de cache, mas diz "Explicit prompt caching is not supported for this Bedrock model." Confira a ficha do modelo exato antes de contar com o desconto de 90% na leitura de cache.
- Os modelos mais novos ficam em uma só região. No endpoint
bedrock-mantleque o BMA usa, o GPT-6 Luna e o GPT-6.1 Sol só estão disponíveis emus-east-1. Se você implanta em Oregon ou Ohio, fica na família GPT-5.6.
A geração mais nova também é a mais barata por token aqui: o GPT-6 Luna custa metade do GPT-5.6 Luna, tanto na entrada quanto na saída. Se você ia escolher um Luna de qualquer forma, teste o GPT-6 Luna primeiro. Meus artigos sobre os preços do GPT-6 Luna e os preços do GPT-6.1 Sol os comparam com o resto da linha da OpenAI.
Linha 2: horas do AgentCore Runtime
O BMA não executa suas ferramentas por conta própria; elas rodam em computação que você fornece: seu próprio host ou o Amazon Bedrock AgentCore Runtime, que é o padrão no exemplo da AWS. Se você usa o AgentCore, paga as tarifas de runtime dele (preços do AgentCore):
| Recurso do AgentCore Runtime | Tarifa de consumo | Base comprometida |
|---|---|---|
| CPU de microVM v2 | $0.1276 por vCPU-hora | $0.0997 por vCPU-hora (lançamento até outubro de 2026) |
| Memória de microVM v2 | $0.0169 por GB-hora | $0.0132 por GB-hora (lançamento até outubro de 2026) |
| CPU de microVM v1 | $0.0895 por vCPU-hora | n/a |
| Memória de microVM v1 | $0.00945 por GB-hora | n/a |
| Instâncias de runtime (EC2) | Tarifa On-Demand do EC2 | mais uma taxa de gerenciamento de 12% |
Esse modelo de cobrança é mais gentil com agentes do que parece. A AWS diz que a CPU "scales to zero during I/O wait (waiting for LLM responses, tool / API calls, or database queries)," e que no v2 "idle memory is reclaimed automatically" após 120 segundos. Como um agente passa a maior parte da vida esperando o modelo, a maior parte do tempo real nem cobra CPU.
A própria página de preços da AWS traz um exemplo resolvido próximo de um agente de suporte: 1 milhão de sessões por mês, 10 minutos cada, 90% de espera de E/S, 1 vCPU e até 2.5 GB. O total é $0.006703 por sessão, ou $6,703 por mês pelo milhão. E isso é só runtime, antes de pagar um único token.
Um ponto de atenção: o exemplo do AgentCore do BMA define o tempo ocioso e a vida máxima do runtime em 28,800 segundos, ou seja, oito horas. A memória ociosa é recuperada, claro, mas uma sessão esquecida continua sendo uma sessão.
Linha 3: o NAT gateway que cobra enquanto seu agente dorme
A pilha de exemplo do AgentCore da AWS cria uma VPC com sub-redes privadas, um endpoint de gateway do S3 e um NAT gateway. Pelos preços do Amazon VPC em US East, um NAT gateway custa $0.045 por hora mais $0.045 por GB processado, e horas parciais são cobradas como horas inteiras.
Em um mês de 730 horas, são $32.85 antes de o seu agente fazer qualquer coisa. Para uma equipe de produção, é pouco dinheiro. Em uma conta de desenvolvimento, onde alguém testou o exemplo numa sexta e esqueceu, é uma linha que continua aparecendo todo mês até alguém executar os passos de limpeza. Por isso a própria documentação da AWS sugere rodar o exemplo em uma conta de desenvolvimento.
As outras linhas de armazenamento (buckets do S3 para skills e saídas, montagens do S3 Files, logs do CloudWatch) normalmente são centavos em volume de teste. Como crescem conforme o que o agente grava, vale conferi-las na sua fatura da AWS quando estiver em produção.
Quanto custa de verdade uma tarefa do agente
Este é o exemplo resolvido que eu uso. Uma tarefa em que o agente lê código e documentação e depois escreve um resultado. São 200,000 tokens de entrada e 20,000 de saída, sem cache, 10 minutos em uma sessão do AgentCore de 2 vCPU / 4 GB com a CPU ocupada 20% do tempo.
- Runtime: 120 segundos ocupados x 2 vCPU x $0.1276 por hora = $0.0085, mais 600 segundos x 4 GB x $0.0169 por hora = $0.0113. Arredonde para $0.02, e menos se o v2 recuperar memória ociosa.
- Tokens no GPT-5.6 Luna: 0.2M x $0.22 + 0.02M x $1.32 = $0.070.
- Tokens no GPT-5.6 Sol: 0.2M x $4.40 + 0.02M x $22.00 = $1.32.
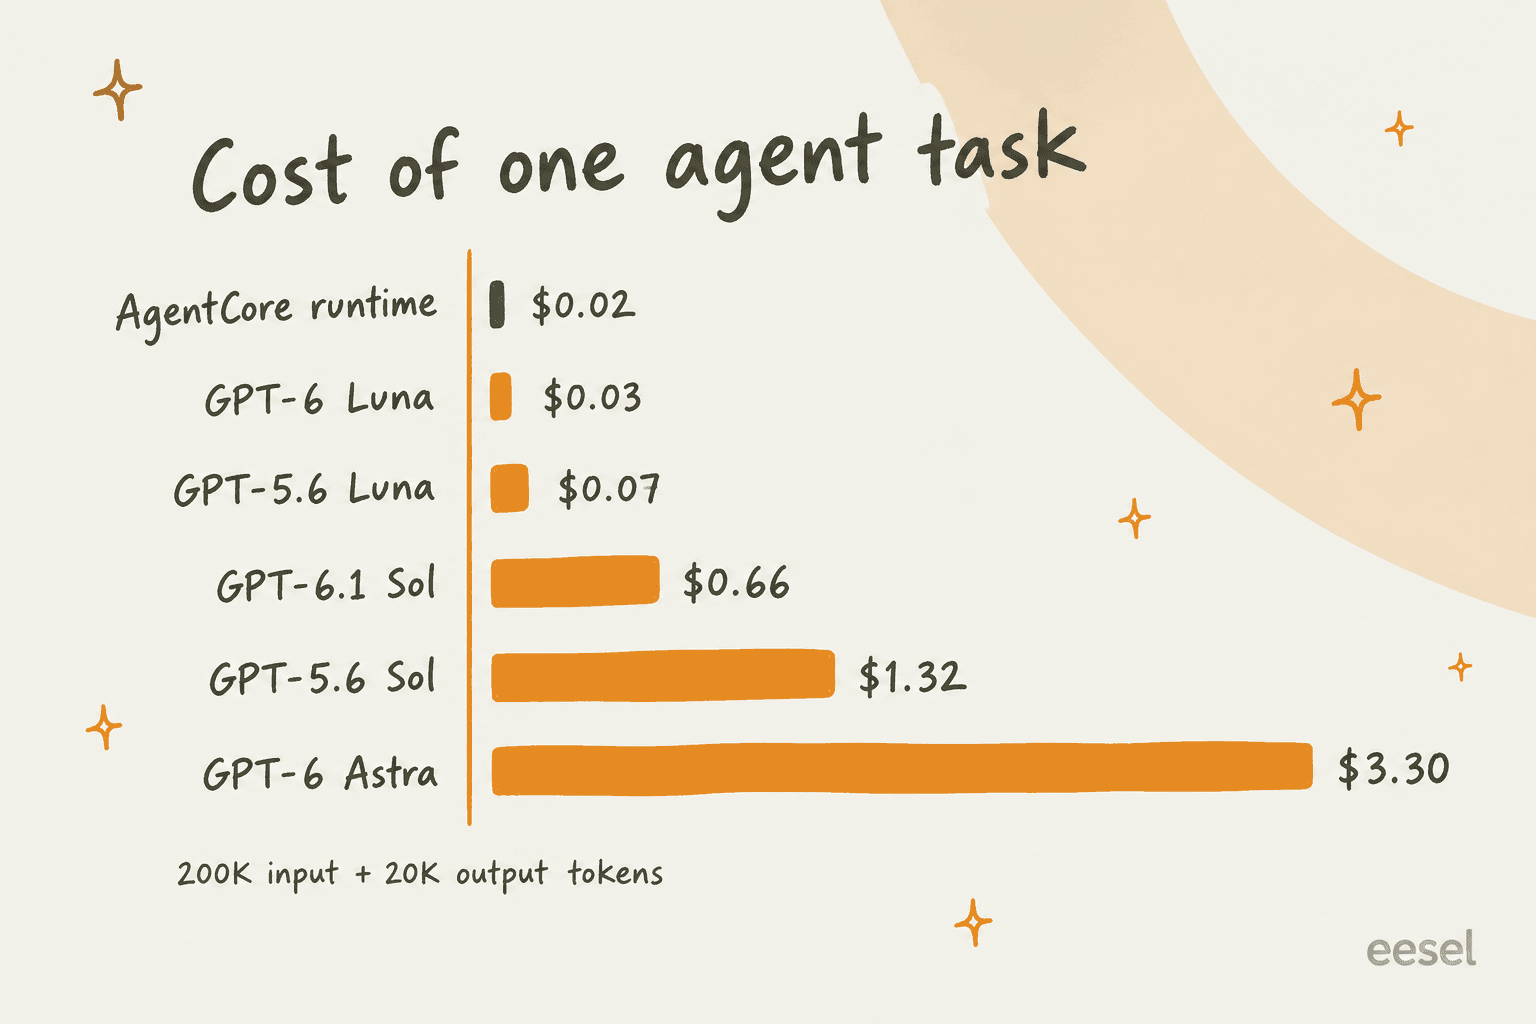
Se você levar uma única coisa deste artigo, leve esse gráfico. O runtime é a menor barra do gráfico. Ir do GPT-6 Luna para o GPT-6 Astra na mesma tarefa é um salto de 100x no custo de tokens, enquanto o runtime do AgentCore fica em cerca de dois centavos. Se você quer reduzir uma conta do BMA, a alavanca é a escolha do modelo. Ajustar vCPUs quase não muda nada.
Veja como isso escala ao longo de um mês no GPT-5.6 Luna, com o NAT gateway ligado:
| Tarefas por mês | Tokens | Runtime do AgentCore | NAT gateway | Total mensal | Por tarefa |
|---|---|---|---|---|---|
| 1,000 | $70 | $20 | $33 | $123 | $0.123 |
| 10,000 | $704 | $198 | $33 | $935 | $0.093 |
| 100,000 | $7,040 | $1,977 | $33 | $9,050 | $0.091 |
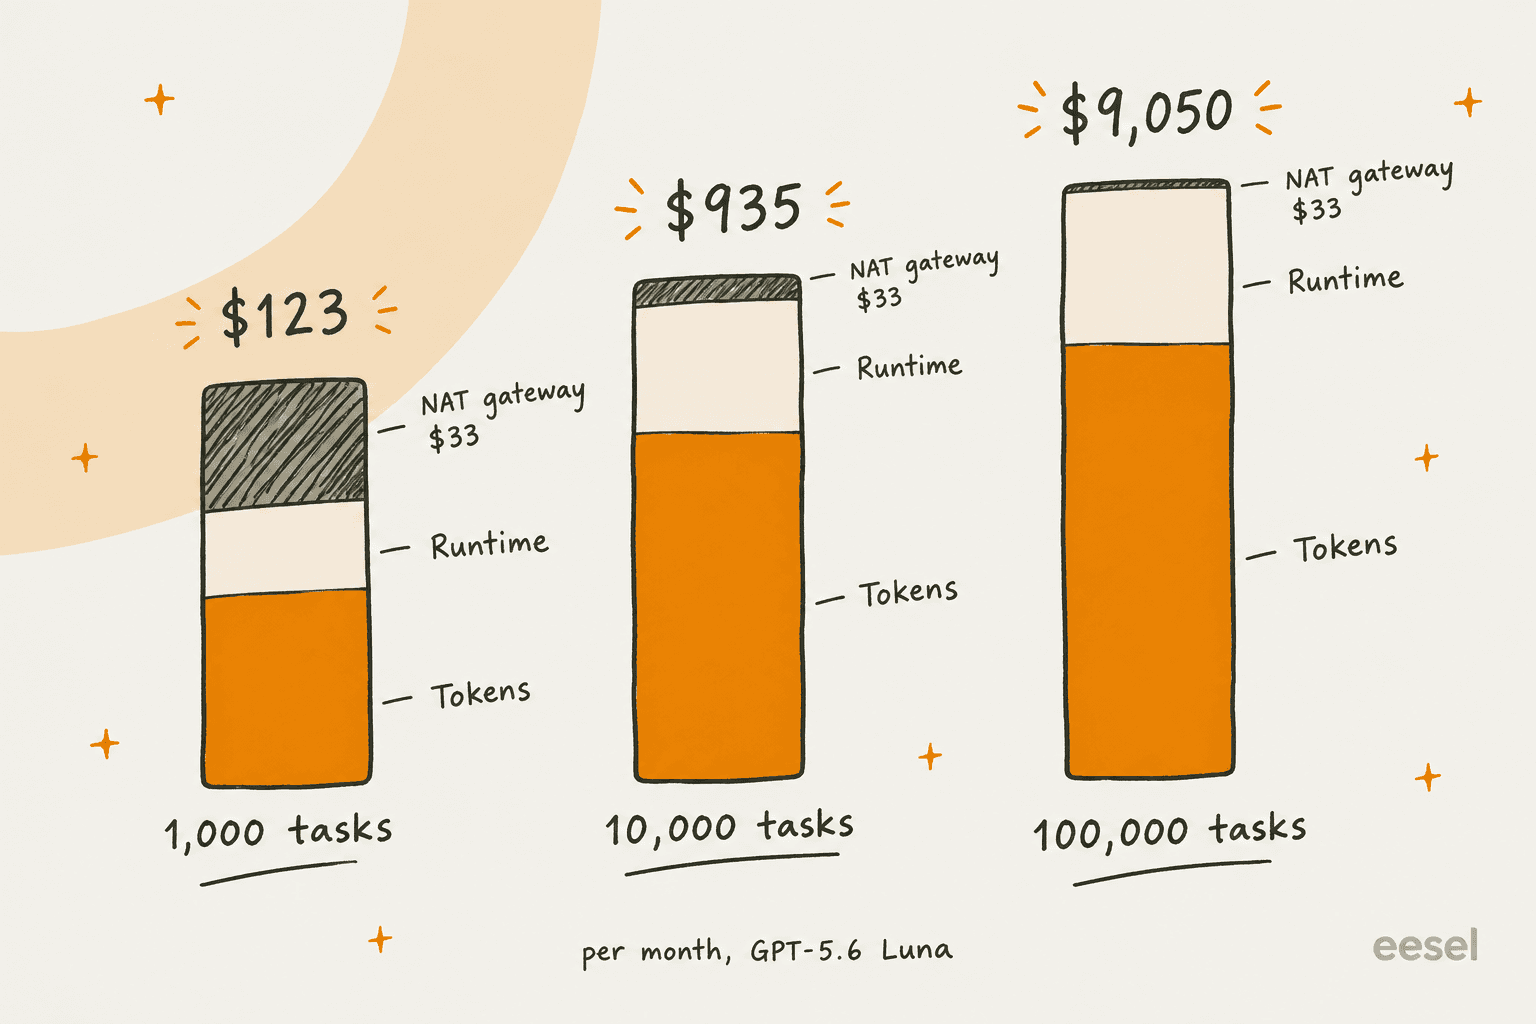
Em volume baixo, o NAT gateway fixo representa mais de um quarto da conta. Com 100,000 tarefas, vira ruído e os tokens são quase 80%. Então o conselho muda conforme a escala: equipes pequenas devem auto-hospedar ou desmontar a pilha de exemplo entre testes, e equipes grandes devem gastar energia na escolha do modelo e no prompt caching (tornar o contexto repetido cacheável).
Você pode colocar seus próprios números na calculadora abaixo, que usa as mesmas tarifas das tabelas acima:
O acréscimo de 10% da AWS vale a pena?
Acho que é a pergunta que a maioria dos compradores realmente faz. A resposta é mais favorável à AWS do que a manchete sugere. Aqui está a mesma tarefa de 10 minutos no GPT-5.6 Luna, precificada de quatro formas:
| Configuração | Tokens | Runtime | Por tarefa |
|---|---|---|---|
| API OpenAI Agents, sandbox auto-hospedado | $0.064 (tarifa da OpenAI) | $0 | $0.064 |
| Bedrock Managed Agents, auto-hospedado | $0.070 (tarifa in-Region) | $0 | $0.070 |
| Bedrock Managed Agents no AgentCore | $0.070 | cerca de $0.020 | $0.090 |
| API OpenAI Agents, contêiner hospedado de 4 GB | $0.064 | $0.06 | $0.124 |
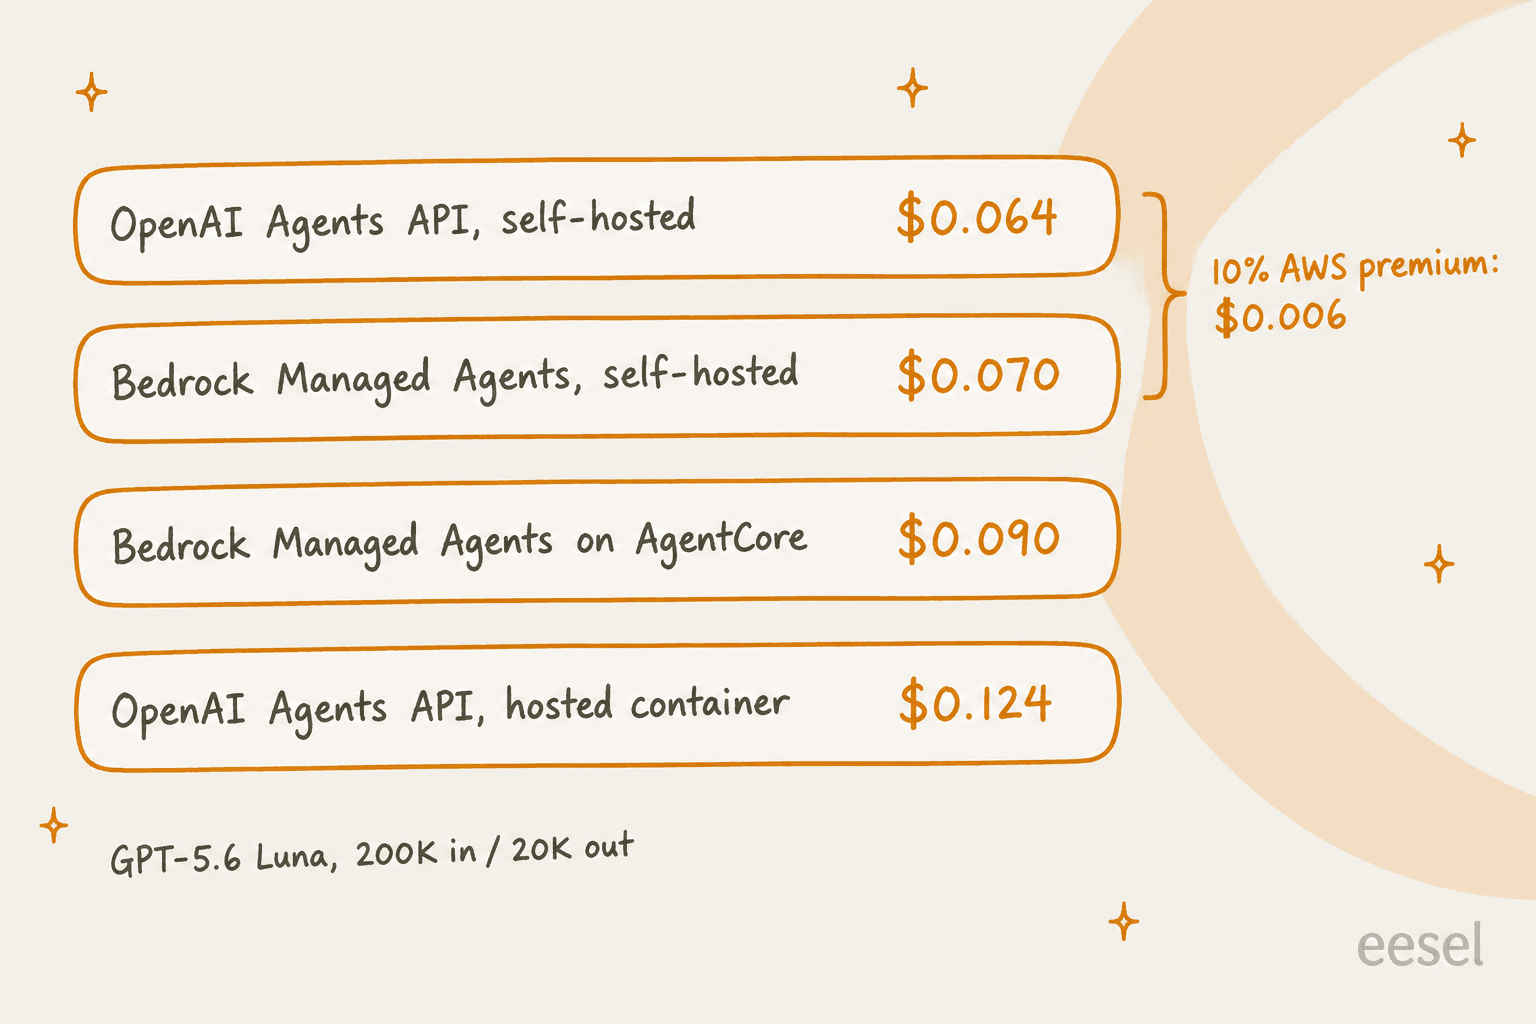
A linha do contêiner hospedado usa a tarifa publicada da OpenAI de $0.12 por sessão de 20 minutos para um contêiner de 4 GB, cobrada por minuto com mínimo de 5 minutos (preços da OpenAI). Meu artigo sobre os preços da API Agents percorre todos os tamanhos de contêiner.
Então o acréscimo da AWS nesta tarefa é de cerca de $0.006. É dinheiro de verdade com um milhão de tarefas por mês (uns $6,400), mas é menor que a diferença entre o contêiner hospedado da OpenAI e a cobrança do AgentCore que considera a E/S. Se você rodaria no sandbox hospedado da OpenAI de qualquer forma, o BMA no AgentCore pode sair mais barato por tarefa, não mais caro. Se você auto-hospedaria nos dois casos, o BMA custa exatamente os 10%.
O que o acréscimo compra é a parte que importa numa revisão de segurança: o runtime do agente, a inferência do modelo e suas ferramentas ficam dentro da sua conta da AWS, sob o contrato da AWS. A lógica de compras foi bem colocada por um comentarista do Hacker News:
"A lot of companies already have data processing agreements and compliance sign-off for using AWS. Many are hesitant to send their data to AI startups with an incentive to train their models and a history of being.... loose with how they intake training data. Even when they do give assurances otherwise. AWS is more trusted in this aspect. If this ends up similar to Claude on Bedrock, it's the same price."

Não saiu exatamente pelo mesmo preço, mas chega perto: 10% a mais pela garantia in-Region. Se sua empresa já tem a papelada da AWS assinada e levaria meses para aprovar um novo fornecedor de IA, esses 10% provavelmente são o trabalho de conformidade mais barato que você vai comprar este ano.
Como o preço do BMA se compara a outros runtimes de agentes gerenciados
Todo grande laboratório já vende um loop de agente gerenciado, e cada um cobra o runtime de um jeito. Os tokens sempre vêm à parte, nas tarifas de modelo de cada fornecedor:
| Runtime | Tarifa de runtime | Unidade cobrada | Modelos |
|---|---|---|---|
| Bedrock Managed Agents | $0 na prévia, mais sua computação | n/a | OpenAI no Bedrock |
| Claude Managed Agents | $0.08 por hora de sessão | Tempo no status running | Apenas Claude |
| API OpenAI Agents | $0.03 a $1.92 por contêiner de 20 minutos | Por minuto, mínimo de 5 minutos | Apenas OpenAI |
| Gemini Managed Agents | Computação não cobrada na prévia | n/a | Apenas Gemini |
| AgentCore harness | Sem tarifa de harness, mais o AgentCore Runtime | CPU e memória por segundo | Qualquer modelo do Bedrock, OpenAI, Gemini ou compatível com LiteLLM |
Hoje dois deles são gratuitos na camada de runtime, e ambos são prévias. Esse é o padrão a notar: os preços de lançamento nessa categoria são generosos, e nenhum laboratório disse quanto sua prévia vai custar quando estiver em disponibilidade geral.
O AgentCore harness é a única opção nativa da AWS que já está em disponibilidade geral, é agnóstica ao modelo e não tem tarifa de harness separada. A menos que você esteja preso especificamente ao harness da OpenAI, ele oferece a mesma cobrança de runtime e mais opções de modelo. O Claude Managed Agents acrescenta uma cobrança de runtime, mas hoje traz mais recursos: memory stores, multiagente e sandboxes de fornecedores. Meu artigo sobre os preços da API da Anthropic cobre o lado dos tokens dessa comparação, e o levantamento de alternativas à API OpenAI Agents cobre o restante do cenário.
Há também um ângulo estratégico que um post do LinkedIn colocou melhor do que eu conseguiria:
"Near-zero switching costs between frontier models on the same bill sounds like a buyer's market. It is, for now. When you can swap Claude for GPT-5.5 with a one-line code change, models start looking interchangeable, and the platform hosting them all owns the customer relationship and the pricing power."

É um motivo para manter o código do seu agente portável, não para evitar o BMA.
Custos ocultos para orçar
As tabelas de tarifas são claras o bastante. O que pega as equipes de surpresa é o que não está em nenhuma tabela:
- A tarifa de GA que ninguém anunciou. A AWS não publicou preço nem data pós-prévia. Se quiser um valor provisório, os $0.08 por hora de sessão do Claude acrescentariam cerca de $0.013 à tarefa de 10 minutos acima. Trate isso como um cenário de orçamento, não como previsão.
- Crescimento do contexto entre turnos. Cada turno reenvia a conversa até ali, então uma tarefa de 20 turnos pode custar muito mais que 20 cópias do primeiro turno. O cache ajuda nos modelos que o suportam, e o precipício de contexto longo de 272K pesa nos que não.
- O que o BMA ainda não inclui. A prévia não tem memória de longo prazo embutida, então a AWS diz para "provision and authorize any application-specific datastore separately" (limitações da prévia). Se você adicionar o AgentCore Memory, são $0.25 por 1,000 eventos novos mais $0.75 por 1,000 registros de longo prazo armazenados por mês (preços do AgentCore).
- Revisão humana. Para ações com efeitos externos, a documentação de segurança manda você aplicar por conta própria a autorização e qualquer revisão human-in-the-loop. Isso é tempo de engenharia, não um item da fatura da AWS.
- Tempo de engenharia, ponto final. É a maior linha de todas, e nunca aparece na fatura da AWS.
Sobre esse último ponto, vale ouvir os próprios críticos do AgentCore:
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
Pelos números acima, discordo que o runtime seja caro. Mas a segunda metade desse comentário é o custo real de qualquer runtime gerenciado: construir o produto continua sendo com você.
O Bedrock Managed Agents vale a pena para um agente de suporte?
É aqui que mais vejo a conta dar errado. Alguém precifica um agente de suporte no BMA, vê cerca de nove centavos por conversa e conclui que vai ser baratíssimo. A conta de tokens também está certa. Mas ela deixa de fora a integração com o helpdesk, a recuperação sobre a sua base de conhecimento, as regras de escalação, os testes com tickets reais e o engenheiro de plantão que faz a manutenção.
Na eesel, vi isso acontecer nas duas direções por anos. Um cliente de médio porte que saiu depois de uma integração quebrada e de um suporte lento disse à equipe da eesel "long term we will just build our own, which is so possible now with AI." E na outra direção: um líder de engenharia de uma empresa de hardware com uma base de conhecimento de mais de 300 artigos explicou por que escolheram comprar:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
As duas são decisões razoáveis. Se você tem engenheiros que querem ser donos de um agente de IA e precisa de modelos da OpenAI dentro da AWS, o preço do BMA não vai ser o que te impede. Se você está comparando o BMA com contratar um agente pronto, compare o custo total de construir versus comprar em vez de só a conta de tokens. Meu guia sobre como criar agentes de suporte lista todas as peças com que você estaria se comprometendo.
eesel: o agente de suporte com preço fixo
Se o que você realmente está precificando é um colega de IA para o helpdesk, a eesel tira o medidor de tokens do orçamento. Ela se conecta ao Zendesk, Freshdesk, Gorgias e ao resto do seu helpdesk e aprende com seus tickets antigos e sua central de ajuda. Antes de responder a um cliente real, é testada em simulação contra centenas dos seus tickets históricos.
Os preços são um plano de créditos, não uma conta de tokens: um plano gratuito com 100 créditos e depois planos pagos a partir de $299 por mês por 500 créditos, onde um ticket ou chat atendido é um crédito, com todos os recursos e assentos ilimitados. O financeiro consegue colocar esse número em uma planilha sem adivinhar o crescimento do contexto, e no campo do suporte ao cliente, a Gridwise viu 73% das solicitações de nível 1 resolvidas no primeiro mês.
E se o motivo de você estar olhando o BMA é querer operar agentes a partir de um terminal ou de um script, a CLI da eesel faz isso com o mesmo colega que você vê no painel. Dá para conectar integrações, editar as instruções, aprovar ou negar ações pendentes e ler a atividade, com saída JSON e --dry-run nas escritas. Ela também pode ser operada por agentes de programação como Claude Code, Codex e Cursor, o que abordei no meu artigo sobre CLI para agentes de IA.
Experimente a eesel grátis e veja quanto custa um agente de suporte quando a parte de infraestrutura já está pronta.
Perguntas frequentes
Quanto custa o Bedrock Managed Agents?
O Bedrock Managed Agents é grátis durante a prévia?
Por que o preço do Bedrock Managed Agents é mais alto que o da API da OpenAI?
Qual é a forma mais barata de rodar o Bedrock Managed Agents?
Como o preço do Bedrock Managed Agents se compara ao do Claude Managed Agents?
O preço do Bedrock Managed Agents vai mudar na disponibilidade geral?
Devo criar um agente de suporte no Bedrock Managed Agents para economizar?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.