O que é o Amazon Bedrock Managed Agents?
O Amazon Bedrock Managed Agents, com tecnologia da OpenAI, é um runtime gerenciado para agentes de IA com estado na AWS. Você cria uma sessão com um modelo, instruções, ferramentas e um ambiente de execução, envia mensagens, e o serviço executa o loop do agente e as chamadas ao modelo. Nas palavras da AWS, é "built on a customized version of OpenAI's Agents API engineered to be AWS-native" (AWS What's New), e a página do produto diz que "combines OpenAI models with the Codex harness and Amazon Bedrock AgentCore" (AWS).
Eu cuido das integrações e das APIs da eesel, então já montei esse mesmo tipo de loop na mão mais de uma vez. E a primeira coisa a saber é algo que a página de marketing meio que esconde: "gerenciado" aqui cobre a conversa e o loop de raciocínio, não a máquina em que seu agente trabalha. Essa máquina é você quem roda.
Foi preciso um tempo para chegar aqui. Esta é a linha do tempo, toda de fontes primárias:
| Data | O que aconteceu | Fonte |
|---|---|---|
| 27 fev 2026 | Amazon e OpenAI anunciam uma parceria, incluindo um "Stateful Runtime Environment" no Bedrock | Amazon |
| 28 abr 2026 | BMA anunciado em preview limitada, junto com os modelos da OpenAI e o Codex no Bedrock | OpenAI |
| 1 jun 2026 | Os modelos da OpenAI e o Codex no Bedrock entram em GA; o BMA ainda "coming soon" | AWS ML blog |
| 29 set 2026 | BMA abre como preview pública em 3 Regiões dos EUA | AWS What's New |
Os clientes de lançamento citados são Box e Salesforce. No post de lançamento da Amazon, o CTO da Box, Ben Kus, diz que ele reúne os modelos da OpenAI "with the scale, security, and infrastructure of AWS", e a Salesforce o combina com seu produto Headless 360 na página do produto da AWS.
Se você leu meu guia da OpenAI Agents API, o formato vai parecer familiar: mesma linhagem de harness do OpenAI Codex (seu preço é separado), mesmos objetos de agente, sessão e eventos. A diferença está principalmente em quem hospeda o loop e quem assina as requisições.
Como o Bedrock Managed Agents funciona
A documentação da AWS divide o serviço em seis partes (documentação da AWS):
- Sessão: uma conversa com estado com um agente. Define um modelo, instruções, ferramentas, uma role do IAM e um ambiente de execução.
- Turno: o trabalho feito em resposta a uma mensagem: raciocínio, chamadas de ferramentas e saída.
- Ambiente de execução: a infraestrutura que você fornece, onde comandos e ferramentas locais realmente rodam.
- Exec server: o processo
codex exec-serverque conecta seu ambiente ao BMA por uma conexão de saída. - Itens e eventos: itens são o registro durável do que aconteceu; eventos são um fluxo ao vivo do progresso.
- Role da sessão: a role do IAM que o BMA assume para chamar o modelo (e, se você usar, para iniciar o AgentCore Runtime).
A AWS tem seu próprio diagrama de como essas peças se comunicam:
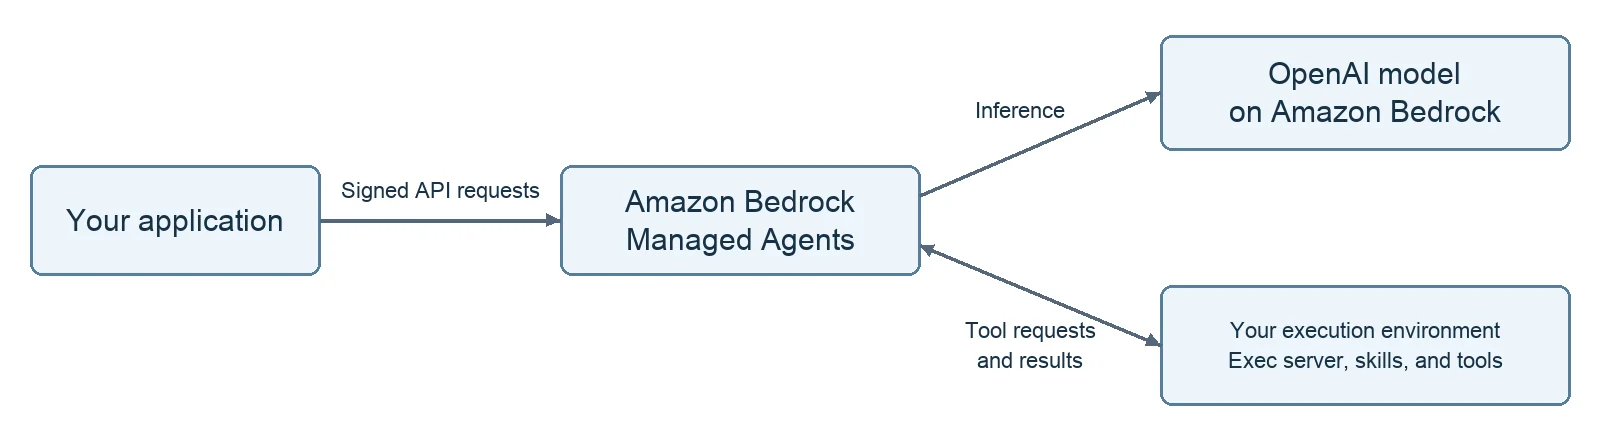
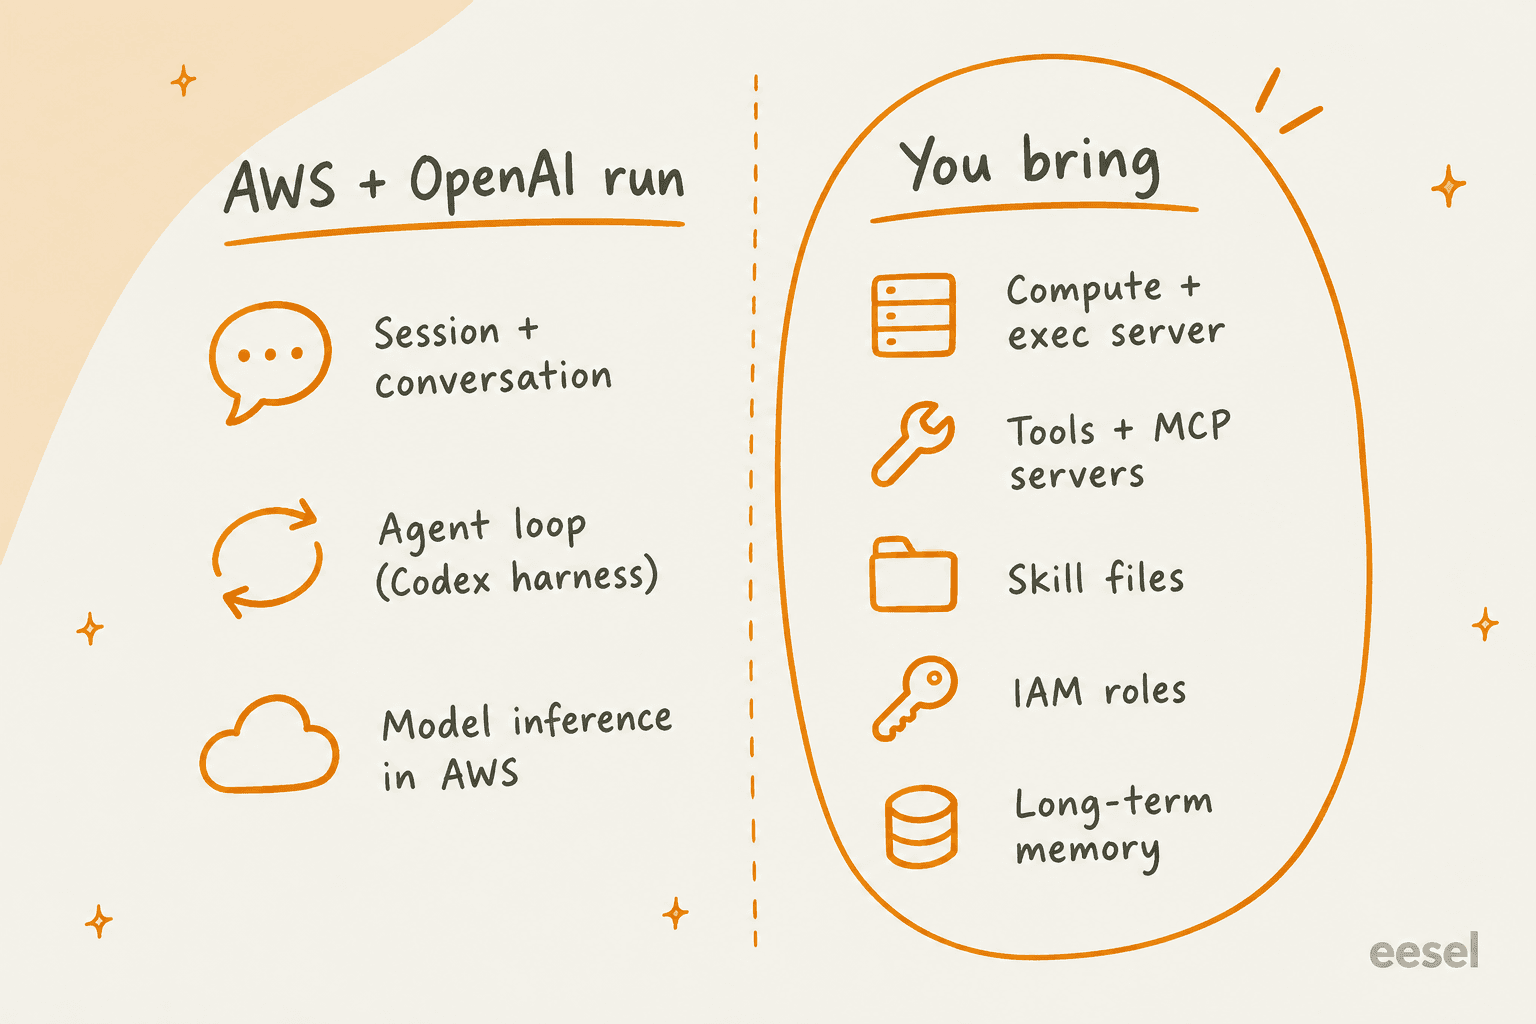
O que me surpreendeu foi a caixa no canto inferior direito. No Claude Managed Agents ou na Agents API hospedada da OpenAI, você pode deixar o fornecedor rodar um sandbox por você. No BMA, não existe opção de sandbox do fornecedor. As ferramentas "execute in the compute environment that you provide" (documentação da AWS), então o exec server, o workspace, as regras de rede e quaisquer servidores MCP ficam por sua conta.
Essa é a troca, a mesma que vejo em toda comparação de melhores agentes de IA. Você abre mão da conveniência e ganha uma história de segurança limpa: a inferência do modelo, o runtime do agente e suas ferramentas ficam todos dentro da AWS, e a página do produto da AWS diz exatamente isso: "The agent runtime and model inference remain inside AWS" (AWS).
A API é pequena
A superfície REST da preview são sete operações no endpoint regional bedrock-mantle, todas assinadas com AWS SigV4 em vez de uma chave de API da OpenAI (referência da API): criar, listar, recuperar e excluir uma sessão, enviar eventos, transmitir eventos e listar itens. Você envia uma mensagem postando um evento agent.session.input.message e depois lê os resultados no endpoint de itens, de 1 a 100 por página (guia de sessões).
Há dois detalhes na documentação que vão te poupar uma tarde:
- Um envio bem-sucedido retorna um corpo vazio. Significa "aceito", não "concluído". A conclusão aparece no estado da sessão, nos itens e nos eventos.
- Uma sessão
idlenão é prova de que a tarefa funcionou. A AWS manda verificar os itens de saída e, no caso de comandos, o código de saída. Cancelar um turno também "does not undo side effects from tools that already completed."
Skills e ferramentas
Uma skill é uma pasta com um arquivo SKILL.md, colocada em um dos diretórios de capacidades da sessão (até 32 caminhos). As ferramentas vêm de servidores MCP STDIO que rodam dentro do seu ambiente (meu guia do servidor MCP para agentes de IA explica o padrão), e você pode restringir cada servidor com uma lista allowed_tools (skills e ferramentas). Se você já usou skills no Claude Code, o formato é parecido o bastante para parecer familiar.
A AWS é direta sobre a parte de segurança: "Treat instructions from documents, websites, and tool responses as untrusted input" (documentação de segurança). É um conselho sobre prompt injection, e soa diferente quando o agente tem um shell de verdade em um host de verdade.
Onde seu agente realmente roda: autohospedado ou AgentCore
Você tem dois ambientes de execução, e a escolha define a maior parte do trabalho de configuração e parte da sua fatura (documentação da AWS):
| Infraestrutura autohospedada | AgentCore Runtime | |
|---|---|---|
| O que você fornece | Um host, um workspace, acesso à rede e um codex exec-server em execução | Um AgentCore Runtime com o exec server e seu adaptador dentro de um contêiner ARM64 |
| O que o stack de exemplo da AWS cria | Apenas roles do IAM (sem host) | Runtime, VPC com sub-redes privadas, 1 NAT gateway, buckets S3 com versionamento para skills e saídas, montagens S3 Files |
| Quem inicia o exec server | Você, em um segundo terminal | O BMA ativa o Runtime por você |
| Limites de tempo do exemplo | Você decide | 28,800 segundos (8 horas) de ociosidade e de vida máxima |
| Bom para | Máquinas de desenvolvimento, contêineres existentes, testes rápidos | Infraestrutura gerenciada por sessão que fica na sua conta |
O AgentCore é a plataforma de agentes mais ampla da AWS e é a infraestrutura padrão do BMA. O argumento da AWS é que, conforme seus agentes crescem, você pode usar mais dela: autorização, descoberta de agentes e ferramentas, observabilidade e avaliação (AWS).
Se você só quer ver algo funcionando, o caminho autohospedado é o mais rápido. O caminho do AgentCore é o que você realmente colocaria em produção, e é também onde começam a se acumular os custos que não aparecem na linha "sem cobrança adicional".
O que a preview inclui e o que deixa de fora
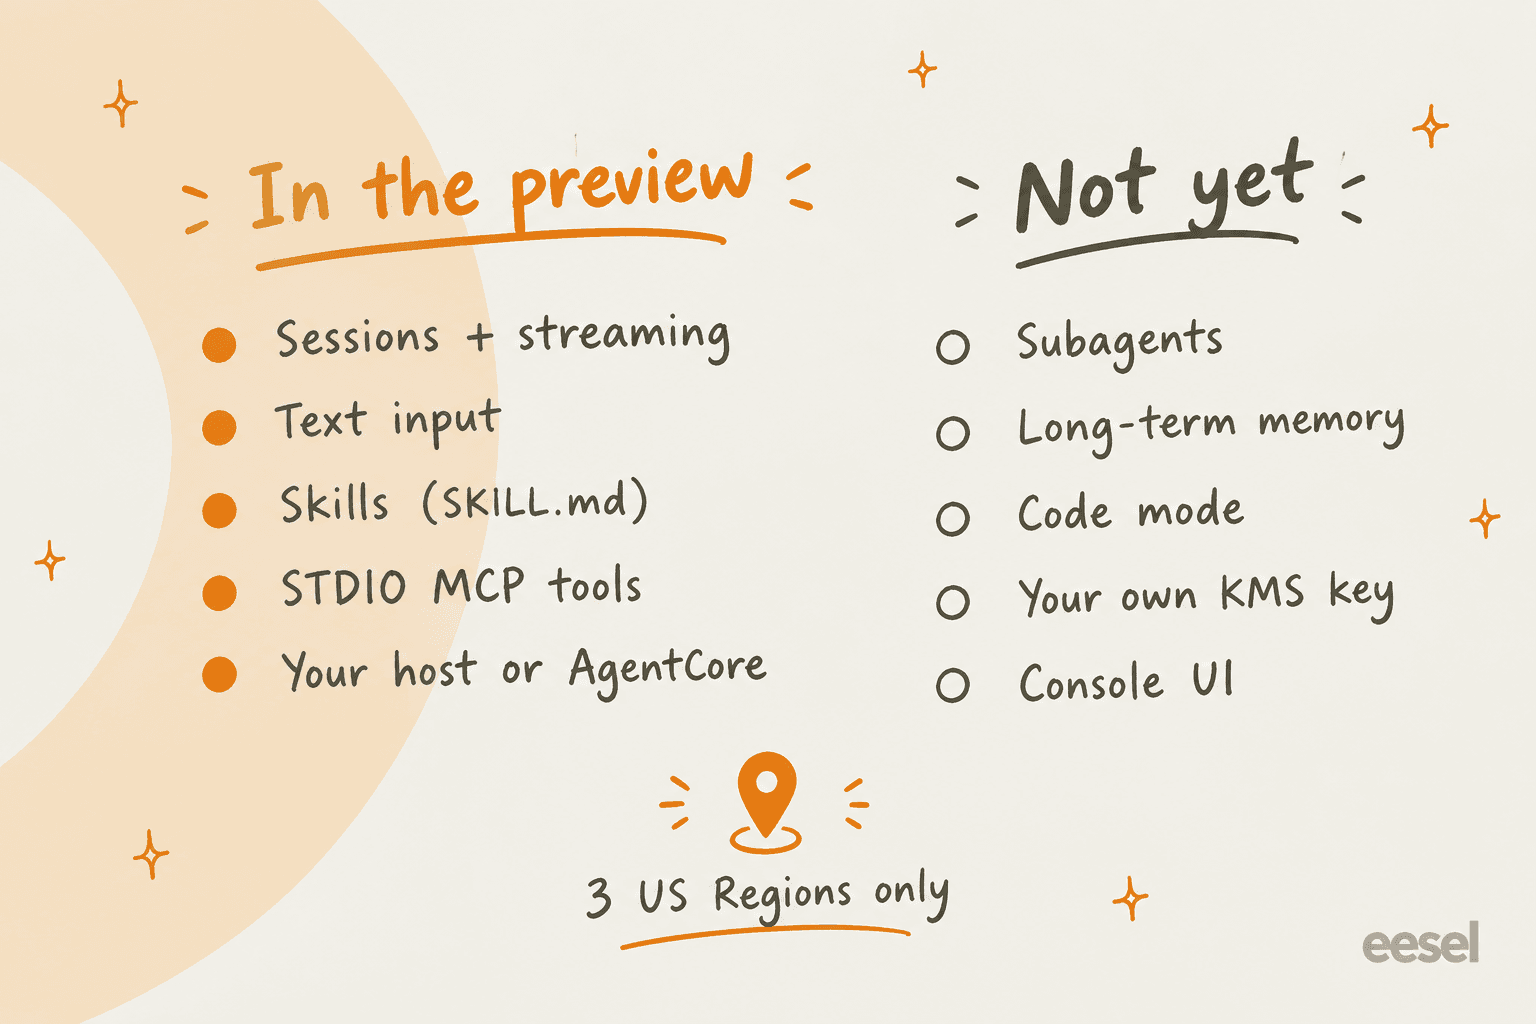
Se você só for ler uma seção duas vezes antes de se comprometer, que seja esta. A página de limitações da preview da AWS é incomumente clara sobre os limites:
- A entrada é somente texto. A superfície de entrada de sessão documentada é texto.
- Sem subagentes, sem code mode. A AWS diz para não habilitá-los na configuração de uma sessão, então os padrões de orquestração de subagentes estão fora de questão por enquanto.
- Sem memória de longo prazo. "The preview does not provide a built-in long-term memory integration; provision and authorize any application-specific datastore separately."
- Sem inferência entre Regiões. O que importa para o preço, como você verá abaixo.
- Sem chave KMS gerenciada pelo cliente para os dados de sessão gerenciados pelo serviço.
- Sem console. Tudo passa pela API e pelo pacote de exemplo da AWS.
- Sem API dedicada de listagem de turnos. Você correlaciona os turnos pelos valores
turn_iddos itens.
Há uma lacuna fácil de passar batida. A mensagem de lançamento diz que o runtime gerenciado "handles inference, memory, and skills" (AWS) e que cada agente "supports human approval before consequential actions", segundo o mesmo anúncio da preview. Nos dois casos, a documentação para desenvolvedores diz algo mais restrito. Memória significa contexto dentro de uma única sessão, e para ações com efeitos externos o guia de segurança diz para "enforce authorization and any required human review in the application or tool implementation" (documentação de segurança). Ou seja, o controle human-in-the-loop é algo que você constrói, não algo que você liga.
Para uma preview, nada disso é incomum. O que significa é que a versão que você pode usar hoje está mais para "um loop gerenciado mais um bom repositório de exemplo" do que para uma plataforma de agentes pronta. A página de BMA da própria OpenAI traz um aviso que vale levar ao pé da letra: "Shared concepts don't imply identical API contracts or feature availability." Não copie uma requisição da OpenAI Agents API esperando que funcione no Bedrock.
Quanto custa o Bedrock Managed Agents
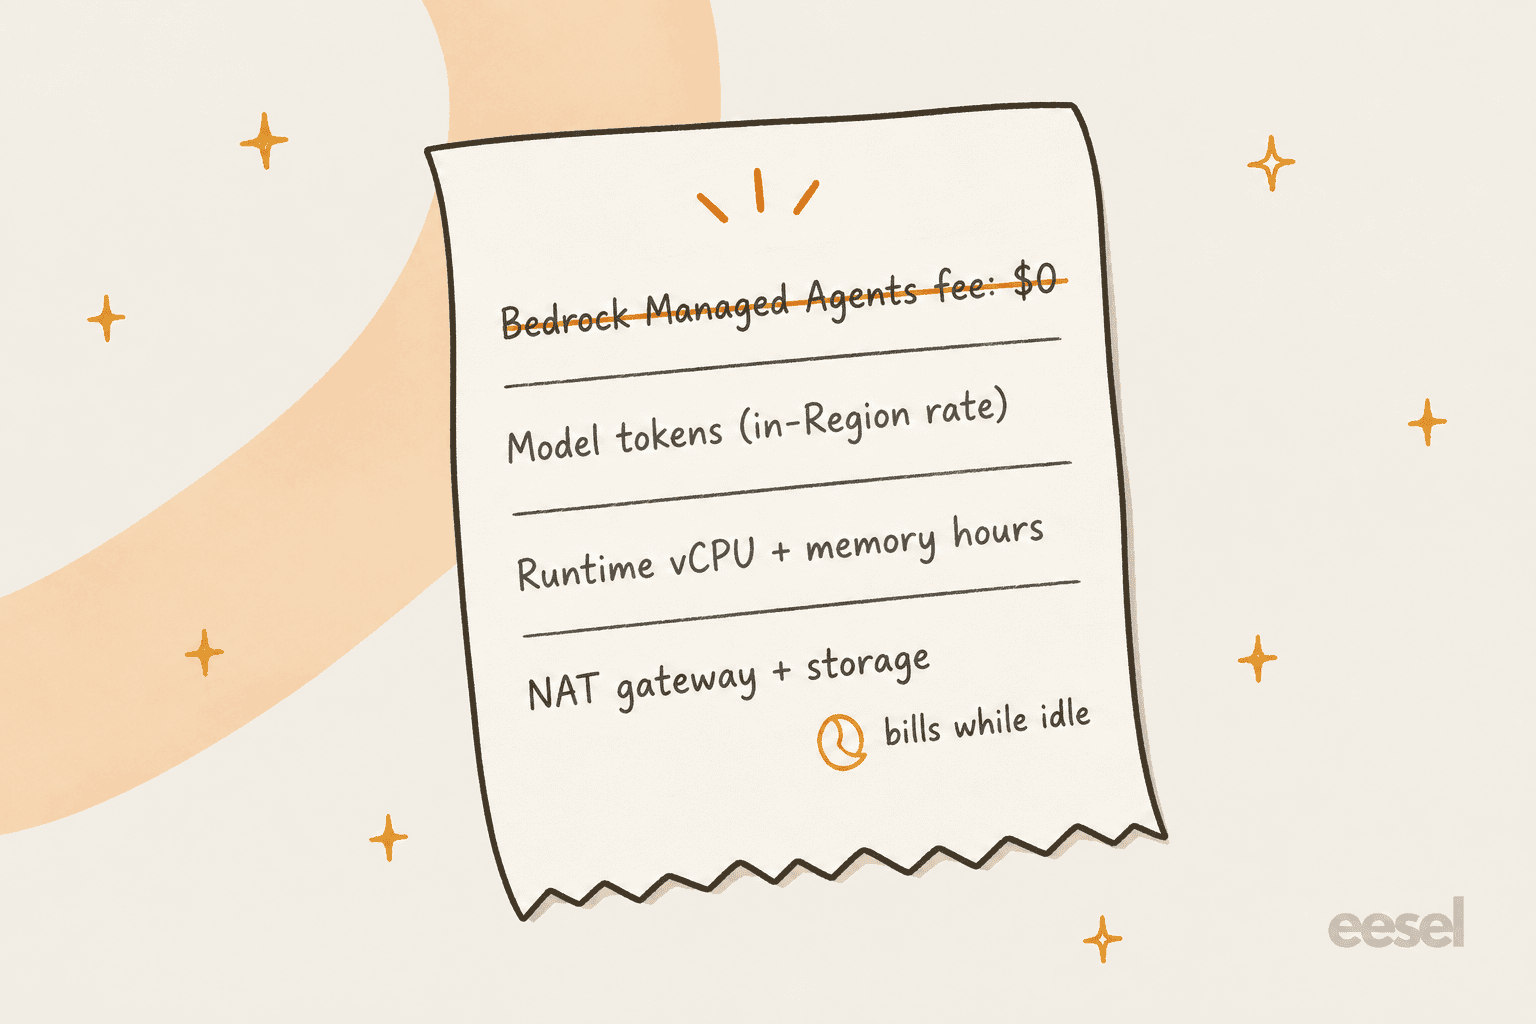
A linha de preços da AWS é curta: "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New). A documentação detalha o que são "recursos subjacentes": a inferência do modelo mais quaisquer recursos da AWS que seu app use, e o exemplo do AgentCore "can continue to incur charges when no BMA turn is running" (documentação da AWS).
Linha 1: tokens do modelo, na tarifa in-Region
Todo modelo da OpenAI no Bedrock tem seu preço no respectivo model card. O detalhe é que a preview do BMA não suporta perfis de inferência entre Regiões, então você paga a tarifa in-Region, e a AWS observa que "Commercial In-Region prices include a 10% fee over OpenAI rates" (card do GPT-5.6 Luna). Estas são as tarifas de contexto curto (272K tokens de entrada ou menos) por milhão de tokens:
| Modelo | Entrada (in-Region) | Entrada em cache | Saída (in-Region) | Tarifa global, igual à da OpenAI (ent. / saí.) |
|---|---|---|---|---|
| GPT-5.6 Luna (padrão do exemplo do BMA) | $0.22 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6 Luna | $0.11 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-6.1 Sol | $2.20 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $1.10 | $55.00 | $10.00 / $50.00 |
Cada tarifa vem do card do Bedrock do respectivo modelo, todos linkados na página de modelos da OpenAI da AWS. A AWS não publica uma lista fixa de modelos compatíveis com o BMA, e o card do GPT-6.1 Sol informa que o prompt caching explícito não é suportado para esse modelo no Bedrock, então confira seu modelo antes de contar com descontos de cache. Requisições de contexto longo (mais de 272K de entrada, uma fração da janela de contexto de mais de 1M) custam ainda mais. O GPT-5.6 Sol sobe para $8.80 de entrada e $33.00 de saída.
Linha 2: horas de runtime
Se você usa o AgentCore Runtime, paga as tarifas de computação dele. Em microVMs v2, são $0.1276 por vCPU-hora e $0.0169 por GB-hora, cobradas por segundo, e a AWS diz que a CPU não é cobrada enquanto o agente espera por E/S, como a resposta do modelo (preços do AgentCore). Autohospedado, você paga apenas o que seu host já custa.
Linha 3: o NAT gateway que ninguém menciona
O stack de exemplo do AgentCore da AWS cria um NAT gateway. Na tarifa publicada de US East, são $0.045 por hora mais $0.045 por GB processado, e horas parciais são cobradas como horas cheias (preços do Amazon VPC). Deixado ligado por um mês (730 horas), dá cerca de $33 por mês antes de o seu agente fazer qualquer coisa. Para uma empresa, é pouco dinheiro. Mesmo assim, é exatamente o tipo de linha que aparece numa conta de desenvolvimento três meses depois de alguém esquecer de executar os passos de limpeza.
Um exemplo prático
Digamos que uma tarefa do agente leia uma base de código e alguns documentos: 200,000 tokens de entrada, 20,000 de saída, cerca de 10 minutos em uma sessão do AgentCore de 2 vCPU / 4 GB.
- No GPT-5.6 Luna: $0.044 de entrada + $0.026 de saída = cerca de $0.07 em tokens.
- No GPT-5.6 Sol: $0.88 de entrada + $0.44 de saída = cerca de $1.32 em tokens.
- Teto do runtime: 2 vCPU x $0.1276 + 4 GB x $0.0169 = $0.32 por hora se a CPU ficasse ocupada o tempo todo, ou seja, cerca de $0.05 por 10 minutos, e menos na prática porque esperar o modelo não cobra CPU.
A conclusão: a escolha do modelo move a fatura em cerca de 19 vezes; o runtime quase não a move. Em baixo volume, você nota os custos fixos (NAT gateway, armazenamento), e em alto volume, os tokens. Se quiser a mesma conta para a versão hospedada da OpenAI, meu post de preços da Agents API cobre as tarifas de contêiner por 20 minutos, e meu guia de preços da AWS cobre o restante da fatura da AWS.
Como ele se compara a outros runtimes de agentes gerenciados
Todo grande laboratório hoje vende alguma versão de "a gente roda o loop do agente para você". O que realmente os diferencia é onde moram duas coisas: o loop e as ferramentas.
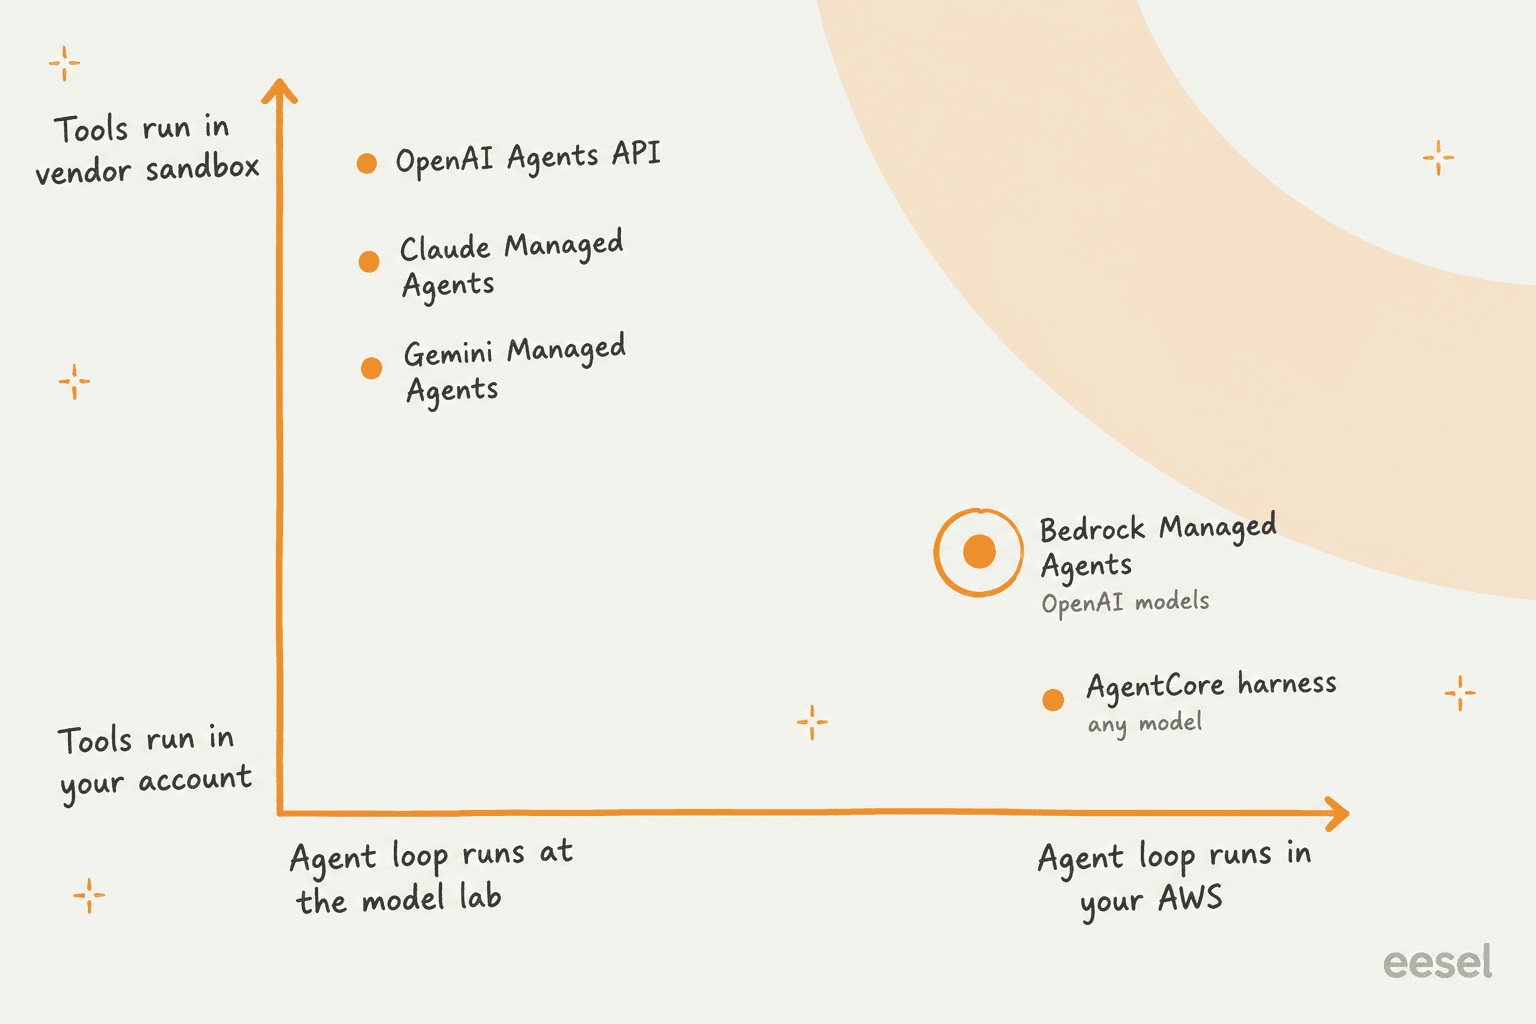
O Claude Managed Agents e a Agents API da OpenAI também oferecem sandboxes autohospedados, então o grupo no canto superior esquerdo é o padrão deles, e não o único modo. Mesmo assim, a orquestração fica com o laboratório: na versão da Anthropic, as entradas e saídas das ferramentas ainda fluem para o plano de controle da Anthropic, e na da OpenAI, escolher um sandbox autohospedado só move a execução das ferramentas. O BMA é a única opção aqui que mantém o harness da OpenAI, os modelos da OpenAI e suas ferramentas todos dentro da AWS.
| Bedrock Managed Agents | Claude Managed Agents | OpenAI Agents API | Gemini Managed Agents | Harness do AgentCore | |
|---|---|---|---|---|---|
| Status | Preview pública, 3 Regiões dos EUA | Beta | Beta pública (10 set 2026) | Preview pública (19 mai 2026) | Disponibilidade geral |
| Modelos | OpenAI no Bedrock | Somente Claude | Somente OpenAI | Somente Gemini | Bedrock, OpenAI, Gemini, qualquer provedor LiteLLM |
| Onde as ferramentas rodam | Somente seu host ou AgentCore | Sandbox da Anthropic ou o seu | Sandbox da OpenAI, o seu, provedores parceiros ou nenhum | Sandbox do Google (4 CPU / 16 GB) | microVM por sessão na sua conta |
| Taxa de runtime | Nenhuma durante a preview | $0.08 por hora de sessão enquanto roda | $0.03 a $1.92 por contêiner de 20 min; nenhuma se autohospedado | Computação não cobrada na preview | $0.1276 por vCPU-hora + $0.0169 por GB-hora |
| Memória de longo prazo | Não (preview) | Memory stores | Não publicado | Não (arquivos mantidos por 7 dias) | AgentCore Memory |
| MCP | STDIO dentro do seu ambiente | Servidores remotos + túneis | Remoto ou local | HTTP remoto | Via AgentCore Gateway |
| Subagentes | Não | Sim (multiagente) | Sim | Não publicado | Não publicado |
Algumas coisas nessa tabela merecem um segundo olhar.
O harness do AgentCore é o rival mais próximo do BMA, e também é da AWS. Está em GA, suporta "any model provided by Amazon Bedrock, OpenAI, Google Gemini, or any LiteLLM-compatible provider" e não há cobrança separada pelo harness (harness do AgentCore). A AWS também colocou o Bedrock Agents original em modo de manutenção: foi renomeado para Bedrock Agents Classic e fechado para novos clientes em 30 de julho de 2026, com a AWS direcionando novos projetos ao harness (documentação da AWS). Então, a menos que você esteja comprometido especificamente com o harness da OpenAI, eu começaria por lá.
O Claude Managed Agents é o produto mais completo hoje. Tem memory stores, orquestração multiagente, sandboxes do fornecedor e MCP remoto, e também é acessível pelo Claude Platform on AWS da Anthropic. Nesse caminho, porém, quem processa os dados é a Anthropic e não a AWS. Se o seu requisito é "a AWS é o único processador", o BMA (ou o Claude no Amazon Bedrock, que cobri em Claude Code no Bedrock) é a resposta mais limpa. Para uma lista mais ampla, veja minha seleção de alternativas à OpenAI Agents API.
Como começar com o Bedrock Managed Agents
O caminho mais rápido é o exemplo autohospedado da AWS. Se seu AWS CLI já estiver configurado, reserve uma hora. O tutorial autohospedado da AWS tem todos os comandos:
- Instale as ferramentas. Node.js 20+, AWS CLI v2,
curlcom suporte a SigV4,jqe Codex CLI 0.154.0 ou posterior (inclui ocodex exec-server). - Escolha uma Região e um endpoint.
us-east-1,us-west-2ouus-east-2, com o endpointhttps://bedrock-mantle.<region>.api.aws. - Baixe o pacote de exemplo e o binário do Codex que corresponde ao seu host (sempre Linux ARM64 para o AgentCore).
- Implante as roles do IAM com
npm ci,npx cdk bootstrapenpm run deploya partir da pastaself-hosted/. Você recebe uma role de cliente e uma role de sessão que o BMA assume. - Crie uma sessão, anexe o exec server e envie um turno. Os scripts numerados do pacote (
0.create-session.sh,1.attach-exec-server.sh,2.submit-turn.sh,3.read-result.sh) guiam você pelo processo.
A maioria das primeiras execuções falha no modelo do IAM. São três identidades: quem chama (precisa de permissões do BMA mais iam:PassRole na role da sessão), a role da sessão (confiada por bedrock-mantle.amazonaws.com e com permissão de bedrock-mantle:CreateInference para o seu modelo) e a identidade que seu ambiente de execução usa (documentação de segurança). Vale favoritar a página de solução de problemas antes de começar, principalmente a parte sobre conferir o AWS_PROFILE em cada terminal. Além disso, use um workspace dedicado, porque "the agent can use the files, tools, and permissions available to that environment."
O que quem está construindo diz
A preview pública só abriu esta semana, então o feedback prático ainda é escasso. O que existe são reações de lançamento de gente que vive na AWS, e a maioria concorda sobre o atrativo:
"Bedrock Managed Agents (limited preview): AWS runs OpenAI's agent harness, and all inferences run through Bedrock. Basically, you'd use the OpenAI SDK against AWS-owned infrastructure, and your data stays in AWS.
AgentCore Runtime is the only one that's GA right now, so it's the only viable option if you need something for production."

O ângulo de conformidade aparece sem parar no tópico do Hacker News sobre o lançamento original:
"This would be a nice compliance win. One less sub-processor and all our data is already on AWS so less worrying about sending it off somewhere else"

Vale ouvir também os céticos. O analista Mitch Ashley colocou a questão do lock-in de forma direta:
"The question for enterprise architects is whether AgentCore stays open enough to govern non-AWS execution, or quietly becomes the lock-in seam."
E um comentarista do Hacker News, falando da camada de computação que o BMA usa por padrão, não poupou palavras:
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
Essa última frase, "on top of building our actual product", é a história inteira dos runtimes de agentes gerenciados. Eles encolhem o trabalho de infraestrutura, mas o trabalho de produto continua sendo seu.
Quem deve usar o Bedrock Managed Agents (e quem não deve)
Use se você já está fundo na AWS, seu time de segurança ou compras aprovou a AWS mas não um novo fornecedor de IA, e você quer especificamente o harness e os modelos da OpenAI. O modelo de IAM por agente, o registro no CloudTrail e a história de "nada sai da conta" são o valor real, e são difíceis de conseguir em outro lugar com modelos da OpenAI.
Espere se você precisa de subagentes, memória de longo prazo, entrada de imagem ou qualquer coisa fora de três Regiões dos EUA. Nada disso está na preview, e não há data de GA.
Pule se você não está preso aos modelos da OpenAI (o harness do AgentCore está em GA e é agnóstico de modelo), ou se quer que o fornecedor rode o sandbox também (Claude Managed Agents ou a Agents API hospedada da OpenAI).
E pense bem se seu objetivo real é um agente de negócio, como um que responde tickets de suporte. Um agente de suporte é um produto, não um runtime. Vejo esse padrão com frequência. Nas notas de churn da própria eesel, vários clientes, incluindo uma empresa de AR e tecnologia da construção e uma marca de beleza DTC, saíram para construir seu agente de suporte diretamente sobre uma API de LLM. Outros fizeram o oposto. Um líder de engenharia de uma empresa de hardware de caixas eletrônicos de Bitcoin, com uma base de conhecimento de mais de 300 artigos no Confluence, contou à equipe da eesel por que escolheram comprar:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
O BMA encurta o caminho do "construir". Ele não elimina a integração com o helpdesk, a busca de conhecimento, a lógica de escalonamento nem os testes. E essas são as partes que levam meses.
eesel para times que querem o agente, não a encanação
O Bedrock Managed Agents é infraestrutura. A eesel é o funcionário. Mais especificamente, a eesel é uma plataforma de colegas de IA em que você contrata colegas prontos para trabalhar em funções definidas, e para suporte esse é o colega de IA para helpdesk: ele se conecta em minutos ao Zendesk, Freshdesk, Gorgias e ao resto do seu helpdesk, aprende com seus tickets anteriores e sua central de ajuda, e é executado contra centenas dos seus tickets históricos em uma simulação antes de responder a um cliente real. Segundo as estatísticas de clientes da própria eesel, a Gridwise viu 73% dos seus tickets de nível 1 resolvidos no primeiro mês.
Se o motivo de você estar olhando o BMA é que gosta de conduzir agentes por um terminal, a eesel também tem isso. A CLI da eesel (@eesel/cli) opera o mesmo colega e o mesmo workspace que você vê no painel: conecte integrações, edite as instruções permanentes do agente, aprove ou negue ações pendentes com eesel approvals e leia cada execução com eesel activity. Todo comando imprime JSON, os comandos de escrita aceitam --dry-run para você ver a chamada exata antes de ela ser enviada, e a autenticação headless funciona em CI. Agentes de programação como Claude Code, Codex e Cursor podem operá-la, e todo workspace também expõe um servidor MCP. É a mesma ideia do design API-first do BMA, só que apontada para um agente de suporte pronto em vez de um loop vazio.
Experimente a eesel de graça. Os preços começam com um plano gratuito de 100 créditos, depois planos pagos a partir de $299 por mês por 500, e um ticket ou chat atendido equivale a um crédito.
Perguntas frequentes
O que é o Amazon Bedrock Managed Agents?
Quanto custa o Bedrock Managed Agents?
O Bedrock Managed Agents está em disponibilidade geral?
Qual a diferença entre o Bedrock Managed Agents e a OpenAI Agents API?
O Bedrock Managed Agents tem memória?
Quais modelos o Bedrock Managed Agents suporta?
Devo usar o Bedrock Managed Agents para atendimento ao cliente?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.