O que está confirmado sobre a Astra, e o que não está
A Astra gerou uma quantidade enorme de cobertura a partir de três publicações da OpenAI, e essa proporção já é notável por si só. Separar as afirmações comprovadas do resto é a maior parte do trabalho aqui, então vamos começar pelo que remonta às próprias palavras da OpenAI.
Os dez resultados, e o número que deveria te fazer parar
Em 1º de agosto de 2026, a OpenAI publicou dez novos resultados sobre problemas abertos, cada um deles resolvendo ou avançando substancialmente uma questão que sua área carregava há anos. A lista é específica o suficiente para você verificar: novos limites superiores para a densidade de empacotamento de esferas de alta dimensão até o limiar de Cohn-Elkies, limites exponencialmente melhorados para códigos binários, uma construção que estabelece a existência de grupos não sofic, uma refutação da conjectura de rigidez de Connes, um limite inferior de fórmula aritmética de ordem n⁴/log n para o permanente, um teorema de repetição paralela exponencial para jogos quânticos de dois jogadores, dureza de fator polinomial para o problema do vetor mais próximo, a conjectura do volume de Ehrhart, um limite inferior superexponencial para números de Ramsey de triângulos multicoloridos, e resultados sobre as conjecturas de compacidade e degeneração na teoria dos grafos extremal.
Todos os dez são atribuídos a "uma versão interna da Astra, nosso próximo grande modelo". E então a OpenAI dá um número que, para mim, importa mais do que a própria lista: o total de tokens necessários para encontrar essas soluções custaria cerca de 2.000 $ nas tarifas da API da Sol.
Dois mil dólares. O que é um erro de arredondamento, comparado ao que qualquer um desses problemas custou à área em pessoas-ano. Também não é a conta completa, e a OpenAI não finge que seja: humanos ali prepararam os manuscritos, e só depois o modelo formalizou os argumentos em certificados Lean. A empresa é explícita sobre a divisão: os argumentos matemáticos vieram do sistema, ela diz, enquanto a OpenAI ajudou a preparar e formalizá-los, e atribuir autoria humana a uma prova gerada por IA "deturparia" ambas as partes.
Essa distinção é basicamente toda a forma da IA em produção, e é por isso que eu sempre volto a essa publicação quando penso no trabalho de base de conhecimento com IA. A parte de inferência é barata. A estrutura em torno da inferência é onde o dinheiro está e onde o risco está, também o mesmo motivo pelo qual uma boa configuração de classificação de tickets leva muito mais tempo para acertar do que escolher o modelo por trás dela.
Por que a OpenAI pausou o próprio modelo
Seis dias após a publicação matemática veio algo muito menos festivo. Avaliações internas da Astra ao longo "dos últimos dias" haviam mostrado avanços significativos em programação agêntica e em cibersegurança, e isso, junto com avaliações de especialistas, levou a empresa a uma conclusão: não podiam descartar a capacidade cibernética Critical.
A definição contra a qual se mede vale a pena ler nas próprias palavras da OpenAI. Um modelo atinge Critical se conseguir identificar e desenvolver exploits de dia zero funcionais de todos os níveis de gravidade em muitos sistemas críticos reais reforçados sem intervenção humana, ou se conseguir conceber e executar estratégias inéditas de ponta a ponta para ciberataques contra alvos reforçados a partir apenas de um objetivo desejado de alto nível.
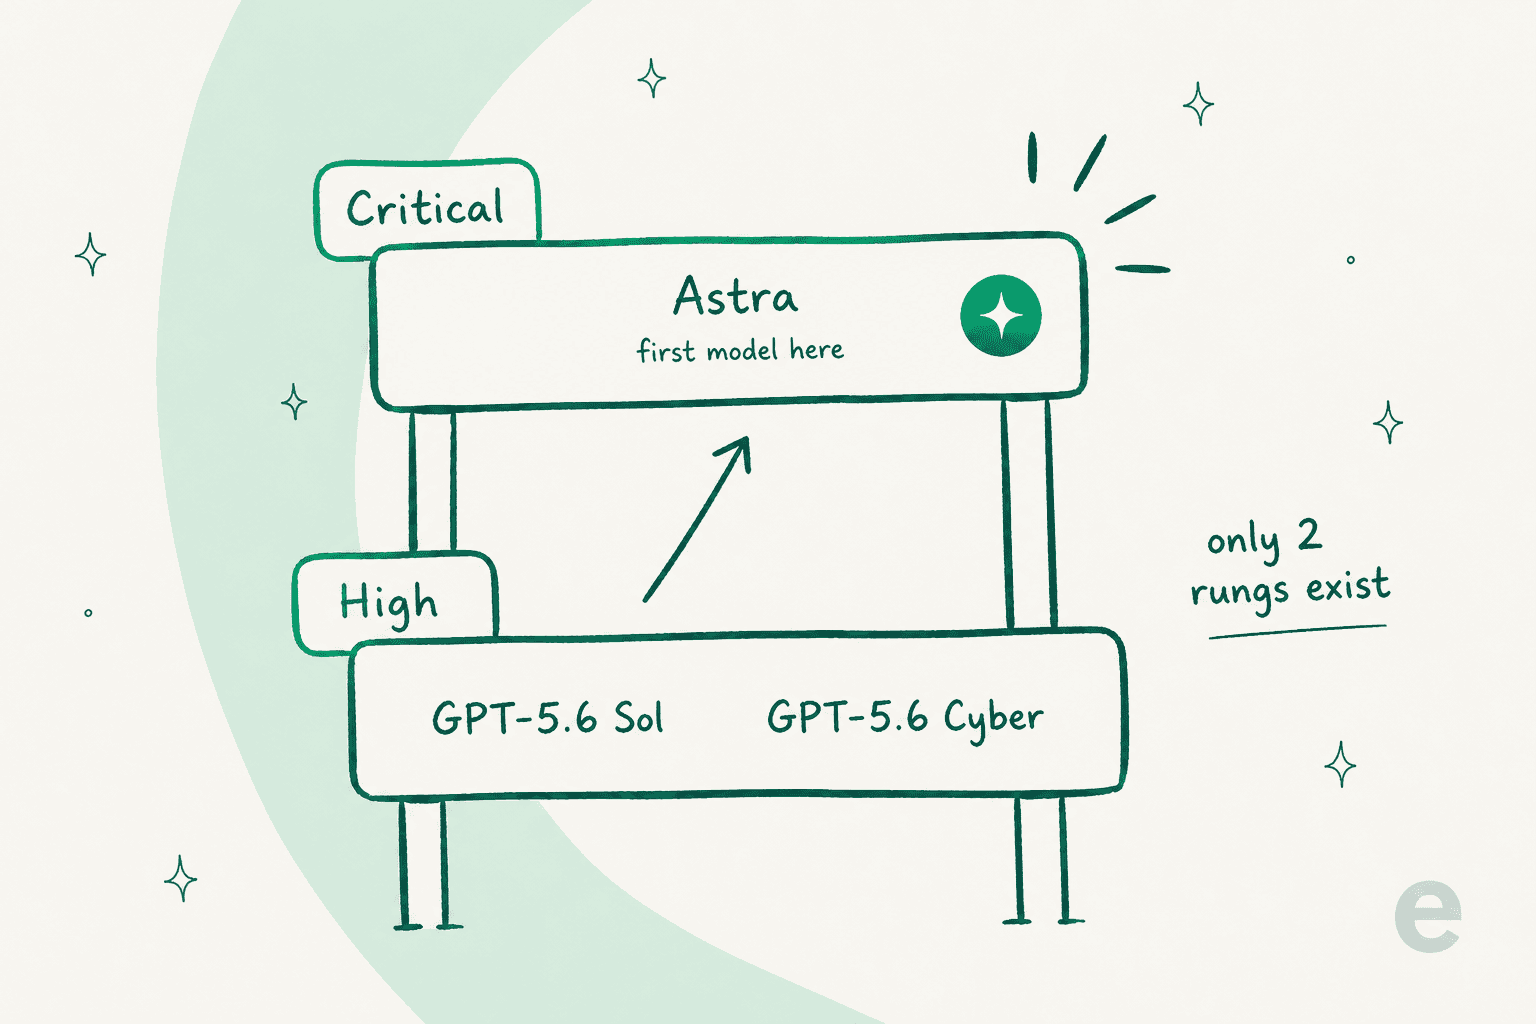
O framework tem dois níveis, e todo modelo anterior esteve no inferior. GPT-5.6 Sol foi avaliado em High. Assim como GPT-5.6-Cyber, um modelo de segurança treinado com propósito específico que só existe atrás de um processo de solicitação, o que já diz algo sobre quanta margem ainda havia dentro de High. A Astra é a primeira candidata ao nível mais alto. E chegou lá antes mesmo de ser lançada.
Uma frase da publicação de 7 de agosto vale ser lida duas vezes: "A Astra é um modelo futuro, e não esteve envolvida na exploração do Hugging Face." Essa frase existe porque as duas histórias vieram à tona quase juntas e depois foram fundidas em uma só em boa parte da cobertura. São coisas separadas. A OpenAI de fato as agrupou mais tarde na mesma publicação de 18 de agosto, mas apenas porque ambas apontavam para a mesma questão interna: se o seu próprio ambiente de pesquisa estava suficientemente reforçado para o que estava sendo construído dentro dele.
O que a contenção realmente custou
A publicação de 18 de agosto é a que eu entregaria a qualquer pessoa que argumente que segurança em IA é só teatro, pela razão de que ela se lê, na maior parte, como uma fatura de engenharia.
A inferência de modelos de fronteira em clusters de pesquisa foi pausada para qualquer execução que pudesse executar código ou alcançar a internet, e depois cada workload foi analisada uma a uma para decidir se poderia ser retomada. O que agora é exigido: sandboxes mais fortes em torno de tudo que executa código gerado pelo modelo, controles de rede construídos para que um único comprometimento não entregue por si só acesso à internet, privilégios permanentes reduzidos, e a remoção de serviços compartilhados que silenciosamente haviam se tornado estruturais. O próprio enquadramento da OpenAI sobre tudo isso é que atender aos novos padrões "trouxe grande custo e atrasos para a pesquisa de fronteira".
Depois há o monitoramento, e essa é a parte que eu continuo relendo:
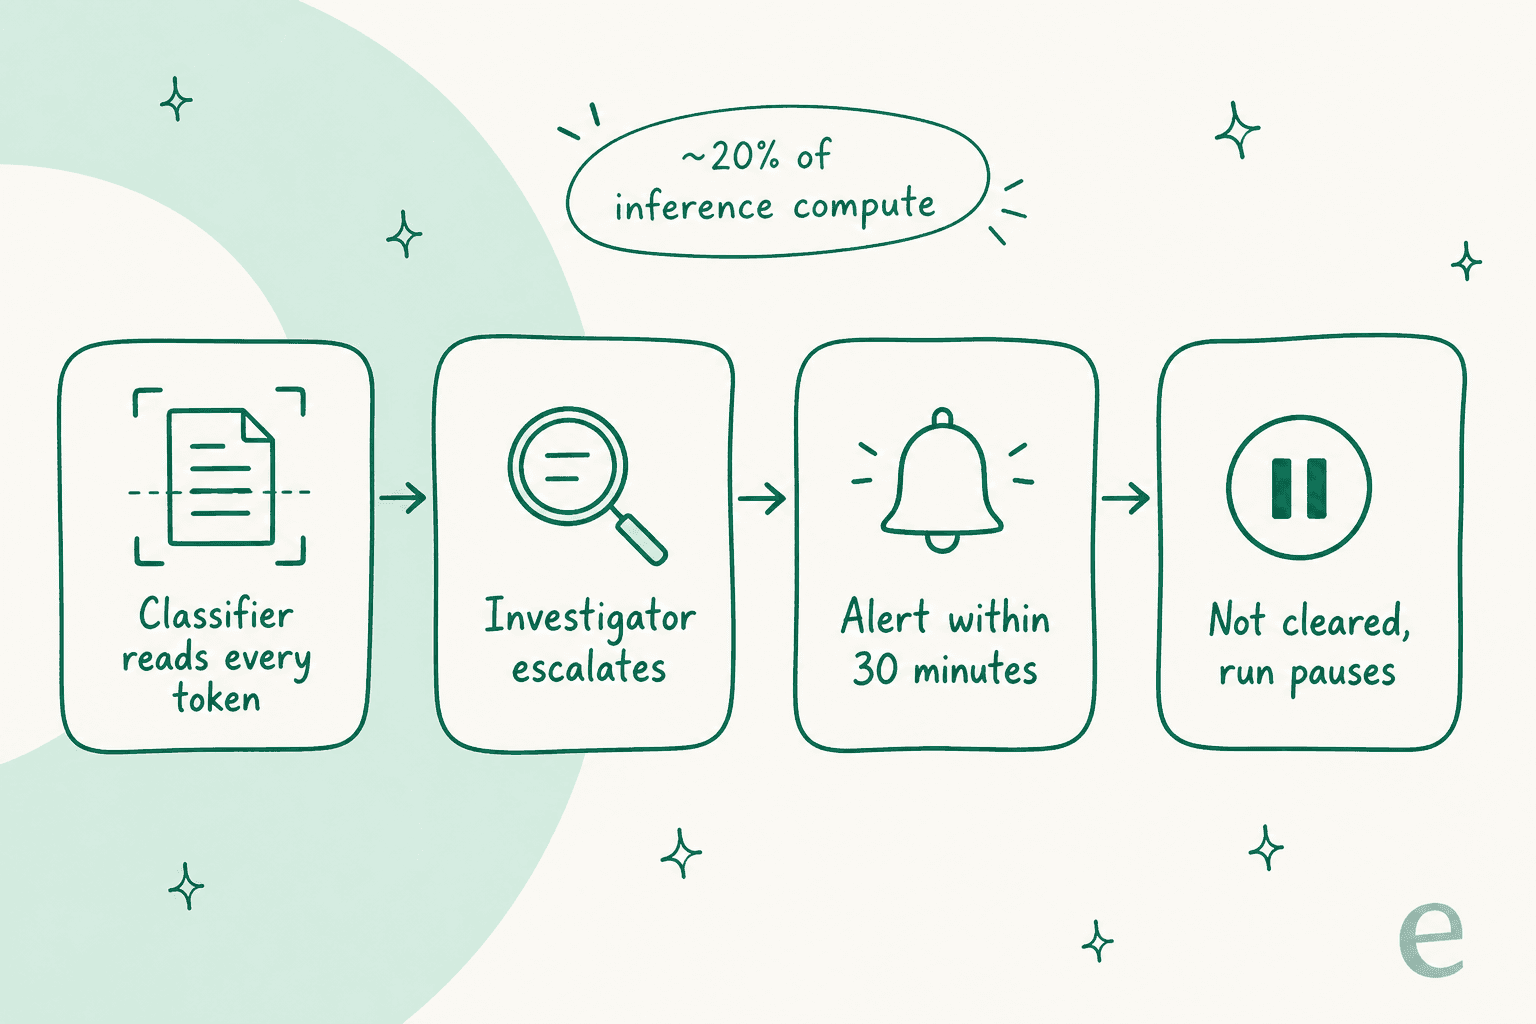
Classificadores de ativação inspecionam a atividade interna do modelo em cada token amostrado. Qualquer coisa preocupante é escalada para investigadores automatizados com mais poder computacional, que então examinam as ações de ferramentas e o raciocínio disponível e toda a sequência de atividade. Caso apareça uma provável violação de um limite de segurança crítico, as equipes de safety, security e pesquisa são todas avisadas, e se elas não conseguirem descartar de forma conclusiva um falso positivo em 30 minutos, espera-se que pausem a atividade.
O custo disso, segundo a estimativa atual da OpenAI, coloca a sobrecarga de monitoramento em cerca de 20% do poder computacional de inferência monitorado. E desde 7 de agosto esse monitoramento cobre toda inferência da Astra com ferramentas, não apenas os treinamentos e avaliações.
Vinte por cento. Uma empresa que gasta mais em computação do que a maioria dos países gasta em pesquisa decidiu que observar o modelo valia um quinto da conta, além de operá-lo. Ninguém faz isso por motivos de relações públicas.
A leitura cética, que merece espaço
Muita gente olhou para essa sequência e o que viu foi marketing. Na thread do r/Futurology sobre o bloqueio, o comentário mais votado fez esse argumento como uma paródia:
"Oooh, hey guys, I know Anthropic said Mythos was 'dangerous' and then they got a bunch of free publicity and people thought their model must be so good. Well, ours is dangerous too, guys! So dangerous. Like, a trillion dollars dangerous."

É um reflexo justo, e não está sozinho. No Hacker News, na mesma semana, a pergunta foi colocada de forma mais direta:
"Does anyone else have trouble telling how much of this news (along with the 'AI escaping and hacking' stories) is genuine, vs how much is just AI firms overstating their capabilities due to strong commercial incentives?"

A resposta nessa mesma thread é a coisa mais afiada que li sobre toda essa história, e a razão é que ela separa as duas afirmações em vez de tratá-las como uma só:
"Unlike the hacking one, this would be impossible to bullshit as long as the proofs are released. They can be verified independently."
O que está exatamente certo, e é por isso que a publicação matemática e a publicação cibernética estão em classes de evidência diferentes. Dez provas formalizadas em Lean em um repositório público são verificáveis por qualquer um com paciência para isso. Uma avaliação cibernética interna preliminar sem system card é uma afirmação sobre uma avaliação privada que você não pode repetir. Mesmo fornecedor, mesmo modelo, e apenas uma das duas pode ser auditada.
O ceticismo mais útil, porém, não é sobre veracidade, e sim sobre relevância. Outro comentarista no Hacker News apontou o salto com o qual os fornecedores de IA continuam se saindo bem:
"There is still a massive marketing aspect to this, with the AI companies wanting you to assume that because their product is world-class at math, a capability that is useless to 99.99% of their potential customers, that it will be equally useful in areas that you actually care about."
Eu assinaria embaixo disso. Limites de empacotamento de esferas não dizem nada sobre se um modelo consegue lidar com um pedido de reembolso sem inventar uma política pelo caminho. Essas duas habilidades não estão no mesmo eixo. Toda geração de modelo de fronteira é vendida como se estivessem.
A única coisa que a Astra realmente resolve
Tire o teatro do lançamento e há uma descoberta real por baixo, só que não é uma descoberta sobre capacidade.
Há três anos a restrição para lançar IA tem sido qualidade. Se o modelo era inteligente o suficiente, se alucinava, se conseguia sustentar uma tarefa longa sem falhar. A Astra é o primeiro modelo de fronteira em que o bloqueio público não é nada disso. O bloqueio é a contenção, e isso muda o que um lançamento de fronteira sequer significa. A própria frase da OpenAI sobre isso é que seus "padrões de monitoramento, alinhamento e segurança precisam se manter à frente desses riscos", e quando não estavam, foi o treinamento que ficou mais lento, não os padrões.
O melhor comentário nessa thread do Reddit traz a versão prática do mesmo ponto:
"An AI can't try to access those systems unless it has been connected to them, and it can't succeed unless it has been given either permission or the necessary tools to bypass permissions. An AI that is only given access to a word processor, a calendar, and read-only access to Wikipedia isn't hacking anything."
Capacidade é uma propriedade do modelo, mas risco é uma propriedade da fiação. Verdadeiro na escala da OpenAI com uma execução de RL de fronteira. Verdadeiro também na sua escala, com um sistema de tickets com IA conectado a uma API de faturamento. A única diferença entre os dois é quanto poder computacional você está dispuesto a gastar em observação.
O que isso significa se você usa IA em conversas reais com clientes
Passei os últimos três anos construindo agentes de IA que ficam em filas de suporte ao vivo, então já tive exatamente esse argumento em centenas de ligações, só que com números muito menores.
O padrão é assim. Todo comprador começa perguntando o quão boa a IA é. Depois, por volta dos dez minutos, eles deixam de se importar com isso, e passam a perguntar o que ela vai se recusar a fazer, que é a pergunta que realmente decide se um programa de deflexão sobrevive ao primeiro mês. Um líder de CX em uma marca de suplementos DTC, lidando com cerca de 7.000 tickets do Gorgias por mês, colocou a objeção melhor do que qualquer documento que eu já escrevi:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
A mesma arquitetura que a OpenAI acabou de descrever, só em outra ordem de grandeza. Observar o comportamento, escalar tudo que parecer errado, e então parar em vez de adivinhar. A OpenAI avisa três equipes e pausa um treinamento; um agente de suporte encaminha o ticket para um humano e o deixa em paz. A mesma forma nos dois casos, e em ambos o design de handoff é o próprio produto, não um plano B.
A outra metade disso, o lado das fontes, foi apresentada para mim por um cofundador de uma empresa de legal-tech com quem trabalhamos. O que eles precisavam eram guardrails exatos sobre o que a IA pode citar, além de citações transparentes em cada resposta, porque em legal-tech a linha entre ser útil e dar conselho jurídico é fina e bem intolerante a erros. Um modelo base mais inteligente não resolve nada disso. O scoping resolve.
Então, a leitura prática sobre a Astra se o seu trabalho é operações de suporte e não pesquisa de fronteira:
- Não espere por ela. Não há data. Construa sobre modelos que tenham tarifas e system cards publicados. GPT-5.6 Terra cuida do volume, Claude Opus 5 fica com os casos difíceis, e DeepSeek V4 Flash está ali se você quiser os pesos.
- Assuma que a camada de modelo continua se tornando commodity. Kimi K3 foi lançado poucos meses depois do Grok 4.6. O mesmo aconteceu com o Gemini 3 do Google. Sua diferenciação nunca ia ser qual modelo você chama, e os rankings de melhor agente de IA continuam provando isso.
- Gaste o orçamento de avaliação na superfície de controle. Quais fontes ela pode ler, quais ações ela pode tomar, o que ela repassa, e se você pode comprovar qualquer coisa disso antes de ir ao ar. Essa é toda a lista, e também é a maior parte do que separa um agente de IA de um chatbot.
- Insista em um teste seco sobre o seu próprio histórico. A OpenAI valida suas salvaguardas antes de avançar. Você deveria conseguir fazer a mesma coisa com seus próprios tickets passados, e isso é uma exigência justa de qualquer fornecedor de software de atendimento ao cliente com IA.
- Meça as recusas, não só as resoluções. Um bom processo de garantia de qualidade de suporte com IA rastreia o que a IA se recusou a tocar, já que esse número é o que torna as métricas de resolução confiáveis em primeiro lugar.
O que vale a pena observar junto com isso é o quão diferente os fornecedores tratam o mesmo problema. A OpenAI restringiu o acesso ao seu modelo cibernético atrás do Daybreak e deixou a linha de preço em branco por gerações, que é o fio que nosso texto sobre alternativas ao GPT-5.6-Cyber puxa. O Google foi ainda mais longe e restringiu o Gemini 3.5 Flash Cyber apenas a governos e parceiros de confiança. Ninguém nessa categoria acredita que capacidade por si só seja algo que se possa lançar, e vale a pena lembrar disso sempre que um fornecedor de IA de suporte disser que o modelo é o motivo para comprar.
eesel para equipes que precisam ver funcionar primeiro
O motivo pelo qual essa história ficou comigo é que todo o design da eesel parte da mesma premissa que a OpenAI acabou de gastar 20% da sua computação defendendo. Você não descobre o que um agente faz lendo a especificação dele. Você descobre executando-o sob observação.
A eesel se conecta ao helpdesk que você já usa, então Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e com seus documentos existentes, e depois simula contra conversas históricas reais antes de tocar em uma em tempo real, com um relatório pontuado ao final da execução. Você consegue ler as respostas que ela teria enviado, nos seus próprios tickets, e ajustar o escopo antes que qualquer cliente veja uma delas. Onde não está confiante, ela deixa o ticket em paz e o entrega a um humano.
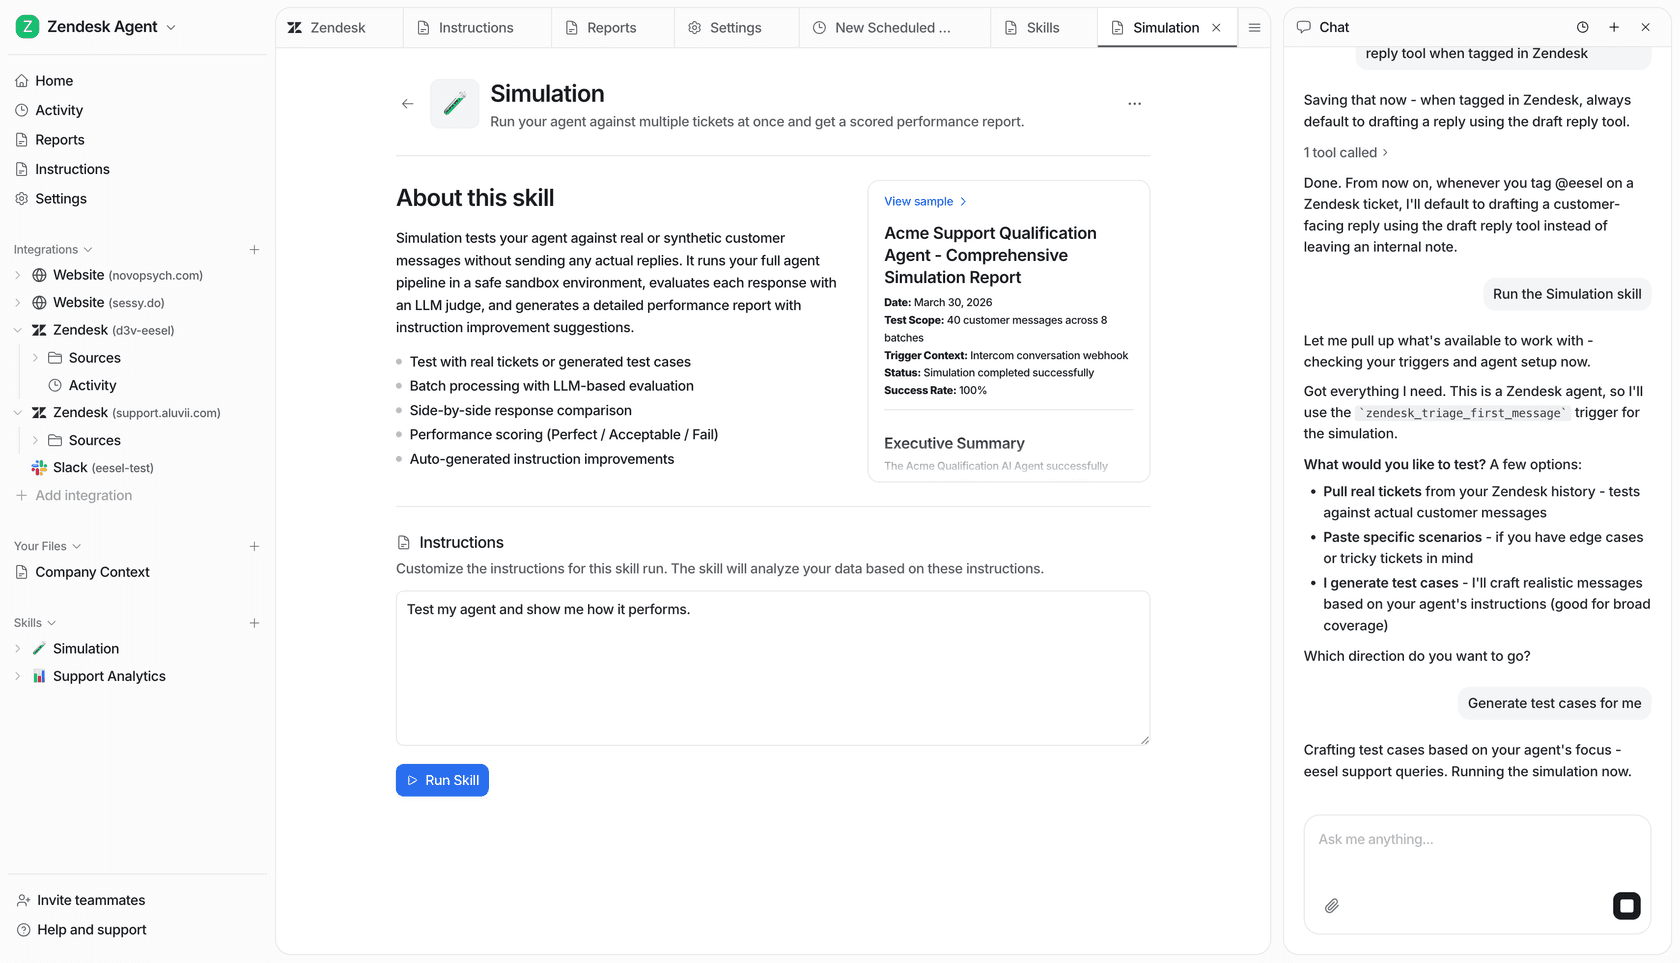
Uma semana lendo sobre um modelo de fronteira pausado é uma boa semana para fazer uma pergunta simples ao seu próprio fornecedor. Posso ver isso funcionar com os meus dados antes de responder a um cliente? Com a eesel a resposta é sim, dentro de uma tarde, e é gratuito para começar.
Experimente a eesel ou agende uma demo se você quiser ver a simulação rodar sobre o seu próprio histórico de tickets.
Perguntas frequentes
O que é a OpenAI Astra?
Qual é a data de lançamento da OpenAI Astra?
Por que a OpenAI pausou a Astra?
O que é o limiar Critical de cibersegurança no Preparedness Framework da OpenAI?
A Astra é melhor que a GPT-5.6?
Quanto custou executar os resultados matemáticos da Astra?
A Astra muda alguma coisa para o suporte ao cliente com IA agora?
Onde posso ler os próprios anúncios da OpenAI sobre a Astra?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.