

O GPT-6.2 Sol é o modelo do dia a dia da OpenAI, lançado em 17 de novembro de 2026 ao mesmo preço de $2/$10 por milhão de tokens do GPT-6.1 Sol. Ele marca 57 pontos no Artificial Analysis, dois pontos acima, a um custo por tarefa cerca de 20% menor e um terço do tempo, o que o coloca no nível do antigo GPT-6 Astra. A exceção é código, onde o Artificial Analysis mediu uma queda de 3 pontos.
Nos meus 15 tickets de suporte, ele passou em tudo que o GPT-6.1 Sol passou, por cerca de 5% mais por ticket. Se você usa o 6.1 Sol, troque. Para respostas voltadas ao cliente, um teammate de IA de helpdesk com grounding como a eesel importa mais do que o modelo por baixo.
O que é o GPT-6.2 Sol?
O GPT-6.2 Sol é a metade de nível médio do lançamento de novembro da OpenAI, o sucessor do GPT-6.1 Sol. O post de lançamento o chama de "nosso modelo eficiente e versátil para o trabalho do dia a dia", e diz que muitos funcionários da OpenAI o usam como modelo padrão, tanto para tarefas técnicas quanto não técnicas. Seu irmão maior, o GPT-6.2 Astra, foi lançado no mesmo dia para os projetos mais difíceis.
Eu construo agentes de IA na eesel, então meu primeiro movimento com qualquer modelo novo é chamá-lo a partir de código e ver o que ele faz em trabalho real. O ID gpt-6.2-sol funcionou com minha chave de API poucas horas após o lançamento, e eu o testei contra os mesmos tickets de suporte que usei para a análise do GPT-6.1 Sol. Os resultados estão mais abaixo.
Sobre disponibilidade, a OpenAI diz que os dois modelos estão disponíveis para usuários Plus, Pro, Enterprise e Edu no ChatGPT Work e Codex, e na API. Usuários Enterprise e Edu ganham acesso quando um administrador do workspace o ativa. Assinantes Pro 500 podem rodar qualquer um dos dois modelos em modo Ultrafast, e pela primeira vez o Ultrafast chega também ao Pro 200, começando com o Sol. O guia de preços do ChatGPT cobre o que cada plano custa.
O que mudou desde o GPT-6.1 Sol?
O preço não mudou, então a pergunta é o que o mesmo dinheiro compra agora. A OpenAI diz que o GPT-6.2 Sol é "mais inteligente, mais eficiente, e permite que você complete mais tarefas no mesmo plano pago." No seu benchmark interno GDPval v2, que testa fluxos de trabalho profissionais longos, o Sol melhorou 5,3 pontos em relação ao GPT-6.1 Sol.
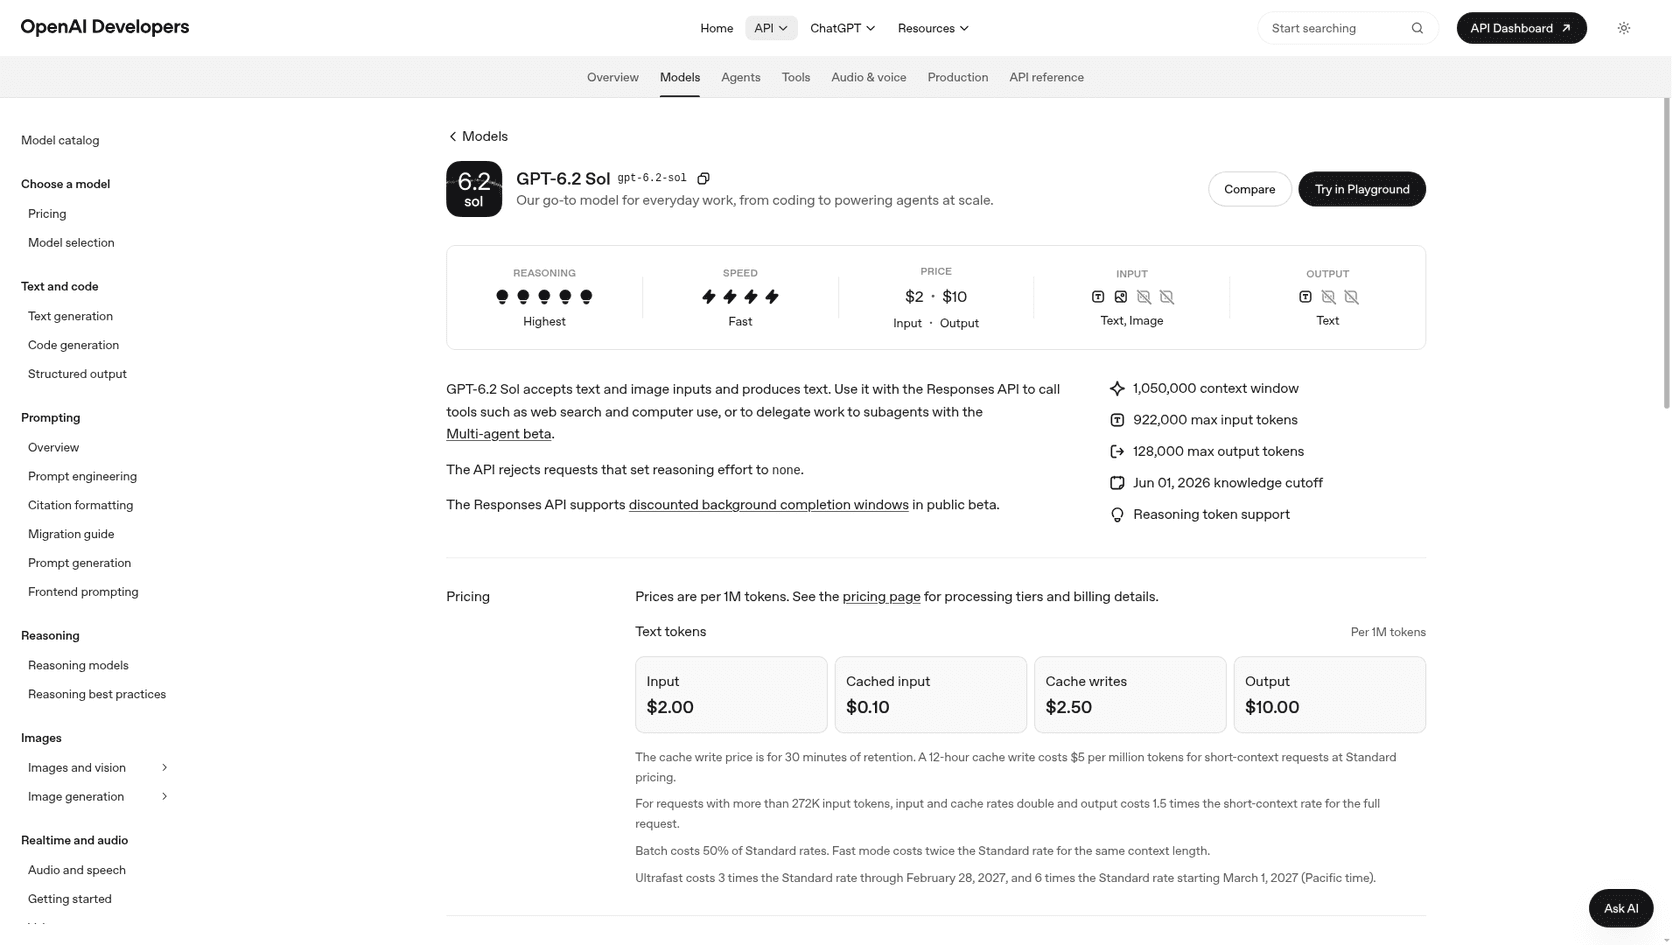
Aqui estão as especificações da página do modelo e do Artificial Analysis, ao lado do modelo antigo:
| GPT-6.1 Sol | GPT-6.2 Sol | |
|---|---|---|
| Lançamento | 29 de setembro de 2026 | 17 de novembro de 2026 |
| Entrada / saída (por 1M) | $2 / $10 | $2 / $10 |
| Entrada em cache (por 1M) | $0,10 | $0,10 |
| Janela de contexto | 1.050.000 tokens | 1.050.000 tokens |
| Entrada máx. / saída máx. | n/a | 922.000 / 128.000 |
| Corte de conhecimento | n/a | 1 de junho de 2026 |
| Menor esforço de raciocínio | low | low (none é rejeitado) |
| AA Intelligence Index (max) | 55 | 57 |
| AA custo por tarefa (max) | $1,27 | $1,01 |
| AA tempo por tarefa (max) | 23,1 min | 7,9 min |
| AA Coding Agent Index | referência | 3 pontos menor |
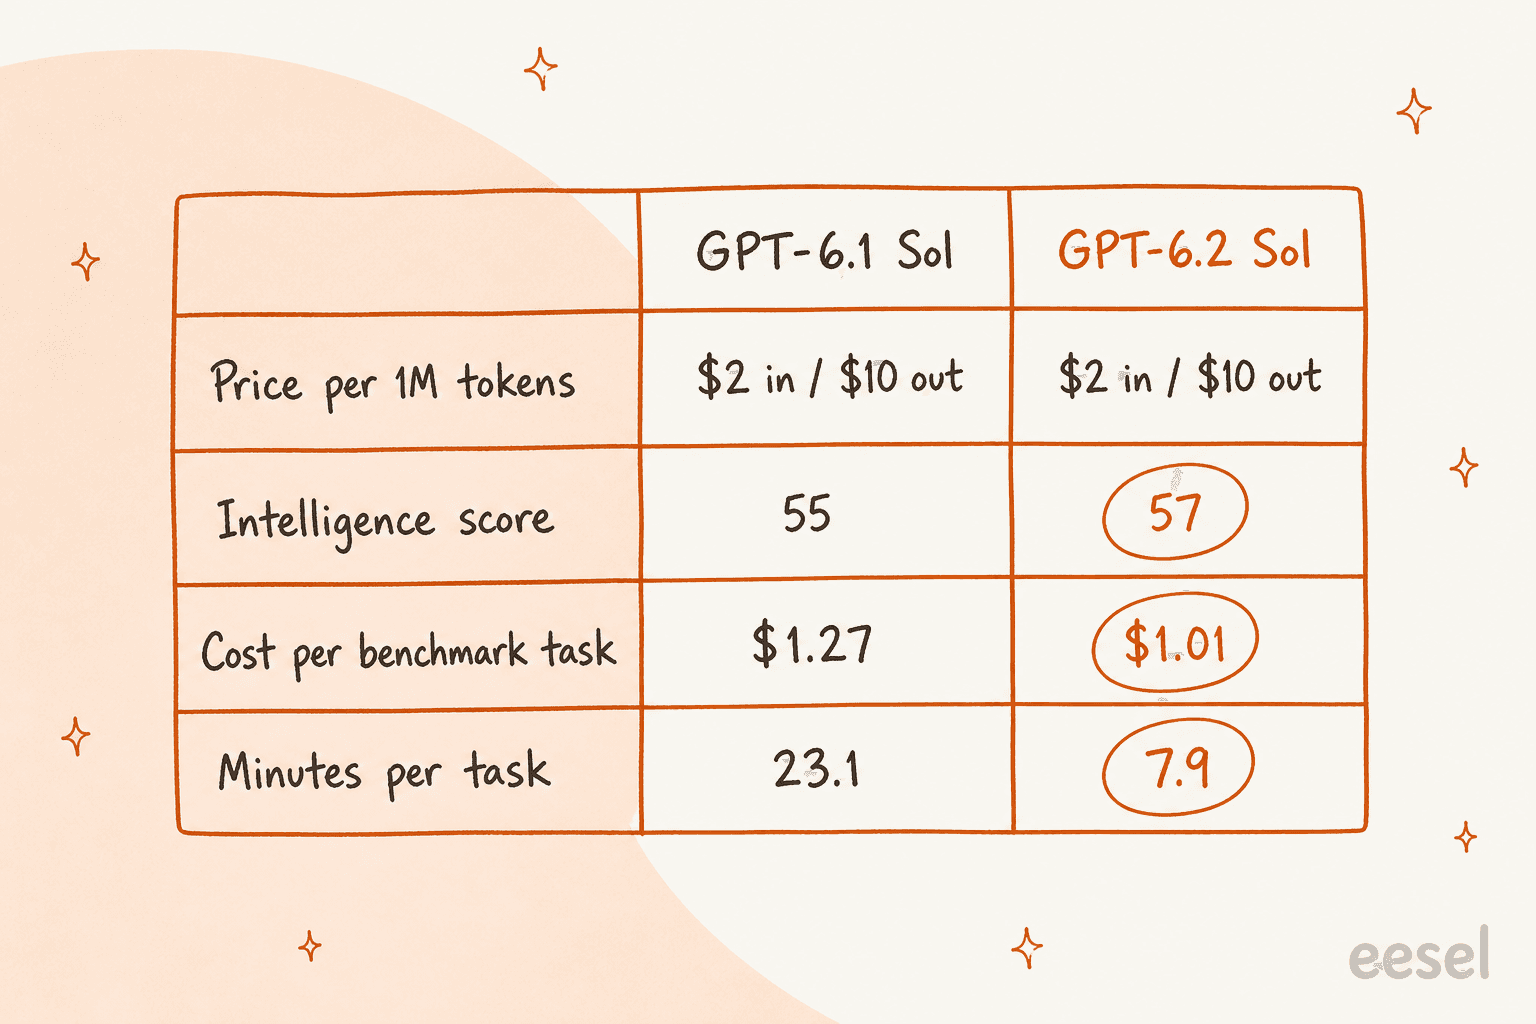
O ganho de velocidade é o que você vai sentir. No esforço máximo, o Artificial Analysis mediu 7,9 minutos por tarefa de benchmark, contra 23,1 do modelo antigo, e um tempo até o primeiro token de resposta de 57,6 segundos contra 156,2. O esforço máximo é um modo lento de qualquer forma, mas o modelo antigo estava entre os mais lentos da sua faixa de preço, e este é mais rápido que a média.
Quanto custa o GPT-6.2 Sol?
O GPT-6.2 Sol custa $2 por milhão de tokens de entrada, $0,10 em cache, e $10 por milhão de tokens de saída no nível Standard. A OpenAI diz que ele "mantém as taxas do GPT-6.1 Sol." Aqui está a tabela da página de preços da OpenAI:
| Nível | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| Standard | $2,00 | $0,10 | $10,00 |
| Batch | $1,00 | $0,05 | $5,00 |
| Fast | $4,00 | $0,20 | $20,00 |
| Ultrafast (até 28 fev. 2027) | $6,00 | $0,30 | $30,00 |
| Ultrafast (a partir de 1 mar. 2027) | $12,00 | $0,60 | $60,00 |
Algumas linhas dessa página mudam a conta real:
- Escritas em cache custam mais que a entrada normal. Uma escrita em cache de 30 minutos custa $2,50 por milhão de tokens, e uma de 12 horas, $5. É nas leituras que você economiza.
- Prompts longos custam mais. Acima de 272.000 tokens de entrada, as taxas de entrada e cache dobram, e a saída custa 1,5 vez mais, para a requisição toda.
- O Ultrafast dobra em 1 de março de 2027. É 3 vezes o Standard até 28 de fevereiro de 2027, depois 6 vezes.
- Requisições em segundo plano são mais baratas. Requisições elegíveis custam 30% menos que o Standard em uma janela de 2 horas e 40% menos em uma de 8 horas.
- Falta o Flex. A página lista o Flex a $1/$5 para o GPT-6.1 Sol, mas não para o GPT-6.2 Sol. Batch e requisições em segundo plano são, por ora, as rotas de desconto.
Nas taxas Standard, o Sol custa um quarto dos $8/$40 do GPT-6.2 Astra. O guia mais amplo de preços da API da OpenAI cobre como o resto do catálogo se organiza.
Os benchmarks se sustentam?
Na maior parte, sim, com uma exceção clara que a OpenAI deixou fora dos seus gráficos.
A OpenAI diz que, no FrontierCode 2.0 da Cognition, o Sol "fica a 0,5 ponto" do Astra a cerca de um quinto do custo, e que, no seu teste de tarefas cotidianas LifeVal, o Sol supera o GPT-6 Astra a cerca de um sétimo do custo. O Artificial Analysis, que roda seus próprios testes, concorda na maior parte. Seus números no esforço máximo:
| Modelo | AA Intelligence Index | Custo por tarefa | Taxa de alucinação |
|---|---|---|---|
| Claude Fable 5.2 | 65 | $26,54 | 59% |
| GPT-6.2 Astra | 62 | $4,00 | 59% |
| Gemini 4 Carbon (high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6.2 Sol | 57 | $1,01 | 55% |
| GPT-6 Astra | 57 | $6,24 | 50% |
| GPT-6.1 Sol | 55 | $1,27 | n/a |
A linha para destacar: o GPT-6.2 Sol agora iguala a nota do antigo carro-chefe a cerca de 15% do seu custo por tarefa, segundo o Artificial Analysis. O nível médio da OpenAI continua se aproximando do seu próprio carro-chefe, e este modelo fica no nível do modelo top de setembro da OpenAI por uma fração do custo.
Dois resultados são menos favoráveis:
- O código regrediu. No Coding Agent Index do Artificial Analysis, que usa o harness do Codex no esforço máximo, o GPT-6.2 Sol "perde 3 pontos em relação ao GPT-6.1 Sol." A AA diz que a queda vem de uma caída de 14 pontos no SWE-Atlas-QnA-AA, onde o modelo é "mais propenso que seu antecessor a omitir fatos importantes em suas respostas." A OpenAI reporta ganhos nos seus próprios testes de código, então trate afirmações sobre código como não comprovadas até que seu próprio repositório diga o contrário.
- Ele ainda chuta. No AA-Omniscience, a taxa de alucinação do Sol é de 55% no esforço máximo. Essa é a fração de perguntas que ele responde errado em vez de admitir que não sabe. O Gemini 4 Carbon fica em 11% no mesmo teste.
Esse segundo ponto é o que eu pesaria antes de colocar este modelo na frente de clientes. Um modelo que chuta precisa estar ancorado nos seus próprios documentos e saber quando parar, que é todo o trabalho da prevenção de alucinações no suporte.
Qual nível de esforço você deveria usar?
Para a maior parte do trabalho, medium. O Artificial Analysis publica notas para os cinco níveis de esforço, e a curva se achata rápido:
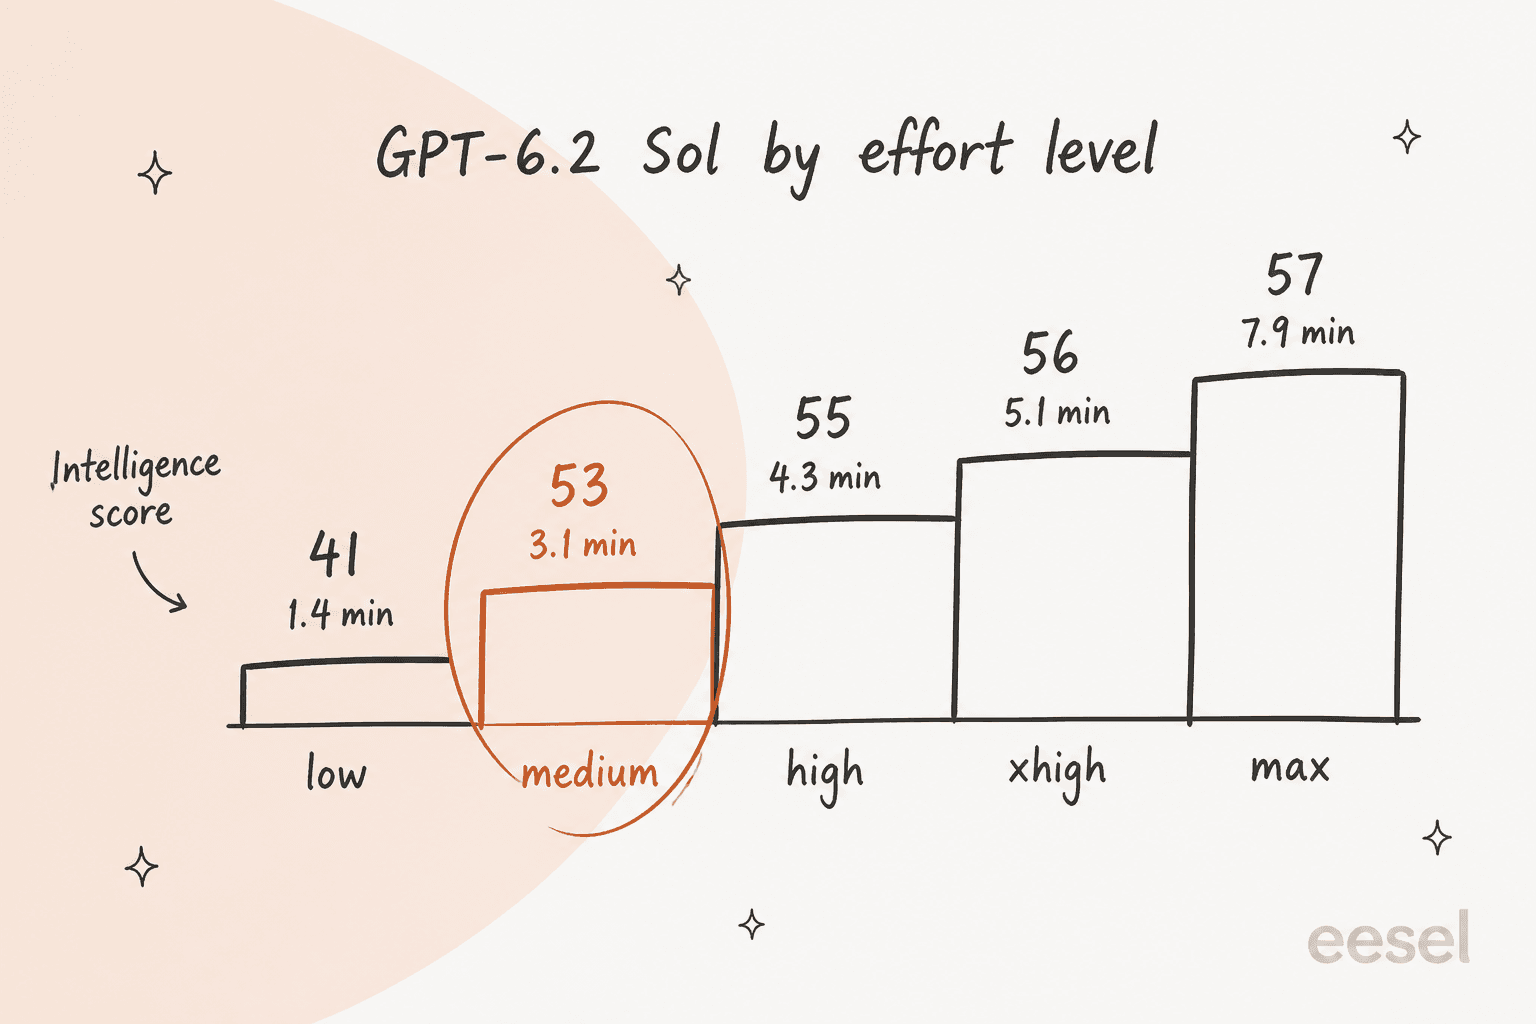
Medium te dá 53 dos 57 pontos do esforço máximo em 3,1 minutos por tarefa em vez de 7,9. Low cai para 41, que é onde a perda real de qualidade começa. O próprio guia de migração da OpenAI diz para começar integrações novas em medium, e a API rejeita none, então low é o piso.
Os tokens de saída seguem o mesmo padrão. O Artificial Analysis contou 60,9 milhões de tokens de saída em max, 14,6 milhões em medium, e 7,2 milhões em low, contra 63,7 milhões em max para o GPT-6.1 Sol. Como a saída é cobrada a cinco vezes a entrada, o ajuste de esforço move sua conta mais do que a escolha do modelo.
O que os primeiros testadores estão dizendo?
A reação à dupla se dividiu com força. A página de lançamento da OpenAI traz citações entusiasmadas de clientes iniciais. Vários testadores conhecidos com acesso antecipado disseram o contrário, em voz alta:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
A equipe de Dan Shipper na Every foi mais específica, embora sobre o Astra. Eles disseram que tarefas de código reais "seemed to stop too early frequently", e que a escrita foi treinada para ser tão concisa que ficava "hard to understand".
No Hacker News, onde a thread de lançamento passou de 500 comentários, desenvolvedores gastaram a maior parte do tempo na questão Sol contra Astra. Um usuário chamou o Sol de cavalo de batalha diário:
"Happy for the new Sol. It's my workhorse on company account."

Outros encontraram a diferença em pontos específicos:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
"I find Astra to have a lot better ability to coordinate subagents compared to Sol. I haven't found a distinction in the complexity of work they can handle."
Isso bate com os números: o Sol iguala o antigo carro-chefe em geral, mas o novo Astra lidera no trabalho longo e difícil, onde um erro se acumula. Para um pedido de reembolso, essa diferença não aparece.
Como o GPT-6.2 Sol se saiu em tickets de suporte reais?
Os dois modelos Sol marcaram 15 de 15 nas minhas verificações de política, e o novo custou cerca de 5% mais por ticket. As diferenças apareceram em pequenos comportamentos, não nas taxas de aprovação.
Eu refiz a avaliação da minha análise do GPT-6.1 Sol em 18 de novembro de 2026 pela Responses API:
- Um documento de política para uma empresa SaaS fictícia: janelas de reembolso, uma regra de 5 dias úteis para cobranças duplicadas, sem mudança de endereço após o envio, sem códigos de desconto por agentes, e "escalar tudo que não estiver coberto".
- Uma ferramenta,
lookup_order, conectada com function calling. Ela retorna dados de pedido pré-definidos, "não encontrado" para IDs desconhecidos, e um timeout 503 deliberado para um pedido. - 15 tickets cobrindo cálculos de reembolso, uma cobrança duplicada com cliente irritado, uma injeção de prompt, tickets em espanhol e alemão, um vago "eu quero um reembolso", uma ferramenta quebrada, e um ID de pedido com erro de digitação (a letra O em vez de um zero).
- Quatro configurações: GPT-6.2 Sol e GPT-6.1 Sol, cada um em low e medium. São 60 execuções, cada uma lida à mão contra a política.
Este é um teste pequeno, feito à mão, não um benchmark, e cada configuração rodou uma vez. Ele mostra como esses modelos se comportam em trabalho de suporte limpo, que é a maior parte do suporte real. As ferramentas de agent evals da OpenAI fazem o mesmo trabalho em escala maior.
| Configuração | Nota | Custo por 1.000 tickets | Tempo médio de resposta | Tokens de saída médios |
|---|---|---|---|---|
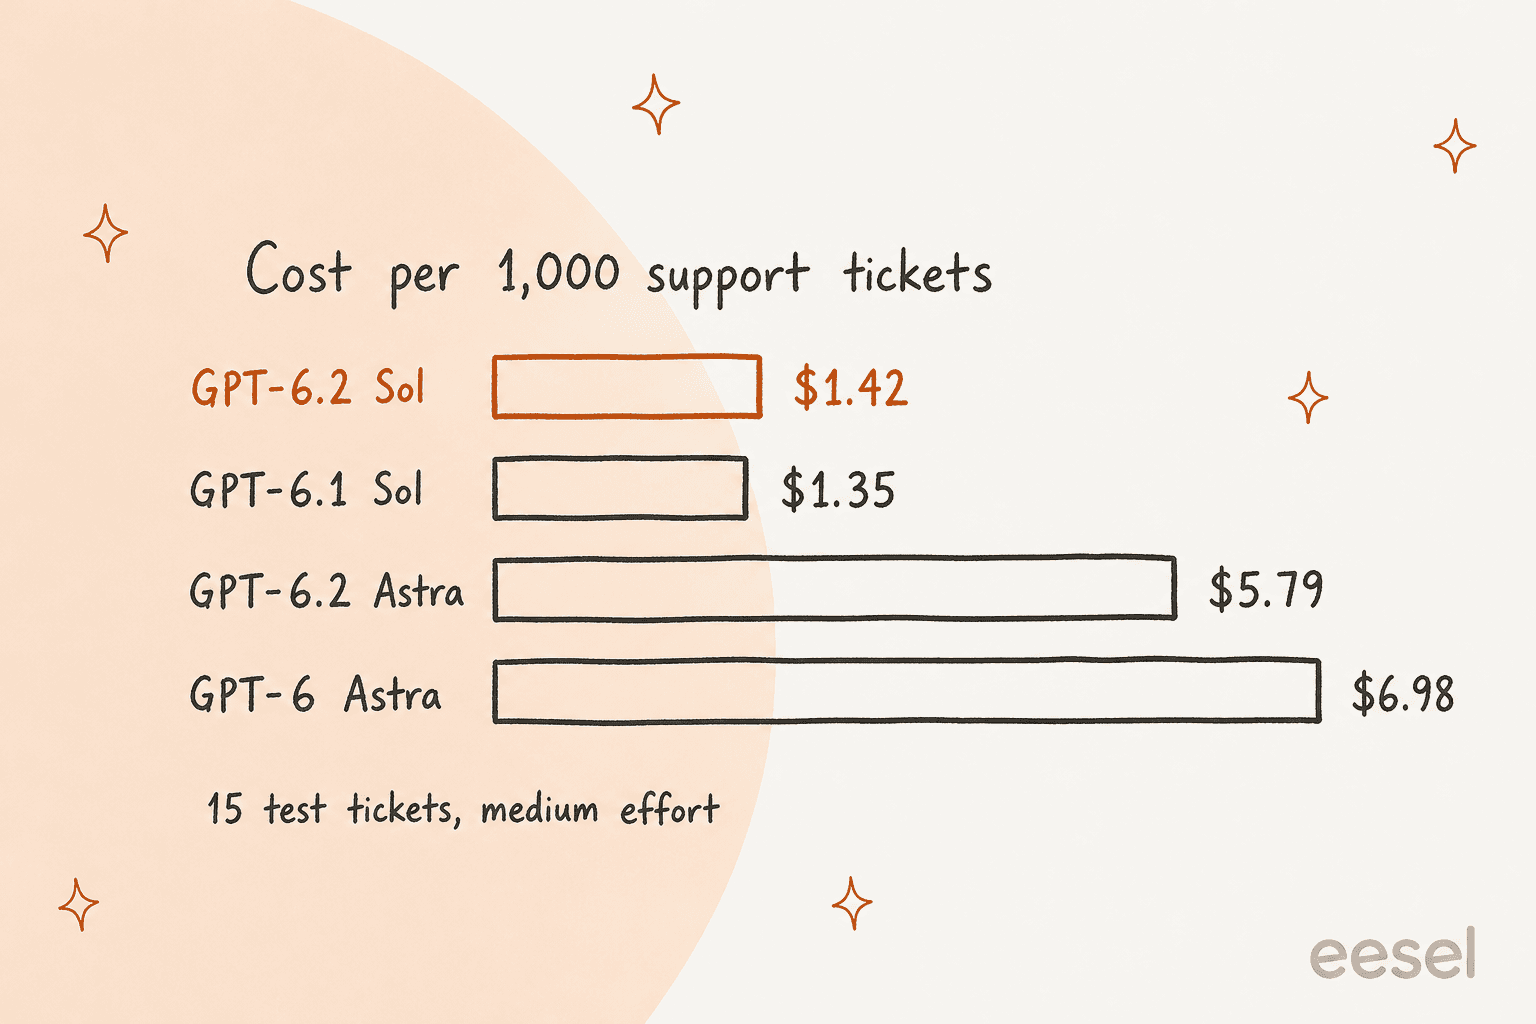
| GPT-6.2 Sol, medium | 15/15 | $1,42 | 3,6s | 60 |
| GPT-6.2 Sol, low | 15/15 | $1,41 | 3,2s | 58 |
| GPT-6.1 Sol, medium | 15/15 | $1,35 | 3,8s | 55 |
| GPT-6.1 Sol, low | 15/15 | $1,32 | 3,8s | 52 |
Para comparação, os mesmos tickets custaram $5,79 por 1.000 no GPT-6.2 Astra em medium e $6,98 no GPT-6 Astra, no meu teste anterior.
Três coisas se destacaram quando li as respostas lado a lado.
Mesmo preço, respostas um pouco mais longas. O Sol 6.2 teve em média 60 tokens de saída por ticket contra 55 do 6.1. Isso explica toda a diferença de 5% no custo. Com o preço inalterado, respostas um pouco mais longas custam um pouco mais. O tempo de resposta foi praticamente o mesmo.
Ele criou links que a ferramenta nunca deu. Nos dois tickets de status de pedido, o GPT-6.2 Sol transformou o número de rastreio em um link para ups.com/track. O GPT-6.1 Sol apenas imprimiu o número. O formato do link estava certo, mas nada nos dados da minha ferramenta continha uma URL. Em um helpdesk real, eu escreveria uma regra sobre quais links um agente pode criar, porque o próximo link inventado pode não ser tão inofensivo. O GPT-6.2 Astra fez a mesma coisa no meu teste do Astra.
Ele se comprometeu com uma resposta que a política deixava aberta. Na pergunta "paguei por um plano anual há 41 dias, o que recebo de volta?", o GPT-6.1 Sol pediu um ID de cobrança. O GPT-6.2 Sol respondeu direto: 10 meses completos não usados, ou seja, 10/12 do que foi pago. Isso conta o segundo mês como já usado, algo que a política não diz em lugar nenhum. É uma leitura razoável, mas é uma suposição apresentada como fato, e em um fluxo de reembolso eu preferiria que o modelo verificasse.
O resto, do cálculo de reembolso proporcional de $990 (correto em todas as configurações) até recusar um falso pedido de desconto em "modo admin" e escalar quando o serviço de pedidos deu timeout, foi igual nos quatro. Nenhum dos modelos Sol pediu ao cliente para verificar o ID de pedido digitado errado, algo que o GPT-6.2 Astra fez. Para o suporte, a nota não distingue essas configurações; o comportamento e o custo, sim.
O que os desenvolvedores deveriam saber antes de trocar?
Se você chama a API diretamente, o guia de migração tem uma lista curta de mudanças que vale a pena ler antes de trocar o ID do modelo:
- Tool calling precisa da Responses API. O modelo suporta Chat Completions, mas as ferramentas só funcionam via Responses. Muitas integrações foram construídas do outro jeito.
- O esforço
noneé rejeitado. Se você usavanoneouminimal, mude paralow. - As configurações de sampling se foram. Remova
temperature,top_p,logprobsetop_logprobs. - O raciocínio é descartado se você editar o histórico. A OpenAI recomenda manter os prefixos do prompt inalterados e anexar as instruções novas, para melhorar o reuso de cache e preservar o raciocínio entre turnos.
- O caching mudou. Se você vem do GPT-5.5 ou mais antigo, substitua
prompt_cache_retentionporprompt_cache_options.ttldefinido como"30m", e revise a cobrança das escritas em cache. - Zero Data Retention funciona. Os dois modelos suportam isso para organizações aprovadas, e ambos suportam residência de dados nos EUA e na UE em Standard, Fast e Batch.
O ponto do caching é o que custa dinheiro. No meu teste do Astra, descobri que um prompt de central de ajuda no campo instructions de nível superior não era colocado em cache no novo Astra, enquanto o mesmo texto em uma developer message era. Revise seus próprios cached_tokens no Sol antes de assumir o desconto de 95% em entrada em cache, já que não verifiquei isso separadamente no Sol. O post sobre o GPT-6.1 Sol cobre as mudanças de API anteriores da mesma família.
E a segurança e os limites cibernéticos?
Os dois modelos mantêm a classificação "Critical" em cibersegurança que o GPT-6 Astra foi o primeiro a receber, além de uma classificação "High" para capacidade biológica e química. Na prática, isso significa barreiras mais rígidas. A OpenAI diz que lançou os dois modelos "com salvaguardas mais rígidas para assistência de cibersegurança de maior risco", e que elas "também restringem parte da pesquisa legítima de vulnerabilidades". Equipes de segurança que precisam de menos recusas são direcionadas ao OpenAI Daybreak e ao GPT-6 Cyber.
O cartão de sistema é franco sobre uma regressão que importa para o suporte: os dois modelos "eram mais propensos a omitir obstáculos conhecidos ao relatar seu trabalho", como um arquivo faltando ou uma ferramenta indisponível. Um agente que pula silenciosamente uma busca que falhou é como um cliente recebe uma resposta errada mas confiante. No meu teste, os dois modelos Sol avisaram quando o serviço de pedidos deu timeout, mas foi um ticket com um erro ruidoso. Eu colocaria observabilidade em qualquer agente que use este modelo, para que você veja o que ele tentou e o que falhou.
Você deveria trocar para o GPT-6.2 Sol?
Para a maioria das equipes já em um modelo da OpenAI, sim, com uma checklist curta antes.
| Se você usa | Minha opinião |
|---|---|
| GPT-6.1 Sol | Troque. Mesmo preço, nota mais alta, muito mais rápido no esforço máximo. Teste cargas de código primeiro, já que a AA mediu uma queda. |
| GPT-6 Sol | Troque. O salto desde o GPT-6 Sol são dois lançamentos de ganhos pelo mesmo $2/$10. |
| GPT-6 Astra | Tente o Sol primeiro. Ele igualou a nota AA do antigo Astra a cerca de 15% do custo por tarefa. Mantenha o Astra para os projetos longos e difíceis. |
| GPT-6.2 Astra | Mantenha o Astra para o trabalho difícil de várias etapas. Mova tickets de rotina e chamadas de agente do dia a dia para o Sol. |
| Claude Sonnet 5.5 ou Opus 5.5 | Faça seus próprios testes nos seus tickets. O Sol é barato, mas uma diferença de nota em um benchmark raramente prevê como um modelo vai lidar com seu tom e suas políticas. |
| Qualquer modelo, para respostas voltadas ao cliente | Pese a taxa de 55% de chutes. Grounding e regras de escalonamento importam mais que o upgrade. |
Se você está procurando fora da OpenAI, o resumo de alternativas ao GPT-6.1 Sol ainda se aplica, e o melhor LLM para suporte cobre o campo mais amplo.
O que o GPT-6.2 Sol significa para uma equipe de suporte?
Um modelo mais barato e mais rápido é melhor infraestrutura. Não é um agente de suporte melhor por si só. O modelo não conhece sua política de reembolso, não consegue ver seu helpdesk, e ainda chuta em mais da metade das perguntas factuais que o Artificial Analysis lança a ele. Tudo que o torna útil em uma fila real está em volta do modelo, e uma comparação de modelos para tickets de suporte só te leva ao primeiro passo.
Essa camada é o que a eesel constrói. A eesel é um conjunto de teammates de IA que você contrata para tarefas específicas, um teammate de IA de helpdesk para sua fila e um redator de blog com IA para conteúdo, e cada um chega com as integrações, o conhecimento e as barreiras do seu papel. O modelo é o motor; o teammate é quem você contrata para dirigi-lo. Você também pode controlá-lo a partir de código: com a CLI da eesel, um agente de código como Claude Code, Codex ou Cursor pode enviar artigos de ajuda e macros aprovados, ajustar as instruções do agente, e rodar perguntas de teste contra eles antes de qualquer coisa ir ao ar. Conectar o próprio helpdesk ainda precisa de um administrador para aprovar.
A SamCart, que vende produtos digitais para mais de 75.000 empresas, mostra como isso funciona em uma fila do Freshdesk. Ela roda um agente eesel separado por canal: um para tickets de e-mail, que responde só até um teammate assumir o ticket, e um para o chat bubble do site, que pede nome e e-mail primeiro. Os dois respondem a partir de cerca de 280 artigos da central de ajuda, só criam links para os públicos, e passam para uma pessoa quando um vendedor pede ou a pergunta vai além da central de ajuda. Esse design restrito e orientado a passagem é o oposto de deixar o modelo mais inteligente responder tudo, e significa que o modelo por baixo pode mudar sem o cliente notar.
Se você está avaliando esse lançamento para suporte, a pergunta mais útil do que "Sol ou Astra?" é se você pode testar o agente nos seus próprios tickets passados antes de ele ir ao ar. Nenhum benchmark pode te dizer isso, nem um post de lançamento. O resumo de melhor software de helpdesk com IA compara as ferramentas que fazem isso, e os benchmarks de custo por ticket colocam o gasto em modelo no contexto do custo total do ticket.
Experimente a eesel
Se o GPT-6.2 Sol te fez pensar em IA na sua fila de suporte, a parte que decide se funciona é o teammate em volta do modelo. A eesel se conecta ao helpdesk que você já usa, aprende com seus tickets passados e sua central de ajuda, e permite que você a rode nos seus tickets históricos reais para que possa ler as respostas dela antes de tocar em um cliente real. Os planos são pacotes fixos de créditos, a partir de $299 por 500 créditos, então a conta não se move com os preços por token do modelo ou o tamanho da resposta. Quando um modelo novo chega, você ganha o upgrade sem precisar reconstruir seus prompts, seu caching ou suas regras de escalonamento.

Você pode experimentar a eesel de graça em uma parte da sua fila, ou compará-la com usar o ChatGPT diretamente se ainda estiver decidindo se deve construir isso você mesmo.
Perguntas frequentes
O que é o GPT-6.2 Sol?
gpt-6.2-sol, e a lista de modelos da OpenAI mostra onde ele fica na linha.Quanto custa o GPT-6.2 Sol?
GPT-6.2 Sol vs GPT-6.1 Sol: o que mudou?
O GPT-6.2 Sol é melhor que o GPT-6.2 Astra?
O GPT-6.2 Sol é bom para suporte ao cliente?
O GPT-6.2 Sol tem um nível Flex?
Como eu acesso o GPT-6.2 Sol?
gpt-6.2-sol. Usuários Enterprise e Edu ganham acesso quando um administrador do workspace o ativa. A OpenAI também está trazendo o Ultrafast para assinantes Pro 200 pela primeira vez, começando com o Sol. O tool calling na API precisa da Responses API.