O que é a OpenAI Decisions API?
A Decisions API é um novo endpoint da OpenAI para uma tarefa estreita: escolher entre opções que você define de antemão. Assim o resumo da DevDay 2026 da OpenAI a descreve:
"Decisions API enables real-time decision-making by focusing Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers. Developers supply context using text or images, and get back answers they can use to classify content, route requests, or choose an agent's next action."
Eu construo agentes de IA para viver, e a maioria das chamadas de modelo dentro de um agente não escreve nada. São pequenas bifurcações no caminho, como qual equipe é dona deste ticket ou se isso precisa de uma pessoa. Um modelo geral responde bem a isso, só que pelo caminho lento, gerando texto primeiro. A Decisions API é a aposta da OpenAI de que esse tipo de chamada merece uma pista própria.
Ela fica ao lado dos lançamentos maiores da DevDay, como os agentes sempre ativos do OpenAI Dots, o modelo GPT-6.1 Sol e o Codex Security Cloud.
Teve menos tempo de palco que esses. O trecho da keynote dura menos de um minuto, começando por volta dos 22:15 da keynote, e na mesma semana também chegou o ChatGPT Space. Mesmo assim, se você cuida de uma fila de suporte, este é o lançamento que mais se encaixa no seu trabalho diário.
Como funciona a Decisions API?
Você envia três coisas e recebe uma. O fluxo, até onde a OpenAI o descreveu, é este:
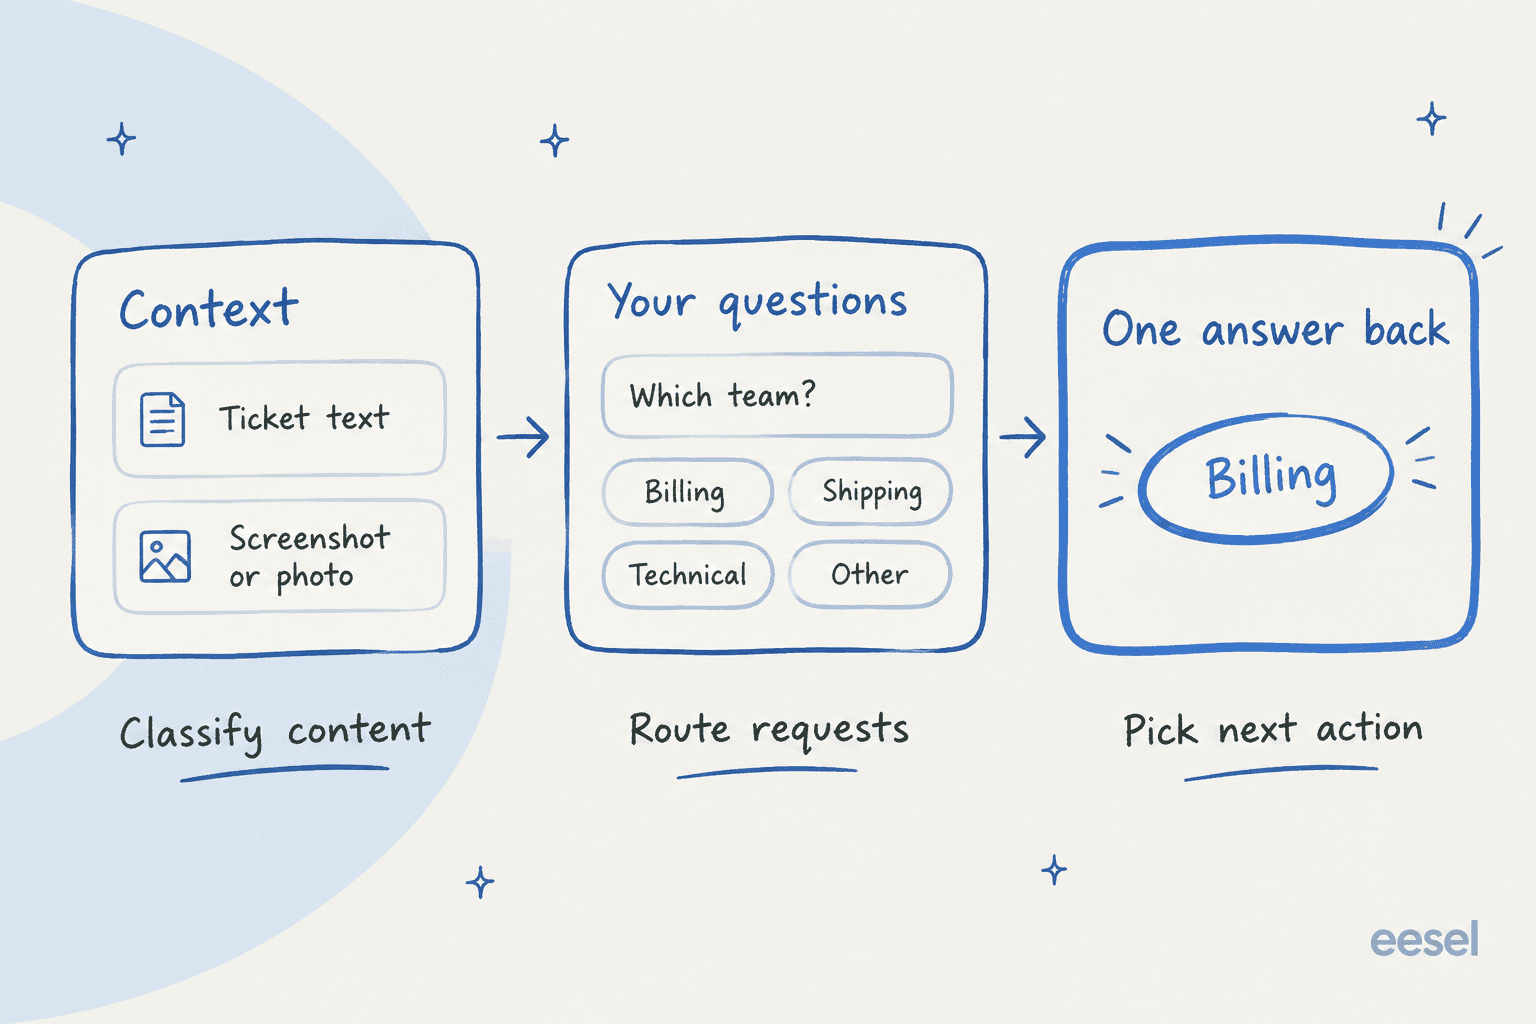
- Contexto. Texto ou imagens, ou seja, o corpo de um ticket, a transcrição de um chat ou uma foto do produto anexada pelo cliente.
- Perguntas com respostas finitas. Você define cada pergunta, mais a lista completa de respostas que ela pode devolver.
- Uma seleção de volta. Uma resposta da sua lista, e então o seu código age.
O exemplo de suporte veio na verdade da própria conta de desenvolvedores da OpenAI, em um thread do @OpenAIDevs:
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use."
Por baixo dos panos ela roda no GPT-6 Luna, que a OpenAI chama de seu "most efficient model for focused, high-volume tasks" na página do modelo Luna. A keynote explica a velocidade dizendo que um conjunto predefinido de opções é o que permite ao Luna responder em uma fração de segundo. Nada precisa ser escrito palavra por palavra, então há menos a esperar.
Se você planeja construir em cima dela, as partes que a OpenAI ainda não explicou importam quase tanto:
- O schema da requisição e da resposta, já que não há página de referência da API.
- Se uma chamada pode levar várias perguntas e quantas respostas cada pergunta pode ter.
- Se a resposta traz uma pontuação de confiança. A imprensa diz que sim, mas não achei nenhuma página ou publicação da OpenAI que cite uma.
- A unidade de cobrança e os limites de uso, e também se Batch ou Flex se aplicam.
Um leitor do Hacker News arriscou um palpite sobre o mecanismo no thread da DevDay: "I think they simply use the LLMs softmax scores (uncalibrated confidence)". É uma leitura plausível, mas ninguém confirmou.
Dá para usar a OpenAI Decisions API já?
Só se a OpenAI escolheu você. O resumo diz que está "available in limited preview today with a broad release planned in the coming days", e o thread da OpenAI Developers acrescenta que "preview access is limited to selected API customers for testing."
Fui conferir o que isso significa na prática. POST https://api.openai.com/v1/decisions é uma rota real, e uma chave padrão recebe esta resposta dela:
{"error":{"message":"Decision API is not enabled for this user.","type":"invalid_request_error","param":null,"code":null}}
Isso é um HTTP 403, ou seja, um bloqueio de recurso e não uma rota inexistente. Caminhos próximos como /v1/decisions/create e /v1/beta/decisions retornam 404. O bloqueio dispara até com corpo vazio, então os erros também não revelam nada sobre o formato da requisição. Recebi o mesmo 403 em 1º de outubro e de novo em 2 de outubro, três dias depois da promessa de “nos próximos dias”.
O rastro documental também é fino. Em 2 de outubro:
| O que eu verifiquei | Resultado |
|---|---|
Guia da documentação (/api/docs/guides/decisions) | 404 |
Referência da API (/api/reference/decisions) | 404 |
| Changelog da API, entradas de 29 set | Sem entrada da Decisions API |
| Página de preços da API | Sem linha da Decisions API |
| Post de anúncio próprio | Nenhum, só o resumo da DevDay |
GET /v1/models | Nenhum ID de modelo contendo "decision" |
Então, por enquanto, a Decisions API é uma promessa e um endpoint restrito. Isso é bem normal numa prévia, mas significa que você não consegue testá-la sob carga, precificá-la nem ler seus limites.
O que a Decisions API acrescenta aos structured outputs?
Um comentarista do HN fez a pergunta óbvia poucas horas depois do lançamento:
"It seems a bit silly since OpenAI LLMs already can output structured data."

É um bom ponto. Você já pode fazer o Luna responder a partir de uma lista fixa hoje: use a Responses API, defina o reasoning como none e passe um JSON schema estrito cujo único campo é um enum das suas respostas. Abaixo está a requisição exata que rodei enquanto a Decisions API continuava restrita:
{"model":"gpt-6-luna","reasoning":{"effort":"none"},
 "input":[{"role":"developer","content":"Route the support ticket. Which queue?"},
          {"role":"user","content":"I was charged twice for my order #4471"}],
 "text":{"format":{"type":"json_schema","name":"route","strict":true,
   "schema":{"type":"object","properties":{"queue":{"type":"string","enum":["billing","shipping","technical","other"]}},
   "required":["queue"],"additionalProperties":false}}}}
Ela voltou {"queue":"billing"} nas três execuções, usando 60 tokens de entrada e 12 de saída. Isso dá $0.000012 por chamada nas tarifas Standard do Luna. Quem já usou o function calling da OpenAI conhece a ideia, só que com rédea mais curta, e é também a configuração por trás da maior parte do roteamento de tickets com IA para SaaS hoje.
Há uma pegadinha, porém, que um comentarista levantou em um thread anterior do HN sobre OpenAI e Jev:
"It's not guaranteed to be correct: it's guaranteed to be formatted in a particular way. You can get the same thing with grammars on any LLM."
Então o problema do formato já está resolvido. O que a Decisions API promete a mais é velocidade, além do que o ajuste de precisão de "focusing Luna's intelligence" acabar significando. Com o que é público até agora, as duas opções se comparam assim:
| Decisions API | Luna + structured outputs | |
|---|---|---|
| Status | Prévia limitada, clientes selecionados | Disponível agora |
| Entrada | Texto ou imagens | Texto e imagens |
| Saída | "A selection" das suas respostas | JSON que bate com o seu schema |
| Velocidade | "Less than a few hundreds of milliseconds end to end" (afirmação de funcionário da OpenAI) | Mediana de 1,46 s no meu teste |
| Preço | Não publicado | $0.10 entrada / $0.50 saída por 1M de tokens |
| Pontuação de confiança | Não confirmada | Nenhuma por padrão |
| Documentação | Ainda nenhuma | Guia de structured outputs |
Qual é a velocidade da Decisions API?
A única afirmação escrita da OpenAI sobre velocidade vem de um funcionário, não há nada na documentação. Thibault Sottiaux, que trabalha na OpenAI, postou no dia do lançamento:
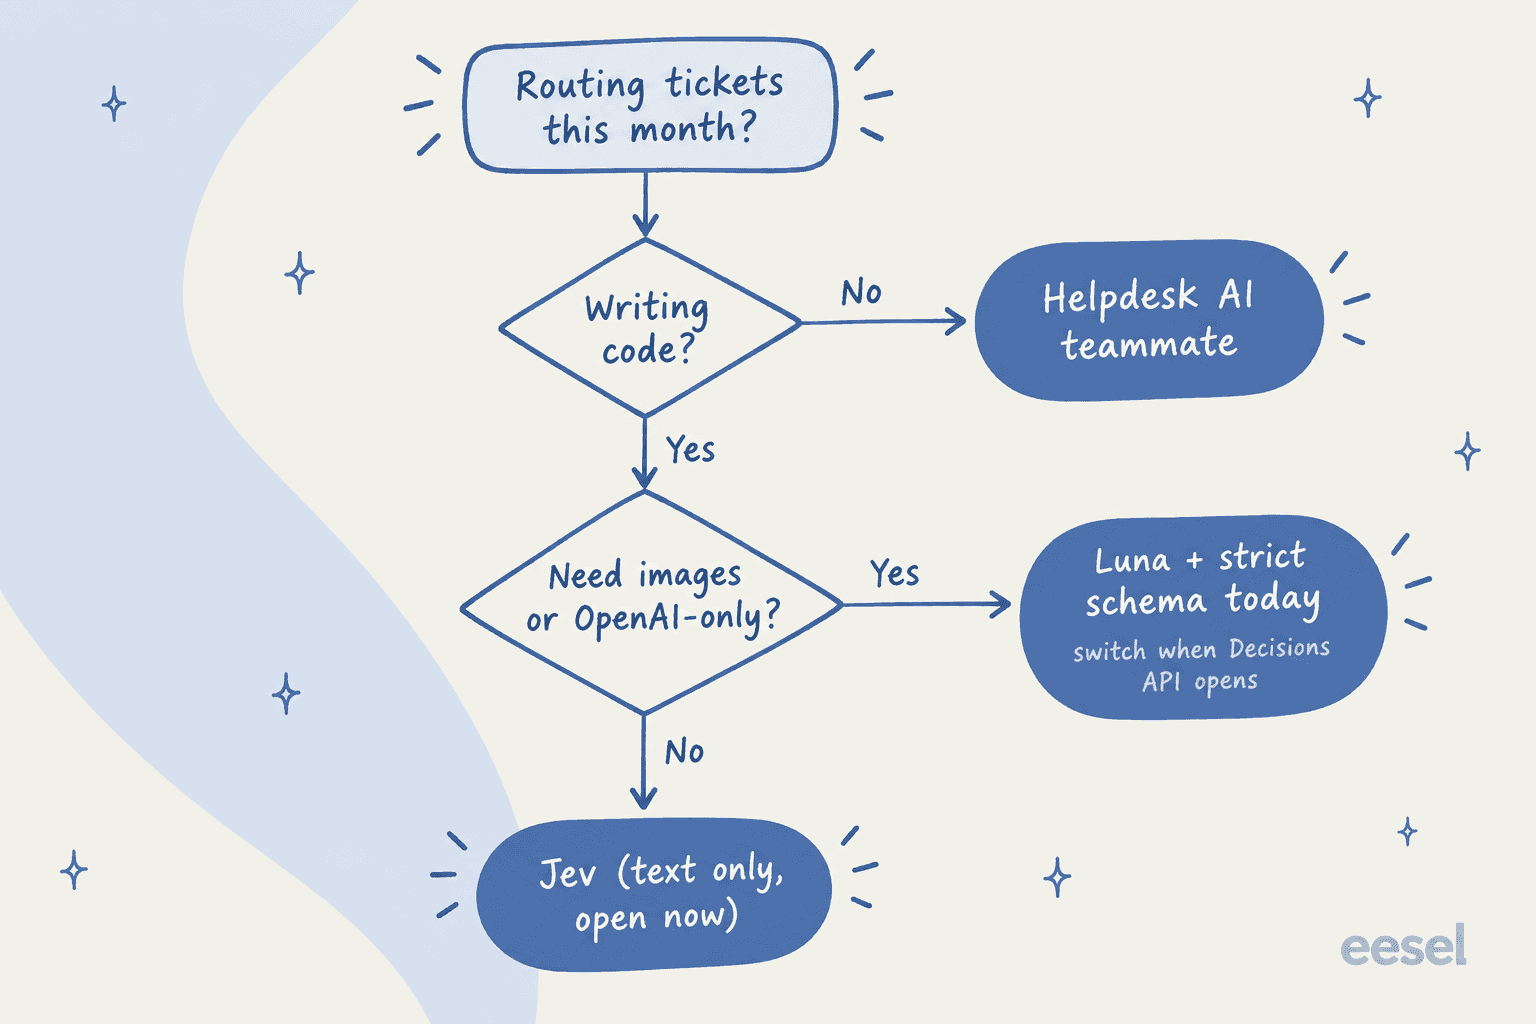
"Decisions API, for lightning fast constrained decision making powered by Luna. Supports visual inputs, and tuned to be able to make decisions in less than a few hundreds of milliseconds end to end."
Para ver o que ela teria que superar, passei 20 tickets de suporte pelo Luna duas vezes por configuração e pedi uma fila e uma prioridade, além de saber se o ticket era seguro para resposta automática. São 160 chamadas no total, cronometradas de ponta a ponta a partir de um notebook, então o tempo de ida e volta da rede está incluído.
| Configuração (meu teste) | Mediana | Mais rápida | Mais lenta |
|---|---|---|---|
| GPT-6 Luna, reasoning none | 1,46 s | 0,95 s | 2,79 s |
| GPT-6 Luna, reasoning low | 1,62 s | 0,95 s | 3,20 s |
| GPT-6 Luna, reasoning medium | 2,33 s | 1,44 s | 5,75 s |
| GPT-6.1 Sol, reasoning low | 2,17 s | 1,52 s | 4,98 s |
Se a afirmação da OpenAI se confirmar, a Decisions API seria cerca de cinco vezes mais rápida que a minha melhor configuração do Luna. Onde essa diferença importa e onde não:
- Triagem de e-mail e tickets. Na verdade não. Ninguém percebe se um ticket foi etiquetado em 300 ms ou em 1,5 segundo.
- Chat ao vivo. Sim. Uma pausa de 1,5 segundo antes de o bot sequer decidir quem deve responder se acumula ao longo de uma conversa.
- Agentes. É onde mais importa. Um agente construído com algo como o OpenAI AgentKit que faz 20 pequenas escolhas por tarefa espera 30 segundos no Luna, contra alguns segundos na velocidade afirmada.
Parte da imprensa mostra um gráfico de "150 ms vs 1.6 s". Não consegui encontrar esses números em nenhuma página ou publicação da OpenAI, então eu não planejaria nada em cima deles antes de a documentação sair.
Como ela se compara ao TypeSafe Jev?
É difícil falar deste lançamento sem mencionar o TypeSafe Jev. A TypeSafe lançou o Jev em 15 de setembro como um modelo feito só para decisões tipadas, e a Decisions API apareceu duas semanas depois. Um comentarista do HN disse sem rodeios no thread da DevDay: "Decisions API is a validation for Jev and the entire space it created."
Pelo que cada empresa publicou, elas se alinham assim:
| OpenAI Decisions API | TypeSafe Jev | |
|---|---|---|
| Acesso | Prévia limitada | Aberto a todos desde 27 set |
| Entrada | Texto ou imagens | Só texto, segundo a página de modelos do Jev |
| Tipos de pergunta | Perguntas com respostas fixas | Choice, Score e Noul (probabilidade de verdadeiro ou falso) |
| Saída | Uma seleção | Escolha mais probabilidades e confiança |
| Preço | Não publicado | $0.042 por 1M de tokens de entrada, saída grátis |
| Velocidade | "Less than a few hundreds of milliseconds" | "70ms-500ms" de ponta a ponta, segundo o post de lançamento |
| Opções por pergunta | Não publicado | Até 255 por Choice |
| Limites de uso | Não publicado | 100K tokens/s ou 40 requisições/s |
Para a maioria das equipes, tudo se resume a duas linhas. O Jev não aceita imagens, então se a sua fila está cheia de capturas de tela e fotos de danos, isso aponta para a OpenAI. Do outro lado, o Jev devolve uma probabilidade com cada resposta, e é exatamente isso que você precisa para decidir quando não agir.
Minha análise do Jev cobre como ele se saiu nos testes. Para a conta das tarifas, o detalhamento dos preços do Jev traz tudo, incluindo o nível mais rápido Jev Ultrafast.
Em preço, a comparação inicial com o Luna já pende para o Jev:
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
Lembre que esse é o preço de tabela do Luna, não um preço da Decisions API. A OpenAI poderia precificar o endpoint de forma bem diferente quando ele abrir.
Para que usar a Decisions API em suporte?
A OpenAI citou três tarefas, e cada uma tem uma versão clara em suporte:
- Classificar conteúdo. Etiquetar um ticket por intenção, produto ou sentimento, detectar spam ou distinguir um pedido de reembolso de uma devolução.
- Rotear pedidos. Enviar um ticket para cobrança, envio ou técnico, ou para uma fila por idioma ou nível. É o clássico roteamento inteligente, a tarefa que a OpenAI usou como seu próprio exemplo. O mesmo padrão funciona para roteamento em e-commerce.
- Escolher a próxima ação de um agente. Decidir se ele deve consultar o pedido, fazer uma pergunta de esclarecimento, responder ou escalar para uma pessoa, normalmente com base em detecção de intenção.
As duas primeiras são o que a maioria das equipes quer dizer com triagem de tickets, e as decisões tipadas já funcionam bem aí. A maioria dos helpdesks também traz alguma versão nativa, da triagem automática do Freshdesk a uma longa lista de apps de classificação para Zendesk. Num teste com tráfego real em uma loja virtual de joias com cerca de 1.000 tickets por mês no Zendesk e Shopify, as chamadas tipadas da eesel alcançaram 93% de precisão na triagem e pegaram 100% do spam sem nenhum falso positivo, e o spam era 22% daquela caixa de entrada.
Meu próprio teste mostrou onde os problemas começam. Toda configuração acertou a fila 40 de 40 vezes. Em “é seguro responder automaticamente?”, porém, o Luna sem reasoning acertou 33 de 40, e até o GPT-6.1 Sol só 39 de 40. Rotear é a parte fácil; saber quando não agir é a difícil. Uma fila errada custa alguns minutos, enquanto uma resposta automática errada vai direto para um cliente.
Os compradores traçam a linha no mesmo lugar. Um líder de CX de uma marca de suplementos com cerca de 7.000 tickets por mês no Gorgias disse à eesel numa call de vendas que não conseguiam conferir à mão cada resposta da IA, então a IA tinha que ficar fora de tudo de que não tivesse certeza:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Um endpoint de decisões dá a resposta. A menos que ele também devolva uma confiança calibrada, ele não diz quando deixar um ticket em paz, então essa regra continua sendo sua para construir. Antes de confiar uma ação a qualquer classificador, vale ler sobre falsos positivos em etiquetagem com IA.
Quanto a Decisions API vai custar?
Ninguém fora da OpenAI sabe ainda. Não há linha de preço, e a OpenAI não disse se cobra por token, por chamada ou por pergunta. Por ora, a única referência pública é a própria tabela do Luna:
| Nível do GPT-6 Luna | Entrada por 1M | Entrada em cache por 1M | Saída por 1M |
|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.50 |
| Batch / Flex | $0.05 | $0.005 | $0.25 |
| Fast | $0.20 | $0.02 | $1.00 |
Nessas tarifas, meu teste de 160 chamadas custou $0.047 por 1.000 tickets sem reasoning e $0.089 com esforço médio. Até um mês de 10.000 tickets fica bem abaixo de um dólar. A conta completa e os custos ocultos, além da briga de preço com o Jev, estão no meu post sobre os preços da Decisions API, e o guia mais amplo de preços da API da OpenAI traz a tarifa de cada modelo. Só pelo preço, a decisão nunca é a parte cara de uma stack de suporte.
Você deve construir em cima da Decisions API agora?
Ainda não, a menos que você esteja na prévia. Você ainda pode construir o mesmo recurso hoje e trocar o endpoint depois. É assim que eu decidiria:
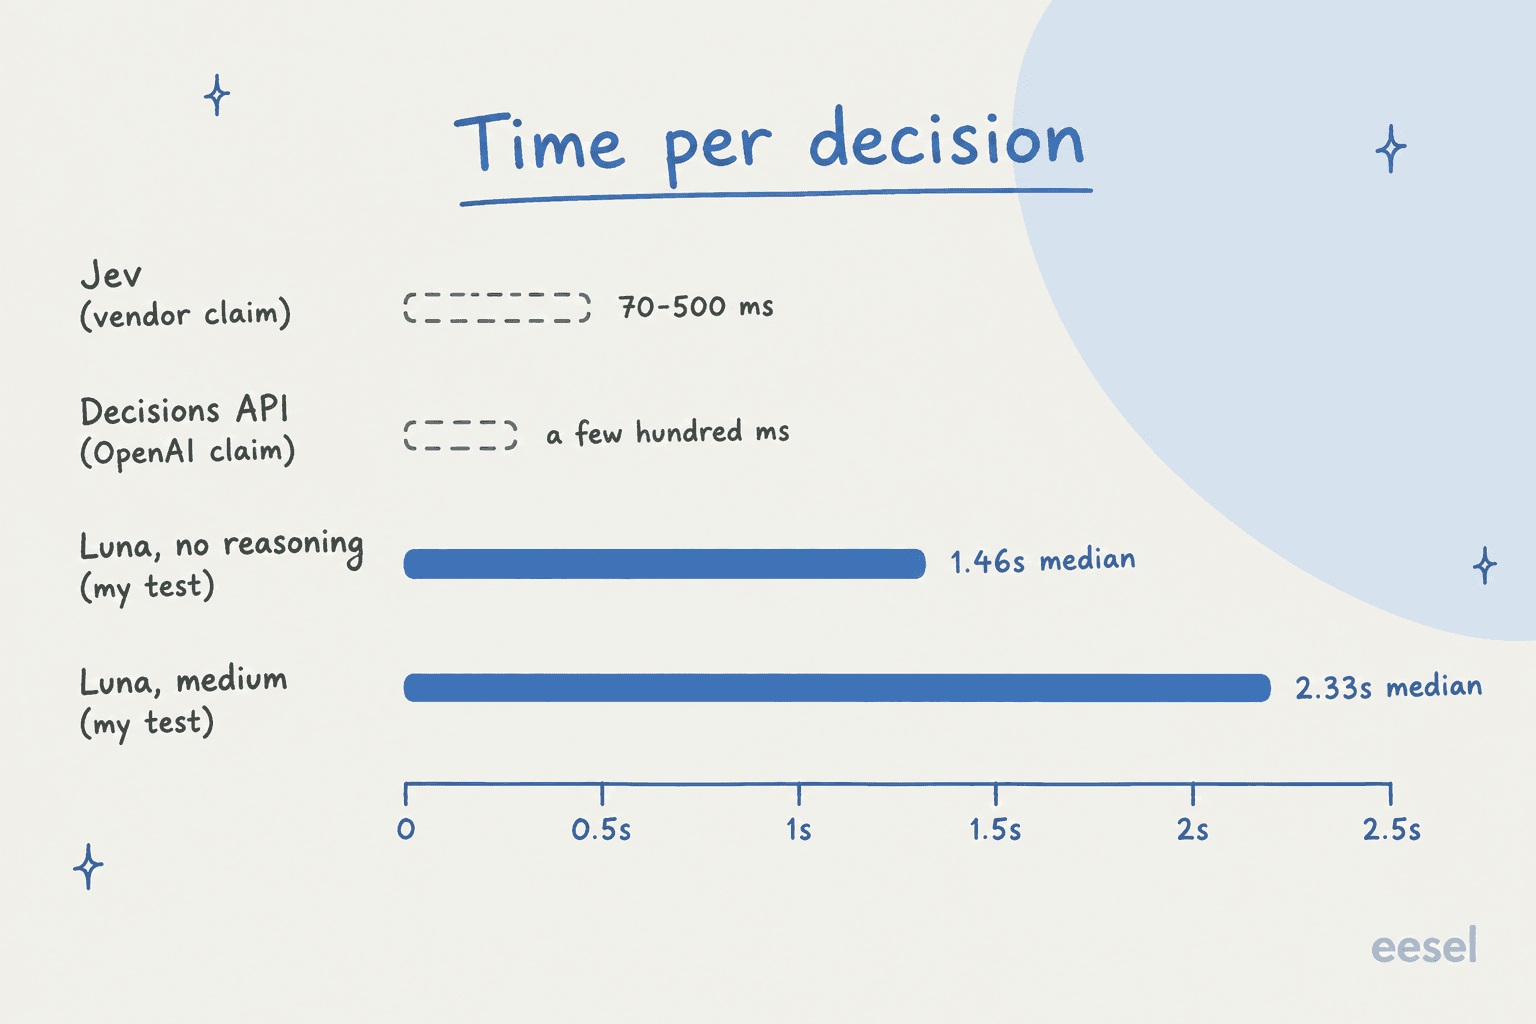
- Você escreve código e fica na OpenAI. Lance o Luna com um schema enum estrito e reasoning em
noneoulow. Mantenha as perguntas e a lista de respostas em um só lugar, assim migrar para/v1/decisionscontinua sendo uma mudança pequena. O post de alternativas ao Luna cobre outros modelos pequenos se você quiser um plano B, como o Gemini 3.5 Flash-Lite. - Você precisa de respostas abaixo de um segundo em texto. Teste o Jev agora. Ele é aberto e tem preço, e também devolve probabilidades. A lista de alternativas ao Jev cobre o resto desse campo.
- Suas entradas são imagens. Fique com a OpenAI. O Luna aceita imagens hoje, e segundo o changelog da API a OpenAI corrigiu em 25 de setembro um bug de codificação de imagem que havia "degraded image understanding", então rode de novo qualquer avaliação de imagem mais antiga.
- Você quer roteamento dentro do Zendesk ou Freshdesk, não uma API. Então pode pular de vez a questão do endpoint. Comece pelo meu guia sobre como automatizar a triagem de tickets, ou pelo resumo da melhor IA para triagem de tickets. Equipes de Zendesk também podem comparar o Zendesk Intelligent Triage.
Sobre o momento, os céticos têm um ponto:
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
Eu seria menos duro. Uma prévia restrita sem preço é normal, e a entrada de imagem é uma diferença real. Ainda assim, “sem documentação, sem preço, sem benchmarks” é motivo suficiente para não basear um roadmap nela esta semana.
eesel para roteamento de tickets com confiança
A Decisions API é infraestrutura. Ela escolhe uma resposta da sua lista, e tudo em volta dessa resposta você ainda precisa construir, como a conexão com o helpdesk e as etiquetas, a regra de “enviar para uma pessoa” e um registro do que ela fez. A eesel é o colega que já faz esse trabalho. O colega de helpdesk com IA entra na sua fila no Zendesk ou no Freshdesk, aprende com a sua central de ajuda e com tickets antigos, e então roteia, etiqueta e responde, com regras de escalonamento que você escreve em linguagem simples.

Segundo o meu teste, a parte que mais importa é a decisão de “é seguro responder automaticamente?”, e é aí que a eesel concentra seu esforço. Antes de tocar numa fila ao vivo, a eesel reproduz centenas dos seus tickets antigos e pontua suas respostas contra o que sua equipe realmente enviou, para que as decisões arriscadas apareçam antes de um cliente vê-las. Qualquer ticket de que ela não tenha certeza vai para uma pessoa.
Se você chegou aqui porque prefere construir com código, a CLI da eesel roda o mesmo colega e o mesmo workspace a partir de um terminal. eesel instructions edita as regras de roteamento, eesel activity lista cada ticket que ela tocou e eesel approvals deixa uma pessoa aprovar uma ação antes que ela aconteça. Todo comando imprime JSON e aceita --dry-run, então scripts e agentes de código como Claude Code ou Cursor podem operá-lo, e cada workspace também funciona como um servidor MCP.
Os preços são por ticket, não por token: um ticket ou chat é um crédito, os planos começam em $299 por 500 créditos e o plano gratuito dá 100 créditos sem cartão. Experimente a eesel numa fatia da sua fila e veja em quais tickets ela tem confiança suficiente para assumir.
Perguntas frequentes
O que é a OpenAI Decisions API?
A OpenAI Decisions API já está disponível?
Quanto custa a OpenAI Decisions API?
Como a Decisions API é diferente dos structured outputs?
A OpenAI Decisions API é uma cópia do TypeSafe Jev?
Posso usar a OpenAI Decisions API para rotear tickets de suporte?
A Decisions API devolve uma pontuação de confiança?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.