

O Meta Muse Spark 1.3 é um modelo genuinamente forte em programação e contexto longo, lançado em 2026-09-02, e ele merece a manchete: um Artificial Analysis Intelligence Index de 62 para o nível mais alto, 6º de 636 modelos. Mas três coisas moderam o entusiasmo. Primeiro, o nível que marca 62 é o max, e o raciocínio max ainda estava restrito por testes de segurança no lançamento, então o nível que você realmente consegue rodar é o xhigh. Segundo, o discurso da Meta de "agentes melhorados" é na verdade uma história de programação melhorada: o Opus 5 max ainda o supera em quatro de seis linhas de agentes no gráfico da própria Meta. Terceiro, ele é verboso, gastando cerca de 3x os tokens do Muse Spark 1.2, então sua conta real fica à frente da tarifa de tabela.
O preço é a parte mais interessante: um endpoint padrão a $1.25 / $4.25 por milhão (dados privados) ao lado de um endpoint de contribuidor a cerca de $0.10 / $0.20 (a Meta treina com o seu tráfego). Se você está avaliando isso para atendimento ao cliente, lembre-se de que um modelo é infraestrutura, não um colega de trabalho. A eesel oferece um agente de suporte de IA pronto para trabalhar que roda em modelos como este, se conecta ao seu helpdesk e simula com seus tickets anteriores antes de responder a qualquer pessoa.
O que "análise" significa aqui, e o que eu não consegui testar
Eu construo integrações e APIs para viver, então quando leio o lançamento de um modelo me interesso menos pelo comunicado de imprensa e mais pelo que a coisa faz depois de conectada. Essa é a lente desta análise. Li com atenção o blog de pesquisa da Meta e a metodologia de avaliação, tirei os números da Artificial Analysis e li todo o tópico de lançamento no Hacker News, onde 261 comentários apareceram em um dia.
O que eu não consegui fazer foi rodar o max de ponta a ponta, e isso não é um atalho meu. O próprio blog da Meta diz que os modos de raciocínio antes disponíveis saem hoje "with max reasoning coming shortly after we finish additional safety testing." Então o modo que marca 62 não é o modo que a maioria das pessoas consegue chamar ainda. Quando falo de comportamento ao vivo, me refiro ao xhigh, o nível que realmente está disponível, que marca 61. Tenha essa diferença em mente pelo resto do texto, porque o marketing da Meta não tem.
O gráfico que a Meta quer que você leia
Toda análise do Muse Spark 1.3 vai abrir com este painel, então vou mostrá-lo e depois dizer o que ele não diz.
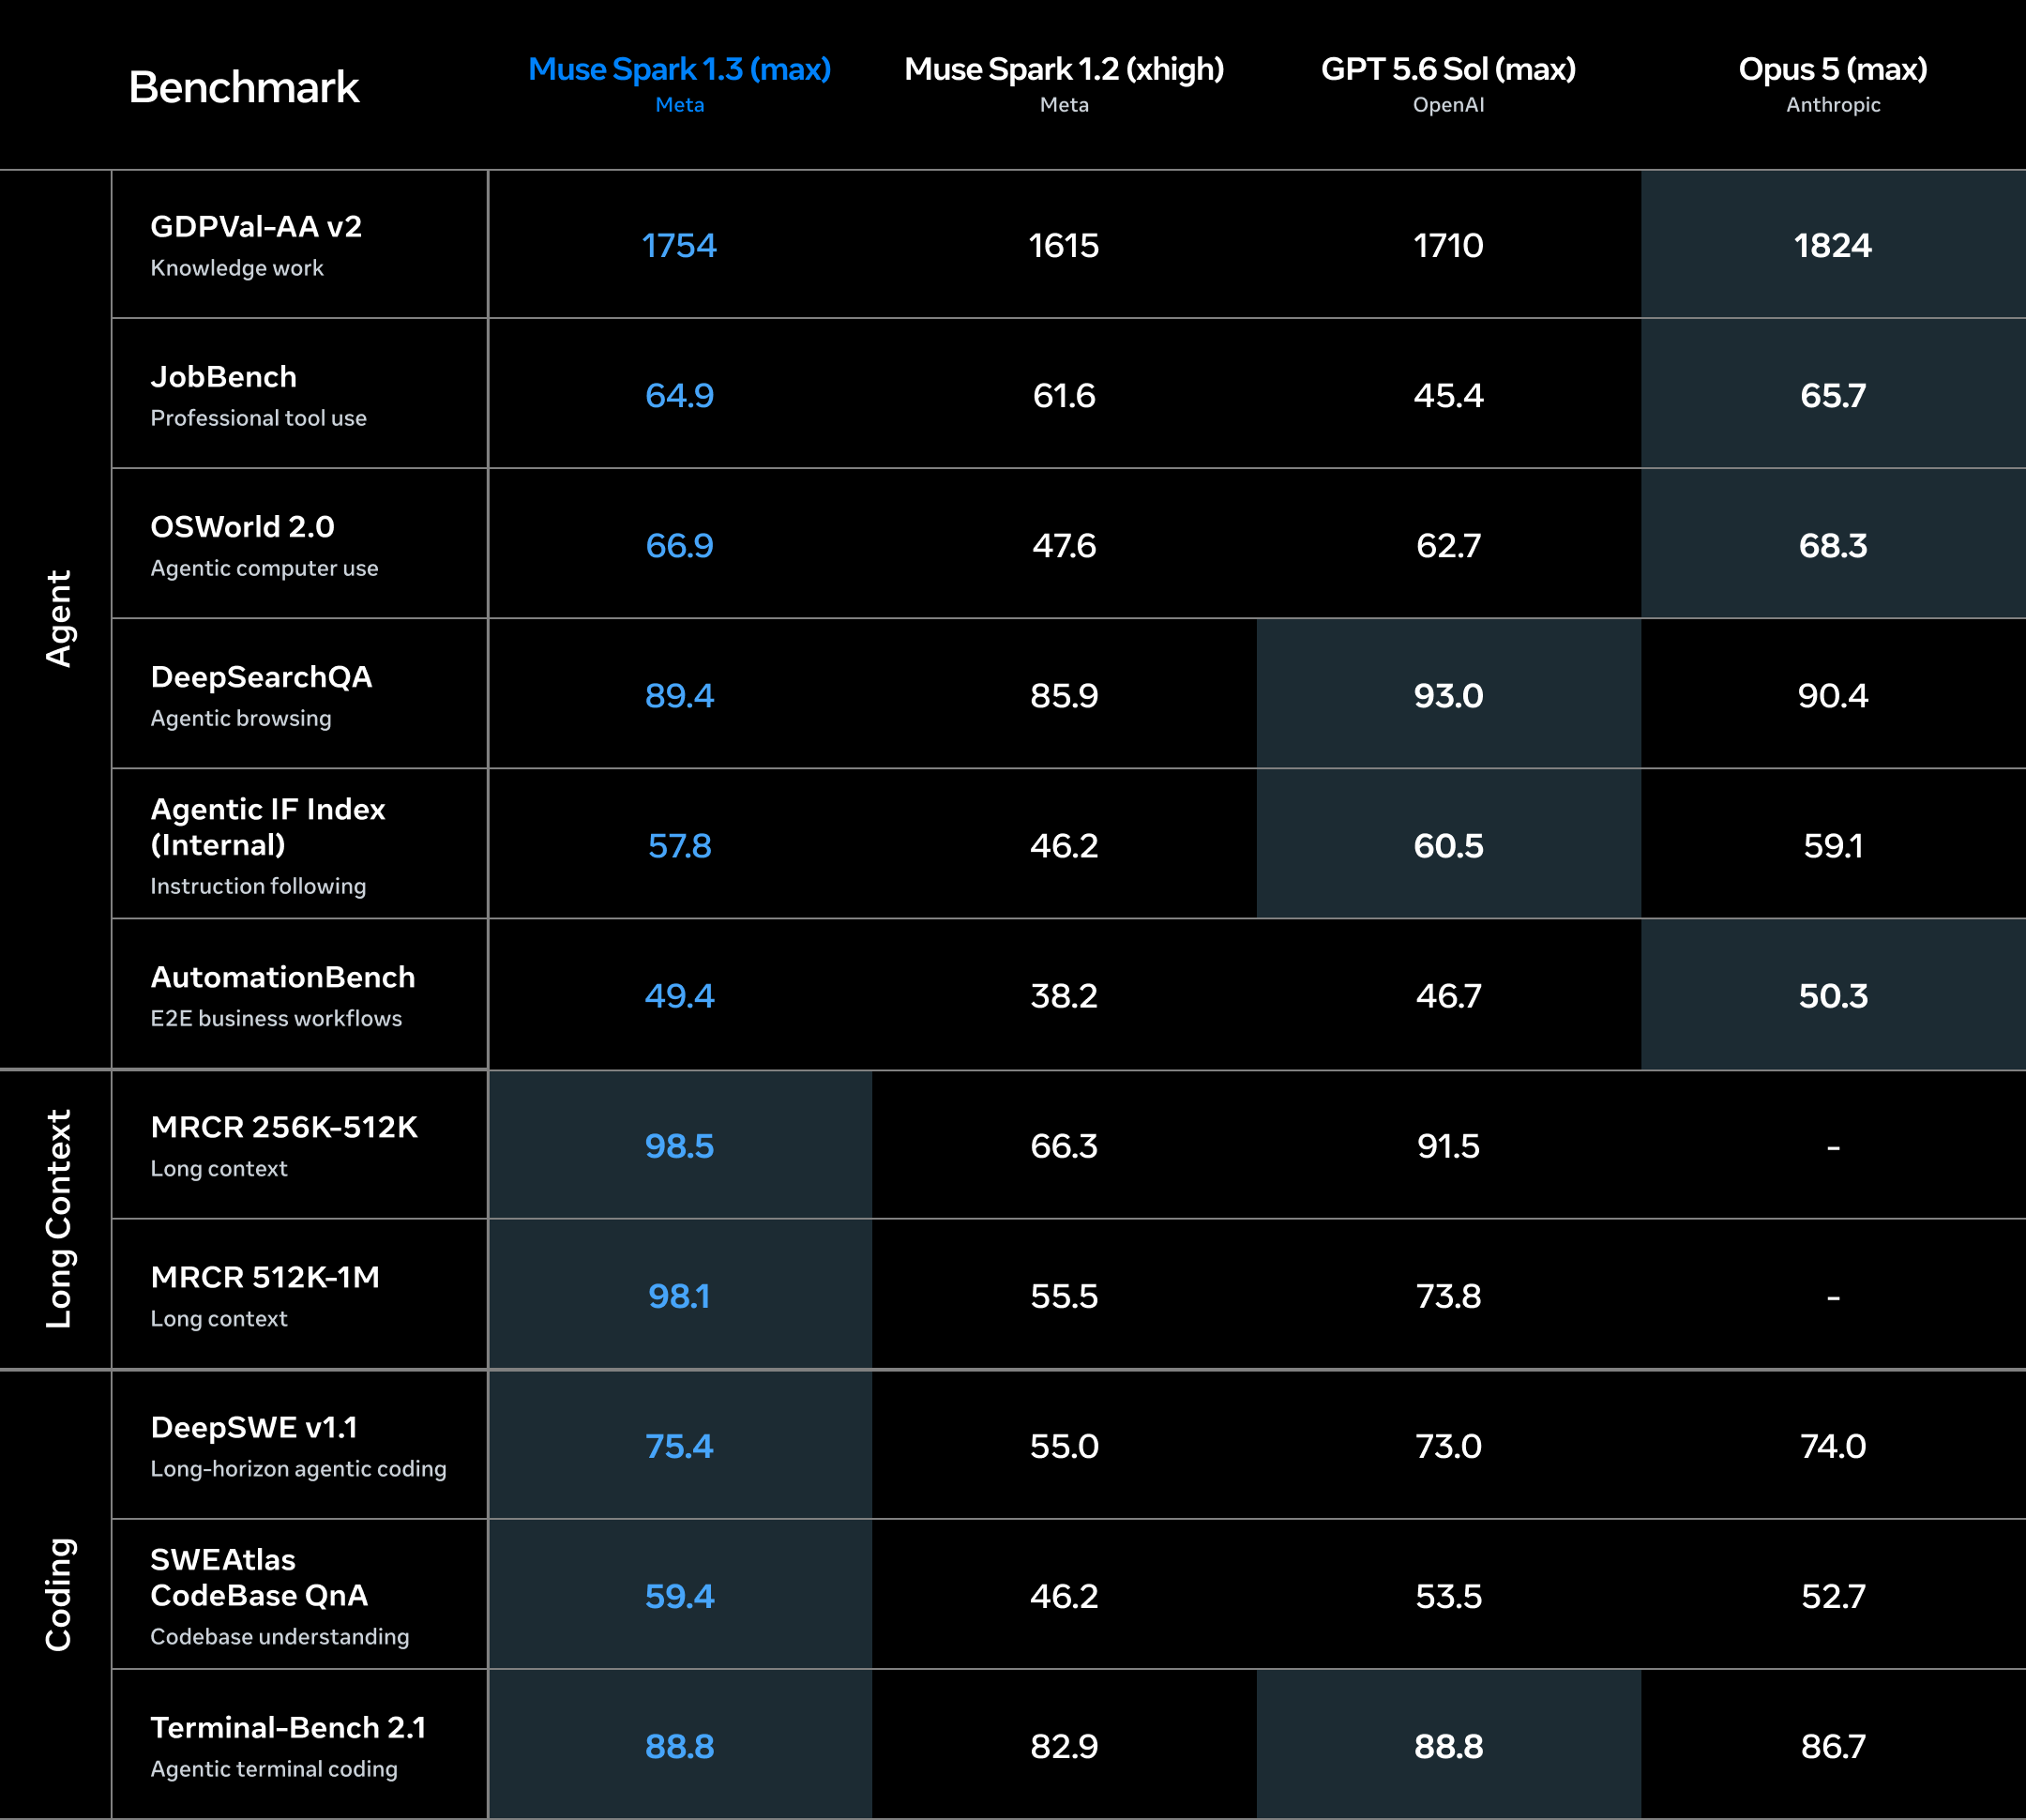
As quatro colunas são Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol e Opus 5, nas categorias de agentes, programação, seguimento de instruções e contexto longo. Parece uma vitória limpa do 1.3. Aqui está o asterisco: a coluna do 1.3 é max, e a coluna do 1.2 com a qual ele é comparado é xhigh. Isso não é uma comparação em pé de igualdade. Parte do salto que você vê é uma mudança de nível de raciocínio, não uma mudança de geração do modelo. Um comentarista do HN, sunaookami, apontou que o painel "only shows max reasoning" enquanto o max é justamente o modo restrito, e chamou isso de desonesto. Estão mostrando a melhor versão possível do 1.3 contra uma versão intermediária do 1.2.
Isso não torna o modelo ruim. Torna o gráfico um artefato de marketing, que é o que gráficos de lançamento sempre são. Leia-o pela direção, não pelo tamanho exato da diferença.
Onde ele realmente vence: contexto longo e programação
Tirando o enquadramento, as vitórias reais continuam reais, e se concentram em dois lugares.
Em contexto longo, o 1.3 é excelente. No teste de recuperação MRCR da Meta, ele marca 98.5 na faixa de 256K-512K e 98.1 em 512K-1M, bem à frente dos números do 1.2 ao lado. Se a sua carga de trabalho é "leia esta enorme base de código ou conjunto de documentos e raciocine sobre tudo", essa recuperação é um motivo legítimo para dar uma olhada. A janela de contexto de 1M tokens não é apenas folga de marketing aqui; as pontuações de recuperação mostram que ele de fato usa a janela.
Em programação, os ganhos em relação ao 1.2 são a parte mais crível do blog da Meta porque são específicos. Os engenheiros da Meta relatam cerca de 20% menos chamadas de ferramentas e 25% menos tokens nas mesmas tarefas de programação, com um estilo mais limpo e menos prolixo. No DeepSWE v1.1 ele marca 75.4 contra 55.0 do 1.2, e empata com o GPT-5.6 Sol em 88.8 no Terminal-Bench 2.1. Um analista da comunidade, majerep, chamou a versão anterior de "the best free model available on OpenCode" para tarefas precisas e moderadas, e os números de programação dizem que o 1.3 amplia essa liderança. Se eu fosse buscar um modelo barato para conduzir um ciclo de programação com agentes, este estaria na lista curta ao lado do Kimi K3 e do DeepSeek V4 Flash.
Onde a história "agêntica" é, na verdade, uma história de programação
Esta é a descoberta que eu não esperava ao começar. A manchete da Meta é "improved performance across agentic and coding tasks", e a metade agêntica disso não se sustenta contra o modelo que a própria Meta escolheu para comparar.
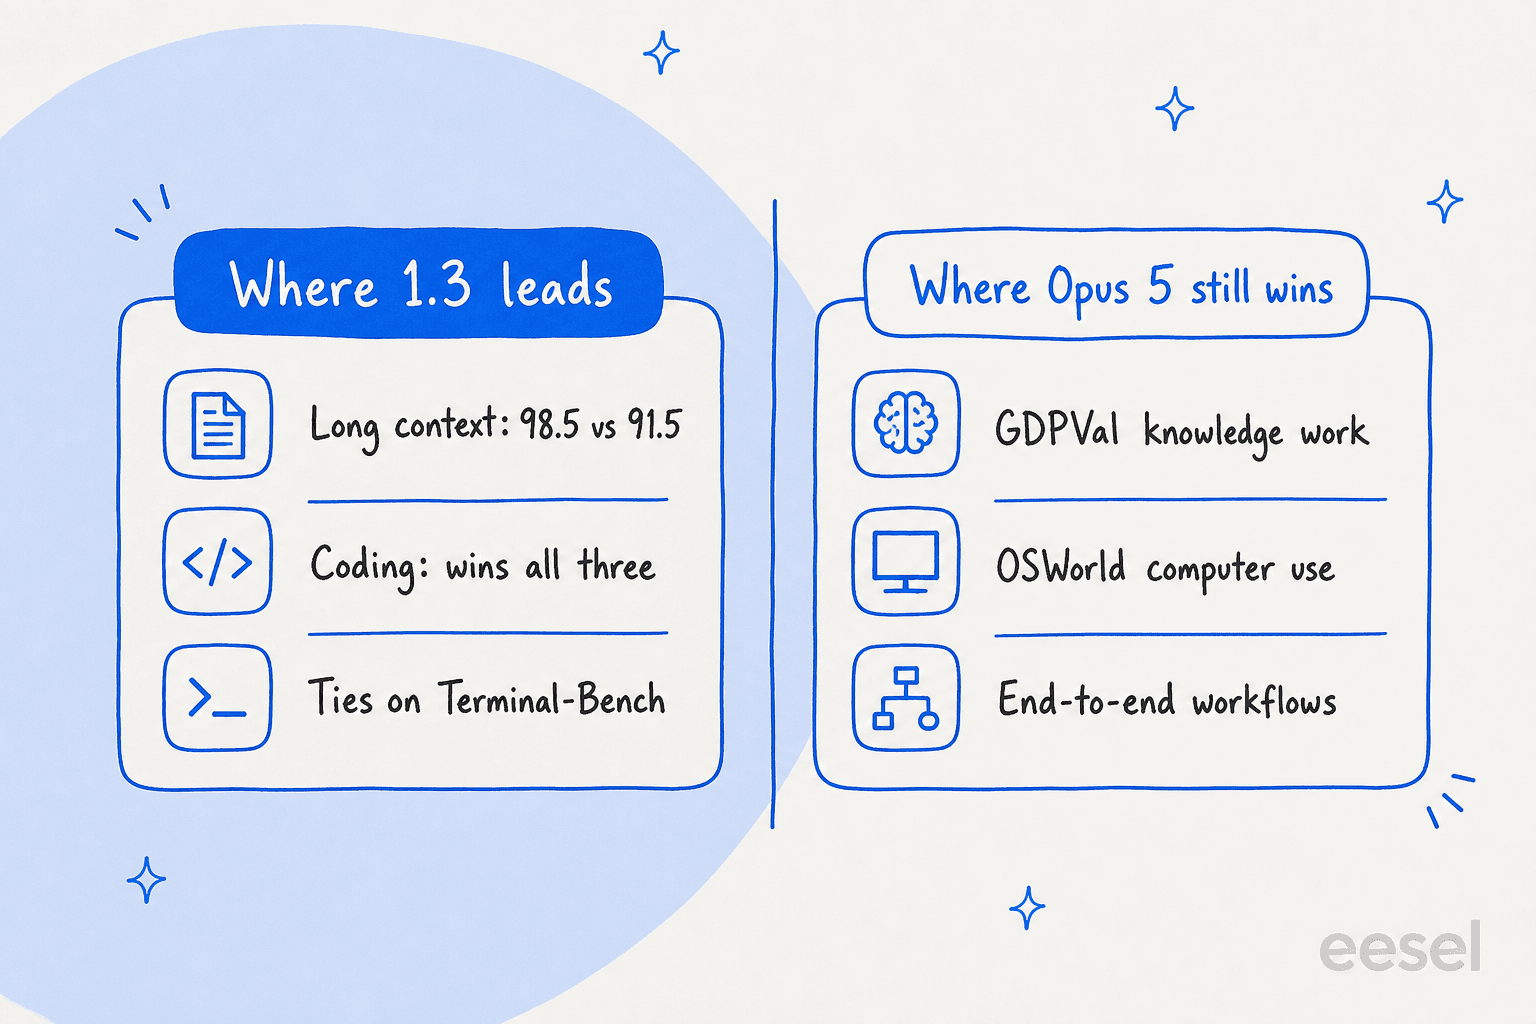
Percorra as seis linhas de agentes do painel da Meta. O Opus 5 max vence GDPVal-AA v2 (1824 a 1754), JobBench (65.7 a 64.9), OSWorld 2.0 (68.3 a 66.9) e AutomationBench (50.3 a 49.4). O GPT-5.6 Sol leva DeepSearchQA (93.0) e o Agentic Instruction-Following Index (60.5). Ou seja, o Muse Spark 1.3 perde todas as linhas de agentes para um rival ou outro. Onde ele domina é em programação e contexto longo, o que é uma afirmação diferente de "melhor agente". A leitura honesta é que "agentes melhorados" é, em grande parte, "programação melhorada", e a programação está de fato melhorada.
Quero ser justo, porque ainda é um modelo do top dez e as diferenças em agentes são estreitas. Mas se você está escolhendo um modelo especificamente para uso de ferramentas em várias etapas e controle de computador, o painel que a Meta publicou está dizendo discretamente que o Opus 5 é a escolha mais segura para esse trabalho. Para automação de suporte, onde uma ação "agêntica" errada significa uma resposta errada a um cliente real, essa distinção importa muito, e é por isso que simulamos cada agente com tickets anteriores antes de ele entrar no ar, em vez de confiar em uma linha de benchmark.
O imposto da verbosidade que ninguém coloca no painel
Velocidade e preço parecem ótimos até você contar os tokens. Para concluir o Artificial Analysis Intelligence Index, o Muse Spark 1.3 emitiu 120 milhões de tokens de saída, contra uma mediana do campo de 72 milhões. Isso o coloca em 139º de 636 em verbosidade, ou seja, ele é mais tagarela que a maior parte do campo.
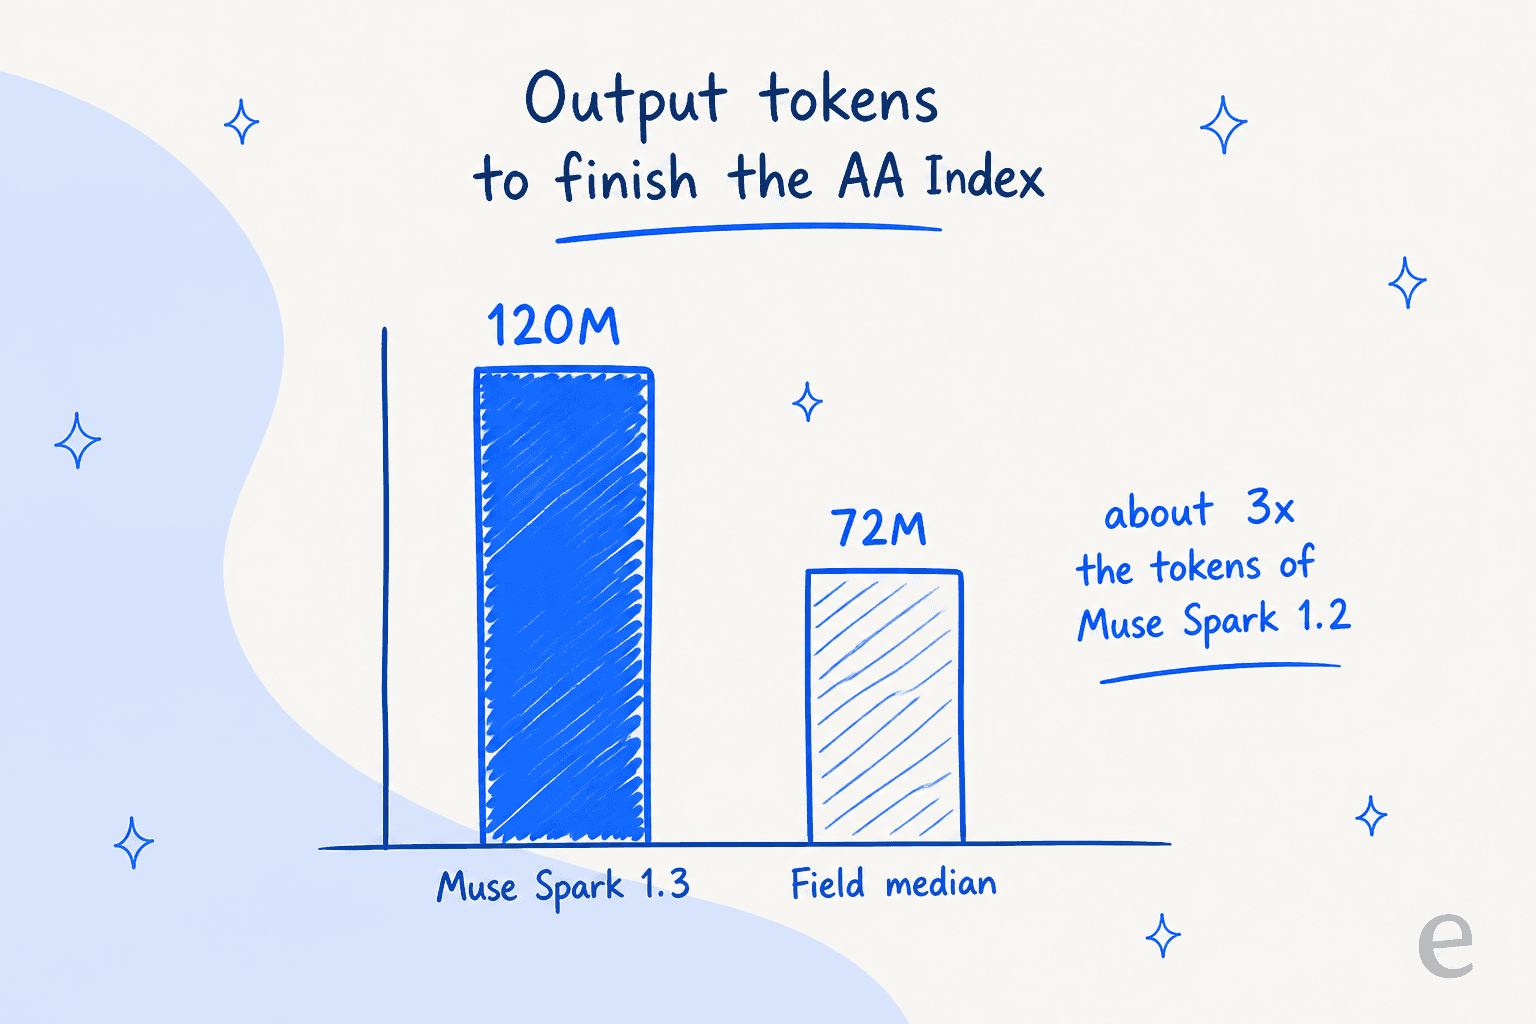
O pessoal do Hacker News, rodando o habitual teste de estresse de SVG de um pelicano de bicicleta, estimou de forma independente cerca de 3x o uso de tokens do 1.2. Como você paga por token de saída, verbosidade é um multiplicador direto de custo. Uma tarifa de saída de $4.25 por milhão que produz o triplo de tokens não é, na prática, um modelo de $4.25. Este é o número que eu colocaria ao lado da tabela de preços antes de assinar qualquer coisa, e é exatamente o tipo de custo total oculto que um medidor de tokens cru esconde e um preço fixo por resolução não.
O preço são dois preços, e a diferença é a história toda
O preço do Muse Spark 1.3 é a coisa mais comentada sobre ele, e com razão, porque na verdade são dois preços com um pedágio de dados no meio.
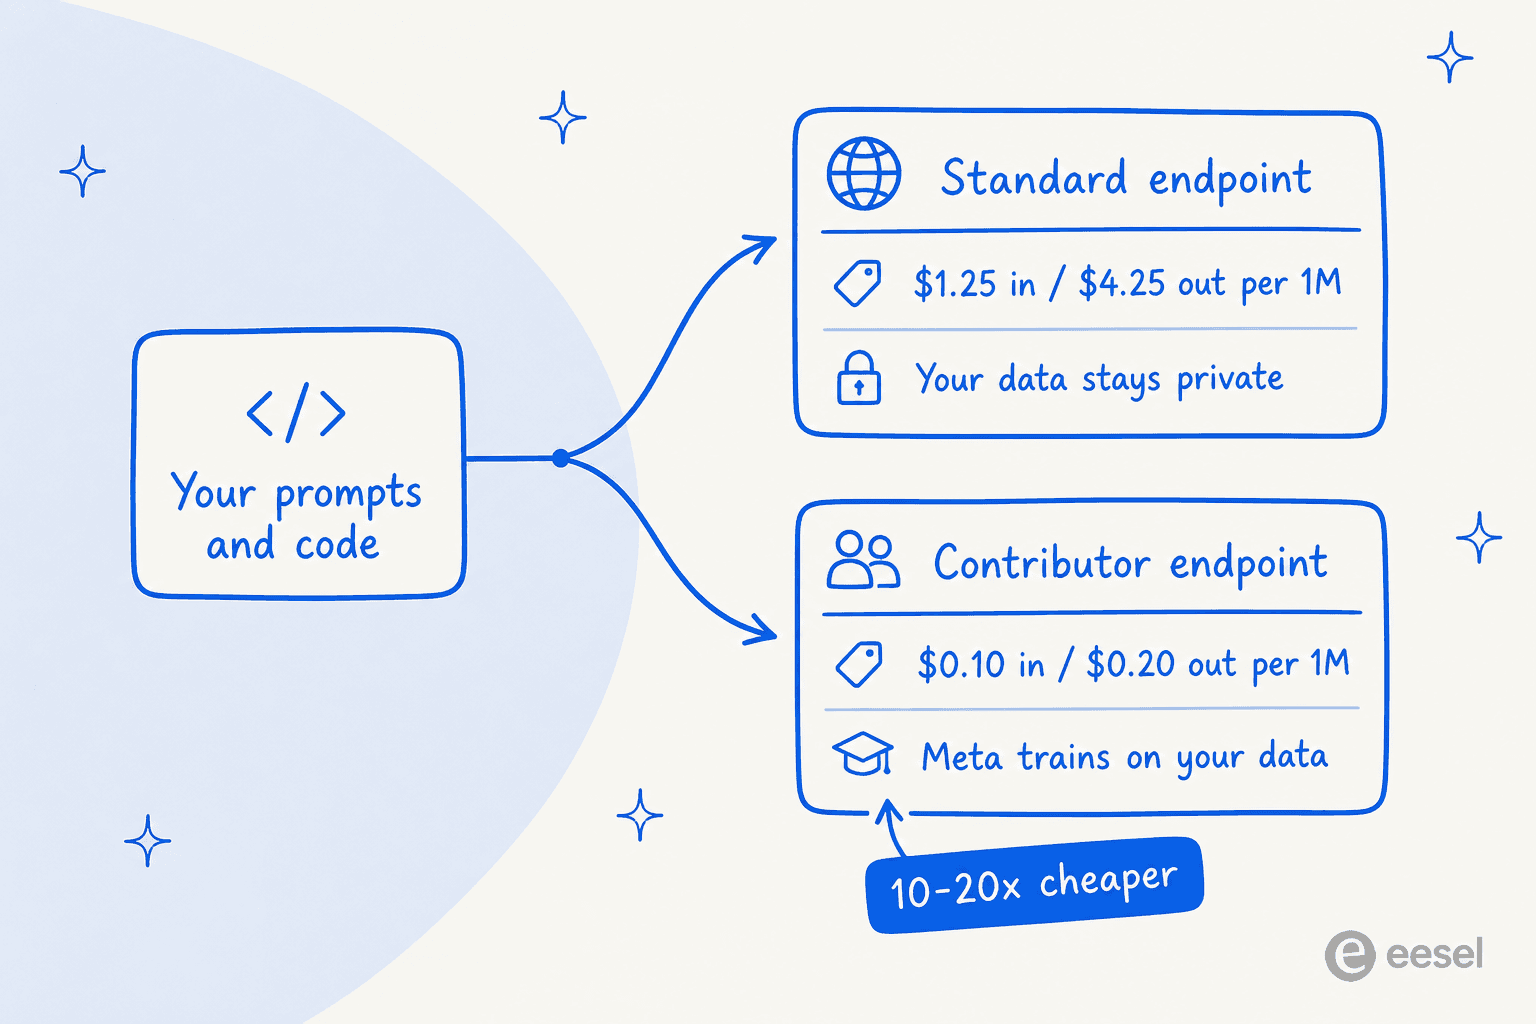
| Endpoint | Entrada / 1M | Saída / 1M | A Meta treina com seus dados? |
|---|---|---|---|
| Padrão (xhigh) | $1.25 | $4.25 | Não |
| Contribuidor | ~$0.10 | ~$0.20 | Sim |
A tarifa padrão tem preço moderado frente a uma mediana de entrada de $1.75, e a Artificial Analysis mediu $0.55 por tarefa do Index. O endpoint de contribuidor é 10-20x mais barato porque você paga à Meta com dados em vez de dólares. A leitura da comunidade sobre por que a divisão existe é mais afiada do que o enquadramento da própria Meta:
"It's not that Meta really wants your data and they're willing to pay top dollar for it. It's that companies really don't want Meta to have their data and they're willing to pay top dollar for that."

Isso é tudo em duas frases. O prêmio não é por um modelo melhor; é o preço de manter a Meta fora do seu tráfego. Para um projeto de hobby, tanto faz. Para qualquer coisa que toque dados pessoais de clientes, o endpoint "barato" não é de fato uma opção, então o número com o qual você deve planejar é o padrão de $1.25 / $4.25, vezes o multiplicador de verbosidade acima.
O que a comunidade realmente pensa
O sentimento no dia do lançamento foi genuinamente misto, e a mistura é instrutiva. Os otimistas gostam da relação preço-inteligência. Como observou HDBaseT, o endpoint de contribuidor é "by far the cheapest, significantly cheaper per M than ChatGPT Luna, significantly smarter than Luna too." Os céticos não se convenceram da capacidade, dizendo sobre a versão anterior:
"Used Muse Spark 1.2 and was not impressed at all. Fast and cheap but even GPT 5.6 Terra felt much more capable."
E mromanuk descreveu ter esbarrado no 1.2 em um aplicativo web real e voltado ao Claude, Kimi K3 ou DeepSeek V4, esperando que o 1.3 supere a barra. O fio comum: rápido e barato é real, capacidade de ponta é contestada, e a ferramenta com a qual você o conduz importa. Vários comentaristas, incluindo meric_, enfatizaram que você deve rodá-lo no próprio harness Muse Code da Meta, com o qual ele foi treinado em conjunto, ou deixa eficiência na mesa.
Quem deve usar e quem deve passar
Vou ser concreto, porque uma análise que termina em "depende" fez você perder tempo.
- Use se a sua carga é programação ou raciocínio de contexto longo, você consegue trabalhar no Muse Code e seus dados não são sensíveis, de modo que o endpoint de contribuidor é viável. Nessa interseção, é uma escolha forte e barata.
- Considere para agentes de programação sensíveis a custo, onde você de outro modo recorreria ao Kimi K3 ou ao DeepSeek V4 Flash. Reserve orçamento para a verbosidade.
- Passe, por enquanto se você precisa do melhor uso agêntico de ferramentas (o painel aponta para o Opus 5), se precisa do
maxhoje (ainda restrito) ou se lida com dados regulados e não pode pagar o prêmio padrão. - Pule o modelo cru por completo se o que você realmente quer é automação de atendimento ao cliente. É um produto diferente, e explico o porquê a seguir.
Um modelo não é um colega de trabalho: o que isso significa para uma equipe de suporte
Aqui está a armadilha em que vejo líderes de suporte caírem toda vez que um modelo como este vira tendência. Eles leem "modelo agêntico top dez, baratíssimo" e acham que podem apontá-lo para a caixa de entrada. Um modelo cru é infraestrutura, como um banco de dados ou uma API de pagamentos. É poderoso e genérico. Não conhece sua política de reembolso, não está conectado ao seu helpdesk, não tem memória dos tickets da semana passada e não tem freio embutido antes de enviar uma resposta errada e confiante a um cliente pagante. A Meta até diz que o 1.3 é melhor em "confirming before consequential actions", o que é uma admissão de que um modelo cru precisa dessa proteção acoplada.
Essa distância entre um modelo e um colega que trabalha é o que a eesel existe para preencher. A eesel é uma plataforma de colegas de equipe de IA, e você contrata colegas prontos para trabalhar em tarefas específicas. O elenco atual é um agente de suporte de IA e um redator de blog de IA. O agente de suporte já chega sabendo fazer o trabalho: ele treina com a sua base de conhecimento e tickets anteriores, entra na sua fila existente, redige ou resolve automaticamente e escala de forma limpa quando deve. O modelo por baixo é um componente intercambiável; um modelo de fronteira como o Muse Spark 1.3 é exatamente o tipo de motor em que ele pode rodar, mas o valor está em tudo o que o envolve.
A parte que se liga diretamente a um lançamento de modelo de programação como este é a CLI da eesel. Se você gosta do Muse Code porque pode conduzir um agente de um terminal, vai entender por que isso importa. A CLI é uma forma amigável a agentes de operar o mesmo colega eesel e o mesmo workspace que vivem no painel: uma pessoa pode executá-la à mão em um terminal, scripts podem automatizá-la no CI e agentes de programação como Claude Code, Codex e Cursor podem conduzi-la diretamente. É o mesmo colega, não um produto separado reduzido, então você pode gerenciar fontes, disparar execuções e puxar atividade sem clicar numa interface. Essa é a diferença entre "aqui está uma chave de modelo, boa sorte" e "aqui está um colega que você também pode automatizar com scripts".
Experimente a eesel em vez de uma chave de modelo crua
Se você chegou a esta análise porque está avaliando construir automação de suporte sobre um modelo de fronteira barato, a resposta honesta é que o modelo é a parte fácil e o menor dos seus problemas. A eesel entrega o agente de suporte de IA já preparado para o trabalho: ele roda em modelos de fronteira como este, conecta-se ao Zendesk, ao Freshdesk e ao resto da sua stack e, a parte que de fato reduz o risco, permite simulá-lo em milhares dos seus tickets anteriores para você ver a taxa de resolução real antes que ele responda a qualquer cliente.
Esse passo de simulação é a lição que aprendemos do jeito difícil depois de anos colocando IA em filas de suporte ao vivo: vimos bots de aparência confiante darem respostas erradas em silêncio, e por isso nada na eesel vai para um cliente sem um ensaio prévio com o seu próprio histórico. Você pode começar de graça e ver o número nos seus próprios dados.
O veredito
O Muse Spark 1.3 é um avanço real em programação e contexto longo, e com o preço de contribuidor é uma das melhores opções de valor por token do mercado. Como "modelo agêntico top" ele é supervalorizado: o próprio painel da Meta mostra o Opus 5 vencendo as linhas de agentes, o nível principal max é restrito e a verbosidade 3x significa que o preço de tabela barato não é o preço que você paga. Leia-o pelo que é, um especialista em programação rápido, barato e verboso, com um forte hábito de contexto longo, e é fácil de gostar. Só não confunda um modelo forte com um colega que trabalha. Se o trabalho é atender clientes, contrate o colega de equipe, não o motor.