

A Sakana AI precificou o Fugu Max em $2 por milhão de tokens de entrada e $6 por milhão de saída, tarifa fixa independentemente do tamanho do contexto, mais $0,25 por milhão de entrada em cache e $0,007 por chamada de busca na web ou fetch. Se você prefere pagar por mês, há três assinaturas, de $20, $100 e $200, e todas incluem todos os modelos Fugu.
A tarifa de vitrine é barata, mas uma página de preços nunca conta a história toda. Duas coisas mexem na conta real: o Fugu Max é um modelo de orquestração que distribui uma requisição por um conjunto de modelos menores, e todo esse tráfego interno cai no seu medidor, então uma requisição pode custar mais que uma chamada a um único modelo. No sentido contrário, o cache faz muito trabalho: no painel ao vivo do OpenRouter, o preço efetivo de entrada nos primeiros dias do Fugu Max ficou perto de $0,61 por milhão contra os $2 de lista.
Há mais de três anos vejo equipes escolherem modelos para o atendimento ao cliente, e o padrão é sempre o mesmo: a tarifa por token é o número mais fácil de comparar e o errado para otimizar. O que você paga para resolver um ticket depende de todo o sistema em volta do modelo. Essa é a lacuna que um teammate de IA como a eesel fecha, e é onde fica a conta de custo de verdade.
Preços do Sakana Fugu Max: a tabela completa de tarifas
Aqui está o quadro completo de pagamento por uso do modelo, direto do FAQ da Sakana e da página do modelo no OpenRouter. O ID do modelo é fugu-max (v1.0).
| Item | Tarifa do Fugu Max |
|---|---|
| Entrada / 1M tokens | $2.00 |
| Saída / 1M tokens | $6.00 |
| Entrada em cache / 1M tokens | $0.25 |
| Sobretaxa por tamanho de contexto | Nenhuma, fixa em qualquer tamanho |
| Busca na web / fetch | $0.007 por chamada |
O design de tarifa fixa é o que há de mais limpo nele. Segundo a Sakana, a tarifa de $2/$6 vale «independentemente do tamanho do contexto», então um prompt de 900K tokens custa o mesmo por token que um curto, seja qual for a capacidade da janela de contexto. A maioria dos modelos de fronteira adiciona uma sobretaxa de contexto longo ao passar de um limite, então, se você costuma jogar documentos grandes em um modelo, essa é uma vantagem real e verificável.
Para contraste, o irmão Fugu Ultra v2 sobe de preço com contexto longo, o que faz a tarifa fixa do nível Max se destacar até dentro da mesma família:
| Item | Fugu Ultra v2 (padrão) | Fugu Ultra v2 (>272K) |
|---|---|---|
| Entrada / 1M | $5.00 | $10.00 |
| Saída / 1M | $30.00 | $45.00 |
| Entrada em cache / 1M | $0.50 | $1.00 |
As duas formas de pagar e uma pegadinha de nome
Você pode comprar o Fugu de duas formas, e elas são fáceis de confundir.
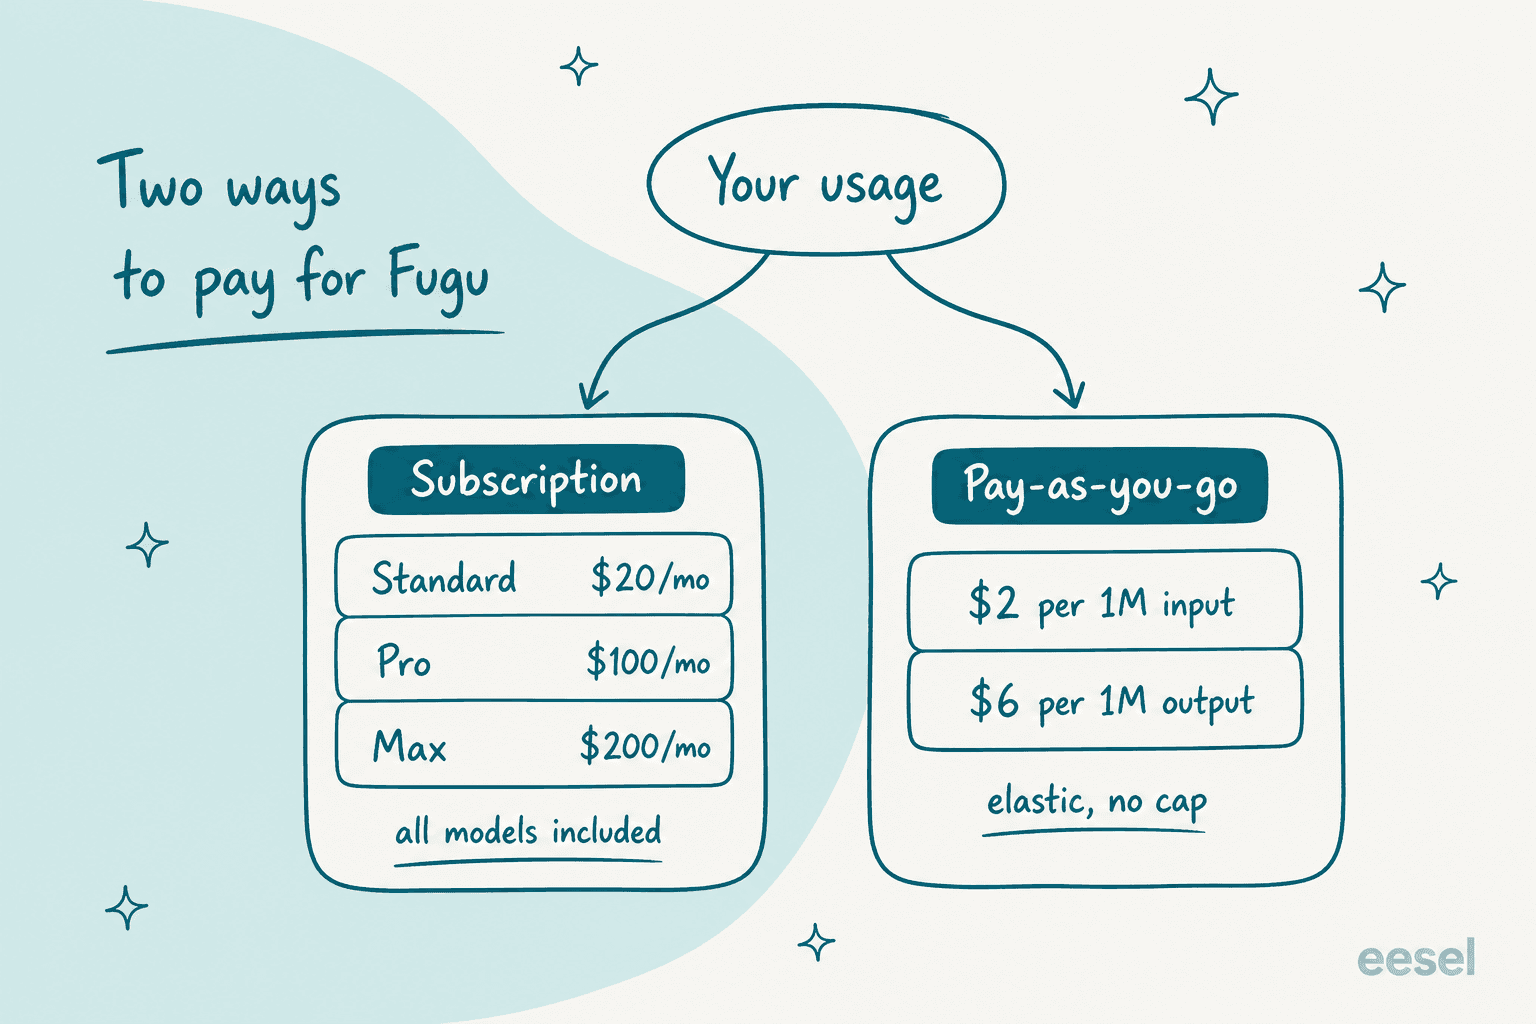
As assinaturas são uma franquia mensal, e cada nível dá acesso a todos os modelos Fugu, não só ao Max:
| Plano | Preço | Franquia |
|---|---|---|
| Standard | $20/mês | Base |
| Pro | $100/mês | 10x Standard |
| Max | $200/mês | 20x Standard |
Já o pagamento por uso «cobra pelo consumo de tokens em vez de uma franquia mensal, dando capacidade elástica para picos e trabalhos grandes», algo que a Sakana oferece a clientes corporativos que não conseguem limitar o uso de antemão.
Agora a pegadinha. A assinatura «Max Plan» não é a mesma coisa que o modelo «Fugu Max». O plano de $200 é um pacote de uso que inclui todos os modelos da família; o Fugu Max é um dos modelos dentro dele. Você pode usar o modelo Fugu Max perfeitamente no plano Standard de $20 ou no pagamento por uso, e não precisa da assinatura de $200 para usá-lo. É uma pequena coincidência de palavras que confunde quase todo mundo que lê a página de preços pela primeira vez.
A pegadinha dos tokens de orquestração
Esta é a parte dos preços do Sakana Fugu Max que uma tabela de tarifas esconde, e é a coisa mais importante a entender antes de orçar.
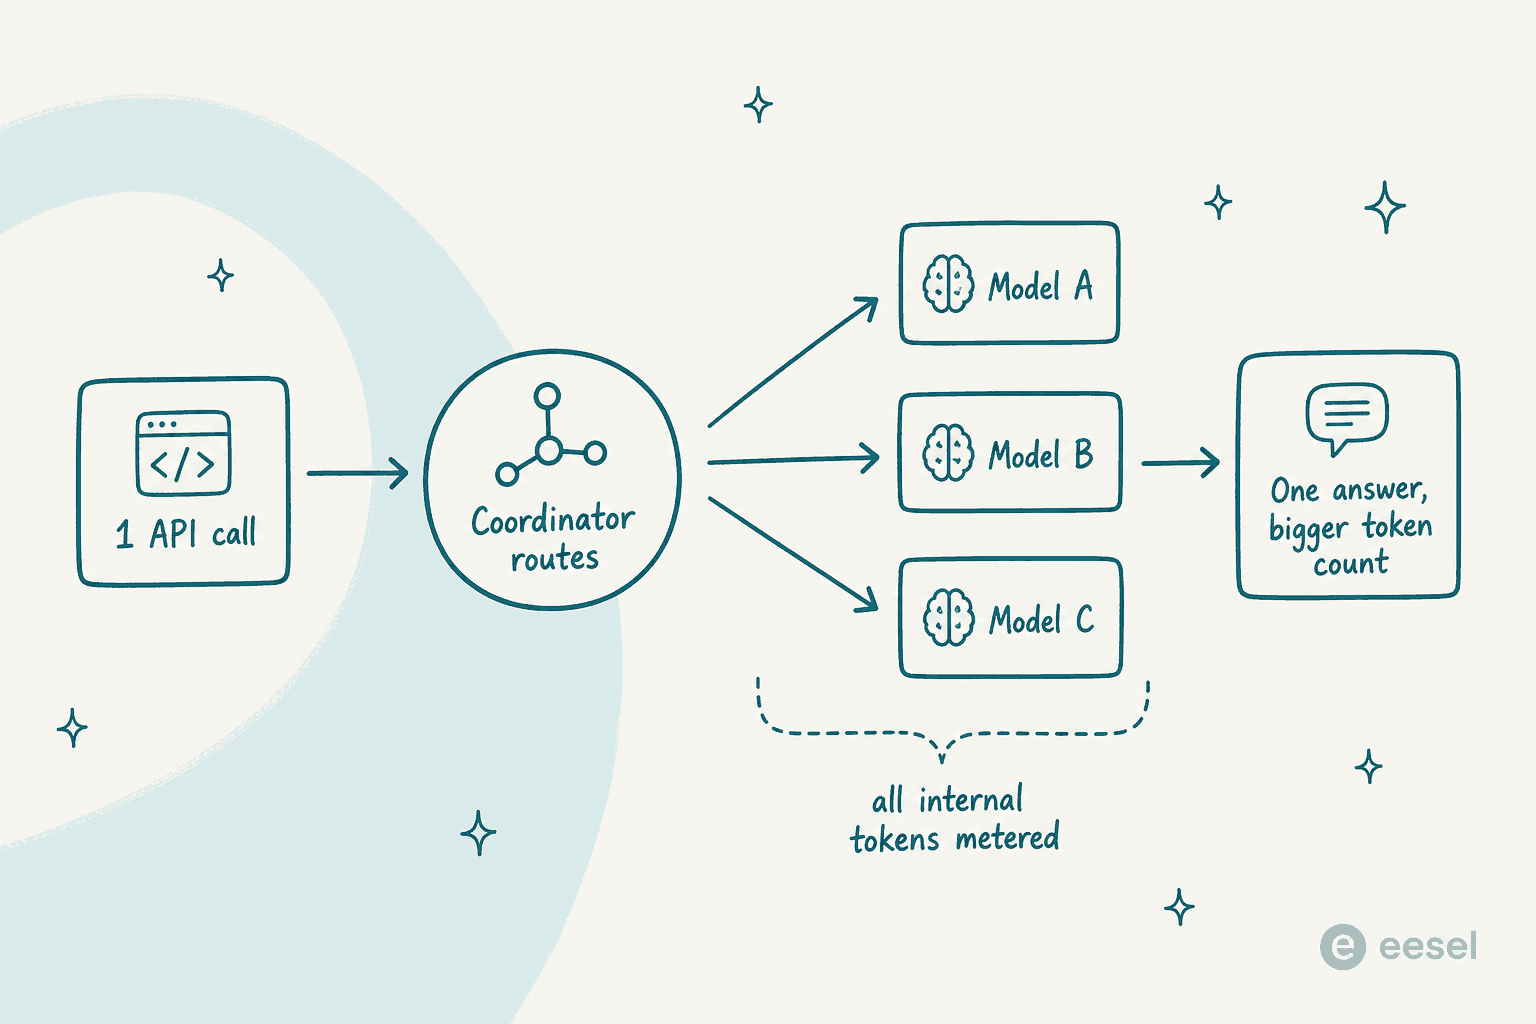
Quando você chama o Fugu Max, não está falando com um único modelo. Está falando com um coordenador treinado que lê sua requisição, a encaminha por um conjunto de modelos de pesos abertos e especializados e depois sintetiza uma resposta. Esse é todo o apelo da família Fugu: você ganha um sistema multiagente, um padrão real de agente de IA, sem construí-lo.
A consequência na cobrança está dita no OpenRouter: «Orchestration tokens consumed by the system are billed as standard input/output tokens.» Em bom português, a conversa interna entre os modelos entra no seu medidor, não é de graça. Então uma única requisição que se espalha por três ou quatro modelos pode queimar bem mais tokens que uma chamada direta a um modelo só, e a baixa tarifa de saída de $6 não se traduz automaticamente em uma conta baixa por resposta.
A Sakana suaviza isso, e vale citar o mecanismo com justiça. Segundo seu FAQ, quando vários agentes estão ativos, «we never stack fees: you pay a single rate based on the top-tier model involved.» Ou seja, adicionar mais agentes a uma requisição não multiplica a tarifa cobrada, só faz mais tokens passarem por essa tarifa única. Resumo: seu custo cresce com o total de tokens, e a orquestração incha o total de tokens. Orce por tokens por resposta, não pela tarifa de vitrine.
O que os compradores realmente pagaram nos primeiros dias
Preços de lista e contas reais são números diferentes, e dessa vez temos uma janela pública para essa diferença. No painel de preços ao vivo do OpenRouter, nos primeiros dias do Fugu Max após o lançamento de 11 de setembro, os números eram estes:
- De lista: $2 de entrada / $6 de saída por milhão.
- Preço efetivo de entrada: ~$0,61 por milhão, bem abaixo dos $2 de lista.
- Preço efetivo de saída: $6 por milhão, inalterado.
- Taxa de acerto de cache: 79,4%, o que puxa o preço efetivo de entrada para baixo.
- Vazão de cerca de 29 tokens por segundo, um único provedor, 100% de disponibilidade.
Ou seja, o cache derruba bastante o custo de entrada, enquanto a saída fica no preço de lista. Isso mostra onde gastar o esforço de otimização: o Fugu Max recompensa cache intenso e pune geração tagarela, pesada em saída. Se sua carga reaproveita muito o mesmo contexto (um prompt de sistema fixo, um conjunto estável de documentos), a tarifa efetiva de entrada pode ser uma fração da de lista. Se cada chamada é nova e pesada em saída, você ficará mais perto da linha de $6.
Como o custo se compara a outros modelos
É aqui que o preço ganha sua manchete. A Sakana afirma em seu post de lançamento que o Fugu Max entrega saída «40-60% mais barata» que Sonnet 5, GPT-5.6 Terra e Kimi K3, ficando «within striking distance of elite models». Alinhada às tarifas de lista de cada fornecedor, a diferença na saída é real:
| Modelo | Entrada / 1M | Saída / 1M |
|---|---|---|
| Fugu Max | $2.00 | $6.00 |
| GPT-5.6 Terra | $2.00 | ~$12.00 |
| Sonnet 5 | $3.00 | ~$15.00 |
| Kimi K3 | $3.00 | ~$15.00 |
Duas ressalvas honestas antes de tirar print dessa tabela. Primeiro, são tarifas de lista no momento da escrita, e os fornecedores as mudam, então trate os valores como um retrato, não como um contrato. Segundo, a comparação é sobre a tarifa bruta por token, que, como mostra a seção de orquestração, não é o mesmo que seu custo por resposta no Fugu Max. Um modelo que distribui o trabalho gasta mais tokens para chegar à mesma resposta que um que não distribui, então uma tarifa mais barata ainda pode gerar uma conta parecida.
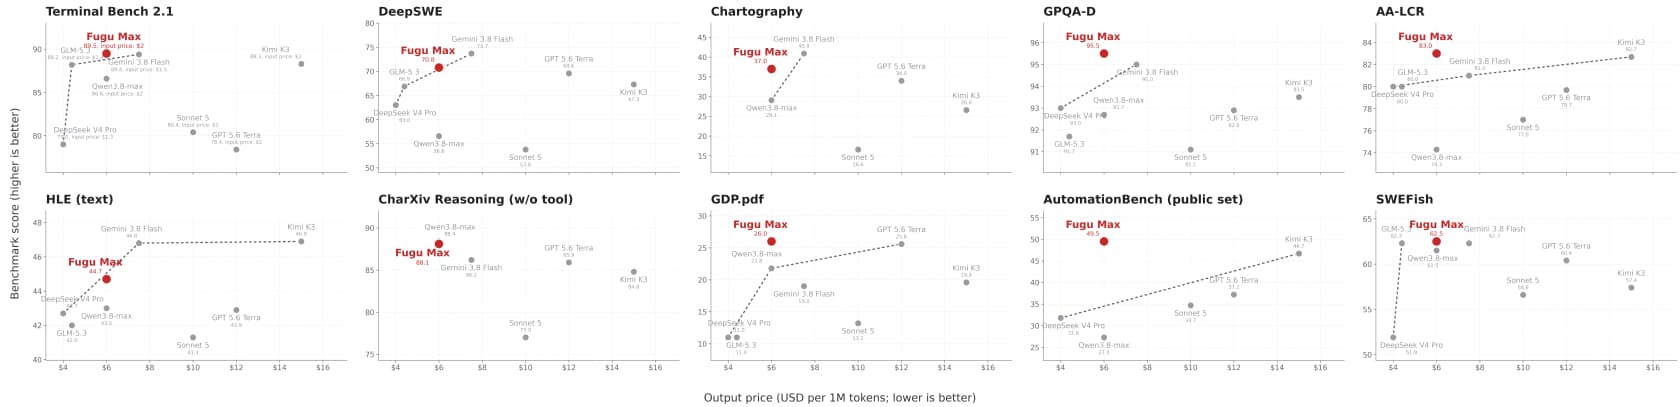
O argumento de eficiência é a proposta de verdade, e acho que é justo: desempenho próximo ao dos modelos de elite com custo de saída menor, verificado até agora apenas pelos benchmarks da própria Sakana. Os modelos proprietários mais fortes, como o Fable 5, não estão no conjunto do Fugu, que é justamente o ponto que a Sakana defende e também um limite do alcance da comparação. Como em qualquer afirmação sobre um modelo de IA, a grade do fornecedor é um ponto de partida, não uma prova.
Estime a sua própria conta do Fugu Max
A conta acima é mais fácil de sentir do que de ler, então aqui vai uma calculadora rápida. Informe seu volume mensal aproximado e seu comportamento de cache, e ela estima a conta do pagamento por uso e mostra a partir de quando a assinatura Max de $200 faz sentido.
A alavanca que salta aos olhos ao arrastar os controles: a taxa de acerto de cache mexe mais na linha de entrada do que o volume bruto. Isso bate com os dados do OpenRouter, e é a primeira coisa que eu ajustaria antes de me preocupar com o nível de assinatura.
Onde termina a conta de um modelo e começa o custo real
Esta é a distinção a que sempre volto, porque um post de preços facilita esquecê-la: a conta de tokens não é o custo que importa para a maioria dos trabalhos. É o custo do motor, não o custo do trabalho.
Pense no atendimento ao cliente, a área que melhor conheço. Um modelo, por mais baratos que sejam seus tokens, devolve texto. Para transformar isso em tickets resolvidos, você ainda precisa conectá-lo ao seu helpdesk, ensiná-lo sua base de conhecimento e suas políticas, dar permissão para consultar um pedido ou etiquetar um ticket, decidir quando ele escala para uma pessoa e provar que é seguro antes de tocar em um cliente real. Esse trabalho é a maior parte do projeto, e nada disso aparece em uma tarifa por milhão de tokens.
É exatamente por isso que comparo o custo de um agente de IA com o de um agente humano pela resolução, não por tokens, e por isso uma comparação de custo com uma equipe de suporte offshore gira em torno da mesma conta por resolução.
É a mesma lógica que torna o próprio Fugu atraente: a maioria das equipes não quer construir a infraestrutura multiagente por conta própria, então compra orquestração gerenciada. Subindo um nível, para suporte você provavelmente também não quer montar à mão o funcionário inteiro em volta de um modelo.
Experimente a eesel: precifique o ticket, não o token
É essa a lacuna que a eesel preenche. A eesel é uma plataforma de teammates de IA: você contrata teammates prontos para trabalhar em funções específicas, e cada um chega com as habilidades, integrações e contexto da empresa para o seu papel. O teammate de helpdesk com IA entra na sua fila atual, consulta pedidos e registros, etiqueta tickets e redige ou envia respostas, tudo dentro do helpdesk que você já usa.

O que importa para um post de preços: você nunca faz contas por modelo. A eesel roda em modelos de fronteira por baixo e cuida dessa escolha por você, e cobra um crédito por ticket ou chat (planos a partir de $299/mês por 500 créditos), não tokens, então o número que você prevê é o que corresponde ao trabalho feito. Ela aprende com seus tickets passados e sua base de conhecimento, se conecta a mais de 1000 ferramentas como Zendesk, Freshdesk e Gorgias, e deixa você simular com tickets históricos para ver tanto a taxa de resolução quanto o custo antes de ela responder a qualquer cliente, o ensaio que o roteamento opaco do Fugu não consegue dar.

Se você vive no terminal, a eesel também oferece uma superfície programável de verdade. A CLI da eesel (@eesel/cli) e seu servidor MCP deixam uma pessoa, um script ou um agente de código como o Claude Code operar o mesmo teammate do painel: conectar integrações, editar as instruções permanentes do teammate, rodar eesel activity para inspecionar cada execução e aprovar ou negar ações, tudo em JSON, com uma flag --dry-run que imprime a chamada exata que uma escrita faria antes de enviá-la. Esse é o acesso agêntico que uma API só de modelo deixa para você construir.
O Fugu Max é uma resposta forte para «qual modelo deve alimentar meu app e quanto vão custar os tokens». Se a sua pergunta real é «quanto vai custar resolver mais tickets», você pode experimentar a eesel de graça, sem cartão de crédito e sem ligação de vendas, e precificar o trabalho em vez do token.
Perguntas frequentes
Quanto custa o Sakana Fugu Max?
O preço do Sakana Fugu Max é $2 por milhão de tokens de entrada, $6 por milhão de tokens de saída e $0,25 por milhão de tokens de entrada em cache, tarifa fixa independentemente do tamanho do contexto, segundo o FAQ da Sakana. Chamadas de busca na web e de web fetch custam $0,007 cada. Se você prefere um plano mensal, as assinaturas são $20 (Standard), $100 (Pro) e $200 (Max), e todos os níveis incluem todos os modelos Fugu.
Qual é o preço do Fugu Max por milhão de tokens?
Segundo o OpenRouter e a Sakana, o ID de modelo fugu-max aparece a $2 de entrada, $6 de saída e $0,25 de entrada em cache por milhão de tokens. Essa tarifa não muda com a janela de contexto, então um prompt de 900K tokens é cobrado pela mesma tarifa por token que um curto.
O "Max Plan" é o mesmo que o modelo Fugu Max?
Não, e essa é a confusão mais comum nos preços do Sakana Fugu Max. O Max Plan de $200 é um pacote de uso por assinatura que inclui todos os modelos Fugu. O Fugu Max é um modelo específico dentro da família. Você pode usar o modelo Fugu Max no plano Standard de $20 ou no pagamento por uso.
Como os preços do Fugu Max se comparam ao Sonnet 5 e ao GPT-5.6?
Na saída, o Fugu Max tem a tarifa de lista mais barata: $6 por milhão contra cerca de $12 do GPT-5.6 Terra e $15 do Sonnet 5. A Sakana afirma que a saída é 40-60% mais barata que Sonnet 5, GPT-5.6 Terra e Kimi K3, com qualidade próxima à de fronteira. São números do fornecedor em benchmarks do fornecedor, então teste nas suas próprias tarefas.
O Fugu Max cobra a mais por contexto longo?
Não. Ao contrário do Fugu Ultra v2, que sobe de preço acima de 272K tokens, o Fugu Max mantém uma tarifa fixa de $2/$6 em qualquer tamanho de contexto, segundo a Sakana. Isso o torna previsível para cargas com documentos grandes, em que outros modelos adicionam uma sobretaxa de contexto longo.
Quanto custam os tokens de orquestração no Fugu Max?
São cobrados como tokens normais de entrada e saída, segundo o OpenRouter. Como uma chamada ao Fugu Max pode se espalhar por vários modelos internos, uma requisição consome mais tokens que uma chamada a um único modelo, então uma tarifa baixa por token nem sempre significa uma conta baixa por resposta. A Sakana diz que nunca acumula taxas e cobra uma única tarifa com base no modelo de nível mais alto envolvido.
Onde posso acessar o Fugu Max e ver seus preços?
O Fugu Max é uma API hospedada, disponível em console.sakana.ai, OpenRouter, no Vercel AI Gateway e no opencode. Ainda não está disponível na UE nem no EEE. Para o trabalho de suporte, um teammate de IA esconde o modelo e seus preços atrás de um preço mensal fixo.
O Fugu Max é mais barato que construir minha própria orquestração?
Depende de você precisar ou não construir e manter uma camada de roteamento, o tipo de escolha tratada em Assistants API vs LangChain. O Fugu Max vende orquestração gerenciada, então você paga pela coordenação que não precisa construir. Para o atendimento ao cliente em particular, dá para pular toda essa decisão: um teammate de IA como a eesel cuida da escolha do modelo e permite simular com tickets passados para ver o custo antes de se comprometer. Compare isso com um chatbot baseado em regras.