2026年版GPT-6.2 Astraの代替候補ベスト10、タスク単価で比較

Kurnia Kharisma

Katelin Teen
最終更新 2026年11月17日
多くのチームにとって最良のGPT-6.2 Astraの代替は、OpenAI自身のGPT-6.2 Solです。Artificial AnalysisでAstraの62に対して57を記録し、タスク単価は約4分の1です。より高いスコアを出すのはClaude Fable 5.2(65)だけで、タスク単価はAstraの6.6倍です。落とし穴は表示価格です。Claude Opus 5.5はAstraのトークン単価の半分を課金しますが、最大エフォートでのベンチマークタスク単価は2.5倍かかりました。代替候補は完了タスクあたりのコストで判断し、乗り換えるのではなくルーティングしましょう。サポートキューでは、モデルを取り巻く知識とエスカレーションルールの方が重要で、それこそがeeselのAIヘルプデスク・チームメイトが提供するものです。
なぜチームはGPT-6.2 Astraの先を見ているのか?
GPT-6.2 Astraは2026年11月17日に発売された、強力なモデルです。Artificial AnalysisはそのIntelligence Indexで62を記録し、Claude Fable 5.2に次ぐ2位につけています。OpenAIはAPIの価格ページで価格を20%下げ、入力100万トークンあたり$8、出力は$40としました。キャッシュされた入力は$1.00から$0.40に下がっています。あなたのエージェントが難しい複数ステップの作業をするなら、Astraはその地位にふさわしいモデルです。
それでもなぜ他を探すのか。3つの理由が繰り返し挙がります。
- ほとんどのタスクにはそこまで必要ない。 3段階のエフォートレベルで行った私自身の15件のサポートチケットのテストでは、GPT-6.2 SolがAstraの約4分の1のコストで全チケットに正しく答えました。詳細は後述します。
- 長い実行ログは読みにくい。 複数の有名なテスターがAstraの出力自体は気に入ったものの、長く自由度の高い実行で一緒に作業するのを嫌がりました。私のGPT-6.2 Astraレビューでそれらの不満を取り上げています。
- 1社だけに頼るのは単一障害点になる。 エージェント製品を作るチームは、価格変更や障害、レート制限に備えて、第二の研究所からテスト済みのフォールバックを持ちたいと考えています。
"I care less about the models being good and more on if I can fallback to them if Opus 5.5 gets a massive price hike after the IPO"

私は買い手が実際に何を検索しているかについて書いていますが、ここでの検索結果は示唆に富んでいます。新しいチャットでChatGPTにまさにこの質問をしたところ、各研究所のモデルドキュメントと価格ページに直接飛び、回答全体を1つの数字、すなわち成功タスクあたりのコストを軸に組み立てました。それは正しい枠組みであり、以下でも私が使ったものです。あなたのエージェントがサポートチケットに答えているなら、eesel CLIを使えば、コーディングエージェントが承認済みのヘルプ記事をeeselのチームメイトに読み込ませ、何かを選ぶ前にその回答をテストできます。
代替候補をどう比較したか
各モデルを3つの観点で評価し、すべて2026年11月18日に確認しました。
- 表示価格。 各ベンダー自身の価格ページから、入力と出力100万トークンあたりの価格と、キャッシュ入力のレートを確認しました。長いシステムプロンプトを繰り返し送るエージェントはキャッシュトークンに依存するためです。
- 知能とタスク単価。 Artificial Analysisは全モデルに同じ9つの評価を実施し、各モデルの最高エフォート設定で1タスク完了時のコストを報告しています。この数字には、表示価格では見えないトークン消費量が反映されています。
- 自前のサポートテスト。 私のGPT-6.2 Astra分析の15件チケットのテストをAstraとSolで低・中・高のエフォートで再実行しました。合計90回で、返金計算、二重課金、プロンプトインジェクション、スペイン語とドイツ語のチケット、壊れた注文照会、タイプミスした注文番号をカバーしています。このテストではOpenAIのみAPIアクセスがあったため、他の研究所についてはベンダーとベンチマークのデータで判断しています。
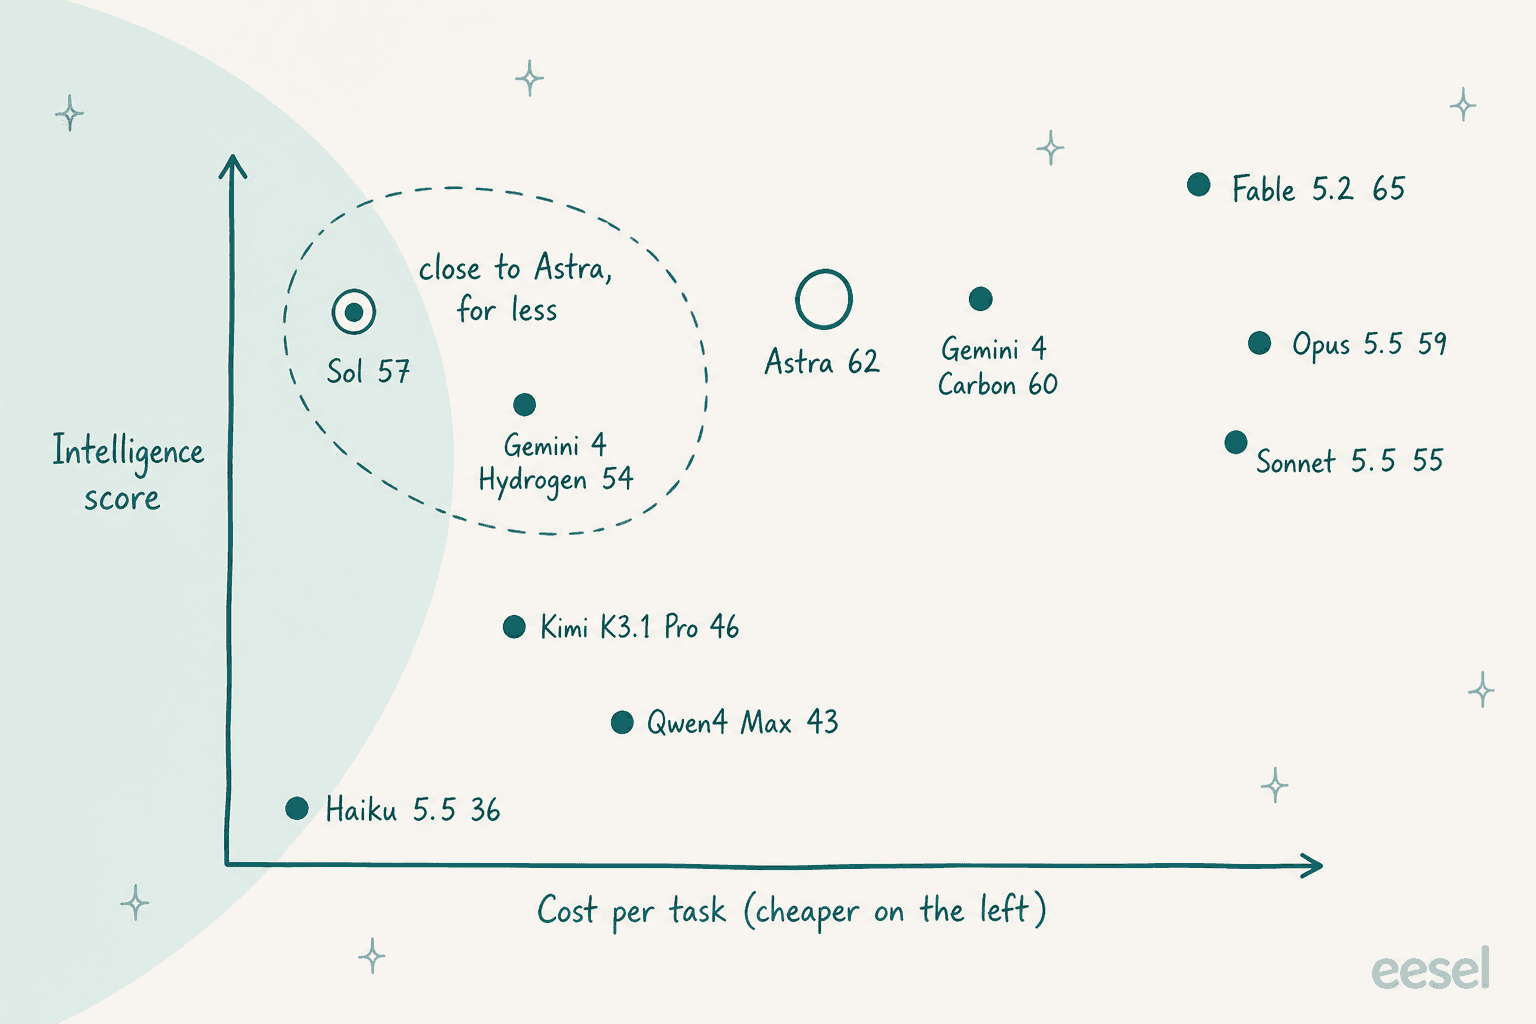
この図がこの記事を1枚にまとめたものです。Astraは高く中央に位置しています。Fable 5.2だけがその上、右側遠くにあります。Solはほぼ同じ高さで、左側遠くにあります。
GPT-6.2 Astra代替候補の一覧
価格は標準レートでの100万トークンあたりです。Artificial Analysisのスコアとコストは各モデルの最高エフォート設定での値です。
| モデル | 開発元 | 入力 / 出力 | キャッシュ入力 | コンテキスト | AAスコア | AAタスク単価 | AAタスクあたり時間 | 最適な用途 |
|---|---|---|---|---|---|---|---|---|
| GPT-6.2 Astra(基準) | OpenAI | $8 / $40 | $0.40 | 1.05M | 62 | $4.00 | 10.4分 | 難しい複数ステップのエージェント作業 |
| GPT-6.2 Sol | OpenAI | $2 / $10 | $0.10 | 1.05M | 57 | $1.01 | 7.9分 | 本番エージェントのトラフィックの大半 |
| Claude Opus 5.5 | Anthropic | $4 / $20 | $0.20 | 1M | 59 | $10.04 | 24.6分 | 長いコーディングと文章作成作業 |
| Claude Fable 5.2 | Anthropic | $8 / $40 | $0.20 | 1M | 65 | $26.54 | 40.8分 | 入手可能な最高スコア |
| Claude Sonnet 5.5 | Anthropic | $2 / $10 | $0.10 | 1M | 55 | $10.02 | 32.3分 | Solと同じ価格帯のAnthropic製 |
| Gemini 4 Carbon | 11月30日まで$2/$10、以降$4/$20 | $0.10、以降$0.20 | 1M | 60 | $5.48 | 33.4分 | Astraに近いスコア、第二のベンダー | |
| Gemini 3.8 Flash | 12月31日まで$0.75/$3.75 | $0.075 | - | 31 | - | 14.1分 | 大量かつ安価なステップ処理 | |
| Grok 4.7 | xAI | $2 / $6 | $0.50 | 500K | 35 | - | 24.5分 | 出力の長いエージェントループ |
| DeepSeek V4 ProとFlash | DeepSeek | $0.66 / $1.98(Pro、オフピーク) | $0.022 | 1M | 23(Pro) | $1.77(Pro) | 17.3分 | トークン費用が最も低い |
| Kimi K3.1 Pro | Moonshot AI | $2 / $10 | $0.20 | 1M | 46 | $3.68 | 38.7分 | Sol価格の非米国系選択肢 |
| Qwen4 Max | Alibaba(Qwen Cloud) | $1.50 / $4.50 | $0.075 | 1M | 43 | $3.27 | 31.9分 | 大規模でも低い出力価格 |
リストの前に読んでおきたい2点です。Gemini 4 Carbonの価格は12月1日に倍になるので、後の価格で予算を組んでください。DeepSeekの価格は平日のピーク時間に倍になり、これについては各モデルの節で扱います。
トークン単価が半分なら料金も半分になるのか?
いいえ、ここでほとんどの比較が間違えます。モデルのトークン単価はトークン1つのコストを示すだけです。モデルが1タスクを終えるのに何トークン使うか、終える前にどれだけ考えるかは示しません。
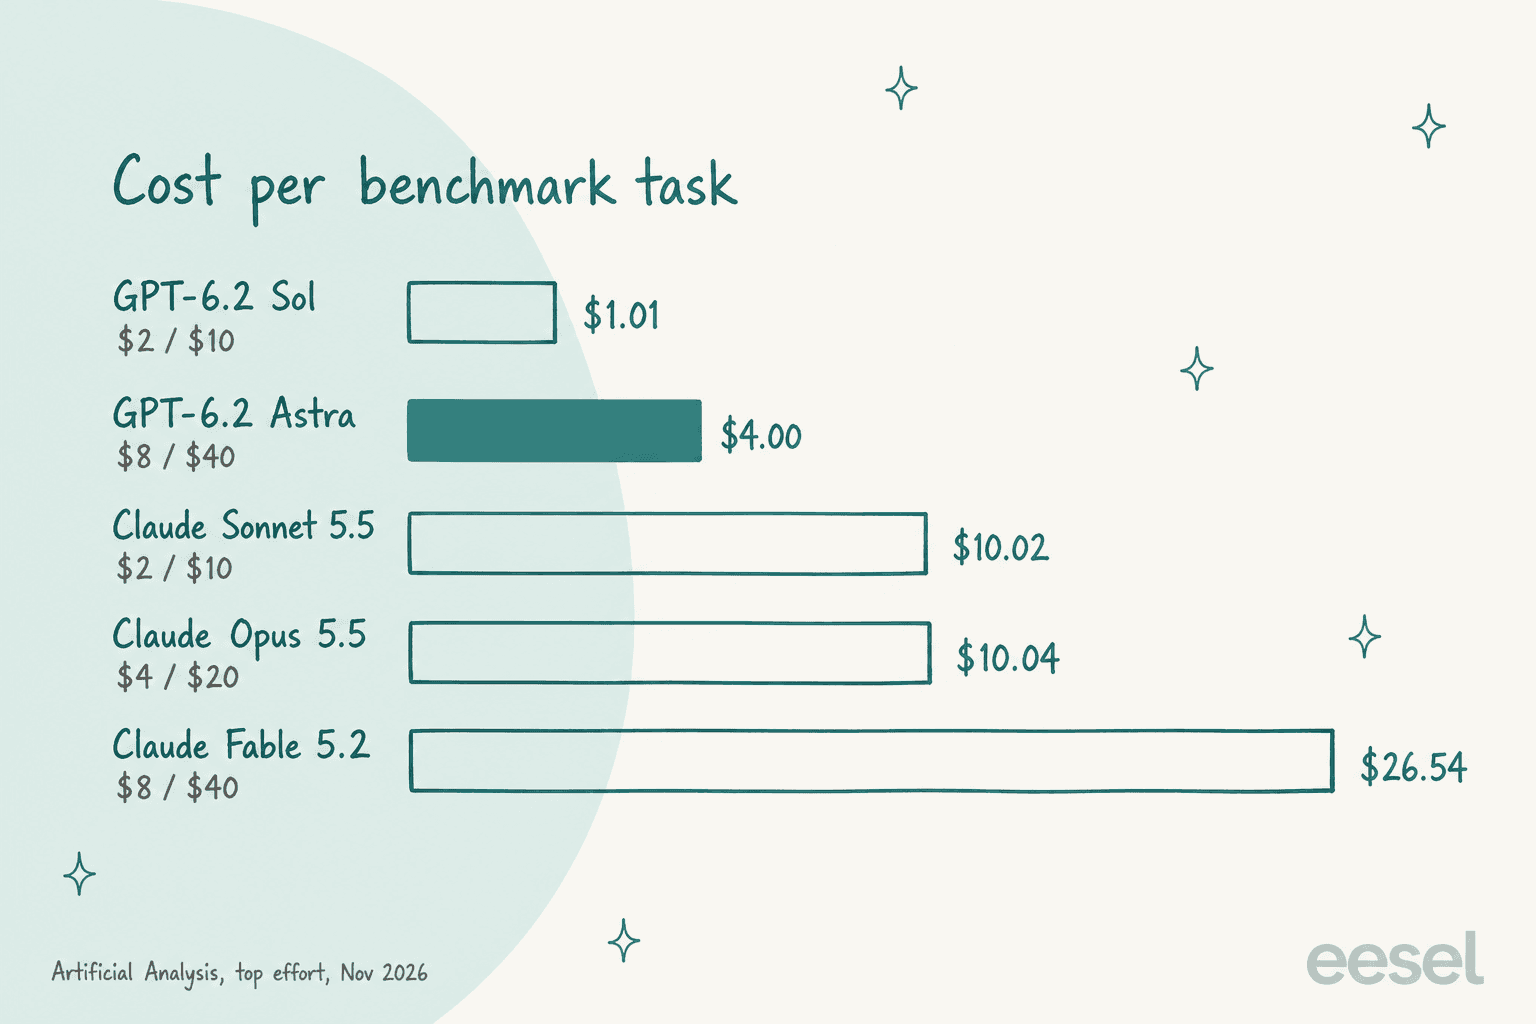
Claude Opus 5.5はAstraのトークン単価の半分($4/$20対$8/$40)を課金しますが、Artificial Analysisは1タスク$10.04と計測し、Astraの$4.00を上回りました。Sonnet 5.5はSolと同じトークン単価ですが、タスクあたりでは10倍のコストがかかりました。その理由は時間の列に表れています。Opusは最大エフォートで1タスクに24.6分、Sonnetは32.3分を要し、Astraの10.4分を大きく上回っています。多く考えるほど出力トークンが増え、出力はどの価格表でも高くつく側です。
この公平さを保つために2つの留保があります。Artificial Analysisは各モデルを最高エフォートで実行しますが、Anthropicのモデル概要ではOpus 5.5は標準でミディアムエフォートで提供されるため、デフォルト設定での料金はベンチマークの数字より低くなるはずです。そしてベンチマークタスクはあなたのタスクではありません。タスク単価は方向性の警告として受け止め、その上で自分の実際の作業で測定してください。
あるHNのコメント投稿者は、自身のコーディング利用から同じ考えに実際の数字を当てています。
"Opus cost me about $1 in tokens per task while Haiku costs about 4.6 cents and Luna is about 2.5 cents."
1. GPT-6.2 Sol
最適な用途: OpenAIに留まりつつ料金を約75%削減したいチーム。
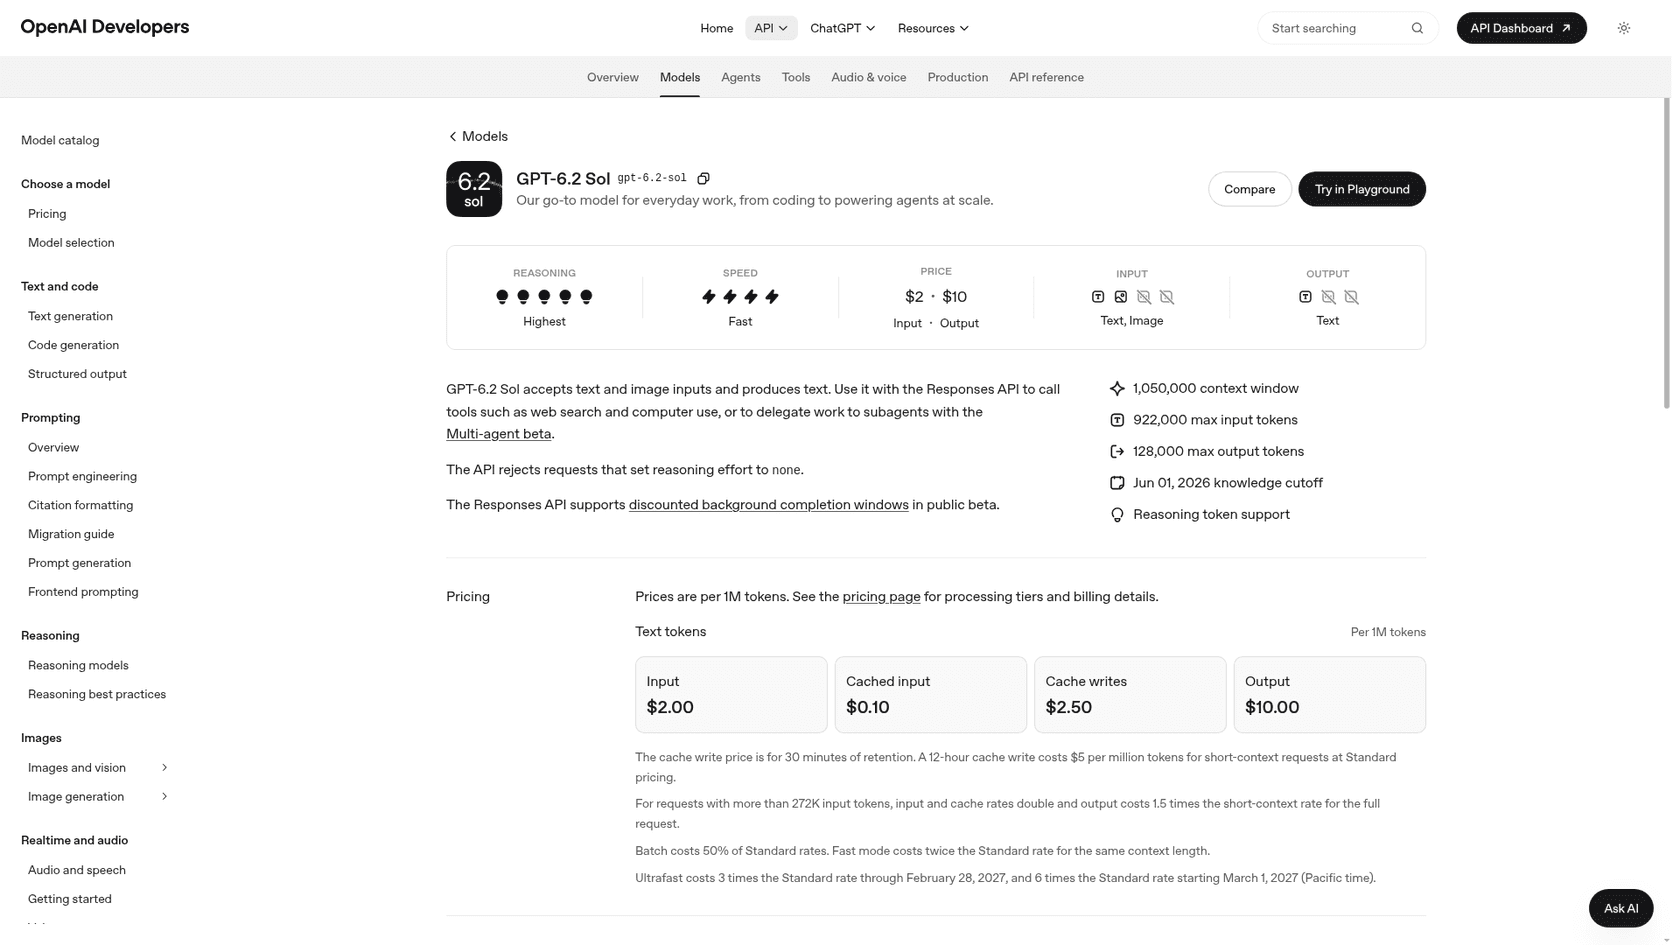
GPT-6.2 SolはAstraと同時に発売され、同じAPI、同じツール、同じ1,050,000トークンのコンテキストウィンドウ(入力922,000トークン、出力128,000トークン)を使います。モデル名を入れ替えるだけで移行は完了です。Artificial Analysisは57のスコアを付け、前世代のGPT-6 Astraと同水準でありながら、タスク単価はその約15%です。
私のテストでは、Solが1位の座を獲得しました。低・中・高のエフォートで45回実行したところ、すべてのチケットに正しく答えました。比例配分の返金は毎回$990になり、プロンプトインジェクションには丁寧な断りの返答が返り、壊れた照会はエスカレーションされ、スペイン語とドイツ語の顧客には各自の言語で返信がありました。Astraも同様でした。
| 私のテスト、15チケット | 1,000チケットあたりのコスト | 返信時間の中央値 |
|---|---|---|
| GPT-6.2 Astra、低/中/高 | $5.75 / $5.79 / $6.57 | 5.4秒 / 3.3秒 / 4.5秒 |
| GPT-6.2 Sol、低/中/高 | $1.42 / $1.40 / $1.54 | 2.5秒 / 2.5秒 / 2.8秒 |
同じ回答が約4分の1の価格で、しかも速く得られました。この長さのチケットではエフォートがコストをほとんど動かさなかった点は、デフォルトで高エフォートの料金を払う前に知っておく価値があります。
"For just doing things or coding things up, Sol all the way."
メリット
- 100万トークンあたり$2/$10、キャッシュ入力は$0.10
- Astraと同じAPI、ツール、コンテキストウィンドウなので、切り替えは1行の変更で済む
- 私のサポートチケット15件すべてで、どのエフォートレベルでもAstraに匹敵した
デメリット
- Artificial AnalysisによるとGPT-6.1 Solに対してCoding Agent Indexで3ポイント失っており、主に回答で重要な事実を省略するためとしている
- 大規模なコードベースでは、一部の開発者が今もSolの作業をAstraに戻してクリーンアップしている
- APIはリーズニングエフォート
noneを拒否する
価格: OpenAIの価格ページによると、標準レートで100万トークンあたり入力$2、キャッシュ$0.10、出力$10です。バッチなら半額です。OpenAI APIの価格のガイドでは各ティアを扱っています。
結論: まずここから始めましょう。Solを標準にし、Solが明らかに失敗するタスクのためだけにAstraを残してください。今日まだ前バージョンを使っているなら、GPT-6.1 Solレビューがそちらを扱っています。
2. Claude Opus 5.5
最適な用途: 生の速さよりも明確な説明の方が重要な、長いコーディングと文章作成作業。
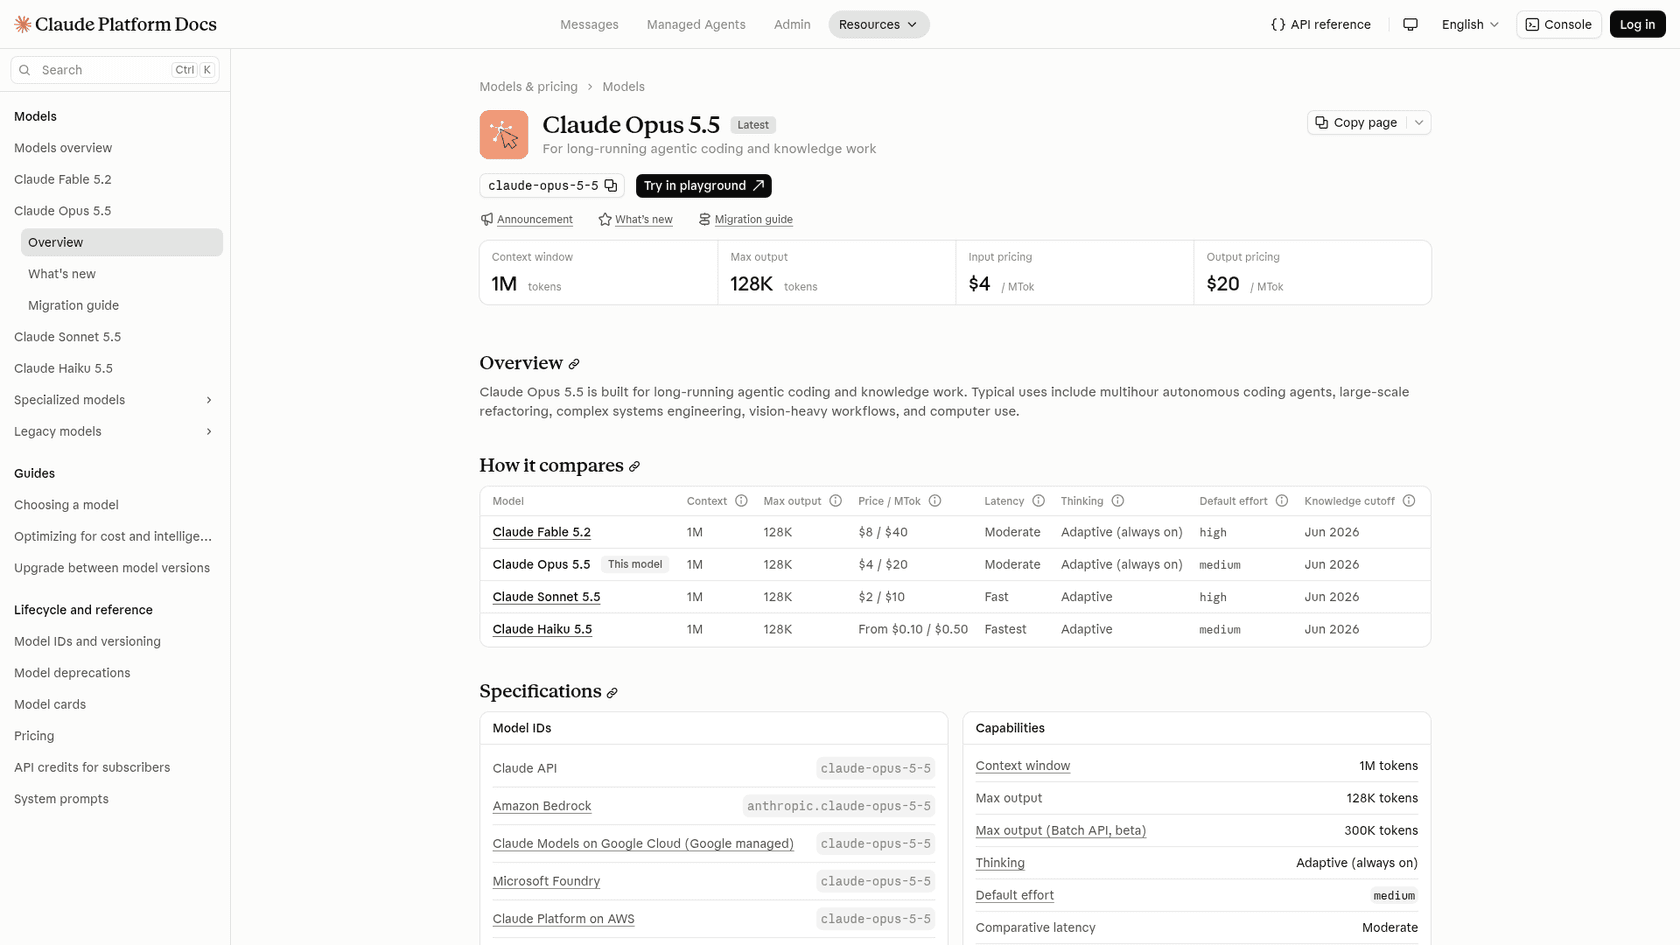
Claude Opus 5.5は、Anthropicがほとんどの開発者にまず使うよう勧めるモデルです。ドキュメントでは"long-running agentic coding and knowledge work"向けに作られていると説明されており、1Mトークンのコンテキストウィンドウ、128Kの出力、標準でミディアムエフォートを備えます。Artificial Analysisでは59を記録し、Astraより3ポイント下です。
このモデルを選ぶ理由はスコアではありません。コミュニケーションの仕方にあります。Astraに対する最も大きな不満は、長い実行の要約が追いにくいという点であり、Opusはそれを解消するために複数のテスターが頼る先になっています。
"I've already built the habit of switching to opus 5.5 at the end of a long 6.2 Astra run, just to get a readable summary of what it said."
メリット
- Astraのトークン単価の半分、$4/$20。キャッシュ読み取りは$0.20
- テスターは長いタスクでの説明と計画立案を一貫して好んでいる
- Anthropicの価格ドキュメントによると、Fastモードは追加費用で最大2.5倍の出力速度を提供する
デメリット
- 最大エフォートでベンチマークタスクあたり$10.04、Astraの数字の2.5倍
- 最大エフォートでタスクあたり24.6分、Astraの時間の2倍以上
- 一部の開発者は、今も文章に2度目の編集パスが必要だと感じている
価格: 入力$4、出力$20、キャッシュ読み取り$0.20、5分間のキャッシュ書き込みは$5です。Claude Opus 5.5の価格のガイドで残りを分解しています。
結論: エージェントの出力を読む人にとって、第二のベンダーとして最良の選択肢です。最大エフォートではなくミディアムで実行し、トークン単価が低いからといってそのまま安くなると思い込む前にタスクあたりの料金を確認してください。私のClaude Opus 5.5レビューでより詳しい見解を扱っています。
3. Claude Fable 5.2
最適な用途: 料金よりトップスコアが重要な、まれなタスク。
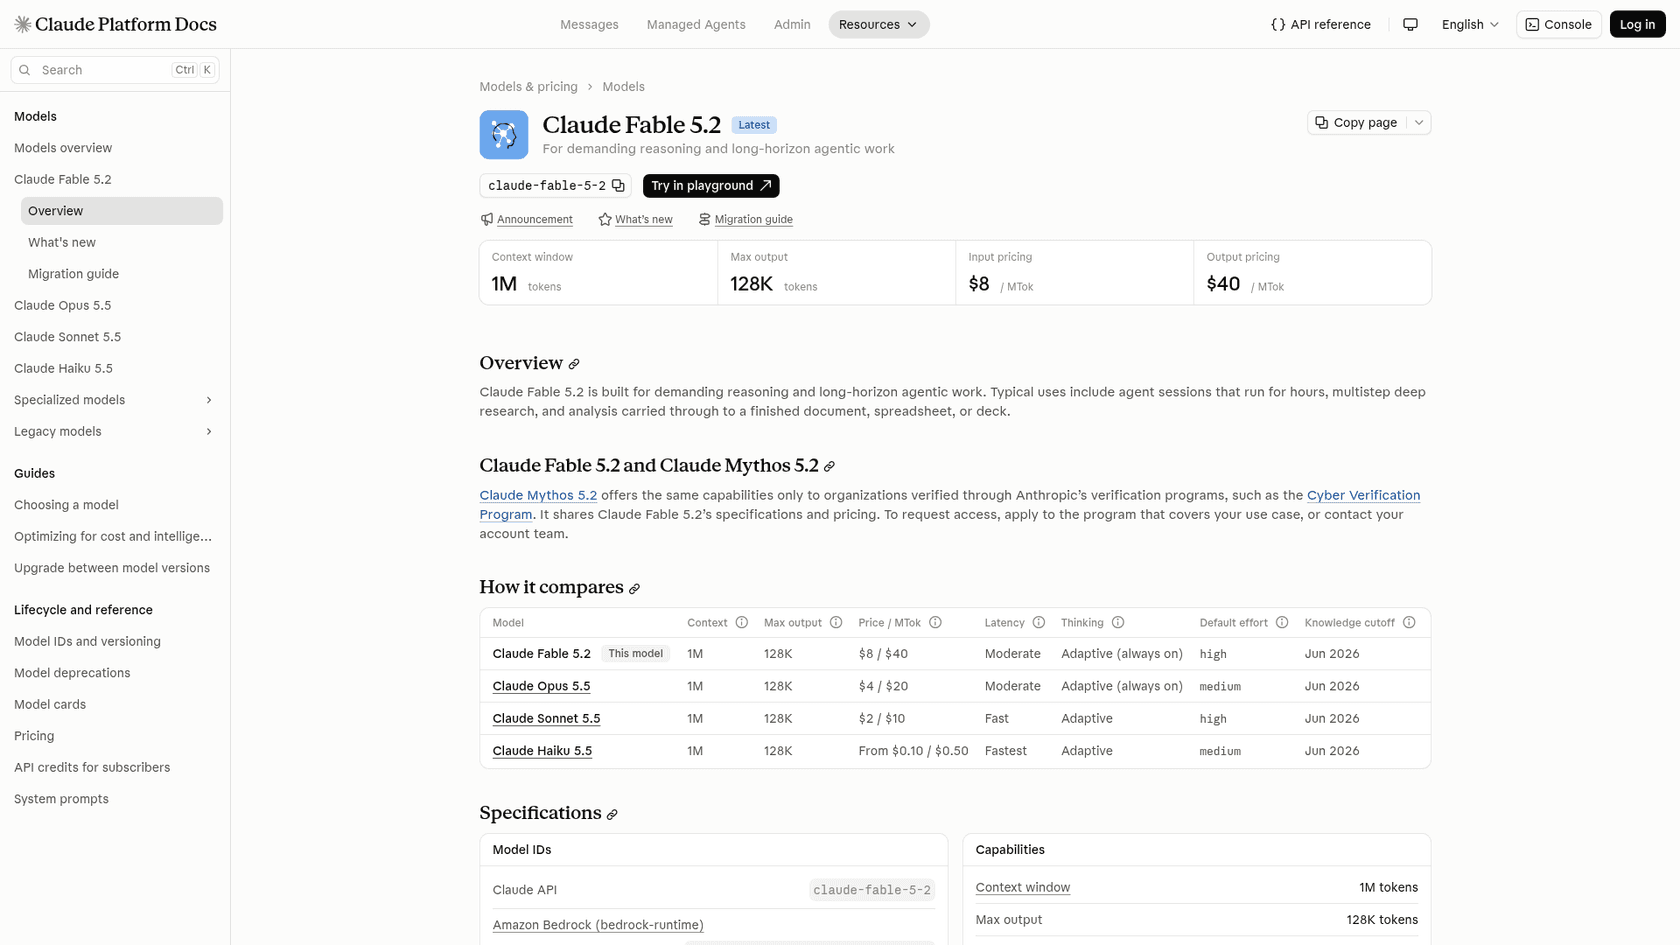
Claude Fable 5.2は、このリストでAstraをスコアで上回る唯一のモデルです。Artificial Analysis Intelligence IndexでAstraの62に対して65を記録しています。Astraと同じ$8/$40の表示価格ですが、キャッシュ読み取りは$0.20対$0.40と半額です。Anthropicはこれを"demanding reasoning and long-horizon agentic work"向けに作られたと説明しています。
そしてタスクあたりの料金がやってきます。Artificial AnalysisはFable 5.2を1タスク$26.54、40.8分と計測しました。これはAstraの$4.00、10.4分に対してです。同じトークン単価で、タスク単価は6.6倍です。あるHNコメント投稿者は、この取引におけるAstra側の意味をまとめています。
"Second place at a sixth the price and in a quarter of the time (both according to Artificial Analysis for Astra 6.2 vs. Fable 5.2, both max effort) definitely has a place."
数週間のテストの後、他の人たちは逆の見解に達しました。
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
メリット
- どのモデルよりも高いArtificial Analysisスコア、65を記録
- Astraと同じトークン単価ながら、キャッシュ読み取りはより安い
- デザインと長いエージェント的タスクでテスターから高評価
デメリット
- ベンチマークタスクあたり$26.54と、ここでは群を抜いて最も高額
- タスクあたり40.8分と、このリストで最も遅い
- 思考が常にオンなので、非リーズニングモードに切り替えられない
価格: 入力$8、出力$40、キャッシュ読み取り$0.20、5分間のキャッシュ書き込みは$10です。バッチは半額です。Claude Fable 5.2の価格のガイドでFastモードを扱っています。
結論: これはアップグレードであり、代替ではありません。Astraが間違えるわずかなタスクのためだけに使い、料金がそれを示すことを前提にしてください。Claude Fable 5.2レビューで詳細を扱っています。
4. Claude Sonnet 5.5
最適な用途: Solの価格でAnthropicの文体を使いたいチーム。
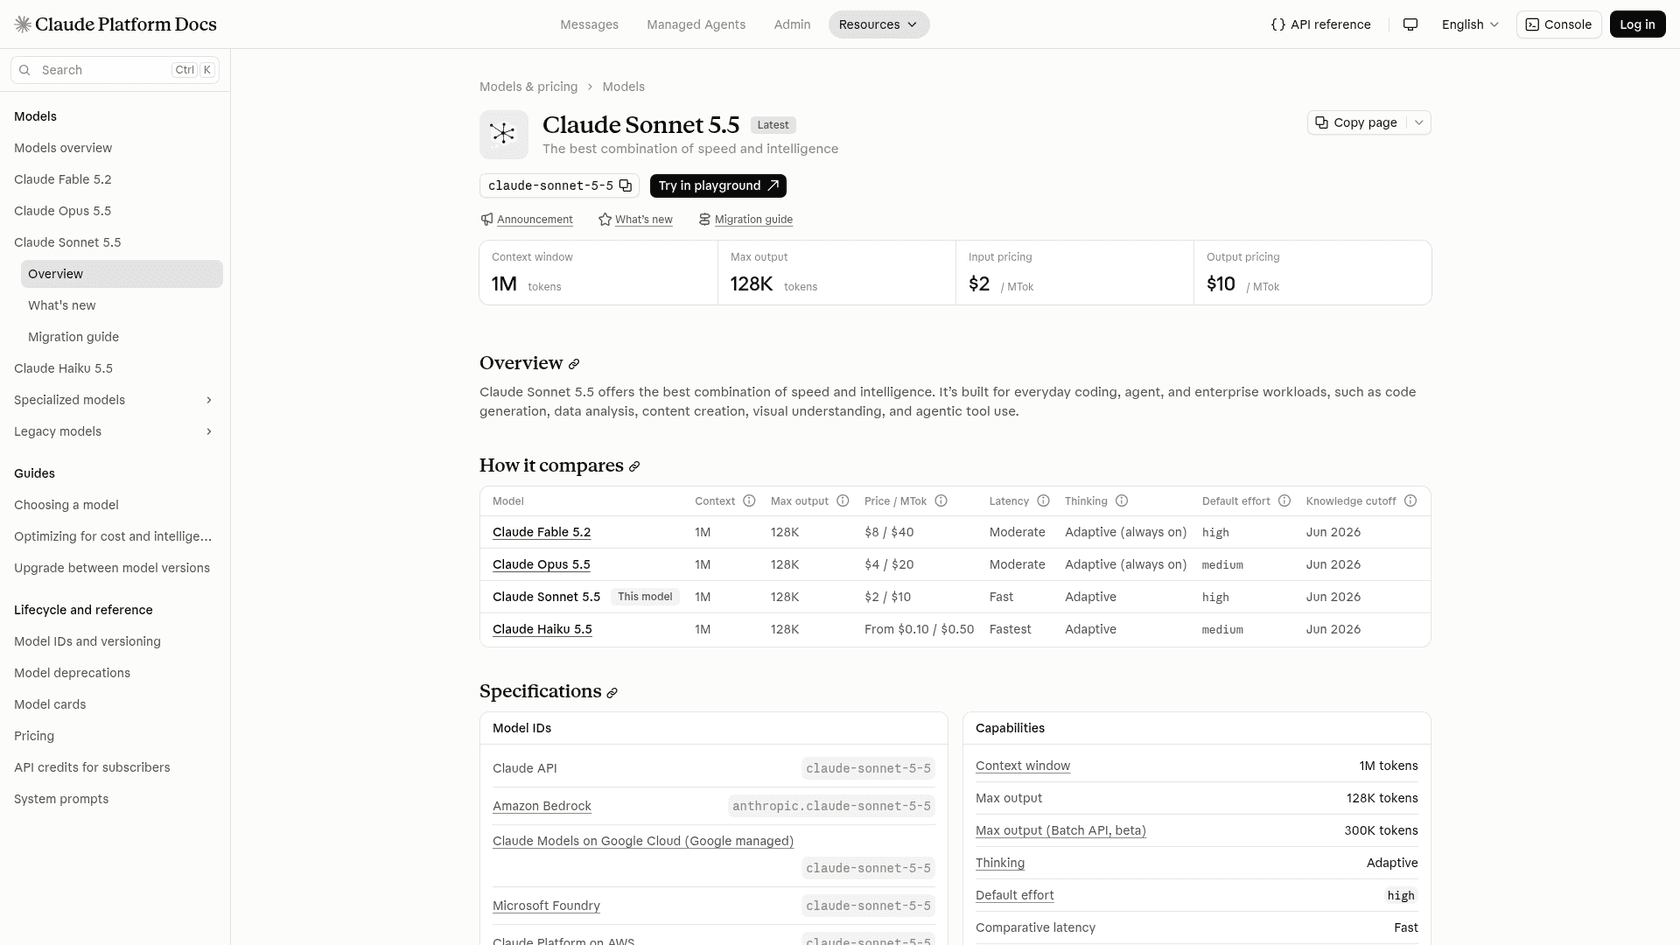
Claude Sonnet 5.5は、Anthropicが"the best combination of speed and intelligence"と呼ぶモデルです。Solと同じ$2/$10で、キャッシュ読み取りは$0.10、コンテキストは1Mです。OpusやFableと異なり、思考は常時オンではなくアダプティブで、デフォルトのエフォートは高です。
Artificial Analysisでは最大エフォートで55を記録し、タスク単価は$10.02、タスクあたり32.3分かかります。これはOpusと同じタスク単価の落とし穴ですが、ここではより深刻です。Solはタスク単価の10分の1でスコアが2ポイント高いからです。解決策は同じです。最大エフォント未満で実行し、計測することです。
メリット
- $2/$10で、キャッシュ読み取り$0.10はSolと同じ
- アダプティブな思考なので、単純な要求が長い思考の分を払わされない
- Opusと同じ1Mコンテキストと128K出力
デメリット
- 最大エフォートでベンチマークタスクあたり$10.02、Solの数字の10倍
- Artificial Analysisで55、Solの57を下回る
- デフォルトのエフォートが高で、高くつく設定がそのまま初期設定になっている
価格: Anthropicの価格によると、入力$2、出力$10、キャッシュ読み取り$0.10、5分間のキャッシュ書き込みは$2.50です。Claude Sonnet 5.5の価格のガイドも参照してください。
結論: すでにAnthropicを使っているか、その文体を好む場合にのみSolより選んでください。エフォートレベルは自分で設定しましょう。私のClaude Sonnet 5.5レビューで破壊的変更を扱っています。
5. Gemini 4 Carbon
最適な用途: 12月の価格で予算を組むなら、第二のベンダーからAstraに近いスコアを得たい場合。
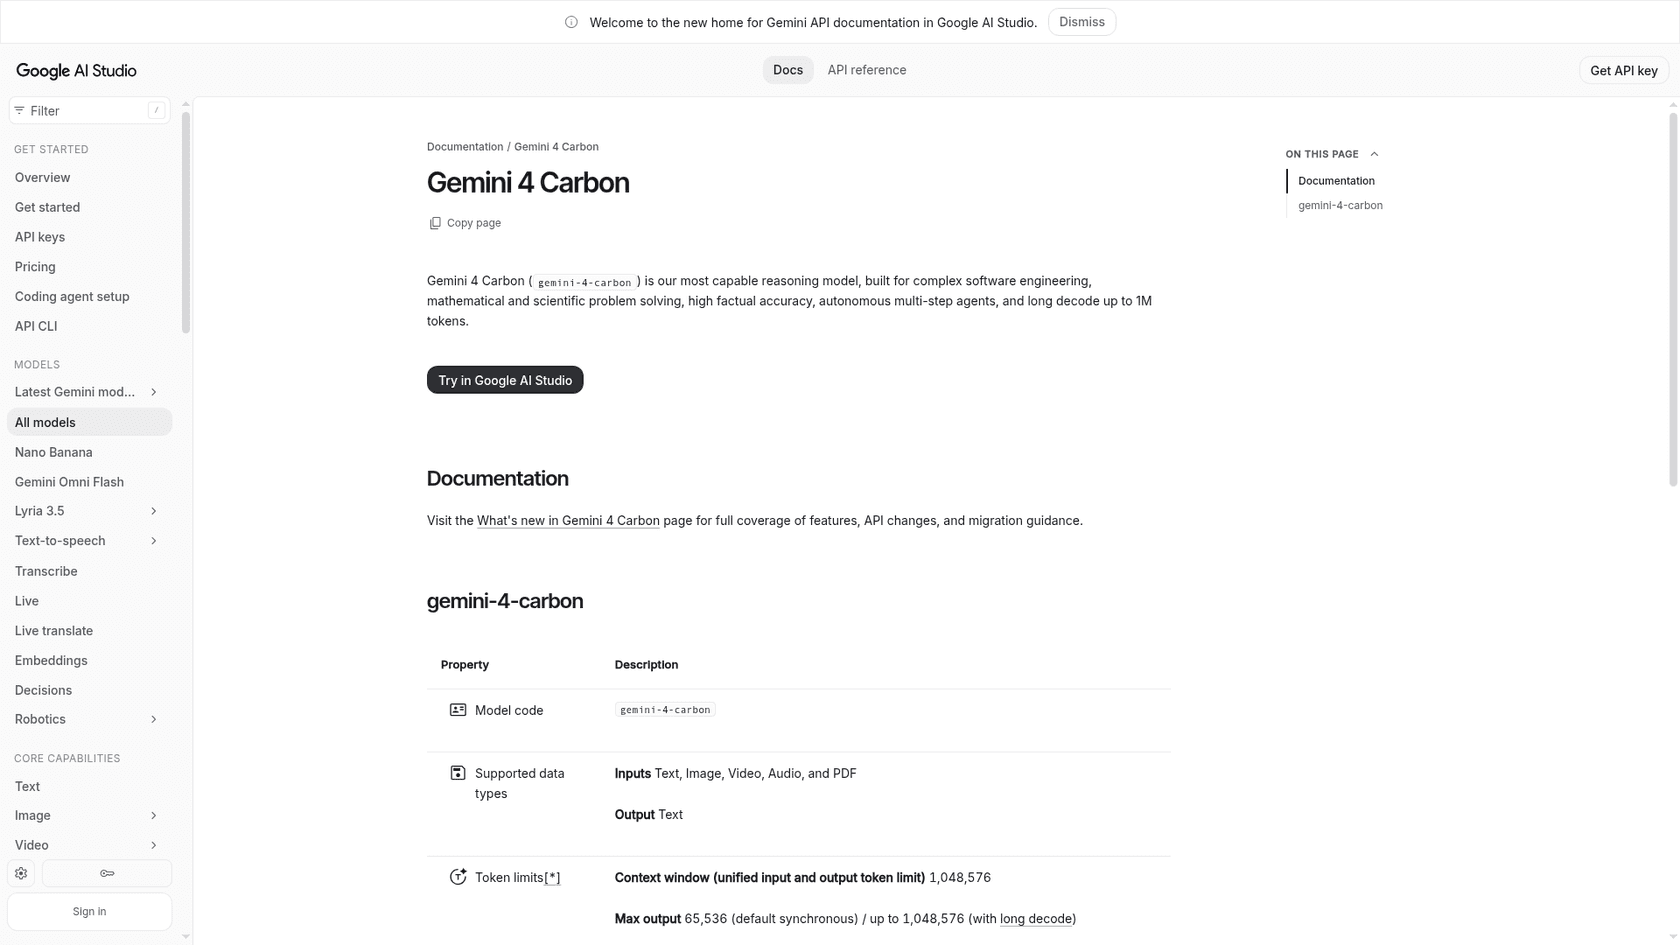
Gemini 4 CarbonはGoogle最強の推論モデルで、Artificial Analysisで60を記録し、Astraより2ポイント下、Opus 5.5より1ポイント上です。タスク単価は$5.48で、OpenAI以外のモデルとしては両軸でAstraに最も近づいています。テキスト、画像、動画、音声、PDFに対応し、1,048,576トークンのコンテキストと、ロングデコードによる最大1Mトークンの出力を持ちます。
カレンダーに注意してください。Googleの価格ページでは、Carbonは2026年11月30日まで$2/$10、12月1日以降は$4/$20とされています。キャッシュは暗黙的なものだけで、Carbonには無料枠がありません。
Carbonの価格が高すぎる場合、GoogleのGemini 4 Hydrogenがより安価な兄弟モデルです。$1.50/$7.50、無料枠あり、スコア54で1タスク$3.16です。そしてあるHNの開発者は、このファミリーに注目する別の理由を見つけています。
"My favorite model for this at the moment is Gemini 4 Argon, which writes very naturally and isn't too expensive."
メリット
- 1タスク$5.48でArtificial Analysis 60、このリストでOpenAI以外として最良のバランス
- テキストと画像に加え、動画、音声、PDFも入力として受け付ける
- ロングデコードで最大1Mトークンの出力
デメリット
- 2026年12月1日に価格が$4/$20へ倍になる
- ベンチマークタスクあたり33.4分と、Astraの3倍以上の時間がかかる
- 暗黙的キャッシュのみで、無料枠がない
価格: 11月30日まで$2/$10とキャッシュ$0.10、以降は$4/$20と$0.20です。検索グラウンディングは月5,000リクエストまで無料、以降は1,000件あたり$14です。Gemini 4 Carbonの価格のガイドでバッチとフレックスのティアを扱っています。
結論: Astraに近い知能が必要なら、第二のベンダーとして最も強力な選択肢です。初日から$4/$20で予算を組んでおけば、12月に驚かずに済みます。私のGemini 4 Carbonレビューでベンチマークを扱っています。
6. Gemini 3.8 Flash
最適な用途: 分類、抽出、下書き作成のような、大量かつ安価なステップ処理。
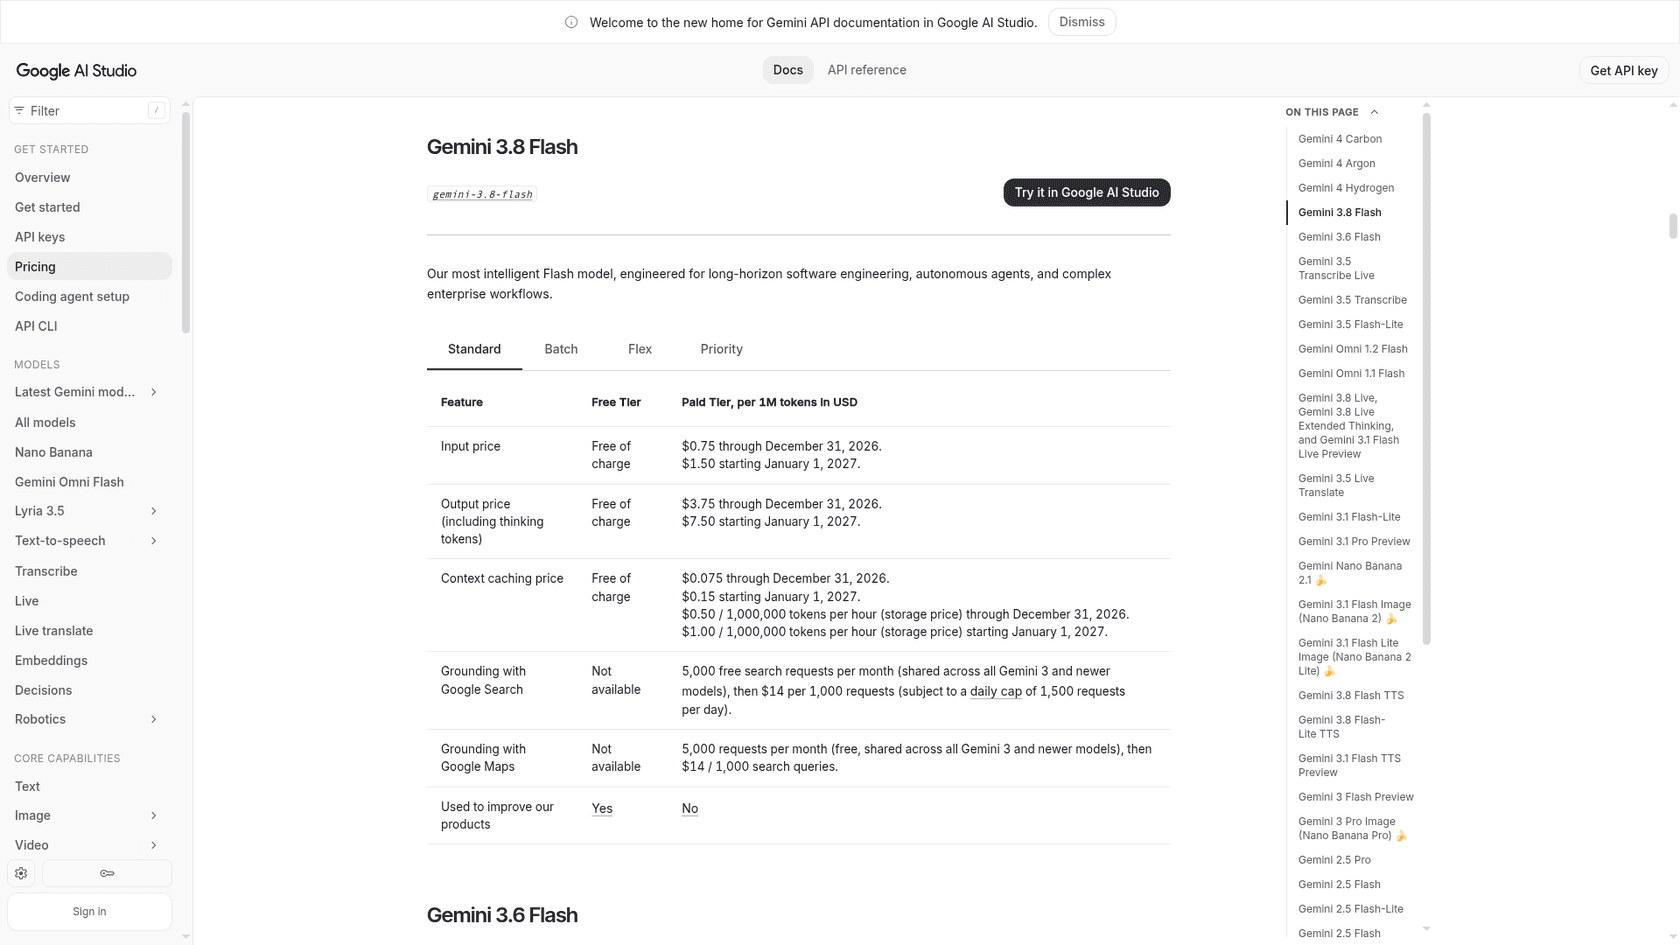
GoogleはGemini 3.8 Flashを自社最も知能の高いFlashモデルと説明し、"engineered for long-horizon software engineering, autonomous agents, and complex enterprise workflows"だとしています。ChatGPTはこれを、価格を理由に自身のAstra代替リストの上位に挙げました。100万トークンあたり$0.75/$3.75で、Astraの約10分の1です。
スコアがもう半分の話です。Artificial Analysis Intelligence Indexで31と、Astraの62の半分です。これはAstraの難しいタスクの代わりにはなりません。タスクが小さく明確に定義された、ルーティングされたシステムの安価な車線向けのモデルです。
メリット
- $0.75/$3.75、Astraのトークン単価の約10分の1
- テスト用の無料枠
- キャッシュ入力は$0.075
デメリット
- Artificial Analysisで31、このリストで2番目に低いスコア
- 2027年1月1日に価格が$1.50/$7.50へ倍になる
- Flashモデルであるにもかかわらず、ベンチマークタスクあたり14.1分とAstraより遅い
価格: Googleの価格ページによると、2026年12月31日まで入力$0.75、出力$3.75、キャッシュ$0.075です。Gemini 3.8 Flashの価格のガイドで2027年の上昇を扱っています。
結論: これはルーティング用のツールであり、置き換えではありません。トラフィックの単純な部分に使い、判断力が必要なものにはより強力なモデルを残してください。Gemini 3.8 Flashの代替のリストに、同じ価格帯の選択肢があります。
7. Grok 4.7
最適な用途: 出力量がAstraを高くつかせてしまう、長いエージェントループ。
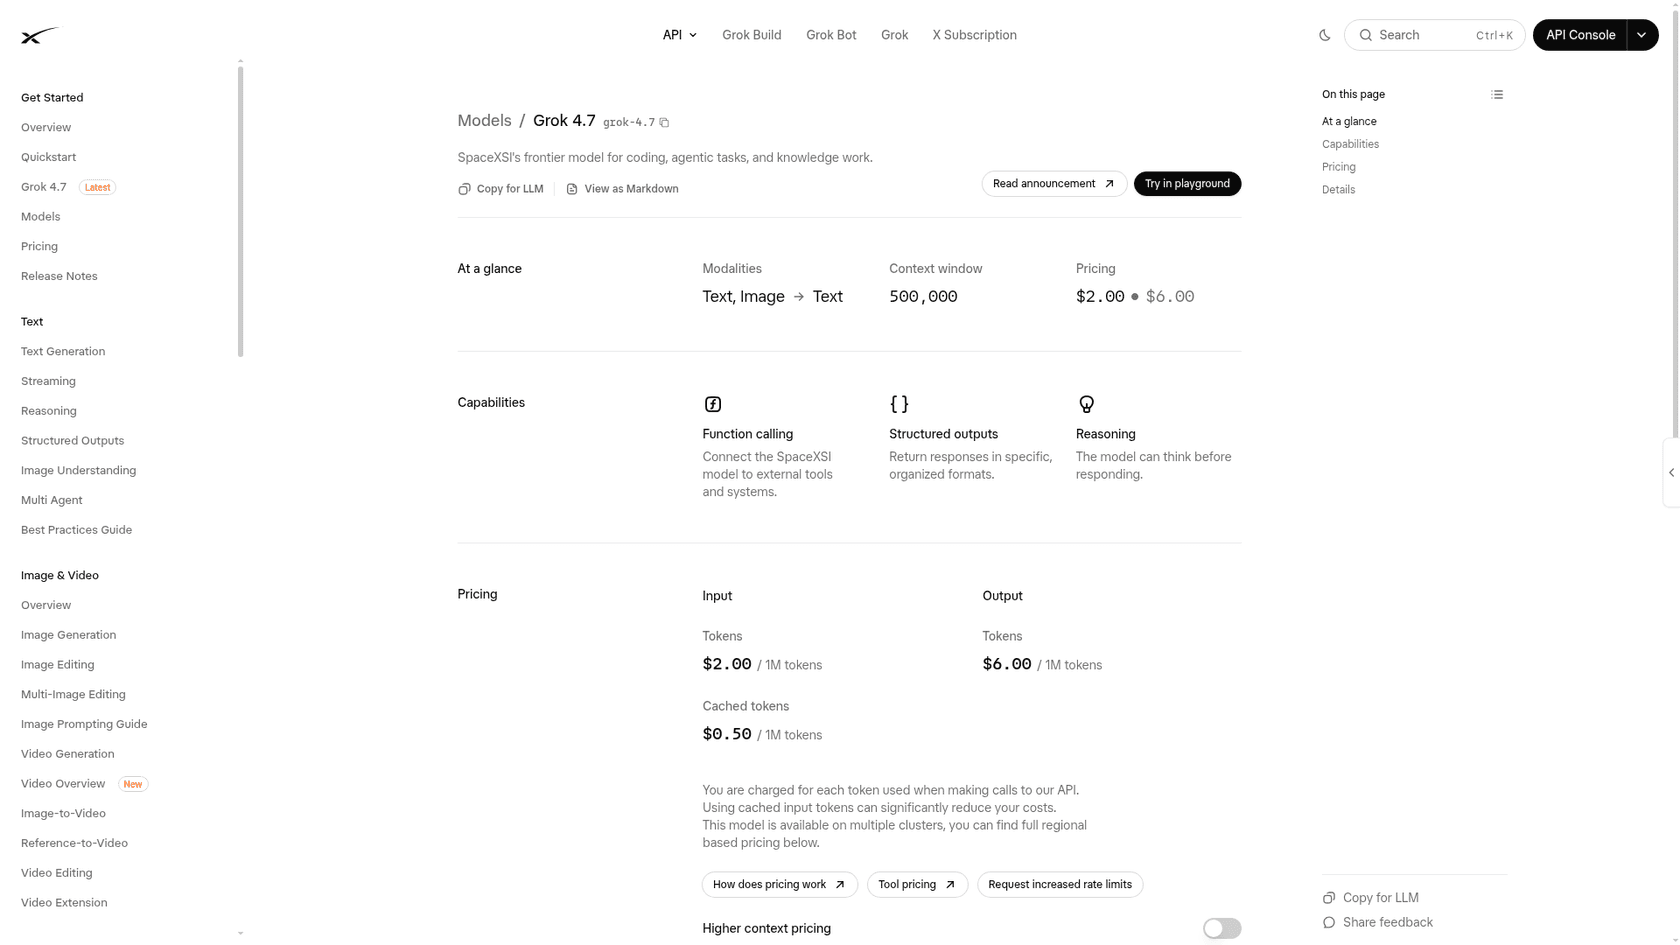
Grok 4.7は出力100万トークンあたり$6で、Astraの$40、Solの$10に対してです。入力は$2でキャッシュ入力は$0.50、コンテキストウィンドウは500Kトークンです。xAIはモデル上でのファンクションコール、構造化出力、推論もサポートしています。
Artificial Analysisのスコアはxhighエフォートで35、ベンチマークタスクあたり24.5分かかりました。これは全体指標でAstraを大きく下回ります。xAI自身のローンチベンチマークはより近い結果を示しており、Grok 4.7はEEBenchでClaude Fable 5.1の56.4に対して64.0を記録しているため、除外する前に自分のループでテストしてみる価値があります。Grok 4.7レビューで詳しく扱っています。
メリット
- 出力100万トークンあたり$6、Astraの6分の1未満
- 500Kのコンテキストウィンドウ
- ネイティブのファンクションコールと構造化出力
デメリット
- Artificial Analysisで35、Astraの62をはるかに下回る
- 200Kトークン以上のプロンプトは$4/$12で課金される
- Web検索などのサーバーサイドツールは1,000コールあたり追加で$5かかる
価格: xAIの価格ページによると、入力$2、キャッシュ$0.50、200Kトークン未満での出力は$6です。Grok 4.7の価格のガイドでツール費用を扱っています。
結論: 出力トークンが料金を支配しているなら試す価値があります。良い方向にも悪い方向にも、指標のスコアだけで選ばないでください。Grok 4.7の代替の記事で同じ価格帯の他の選択肢と比較しています。
8. DeepSeek V4 ProとFlash
最適な用途: ワークロードがオフピーク時間とテキストに収まるなら、最も低いトークン料金。
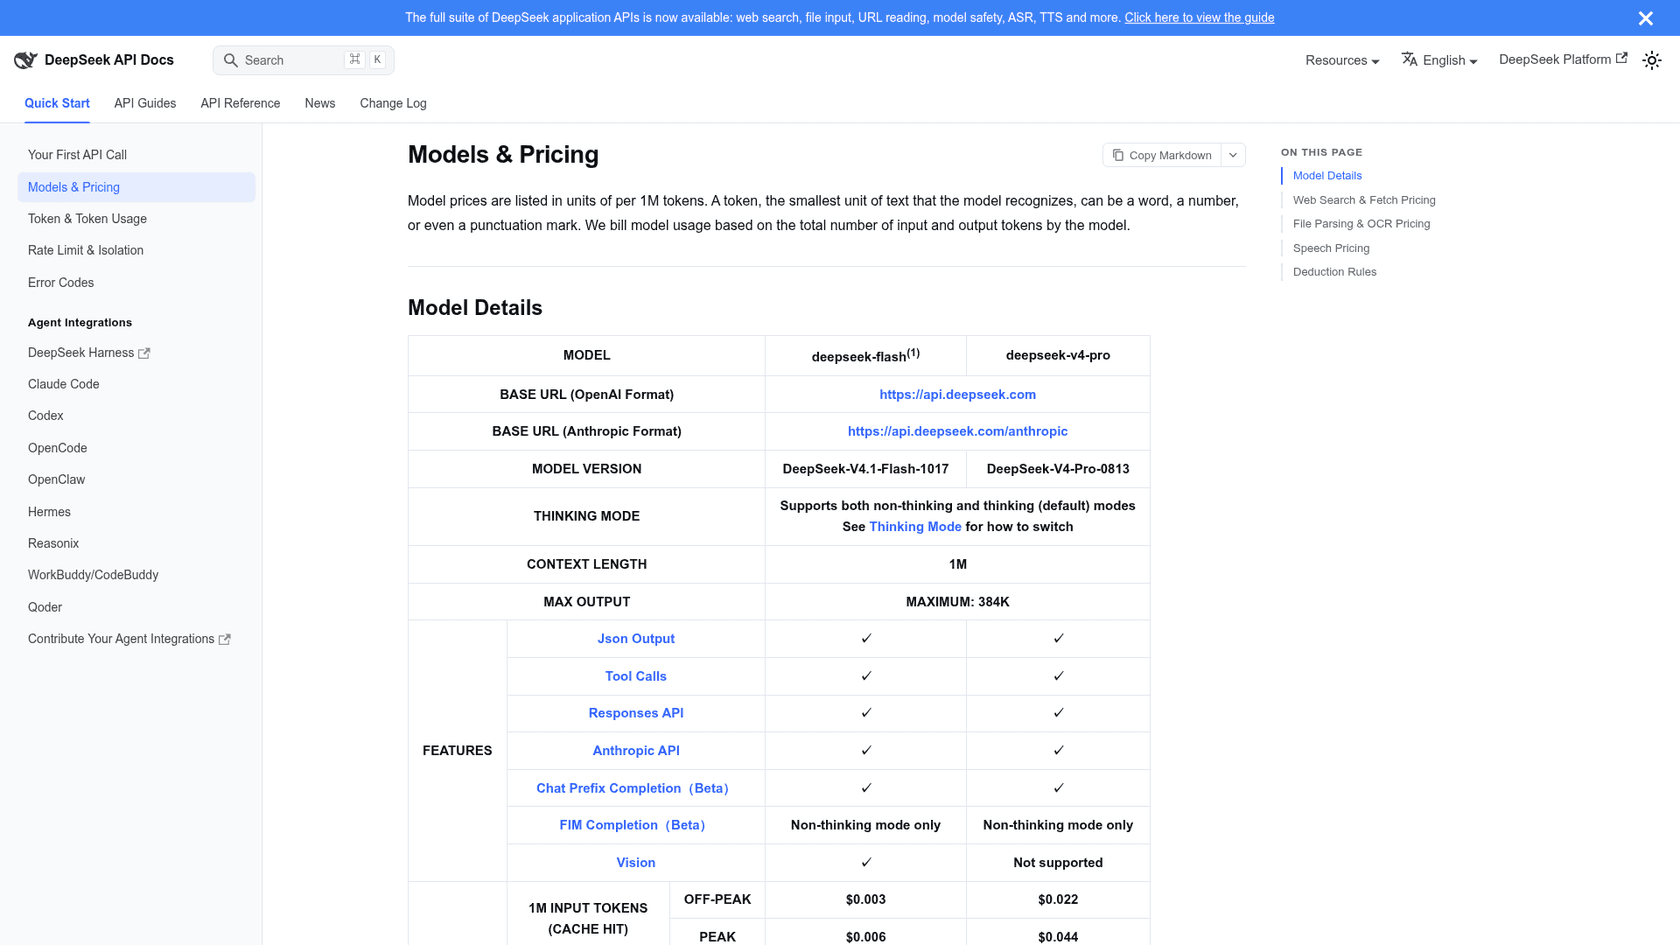
DeepSeekはOpenAI互換のAPIを通じて2つのモデルを提供しており、Anthropic API形式も受け付けます。deepseek-flashは現在DeepSeek V4.1 Flashを提供し、オフピークで入力$0.15、出力$0.60です。deepseek-v4-proはオフピークで$0.66/$1.98です。両方とも1Mのコンテキスト、最大384Kの出力、ツールコール、JSON出力に対応しています。
落とし穴は時間帯です。DeepSeekは平日のピーク時間に価格を倍にします。UTCの01:00〜04:00と06:00〜10:00で、Proは$1.32/$3.96、Flashは$0.30/$1.20になります。キャッシュヒットは100万あたり$0.003〜$0.044とほぼ無料です。
Artificial Analysisでは、V4 Proは最大エフォートで23を記録し、1タスク$1.77です。これはここにある他のどのモデルよりも大きく下回るため、DeepSeekは明確に定義された作業向けのコスト重視の選択肢として扱ってください。Flashにはまさにそのためのファンがいます。
"I used Luna Max a lot, until Deepseek 1017. Then never again."
メリット
- オフピークで$0.15/$0.60のFlashは、このリストで最も安い実用的なモデル
- OpenAIとAnthropic両方のAPI形式を受け付ける
- 1Mのコンテキストと最大384Kの出力
デメリット
- 平日のピーク時間(UTC)に価格が倍になる
- V4 Proはここで最も低いArtificial Analysis 23を記録
- V4 Proはビジョンに対応せず、並列処理は500リクエストに制限されている
価格: 100万トークンあたりオフピークで、Flash $0.15/$0.60、Pro $0.66/$1.98。ピーク時は倍です。Web検索とフェッチは1,000コールあたり$0.75です。DeepSeek V4.1 Flashの価格のガイドでピークスケジュールを詳しく扱っています。
結論: 可能ならオフピークに計画された、大量のテキストのみの作業に適した強力な安価な車線です。Astraの難しいタスクの代わりにはなりません。両方の選び方についてはV4 Flash対V4 Proを参照してください。
9. Kimi K3.1 Pro
最適な用途: Solの価格で手に入る、非米国系のフロンティアオプション。
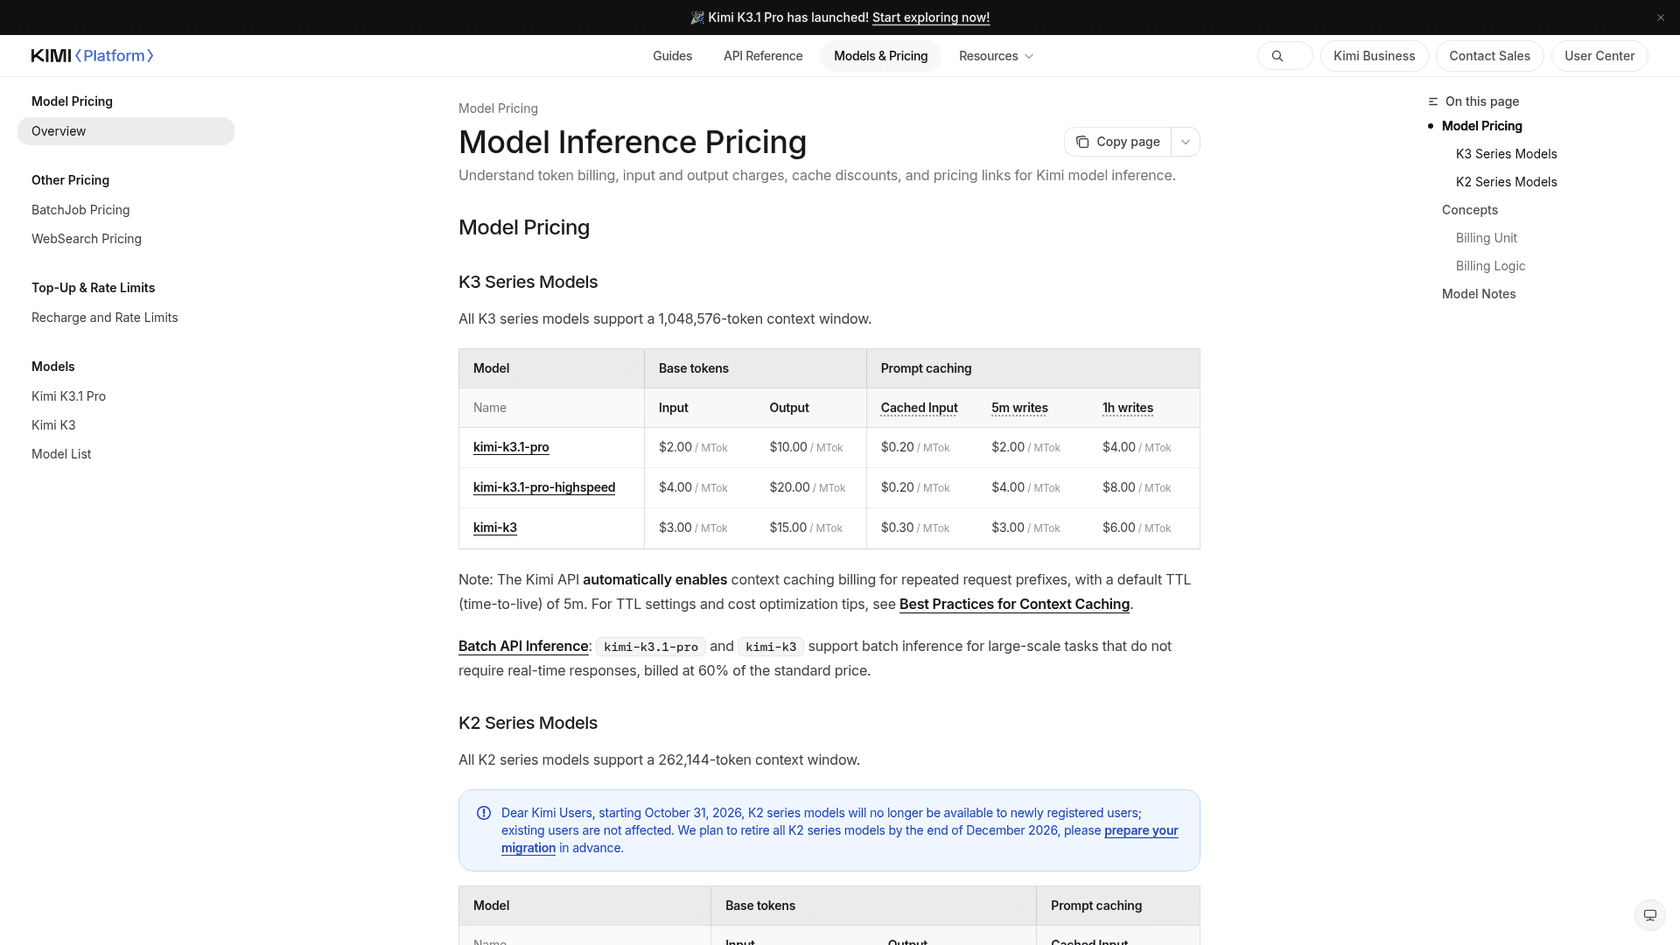
Moonshot AIのKimi K3.1 Proは、Solと同じ$2/$10で、キャッシュ入力は$0.20、コンテキストウィンドウは1,048,576トークンです。Kimiの価格ページより。ハイスピード版はその2倍の価格です。コンテキストキャッシュは繰り返されるプレフィックスに対して自動で有効になり、デフォルトの有効期間は5分です。
Artificial Analysisでは46を記録し、1タスク$3.68で、予算モデルとフロンティア級グループの中間に位置します。タスクあたりの時間は38.7分と長めです。
メリット
- $2/$10、SolやSonnet 5.5と同じ
- 設定不要の自動コンテキストキャッシュ
- 1Mトークンのコンテキストウィンドウ
デメリット
- Artificial Analysisで46、同じトークン単価のSolより11ポイント低い
- ベンチマークタスクあたり38.7分
- K2モデルは2026年10月31日以降新規ユーザーに提供されていないため、古いガイドが使えないモデルを指している場合がある
価格: 入力$2、出力$10、キャッシュ$0.20、5分間のキャッシュ書き込みは$2です。Kimi K3.1 Proの価格を参照してください。
結論: 非米国系の研究所が必要なら試す価値があります。同じ価格でも、共通指標ではSolの方が高いスコアを記録しています。Kimi K3.1 Proレビューでさらに深く扱っています。
10. Qwen4 Max
最適な用途: 大規模な汎用モデルからの低い出力価格。
Qwen4 Maxは2026年11月16日に一般提供が始まりました。Qwen Cloudのシンガポールリージョンでは、100万トークンあたり入力$1.50、出力$4.50、キャッシュ読み取りは$0.075です。Qwen Cloudのモデル価格より。コンテキストウィンドウは1Mトークンです。
Artificial Analysisでは43を記録し、1タスク$3.27です。これはKimi K3.1 Proより低く、Solよりかなり下ですが、出力価格はAstraの約9分の1です。
メリット
- $4.50の出力は、DeepSeekとGemini 3.8 Flashを除けばここで最も低い
- キャッシュ読み取りは$0.075
- 思考モードと非思考モードが同じ価格
デメリット
- Artificial Analysisで43
- 価格はリージョンによって異なるため、シンガポールのレートは普遍的ではない
- ベンチマークタスクあたり31.9分
価格: シンガポールで$1.50/$4.50、明示的キャッシュは5分間の書き込みで$1.875です。Qwen 4 Maxの価格のガイドで他のリージョンを扱っています。
結論: 単純な作業向けの予算選択肢です。Astraにより近いものを求めるなら、このリストの上位を見てください。Qwen 4 Maxの代替の記事で、自身の競合と比較しています。
乗り換えるのではなく、モデル間でルーティングすべきか?
ほとんどのエージェント製品では、はいです。Astraから安価なモデルへ一括で乗り換えると、そのモデルの弱点をすべてのタスクで受け入れることになります。ルーティングとは、各タスクをそれをうまく処理できる最も安いモデルに送ることです。
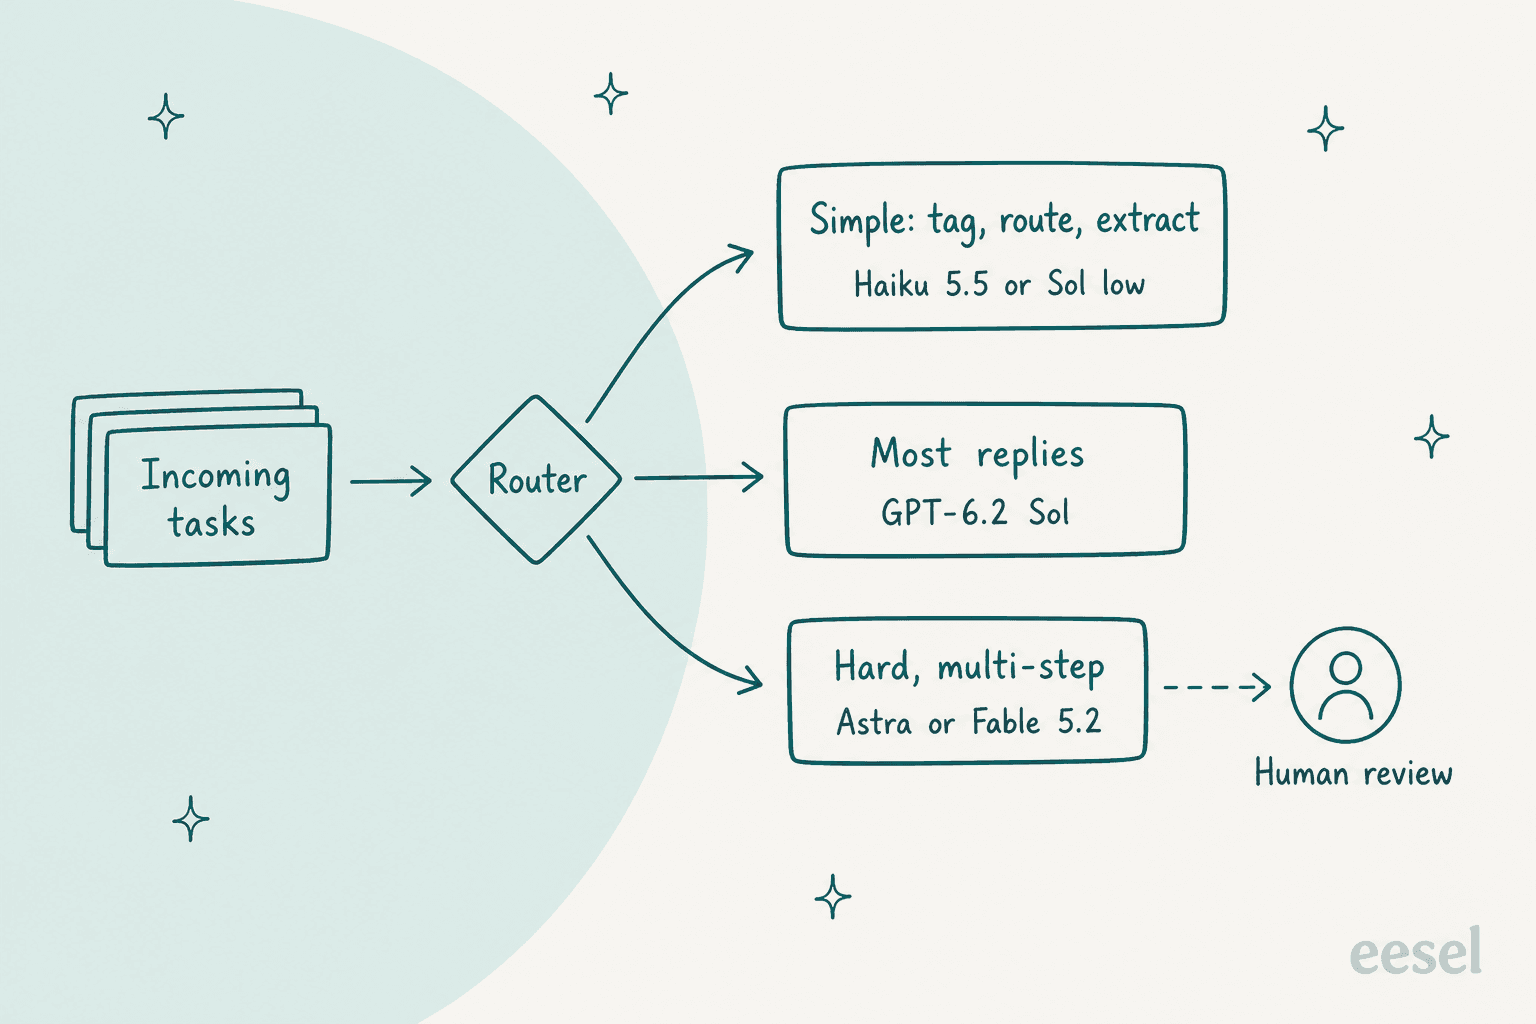
私が始めるならこの構成です。
- 単純なタスク。 タグ付け、ルーティング、抽出のようなものは小さなモデルに送ります。Claude Haiku 5.5は100,000トークンまでのプロンプトで$0.10/$0.50、Artificial Analysisのタスクあたり$0.41でした。あるいは低エフォートのSolを使います。
- 大半の返信と日常的なツールコール。 GPT-6.2 Solに送ります。私のテスト全体でAstraに匹敵しました。
- 難しい複数ステップの作業。 Astraに送り、賭け金が1タスク$26.54を正当化するならFable 5.2に送ります。
- 不確かなものすべて。 人間に送ります。
ローンチスレッドの開発者たちは、すでにこの一種を実践していました。
"Opus medium as orchestrator and reviewer, Sol(high/medium)/Terra(max) as implementer."
同じ考え方はサポートキューにも当てはまります。インテリジェントルーティングはチケットを適切な人に送り、モデルルーティングは各ステップを適切なモデルに送ります。AIエージェント対人間のエージェントのコストの分析では、大量のときに安価な車線がなぜ重要かを示しています。
乗り換える前に代替モデルをどうテストすべきか?
ベンチマークはどのモデルを候補に入れるべきかを教えてくれます。実際にどれを使うべきかを教えてくれるのは、あなた自身のタスクだけです。Solのテストで使い、それを拡大したプロセスを紹介します。
- 実際のタスクを100〜300件取り出す。 ログから、失敗したツールコール、曖昧な依頼、別言語のものなど、やりにくい例も含めてください。
- モデル以外はすべて同一に保つ。 同じシステムプロンプト、同じツール、同じ制限です。
- 成功タスクあたりのコストで評価する。 コールあたりのコストではありません。2回のやり直しが必要な安いモデルは安くありません。
- 実際に運用するエフォートで各設定を実行する。 エフォートは表示価格よりも料金を大きく変えるためです。
- 失敗例を手で読む。 間違った返金額は、少し硬い文章よりも重要です。
サポート業務について具体的には、AIサポートエージェントのテストで過去のチケットからそのテストセットを組み立てる方法を扱っています。ベンチマーキングガイドで評価方法を扱い、AIの会話をレビューする方法で本番稼働後の継続的なチェックを扱っています。
サポートチームにとってこれは何を意味するのか?
あなたのエージェントが顧客に答えているなら、モデル選びは小さな決定です。このリストのどのモデルも丁寧な返信は書けます。それが正しい返信かどうかを決めるのは、読んでいる知識、取れる行動、確信がないときにどうするかです。私のテストはそれを直接示しました。AstraとSolはどちらも、指示があったため壊れた注文照会を正しくエスカレーションし、ポリシーが文書化されていたため返金の計算も正しく行いました。
それがeeselが構築している層です。eeselはAIチームメイトのプラットフォームです。あなたは特定の仕事のために即戦力のチームメイトを雇います。あなたのキューにはAIヘルプデスク・チームメイト、コンテンツにはAIブログライターです。モデルはエンジンであり、チームメイトはそれを操る従業員で、あなたの統合、知識、ガードレールはすでに整っています。実際の顧客に答える前に、過去のチケットに対してシミュレーションされます。
プライベートナンバープレートを販売するSwiftregは、このルール層が実際にどう見えるかを示しています。同社のeeselエージェントは1か月で2,100件のZendeskチケットを処理し、Swiftreg自身が書いたルールのもとで実際の注文データから回答しました。1,500件の公開返信を送り、スタッフの担当となるステップでは1,050件の内部メモを残しました。SE RankingはZendesk上の3つのプロダクトそれぞれに1つのeeselエージェントを稼働させ、回答前に約16,800ページのヘルプとサイトコンテンツを検索して、1か月で4,650件の会話を処理しました。
コードから作業したい場合、eesel CLIを使えば、あなた自身やClaude CodeやCodexのようなコーディングエージェントが、ターミナルから同じチームメイトを操作できます。承認済みのヘルプ記事やマクロをアップロードし、エージェントの指示を調整し、何かを公開する前にテストの質問を投げかけられます。ヘルプデスク自体の接続には今も管理者の承認が必要で、アップロードされた知識は準備完了と見なされる前にテストされます。
これはAIエージェントCLIと同じ考え方を、サポートのチームメイトに適用したものです。MCPサーバーはもう一つの一般的なルートです。SolやAstraの上でこれを自分で組むべきか迷っているなら、構築か購入かでモデル料金が見落としている部分を扱っています。
eeselを試す
AstraをSolに乗り換えればトークン料金は下がります。しかしそれはあなたのエスカレーションルールを書いてくれるわけではなく、回答をあなたのヘルプセンターに根付かせるわけでも、先月のチケットでエージェントをテストしてくれるわけでもありません。eeselのAIヘルプデスク・チームメイトはZendeskに接続し、Freshdeskやあなたのスタックの他の部分でも同じように動作し、あなたの過去のチケットから学び、公開する前にそれらにどう答えたかを見せてくれます。
