Gemini 4 Neonの代替7選(2026年):タスク単価でランキング

Kira

Katelin Teen
最終更新 2026年11月19日
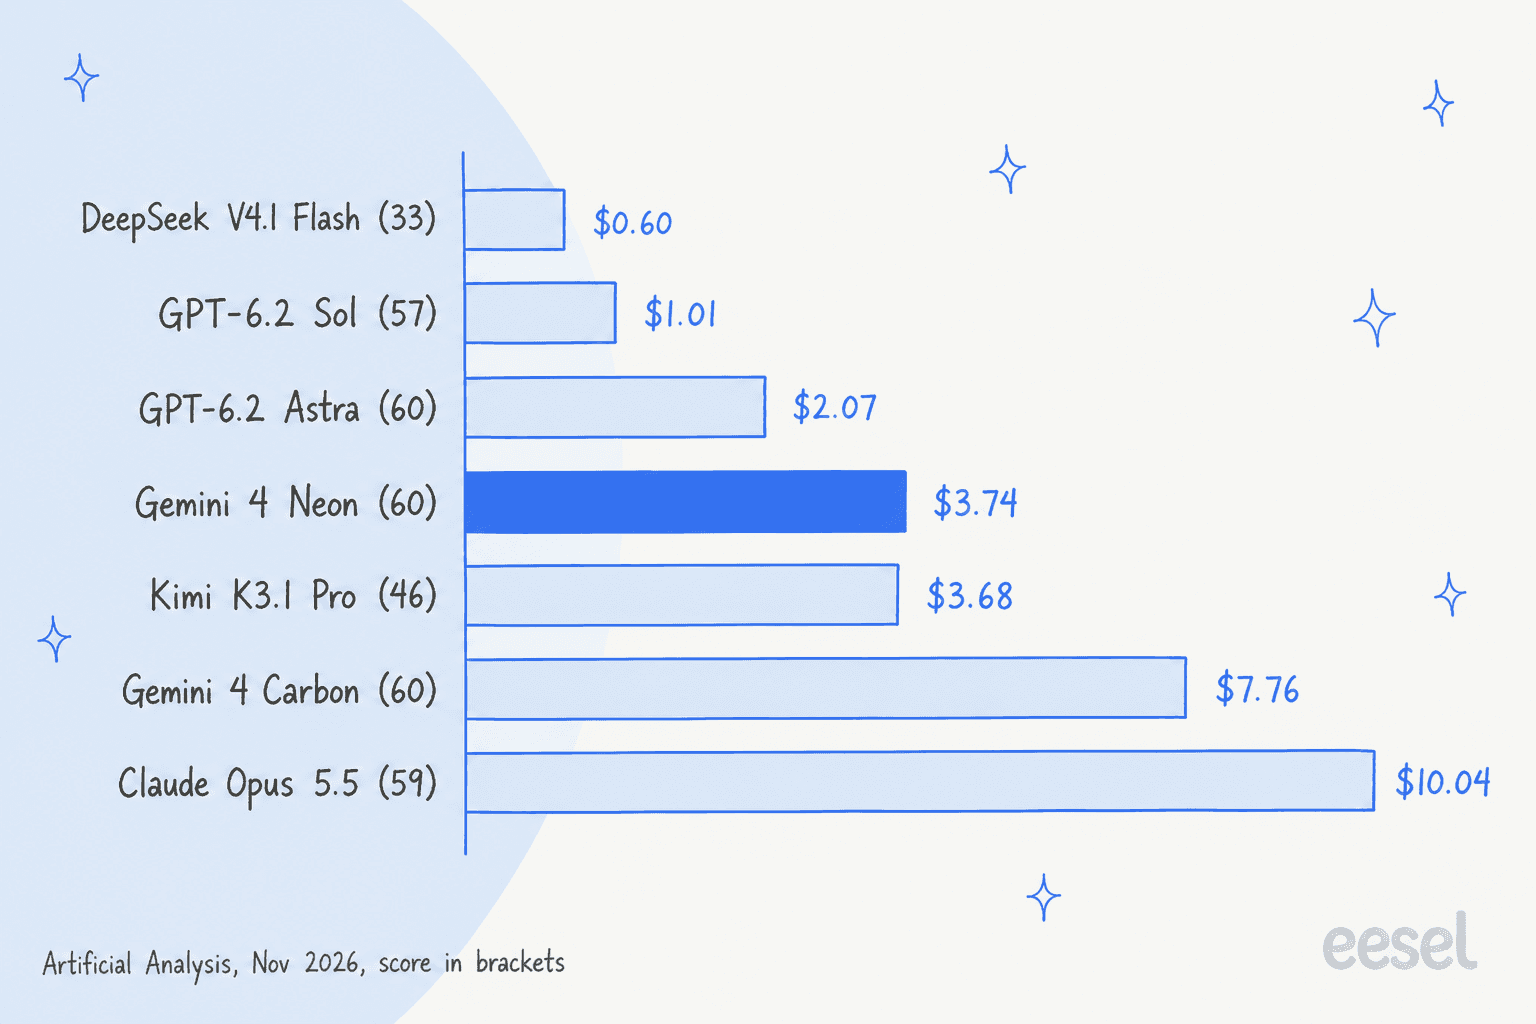
最良のGemini 4 Neonの代替はGPT-6.2 Solです。Artificial Analysisでは1タスク$1.01で57.3を記録し、Neonのhighでの$3.74・59.6と比較されます。AstraはNeonのスコアを$2.07で達成し、Opus 5.5は$10.04かかり、Carbon、Kimi K3.1 Pro、DeepSeekは正直さ、オープンウェイト、大量処理の安さで勝ります。Neonの強みは、回答不能な質問に対して55%ではなく14%しか間違えない点です。サポートボット用途なら、eeselのヘルプデスク・チームメイトがこの選択を代わりに行い、過去のチケットでテストします。
なぜGemini 4 Neonの代替が探されているのか?
Gemini 4 Neonは、2026年11月18日にリリースされたGoogleのGemini 4ファミリーの中間モデルです。100万トークンあたり入力$3、出力$15で、コンテキストウィンドウは1,048,576トークン、無料枠はありません。私のNeonレビューでは、タスクあたりのコストがCarbonの約半分で、「わかりません」と言うことを珍しく厭わない、強力なモデルだとわかりました。
他を探す理由はすべて料金とスタックに関わるものです。Neonは多くのトークンを書くため、OpenAIのモデルよりタスクあたりのコストが高く、あるHacker Newsの読者が発売日にこう指摘しました。
"That looks to me like OpenAI equals or beats everything Google offers at half the price."

他にも、Googleではないベンダー、自前でホストできるオープンウェイト、ライブチャットでより速いモデルを求める人がいます。これらは異なる用途なので、私は代替案を用途別に並べ、すべてに同じ指標、タスク単価を当てはめました。
自前のテスト環境を構築せずにこれらのモデルをサポートの質問で試したい場合、eesel CLIを使えば、コーディングエージェントが承認済みのヘルプ記事やマクロをeeselのヘルプデスク・チームメイトにアップロードし、テスト用の質問をして、何かが本番公開される前に回答を確認できます。ヘルプデスク自体の接続には、依然として管理者の承認が必要です。
これらの代替をどう選んだか
買い手が実際に目にするものから出発しました。新しいチャットでChatGPTに、あるアプリ向けにGemini 4 Neonと比較すべき代替を尋ねたところ、GPT-6.2 Astra、Claude Opus 5.5、GPT-6.2 Sol、Gemini 4 Carbon、Kimi K3、DeepSeek V4.1 Flashの6つがこの順で挙げられました。また、価格は100万トークンあたりではなく「成功タスクあたりのコスト」やツール呼び出し、JSONの妥当性、レイテンシ、リトライ数で比較するよう助言されました。私はこの枠組みに従い、Claude Sonnet 5.5を追加しました。Solと同じ価格帯ながら、動作がかなり異なるためです。
各モデルについて、2026年11月19日に確認した3つの情報源を使いました。
- ベンダー自身のページ: 料金、モデルページ、コンテキストウィンドウ、ツール対応で、それぞれ以下の各セクションにリンクしています。この記事のすべての価格はこれらのページからのもので、第三者の情報ではありません。
- Artificial Analysis: スコア、タスク単価、タスクあたりの分数、ハルシネーション率について設定ごとの結果です。「タスク」はそのIntelligence Indexのベンチマークタスクであり、あなたのチケットではありません。
- Hacker News: Neon、Astra、Solの発売スレッドで、開発者が自身のコストと時間を投稿しています。
Neon用のGoogleのキーがないため、自分ではNeonをテストしていません。先週、サポート用にAstraとSolで90回分のテストを行い、当てはまる範囲でその結果を使っています。このランキングは候補リストとして扱い、テストのセクションで自分の業務に当てはめて確認してください。
タスク単価はNeonの代替について何を語るか?
トークン単価は話の半分にすぎません。料金は価格にモデルが書くトークン数を掛けたもので、思考トークンも出力として数えられます。Artificial Analysisは両方を公開しているため、ここから始めるべき表はこれです。
| モデルと設定 | インデックススコア | タスク単価 | タスクあたりの分数 | タスクあたりの出力トークン数 | 不確実な場合に間違える率 |
|---|---|---|---|---|---|
| Gemini 4 Neon high(デフォルト) | 59.6 | $3.74 | 14.8 | 90,188 | 14% |
| Gemini 4 Neon medium | 54.9 | $1.90 | 8.3 | 50,000 | 16% |
| GPT-6.2 Astra max | 62.1 | $4.00 | 13.7 | 41,029 | 59% |
| GPT-6.2 Astra high | 60.1 | $2.07 | 5.9 | 17,828 | 58% |
| GPT-6.2 Sol max | 57.3 | $1.01 | 8.5 | 40,360 | 55% |
| GPT-6.2 Sol high | 54.9 | $0.56 | 4.6 | 20,160 | 60% |
| Claude Opus 5.5 max | 59.1 | $10.04 | 24.5 | 173,313 | 50% |
| Claude Opus 5.5 medium(APIデフォルト) | 48.2 | $2.45 | 6.9 | 43,817 | 67% |
| Claude Sonnet 5.5 max | 54.5 | $10.02 | 32.6 | 285,387 | 43% |
| Claude Sonnet 5.5 high(APIデフォルト) | 41.5 | $1.64 | 7.2 | 58,421 | 64% |
| Gemini 4 Carbon high | 60.0 | $7.76 | 37.2 | 122,768 | 11% |
| Kimi K3.1 Pro | 46.5 | $3.68 | 39.4 | 72,239 | 37% |
| DeepSeek V4.1 Flash 1017 max | 32.6 | $0.60 | 13.7 | 138,962 | 64% |
表の内容はすべて2026年11月19日にArtificial Analysisで確認したものです。「不確実な場合に間違える率」はAA-Omniscienceのハルシネーション率で、低いほど良い結果です。各モデルのページ:
- Gemini 4 NeonとGemini 4 Carbon
- GPT-6.2 Astra
- Claude Opus 5.5
- Claude Sonnet 5.5
- Kimi K3.1 Pro
- DeepSeek V4.1 Flash 1017
目立つ点は4つです。
- 同じスコアで料金が違う。 Astraのhighは
$2.07で60.1に達し、Neonの59.6・$3.74より45%安いです。Opus 5.5のmaxは59.1に$10.04かかり、Neonの約2.7倍です。 - Solのhighはmedium設定のNeonに並ぶ。 どちらも54.9ですが、Solは
$0.56、Neonは$1.90です。 - DeepSeekはタスク単価では安くない。 入力価格はSolの13分の1ですが、1タスクは
$0.60でSol highの$0.56とほぼ同じ、スコアは32.6対54.9です。そのために138,962トークンを書いています。 - Neonは正直なモデル。
14%は、60前後のスコアを持つ上記モデルの中でCarbonを除けば最良です。Sol、Astra、Opusは回答不能な質問の50%から59%を間違えます。
理由は冗長さにあり、これは人々が見落としがちな仕組みの部分です。出力トークンはどの価格表でも高くつく側で、各モデルには回答前に書くトークン数について独自の傾向があります。
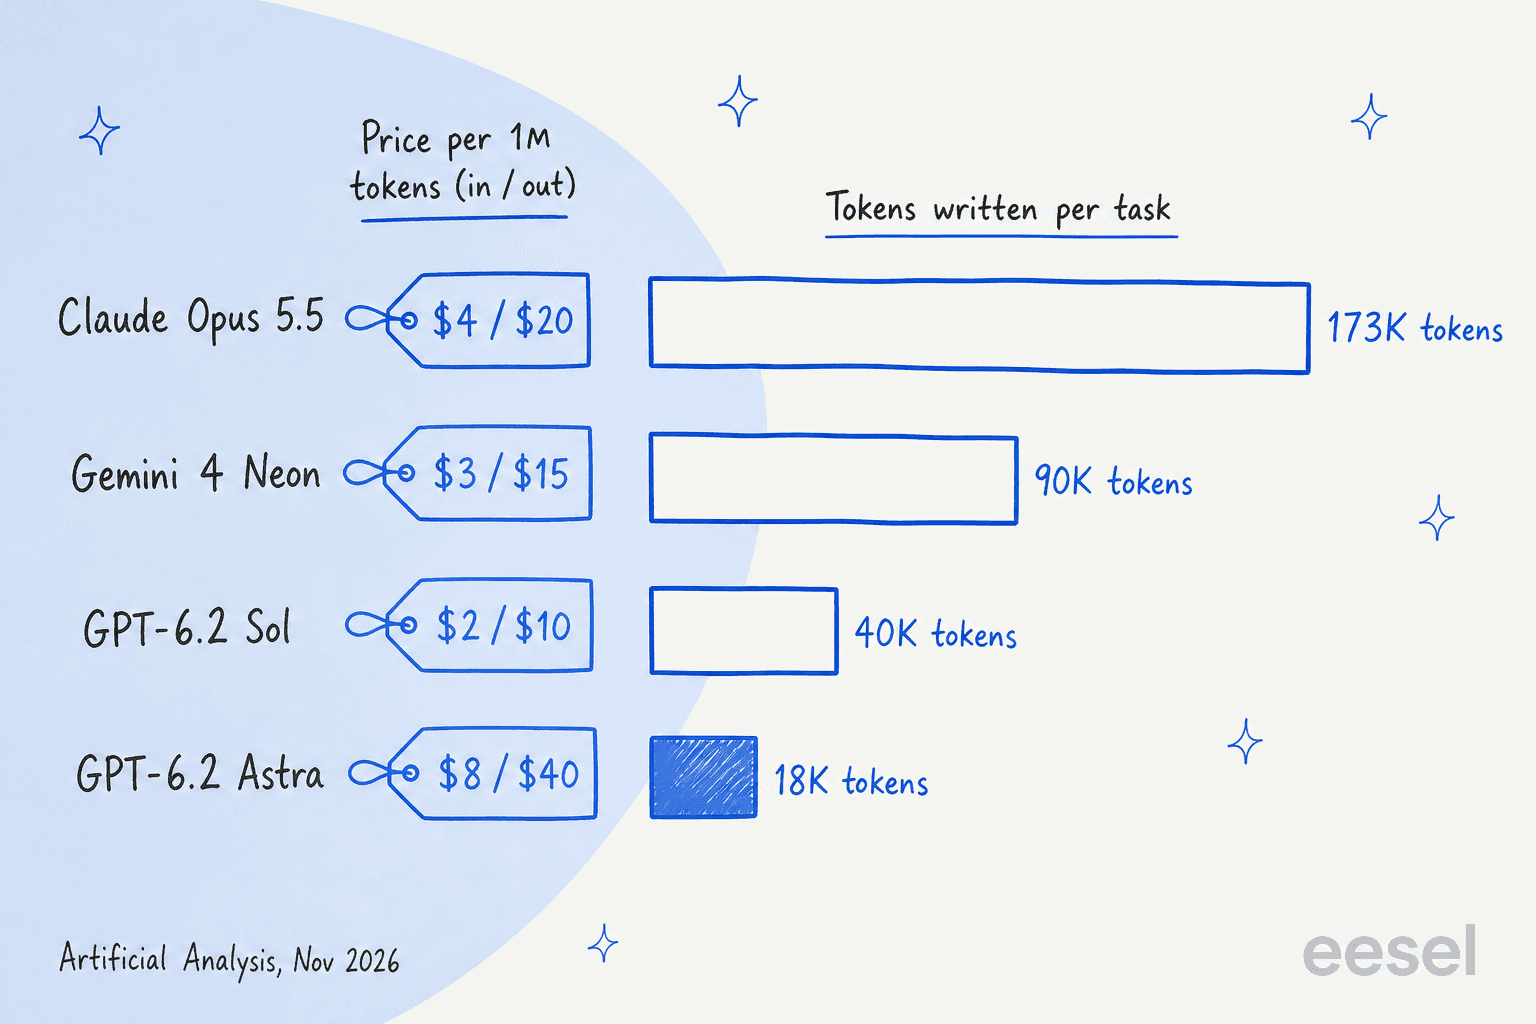
この図はOpusとSolについては各モデルの最高スコア設定を、NeonとAstraについてはデフォルトのhighを使っています。Astraは4モデル中最も高い価格表示でありながら最も安い傾向で、同じスコアに対してNeonが書く量のおよそ5分の1しか書きません。これが、価格表を比較してはいけないと言う理由です。
Gemini 4 Neonの代替を一覧で見る
各ベンダー自身の資料から、買い手が気にするその他すべての情報です。
| モデル | 100万トークンあたりの価格(入力/出力) | キャッシュ入力 | コンテキスト | 最高スコア(設定) | 無料APIティア | オープンウェイト | データ常駐オプション |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon(基準) | $3 / $15 | $0.15、暗黙のみ | 1,048,576 | 61.4(xhigh) | なし | いいえ | Googleのエンタープライズプラットフォームでglobal、us、euリージョン |
| GPT-6.2 Astra | $8 / $40 | $0.40 | 1,050,000 | 62.1(max) | 記載なし | いいえ | リージョンエンドポイント、+10% |
| GPT-6.2 Sol | $2 / $10 | $0.10 | 1,050,000 | 57.3(max) | 記載なし | いいえ | リージョンエンドポイント、+10% |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | 59.1(max) | 新規ユーザー向け無料テストクレジット | いいえ | 米国のみの推論、+10% |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | 54.5(max) | 新規ユーザー向け無料テストクレジット | いいえ | 米国のみの推論、+10% |
| Gemini 4 Carbon | 11月30日まで$2 / $10、以降は$4 / $20 | $0.10、以降$0.20、暗黙のみ | 1,048,576 | 60.0(high) | なし | いいえ | Carbonについては未確認(Neonのガイドではglobal、us、euを記載) |
| Kimi K3.1 Pro | $2 / $10 | $0.20 | 1,048,576 | 46.5 | 記載なし | はい、Moonshot独自のライセンス | 料金ページに記載なし |
| DeepSeek V4.1 Flash | オフピーク$0.15 / $0.60、ピーク$0.30 / $1.20 | オフピーク$0.003、ピーク$0.006 | 1M | 32.6(max) | 記載なし | はい、MIT | 料金ページに記載なし |
2点補足します。「記載なし」はベンダーの料金ページに無料APIティアの記載がないことを意味し、存在しないと確認したわけではありません。また、Carbonの価格は12月1日に倍になるため重要です。Artificial Analysisはそのタスク単価を12月の高い価格で計算しています。
各代替は月あたりいくらになるか?
タスク単価はベンチマークの数字であり、あなたのタスクはそれより小さいはずです。このカリキュレーターは、あなたのタスクがベンチマークタスクと比べてどれくらいの大きさかに応じてArtificial Analysisのタスク単価をスケーリングし、量を掛け合わせ、必要なスコアを満たす設定だけを残します。これは推定値なので、ギャップの大きさを把握するために使い、そのうえで自社の実データを測定してください。
デフォルト値、月10,000件の短いチケット返信、スコアの下限55では、Sol maxは月約$505、Neon highは約$1,870です。スコアの下限を60まで上げるとSolは対象外になります。これが正直なトレードオフで、最後の5ポイントの分だけ多く払うということです。
1. GPT-6.2 Astra
最適な用途: Neonのスコアを求め、そのために安くはない料金を払ってもよいチーム。
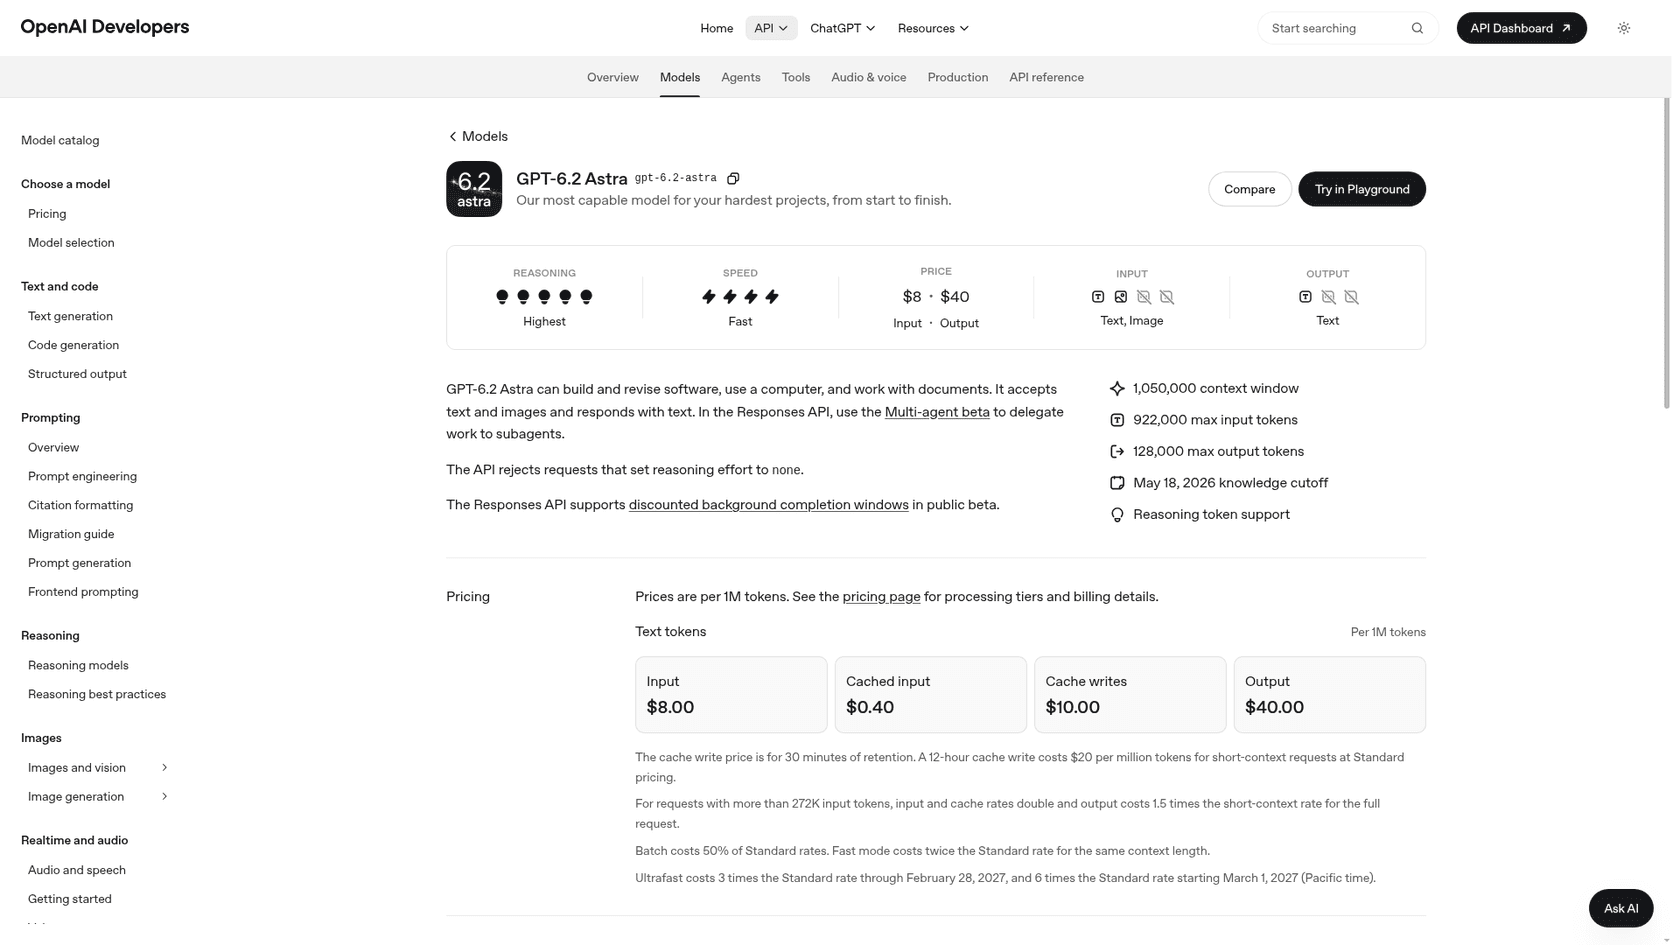
GPT-6.2 AstraはOpenAIのトップモデルで、Neonより1日早い2026年11月17日に発売されました。コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークン、知識のカットオフは2026年5月で、APIはreasoning effortのnoneを拒否します。価格は100万トークンあたり入力$8・出力$40と高く、Neonの入力レートの2.7倍です。
しかし料金面では、AstraはNeonを同じ土俵で打ち負かすモデルです。高エフォートでは1タスク$2.07で60.1を記録し、5.9分で完了します。これはNeonの14.8分に対してです。これはNeonが90,188トークンを書くところをAstraが17,828トークンで達成しているためです。maxでは62.1まで上がり、Neonの最高値61.4をわずかに上回り、コストは$4.00です。Astraの代替ガイドでの90回分の自前のサポートテストでも同じ傾向が見られました。エフォートレベルは短いチケットではコストをほとんど動かさず、低から高で1,000チケットあたり$5.75から$6.57でした。
あるHacker Newsの読者が行った簡易ベンチマークは、実際にどう現れるかを示しています。
"GPT-6.2 Astra scored 92 in 6.6 min for $2.04, vs Kimi K3.1 Pro (93 in 11.5 min for $0.68)"
メリット
- Neonのスコアに対しタスクあたり約45%安く、2倍以上速い
- Astraと同じ1,050,000トークンのウィンドウと、多くのチームが既に使うResponses API
$0.40のキャッシュ入力、バッチなら標準レートの半額
デメリット
- AA-Omniscienceで回答不能な質問の58%を間違え、Neonの14%より多いため、モデル自身の拒否に依存しない引き継ぎルールが必要
- 入力272Kトークンを超えるリクエストは入力レートが倍になり、出力は標準レートの1.5倍になる
- タスクあたりのトークン数を見ない表計算では、表示価格が割高に見える
料金: 標準ティアで100万トークンあたり入力$8、キャッシュ$0.40、出力$40、OpenAIの料金ページより。リージョン処理で10%上乗せされます。段階についてはGPT-6.2 Astraの料金を参照してください。
結論: Neonレベルのスコアが欲しく、料金が気になる場合に最初に試すモデルです。モデル自身が不確実なときに拒否する必要がある場合は見送ってください。そこはNeonの方が優れています。
2. GPT-6.2 Sol
最適な用途: 50台後半のスコアを維持できる最安の料金。
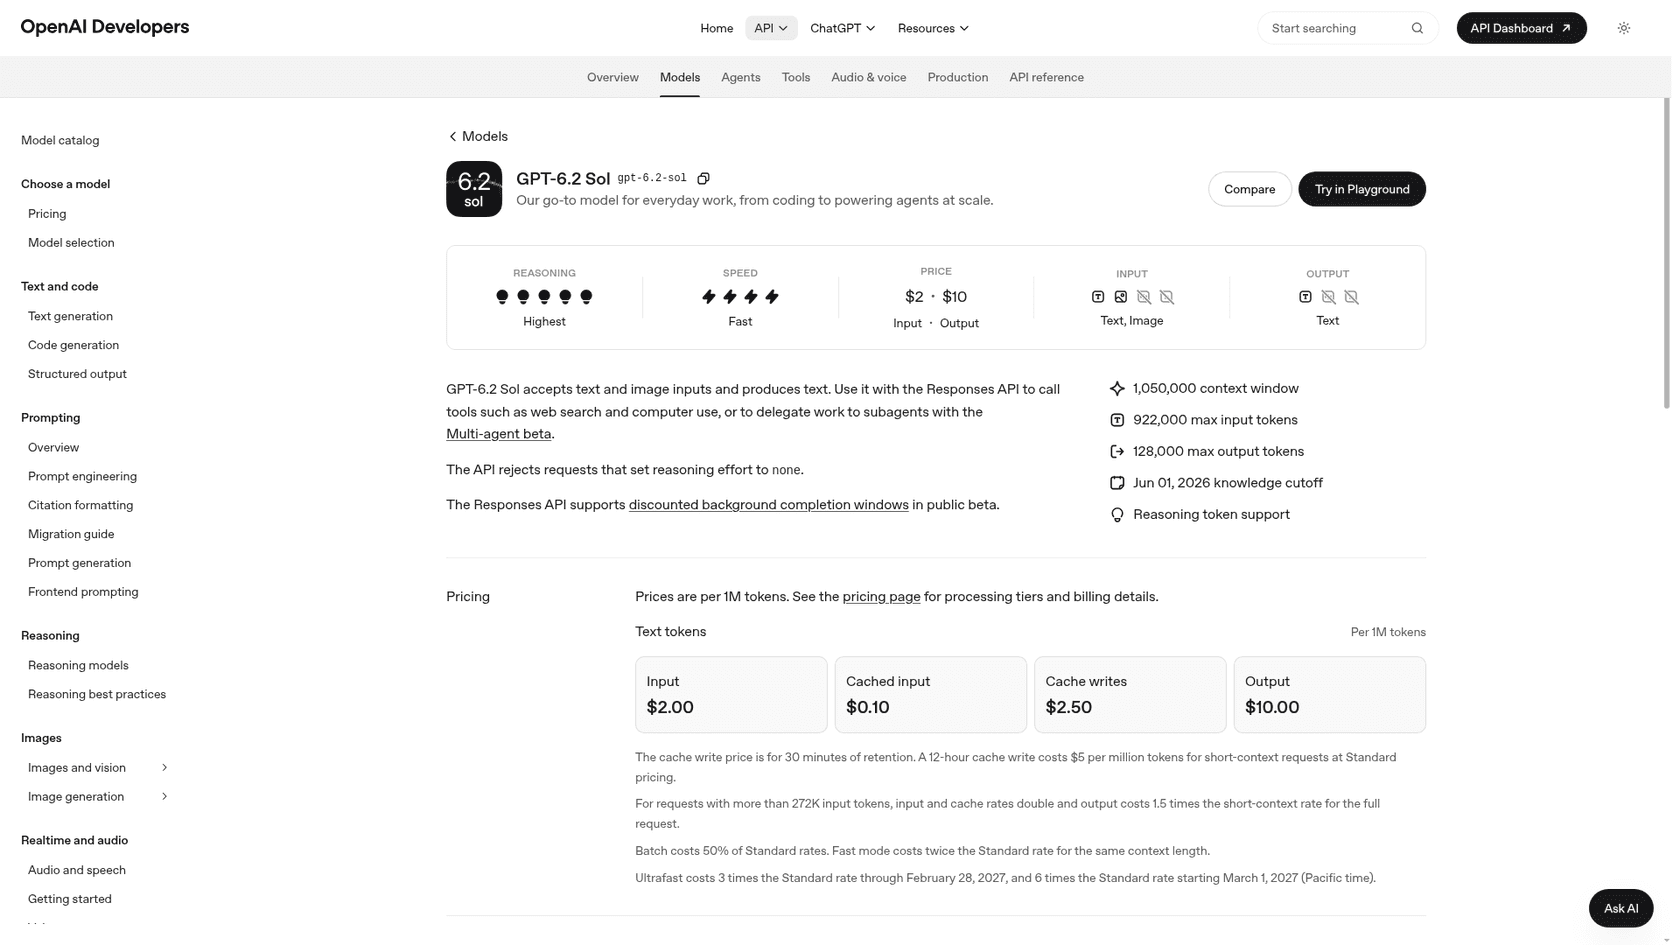
GPT-6.2 SolはOpenAIの日常用モデルで、Astraと同じ1,050,000トークンのウィンドウを持ち、知識のカットオフは2026年6月、100万トークンあたり入力$2・出力$10です。Artificial Analysisは最大エフォートで1タスク$1.01のコストで57.3を、高エフォートでは$0.56で54.9を記録しています。この2番目の数字は私が何度も戻ってくる値で、Neonのmediumと同じスコアを、コストの3分の1未満で達成しています。
私自身のテストでは、Solは低・中・高のエフォートを通じて45回すべてを正しく回答しました。毎回$990になる比例返金、丁寧に拒否したプロンプトインジェクション、顧客の言語で回答したスペイン語とドイツ語のチケットを含みます。コストは1,000チケットあたり$1.42、$1.40、$1.54で、Astraの約4分の1でした。難しいケースでは現場の意見は分かれています。
"OpenAI's models require constant reprompting for me."
この読者はSonnet 5.5を好んでいましたが、安いモデルはプロンプトにより多くを要求するという公正な警告です。
メリット
- 1タスク
$0.56から$1.01で、54を超えるスコアを出すモデルの中で最安 - 速い:Artificial Analysisで1タスクあたり4.6分から8.5分
- Astraと同じAPIサーフェスで、両者間でルーティングできる
デメリット
- 回答不能な質問の55%から60%を間違えるため、引き継ぐべき場面でも答えてしまう
- キャッシュ書き込みは30分保持で100万トークンあたり
$2.50が別途課金されるため、キャッシュレートは無料ではない - APIはreasoning effortの
noneを拒否する
料金: 100万トークンあたり入力$2、キャッシュ$0.10、出力$10、OpenAIの料金ページより。バッチなら半額になります。詳細はSolの料金ガイドにあります。
結論: 多くのワークロードでのデフォルトの選択です。ここから始めて、明らかに失敗するタスクに限りAstraやNeonに切り替えてください。
3. Claude Opus 5.5
最適な用途: Anthropicスタック上での長いコーディング・エージェントセッション。
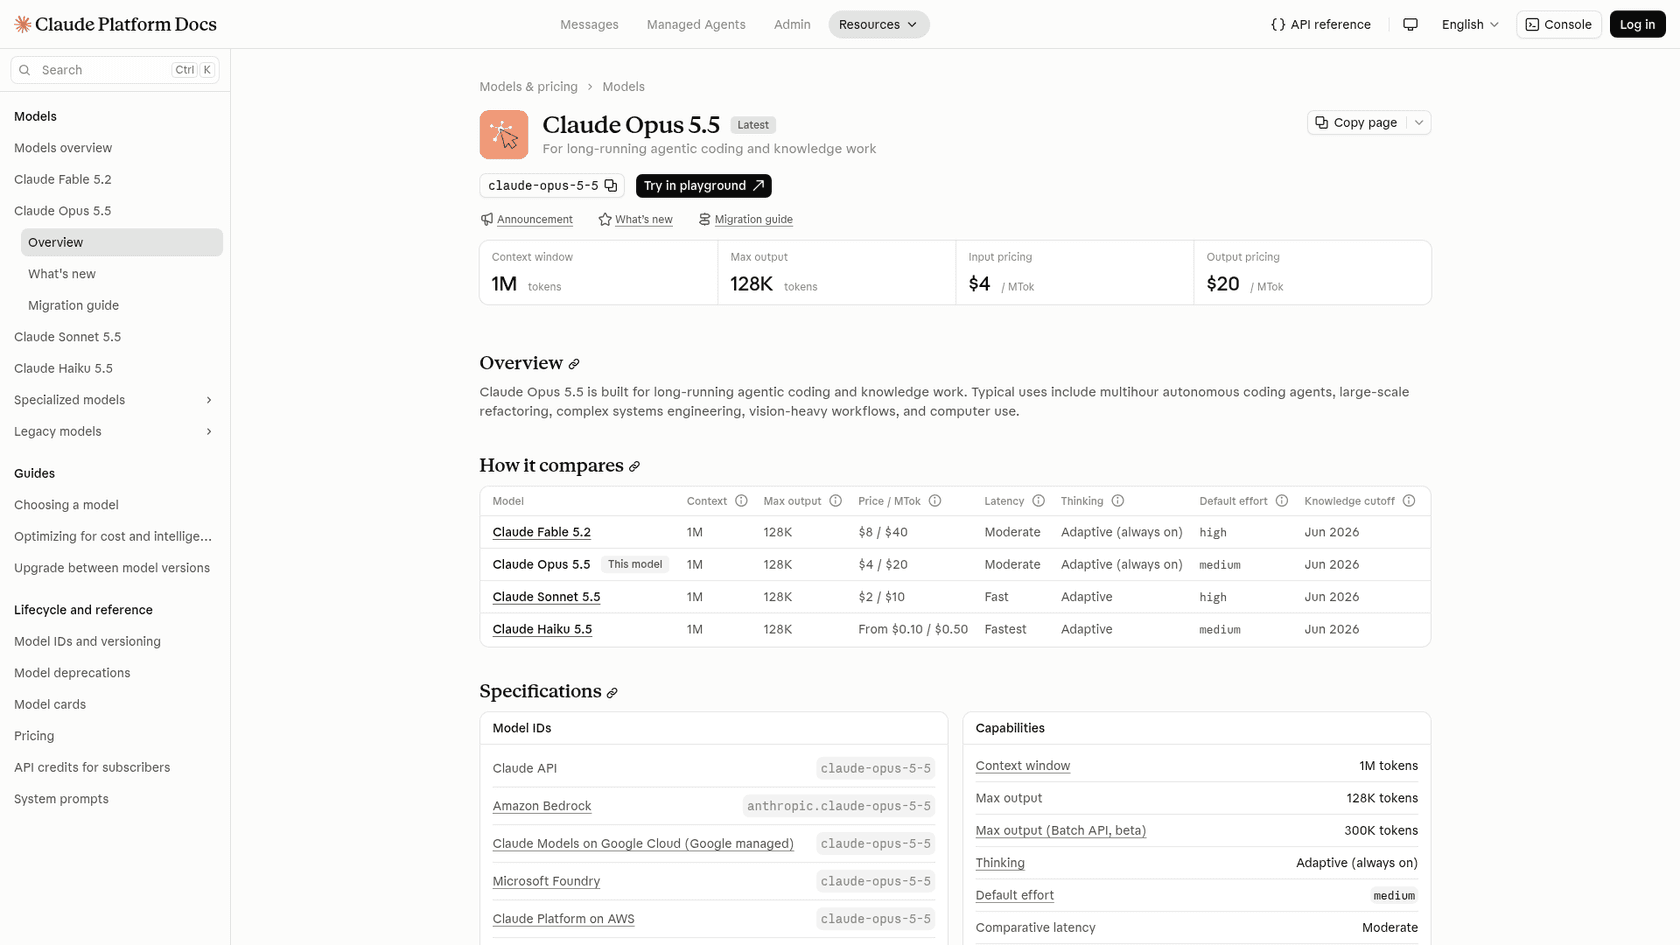
Claude Opus 5.5は2026年9月22日に、100万トークンあたり入力$4・出力$20で登場しました。1Mトークンのウィンドウ、最大128Kの出力、常時アクティブなアダプティブシンキング、デフォルトエフォートはmediumです。Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry上で動作します。NeonのモデルカードにあるGoogle自身の比較表では、Terminal-Bench 4.1とFrontierCode 2.0でOpusがNeonをわずかに上回っており、このリストの中で最も強いコーディングの対抗馬です。
落とし穴は先に述べた傾向です。最大エフォートではOpusは1タスクあたり173,313トークンを書き、これが半額のはずの価格を表の中で最も高いコストに変えます。59.1に対して1タスク$10.04で、Neonの59.6に対する$3.74と比べて高くなります。APIデフォルトのmediumでは48.2に$2.45で、Neon mediumの54.9より弱いスコアに対してコストも高くなります。それでも、あるHacker Newsの読者は2か月後もOpusを先頭だと評しています。
"Every day I'm just more and more amazed at Opus 5.5 and how ahead it was."
メリット
$0.20のキャッシュ入力、バッチなら半額- Anthropicの料金ページでは
inference_geoによる米国のみの推論を10%の追加料金でリストしている - 長いコーディングセッションで強く、Google自身の表でも優位性が示されている
デメリット
- maxで1タスク
$10.04、同じスコアに対してNeonの約2.7倍 - Anthropicの料金ページではOpus 5.5のツール選択が
autoとnoneのみで、特定のツールを強制するエージェントは事前にテストが必要 - maxでは回答不能な質問の50%、mediumでは67%を間違える
料金: 100万トークンあたり入力$4、キャッシュ読み取り$0.20、出力$20、Anthropicの料金ページより。高速モードは$8と$40です。詳細はOpus 5.5の料金を参照してください。
結論: すでにAnthropicを使っていて、作業が長いコーディングセッションである場合に選んでください。タスク単価が制約になる場合は見送り、まず私のOpus 5.5レビューを読んでください。
4. Claude Sonnet 5.5
最適な用途: 低エフォートの短いツール呼び出しを行うAnthropicユーザー。
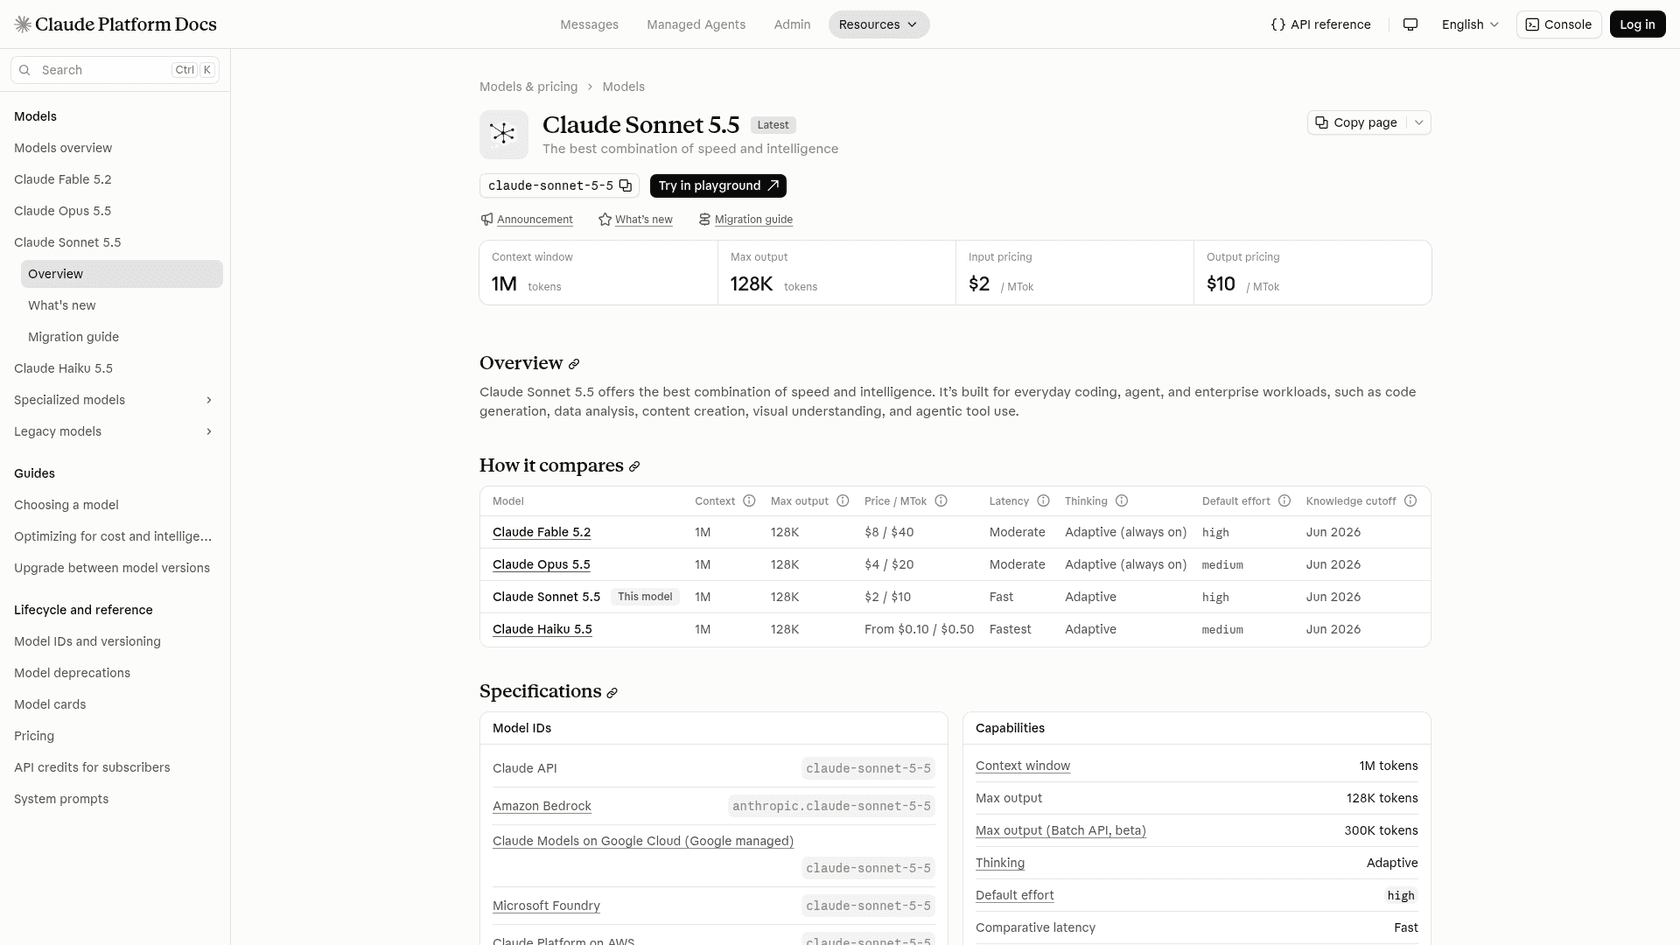
Claude Sonnet 5.5はSolと同じ$2・$10の価格、1Mトークンのウィンドウ、2026年6月の知識カットオフを持ち、APIのデフォルトエフォートはhighです。これが落とし穴です。Artificial Analysisでは、maxで1タスク$10.02で54.5を記録し、Solの10倍のコストです。これは285,387トークンを書き、32.6分かかるためです。デフォルトのhighでは41.5に$1.64で、Neon lowはこの両方で$0.75・44.1と上回っています。
明るい点もあります。Sonnet 5.5はmaxで回答不能な質問の43%を間違え、Sol、Astra、Opusより良い結果ですが、Neonには大きく及びません。
メリット
$0.10のキャッシュ入力、OpenAIの2モデルより低いハルシネーション率- 1Mトークンのコンテキスト、最大128Kの出力、Opusと同じプラットフォーム
- すでにAnthropicのツールを中心に構築しているチームに合う
デメリット
- スコアはhighの41.5からmaxの54.5まで振れ、コストは
$1.64から$10.02まで振れる - Anthropicの料金ページでOpusと同じく
autoとnoneのみがツール選択として記載されている - maxで1タスク32.6分と、主要モデルの中で最も遅い
料金: 100万トークンあたり入力$2、キャッシュ読み取り$0.10、出力$10、Anthropicの料金ページより。バッチは$1と$5です。詳細はSonnet 5.5の料金を参照してください。
結論: Anthropicが必須条件で、低または中エフォートで運用する場合のみ選んでください。それ以外ではSolが同じ仕事をより安くこなします。私のSonnet 5.5レビューでエフォートの落とし穴を解説しています。
5. Gemini 4 Carbon
最適な用途: 作り話の回答を最小限にしたく、そのために料金を払えるチーム。
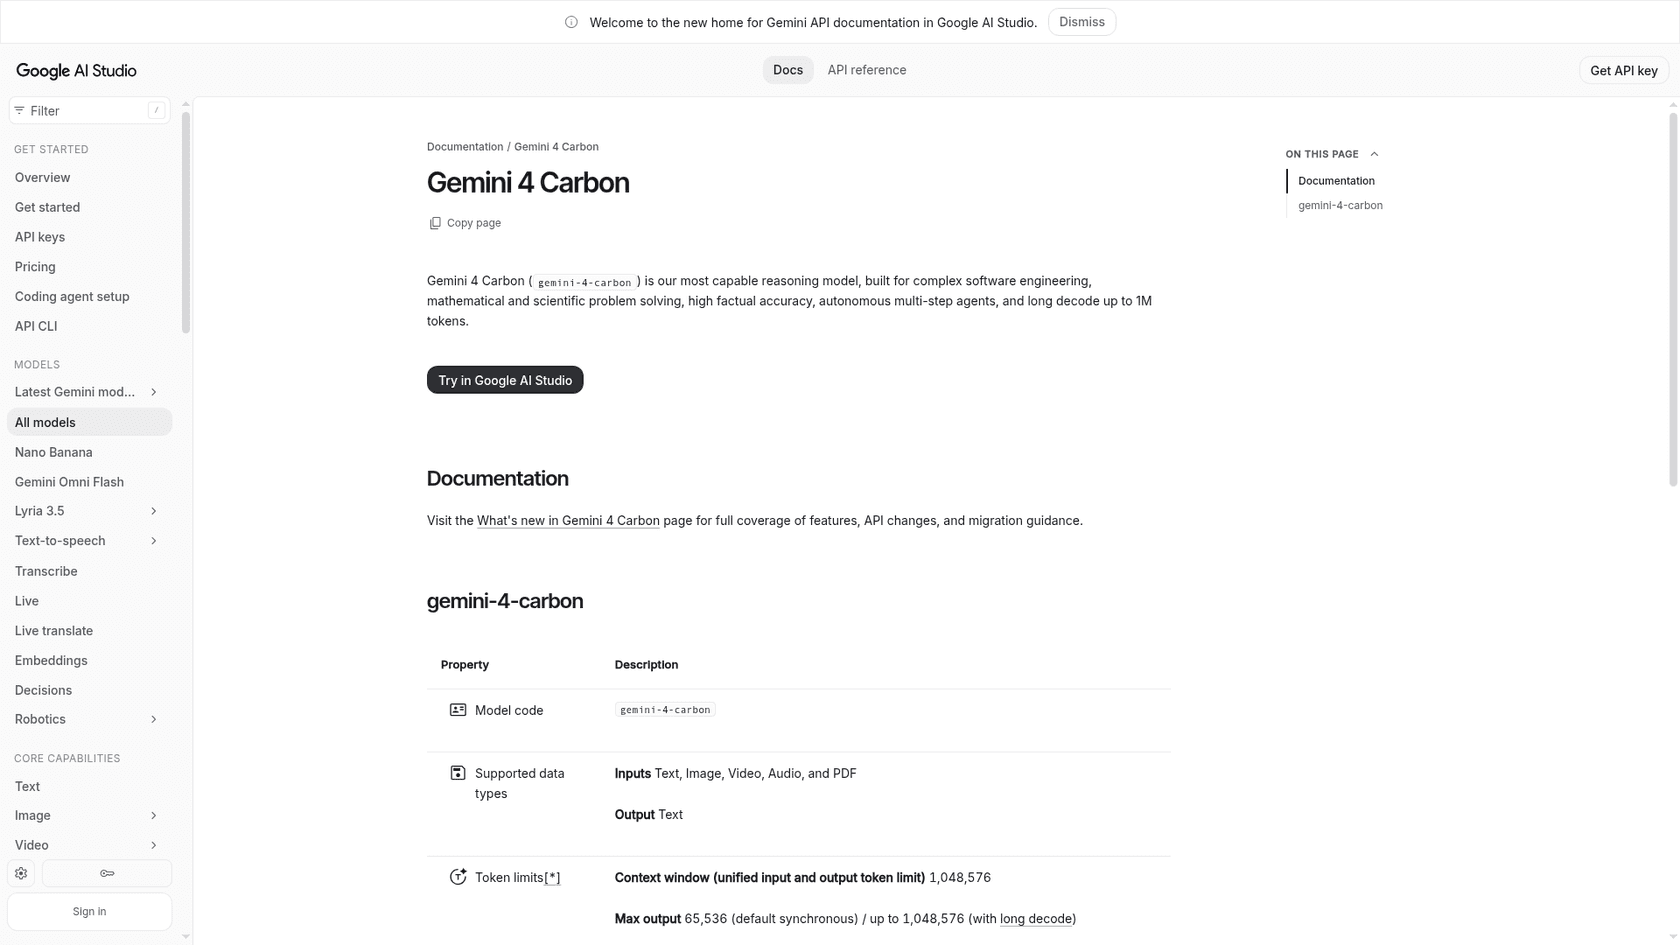
Gemini 4 CarbonはNeonの元になったモデルで、Googleはソフトウェアエンジニアリング、科学、長い多段階エージェント向けに構築された、最も高性能な推論モデルだと説明しています。現在Gemini APIで有料専用の価格設定になっており、2026年11月30日までは入力$2・出力$10、12月1日からは$4・$20、キャッシュ入力は$0.10から$0.20に上がります。
Carbonの強みは正直さです。中エフォートでは回答不能な質問の4%を、高エフォートでは11%を間違え、Neonの14%より少ないです。問題はコストです。highでは1タスク$7.76で60.0を記録し、同じスコアに対してNeonの$3.74の2倍以上で、37.2分かかります。あるHacker Newsのテスターは別の視点から同じ遅さを測定しています。
"I've tested 75 models so far, and Gemini 4 Carbon is 68th/75 in terms of slowness"
メリット
- リストの中で最も低いハルシネーション率:mediumで4%、highで11%
- 1,048,576トークンのウィンドウと、出力約1Mトークンまでの長いデコード
- Neonと同じGoogleスタックのため、移行はモデル名の変更だけ
デメリット
- highで1タスク
$7.76、プロモーション終了後は同じスコアに対してNeonの2倍 - 遅い:1タスクあたり29.6分から37.2分、HNのテスターが見た長いテール
- 無料枠なし
料金: 11月30日まで入力$2・出力$10、以降は$4・$20、Googleの料金ページより。Carbonの代替のまとめと比較してください。
結論: 誤った回答が時間よりコストが高くつく場合に選び、12月の価格で予算を組んでください。それ以外では、Neonが同じスコアを半額で提供します。
6. Kimi K3.1 Pro
最適な用途: 米国以外のベンダーによるオープンウェイトを求めるチーム。
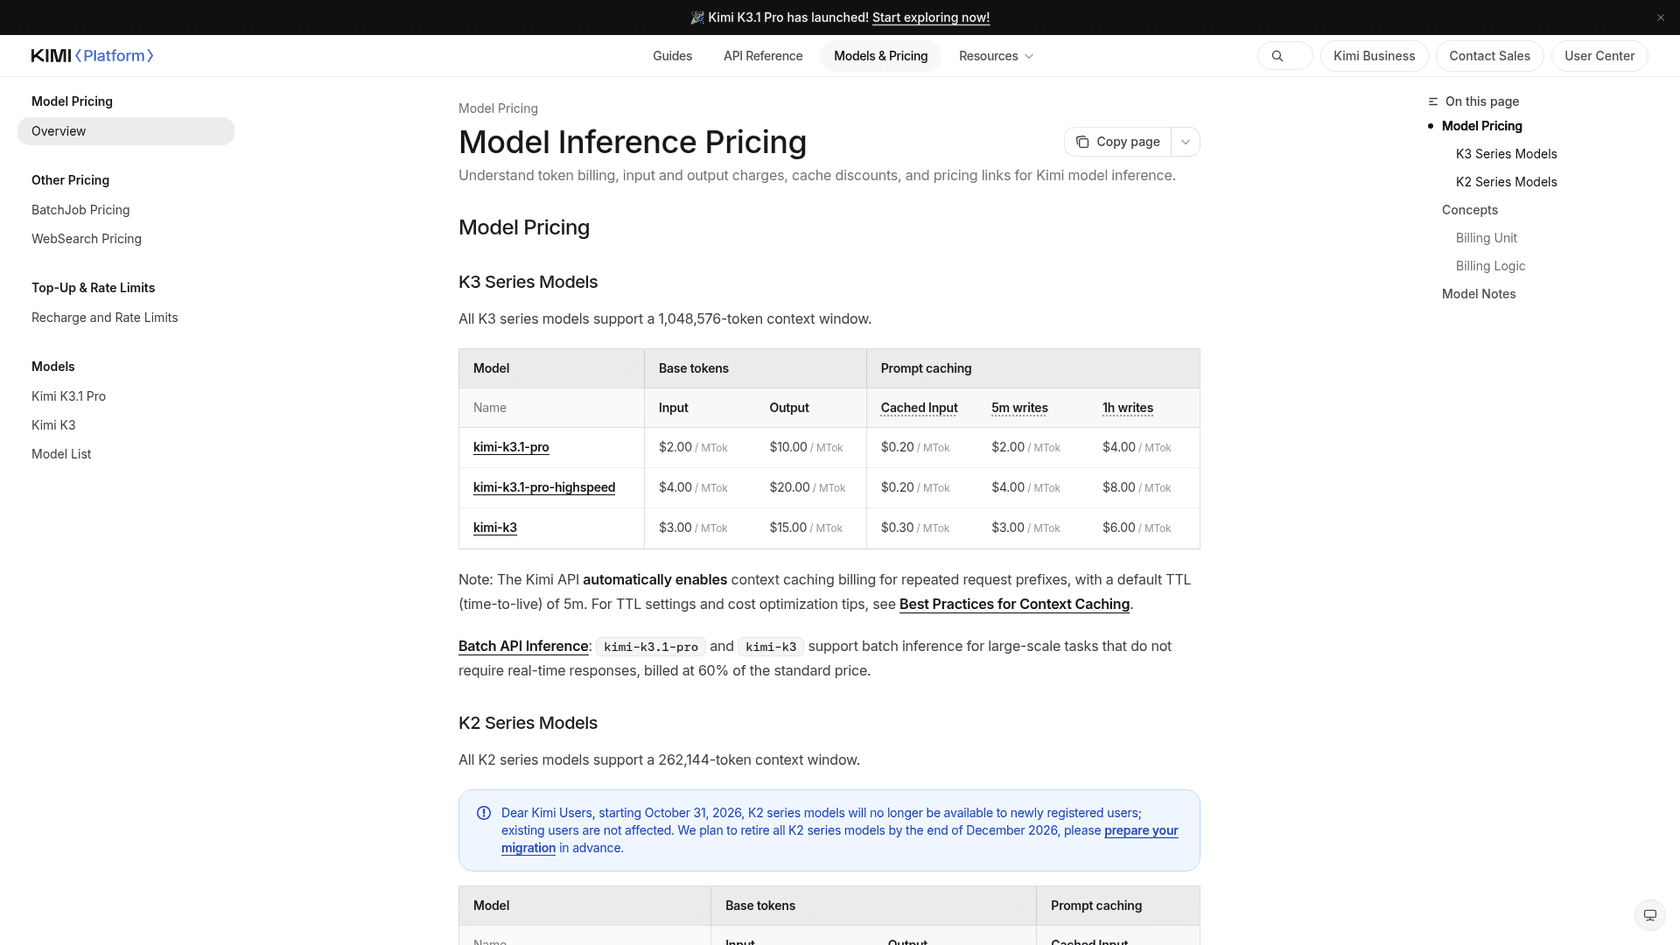
ChatGPTはKimi K3を挙げましたが、今日試すべきモデルはKimi K3.1 Proです。古いKimi K3より安く、100万トークンあたり入力$2・出力$10、キャッシュ入力$0.20です。K3は依然$3・$15です。K3.1 Proは1,048,576トークンのウィンドウを持ち、$4・$20のhighspeedバージョンもあります。Artificial Analysisはこれをオープンウェイトとして、総パラメータ2.8T、アクティブパラメータ104Bでリストしています。
劣るのはスコアです。46.5で、Neon mediumの54.9に対して低いです。また1タスクあたり39.4分かかり$3.68のコストで、Neon mediumはスコア、コスト、速度すべてで上回ります。価格面の主張は別のタイプのタスクに基づいています。前述のPacBenchの結果では、ある簡易コーディングテストでKimiが$0.68、Astraが$2.04だったため、絞られたジョブでは、リーダーボードが示すよりはるかに安くなる可能性があります。
メリット
- 100万トークンあたり
$2/$10、Moonshot独自のライセンスによるオープンウェイト - Kimiの料金ページによると、バッチ推論は標準料金の60%
- 回答不能な質問の37%を間違え、Sol、Astra、Opusより良い結果
デメリット
- インデックスで46.5、Neon、Astra、Opusを大きく下回る
- 1タスクあたり39.4分、私の表の中で最も遅いモデル
- 料金ページにリージョンエンドポイントの記載なし
料金: kimi-k3.1-proで100万トークンあたり入力$2、キャッシュ$0.20、出力$10、Kimiの料金ページより。私の記事Kimi K3.1 Proの料金でプランを解説しています。
結論: オープンウェイトやベンダーの多様性が重要な場合に選んでください。難しい推論には見送り、まず私のKimi K3.1 Proレビューを読んでください。
7. DeepSeek V4.1 Flash
最適な用途: 表示価格が最も安い大量の分類とルーティング。
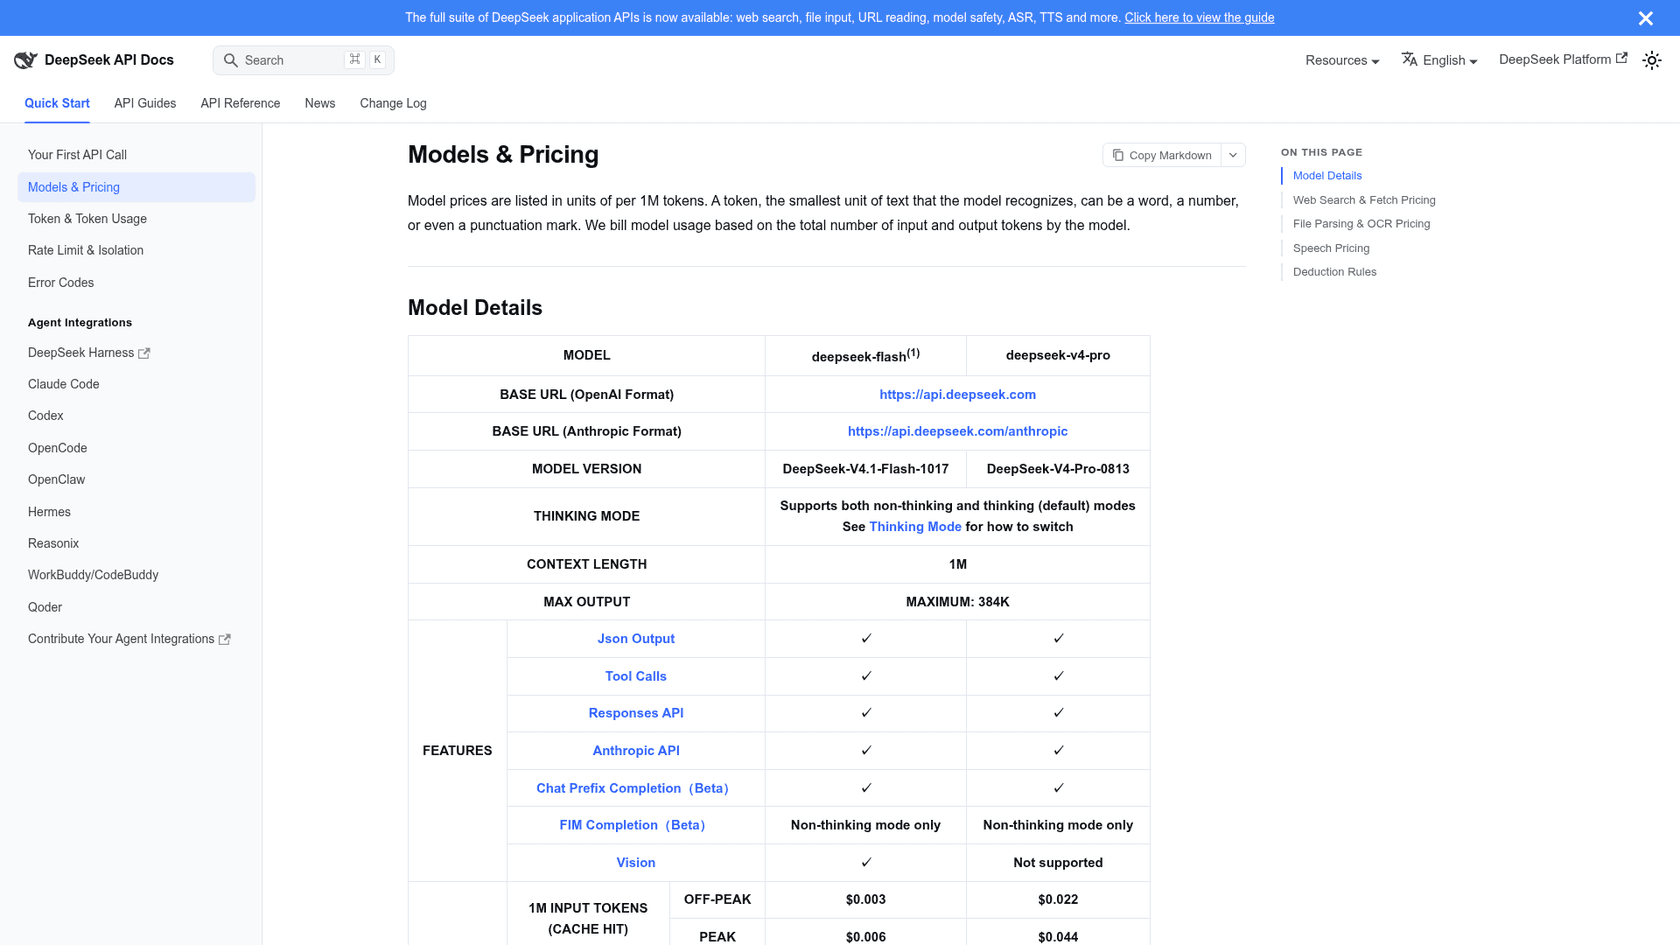
現行モデルはDeepSeek V4.1 Flashで、DeepSeekのドキュメントではDeepSeek-V4.1-Flash-1017を実行するdeepseek-flashとしてリストされています。オフピークでは100万トークンあたりキャッシュミス時の入力$0.15、出力$0.60で、ピーク時(平日UTC 01:00から04:00、06:00から10:00)はその倍です。キャッシュヒットは$0.003です。1Mトークンのウィンドウ、最大384Kの出力、JSON出力、ツール呼び出し、ビジョン、並行数上限2,500を持ちます。
Artificial Analysisはmaxで1タスク$0.60のコストで33を記録していますが、これはピークレートで計算されたもので、私の計算ではオフピークならその約半分です。驚くべきは、安いトークンが安いタスクにはならなかったことです。138,962トークンを書くため、54.9のSol highとほぼ同じコストになります。発売スレッドのあるコメンターは別の予算感を持っていました。
"I don't think it beats Deepseek v4.1 Flash 1017 at cost per task."
トークン価格については、そして軽い作業の料金についても、その意見は正しいです。ウェイトはMITライセンスなので、自分でホストできます。
メリット
- オフピーク
$0.15/$0.60、キャッシュヒット$0.003 - Artificial Analysisによると、合計552B、アクティブ16BのMITライセンスのオープンウェイト
- 料金ページにJSON出力とツール呼び出しの対応が記載されている
デメリット
- インデックススコア32.6で、推論モデルではなくトリアージ用モデル
- maxで回答不能な質問の64%を間違える
- 料金ページにリージョンエンドポイントやデータ処理条件の記載がないため、顧客データを送る前に確認が必要
料金: オフピークで入力$0.15(キャッシュミス)、キャッシュヒット$0.003、出力$0.60、DeepSeekの料金ページより。ピークとオフピークの計算についてはDeepSeek V4.1 Flashの料金を参照してください。
結論: 33のスコアで十分な分類とルーティングに選んでください。人間が関与しない顧客対応には見送ってください。
どのGemini 4 Neonの代替を選ぶべきか?
用途別に、私が選ぶならこうする、という判断を示します。
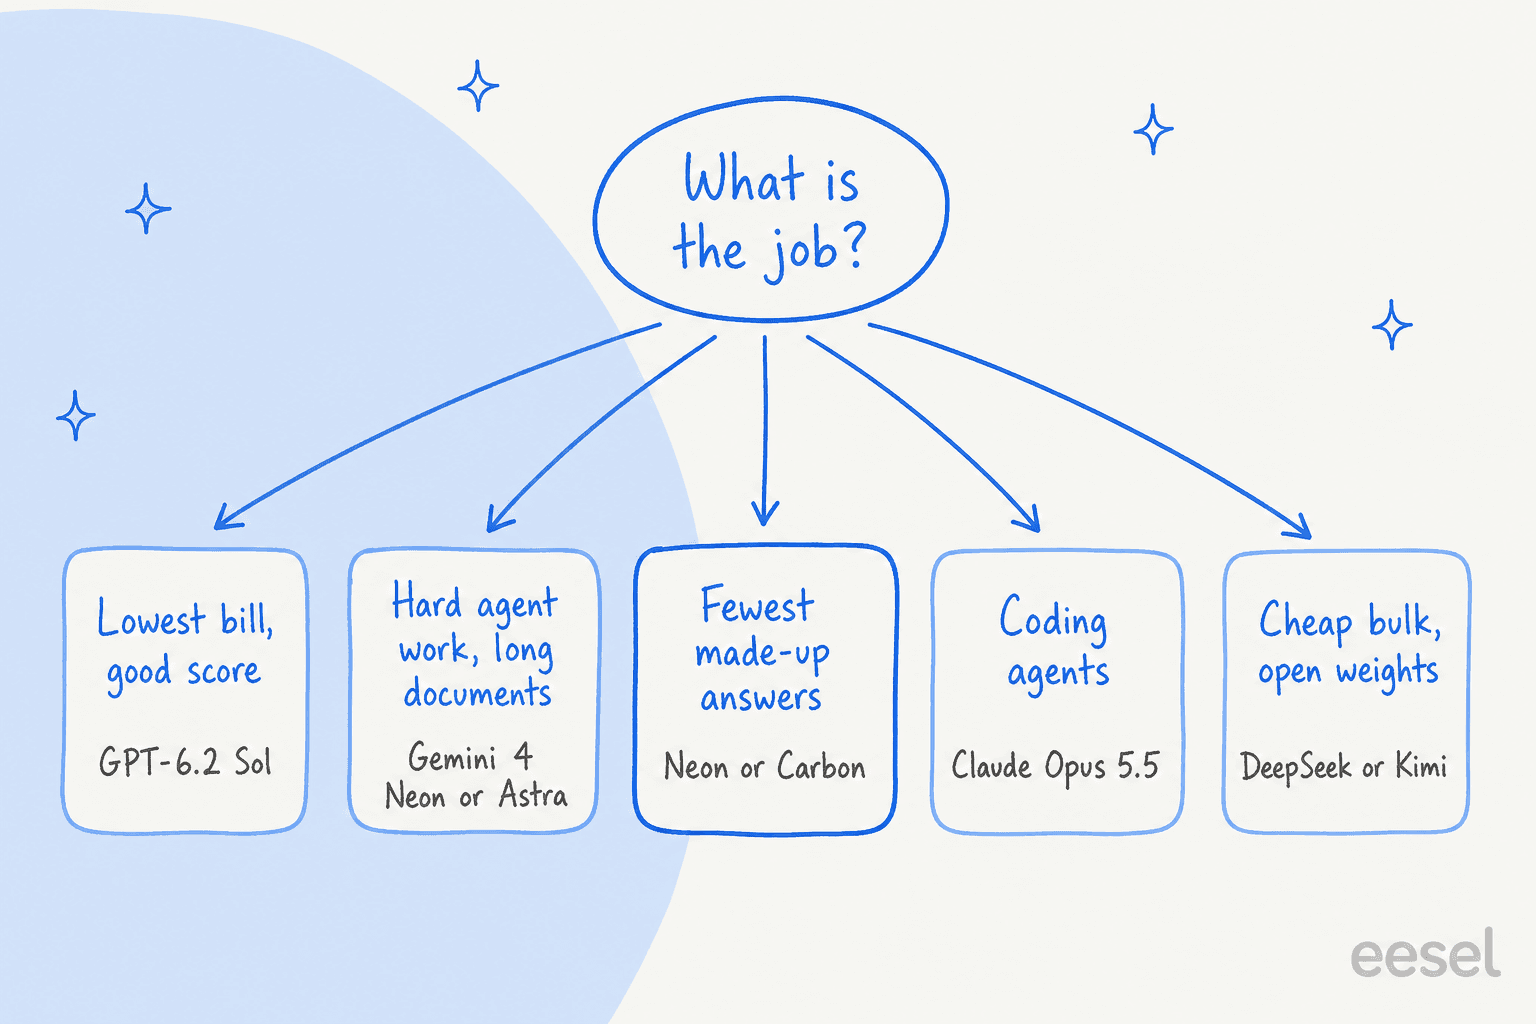
| タスクが... なら | 私の選択 | 理由 |
|---|---|---|
| 50台後半のスコアで最安料金 | GPT-6.2 Sol | 1タスク$0.56から$1.01 |
| より低コストでNeonのスコア | GPT-6.2 Astra high | $2.07で60.1 |
| 難しいエージェントと非常に長いドキュメント | Neonのhigh、またはAstra | Google自身の表でもNeonの長コンテキストの行が上位 |
| 不確実な場合に拒否するモデル | Neon、またはCarbon | 不確実な場合の間違い率14%、4%から11% |
| Anthropicでの長いコーディングセッション | Claude Opus 5.5 | コーディングは強いが、maxで1タスク$10.04 |
| オープンウェイト、または米国以外のベンダー | Kimi K3.1 Pro | $2/$10、スコア46.5 |
| 大量のトリアージとルーティング | DeepSeek V4.1 Flash | 1タスク$0.60、MITウェイト |
| ライブチャット | Neon medium、またはHydrogen | 14.8分ではなく8.3分 |
私の全体的な見解は切り替えるのではなくルーティングすることです。多くのタスクをSolに送り、より強いモデルが必要なものだけをAstraかNeonに送り、トリアージ用に下位ティアを残してください。モデルファミリーで迷っている場合は、私のChatGPT対Geminiの比較がさらに詳しく解説しています。Geminiの代替のまとめでGoogleのラインナップの残りを、OpenAI API対Gemini APIのガイドでプラットフォームを扱っています。
自社のワークロードで代替をどうテストするか?
リーダーボードのタスクはあなたのタスクではありません。実際のトラフィックを動かす前に行うべき5つの確認を、実施する順に示します。
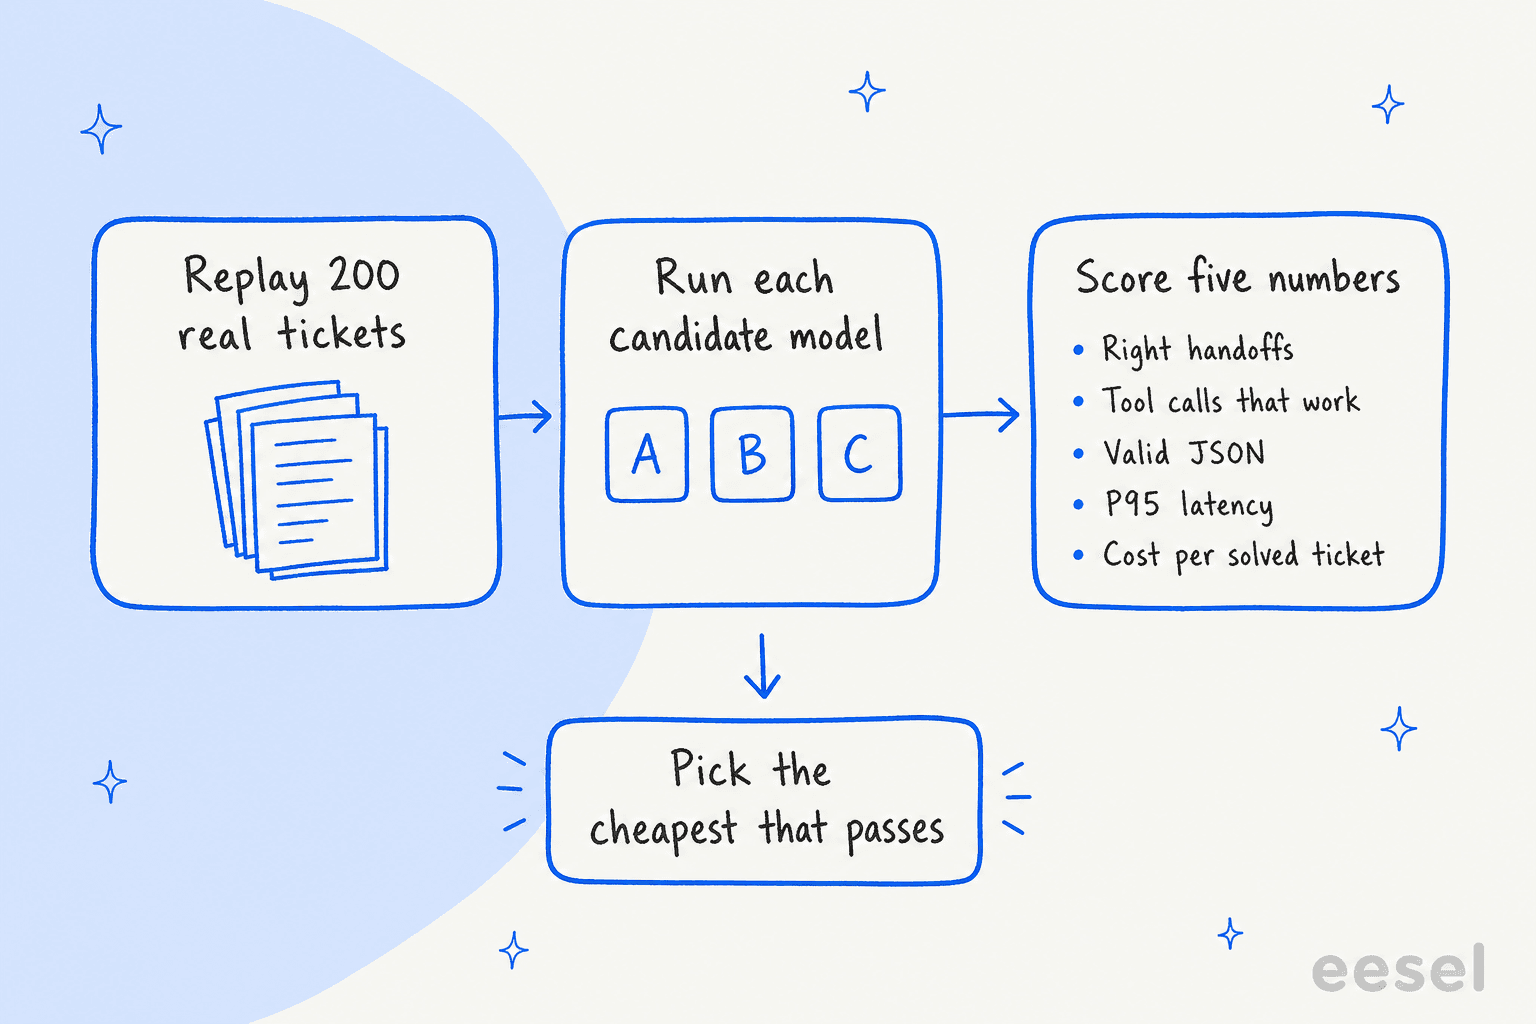
- ツール呼び出し。 実際のツール定義でタスクを再生し、3つを数えてください。正しいツールが選ばれているか、検証に通る引数か、不要な場合に呼び出しがないか。エージェントが特定のツールを強制する場合は、まずそのモードをテストしてください。Anthropicの料金ページではOpus 5.5とSonnet 5.5のツール選択が
autoとnoneのみなので、ツールの強制に依存する設計は移行前の確認が必要です。OpenAIのファンクションコーリングのガイドでOpen AI側を解説しています。 - 構造化出力。 修復ステップなしでスキーマに対してパースできる回答の割合を測定してください。DeepSeekの料金ページはJSON出力の対応を記載しており、OpenAIのJSONモードには独自のルールがあるため、同じスキーマを各候補で試してください。50件に1件の無効な回答がリトライとコストになります。
- レイテンシ、特に裾の部分。 最初のトークンまでと完了までの時間の中央値とP95を記録してください。前述のHNのテスターはCarbonで中央値5秒、1回の呼び出しで50秒、1回のタイムアウトを測定しました。中央値はそれを隠し、顧客は裾の部分を感じます。Artificial Analysisも、xhighのNeonで最初の回答トークンまで56.5秒を測定しているため、使う予定のエフォートレベルごとに測定してください。
- リトライ。 タイムアウト、レート制限エラー、整形不良の出力を100回の呼び出しごとに数え、
1回あたりのコスト x (1 + リトライ率)を実際のコストとしてください。これが安いモデルを高いモデルと同じ土俵に戻す数字です。 - 誤った回答対引き継ぎ。 回答が自社ドキュメントにない約20件のチケットを用意し、それでも各モデルが答えてしまう回数を数えてください。これはAA-Omniscienceの数字が示すのと同じ挙動を、自社のコンテンツで測定したものです。
最後にすべてを1行にまとめます。解決チケットあたりのコスト = 総支出 / 人の修正なしで正しく解決したチケット数です。これがランキングに使うべき数字で、チケットあたりのコストのモデルレベル版です。各候補を同じ200件のチケットで、2つのエフォートレベルで、2回実行してください。AstraとSolでの90回分のテストでは、短いチケットではエフォートがコストをほとんど動かさないことがわかり、それが本番で使うエフォートレベルを変えました。
これはサポートエージェントにとって何を意味するか?
目標がサポートボットであれば、これら7つのモデルはエンジンであり、エージェントではありません。エージェントが何を知っているか、いつ引き継ぐべきか、公開前にテストされたかが、その振る舞いを決めます。自信ありげだが間違った返金の回答は、引き継ぎよりもコストがかかります。eeselは何年も実運用のサポートキューにAIエージェントを置いてきましたが、身についた教訓は、エージェントが顧客に返信する前に、過去のチケットに対してあらゆるロールアウトをシミュレートすることです。
smava、ドイツのローン比較企業は、このようにeeselを1つのZendeskで運用しています。2026年8月8日から9月8日の間に、3つのエージェントが約27,000件のチケットを処理しました。1つは約14,600件を分類し、1つは820のマクロとヘルプ記事から約15,300件の返信を作成し、ブランド別のエージェントが顧客向けの回答を準備しました。各エージェントには1つの仕事と、絶対にしてはならないことのリストがあり、何かが送信される前に人がドラフトを承認します。SamCartはチャネル別に作業を分けています。1つのエージェントがFreshdeskのチケットを、もう1つがウェブサイトのチャットを担当し、どちらも同じ280件のヘルプセンター記事から回答します。
どちらの話も最良のモデルを選ぶことについてではありません。モデルはデザインの中の1つの設定であり、そのデザインには知識、引き継ぎルール、テストが含まれることを示しています。自社のキューでモデルを比較したい場合は、過去のチケットでエージェントをシミュレートし、精度よりも引き継ぎ率を注視してください。私のガイドAIサポートエージェントのベンチマークで追跡している数字をリストしており、AIカスタマーサービスのコストでキュー全体のコストを示しています。
eeselを試す
キューでより良い回答が欲しくてモデルを選んでいるなら、eeselのAIヘルプデスク・チームメイトが、あなたが選んだどのモデルの上にも乗る従業員です。過去のチケットとヘルプセンターから学び、ドキュメントに回答がない場合は人に引き継ぎ、誰にも返信する前に実際のチケット履歴でテストできます。ZendeskとFreshdeskの中で動作し、サポートのロールアウトで本当の問いが「どのモデルか」であるなら、そこから始めます。
料金は固定の月額クレジットプランで、カード登録不要の100クレジットの無料プランがあるため、モデルの価格変更があなたの料金を動かすことはありません。キューの一部でeeselを試してみてください。