Meta Muse Spark Openのおすすめ代替モデル8選【2026年】ライセンス・価格・ハードウェアで比較

Rama Adi

Katelin Teen
最終更新 October 18, 2026
なぜMuse Spark Open以外を探すのか
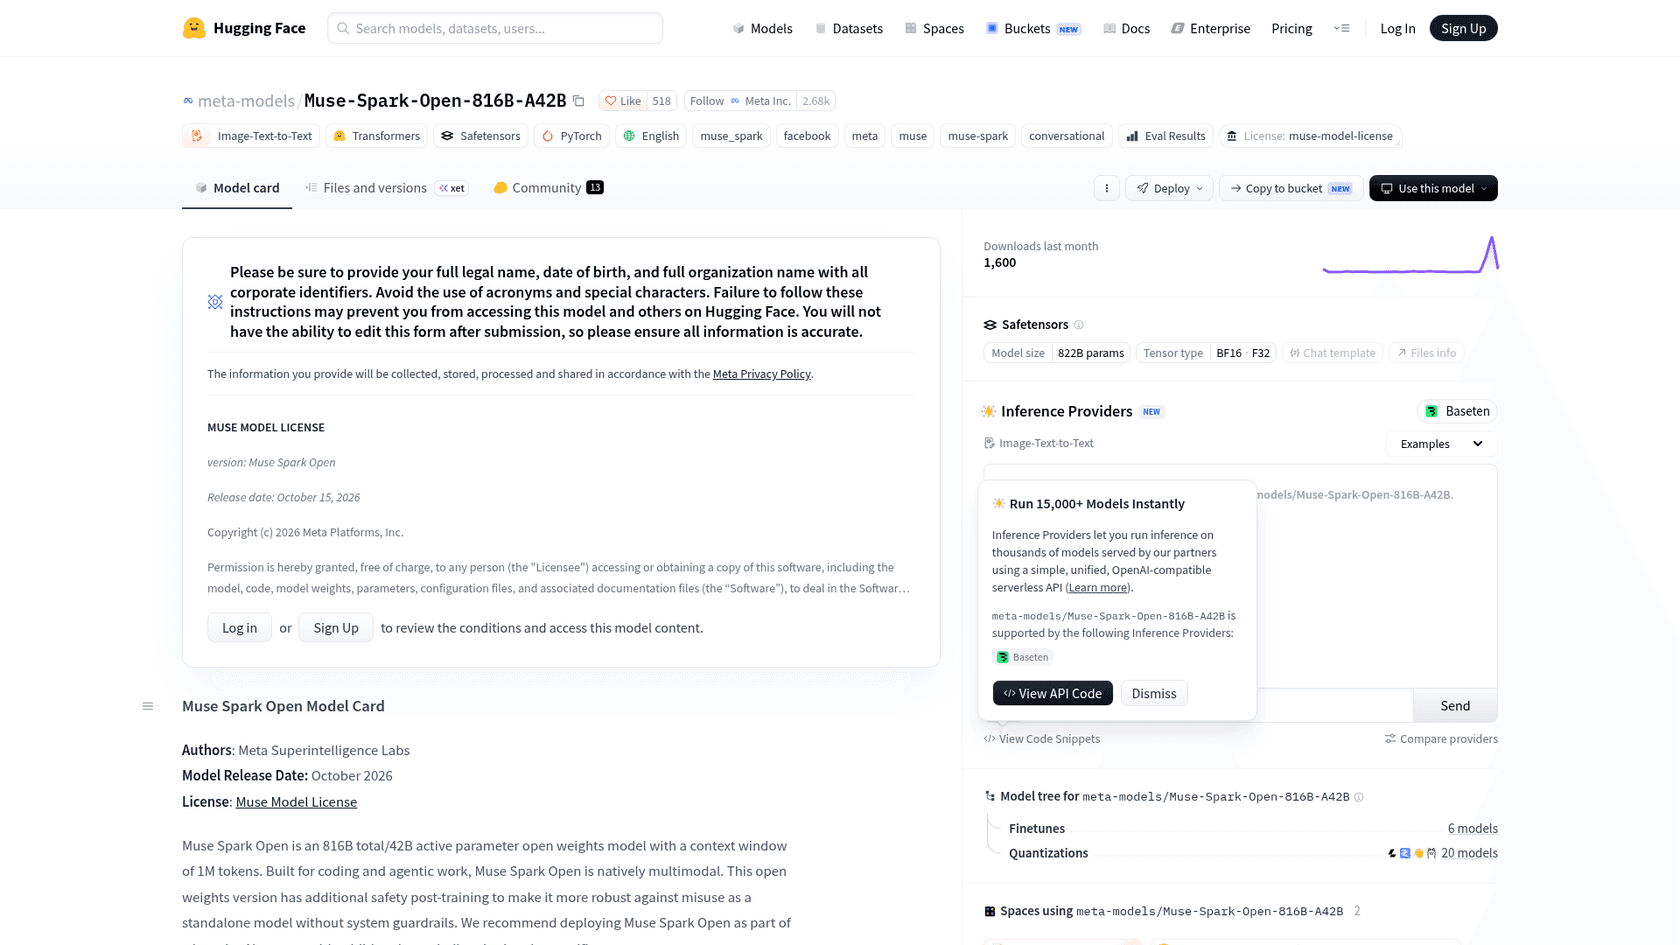
Metaは2026年10月15日にMuse Spark Openをリリースしました。これは本格的なモデルです。816Bパラメータのmixture-of-expertsで、トークンあたり42Bがアクティブ、1Mトークンのコンテキストウィンドウを持ち、Metaのリサーチブログによればテキスト、画像、音声、動画をネイティブに入力できます。また、同クラスで初めてデスクの上で動くモデルでもあります。AppleのMLXを使い、M5 UltraのMac Studio 2台で毎秒24.99トークンを出します。
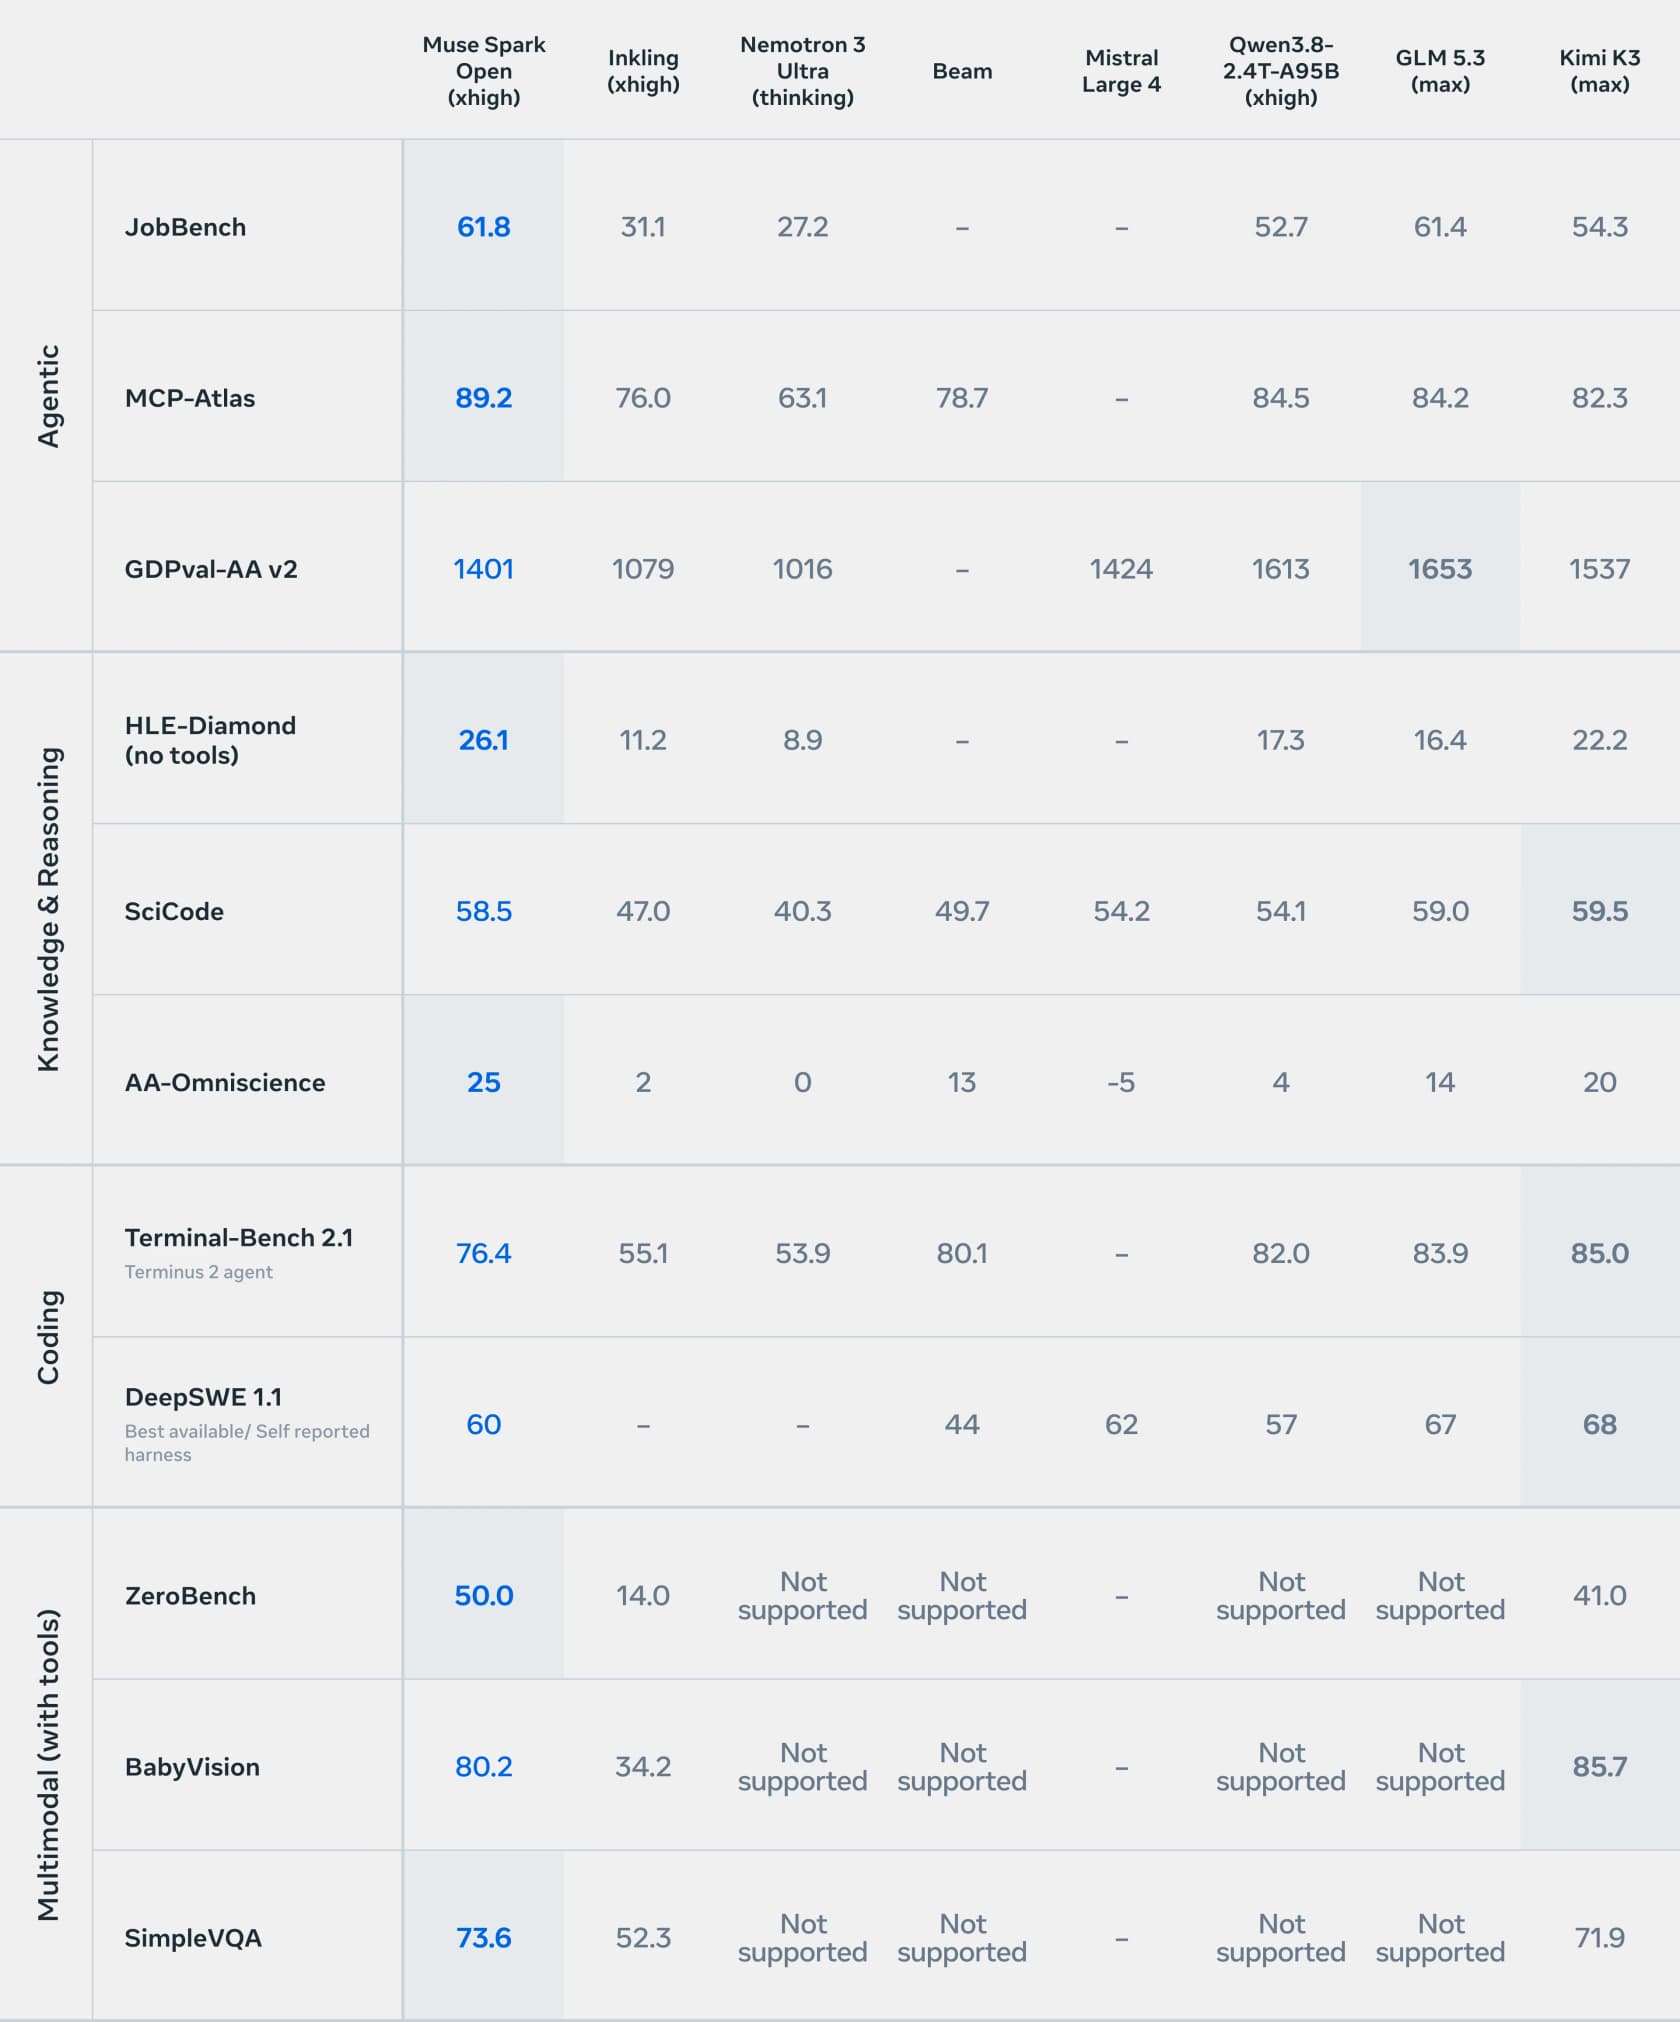
私はeeselでインテグレーションとAPIを作っているので、新しいモデルが出たらまずベンチマークのグラフより先にライセンスと料金表を読みます。Muse Spark Openにはそこで確かな強みがあります。Metaのモデルカードでは、MCP-Atlas(89.2)、JobBench(61.8)、HLE-Diamond(26.1)で同クラスをリードし、StrongREJECTでは0.5を記録しています。表の他のモデルはすべて62.9から86.4の間です。一日中ツールを呼び出し、不適切な依頼を断る必要があるエージェントにとって、これは意味のあるリードです。
それでも、ほかを探そうと考える人が挙げる理由は、繰り返し出てくる4つです。
- スコア。 Meta自身の表では、Muse Spark OpenのArtificial Analysis Intelligence Indexは39で、GLM 5.3(45)、Kimi K3(44)、Qwen3.8(40)の後ろです。コーディングでも劣り、DeepSWEは60で、Kimi K3の68に及びません。
- ライセンス。 Muse Model Licenseは、これを使うすべての製品で「prominently display 'Built with Muse Spark Open'」(「Built with Muse Spark Open」を目立つ形で表示)することを、規模を問わず求めています。売上高が2,000万ドルを超えるモデルホスティング事業者は、Metaと別途契約も必要です。
- 価格。 OpenRouter上のどのホストも、100万トークンあたり入力$1.25、出力$4.25で、クローズドモデルのMuse Spark 1.3と同じ料金です。オープンウェイトなら通常はホスト価格が下がりますが、今回は下がりませんでした。
- 過剰な拒否。 FORTRESSでは、Muse Spark Openの過剰拒否スコアは17.4で、Kimi K3は2.7、GLM 5.3は3.2です。ジェイルブレイクを難しくする安全性トレーニングは、無害な依頼まで断る場面も増やします。
Hacker Newsのローンチスレッドも、同じ2点に行き着いています。
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model. I know we've seen this before with other large models, but it's still a bit irritating. The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

"Well, this is much better than nothing -- we should be grateful that whatever the market conditions and corporate incentives, a major lab is releasing a capable open-weight model. But still very far behind DeepSeek and GLM. Even on consumer hardware, Qwen 3.8 27B is going to compare favorably to this."
代替モデルの選び方
この記事を書く前に、ビルダーはMuse Spark Openを何と比較すべきかをChatGPTに尋ね、実行された検索を記録しました。ChatGPTはまず「best open-weight language models 2026 Qwen DeepSeek Kimi GLM」を検索し、GLM 5.3、Kimi K3、Qwen3.8、DeepSeek V4、Mistral Large 4、gpt-oss-120bの6つの名前を返しました。私はこの6つをすべて採用し、Meta自身の比較表にある他の2つのオープンモデル、Nemotron 3 UltraとInklingを加えました。
ここで取り上げる代替モデルは、すべて次の3つのルールを満たしています。
- ウェイトが今日ダウンロードできること。または、ベンダーが日付付きの公約を出していること(これに当てはまるのはMistral Large 4だけで、その旨を明記しています)。
- 価格はベンダー自身のページから取ること。ラボがモデルを直接販売していない場合は、名前の挙がったホスト自身の料金ページから取ります。
- スコアは可能な限り1か所から取ること。すべてのモデルを同じハーネスで実行しているため、Metaの比較表を使います。ほかから取った数字には、その旨を書きます。
それぞれを同じ4つの質問で比べました。Muse Spark Openに勝っている点は何か、足りない点は何か、いくらかかるか、ライセンスは何を求めるか、です。
Muse Spark Openの代替を一覧で比較
| モデル | 開発元 | 総パラメータ / アクティブ | コンテキスト | 入力タイプ | ライセンス | 付帯条件 | Metaの表でのスコア | ホスト価格(100万あたり入力 / 出力) | セルフホストの最小構成 | 推論をオフにできるか |
|---|---|---|---|---|---|---|---|---|---|---|
| Muse Spark Open(基準) | Meta | 816B / 42B | 1M | テキスト、画像、音声、動画 | Muse Model License | すべての製品に「Built with」ラベル。売上高$20M超のモデルホストは契約が必要 | 39 | $1.25 / $4.25 | Mac Studio 2台(M5 Ultra) | 不可 |
| GLM 5.3 | Z.ai | 744B / 40B | 1M | テキストのみ | GLM-5.3 License(MIT系) | 売上高$10B超のモデルホストにのみセキュリティレビュー | 45 | $1.40 / $4.40 | 記載なし | 不可 |
| Kimi K3 | Moonshot AI | 2.8T / 104B | 1M | テキスト、画像、動画 | Kimi K3 License(MIT系) | ユーザー1億人超または月売上$20M超で「Kimi K3」を表示。売上高$20M超のモデルホストは契約が必要 | 44 | $3.00 / $15.00 | 記載なし(2.8Tパラメータ) | 不可 |
| Qwen3.8 2.4T | Alibaba | 2.4T / 95B | ネイティブ262K、最大1M | テキストのみ(オープンのベース) | Qwen3.8 License | ユーザー1億人超または月売上$20M超で名称を表示。売上高$50M超のモデルホストはライセンスが必要 | 40 | $2.00 / $6.00(Qwen3.8 Max) | 記載なし | 不可(オープンのベース) |
| DeepSeek V4.1 Flash | DeepSeek | 552B(アクティブ8B / 16B) | 1M | テキスト、画像 | MIT | 著作権表示を残す | 表になし | オフピーク $0.15 / $0.60 | 記載なし | 可 |
| gpt-oss-120b | OpenAI | 117B / 5.1B | 128K | テキストのみ | Apache 2.0 | 再配布時に表示 | 表になし | $0.15 / $0.60(Together) | 80GB GPU 1枚 | 不可(low / medium / high) |
| Mistral Large 4 | Mistral AI | 1.05T / 52B | 1M | テキスト、画像 | 未発表 | ウェイトは10月末に公開予定 | 38 | $0.68 / $2.09(セール価格) | 記載なし | ハイブリッドモデル |
| Nemotron 3 Ultra | NVIDIA | 550B / 55B | 最大1M(設定では262K) | テキストのみ | OpenMDW-1.1 | 再配布時に表示 | 23 | $0.50 / $2.20(DeepInfra) | H200 8基 | 可 |
| Inkling | Thinking Machines Lab | 975B / 41B | 1M | テキスト、画像、音声 | Apache 2.0 + 利用ポリシー | 利用ポリシー(AIであることの開示) | 26 | $1.00 / $4.05 | 600GB以上(NVFP4) | エフォート制御 |
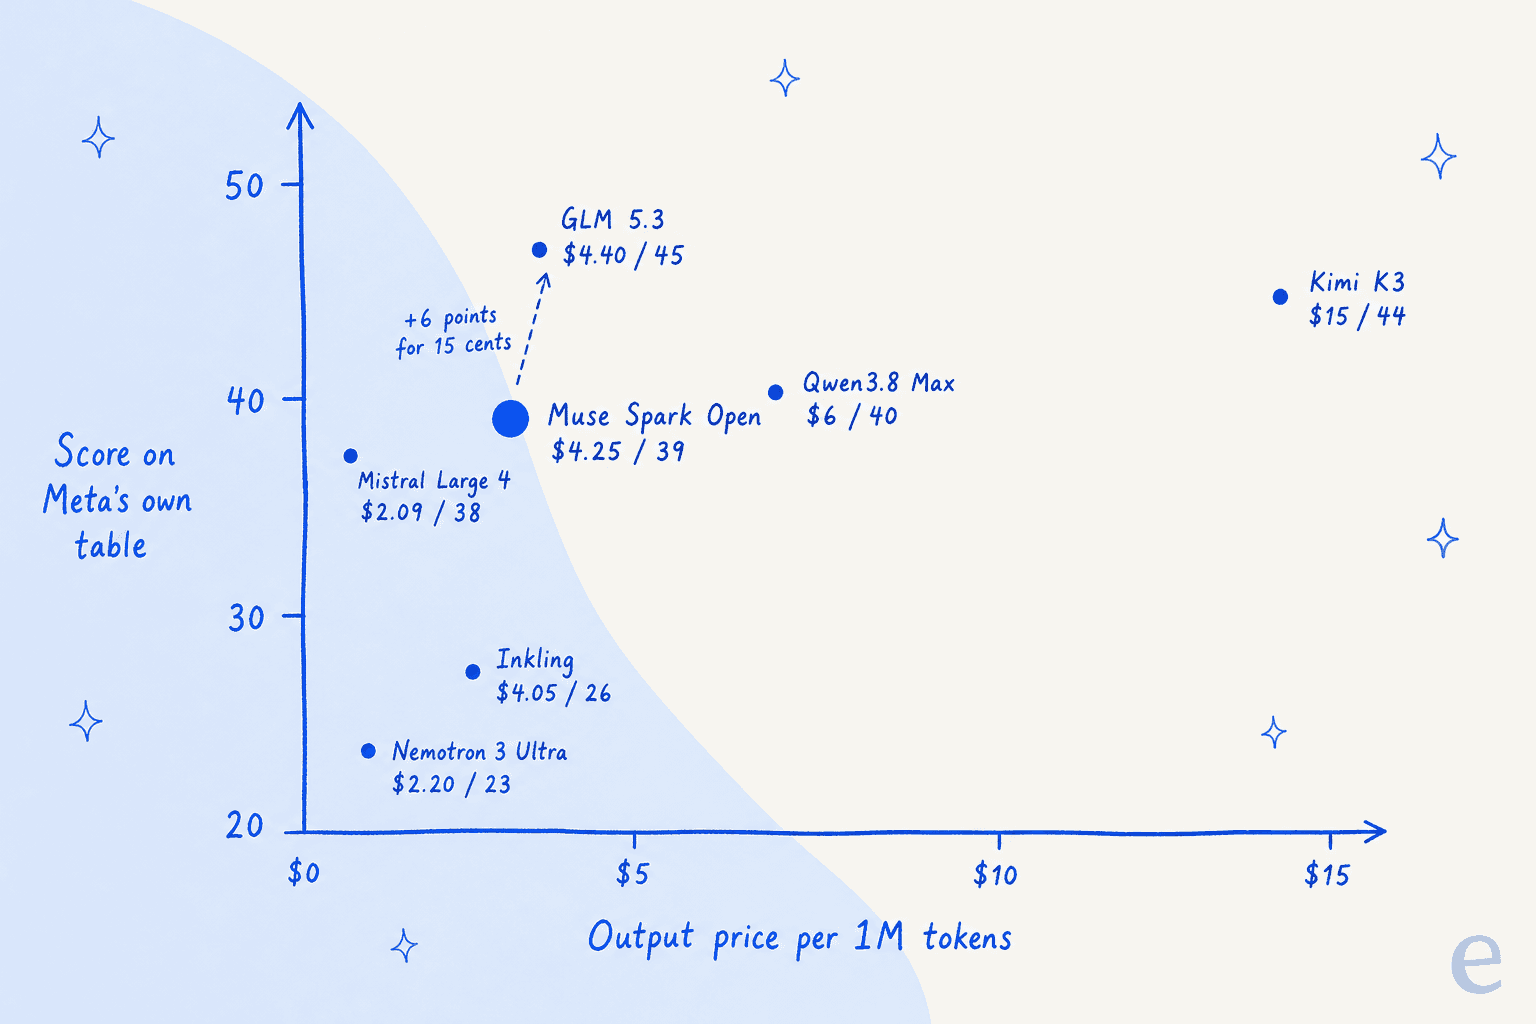
このチャートが議論のすべてを1枚で表しています。Muse Spark Openは価格もスコアも中ほどに位置します。GLM 5.3はそのほぼ真上にいます。Kimi K3は大きな請求額と引き換えに数ポイントを買い、Mistral Large 4は同程度のスコアでより安いものの、今のところはプレビューAPIのみです。
乗り換えの理由別、どの代替が合うか
多くの人は「一般的に優れたモデル」を求めてMuse Spark Openを離れるわけではありません。具体的な理由が1つあります。自分の理由を選ぶと、対応するおすすめが下に表示されます。
Muse Spark Openをやめたい理由を選ぶと、最初に試すべき代替が表示されます。数字はすべて、下に挙げたベンダーのページとMetaの表によるものです。
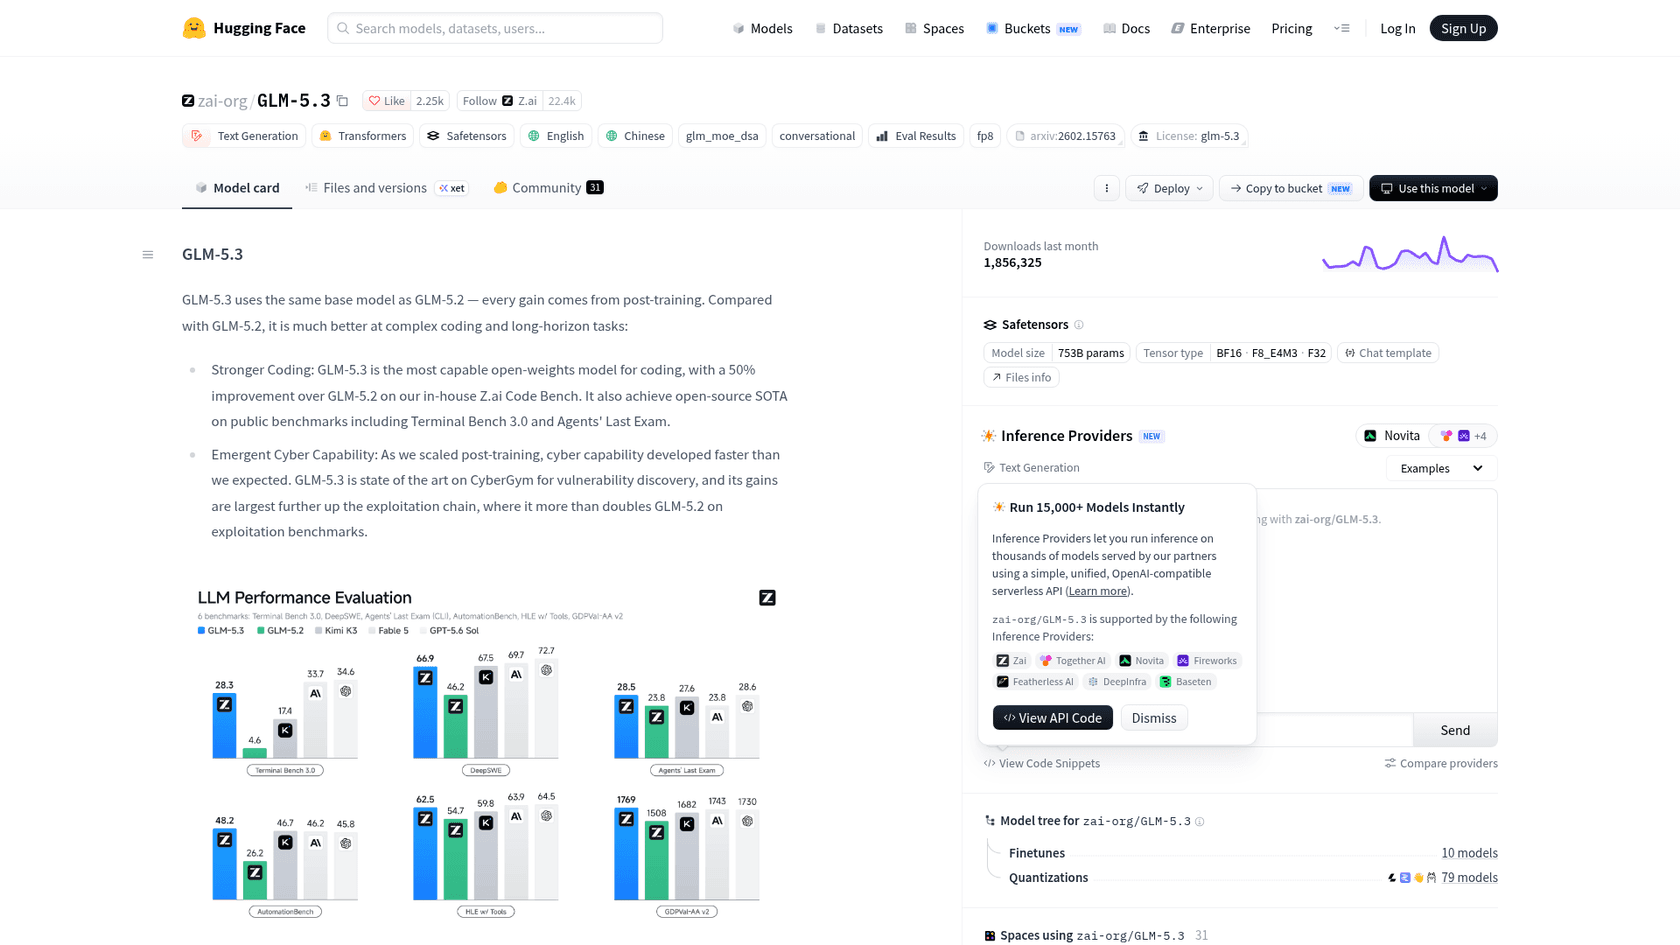
1. GLM 5.3
**こんな人におすすめ:**ほぼ同じ価格で、より軽いライセンスのMuse Spark Open上位互換を求めるチーム。
GLM 5.3は、2026年8月14日にローンチされたZ.aiのフラッグシップです。Z.aiのGLM-5ダウンロード表によれば、744Bパラメータのmixture-of-expertsでアクティブは40B、1Mトークンのコンテキストと最大128Kトークンの出力を備えます。GLM-5.2と同じベースモデルで、モデルカードには「every gain comes from post-training」(すべての向上はポストトレーニングによる)とあります。別のベースである320Bの、より小さなGLM 5.3 Flashと混同しないでください。
**Muse Spark Openに勝っている点。**Meta自身の表で、GLM 5.3はオープンモデルの中で最高のIntelligence Indexスコア(45対39)、最高のGDPVal-AA v2スコア(1653対1401)を記録し、ツール付きHLE(62.5対61.0)、DeepSWE(67対60)、Terminal-Bench 2.1(83.9対76.4)でもリードしています。無害な依頼の拒否もはるかに少なくなっています(FORTRESS過剰拒否 3.2対17.4)。
**足りない点。**テキストのみなので、画像、音声、動画の入力はできません。推論はオフにできません。Z.aiのドキュメントには「disabling reasoning is no longer supported」(推論の無効化はサポートされなくなりました)とあり、エフォートレベルはlow、high、maxです。MCP-Atlas(84.2対89.2)ではMuse Spark Openに負け、ジェイルブレイクもはるかにされやすくなっています(StrongREJECT 62.9対0.5)。
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."
**価格とライセンス。**Z.aiの料金ページでは、GLM 5.3は100万トークンあたり入力$1.40、キャッシュ$0.26、出力$4.40で、ローンチ時から変わっていません。Muse Spark Openより入力も出力も15セント高い設定です。GLM-5.3 LicenseはMIT系で、条件は1つだけです。グループ売上高が100億ドルを超えるモデルホスティング事業者は、Z.aiのセキュリティレビューを受ける必要があります。モデルを機能に組み込む製品はその定義から除外されており、表示義務もありません。
| プラン | 100万あたり入力 | 100万あたりキャッシュ入力 | 100万あたり出力 |
|---|---|---|---|
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 FlashX | $0.37 | $0.075 | $1.25 |
| GLM 5.3 Flash | $0.15 | $0.03 | $0.50 |
**評価:**最初に試すならこの代替です。マルチモーダル入力が不要なら、GLM 5.3は100万トークンあたり15セント高いだけで、より高いスコア、より少ない拒否、より緩いライセンスが手に入ります。画像、音声、ツール呼び出しの精度がワークロードの核心である場合だけ見送ってください。
2. Kimi K3
**こんな人におすすめ:**トークン代よりも品質が重要な、コーディングエージェントとマルチモーダル作業。
Kimi K3は、2026年7月にリリースされたMoonshot AIのフラッグシップで、ウェイトはHugging Faceにあります。ここで紹介する中で最大のモデルで、総パラメータ2.8T、アクティブ104B、896のエキスパートからトークンごとに16が選ばれます。テキスト、画像、動画をネイティブに読み、1Mトークンのコンテキストを保持し、K3クイックスタートによれば出力は最大1,048,576トークンまで設定できます。
**Muse Spark Openに勝っている点。**Kimi K3はMetaの表のコーディングリーダーです。DeepSWEは68対60、SWE-Atlas-QnAは66対58、Terminal-Bench 2.1は85.0対76.4です。OSWorld Verified(84.8対80.4)、Toolathlon(76.5対72.8)、動画ベンチマークのVideoMMEv2(65.4対61.5)でも勝っています。過剰拒否スコアは2.7で、セット内で最も低くなっています。
**足りない点。**MCP-Atlas(89.2対82.3)、JobBench(61.8対54.3)、安全性ではMuse Spark Openが上です。Metaのカードによれば、Metaの社内サイバーベンチマークでKimi K3がジェイルブレイクを拒否できたのは75.5%にとどまり、Muse Spark Openは99.2%です。推論はオフにできず、APIは公開画像URLを受け付けず、base64またはアップロード済みファイルIDのみです。
価格とライセンス。Moonshotの料金ページでは、100万トークンあたり入力$3.00、キャッシュ$0.30、出力$15.00で、1Mコンテキスト全体で一律です。新しい点として、キャッシュ書き込みは別課金になり、5分キャッシュで100万あたり$3.00、1時間キャッシュで$6.00です。Kimi K3 Licenseはホスティング面ではMuse Spark Openに近い内容(年間売上高が2,000万ドルを超えるモデルホスティング事業者は別途契約)ですが、表示義務が発動するのは月間ユーザー1億人超または月売上2,000万ドル超からです。
"I believe it's because they are below $20 Million revenue limit (which Kimi K3's license has) So we won't see any price decrease unless Kimi changes the license of K3"
**評価:**コーディングスコアがプロジェクトを左右するなら、Kimi K3です。出力価格はMuse Spark Openの3.5倍なので、必要な仕事にだけ使い、それ以外はもっと安いモデルに振り分けるのがよいでしょう。コスト計算はKimi K3の料金解説にあります。
3. Qwen3.8
**こんな人におすすめ:**Mac 1台からホスト型フラッグシップまで、1つのモデルファミリーでスケールさせたいチーム。
Qwen3.8は実際には2つのオープンリリースです。大きいほうのQwen3.8-2.4T-A95Bは、2.4Tパラメータでアクティブ95Bのmixture-of-expertsです。コンテキストはネイティブで262,144トークン、約1Mまで拡張できます。小さいほうのQwen3.8-27Bは、画像と動画を読む密な27Bモデルで、リクエストごとに思考のオン・オフを切り替えられます。ホスト型のQwen3.8 Maxは大きなベースの上に作られ、ビジョン、非思考モード、組み込みツールが加わっています。
**Muse Spark Openに勝っている点。**Metaの表では、オープンの2.4Tベースは Intelligence Indexで40(1ポイント上)、GPQA DiamondでKimi K3と並んで最高スコア(93.5対89.0)を記録し、Terminal-Bench 2.1(82.0対76.4)、SWE-Atlas-QnA(62対58)、GDPVal-AA v2(1613対1401)でもMuse Spark Openを上回ります。本当に驚きなのは27Bです。AppleのMLXベンチマークでは、65,536トークンのコンテキストで最大68GBのメモリを使い、Mac Studio 1台に収まることが示されています。
**足りない点。**オープンの2.4Tベースは、期待されるより用途が狭いです。モデルカードには「is a text-only model that requires thinking mode for all interactions」(テキスト専用モデルで、すべてのやり取りで思考モードが必要)とあり、ビジョンと非思考の機能はホスト型のMaxだけのものです。MCP-Atlas(84.5対89.2)、JobBench(52.7対61.8)、HLE-Diamond(17.3対26.1)ではMuse Spark Openに劣ります。
"From running small models like Qwen3.8-27B to large models like Qwen3.8-2.4T. I can tell you that small models will never be enough or match up. Everyone will want the smartest model, not just a good enough model."
**価格とライセンス。**Alibabaはオープンのベースを直接販売していません。ホスト型の経路は、QwenCloud上のQwen3.8 Maxで、100万トークンあたり入力$2、出力$6、暗黙キャッシュヒットは$0.25です。27Bには専用のホストページができ、入力$0.50、出力$3です。2.4TのベースはQwen3.8 Licenseで提供され、月間ユーザー1億人超または月売上2,000万ドル超で表示義務があり、売上高5,000万ドル超のモデルホスティングまたはAIワークアシスタント事業者は別途ライセンスが必要です。27BはシンプルなApache 2.0です。
| モデル | 100万あたり入力 | 100万あたりキャッシュ入力 | 100万あたり出力 | ライセンス |
|---|---|---|---|---|
| Qwen3.8 Max(ホスト型) | $2.00 | $0.25(暗黙) | $6.00 | ホスト型のみ |
| Qwen3.8-27B(ホスト型) | $0.50 | $0.10(暗黙) | $3.00 | Apache 2.0 |
| Qwen3.8-2.4T-A95B | セルフホストまたはサードパーティ | n/a | n/a | Qwen3.8 License |
**評価:**Qwen3.8はファミリーとしての選択肢です。ノートPCやMac 1台で小さなMuseモデルを使うところには27Bを、大きなモデルが必要ならホスト型のMaxを使ってください。オープンウェイトの2.4Tを狙うなら、テキストのみであることを忘れないでください。直接対決はQwen3.8 Max vs Kimi K3をご覧ください。
4. DeepSeek V4.1 Flash
**こんな人におすすめ:**トークンコストがすべてを左右する大量ワークロード。
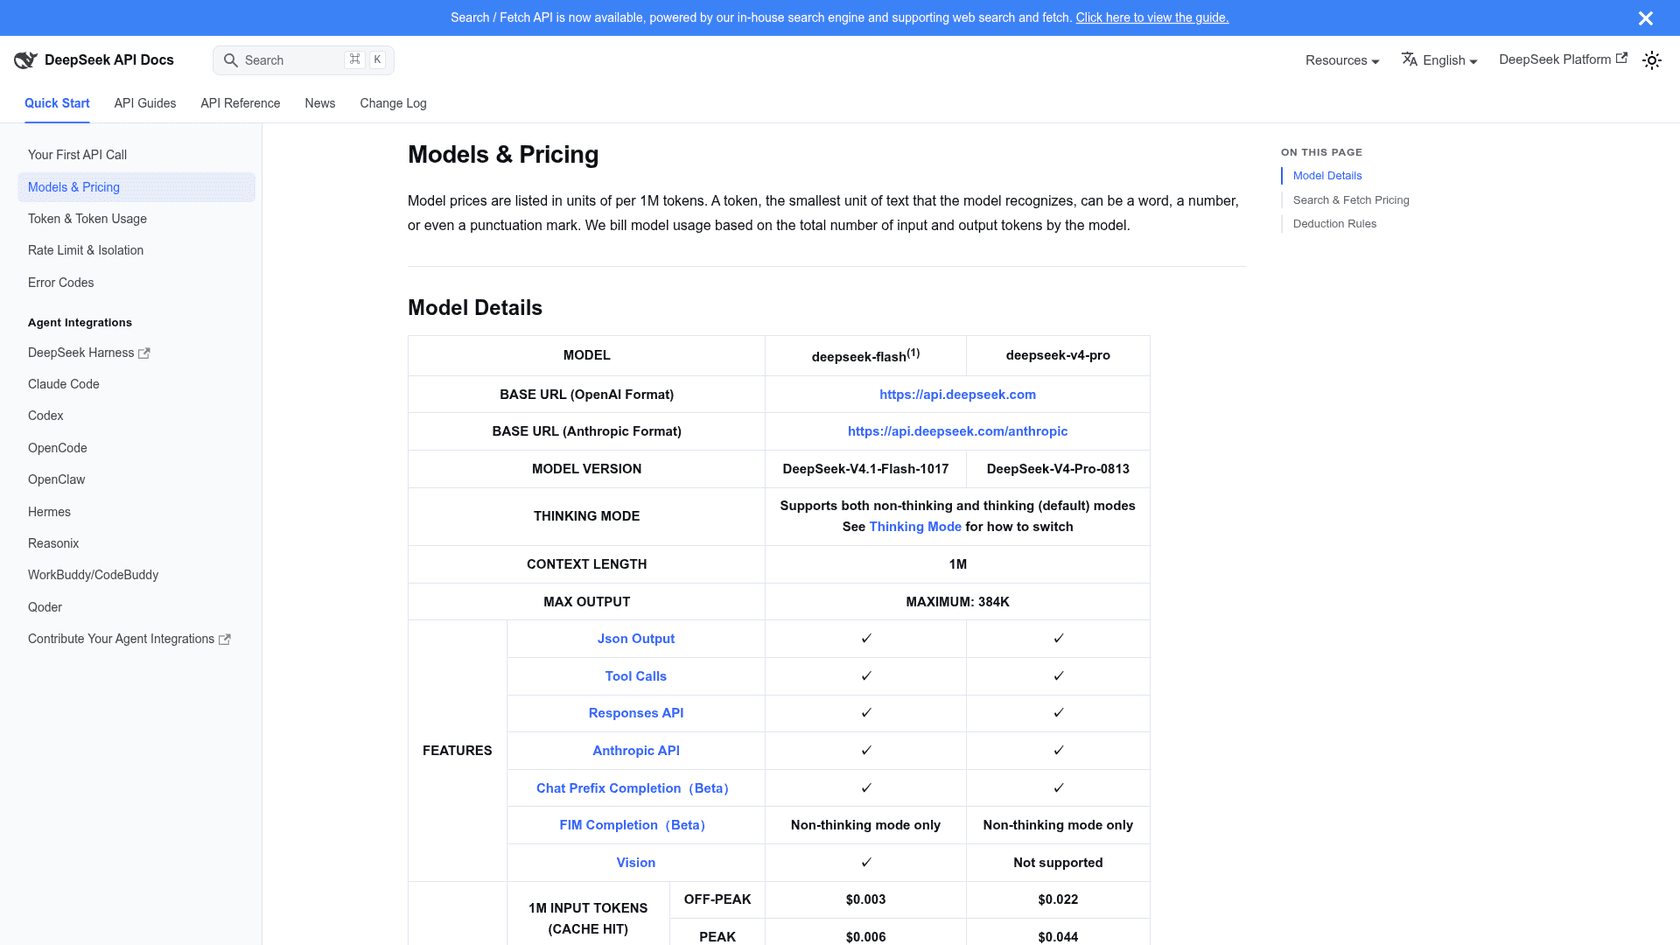
DeepSeek V4.1 Flashは2026年9月10日にローンチされ、10月17日にDeepSeek-V4.1-Flash-1017へアップデートされました。DeepSeekはこれを「stronger benchmark performance, faster task completion, and shorter outputs than the previous version」(前バージョンより高いベンチマーク性能、速いタスク完了、短い出力)と説明しています。ローンチノートによれば、552Bパラメータのmixture-of-expertsで、入力の読み取りにはアクティブ8B、出力の書き込みには16Bという珍しい分け方をしています。1Mのコンテキスト、最大384Kの出力トークン、ビジョン入力に対応します。
**Muse Spark Openに勝っている点。**価格は圧倒的です。また、DeepSeek自身の1017リリースのカードでは、DeepSWE v1.1が77.0に上がり、Metaの表のどのモデルも上回りますが、これは別のハーネスでのベンダー自身の数字です。DeepSeekはMetaの比較には含まれていません。Muse Spark Openのローンチスレッドのコメントでは、Artificial Analysisが以前のV4.1 FlashをMuse Spark Openと同じスコアにしていると指摘されました。
"Crucially, it's about the same as DeepSeek v4.1 Flash, and about 10x more expensive to run...
No thanks..."
**足りない点。**推論トークンは出力として課金され、思考はデフォルトでオンなので、単価が安くても長い回答では大きな請求になりえます。有料APIの規約は、DeepSeekが入力を学習に使うかどうかについて何も述べておらず、ゼロリテンションのオプションも公開されていません。顧客データを自社のAPIに送るつもりなら、これは重要です。MITのウェイトを自分でホストするか、サードパーティのホスト経由で使えば、この問題は避けられます。
価格とライセンス。DeepSeekの料金ページには2つの料金があります。ピーク時間帯は平日の01:00-04:00と06:00-10:00 UTCで、それ以外はオフピークで半額です。
| 料金 | 100万あたりキャッシュヒット入力 | 100万あたりキャッシュミス入力 | 100万あたり出力 |
|---|---|---|---|
| オフピーク | $0.003 | $0.15 | $0.60 |
| ピーク | $0.006 | $0.30 | $1.20 |
ウェイトはMITで、著作権表示を残すだけです。売上のしきい値も表示義務もありません。
"I've been using DS v4.1 Flash daily for nearly a month now on Agent Swarm experiments. I've tested it against GLM-5.3-flash and Opus 5.5. DS 4.1 comes out tops for me. Opus 5.5 is still the smartest, but DS 4.1's speed and price more than make up for the "intelligence" gap."
**評価:**Muse Spark Openを1日に何百万回も呼び出すつもりなら、まず同じテストセットをDeepSeek V4.1 Flashで実行してください。オフピークで出力100万トークンあたり$0.60、約7倍安く、この一覧で最も寛容なライセンスです。ピーク時間帯の計算はDeepSeek V4.1 Flashの料金をご覧ください。
5. gpt-oss-120b
**こんな人におすすめ:**GPU 1枚でセルフホストする必要があるチームや、大きなモデルと比較するための安価なベースラインが欲しい人。
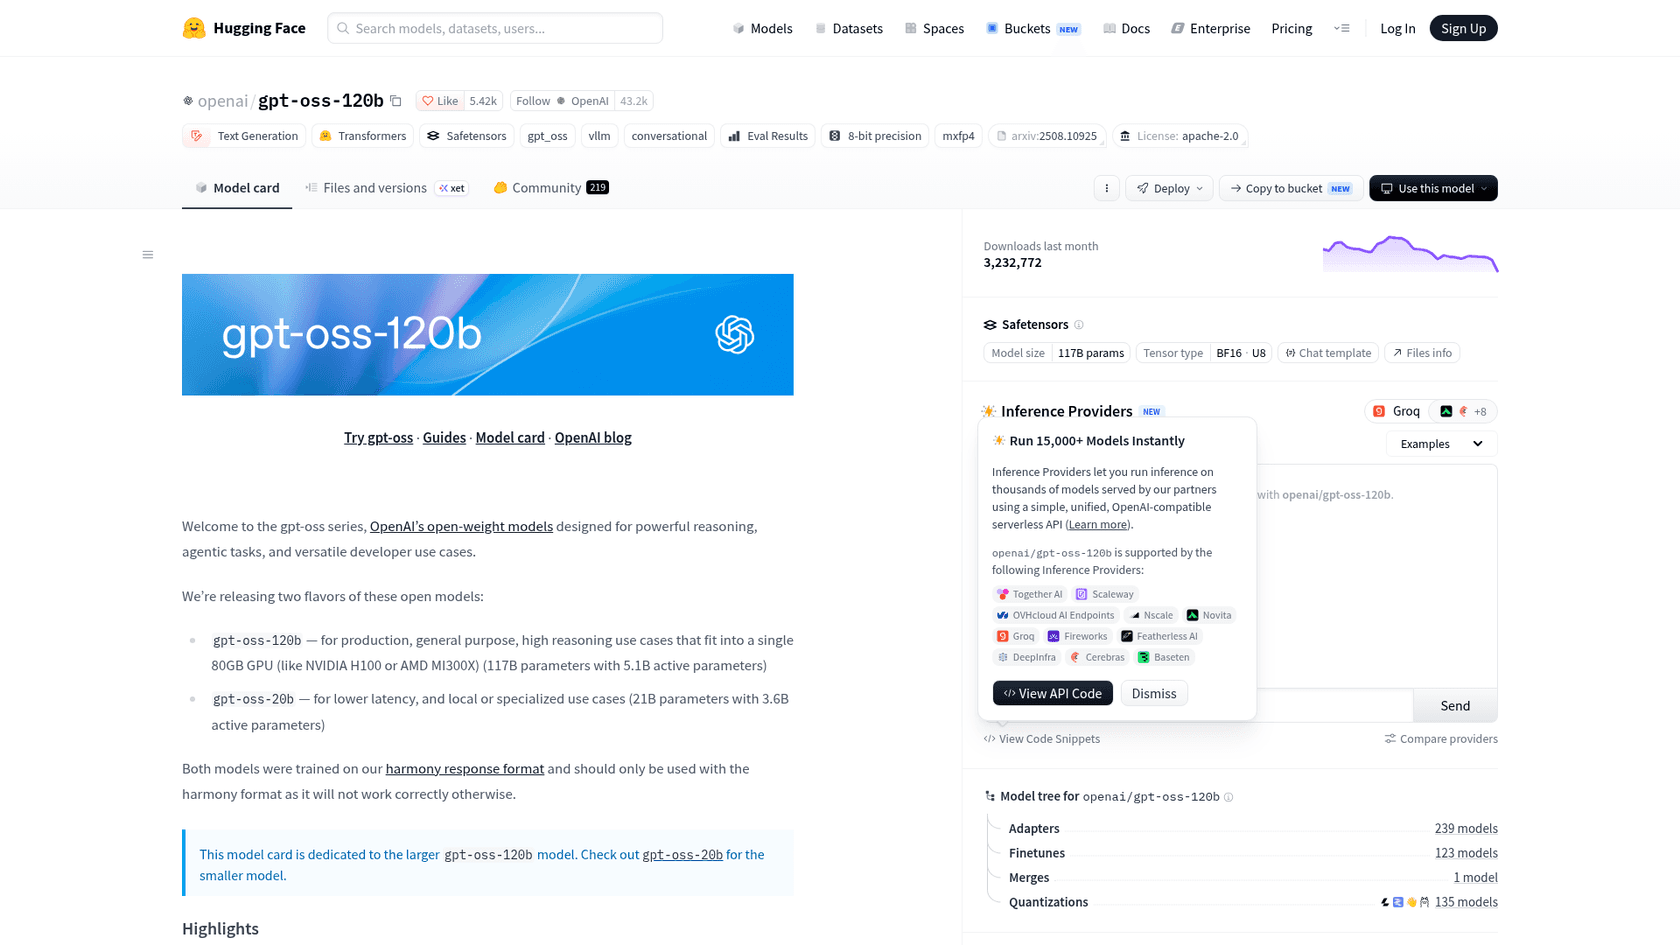
gpt-oss-120bは、2025年8月にOpenAIが出したオープンウェイトモデルです。総パラメータ117Bでトークンあたりのアクティブはわずか5.1B、量子化により、モデルカードの言う「on a single 80GB GPU (like NVIDIA H100 or AMD MI300X)」(NVIDIA H100やAMD MI300Xのような80GB GPU 1枚)で動きます。テキストのみで、128Kのコンテキストと、システムプロンプトで設定する3つの推論レベル(low、medium、high)があります。
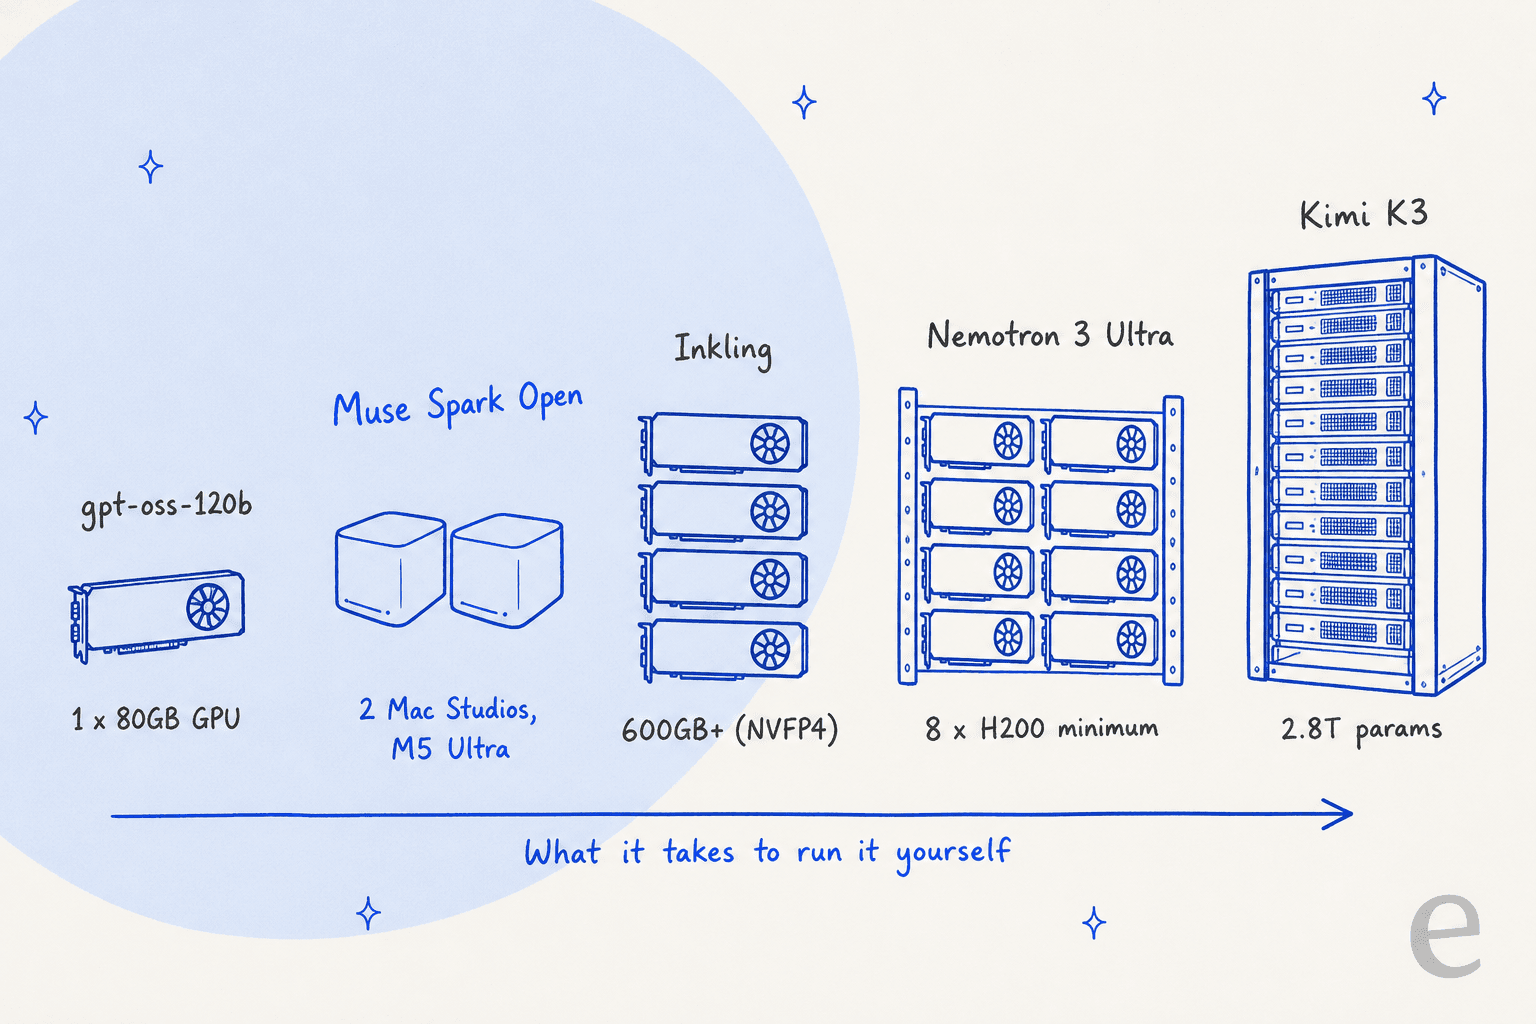
**Muse Spark Openに勝っている点。**ハードウェアとコストです。Appleによれば、Muse Spark Openは最大512GBのメモリを持つMac Studio 2台が必要ですが、gpt-oss-120bはカード1枚で済みます。小さなチームが自前のサーバーやプライベートクラウドのアカウントで現実的に動かせる、この一覧で唯一の代替です。
**足りない点。**リリースから14か月が経ち、OpenAIはそれ以降、新しいgpt-ossモデルを出していません。その後のリリースは安全性分類器です。Metaの比較表には含まれず、128Kのコンテキストは、Muse Spark Openの8分の1です。また、OpenAIのharmonyレスポンス形式でしか正しく動作せず、カードにも「will not work correctly otherwise」(そうでなければ正しく動作しません)とあります。
"The finding that flips the usual story is the sparse-MoE reversal: on gpt-oss-120b the A100 comes in cheaper per output token than the H100, because the workload is latency-tolerant and the MXFP4 experts fit in 80GB."
**価格とライセンス。**OpenAIは販売していないため、ホスト価格はプロバイダーによります。Together AIの料金ページでは、100万トークンあたり入力$0.15、出力$0.60で、DeepSeekのオフピーク料金と同じです。ライセンスはApache 2.0で、利用ポリシーは法律を守ることを求める1行だけです。
**評価:**gpt-oss-120bは、難しいエージェントタスクではMuse Spark Openに及びません。そうではないふりはしません。ただ、対照モデルとしては最適です。まずこれで評価を実行すれば、Muse Spark Openの余分なサイズをどれだけ使っているかが分かります。Together AIやGroqなどのホストが、どちらも提供しています。
6. Mistral Large 4
**こんな人におすすめ:**EUで学習し、EUでホストされるモデルを求め、ウェイトの公開をあと数週間待てる欧州のチーム。
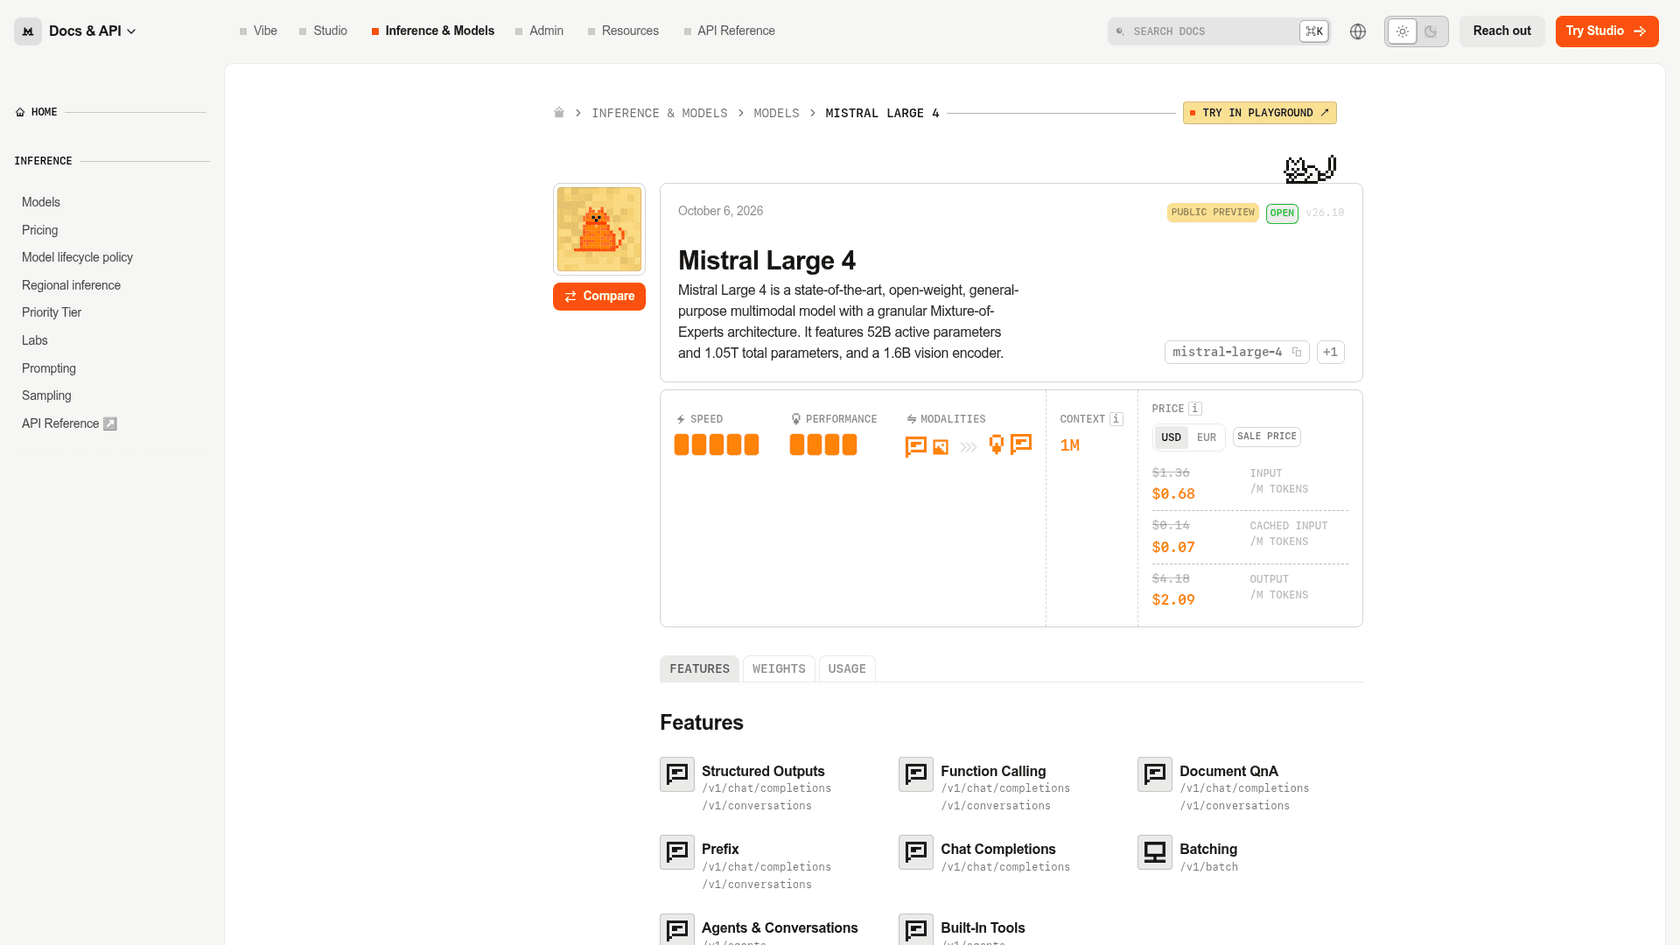
Mistral Large 4は、2026年10月6日にパブリックプレビューに入りました。モデルカードには、総パラメータ1.05T、アクティブ52B、1.6Bのビジョンエンコーダー、1Mのコンテキストと記載されています。ローンチ記事によれば、MistralはこれをNVIDIA Grace Blackwell GPU 3,800基を使い、自社の欧州データセンターで学習しました。
**Muse Spark Openに勝っている点。**価格と、欧州という要素です。Metaの表でのスコアは38とMuse Spark Openの1ポイント差で、セール中は出力価格が半分です。DeepSWE(62対60)、SWE-Atlas-QnA(59対58)、GDPVal-AA v2(1424対1401)でも僅差で上回っています。
**足りない点。**10月18日時点で、ウェイトは公開されていません。Hugging FaceにMistral Large 4のリポジトリはなく、ローンチ記事にも「we will release the weights by the end of the month」(月末までにウェイトを公開します)とあるままです。ライセンスも未発表なので、Apache 2.0だと決めつけないでください。Metaの表のAA-Omniscienceスコアは-5で、セットの中で唯一のマイナスであり、Muse Spark Openは25です。
"I created a brand new programming language to test LLM models on. It looks like Mistral Large 4 fares about as well as Kimi K3 and Claude Sonnet 5.5. Though it is much slower than Sonnet 5.5 and more expensive than both of those."
**価格とライセンス。**Mistralの料金ページでは、終了日未定の50%セールが行われており、100万トークンあたり入力$0.68、キャッシュ$0.07、出力$2.09です。定価は$1.36、$0.14、$4.18です。ライセンスは未発表です。
**評価:**EUでの学習とホスティングが要件なら悪くない選択で、セール価格は今日時点でMuse Spark Openを下回ります。ただし、まだオープンウェイトの代替ではありません。セルフホストの計画を立てる前に、10月31日以降にもう一度確認してください。セールの動向はMistral Large 4の料金の記事で追っています。
7. Nemotron 3 Ultra
**こんな人におすすめ:**寛容な米国のライセンスのもとで、ウェイトだけでなく学習データとレシピも必要なチーム。
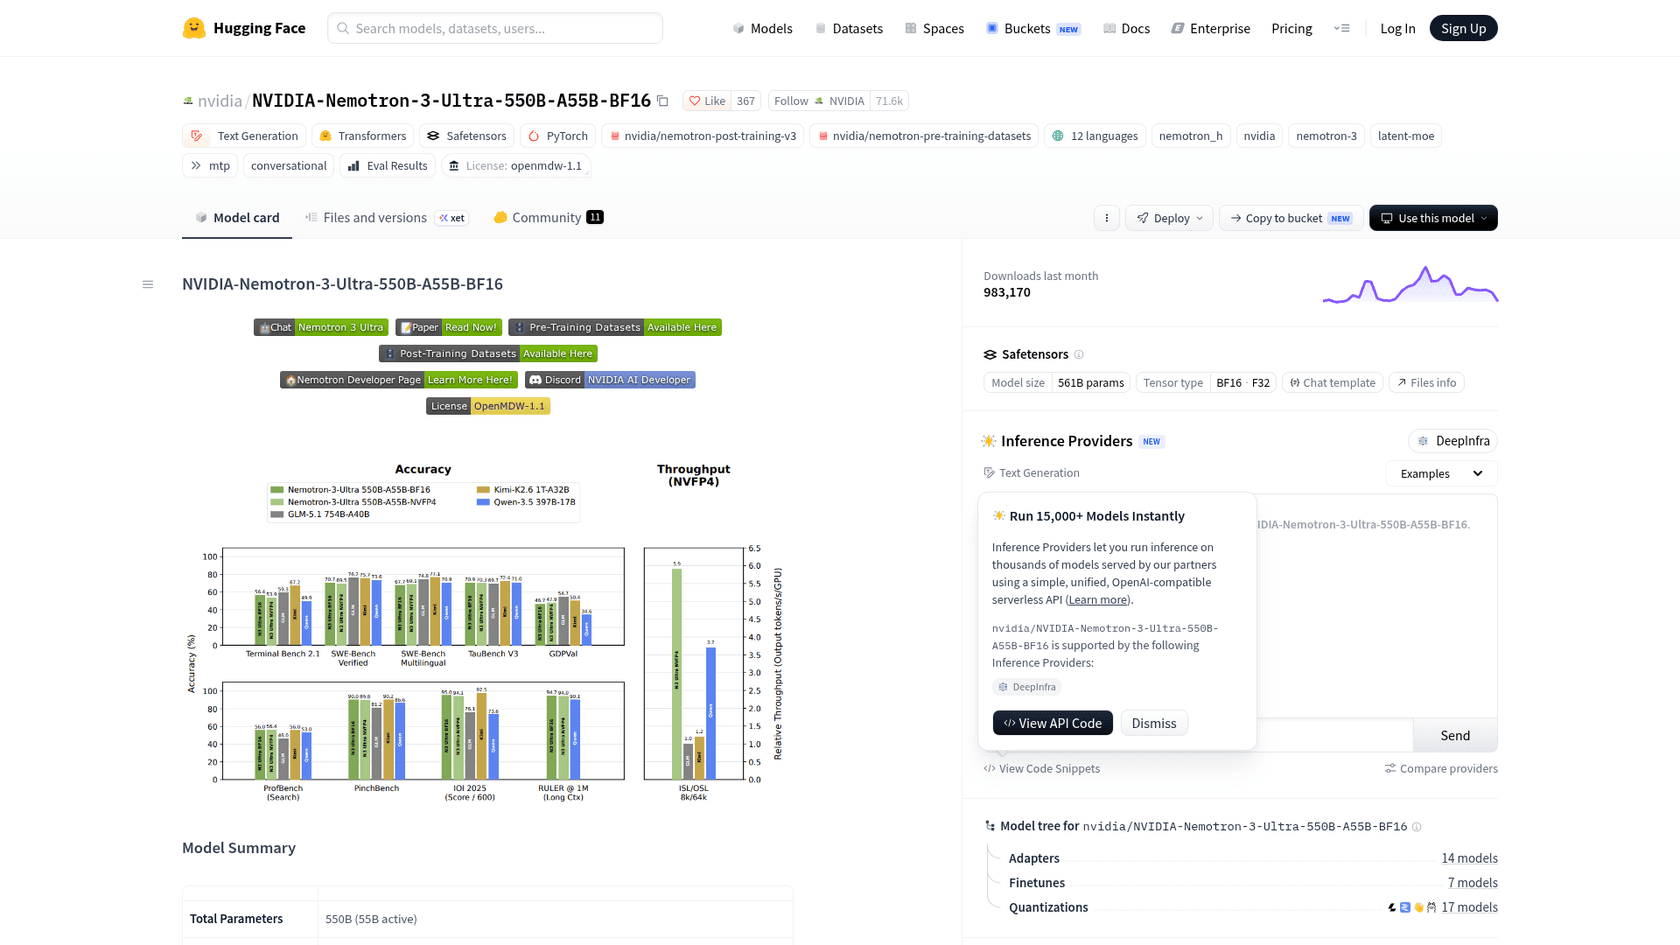
Nemotron 3 Ultraは、2026年6月4日にリリースされたNVIDIA最大のオープンモデルです。総パラメータ550B、アクティブ55Bで、Mamba-2レイヤー、アテンション、mixture-of-expertsを組み合わせたハイブリッドです。テキストのみで、推論はチャットテンプレートでオン・オフを切り替えます。
**Muse Spark Openに勝っている点。**オープン性です。NVIDIAは事前学習と事後学習のデータセット、RL環境、技術レポートを公開しています。モデルに何が入っているのかを監査人に説明する必要があるなら、この一覧でそれができるのはこのモデルだけです。ライセンスも軽くなっています。
**足りない点。**能力です。Metaの表でのスコアは23で、ここでは最も低く、両方が登場するすべてのベンチマークでMuse Spark Openに劣ります。MCP-Atlas(63.1対89.2)とTerminal-Bench 2.1(53.9対76.4)も含みます。カードには「up to 1M tokens」とありますが、出荷時の設定は262,144です。最小ハードウェアはH200 8基またはH100 16基です。
"Each of the Nemotron 3 models were briefly competitive when they launched, but never exceptional, and less competitive with each scale up. The fact that it took so long for Nemotron 3 Ultra to launch really hampered its competitiveness. The Nemotron 3 series is extremely open about training recipes and training data, far more open than most open weight models, and that is valuable."
**価格とライセンス。**NVIDIAのビルドページは、トークン単価なしのトライアルエンドポイントを提供しています。DeepInfraでは、100万トークンあたり入力$0.50、キャッシュ$0.10、出力$2.20です。ライセンスはOpenMDW-1.1で、再配布時にライセンスと表示を残すことが条件で、出力については「does not impose any restrictions or obligations」(いかなる制限も義務も課さない)とされています。
**評価:**Nemotron 3 Ultraは、より賢いモデルとしてではなく、透明性のために選んでください。法務や研究のチームが学習データを知る必要があるなら、これが明確な選択です。最良の回答だけが欲しいなら、違います。
8. Inkling
**こんな人におすすめ:**米国ラボのApache 2.0モデルを求める、音声とテキストの製品。
Inklingは、2026年7月15日にリリースされたThinking Machines Labの最初のモデルです。モデルカードによれば、975Bパラメータのmixture-of-expertsでアクティブ41B、1Mのコンテキストを持ち、テキスト、画像、16kHz音声を入力できます。より小さなInkling Small(276B、アクティブ12B)が7月30日に続きました。
**Muse Spark Openに勝っている点。**ライセンスの明快さです。ウェイトはApache 2.0で、製品ラベルも売上条項もありません。Thinking Machinesはホスト型のファインチューニングプラットフォームTinkerも運営しているため、自社データでのチューニングは週末の工作ではなく、サポートされた手段です。
**足りない点。**Metaの表でのスコアは26で、共通するすべてのベンチマークでMuse Spark Openが上回り、しばしば大差です(JobBench 61.8対31.1、MCP-Atlas 89.2対76.0)。また、ウェイトはApache 2.0ですが、Hugging Faceのカードは別の利用規定にリンクしており、ダウンロードした人すべてを拘束すると書かれています。重要な場面では、ユーザーにAIと話していることを伝えるよう求めており、ほとんどのサポートチームはすでにそうしています。
"Very nice, multi modal, largest open weight model that supports audio. Would be interesting to see how good the audio capability is."
**価格とライセンス。**価格は下がりました。Thinking Machinesのサーバーレス推論ベータでは、10月14日時点で、Inklingは100万トークンあたり入力$1.00、キャッシュ$0.17、出力$4.05で、「not yet recommended for intensive production use」(本格的な本番利用はまだ推奨されない)という注記があります。Together AIも同じ価格です。Inkling Smallは入力$0.30、出力$1.20です。
**評価:**Apache 2.0で音声入力が必要なら、Inklingです。Muse Spark Openも音声を扱い、はるかに高いスコアを出すので、決め手は「Built with Muse Spark Open」のラベルが自社の製品で許容できるかどうかです。さらに詳しくはInklingのレビューをご覧ください。
ライセンスの細則を並べて比較
多くの比較記事はベンチマークで終わります。オープンウェイトでは、そもそも出荷できるかどうかをライセンスが決めるので、すべての義務を1つの表にまとめます。
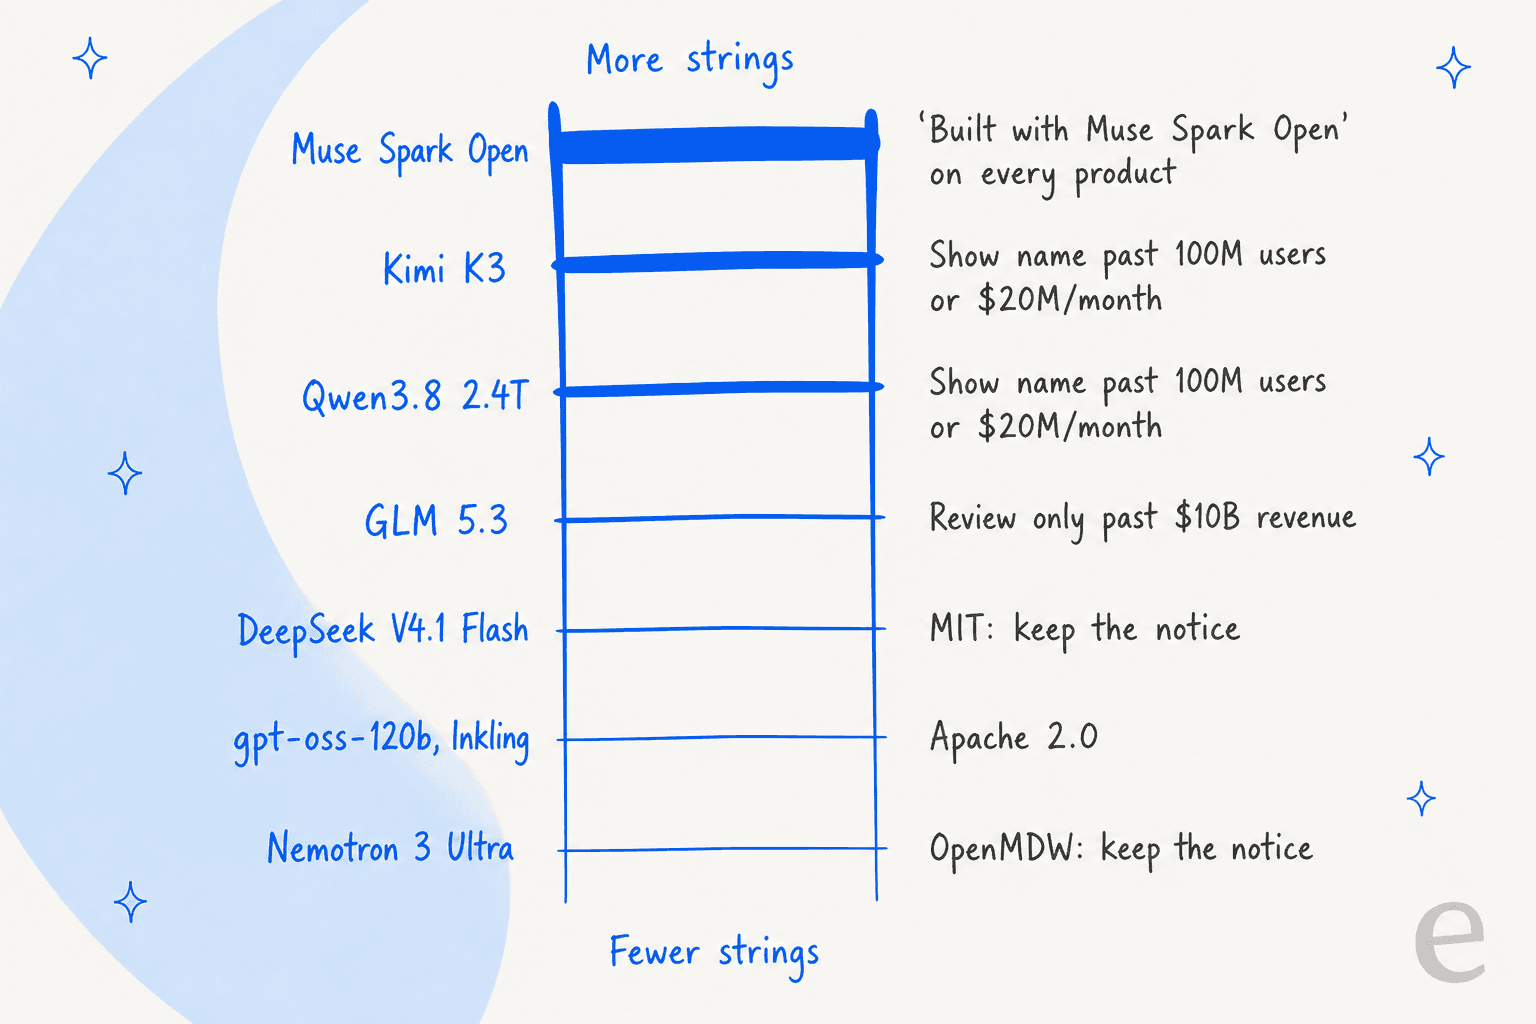
私にとって意外だったのは、Metaの表示ルールがいかに特殊かでした。Kimi K3とQwen3.8もモデル名の表示を求めますが、それは月間ユーザー1億人または月売上2,000万ドルを超えてからです。Muse Spark Openは、初日からすべての製品にラベルを求める、ここで唯一のモデルです。ホスティング条項はKimi K3に近く(年間2,000万ドル)、GLM 5.3はしきい値を100億ドルに置き、求めるのはセキュリティレビューだけです。
一般的な製品にとって、どれも致命的ではありません。ドキュメントや設定メニューに「Built with Muse Spark Open」の一文を入れれば、Metaの条項は満たせます。ただし、クライアント向けにホワイトラベルで提供する場合や、推論を再販売する場合は、選ぶ前に弁護士と一緒に条項を読んでください。
結局どう選ぶか
8つすべてを検討した上で、ほとんどのチームに私がおすすめするテストの順番は次のとおりです。
- GLM 5.3から始めて、直接の置き換えにします。価格帯は同じで、スコアは高く、ライセンスは軽くなります。
- DeepSeek V4.1 Flashを加えて、コストの確認をします。評価に合格すれば、請求額を約7分の1に削減できたことになります。
- gpt-oss-120bを加えて、下限を確認します。これにも合格するなら、その仕事に700B超のモデルは必要ないでしょう。
- Kimi K3は、ほかが失敗するコーディングやビジョンのタスクにだけ投入します。
- Muse Spark Openは、MCP-Atlasでのリードとジェイルブレイク耐性が重要なツール重視のエージェント、特にきれいに断る必要がある顧客向けのものに残します。
多くのチームが飛ばす手順は、評価そのものです。ベンチマークは平均値であり、皆さんのワークロードは平均ではありません。Fireworks AIやBasetenのようなホストで、実際のタスク100件を各候補に通し、同じ方法で採点してから決めてください。
モデルがカスタマーサポート向けなら、モデルは小さな判断です
2026年にオープンウェイトを検討している人の多くは、サポートボットのためにそうしています。全員に同じことを言います。モデルはインフラです。従業員は、その上に構築されたすべてです。
eeselは何年も実際のサポートキューでAIを運用してきましたが、最も痛かった失敗はモデル選びとは無関係でした。一部の有料顧客のボットが、ナレッジベースに関連する情報を見つけられないとき、モデルの一般的な学習データで穴を埋め、自信満々の間違った回答を実際の顧客に送っていたのです。より高スコアのモデルに替えても解決しません。解決するのは、ハードなフォールバック、自社ソースでのグラウンディング、公開前の実際のチケットでのテストです。だからeeselの導入は、誰かに回答する前に、必ず過去のチケットでシミュレーションされます。
ヘルプデスク向けにGLM 5.3とMuse Spark Openのどちらを選ぶか迷っているなら、もっと近道があります。eeselのAIヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgiasに接続し、過去のチケットとヘルプセンターから学び、公開前に先月のチケットにどう回答したかを見せてくれます。正直な制約が1つあります。eeselはOpenAI、Anthropic、Googleのホスト型フロンティアモデルで動いており(セキュリティページに記載)、これらのオープンウェイトでは動きません。モデルのセルフホストが必須要件なら、eeselは合いません。
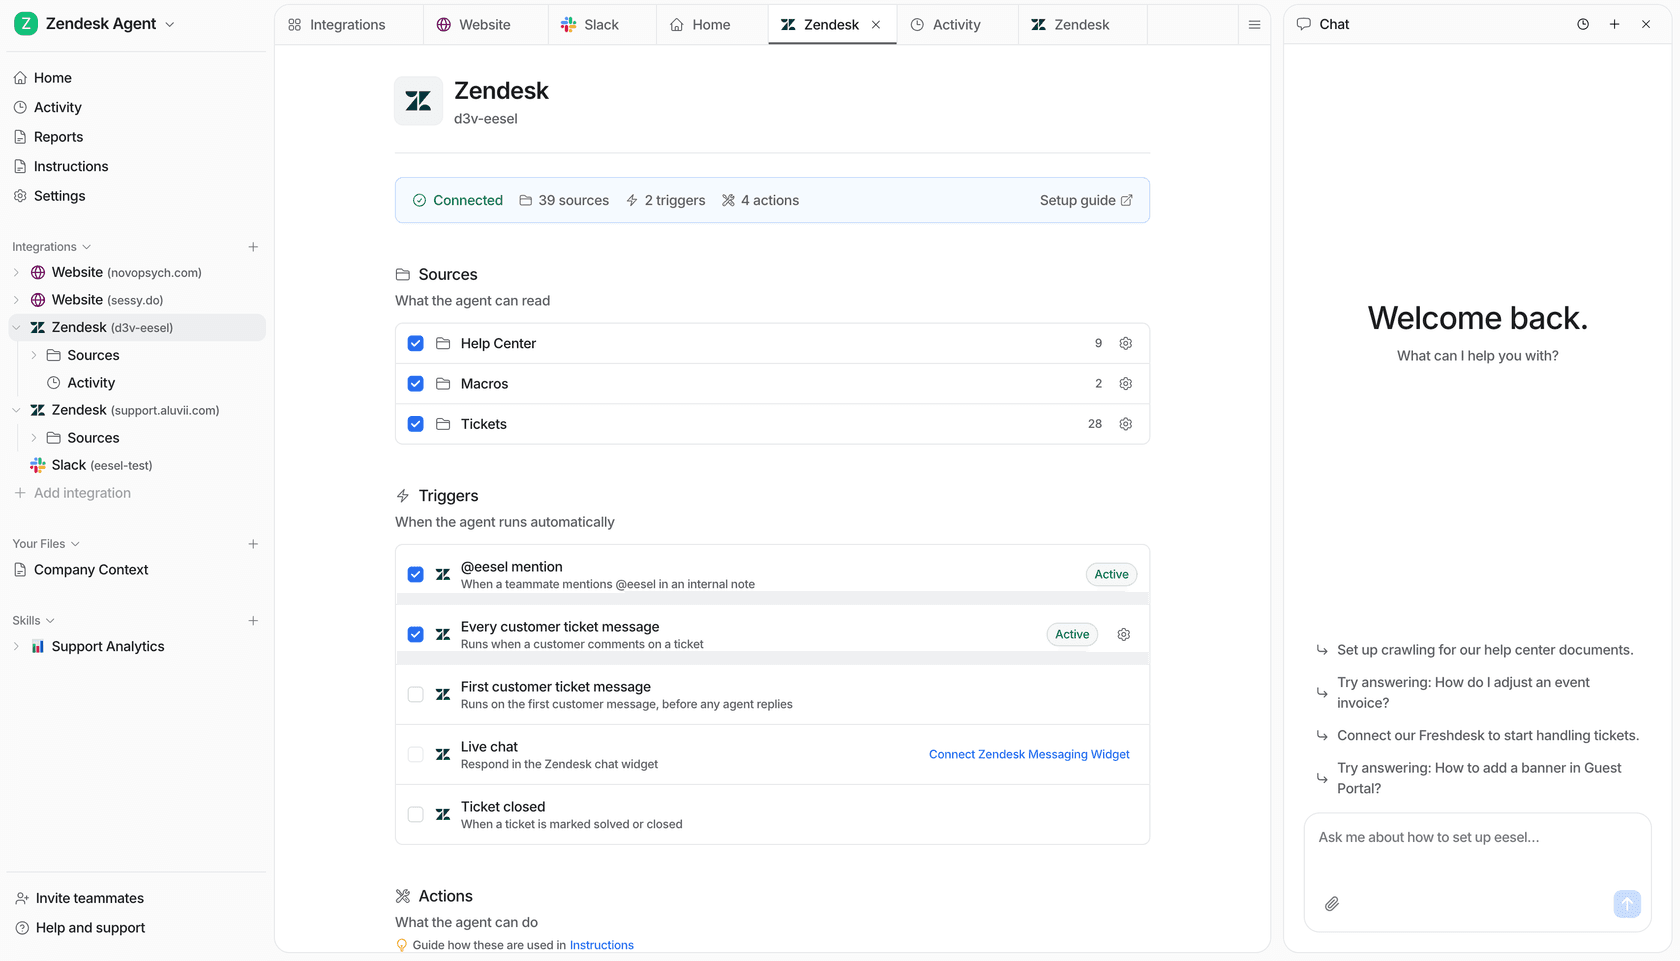
モデルのライセンスを比較するようなチームなら、コードからも操作したくなるでしょう。eesel CLI(npmの@eesel/cli)は、同じチームメイトとワークスペースをターミナルから動かします。eesel integrations connectでヘルプデスクを接続し、eesel instructionsで常設の指示を読み書きし、eesel approvalsで保留中のアクションを承認または拒否し、eesel activityで実行内容を確認できます。すべてのコマンドはJSONを出力し、書き込みコマンドは--dry-runに対応し、ヘッドレストークンはCIでも使えるので、スクリプトやClaude Codeのようなコーディングエージェントも、人間と同じように操作できます。すべてのワークスペースはMCPサーバーでもあり、カスタマーサポート向けMCPで解説しています。
また、オープンウェイトのプロジェクトがチケットではなくコンテンツに関するものなら、eeselのもう一つのチームメイトは、このような記事を調査し、下書きし、イラストまで付けるAIブログライターです。
eeselを試す
Muse Spark Open、GLM 5.3などは、エンジンです。本当に必要なのが顧客に回答するAIなら、eeselは、すでにヘルプセンターと過去のチケットを知っていて、既存のヘルプデスクに数分で参加し、実際のチケットに触れる前に先月のチケットで実力を証明するサポートチームメイトです。eeselを無料で試すか、チームがどう比較しているかを、私がまとめたベストAIカスタマーサポートエージェントの一覧でご覧ください。