

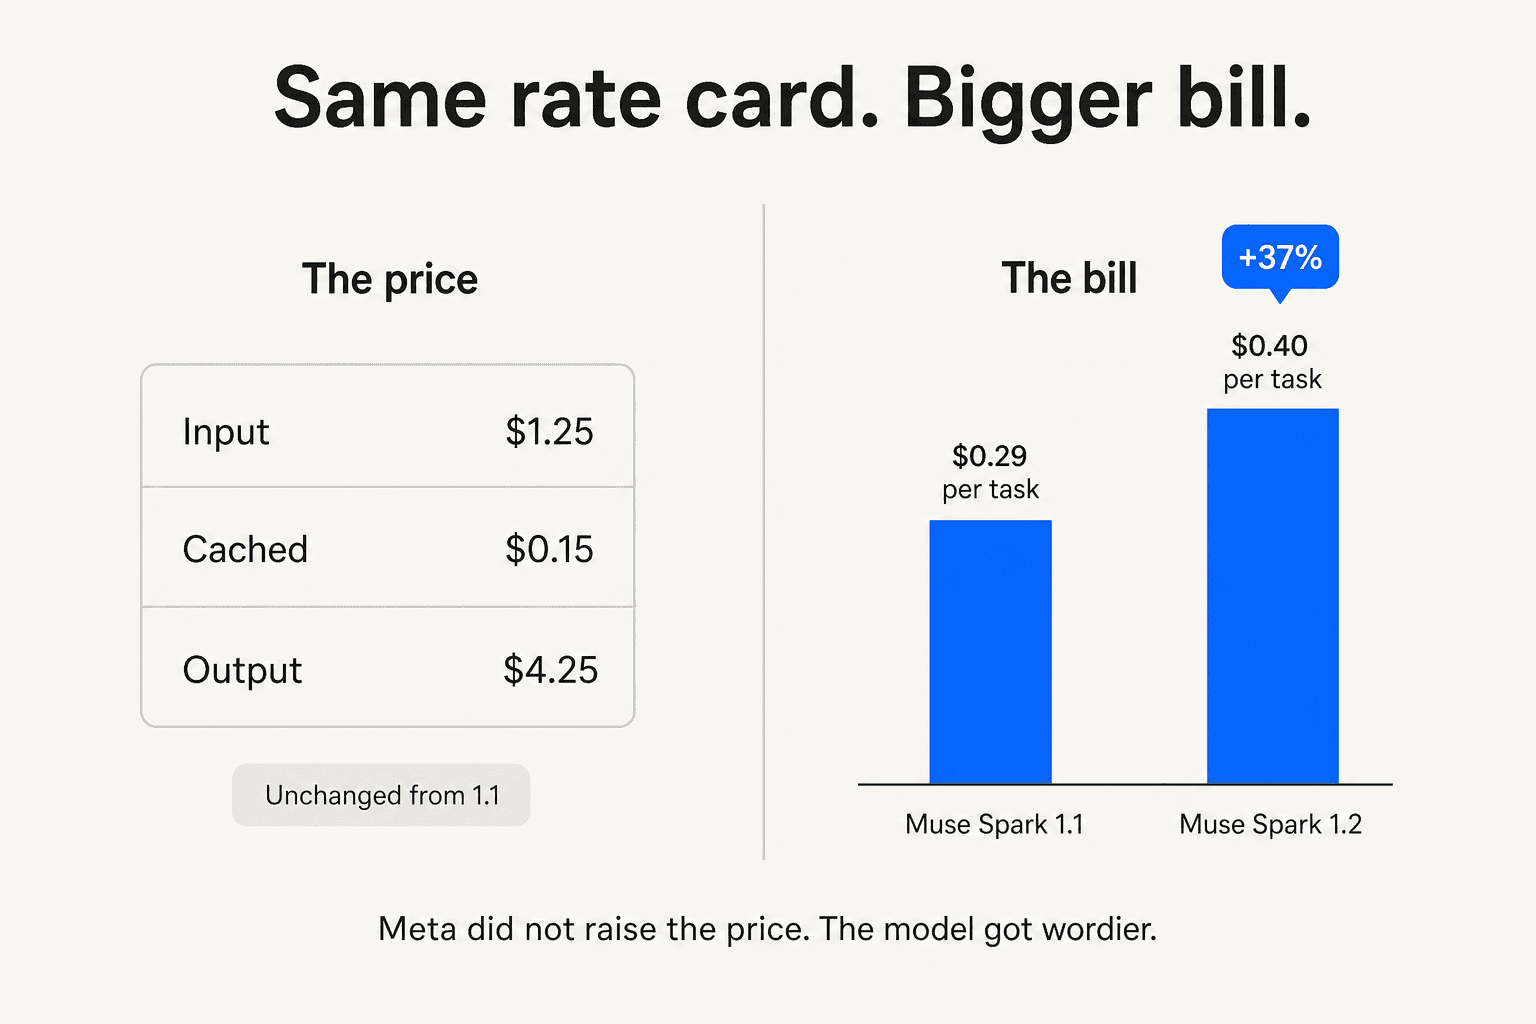
Metaは、Muse Sparkの料金表の数字を1つも変えていませんが、モデルの運用コストは37%上がりました。 標準ティアは入力100万トークンあたり$1.25、キャッシュ$0.15、出力$4.25で、1.1とまったく同じです。コントリビューターティアは、Metaにトラフィックでの学習を許可すれば$0.10 / $0.002 / $0.20です。しかしArtificial Analysisの測定では、ベンチマークタスクあたりのコストは1.1の$0.2923から1.2の$0.3992へ上がっており、その理由は誰もが想定していたものではありません。
推論は安くなりました。追加のお金はキャッシュ読み取りと回答そのものに使われ、回答はタスクあたり78%長くなっています。したがって注目すべき数字は、モデルがあなたの代わりにいくつのトークンを使うと決めるかであり、Metaの料金表はそれについて何も語っていません。
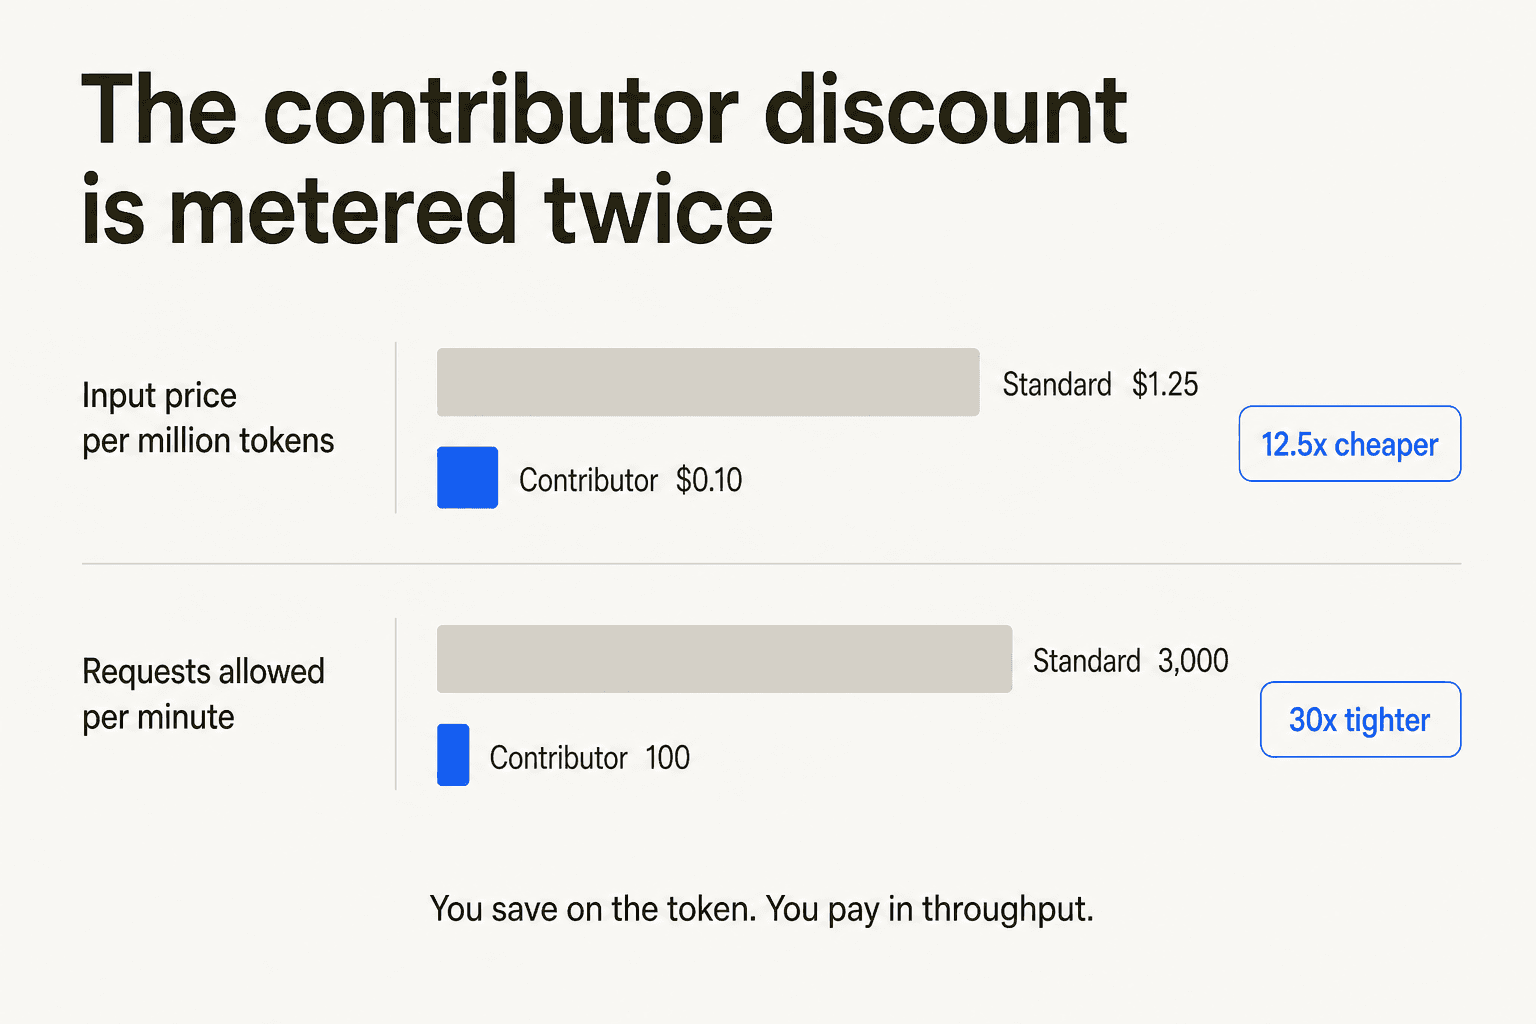
ティアを選ぶ前に確認すべきことが2つあります。コントリビューターの割引は二重に測られます。入力は12.5倍安くなる一方で、上限は1分あたり100リクエストと、標準の3,000に対して30倍厳しくなります。そして1.1にとどまっても何も節約できません。Metaは両方のチェックポイントを同じ価格にしているからです。
サイドプロジェクトではなくサポートキューの料金を見積もっているなら、正直な答えは、どのトークン料金表でもその請求額は予測できないということです。解決済みのチケット1件は、複数の呼び出し、検索、リトライで成り立っています。だからeeselは、長さに関係なくチケット1件につき1クレジットを請求し、本番投入の前に自社のチケット履歴でコストをシミュレーションできるようにしています。
Meta Muse Spark 1.2の料金、料金表の全体
公開されているすべての数字を、2026年8月17日にMeta自身のページで確認したものです。価格はすべて100万トークンあたりの米ドルです。
| モデルID | ティア | コンテキスト | 入力 | キャッシュ入力 | 出力 | Metaのデータポリシーの文言 |
|---|---|---|---|---|---|---|
muse-spark-1.2-contributor | コントリビューター | 1,048,576 | $0.10 | $0.002 | $0.20 | "Used to improve our products." |
muse-spark-1.2 | 標準 | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
muse-spark-1.1 | 標準 | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
3行目は、ほとんどの報道が見落としているところです。MetaのModel APIのページは前のチェックポイントをまったく同じ価格で掲載しており、料金ドキュメントも両方のチェックポイントが標準料金を共有していることを確認しています。戻れる安い旧世代のティアはありません。 1.2の挙動でコストが増えても、ダウングレードしてもお金は戻りません。これは、1.1が料金表で唯一のチェックポイントだった発売時のMuse Spark 1.1の料金の見え方とは違う点です。
料金表が隠していることに入る前に、いくつか率直に言っておくべきことがあります。
長いコンテキストのプレミアムはありません。 Metaは料金とレート制限のページではっきり述べています。ウィンドウがほぼ空でもほぼ満杯でも、支払う額は同じです。コンテキストのしきい値を超えると価格を引き上げるプロバイダーは複数あり、毎回の呼び出しに大きく安定したプレフィックスを詰め込むなら、その差はすぐに積み上がります。
プロンプトキャッシュは自動で、有効化も無料です。 Metaのプレフィックスキャッシュには"no flag or key to manage"とあり、料金表にキャッシュ書き込み料金はなく、キャッシュされたトークンは追加料金ではなく入力の割引された一部です。prompt_cache_retention: "24h"で保持期間の延長を依頼できますが、Metaはそれを保証ではなくヒントと呼んでいます。
そしてMeta自身の足場は無料です。ドキュメントによると、Metaはすべてのプロンプトに少量の誘導用コンテキストを挿入し、そのトークンは"are not billed and are excluded from the token counts reported in your usage."とされています。ささやかな配慮ですが、他社の請求書ではひっそり載ってくる類のものです。
料金表は動かなかった。請求は37%上がった。
これがMuse Spark 1.2の料金について書くのを奇妙にしている点です。Metaは8月5日に新しいモデルを出し、価格は据え置いたのに、同じ作業のコストは3分の1以上上がりました。
Artificial Analysisはすべてのフロンティアモデルに同じ9つの評価スイートを実行するため、バージョン間の比較は公開データとしてはできる限り統制されています。コストの測り方は2つ公開されており、両者は連動しないので分けて考える価値があります。
タスクあたりの加重コストは、1.1の$0.2923から1.2の$0.3992へ、36.6%上がりました。スイート全体を1回実行する合計は、$547.32から$639.27へ、$91.96、つまり16.8%上がりました。前者は特定の作業にいくらかかるかを予測する数字で、私が先に挙げる理由です。後者はお金がどこへ行ったかを示す数字で、次のセクションで内訳を見ます。
この37%が何であり、何でないかは慎重に言っておきたいところです。これはベンチマークのワークロードであり、あなたのワークロードではありません。しかし、両バージョンで同じベンチマークを同じ料金表で見積もっているので、1つの問いに対する明快な答えになります。このモデルは1単位の作業にどれだけ多く使うのか? 3分の1以上多く、無料で、誰も価格変更を告知しないまま。
これはチームが繰り返しはまる失敗パターンで、Meta特有のことではありません。ある見込み客は、私との通話中に自分で計算し、15万件のチケットへ向けて拡大する企業で月およそ$30,000という結果にたどり着きましたが、混乱の原因はすべて、彼が数えていた単位と課金される単位のずれにありました。別の人は、1日およそ500件のチケットを1件あたり4往復で処理しているのに、月3,000インタラクションの枠を提示され、その枠は1日半で尽きます。どちらも計算が苦手だったわけではありません。どちらの場合も、「私が数えるもの」と「あなたが請求するもの」の間の倍率が、請求書が届くまで見えなかったのです。Muse Sparkの料金表はまさにこの形をしています。
追加の$92は実際にどこへ行ったのか
私自身の以前のMuse Spark 1.2の解説を含め、ほとんどの人が、コスト増は考える量が増えたせいだと想定していました。推論モデルはより懸命に推論することで高くなりますし、1.2はより賢いチェックポイントとして売り出されました。無理のない推測です。
しかし、それは間違いで、公開されているコスト内訳がそう示しています。
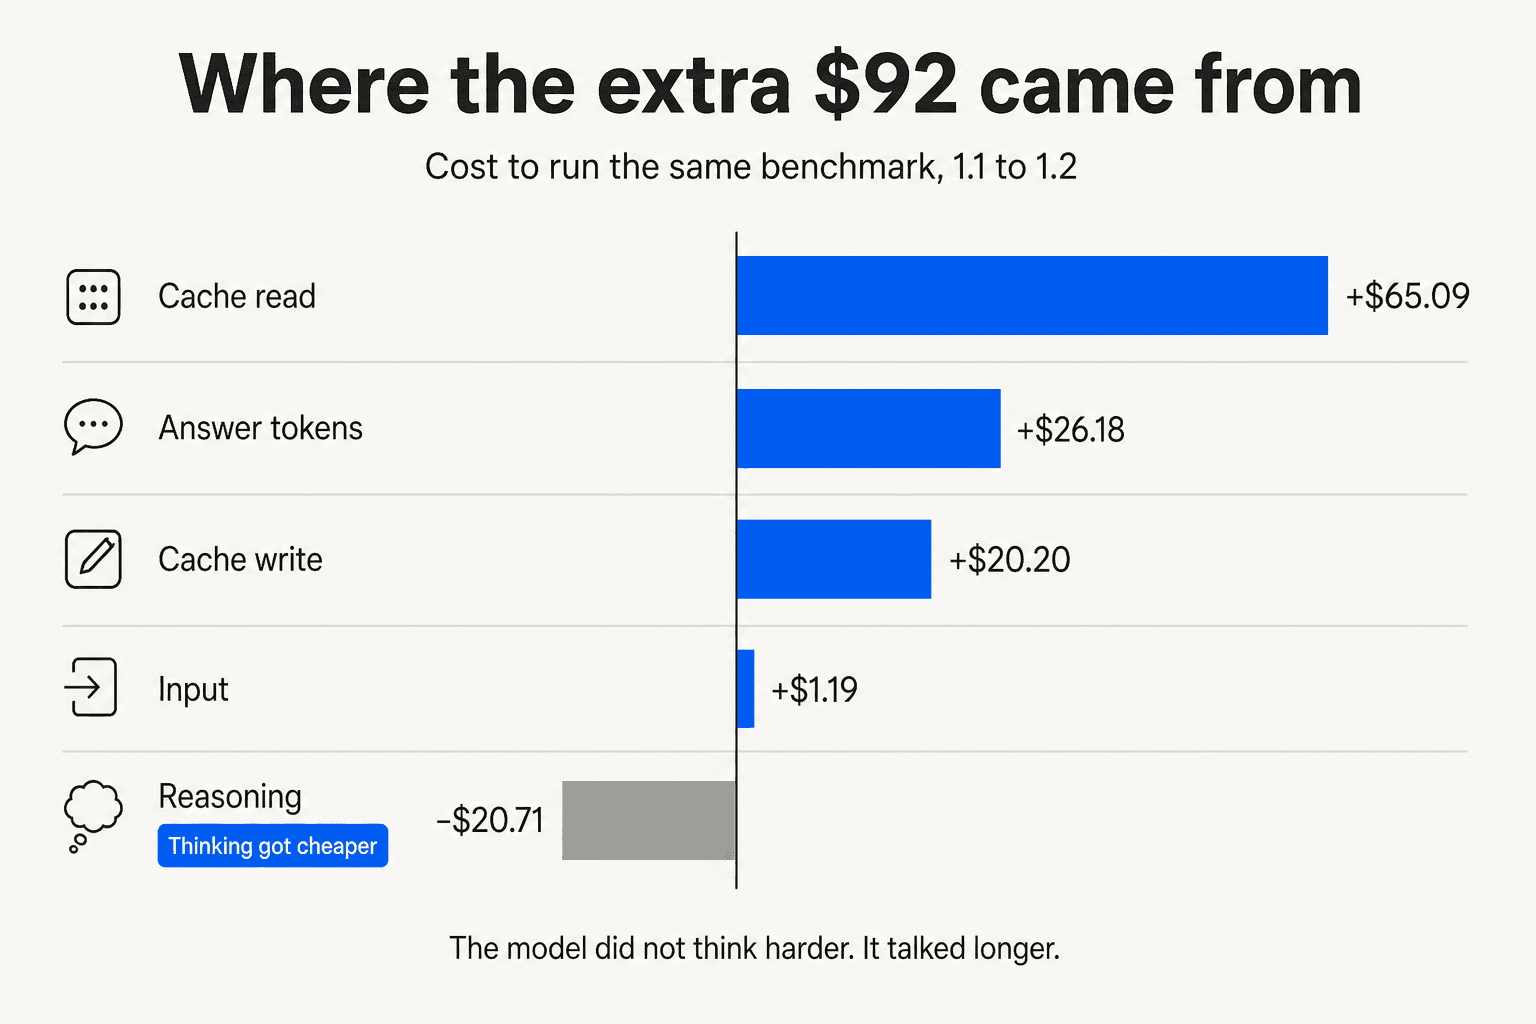
| トークンの種類 | Muse Spark 1.2 | Muse Spark 1.1 | 変化 |
|---|---|---|---|
| 推論 | $339.82 | $360.53 | -$20.71 |
| キャッシュ読み取り | $136.85 | $71.76 | +$65.09 |
| キャッシュ書き込み | $82.21 | $62.01 | +$20.20 |
| 回答(出力) | $63.61 | $37.42 | +$26.18 |
| キャッシュなし入力 | $16.78 | $15.59 | +$1.19 |
| 合計 | $639.27 | $547.32 | +$91.96 |
推論は、安くなった唯一の行です。 1.2は非表示の思考トークンに、1.1より$20.71少なく使いました。増加はそれ以外のすべてから生じており、キャッシュ読み取りがほぼ倍増して最大の要因です。
タスクあたりのトークン数がその理由を説明します。タスクあたりの回答トークンは7,237から12,874へ、78%増えました。タスクあたりの推論トークンは15,158から17,557へ、16%しか増えていません。その間、指数全体はどちらもほぼ同じ総出力予算で実行されており、9,500万トークン対9,400万トークンでした。
実用的に言い換えるとこうです。Muse Spark 1.2は1.1より懸命に考えているのではなく、長く書いているのです。 ワークロードが複数ターンにわたってAIエージェントを動かしているなら、冗長な回答は次の呼び出しのコンテキストにそのまま戻り、それがキャッシュ読み取りの行を倍増させたまさにその仕組みです。冗長さは、純粋な思考にはない形で積み上がります。
これは実際に回せるつまみです。短い回答を求め、出力トークンに上限を設け、プロンプトチェーンのうち過去の回答を持ち越している部分を削ります。これは普通のLLM最適化で、Anthropic APIの料金を予測可能に保つのと同じ規律であり、出力の長さを見ない人をOpenAI APIが驚かせるのと同じ理由です。
コントリビューターティアは12.5倍安く、30倍厳しい
2段階の価格構造は、Muse Sparkについて誰もが引用する点ですが、たいていは間違って引用されます。割引率が入力と出力で違うからです。入力は12.5倍安くなります。出力は21.25倍。キャッシュ入力は75倍です。
Metaの表現は異例なほど率直です。ドキュメントは、コントリビューターを、あなたのプロンプトと出力で将来のモデルを学習させる"permission"と引き換えの"heavily discounted token pricing"と説明し、"prototyping, testing integrations, and scaling experiments where training on your data is acceptable."向けだとしています。そしてティアはアカウントで切り替える設定ではありません。Metaの言葉では"Tier is a model attribute"です。学習から外れるには、別のモデルIDを呼び出します。
発売当日のHacker Newsのスレッドは、この取引が公平かどうかをめぐるものがほとんどで、意見は鋭く割れました。
"What are you talking about? This is one of the most honest offers ever made by a corporation. "We'll use your data, and we'll compensate you for it." Where is the problem?"

標準ティアの約束がプレミアムに見合うと誰もが考えたわけではありません。あるコメント投稿者が、請求書に関係なくMetaはすべてで学習していると主張したとき、Simon Willisonは反論し、その非難が実際に意味すること、つまり企業が2つのデータポリシーを掲げてその一方を承知のうえで破るということを、皮肉を込めて描きました。契約上の違いこそが製品です。
しかし、誰も議論していなかった論点こそ、本番予算にとって最も重要です。公開されている制限は次のとおりです。
| ティア | 1分あたりリクエスト数 | 1分あたりトークン数 |
|---|---|---|
| 標準 | 3,000 | 4,000,000 |
| コントリビューター | 100 | 3,000,000 |
コントリビューターティアは、入力トークンあたり12.5倍安く、1分あたりのリクエスト数は30倍少なくなります。 トークン上限は25%しか下がらないので、絞り方は意図的に不均一です。Metaは特にリクエストの経路を絞りました。コントリビューターは量に合わせて価格がつけられ、プロトタイピング向けに制限されています。筋の通った製品判断ですが、その上に作ってから気づくと痛い不意打ちになります。
あるXのユーザーはこれに直接ぶつかり、5語で言い切りました。1分あたりのリクエスト数は"seem to be severely limited"。検証可能なプラットフォームで私が見つけられた具体的なレート制限の報告はこれだけで、コントリビューターを趣味の負荷以上に使った人がいかに少ないかを示しています。
これらの数字で計画を立てる前に、知っておくべき仕組みがあと2つあります。制限はAPIキー単位ではなくチーム単位でまとめて適用されるため、キーを増やしても余裕は増えません。そしてバックグラウンドレスポンスには、RPMとTPMに加えて、チームあたり1分600件の送信という別の上限があります。
実際にどのティアを使えるかを確認する
価格は2番目の問いです。1番目はスループットです。上限があなたの下限より低ければ、どんな割引も役に立ちません。ここで数字を設定すれば、答えが出ます。
トークンメーターの隣にあるメーター
トークン料金は見出しですが、請求書のすべてではありません。ほかに4つのものが課金または制限の対象になります。
Web検索グラウンディングは別に計測されます。 1,000検索クエリあたり$2.50で、リクエストのトークンに上乗せして課金されます。エージェントがすべての回答を検索で裏付けるなら、1つ目と並行して2つ目のメーターが回ることになり、モデルのページをもとに作った表計算で最も抜け落ちやすいのがこれです。
バッチAPIもバッチ割引もありません。 ドキュメントのナビゲーションにバッチ関連の画面は一切ありません。唯一の非同期経路はバックグラウンドレスポンスで、これは割引ティアではなく、独自の上限を持つ送信モードです。他のプロバイダーが公開しているバッチ割引を前提に計画していたなら、その節約はここには存在しません。
Muse Sparkにはファインチューニングの提供もありません。モデルのドキュメントには推論用のモデルIDが3つ載っているだけです。Metaの開発者サイトでのファインチューニングはLlamaのウェイトの領域で、コスト構造の異なる別の製品です。
厳格な支出上限もありません。 これこそが、人々が実際に登録をやめた不満です。2人の別々のHacker Newsユーザーが、同じ日に同じことを述べました。
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
これは料金ではなく請求UXの欠落で、1日の午後で直せますが、安いトークンが売りのモデルで、コンバージョンを妨げているのが上限がないことだという点は知っておく価値があります。
Muse Spark 1.2の料金は他と比べてどうか
定価は両方向に実態を美化し、誤解させるので、重要なのは固定のベンチマークで測ったタスクあたりの実測コストの列です。Artificial Analysisのリーダーボードの数字を使い、Muse Sparkを実際に競合するモデルと並べます。
| モデル | Intelligence Index | タスクあたりコスト | ブレンド$/Mtok | 入力 | 出力 |
|---|---|---|---|---|---|
| Claude Opus 5 (max) | 63.05 | $2.34 | $3.85 | $5.00 | $25.00 |
| GPT-5.6 Sol (max) | 60.93 | $1.23 | $4.35 | n/a | n/a |
| Kimi K3 (max) | 59.70 | $0.84 | $2.31 | $3.00 | $15.00 |
| Qwen3.8 Max | 58.08 | $1.13 | $1.18 | $2.00 | $6.00 |
| Muse Spark 1.2 (xhigh) | 56.76 | $0.40 | $0.78 | $1.25 | $4.25 |
| GPT-5.6 Terra (max) | 56.58 | $0.51 | $1.74 | n/a | n/a |
| Gemini 3.7 Flash (high) | 56.03 | $0.40 | $0.58 | $0.75 | $3.75 |
| GPT-5.6 Luna (max) | 52.32 | $0.05 | $0.17 | n/a | n/a |
| DeepSeek V4 Flash (max) | 51.77 | $0.11 | $0.23 | $0.44 | $1.32 |
買い手側の読み方は明快で、Metaにとって良いニュースです。Muse Spark 1.2は、この表でスコアが56を超えるモデルの中で最も安いモデルです。 それより賢いものは、すべてタスクあたり少なくとも2.8倍高くなります。Opus 5は5.9倍です。最も近い同等の比較はGPT-5.6 Terraで、スコアはほぼ同じで、コストはMuse Sparkの$0.40に対して$0.51ですから、同じ知能でMetaは22%安いことになります。
投稿をまたいだ比較でつまずきやすいので、1点訂正しておきます。Artificial Analysisはこれらのページで、広く流通している以前の入力対出力3:1の比率ではなく、キャッシュヒット、入力、出力を7:2:1でブレンドしています。計算も合います。(0.7 × $0.15) + (0.2 × $1.25) + (0.1 × $4.25) = $0.78。3:1を前提に引用されたブレンド値を見かけたら、この表とは比較できません。
そしてGPT-5.6 Lunaは、安いは弱いという単純な話を壊す行です。タスクあたり$0.05で、Muse Sparkの8分の1、インデックスは52.3です。そこに至るために何を手放しているかは、GPT-5.6 Lunaの記事で扱っています。
Muse Sparkのすぐ上の行については、Kimi K3の料金に料金表の全体があります。表の安い側にあるオープンウェイトの選択肢は、DeepSeek V4 Flashのレビューにあります。
料金表が触れていないこと
料金の記事は、数字と同じくらい空白部分についても明確であるべきです。予算が狂うのは空白のところだからです。
1.2の速度とレイテンシは未公開です。 Artificial Analysisには、このチェックポイントの出力速度、最初のトークンまでの時間、エンドツーエンドの応答時間の測定がなく、リーダーボードでは3列すべてがダッシュです。Muse Spark 1.1にはあり、毎秒225.9トークン、最初のトークンまで1.38秒ですが、それは古いチェックポイントのものであり、1.2のものと見なすべきではありません。応答時間があなたのコスト判断に含まれるなら、まだ存在しないデータを待っていることになります。
ゼロデータ保持のプログラムはありません。 ドキュメントのナビゲーションをすべて確認しましたが、セルフサービスでも営業経由でも、データ保持、プライバシー、ZDRに関するページは見つかりませんでした。最も近い制御はレスポンス保存のフラグで、Responses APIでstore: falseにするとGET /v1/responses/{id}があなたのレスポンスを返さなくなりますが、Metaは"does not disable caching."と明言しています。データに関するレバーはティアだけです。
APIはまだパブリックプレビューです。 Metaの製品ページは現在"Public preview. Now available with expanded global access"で始まっており、発売時の地域限定という表現よりは良くなりましたが、プレビューはプレビューです。プレビューの画面での料金と制限は、一般提供の料金表とは違い、変更される可能性があります。
そして、安いティアを試すなら意味のある小さな点がもう1つあります。アクセスは取り上げられることがあります。ある開発者は、作業の途中で事前の警告なしに403を受け、"Your access has been restricted due to repeated policy violations"と表示されたと投稿しました。コントリビューターは、キャンペーンのように値付けされ、キャンペーンのように制限されています。
ある開発者が実際に支払った額
ここまでは定価とベンチマークの実行結果です。私が見つけた最も有用なデータポイントは、実際のセッションコストを報告している人のもので、本来あるべきより珍しいものです。
"even with this subsidized pricing, less than an hour of usage resulted in slightly over $1 of cost (fig. 1). if i do this all month it'll be more expensive than the highest Anthropic/OpenAI subscription"
これは安いほうのコントリビューターティアでの話で、発売当日に不当に安いと言われていたものです。エージェント型のコーディング作業1時間が、入力100万トークンあたり$0.10で1ドルを超えました。
同じ指摘は、発売から1日以内に、領収書ではなく警告という形でLinkedInの実務家からも出ていました。
"But token price isn't the full picture. What matters is cost per task. Different models burn different amounts of tokens to solve the same problem. We don't have that data yet for Muse Spark 1.2. Cheap tokens mean nothing if the model takes twice as many shots to get there."

彼はタスクあたりコストのデータが出る前にこれを書きました。データが出てきて彼の正しさが示されましたが、誰も予想しなかった方向でした。1.2は前世代より長く答えることでより多くのトークンを使い、考える部分はわずかに安くなったのです。
サポートキューにとってトークンが間違った単位である理由
私はeeselで3年間、AIがライブのサポートキューを処理するのを見てきましたが、その間、トークン料金表からサポートの請求額を予測できたチームを一度も見たことがありません。計算自体は簡単です。ただ、その単位が実際のチケットに触れると成り立たないのです。
解決済みのチケット1件は、プロンプト1回ではありません。ヘルプセンターとマクロライブラリをまたぐ検索、チケット分類の処理、下書きの処理、最初の下書きが間違っていたときのたいていのリトライ、ときには注文を確認するツール呼び出し、そして顧客が返信するたびに会話全体がコンテキストとして持ち越されます。これらの各ステップが掛け算になります。トークンあたりの安い料金に、不明なステップ数を掛けても、予算にはならず、期待になるだけです。どのモデルを選ぶかは、この構造よりはるかに重要度が低く、これはサポートチケットに最適なモデルを選んだときに論じたとおりです。
しかも、これがうまくいかない様子は実際の数字で見られます。サポートチームは日常的にある倍率で過小評価し、最も痛い目を見るのは最も量の多いチームです。倍率が積み上がるからです。これはMuse Spark 1.2の話と同じ構造的な罠です。料金は動かず、消費が動いた。 チームが最終的に何を支払うかの全体像は、AIカスタマーサービスのコストの解説にあります。
だからeeselは、トークン単位や席単位ではなく、長さに関係なくチケット1件につき1クレジットを請求しており、これはトークン料金表を手にやって来る人に最初に伝えることです。解決は、ビジネスがすでに数えている単位で、サポートリーダーが予算会議で説明できるものに対応し、モデルが長い回答を書き始めても黙って値上がりしません。同じ論点が、私の解決あたりのコストの考え方の背後にもあります。
メーターがモデルではなくチケットシステムに置かれるべき理由であり、サポートリーダーにとって正直な比較対象がAPIではなく人である理由でもあります。そのことは、AIと人間のエージェントのコストで検討しました。
もう半分は、コミットする前にその数字を知ることです。私はすべての導入を、まず顧客自身の過去のチケットでシミュレーションし、ベンチマークではなく実際のトラフィックでの解決率とコストを出します。その習慣は、自信ありげなボットが本番で静かに誤った答えを返すのを見てきたことから来ており、それはAIのハルシネーション防止で扱っている独立した規律ですが、結果として予測の問題も解決します。それについては構築か購入かのガイドにさらに詳しく書いており、料金表を読んでいる人の大半が実際に下そうとしている判断を扱っています。
eeselを試す
生のモデルAPIの上にサポート自動化を構築する予定があってMuse Spark 1.2を見積もっているなら、トークン料金はそのプロジェクトで最も面白くない数字です。eeselはヘルプデスクの上で動き、既存のナレッジベースと過去のチケットを読み、数分で第一線の会話の解決を始め、チケット1件につき1クレジットなので、請求は消費したトークンではなく行った仕事に連動します。
最初に試す価値があるのはシミュレーションです。チケット履歴に向けると、顧客に何かが届く前に、ご自身のトラフィックでの解決率と予測コストが得られます。トークン料金表には構造上出せない予測です。

まさにこの判断を経たエンジニアリングリードが、その理由を平易に語りました。匿名ですが、彼はConfluenceとTelegramに300本以上の記事のナレッジベースを持つ、ビットコインATMのハードウェア企業を運営しています。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
無料で試せて、何かを決める前にシミュレーション結果の数字を確認できます。
Muse Spark 1.2の料金についての結論
入力$1.25、出力$4.25のMuse Spark 1.2は、インテリジェンスインデックスで56を超えるフロンティアの表の中で最もお得で、Metaは、アップグレードで価格を改定しなかったこと、長いコンテキストに追加料金を課さなかったこと、キャッシュを設定作業ではなく自動にしたことで評価されるべきです。
計画に織り込むべきなのは、価格が変わらないままモデルの運用コストが37%上がったことで、それは1.1より78%長く答えるからです。出力トークンに上限を設け、プロンプトチェーンが何を持ち越しているかを見て、コントリビューターティアが使えると思い込む前に、ピーク時の1分あたりリクエスト数を確認してください。
そしてワークロードがサポートキューなら、解決数で価格を見積もってください。それが、実際の請求書を乗り越えてきた唯一の単位です。