

Metaが10月15日に実際に公開したもの
Metaのリサーチブログは、Muse Spark Openを「これまでで最も高性能な米国製オープンウェイトモデル」と呼び、コーディングとエージェント用途向けに作られたとしています。PyTorchチームの投稿は最も重要な点を補足しています。「Muse Spark 1.3と同じベースモデルを共有」しており、「システムのガードレールなしの単体モデルとして」耐えられるよう、追加の安全性ポストトレーニングが施されています。2026年の大半を通じてMuse Sparkをクローズドに保ってきた会社にとって、これは大きな転換です。
Hugging Faceのモデルカードに記載されている仕様は次のとおりです。
| 仕様 | Muse Spark Open |
|---|---|
| 公開日 | 2026年10月15日 |
| パラメータ数 | 合計816B、トークンあたり42Bが有効 |
| アーキテクチャ | Mixture-of-experts、エキスパート256個、トークンあたり8個が有効、62層 |
| コンテキスト | 推論時に1Mトークン |
| 入力 / 出力 | 入力はテキスト・画像・動画・音声、出力はテキスト |
| 言語 | 100以上の言語のデータで学習 |
| 推論の強度 | low、medium、high、xhigh(デフォルトはxhigh) |
| ウェイト | BF16とNVFP4 |
| ライセンス | Muse Model License |
ローンチは大きな話題になりました。Hacker Newsのスレッドは初日に914ポイント、477コメントに達し、Mac Studioで動かすことについてのApple自身のMLリサーチ投稿もさらに363ポイントを集めました。
816Bのうち42Bが有効という仕組み
ここが最も面白い部分です。ハードウェアの事情と価格の両方を説明してくれるからです。Muse Spark Openはmixture-of-expertsモデルです。各層には256個の小さなエキスパートネットワークがあり、ルーターがトークンごとにそのうち8個を選びます。そのためモデルは816Bのパラメータを保持しますが、各トークンが通るのはそのうち約42Bだけです。
この分割には、よく混同される2つの帰結があります。
- **メモリは816Bで決まります。**どのトークンもどのエキスパートを必要とする可能性があるため、すべてのエキスパートをメモリに載せておく必要があります。BF16のウェイトが約1.6TBになるのはそのためです。
- **速度は42Bで決まります。**各トークンは自分の分だけを読み込むので、生成は42Bモデルに近いペースになります。Appleは端的にこう述べています。M5 Ultraの1.2 TB/sの帯域幅は「各トークンが必要とする小さな部分を読み出すのに十分な速さ」です。
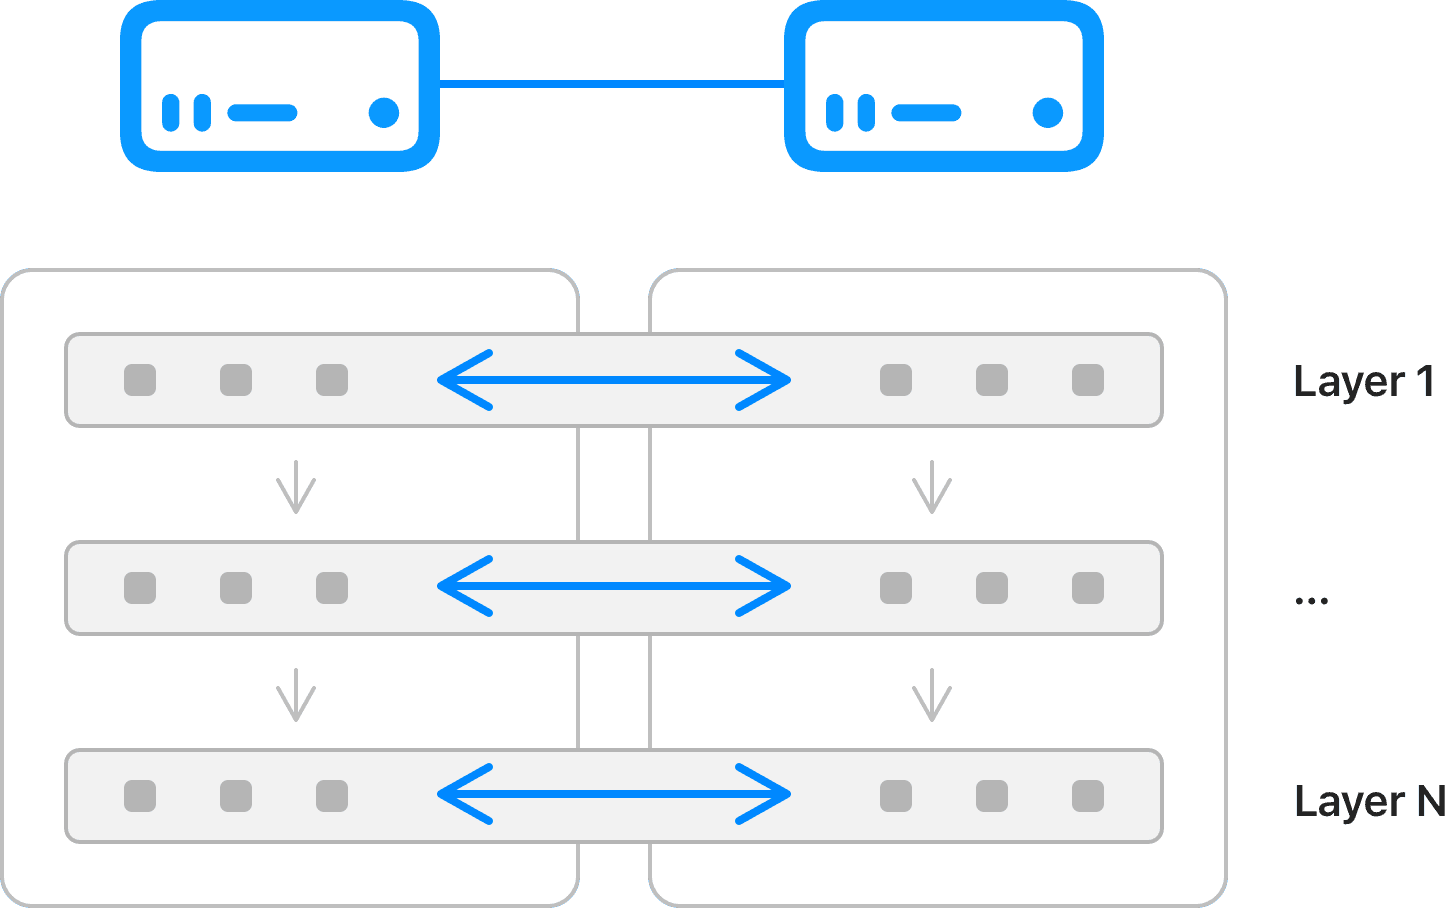
Metaの開発者向け投稿によると、NVFP4チェックポイントはエキスパートのみを量子化しており、サイズは約530GBになります。それでも単体のデスクトップには大きすぎるため、MetaとAppleはテンソル並列で2台に分割しています。各Macがすべての層の半分を保持し、各トークンの計算の半分を担当します。
モデルカードには、画像と動画用の1.8Bパラメータの別個の知覚エンコーダーも記載されています。実際には、ビジョンモデルを別に追加する必要がないということです。1つのチェックポイントがスクリーンショット、録画、ドキュメントを読み取れます。単なるチャットボックスではなく、コンピューターを使うエージェントを作るなら、これは重要です。
Muse Spark Openの料金:クローズドモデルと同じ価格表
ウェイトは無料です。注目すべき数字は、借りて使う場合のコストです。MetaはMuse Spark Openを自社APIで提供しておらず、料金ページに載っているのはMuse WonderとクローズドなSparkモデルだけです。代わりに7社のパートナーがホストしており、料金を公開しているところはすべて同じ価格表に落ち着きました。
| 提供元 | 入力 / 1M | キャッシュ / 1M | 出力 / 1M | 備考 |
|---|---|---|---|---|
| OpenRouter | $1.25 | $0.15 | $4.25 | Modal、Together、Nebius、Fireworks、Basetenにルーティング。最大出力262,144 |
| Fireworks AI | $1.25 | $0.15 | $4.25 | API経由のサーバーレスLoRA学習 |
| Baseten | $1.25 | $0.15 | $4.25 | NVFP4、投機的ドラフターあり |
| Groq | 非公開 | 非公開 | 非公開 | 限定プレビュー、コンテキスト131K |
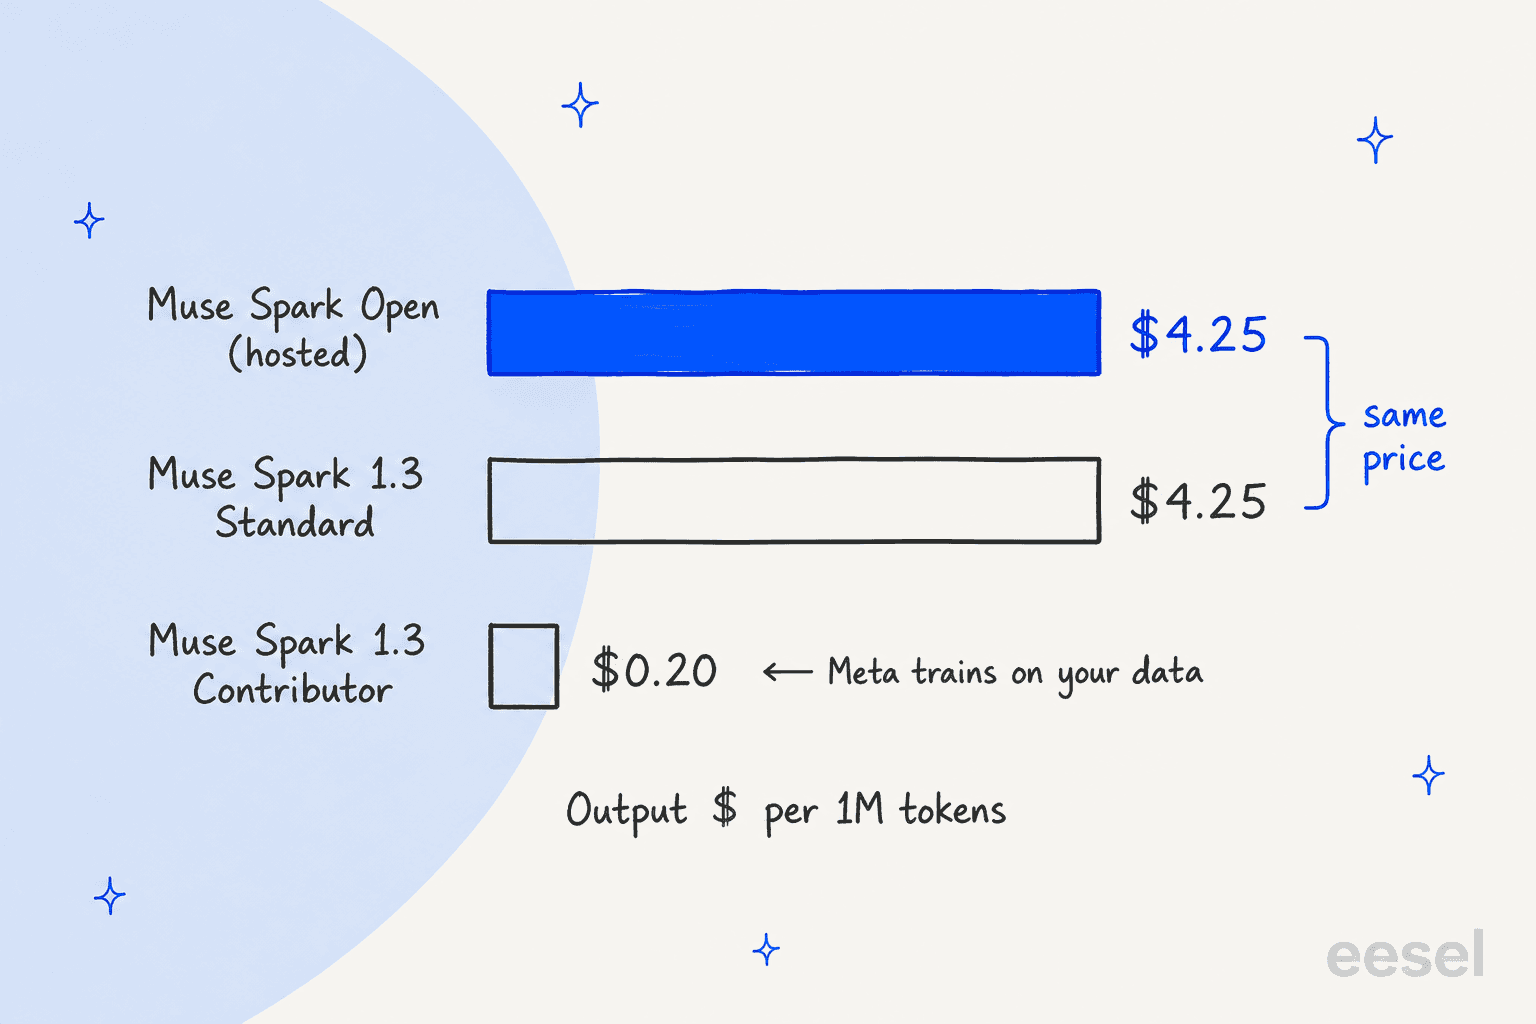
| Meta API:Muse Spark 1.3 Standard | $1.25 | $0.15 | $4.25 | クローズド、Metaの料金 |
| Meta API:Muse Spark 1.3 Contributor | $0.10 | $0.002 | $0.20 | クローズド、Metaがあなたのデータで学習 |
オープンモデルの利用料金は、クローズドモデルとまったく同じです。そしてMetaのトークンで最も安いのは、依然としてクローズドのコントリビューターティアで、出力価格は約20分の1ですが、その代わりMetaがあなたのトラフィックで学習します。オープンウェイトにありがちな割引を期待してMuse Spark Openの価格を調べたのなら、今のところそれはありません。この2段階の仕組みについては、私のMuse Spark 1.3の料金の記事で解説しています。
これを和らげる要素が2つあります。1つ目はキャッシュが強力なことです。OpenRouterによると、実トラフィック全体の入力価格の加重平均は100万トークンあたり約$0.35で、ほとんどのホストでキャッシュヒット率が70%を超えているためです。2つ目に、Artificial Analysisはこのモデルがかなり簡潔だと報告しています。指数の評価を完了するのに出力トークンは1.1億で、中央値の1.3億を下回り、1タスクあたり約$0.84です。
あるHacker Newsのコメント投稿者は、料金が横並びなのはライセンスの副作用だと読み解いていました。
「ライセンスが別になることの通常の効果は、公開プロバイダー間の価格競争が弱まることだ(Kimi K3で見たように)。」

ライセンスについての妥当な見方で、これは後ほど取り上げます。数週間後にホスト各社が値下げ競争を始めるかどうかが、私が注目している点です。他のホストがオープンモデルにどう値付けしているかについては、Together AIの料金とFireworks AIの料金をご覧ください。
Mac Studioの主張と落とし穴
Metaの売り文句は、Muse Spark Openが「Apple M5 Ultra搭載のMac Studio 2台を使い、デスクトップで動かせるこのクラス初のモデル」だというものです。これは事実で、Appleが数字を公開しています。コンテキスト8,192トークンでのベンチマーク表は次のとおりです。
| 構成 | 最初のトークンまでの時間 | デコード速度 |
|---|---|---|
| Mac Studio 2台、パイプライン並列 | 8.4秒 | 15.74 tok/s |
| Mac Studio 2台、テンソル並列 | 8.2秒 | 24.99 tok/s |
| Mac Studio 4台、テンソル並列 | 4.8秒 | 36.73 tok/s |
毎秒25トークンは、バックグラウンドで動くコーディングエージェントには使える速度です。Metaは、この構成でMuse Codeを通じて、MastodonクライアントIce Cubesの実際のiOS修正を出荷し、DaVinci Resolveをエンドツーエンドで操作したと述べています。すべてオンデバイスです。
ここからが落とし穴です。2台構成には1台あたり512GBのメモリが必要ですが、Apple自身のストアでは、M5 Ultraの512GBオプションは「10月下旬発売予定」と表示されています。現時点では注文できません。Mac Studioのストアページでは、M5 Ultra構成はアップグレード前のメモリ96GBで$5,499から始まります。Metaの開発者向け投稿では、1台あたり256GBの4台構成も提案されており、プールされるメモリは同じ1TBになります。
Appleのハードウェアを持っていない場合、必要になるもののすべての段階は次のとおりです。
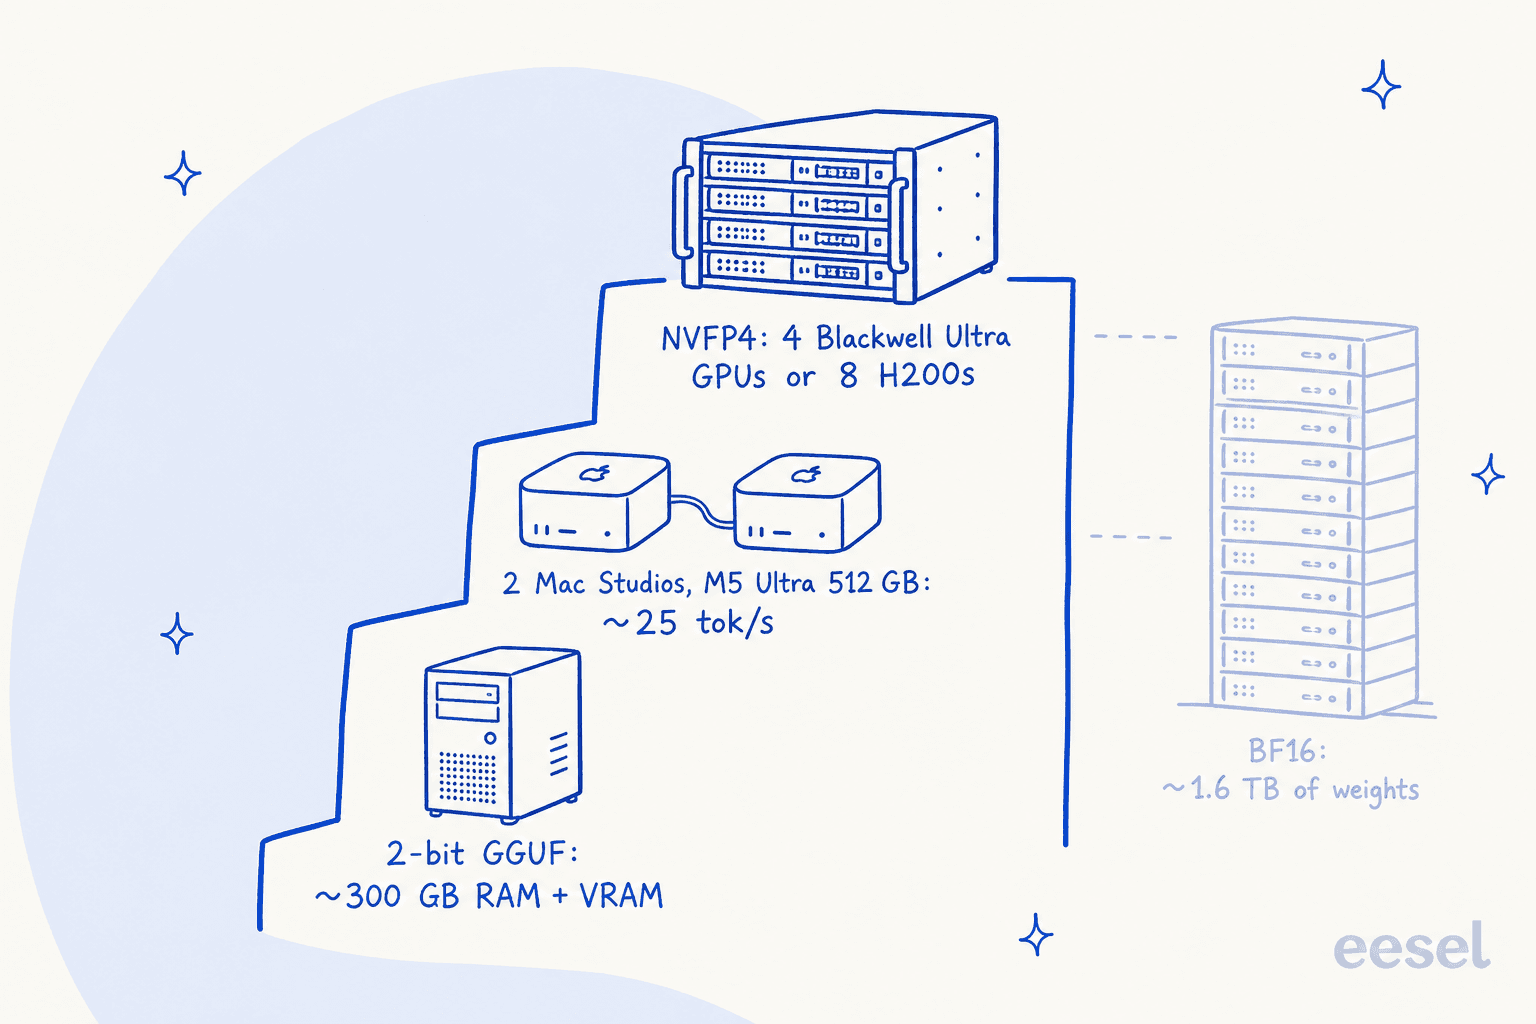
- **データセンター向けGPU。**モデルカードでは、NVFP4で少なくとも700GB、BF16で2TBのGPUメモリが求められています。Metaの開発者向け投稿によると、NVFP4はBlackwell Ultra GPU 4基またはH200 8基で、SGLang、vLLM、TensorRT-LLMを通じて提供できます。
- **大型ワークステーション1台。**Unslothの2ビット動的GGUFは、システムRAMとVRAMの合計約300GBに収まり、llama.cppで動かします。この圧縮では品質の低下が予想され、モデルカード自体も、量子化版は特殊なケースで結果が異なる可能性があると警告しています。
- **クラウドのカタログ。**自分のクラウドアカウント内にプライベートインスタンスが欲しい場合は、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Modelsでウェイトが提供されています。
最も正直な要約は、Unslothのガイドを読んだコメント投稿者から出ました。「僕らがこれを動かすことはない」(spwa4, Hacker News)。多くのチームにとって「オープン」とは、ホストから借りるか、データの理由で自社のクラウドで動かすことを意味するでしょう。
Muse Spark Openは他のオープンモデルとどう比較されるか
Metaは、Kimi K3、Mistral Large 4、Inkling、ReflectionのBeamなど、7つのオープンウェイトの競合とMuse Spark Openを比較しました。自社モデルはxhigh強度で実行しています。公開された表は次のとおりです。
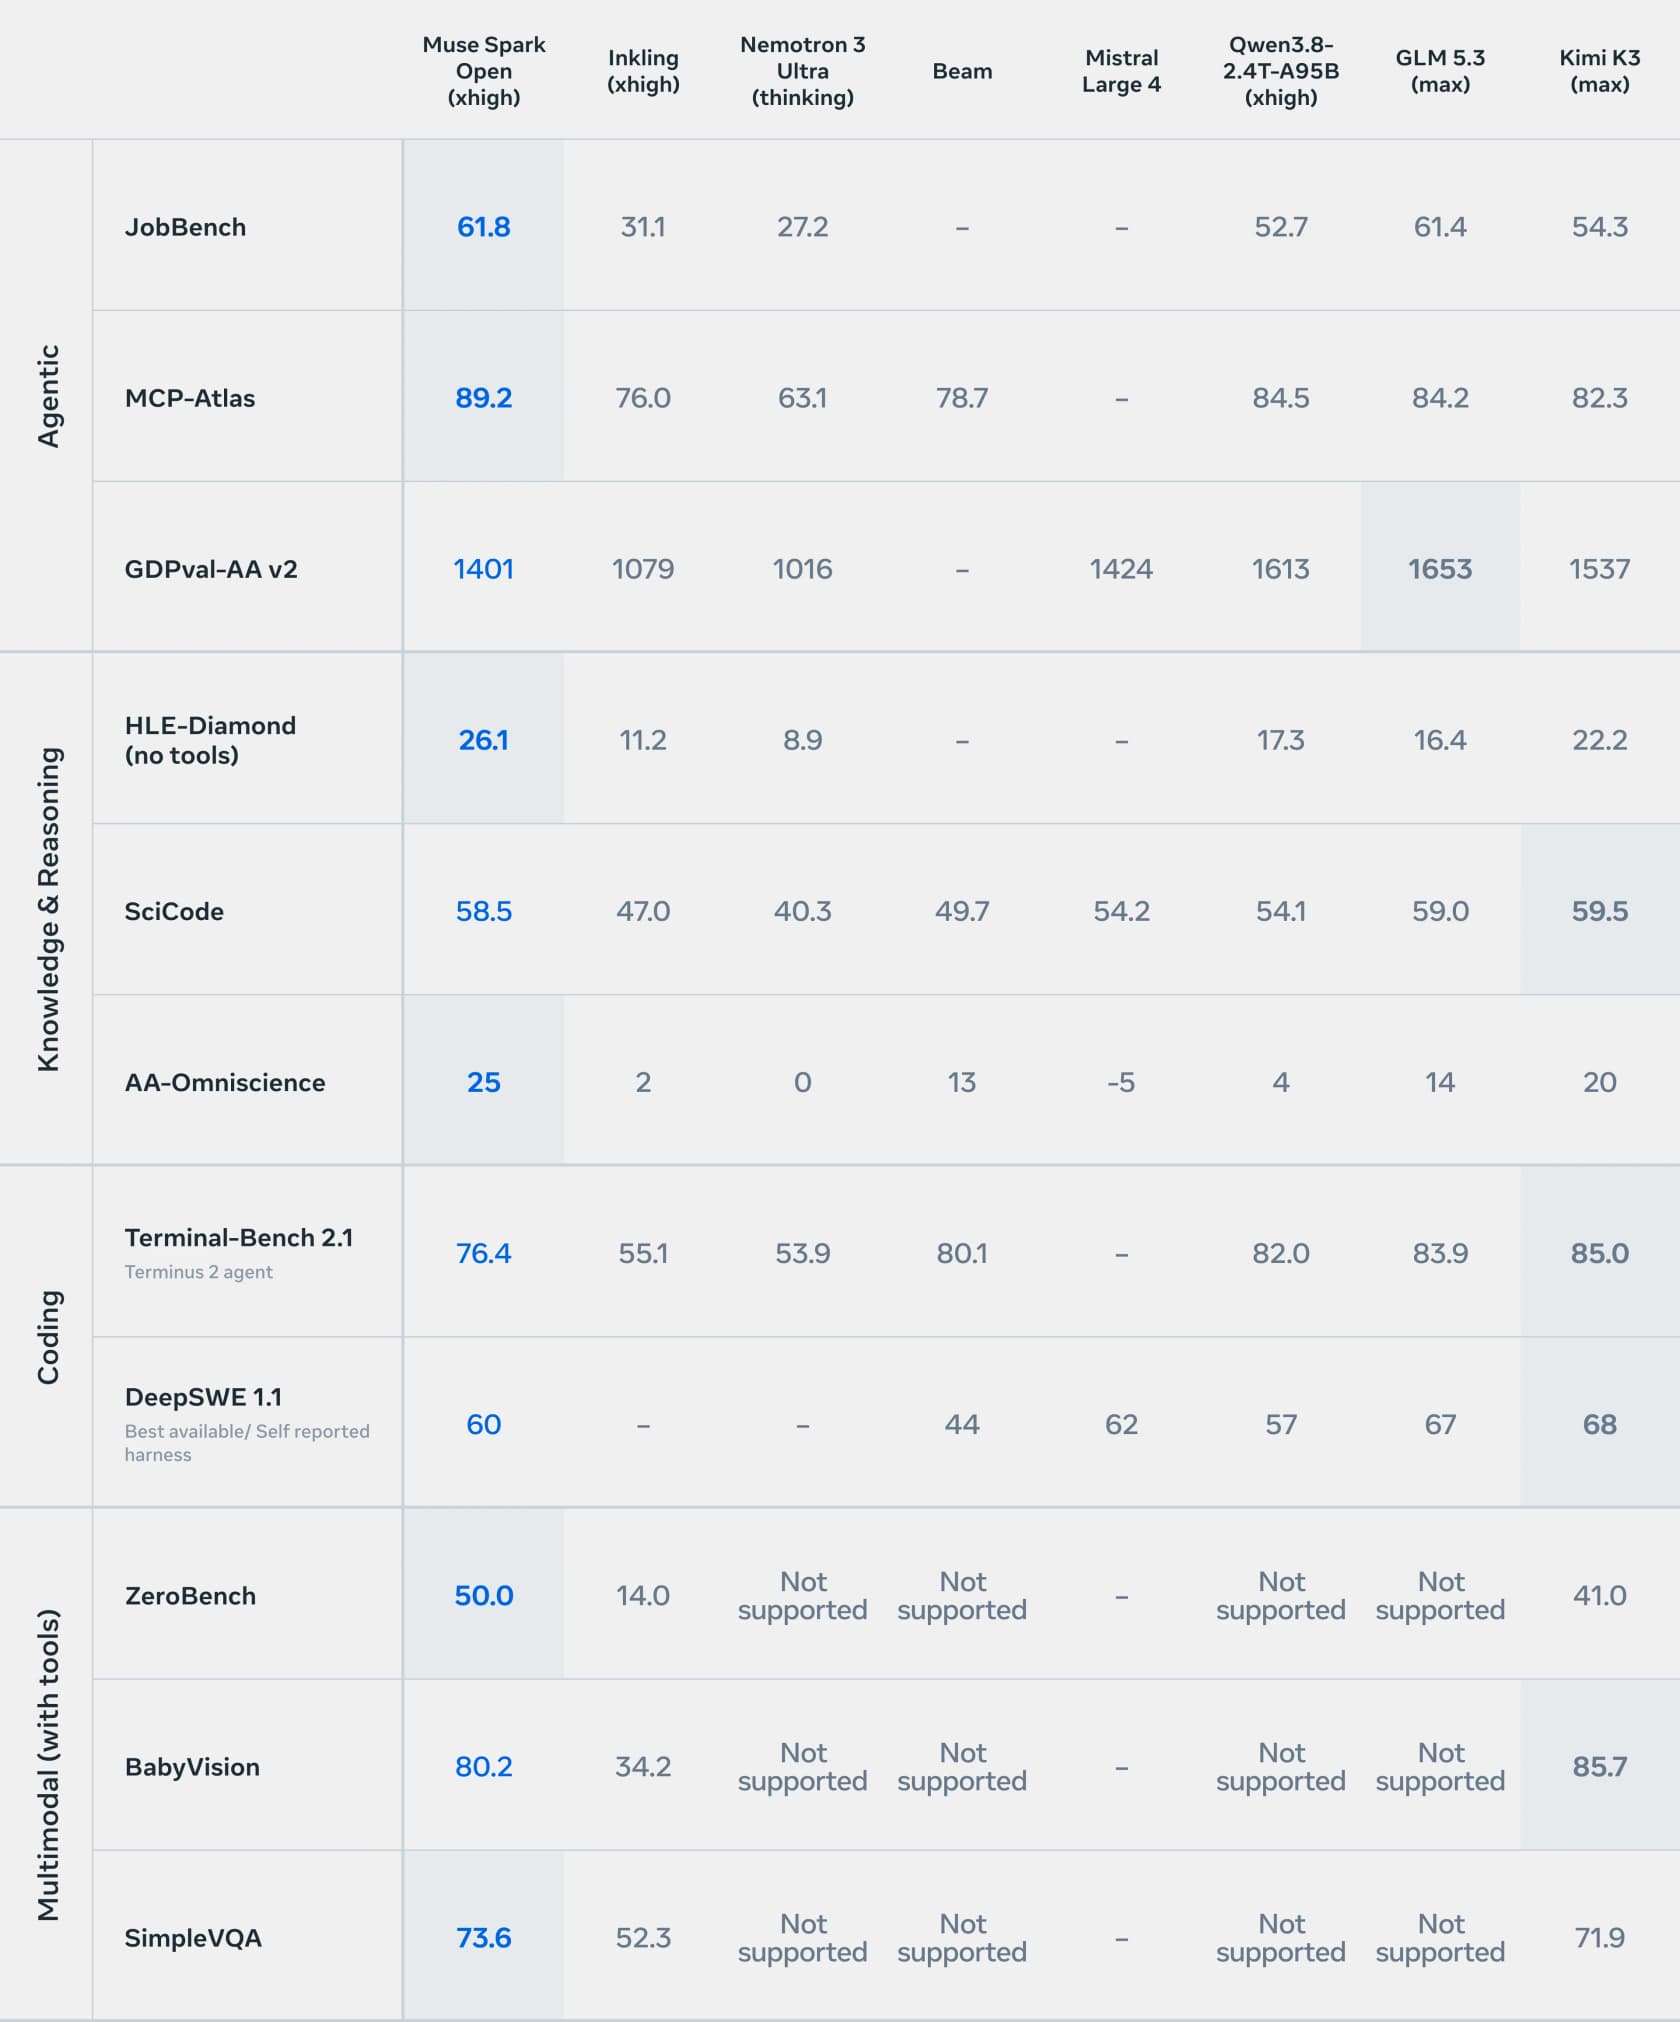
行ごとに読むと、はっきりした傾向が見えてきます。
- **リードしている分野:**ツール利用とエージェントタスク(MCP-Atlas 89.2、JobBench 61.8)、ツールなしの知識(HLE-Diamond 26.1、AA-Omniscience 25)、いくつかのマルチモーダルテスト(ZeroBench 50.0、SimpleVQA 73.6)。
- **劣っている分野:**総合指数とコーディング。Artificial Analysis Indexのスコアは39で、GLM 5.3(45)、Kimi K3(44)、Qwen3.8(40)に及びません。Terminal-Bench 2.1ではKimi K3の85.0に対して76.4、DeepSWEでは68に対して60です。
- **別次元の分野:**安全性。低いほど良い適応型ジェイルブレイクテストのStrongREJECTでは0.5です。Metaがテストした他のすべてのモデルは62.9から86.4の間に収まっています。
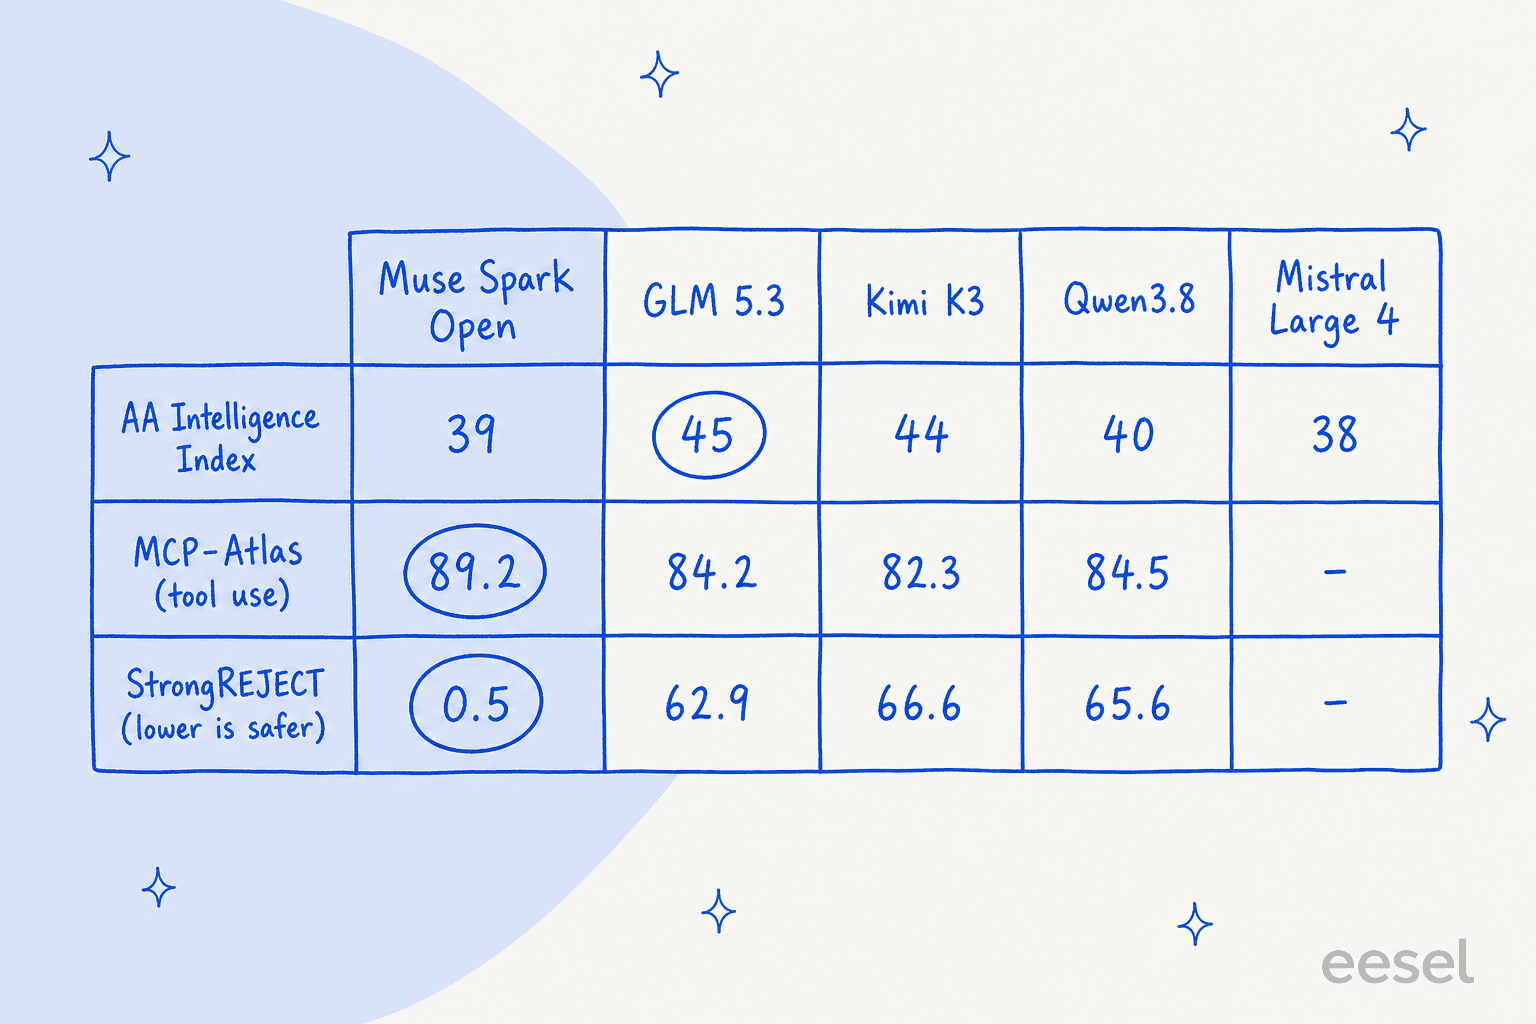
第三者の数字もMetaの数字と一致します。Artificial AnalysisはMuse Spark Openを指数39としており、比較可能なモデルの中央値19を大きく上回り、速度は毎秒131トークンです。Hacker Newsはすぐにその数字を文脈の中に位置づけました。
「AAで39。Deepseek v4.1 flashやMimo 2.5 Flashとほぼ同じ。Glm 5.3 flashやQwen3.8-Flash-Nextには負けている」
DeepSeek V4.1 FlashやGLM 5.3 Flashははるかに小さいモデルなので、この比較は痛いところを突いています。これまでの実使用の報告も同じ傾向です。あるテスターはFireworksで「GLM 5.3より頭が悪い」が「本当に速い」と評し(eknkc, Hacker News)、別のテスターはベンチマークで1.3より「1.2に近い」としています(modeless, Hacker News)。Metaは自社のクローズドモデルとの直接比較を公開していないため、後者は初期の印象として扱ってください。
私の見立てでは、これは最高のオープンなコーディングモデルというより、まずツール呼び出しとエージェントループ向けのモデルで、安全性の挙動が強力です。Metaの開発者向け投稿で引用されている初期ユーザーも同じことを述べており、「次に使うべきツール」を選べることや、複数ステップや並列呼び出しでの構造化出力がきれいなことを評価しています。エージェントが日々ツールを呼び出しているなら、指数の差よりMCP-Atlasでのリードのほうが重要です。コードを書くのが仕事なら、これらの数字ではオープンモデルとしてKimi K3のほうが有力です。
ライセンス:無料、ただし3つの条件付き
MetaはウェイトをMuse Model Licenseで公開しており、これを「限定的な商用条件」付きと説明しています。寛容なライセンスに条件を後付けしたような内容です。次の条件のもとで、無料で利用、コピー、改変、ファインチューニング、蒸留、マージ、公開、販売ができます。
- **利用ポリシー。**兵器や重要インフラから、偽レビューや出力を人間が書いたと偽ることまで、禁止用途が長く列挙されています。また、18歳未満の利用を想定していないとも書かれています。
- **表示義務。**製品のインターフェース、ドキュメント、ウェブサイト、設定メニューに「Built with Muse Spark Open」という文言を「目立つように表示」する必要があります。これは、その出力から学習または蒸留したモデルにも適用されます。
- **2,000万ドルのサービス条項。**APIでAIモデルへのアクセスをサービスとして販売し、かつ企業グループの12か月間の収益が2,000万ドルを超える場合は、Metaに通知し、先に別途契約を結ぶ必要があります。
3つ目の条項は恐ろしく聞こえますが、ほとんどは問題になりません。社内利用、研究、自社製品の機能を動かすためにモデルを使うことは明確に除外されています。サポート受信箱の裏でMuse Spark Openを動かすSaaS企業が、表示義務以外でMetaに支払うべきものはありません。この条項が狙っているのは、モデルを再販する推論プロバイダーや大手プラットフォームです。
もう1つ実務上のハードルがあります。Hugging Faceからのダウンロードには、氏名(本名)、生年月日、法人識別子を含む組織の正式名称を尋ねるゲート付きフォームが必要です。また、Metaは出力に対する所有権を主張していません。法務チームが真っ先に確認する条項です。
社内利用、研究、または自社製品内の機能を動かすために使う
無料です。売上が2,000万ドルを超えていても、別途契約は不要です。利用ポリシーには従い、ユーザーが見つけられる場所(UI、ドキュメント、ウェブサイト、設定メニュー)に「Built with Muse Spark Open」を表示する必要があります。
AIモデルへのAPIアクセスを販売していて、企業グループの年間収益が2,000万ドル未満
今のところ無料で、表示と利用のルールは同じです。収益を把握しておいてください。判定は連続する任意の12か月で、あなたと関連会社の合計で数えます。
AIモデルへのAPIアクセスを販売していて、企業グループの年間収益が2,000万ドルを超える
そのサービスでMuse Spark Open、またはそこから派生したものを提供する前に、Metaに通知し、別途書面による契約を結ぶ必要があります。条件は公開されていません。
ここからファインチューニングまたは蒸留して新しいモデルを作った
それは派生物(Derivative)に当たります。表示の文言と利用ポリシーが引き継がれ、そのアクセスを再販する場合は2,000万ドルのサービス条項も適用されます。
2026年10月15日付のMuse Model Licenseの要約です。法的助言ではありません。出荷前にHugging Face上の全文をお読みください。
これは「オープン」なのでしょうか。Hacker Newsの多くのコメント投稿者は、ライセンスがOSI承認ではなく、ウェイトだけで学習データもコードも公開されていないとして、違うと述べました。私は、商用上の上限があるオープンウェイトと呼びます。ほとんどの企業にとって、その上限は到達しうる水準をはるかに上回っています。完全にオープンソースの部品が欲しいなら、私のオープンソースAIエージェントのまとめが出発点として適しています。
安全性:このリリースで最も強い部分
Metaが最も力を入れたのはここで、それが結果にも表れています。モデルカードは、システムレベルの保護策なしで次の結果を報告しています。
- **サイバー悪用:**Metaの内部ベンチマークでジェイルブレイクの99.2%を拒否し、PolyGuard、RedCode、CyberBench 2024全体では94.8%を拒否。同じ条件でKimi K3の拒否率は75.5%と70.2%でした。
- **化学・生物:**SecureBioのBioTIERで98%超、Metaのマルチターンのエージェント型生物学テストで97%超の拒否率。
- **誠実性:**MASKベンチマークで98.1%の誠実性、Agentic Misalignmentベンチマークで不適切な挙動は0%。
Meta自身の表には、トレードオフも隠れています。FORTRESSテストでは、Muse Spark Openは敵対的リスクスコアが最も低い(5.8)一方で、過剰拒否スコアはグループ内で最も高く(17.4)、GLM 5.3(3.2)やKimi K3(2.7)よりも無害なリクエストを断ることが多いということです。顧客向けのボットでは、「お手伝いできません」という返答が少し増えることは現実的なコストです。デフォルト設定を信頼する前に、自社のトラフィックでテストしてください。
Meta自身が挙げている注意点が2つあります。1つは、完全な評価レポートがまだ「近日公開」であること。もう1つは、モデルカードが「下流での改変は安全性を低下させる可能性がある」と警告していることで、ファインチューニングした瞬間に、それらの数字はあなたのものではなくなります。Meta自身のアドバイスは、追加のガードレールと「不可逆的なアクションに対する人間による確認」を備えたシステムの中に展開することで、これはサポートキューの裏にモデルを置く人に私が伝えることと同じです。
初日からのファインチューニング
これも、オープンウェイトが実際に可能にするものです。Metaは、開発者向け投稿によると、ローンチ時にポストトレーニングのサポートを全面的に整えていました。
- **PyTorch TorchTitan:**事前学習、マルチターンSFT、LoRA、強化学習。
- **Hugging Face TRL:**公開されたチェックポイント上でSFTTrainerを使ったLoRA。
- **Fireworks AI:**APIによるサーバーレスLoRA学習、シーケンス長は最大262,144トークン。モデルページには、UIでのマネージドなファインチューニングはこのモデルではまだ利用できないと記載されています。
- **Together AI:**ポストトレーニングサービスでSFTまたはGRPO強化学習を行い、1つのデプロイで複数のLoRAアダプターを提供。
- **NVIDIA NeMo AutoModelとRadixArkのMiles:**フルパラメータの作業向け。
サポートチームにとって、ファインチューニングは魅力的に聞こえます。トーン、製品名、返金ルールを教え込めるからです。私の経験では、それが最初の対処法になることはまれです。私が目にする誤回答の多くは、再学習が必要なモデルではなく、古い、あるいは矛盾したヘルプセンターが原因で、リトリーバルのほうが早く解決します。その理由は私のRAG vs LLMの記事で説明しています。ファインチューニングは、リトリーバルが固まったうえで、なおスタイルや形式の問題が残る場合に行ってください。
Muse Spark Openを実際に使うべきなのは誰か
私なら次のように判断します。
- **モデルを自社の内側に置く必要がある。**規制対象のデータ、第三者の処理事業者を認めないセキュリティレビュー、「外部AI禁止」という顧客との契約など。これが最も強いケースで、安全性の数字が主張を裏付けやすくしてくれます。
- **ツールを多用するエージェントを作っている。**MCP-AtlasとJobBenchでのリードは本物です。MCPサーバーと組み合わせて、手持ちのツール群をどう扱うか確かめてください。
- **大規模なマルチモーダルモデルをファインチューニングしたい。**音声と動画をネイティブに入力でき、学習用のスタックもローンチ日に整っていました。
- **Metaで最も安いトークンが欲しい。**これは見送ってください。クローズドなMuse Spark 1.3のコントリビューター料金のほうがはるかに安いです。Metaにそのトラフィックで学習されても構わなければ、ですが。
- **最高のオープンなコーディングモデルが欲しい。**まずKimi K3かQwenを見るか、Claude Opus 5.5や新しいMuse Wonderのようなクローズドのフロンティアモデルに進んでください。
カスタマーサポートに限れば、モデル選びは小さな判断です。私のサポート向けモデルガイドでは、指数の数ポイントよりも、リトリーバル、エスカレーション、テストのほうが解決品質を左右する理由を説明しています。6ポイントの指数の差がキューに現れることはまれです。古い記事に基づく自信満々の回答は、オープンウェイトかどうかにかかわらず、毎日現れます。
eeselを試す
Muse Spark Openはインフラです。ウェイトとライセンスとハードウェアの請求書が手に入り、その後のリトリーバル、エスカレーションのルール、テスト、監査証跡は自分で作ります。eeselは従業員です。当社のAIヘルプデスクのチームメイトは、Zendesk、Freshdesk、Gorgiasなどに接続し、過去のチケットとヘルプセンターから学習します。お客様に1件も回答する前に、過去のチケット数百件に対して実行できます。そのリプレイこそ、どのモデルが裏にあっても、自信過剰な回答をお客様より先に見つける場所です。
セルフホストモデルを操作するように、ターミナルから管理したいなら、eesel CLIが対応しています。eesel instructionsはチームメイトの常設ルールを読み取り・編集し、eesel approvalsは人間の承認待ちのアクションを一覧表示し、eesel activityは各実行とその理由を表示します。すべてのコマンドはJSONを出力し、書き込みは--dry-runを受け付けるため、Claude Codeのようなコーディングエージェントが、リポジトリを管理するのと同じ方法でサポートのチームメイトを管理できます。チケットへの回答ではなくコンテンツを書くなら、同じラインナップにAIブログライターがあります。

100クレジットでカード不要、無料で始められます。Mac Studioの費用を見積もる前に、先月のチケットでeeselを試して、どう答えたかを確認してください。プランは料金ページでご確認いただけます。