

要点
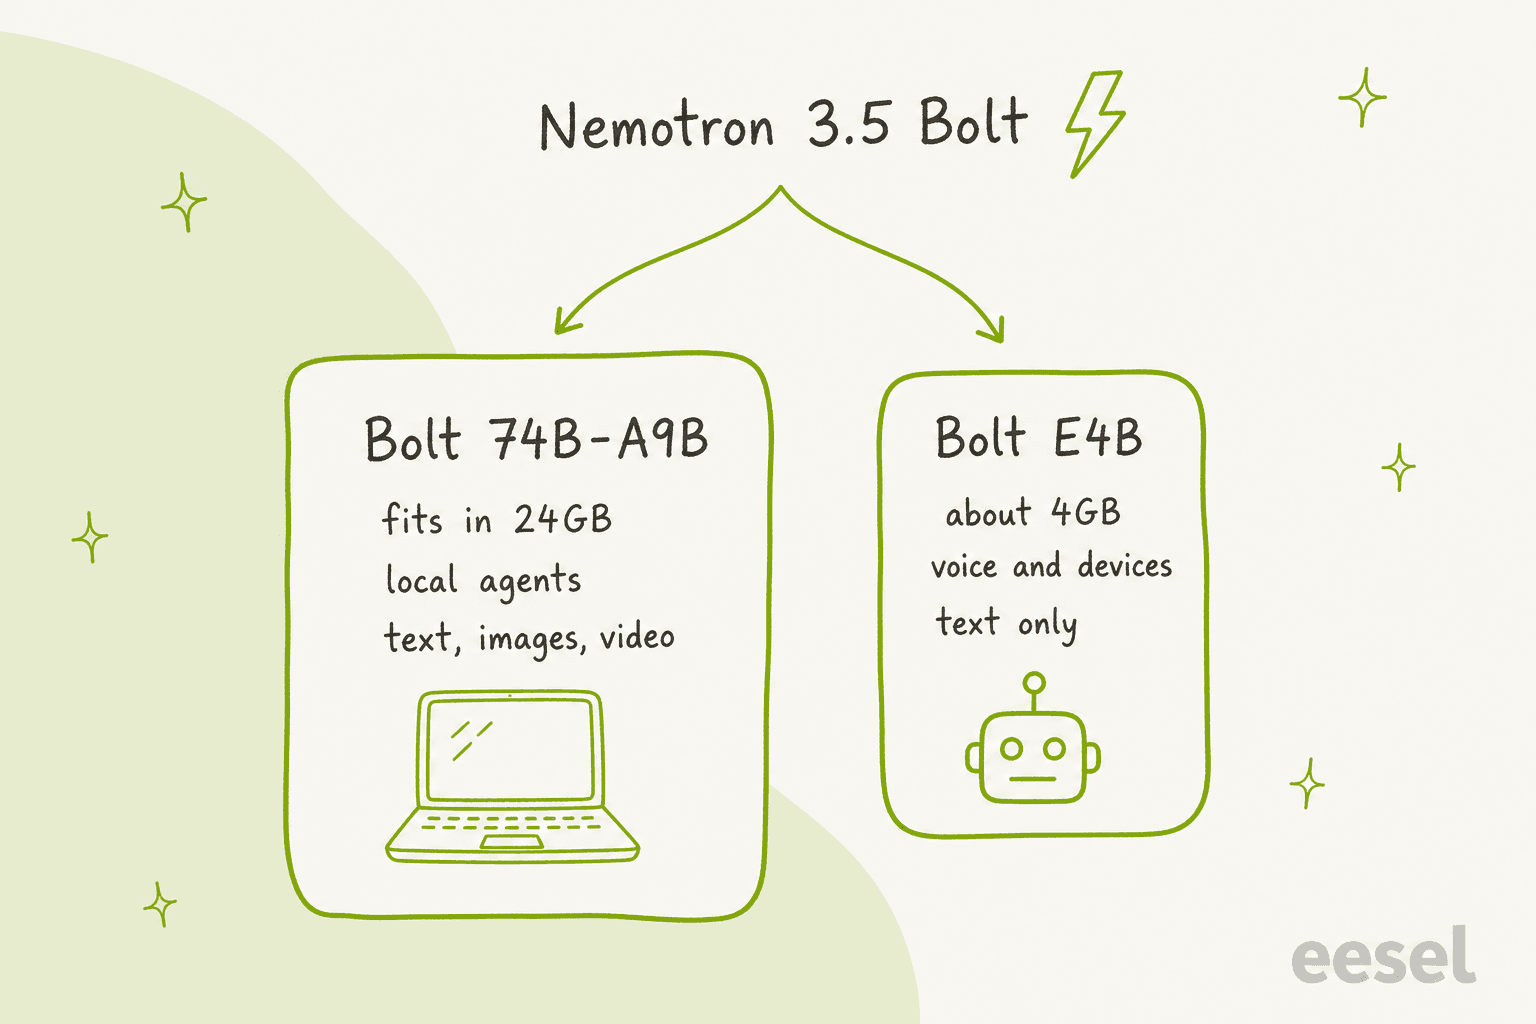
Nemotron 3.5 Boltは、自分のマシンで動かすために作られたNVIDIAの新しいオープンモデル群で、1つではなく2つのモデルがあります。Bolt 74B-A9Bは74Bパラメータのモデルを24GBに収め、2ビットの重みを使うことで、一般消費者向けクラスのGPU 1枚でローカルエージェントを動かせます。Bolt E4Bは、音声アシスタント、ゲームキャラクター、デバイス向けの4GBモデルです。
74BモデルはArtificial Analysis Intelligence Indexで21を記録し、100Bパラメータ未満のモデルで4位、NVIDIAの550B Nemotron 3 Ultraとの差は2ポイント以内です。重みはOpenMDW-1.1の下で無料公開されており、どちらのBoltにもまだ有料APIはないので、支払うのはハードウェアの費用です。
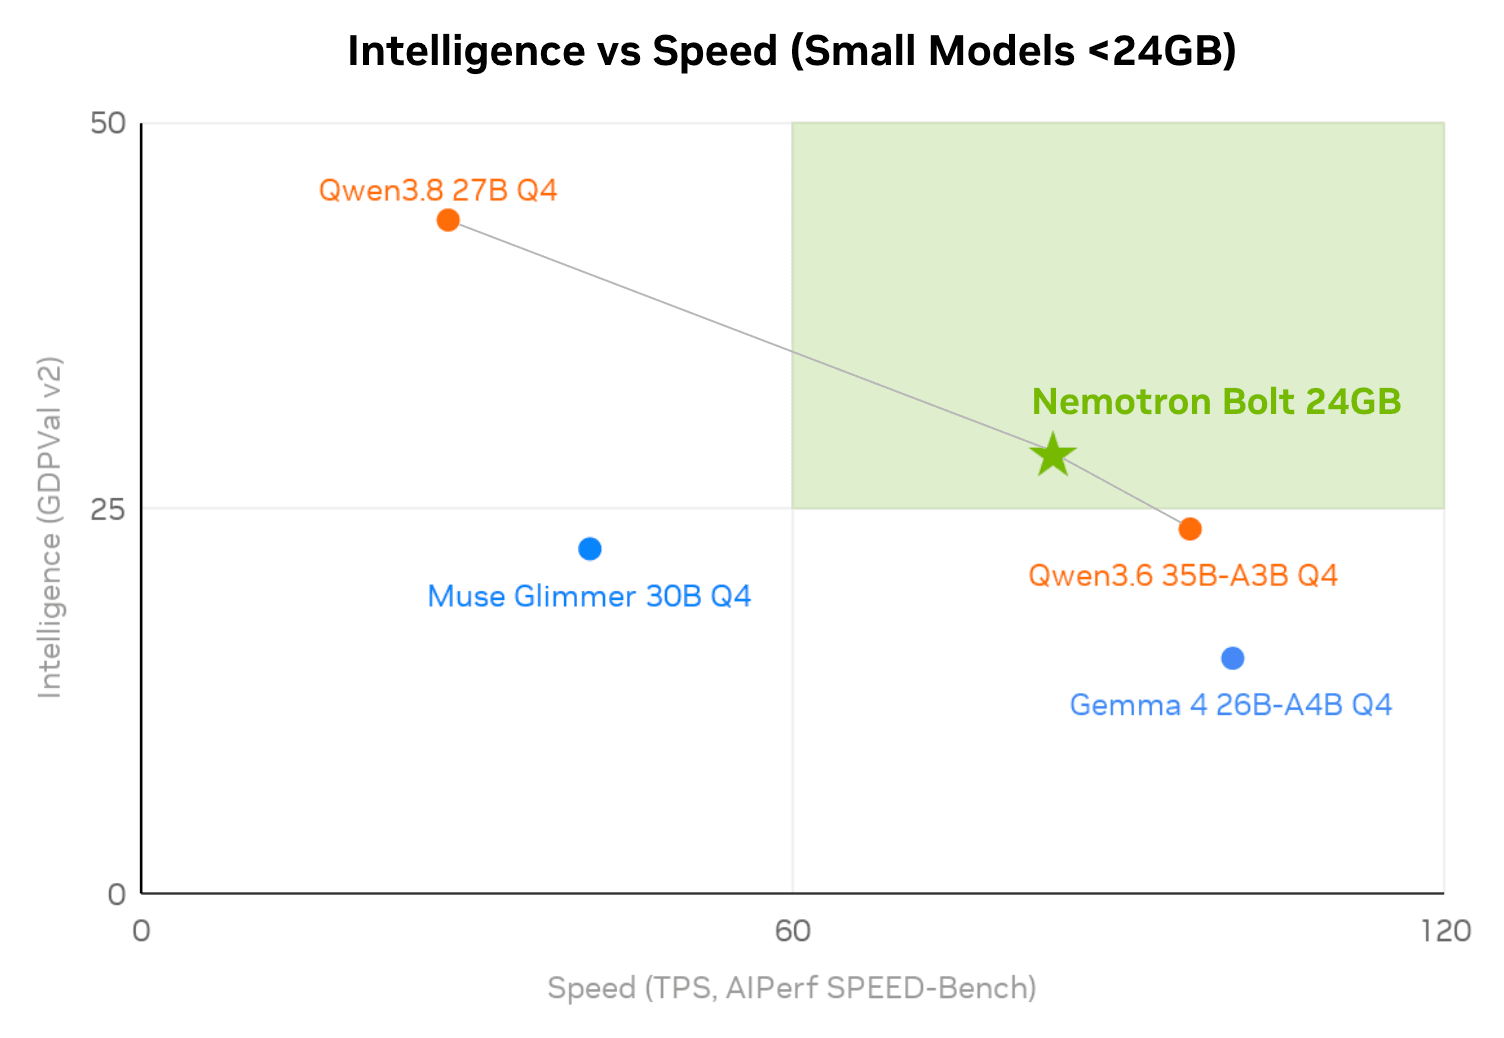
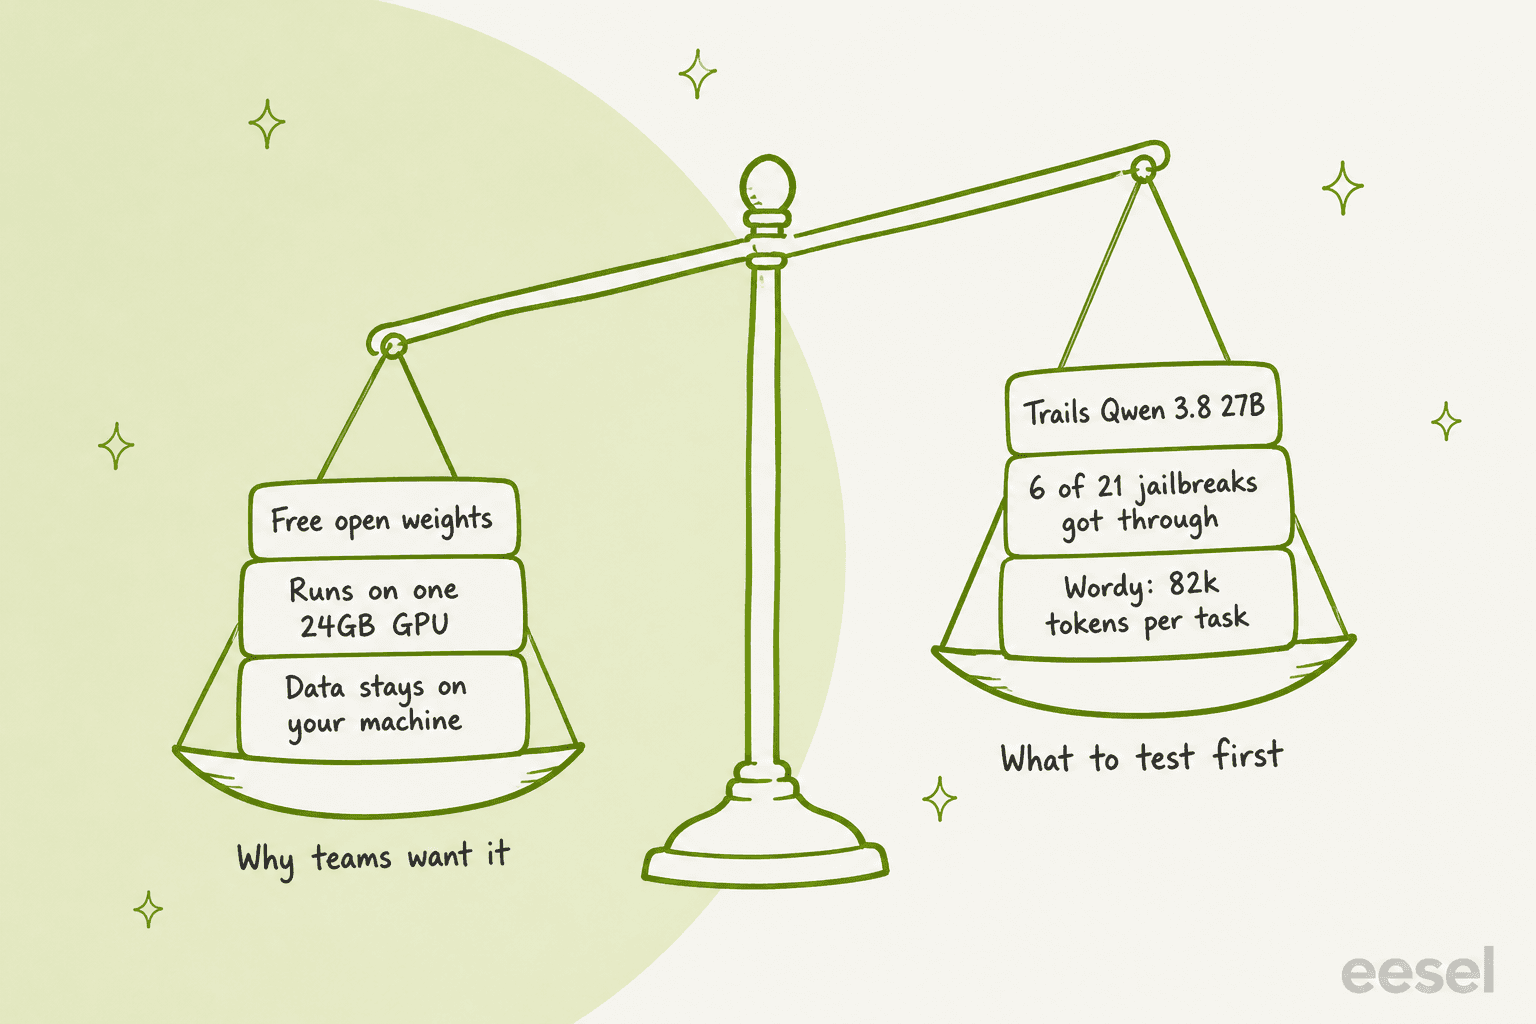
ただし注意点もあります。密なモデルであるQwen3.8 27Bのほうが依然として賢く(NVIDIA自身のGDPVal v2チャートで44.5対28.5)、Boltは冗長で、あるテスターの検証では21件中6件のジェイルブレイクテストに失敗しました。サポートチームにとっては、プライバシーを保ったオンデバイス作業のための有望なエンジンですが、スイッチを入れればチケットに回答してくれるものではありません。今すぐそれが必要なら、eeselのAIヘルプデスクチームメイトは自社のドキュメントだけを基に回答し、誰かに返信する前に過去のチケットでテストされます。
私がBoltの技術レポートを読んだ理由
私はeeselで機能やAIエージェントを開発しているので、1週間の大半はエージェントの地味な中間部分に費やしています。コンテキストに何を入れるか、どのツールを呼び出すか、モデルが間違えたらどうなるか、といったことです。技術に詳しい購入検討者から最もよく聞かれるのは、「どれくらい賢いですか?」ではありません。「私たちのデータはどこへ行くのですか?」です。今年のある商談では、ハードウェア企業の評価担当者から、AIが答えを知らない場合に“some kind of other ChatGPT”へフォールバックするのか、自社のナレッジが組織内に閉じたままになるのかを聞かれました。
自分の机の下に置いたマシンで動かせるモデルは、その問いに対する誠実な答えの1つです。そこでNVIDIAが「大きなモデルを24GBに収める」ことを全面に打ち出したモデルを公開したとき、私はモデルカード、技術レポート、そして見つけられる限りのユーザーテストを読みました。ここでは、裏付けのある点と補足が必要な点を紹介します。
Nemotron 3.5 Boltとは?
Nemotron 3.5 Boltは、Nemotron 3.5ファミリー内のNVIDIAの「エッジ」向けラインです。NVIDIAは2026年10月15日、Nemotron 3.5 Super VLと同時に発表しました。同社はこのファミリーについて、Lightningは高スループットのワークロードを、Ultraは最も難しい推論を担当し、“Bolt brings intelligence to the edge.”と説明しています。
この名前には大きく異なる2つのモデルが含まれていて、初期の報道の多くはここで混乱しています。
- Bolt 74B-A9B 24GBは主役となるモデルです。NVIDIAによると、“designed to run everyday agentic tasks locally on NVIDIA RTX/DGX Spark, using a native 2-bit quantization to fit in 24GB of memory,”とのことです。
- Bolt E4B 4GBは10月23日に登場しました。実効パラメータ数が4Bの8Bモデルで、GoogleのGemma 4 E4BをベースにNemotronの事後学習を施し、“fast local voice assistants, interactive characters and embedded interfaces.”向けに作られています。
仕様を並べてみましょう。
| 仕様 | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| 公開日 | 2026年10月15日 | 2026年10月23日 |
| パラメータ | 合計74B、トークンごとに9Bがアクティブ | 合計8B、実効4B |
| ベース | Nemotron 3.5 Super VL(120B)を圧縮 | Gemma 4 E4Bに事後学習 |
| アーキテクチャ | Mamba-2とTransformerのハイブリッド型混合エキスパート | Gemma 4 E4B |
| 重みの形式 | 2ビットのエキスパート(IQ2_XXS)、22.1GB | 4ビット(Q4_K_M) |
| 入力 | テキスト、画像、動画(最大2分のMP4) | テキスト |
| コンテキストウィンドウ | 最大256Kトークン | 64Kトークン |
| 対象ハードウェア | RTX Spark、DGX Spark、GeForce RTX、RTX PRO | GeForce RTX、Jetson、RTX/DGX Spark |
| ライセンス | OpenMDW-1.1 | OpenMDW-1.1に加え、Gemmaのベース部分にはApache 2.0 |
どちらも推論のオンとオフを切り替えられ、74Bモデルはツール呼び出しとJSON出力に対応しています。Meta Muse Spark OpenやKimi K3のようなオープンモデルの公開を追っている方にとって、今回の違いはターゲットです。Boltはデータセンターではなく、1台のマシン向けに作られています。
NVIDIAはどうやって74Bモデルを24GBに収めているのでしょうか?
端的に言うと、大きなモデルから始め、削り込み、それぞれの数値を小さくします。NVIDIAの研究ページには、目標が明確に書かれています。“fit into 24GB of memory and achieve a decoding speed of at least 80 TPS, while maximizing intelligence.”です。これを4つのステップで実現します。
- 大きなモデルを圧縮します。 Boltの出発点は、120Bパラメータを持ち、トークンごとに22のエキスパートを選択するSuper VLです。NVIDIAのStar Elastic手法でこれを74Bに枝刈りし、エキスパート数を9に固定します。技術レポートによると、これだけで平均精度は2.85ポイント、元モデル比で4.94%低下します。
- 学習で回復させます。 次にBoltには120Bトークンの回復学習、再接続した視覚機能、教師ありファインチューニング、強化学習が施されます。最も回復を必要とするのは視覚部分です。圧縮でWebArenaスコアは57.4から1.35に落ちましたが、学習によって約50まで戻りました。
- エキスパートを2ビットに量子化します。 エキスパートの重みはそれぞれ2.0625ビットで保存されます。量子化を考慮した蒸留を使い、その精度で小さなモデルが大きなモデルに合わせるよう学習します。Mamba層は4ビットのNVFP4を使い、アテンションと埋め込みは8ビットのままです。これによりモデルは148GBから22.1GBになり、NVIDIAは“an 85.1% reduction in size. This quantization is lossy by design,”と述べています。
- 高速化のためにドラフターを追加します。 LiLiCorrという別の1.13Bパラメータのモデルが数トークン先を予測し、メインモデルがそれを確認します。こうしてNVIDIAはRTX Sparkで毎秒84トークンを実現しています。
NVIDIAが賭けているのは、2ビットに縮めた大きなモデルは、4ビットで学習した小さなモデルに勝るという考えです。これは多くのローカルモデルの作り方とは逆で、今回のリリースにおける新しいアイデアです。
名前にある「24GB」について、1点補足があります。技術レポートのメモリ表を合計すると、テキストのみで23.83GBになります。視覚エンコーダーには、さらに1.68GBが必要です。
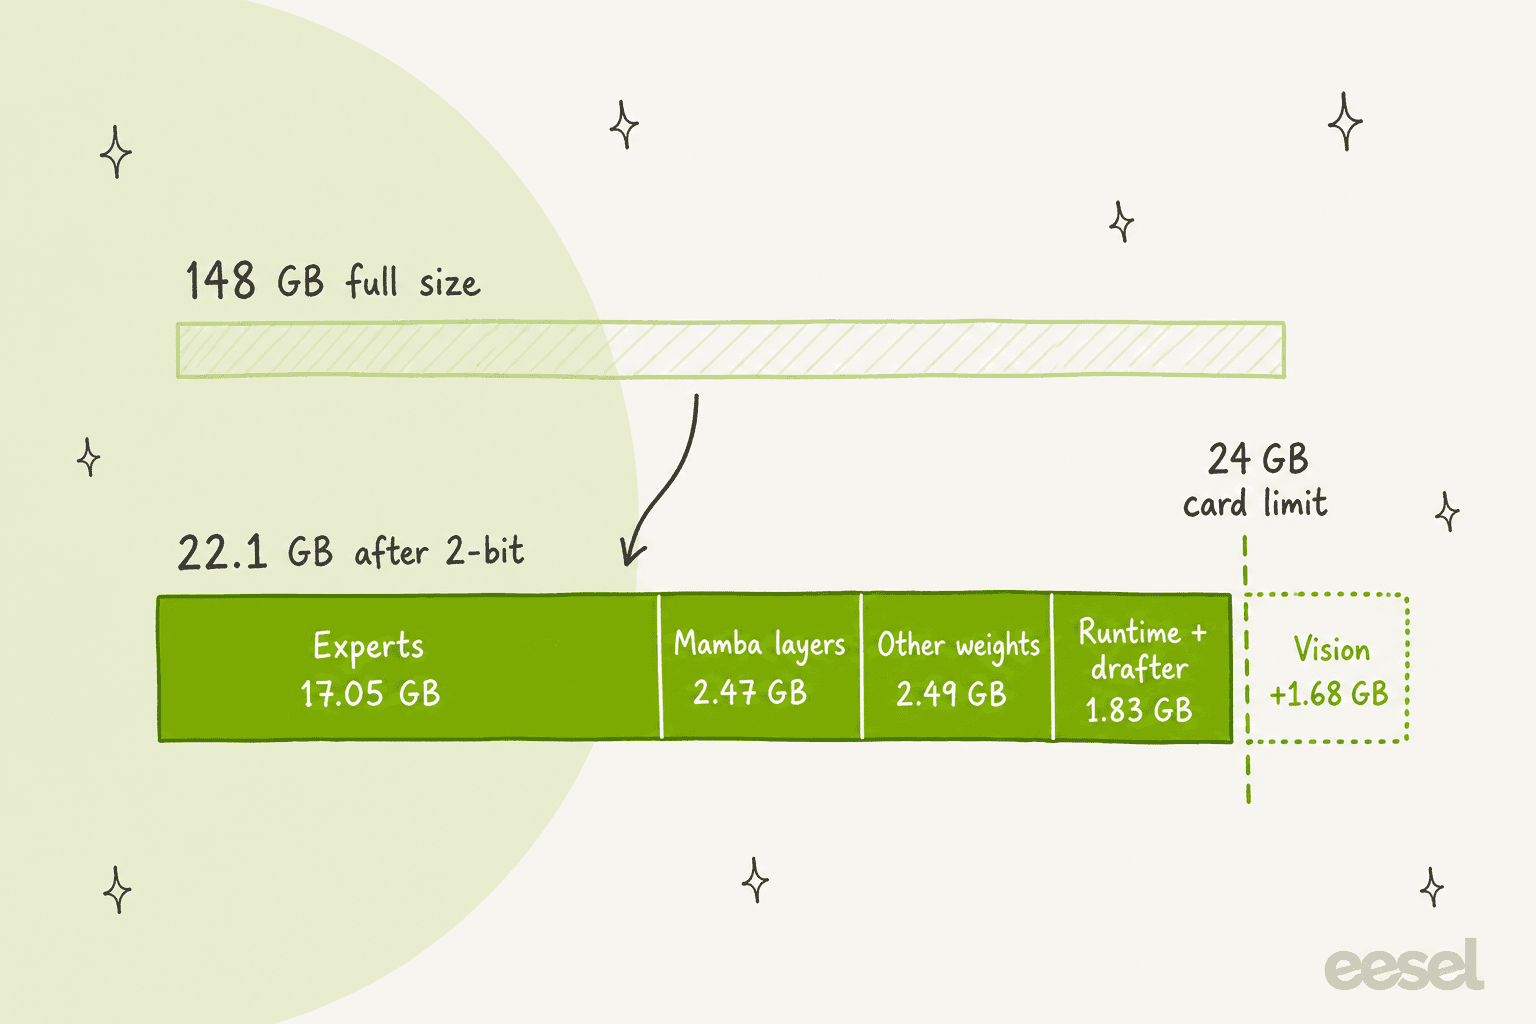
つまり24GBのカードで動かすのは、テキストエージェントです。画像や動画の機能も使いたいなら、もう少し余裕を見込んでください。いずれにせよ、Unslothのローカル実行ガイドも24から32GBのメモリを推奨しています。
Nemotron 3.5 Boltは、実際どれくらい優秀なのでしょうか?
独立した評価とNVIDIA自身の評価、この2つのスコア表を見てみましょう。
独立した評価のスコア。 Artificial AnalysisはBolt 74BのIntelligence Indexを21.4とし、“placing 4th among models under 100B parameters and first among US models in that class.”としています。パラメータ数が約7倍のNemotron 3 Ultra(23)との差は2ポイント以内です。AutomationBench-AAでは、BoltはUltraさえ上回っています(15.5%対3.0%)。
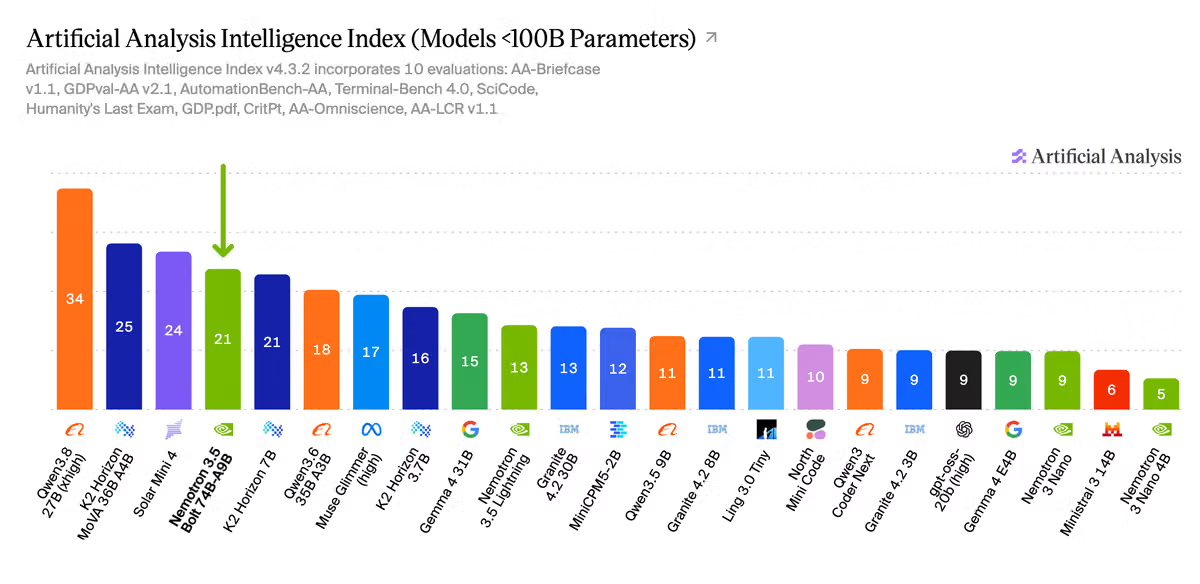
ただし、チャートの左側を見てください。Qwen3.8 27Bは34を記録しています。Boltは同クラスで最高の米国モデルですが、同クラスで最高のモデルではありません。
NVIDIA自身の表。 モデルカードでは、2ビットのBoltを、フル精度の3つの混合エキスパートモデルと比較しています。
| ベンチマーク | Bolt 74B 24GB(2ビット) | Qwen3.6 35B-A3B | Gemma 4 26B-A4B | Nemotron 3.5 Lightning |
|---|---|---|---|---|
| GDPVal-AA-V2(実務タスク) | 28.47 | 25.75 | 15.33 | 18.26 |
| Terminal-Bench 2.1 | 50.98 | 44.38 | 37.22 | 23.46 |
| Tau3 Banking(カスタマーサービス) | 17.01 | 10.52 | 14.02 | 9.48 |
| GPQA Diamond | 86.43 | 83.40 | 79.61 | 75.57 |
| BrowseComp | 66.75 | 48.74 | 26.30 | 36.81 |
| PinchBench | 87.82 | 88.07 | 74.70 | 83.43 |
| AA-Omniscienceの精度 | 16.90 | 19.47 | 22.17 | 16.63 |
| IFBench(指示への追従) | 66.17 | 63.71 | 77.25 | 72.88 |
この3つと比べると、Boltはほとんどの項目で勝っており、2ビットでそれを実現しているのは見事です。ただし、この表には密なモデルであるQwen3.8 27Bが含まれていません。NVIDIA自身の技術レポートのチャートでは、GDPVal v2でBoltの28.5に対して44.5を記録し、速度はおよそ3分の1です。選択肢としては妥当なトレードオフですが、それを知るにはPDFを読む必要があります。
知っておきたい代償が、あと2つあります。
- 2ビットには代償があります。 技術レポートによると、Bolt自身のフル精度の重みと比べて、GDPValは31.13から28.47に、Omniscienceの精度は21.80から16.90に低下します。
- とてもよくしゃべります。 Artificial Analysisが数えた出力トークン数はIndexの1タスクあたり82kで、Super VLの1.8倍、Ultraの2.9倍でした。ローカルでは金銭ではなく時間がかかりますが、時間は時間です。
実際のハードウェアではどれくらい速いのでしょうか?
NVIDIA自身の速度表は、公開時の投稿よりも控えめです。研究ページによると、RTX Spark上のllama.cppでBoltは毎秒83.99トークンで動作します。対してQwen3.6 35B-A3Bは96.63、Gemma 4 26B-A4Bは100.56、Qwen3.8 27Bは28.26です。つまり、精度で上回る小型の混合エキスパートモデルよりは遅く、精度で負ける密なモデルよりは約3倍速いということです。
より大きなカードを使うユーザーは、はるかに高い速度を得ています。
"343 tok/s median with the LiLiCorr drafter (DFlash, n_max 6, about 55% of drafted tokens accepted), 166 tok/s without it. 25.0 GiB at 32K with the drafter and the projector, 22.7 GiB without the drafter."

これはRTX 5090での結果です。視覚機能とドラフターを読み込むと25GBになる点にも注目してください。16GBのカードでは、モデルの一部をシステムメモリにオフロードすることで、毎秒約45トークンだったというユーザーの報告があります。Macユーザーにとっては、今のところさらに厳しい状況です。
"Nemotron Bolt appears to be really quite good but unfortunately it is quite slow on macOS/Metal in llama.cpp at the moment because of lack of support for a tensor type (or something… not sure I understand)."

Nemotron 3.5 Boltの費用はいくらでしょうか?
重みは無料で、料金表はそれで全部です。2026年10月27日時点で、どちらのBoltモデルにも有料のホスト型APIはありません。OpenRouterにもDeepInfraにも掲載されておらず、NVIDIAの74Bモデル用build.nvidia.comページは404を返します。Artificial Analysisにも“No publicly available API.”と記載されています。
| 利用方法 | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| オープンウェイト | 無料、OpenMDW-1.1 | 無料、OpenMDW-1.1 |
| NVIDIAによるホスト | 利用不可 | NVIDIAのAPI Trial Termsに基づく無料トライアル用エンドポイント |
| OpenRouter、DeepInfra | 掲載なし | 掲載なし |
| ローカルダウンロード | 22GB(2ビットGGUF) | 6.18GB(4ビットGGUF、Unsloth) |
| 実行に必要なメモリ | 24から32GB | 約4GBのビデオメモリ |
トークン単位で支払いたいなら、兄弟モデルはホストされています。OpenRouterでは、Super VLは入力100万トークンあたり$0.15、出力は$0.50、Lightningは$0.07と$0.20で掲載されています。ホスト型を使う予定なら、私のサポートチケットに最適なAIモデルのガイドでは、Claude Haiku 5.5やGemini 3.8 Flashなどのクローズドな選択肢も比較しています。
費用の話のもう半分はライセンスで、これは良い内容です。OpenMDW-1.1は“without restriction,”での利用を認め、出力への制限はなく、ユーザー数の上限も利用許諾ポリシーもありません。再配布する際には通知を保持し、モデルが特許または著作権を侵害しているとして訴えた場合は権利が終了します。Redditのあるコメント投稿者は“an Apache styled license,”と呼んでいましたが、ほぼそのとおりです。
どうやって動かすのでしょうか?
公開初日のリリースとしては、多くの選択肢があります。NVIDIAとパートナーは以下を提供しました。
- Ollama:
ollama run nemotron-3.5-boltで、256Kコンテキストと画像入力に対応した25GBビルドを取得できます。Ollamaには、Claude Code、OpenCode、Hermes Agent、OpenClaw用の1行ランチャーも掲載されています。 - llama.cpp: NVIDIA自身のGGUFに加え、別ファイルのドラフターがあります。NVIDIAによると、このビルドは“optimized for use on RTX Spark with llama.cpp and DGX Spark with vLLM.”とのことです。
- vLLM: ナイトリービルドが必要で、現時点ではBlackwell世代のGPUにのみ対応しています。
- LM Studio、Unsloth、Canonicalのsnapも選べます。
本命のユースケースは、ローカルのエージェント実行基盤として使うことです。NVIDIAは、クラウドに作業を送ることなく、“from researching the web to writing to debugging code,”というプロジェクトをBoltに任せることを提案しています。最も気に入っているユーザーは、明確なゴールのある限定的な仕事を与えています。
"I really don't hate this model. I was expecting to, it's a 2 bit quant for fucks sakes, but it seems to do really well when it's got some tools, a defined goal and a success condition such as 'compile works and tests pass'."
初期のテスターは何と言っているのでしょうか?
r/LocalLLaMAでの反応は好意的ですが、限界も明確です。4つのテーマが繰り返し登場しました。
2ビットの工夫は予想以上にうまく機能します。 あるコメント投稿者は“74GB QAT coming in at 24GB on disk”を“pretty incredible”と評し、“has a decent chance of retiring Qwen3.6-35B for some people.”と述べています。別のユーザーは仕事でFAXの取り込み処理に使っており、以前の視覚モデルとの直接比較で勝ったそうです。
実務では密なモデルであるQwen 3.8 27Bを下回ります。 私が見つけた中で最も入念なテストでは、RTX 5090で33件のインフラタスクを実行していました。
"26 of 33 passed, with the LiLiCorr drafter on. On the same tasks the same day qwen3.8:27b passed 32, qwen3.6:27b 31, gemma4:31b and glm-4.7-flash 29, qwen3.6:35b and gemma4:12b 27."
別のテスターはGemma 31Bと36件のブラインドタスクで比較し、Boltについて“about 3.5 times faster, but it made up more problems that weren't there.”と述べています。
よく探索します。 同じ33タスクのテスターによると、ツール呼び出しの54%は調査や診断で、その特徴を“Careful, and expensive in turns.”とまとめていました。別のユーザーは、AGENTS.mdファイル内のDockerに関する指示を無視するのを確認しています。
安全性には大きな疑問が残ります。 顧客に接するものでは、これが最も重要です。
"It is not safe for an agent; it failed 6/21 jailbreak tests. Qwen3.8 Flash and 27 B failed none."
これは1人のテストですし、同じスレッドの返信には妥当な反論もありました。“If you're relying on model weights to protect you from hostile content, you're doing it wrong.”。どちらも正しいです。
Bolt E4Bはどうでしょうか?
音声やデバイスの製品を作っているなら、注目すべきはBolt E4Bです。NVIDIAのE4Bページでは、従来の4Bモデルと比べて“~40% higher average quality”、また“up to ~80% fewer tokens vs peers,”とうたい、音声アシスタントの用途に“customer service”を挙げています。読み上げられる程度に返信を短く保つ会話モードがあり、35言語に対応しています。
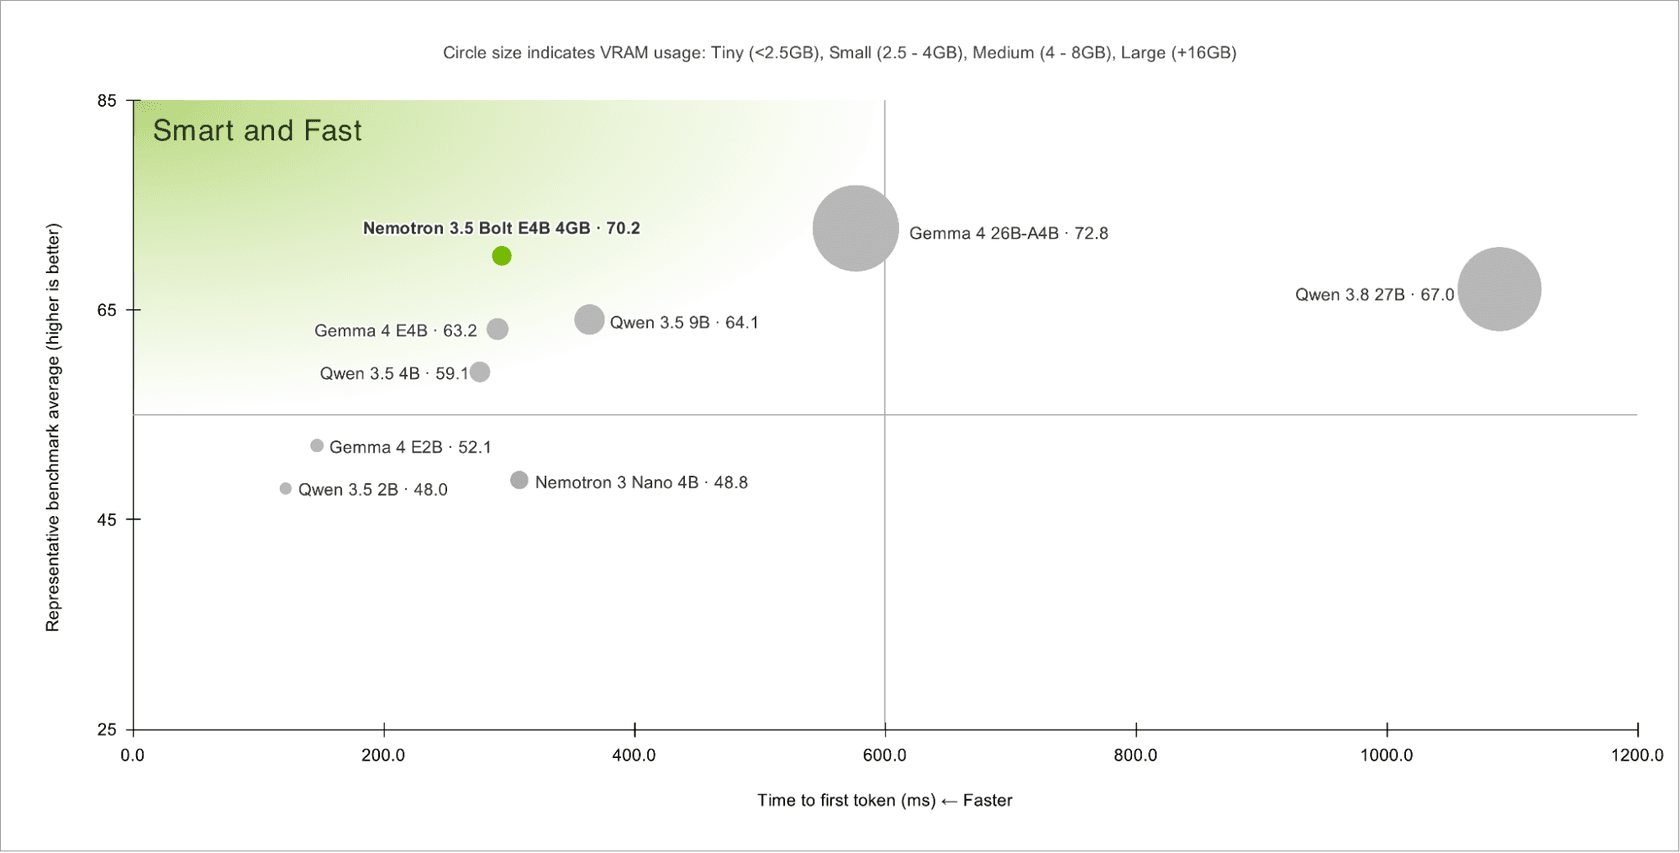
高速です。RTX 5070では最初のトークンを548ミリ秒で返し、3.5GBのビデオメモリを使って毎秒133.4トークンで動作します。Jetson Orin Nanoでさえ、毎秒15.5トークンを達成しています。
ベンチマーク表ではほとんどの項目で勝っていますが、サポートチームが注目すべき項目が1つあります。
| ベンチマーク | Bolt E4B | Qwen 3.5 4B | Gemma 4 E4B |
|---|---|---|---|
| IHEval(指示の階層) | 84.8 | 60.6 | 67.0 |
| RoleMRC | 80.6 | 65.8 | 74.6 |
| RAGTruth F1 | 77.6 | 75.6 | 77.0 |
| BFCL-v3(ツール呼び出し) | 68.5 | 70.9 | 66.4 |
| Tau2-Bench(顧客対応タスク) | 55.1 | 75.1 | 38.5 |
Tau2-BenchではQwen 3.5 4Bが20ポイント上回っています。これは、エージェントが企業ポリシーに従って顧客の依頼に対応する状況をシミュレーションするベンチマークです。カスタマーサポート向け音声エージェントを作るなら、両方をテストしてください。
Nemotron 3.5 Boltはカスタマーサポートに向いているのでしょうか?
サポートのある部分には向いていますが、一般に想像される部分にはリスクがあります。
向いている部分: データを社内に保つこと。 制限の少ないライセンスで1台のマシン上で動くモデルは、「私たちのデータはどこへ行くのですか?」という問いに明快に答えられます。チケットの要約、分類、担当者が確認する返信の下書きなどの社内作業では、ローカルのBoltは妥当なエンジンです。また、Tau3 Bankingスコア(17.01)はNVIDIAの表にあるすべての比較対象を上回っています。
リスクのある部分: 顧客に直接回答すること。 銀行のカスタマーサービスのベンチマークで17%というのは、絶対値としては依然として低い水準です。報告された21件中6件というジェイルブレイクの失敗率と、追加のツール呼び出しで探索する傾向を合わせると、顧客と話す前に多くの周辺の仕組みが必要なモデルだといえます。顧客からのメッセージは、すべて信頼できない入力です。
その周辺の仕組みが何をすべきかこそ、私が日々取り組んでいる部分です。eeselは早い段階で、間違った詳細を伝えることは、答えがないことより悪いと学びました。そのため、AIが実際の顧客に返信する前に、すべての導入で過去のチケットを使ったシミュレーションを行っています。公開している顧客事例の1つである産業オートメーション企業は、自社の技術文書だけを基にエンジニアへ回答し、それぞれの回答の出典を示すチャットを運用しています。そこでは、答えが見つからないことも受け入れられる結果です。これは重みの特性ではなく、モデルを取り巻くシステムの特性です。サポートでAIのハルシネーションを防ぐ方法のガイドで、ガードレールについて詳しく説明しています。
ですから、私の結論はこうです。エンジニアがいて、24GB以上のNVIDIA GPUがあり、データをローカルに保つ理由があるなら、Boltには週末を使って試す価値があります。月曜日にZendesk AIのキューへつないですぐ使うものではありません。代わりに既製のツールを比較しているなら、私がまとめたAIヘルプデスクソフトウェアから始めてください。
Nemotron 3.5 Boltを使うべきなのは誰でしょうか?
私なら、こう判断します。
- 1枚のGPUでローカルのコーディングエージェントやリサーチエージェントを動かしている方。 これはまさにBolt 74Bが作られた目的です。ツールと明確な成功条件を与えてください。
- データをクラウドに出せない方。 規制対象のデータ、外部AI処理業者の利用を禁じる契約、あるいは飛行機内のノートPCなどです。ライセンスと24GBというメモリ使用量によって、採用を正当化しやすくなります。
- 音声、ゲーム、デバイスの製品を作っている方。 Bolt E4Bは、速く、小さく、短く話すように設計されています。
- 24GBに収まる最も賢いモデルが欲しい方。 まずQwen3.8 27Bを検討し、約3倍遅いことは受け入れてください。あるいは、Qwen3.8 Flash-NextやDeepSeek V4 Flashのホスト型を使いましょう。
- 今週中にホスト型APIが必要な方。 Boltにはありません。代わりに、OpenRouterで利用できるNemotron 3.5 Super VLを使ってください。
eeselを試す
Nemotron 3.5 Boltはインフラです。無料の重み、GPU、そしてセットアップに使う週末です。それでも、検索、エスカレーションのルール、テスト、監査証跡は自分で構築する必要があります。eeselは従業員です。私たちのAIヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgiasなどに接続し、過去のチケットとヘルプセンターから学び、自社のナレッジだけを基に回答します。顧客に1件でも返信する前に、数百件の過去のチケットで実行し、どのように回答したかを確認できます。
Dokument 24はZendesk上でこのように運用しています。1か月で、このチームメイトはチーム向けに680件のチケットを準備し、そのまま送信するか編集できるデンマーク語の返信下書きを670件、内部メモとして残しました。

ローカルモデルを扱うようにターミナルからエージェントを操作するのが好きなら、eesel CLIで同じチームメイトを操作できます。継続的に適用される指示の閲覧や編集、人間の承認待ちアクションの一覧表示、各実行のアクティビティログの確認ができ、JSON出力と書き込み時のドライランにも対応しています。そのため、Claude Codeのようなコーディングエージェントが、リポジトリと一緒にサポートのチームメイトも管理できます。チケットへの回答ではなくコンテンツを書くなら、同じラインアップにはAIブログライターもあります。
無料で始められます。このために24GBのカードを買う前に、先月のチケットでeeselを試してみてください。プランは料金ページで確認できます。