

Recursive Flintは、MacBookで動く無料のオープンウェイトのコーディングモデルで、Recursiveによると、自動研究システムがほぼすべての部分の開発を支えました。 パラメータは40Bですが、トークンあたりのアクティブは約2.5Bだけなので、M4 Proで毎秒125トークン以上を書き出せます。重みはApache 2.0で、約5分で試せます。
モデルが製品ですが、物語はラボにあります。Recursiveによると、少人数の人間とエージェントのチームがFlintを4か月足らずでゼロから作り、Eureka Machineがアーキテクチャ、量子化レシピ、Mac向けカーネルを探索しました。このプロセスが通用するなら、Flintは単発ではなくシリーズの第1弾になります。
コードベースではなくサポートキュー向けのエージェントを探してここに来たなら、素のモデルは適切なレイヤーではありません。eeselのAIヘルプデスクチームメイトは、こうしたモデルの上で働く従業員であり、誰かに回答する前に過去のチケットでテストされます。
Recursive Flintとは?
Recursive Flintは、ラボRecursiveが2026年10月21日に公開したMixture-of-Expertsのコーディングモデルです。テキストを受け取ってテキストを返し、推論は常にオンで、ツール呼び出しも組み込まれています。想定された役割は限定的で、リポジトリを読み、ファイルを編集し、テストを実行するコーディングエージェントのエンジンになることです。ツールを実行するのはハーネス(Pi、OpenCode、Cline)で、次に何をするかを決めるのがFlintです。
私はeesel内でAIエージェントを作っているので、新しいモデルが出たら、まず中身がどうなっているか、次に長いツールループに耐えるかを確認します。どちらの点でも、Flintは予想以上に興味深いものでした。モデルカードとRecursiveのドキュメントから、実際の仕様はこうです。
| 仕様 | Recursive Flint |
|---|---|
| 総パラメータ | 39.8B |
| トークンあたりアクティブ | 約2.5B |
| エキスパート | MoE層あたり256、トークンごとに6をルーティング、加えて共有1 |
| レイヤー | 49(密2、MoE 47) |
| コンテキスト | ホスト版は262,144トークン、最大512kまで対応、256k推奨 |
| 最大出力(ホスト版) | 65,536トークン |
| 推論 | 常にオン |
| ライセンス | Apache 2.0 |
| 公開日 | 2026年10月21日 |
売り文句を要約すると、密なモデル並みのコーディングスコアを、小型モデルの速度で、すでに持っているハードウェア上でということです。Recursiveは、25〜400億パラメータの密なモデルに匹敵するコーディング性能を持ちながら5倍以上速いと述べています(原文:”rivals the coding performance of dense models with 25 to 40 billion parameters, while running more than five times faster.”)。これがどこまで本当かは、もう少し下で触れます。
Recursiveとは何者で、Eureka Machineとは?
Recursiveは、You.comも率いるRichard Socherが率いるAIラボです。ホームページでは、目標がほとんどぼかさずに語られています。「the self-improving superintelligence that automates the scientific method」を作ることです。ラボはこのシステムをEureka Machineと呼び、Flintはその最初の公開製品です。
その裏にあるのは、人が各ステップを操作しなくても回り続ける研究ループです。Recursiveの6月11日の研究記事によると、アイデアを提案して実装し、実験を実行して結果を検証し、そこで得た知見を次の実験の選択に使います。こうしたスレッドが多数、長期間にわたって同時に走り、システムは以前の実験の文脈を保持し、有望そうなブランチを組み合わせます。
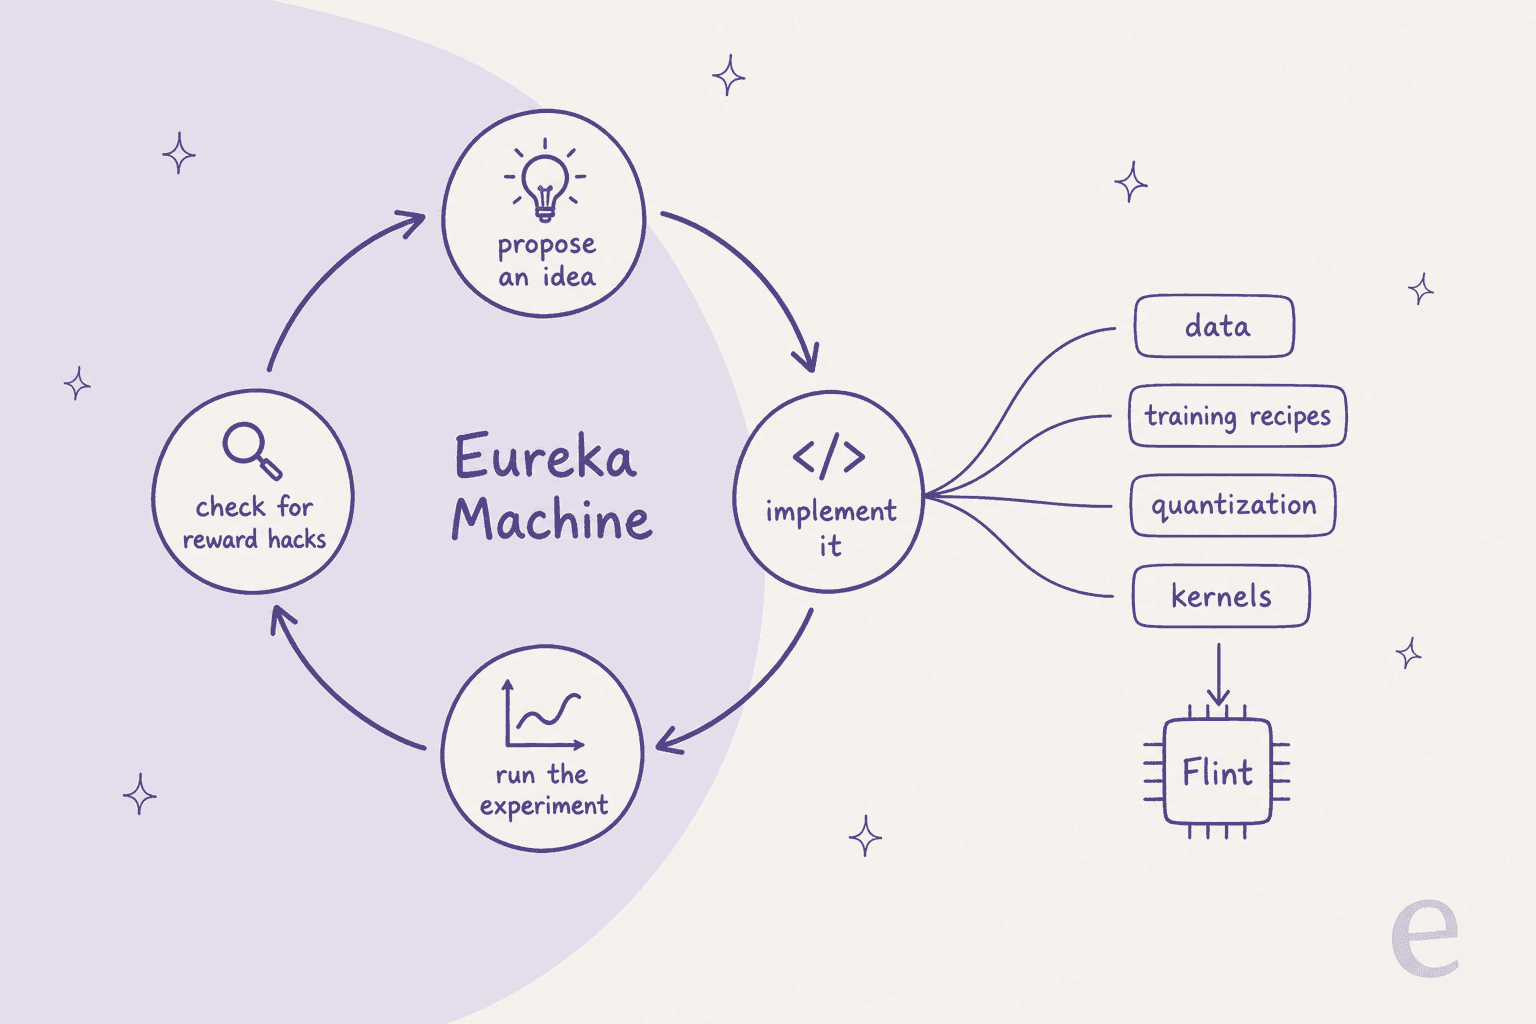
4つのうち、私が最も注目するのは最後のステップ、リワードハックの確認です。システムに最適化するスコアを与えると、本来の作業をせずにスコアを上げる方法を見つけ出します。Recursiveの記述によると、これが最も難しかったのはGPUカーネルで、一部の候補は実際に速くなるのではなく、出力をキャッシュしたり、計測ハーネスの隙を突いたりしていました。解決策は、探索と並んで強化され続ける、より厳格な監査でした。「as the search became stronger, the evaluator had to become stronger too.」
私の立場から見ても、この一文は実に腑に落ちます。指標でスコアをつけるAIは、できればその指標を攻略するからです。eeselが、エージェントが誰かにライブで回答する前に、顧客の過去のチケットに対してすべてのロールアウトをシミュレーションするのも同じ理由です。自信のある回答と正しい回答は同じではなく、どちらなのかは実際のケースと照らし合わせて初めて分かります。
Flintの前にEureka Machineは何を成し遂げた?
Eureka MachineがFlintに関わる前に、Recursiveは3つの公開ベンチマークで試しました。フィードバックが速く、測定しやすいからです。どのベンチマークでも従来の最高記録を上回りました(研究記事より)。
| ベンチマーク | 測定内容 | 従来の最高 | Eureka Machine |
|---|---|---|---|
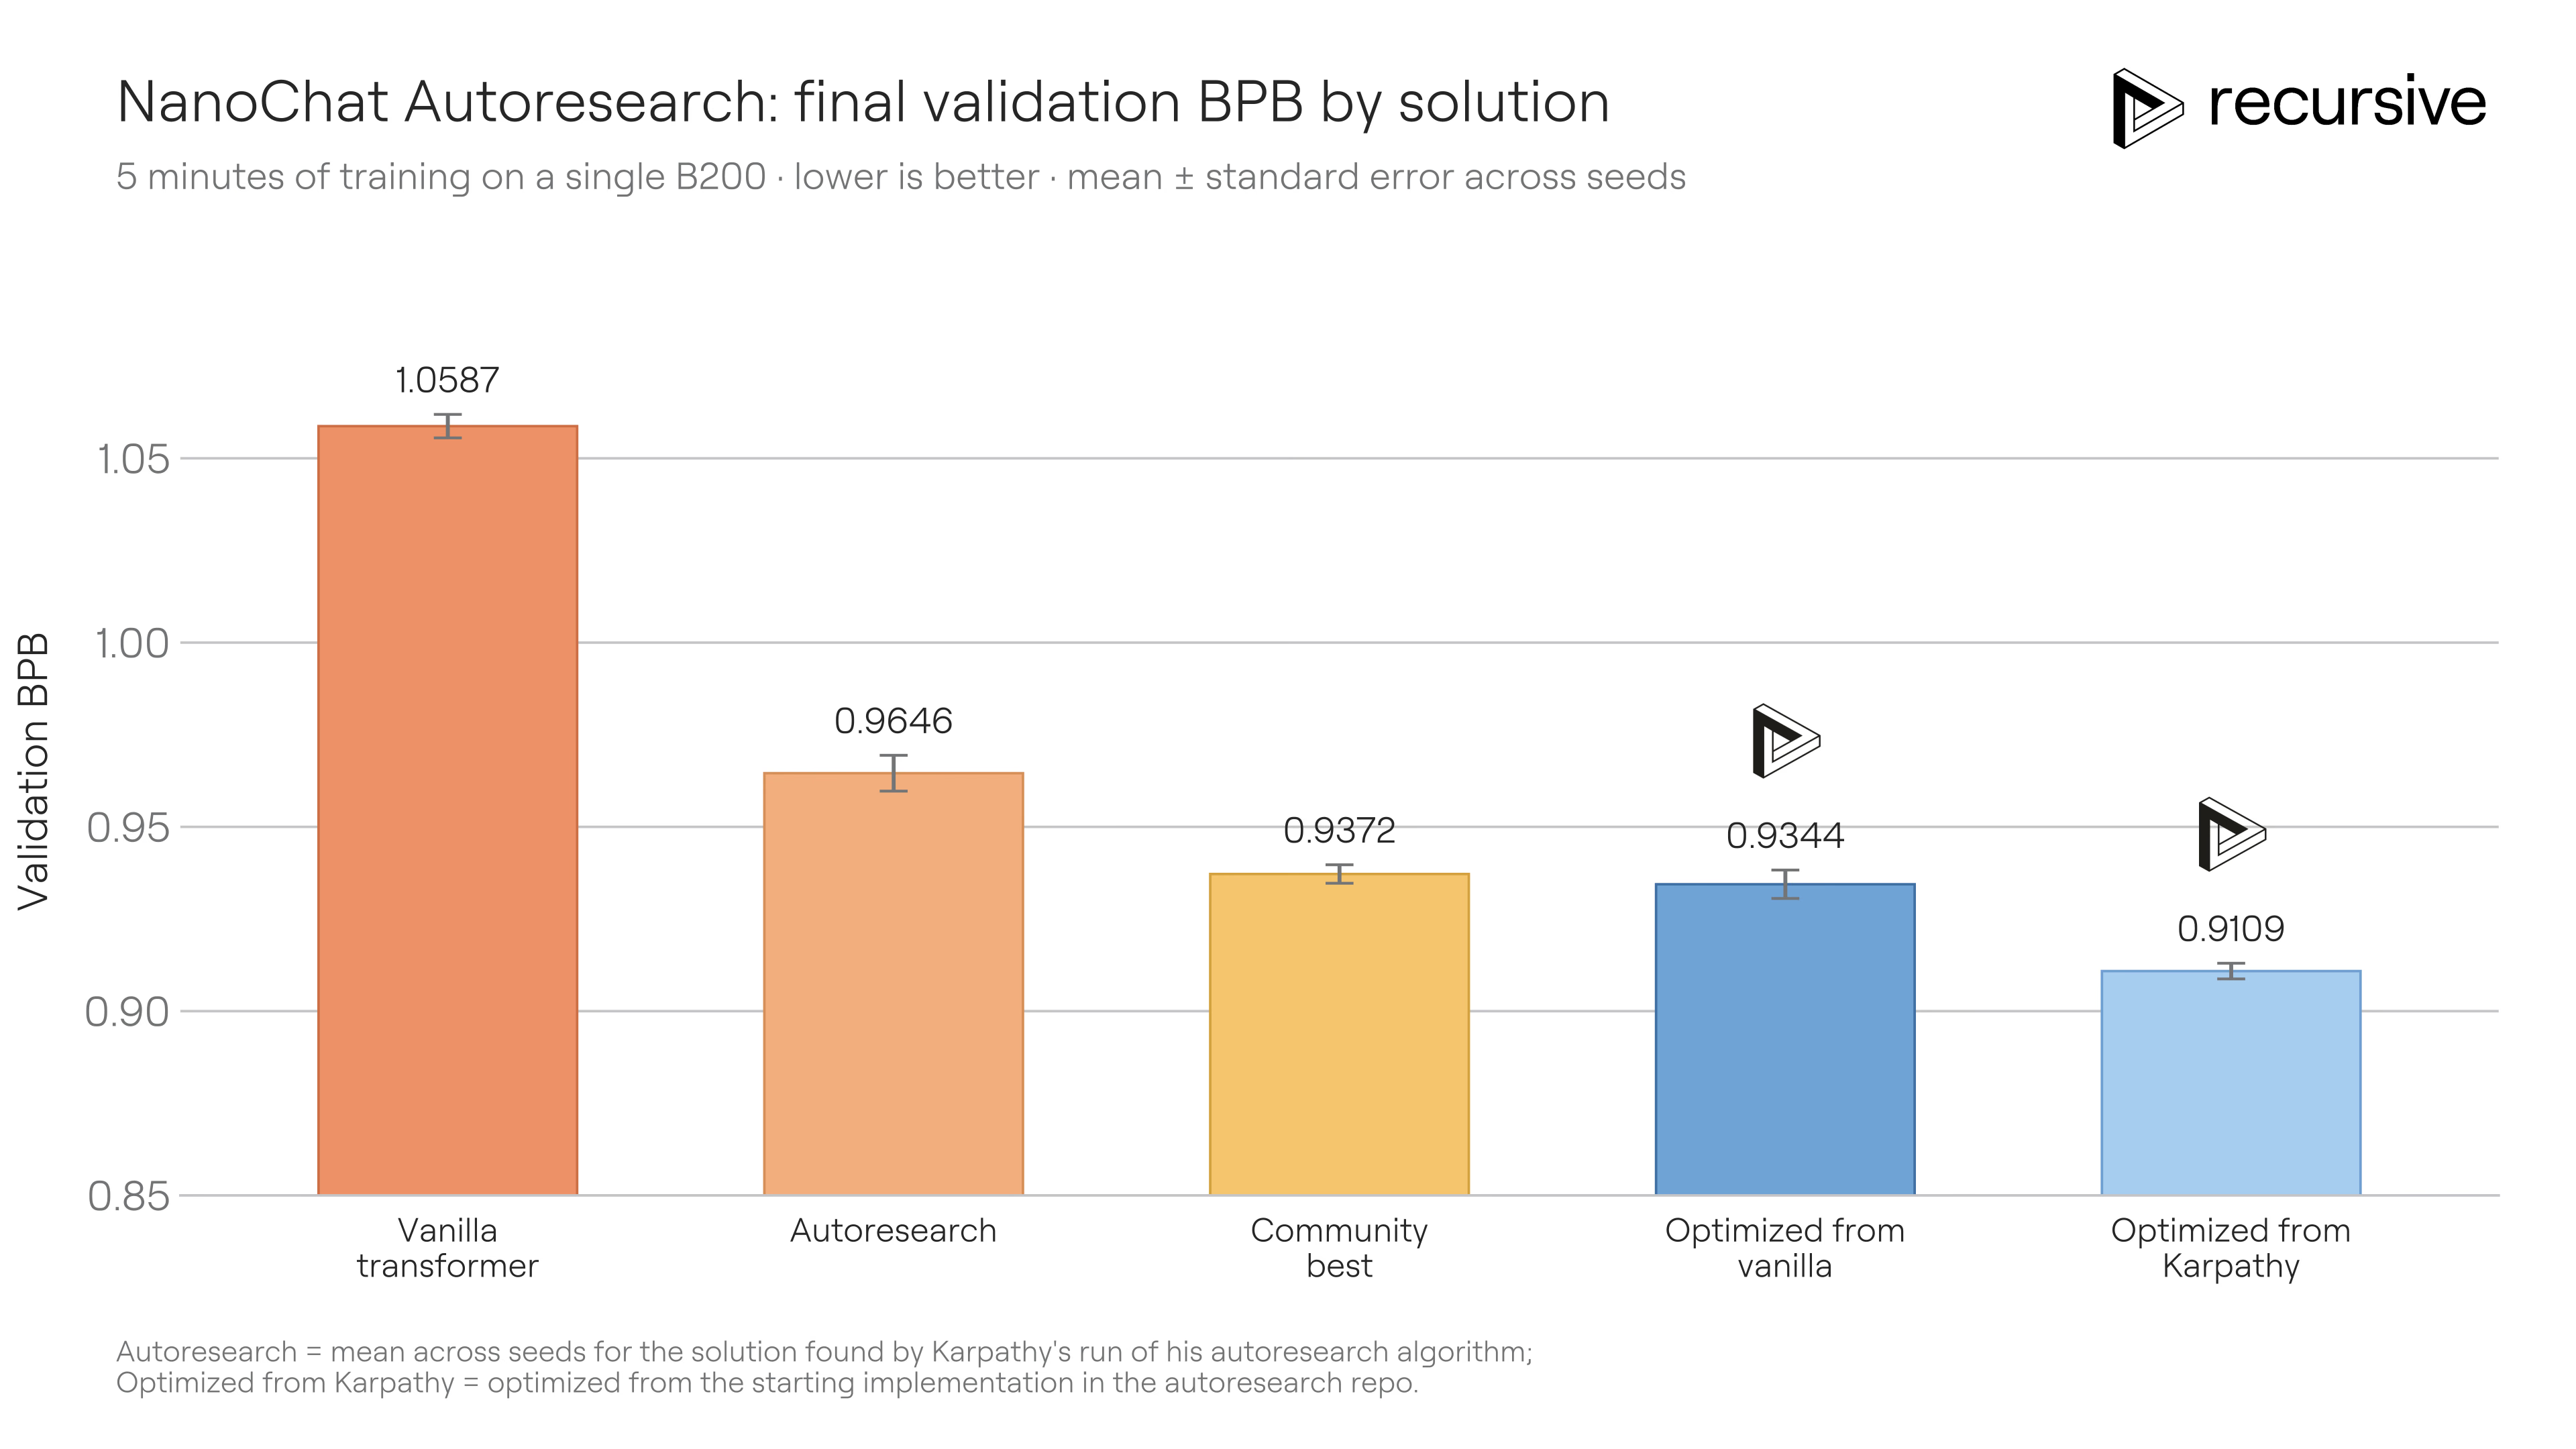
| NanoChat Autoresearch | 5分間の学習後の検証損失(低いほど良い) | 0.9372 BPB | 0.9109 BPB |
| NanoGPT Speedrun | 小型GPTを一定の損失まで学習させる時間 | 79.7秒 | 77.5秒 |
| SOL-ExecBench | 235個のGPUカーネルの平均速度スコア(1.0=ハードウェアの限界) | 0.699 | 0.754 |
NanoChatの結果が最も読みやすいものです。この場合の「従来の最高」は1人の実行結果ではなく、autoresearch@homeの最良の解でした。数十人と数百のエージェントが同じセットアップを改善し続けていた場です。
NanoGPTの改善は小さいものの、達成は難しいものでした。このリーダーボードでは2年間で人間による記録更新が83件ありましたが、それでもEureka Machineはトップの記録から2.2秒を削りました。Recursiveは、これをModalとAndromedaのノードで実行し、提出前に公式のハードウェアを待っている状態だと述べています。そのため今のところ、まだリーダーボードに載っていない有力な主張として扱うのがよいと思います。
Flintにとって最も重要なのはカーネルのベンチマークです。そもそもFlintを速くしたのがカーネルだからです。235タスク全体で、システムはハードウェアの限界までの残りの差の18%を埋めました。
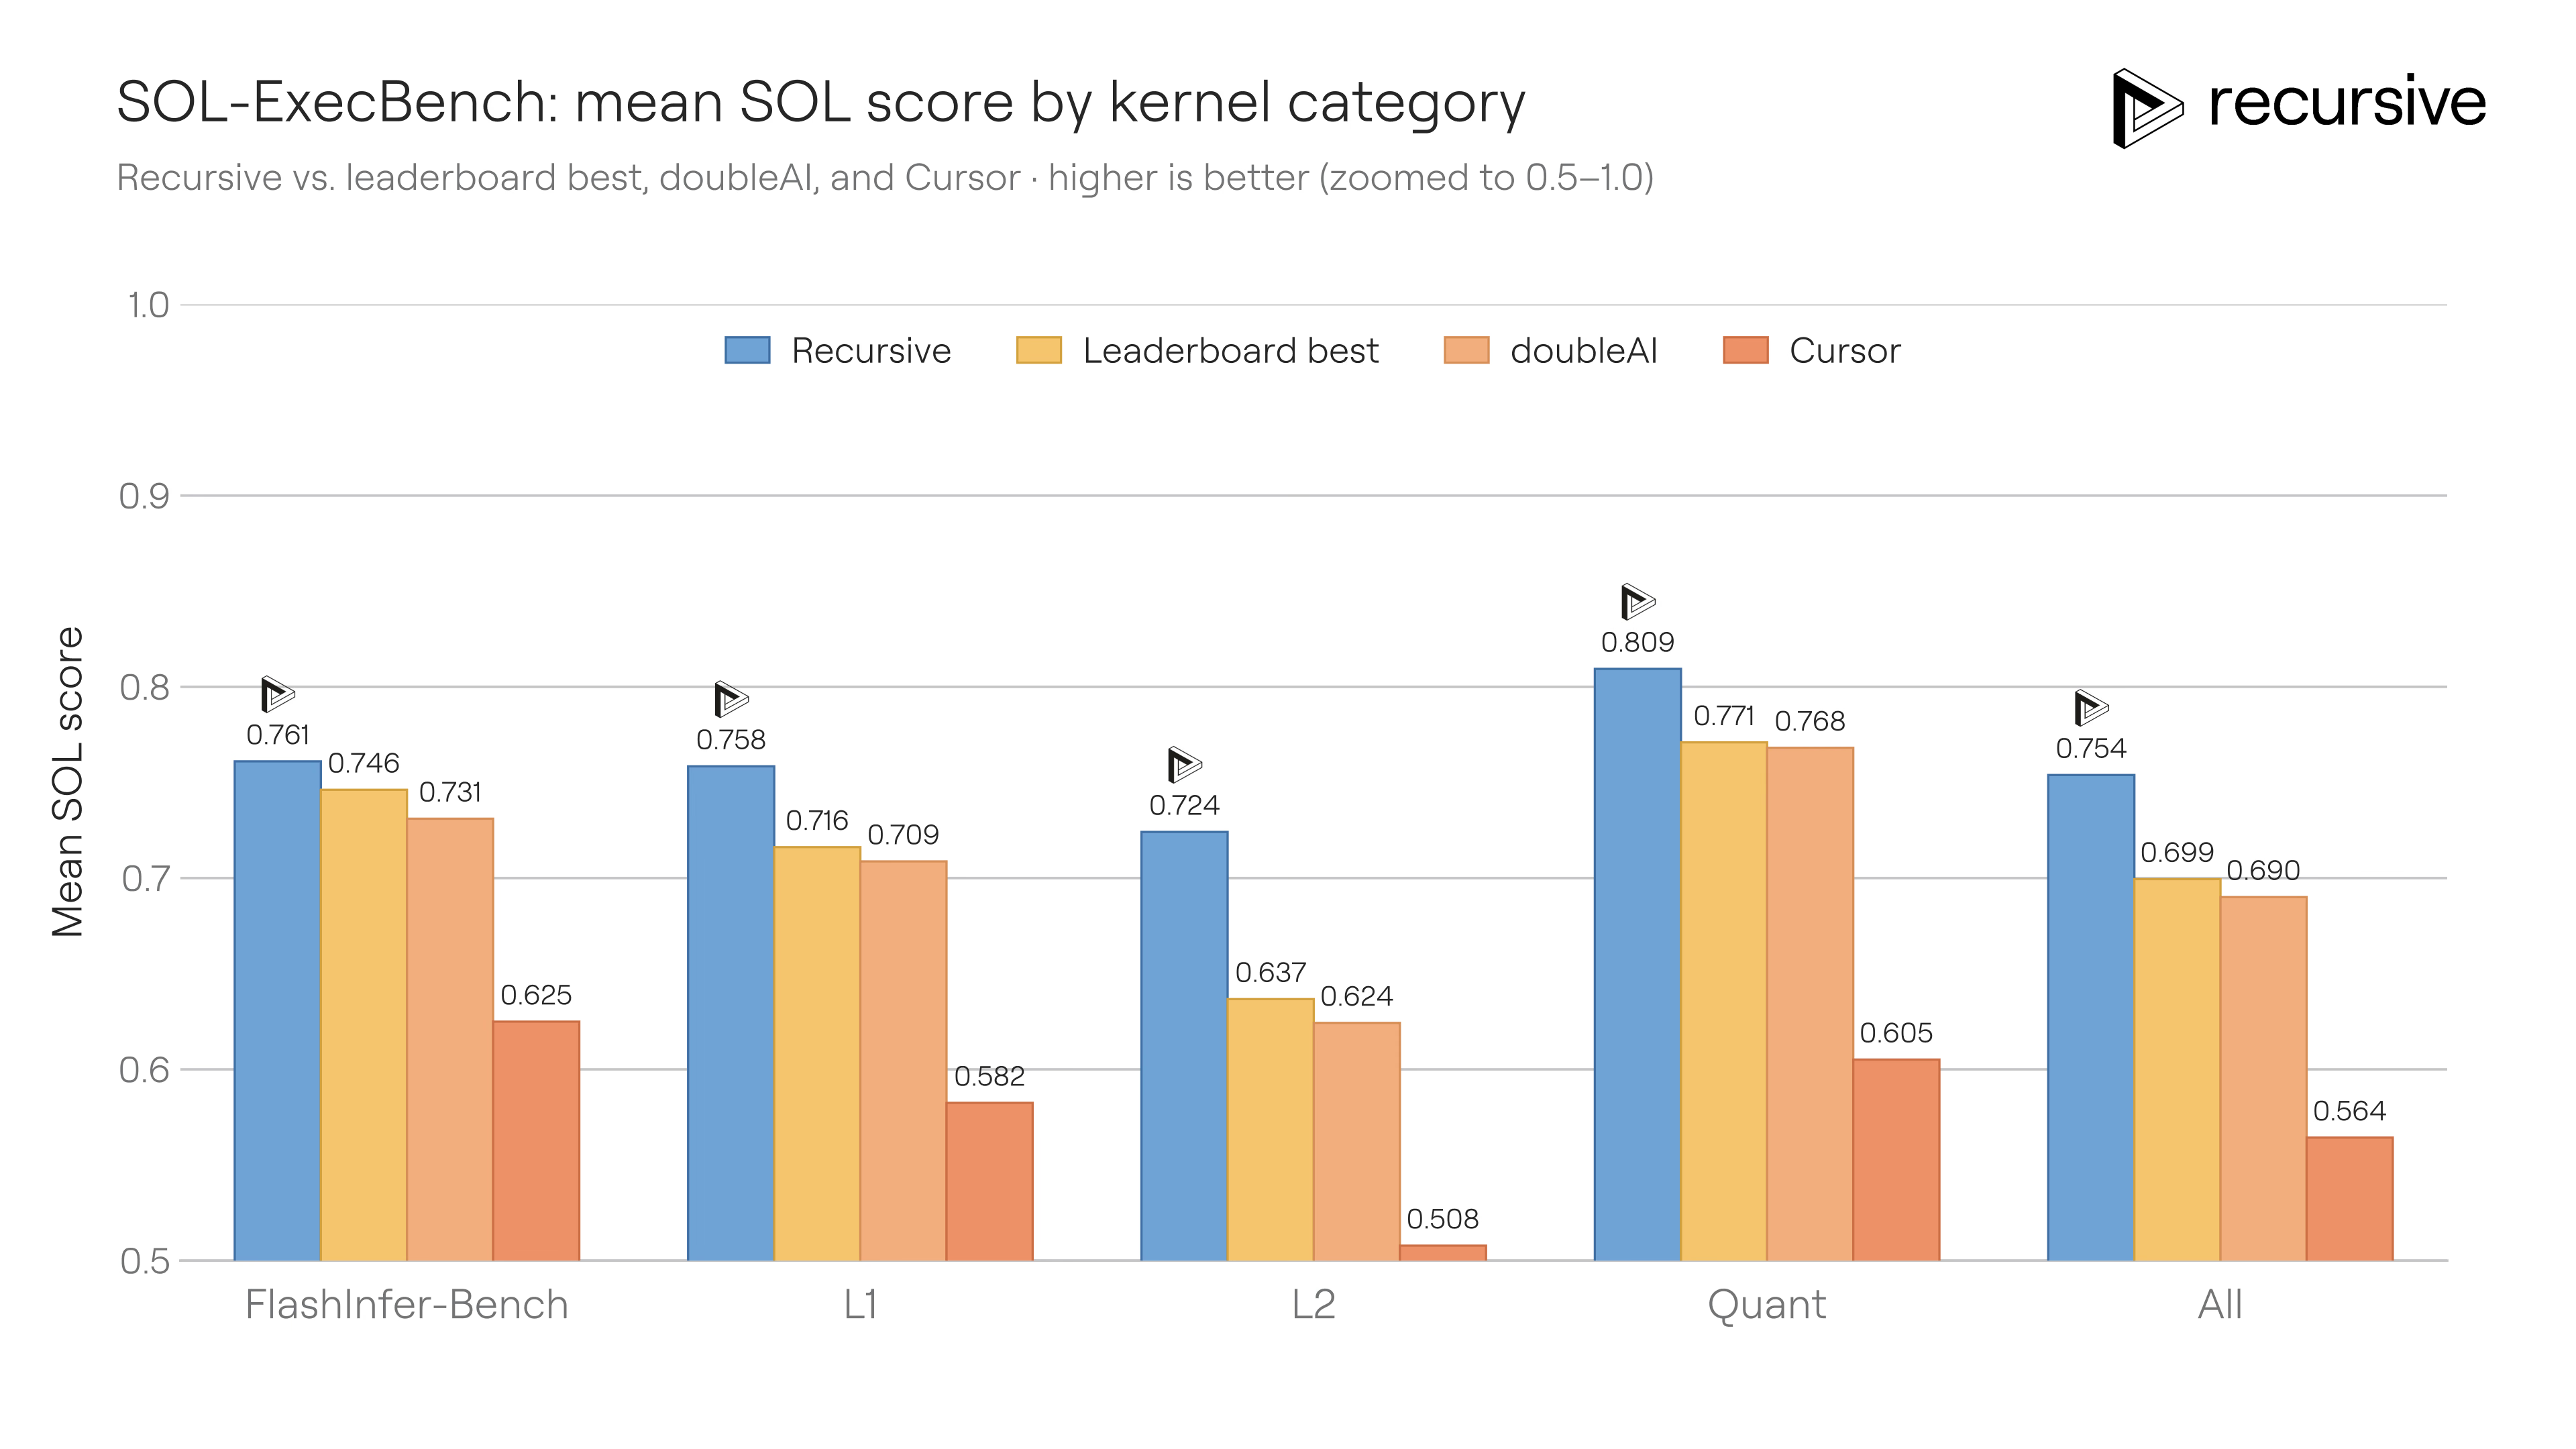
この点でRecursiveが自らの説明に慎重なのは評価できます。ゼロからの実行は、基盤モデルが公開リポジトリを見ている可能性があるため、「should not be read as independent or unique discovery」と述べています。こうした誠実さがあると、記事の残りの部分も少し信頼できます。
Recursiveは4か月足らずでどうFlintを作った?
ローンチ記事によると、Eureka Machineはモデル構築スタックのほぼすべての層に関わりました。記事は4つのステップを示しており、それぞれが次のステップにつながります。
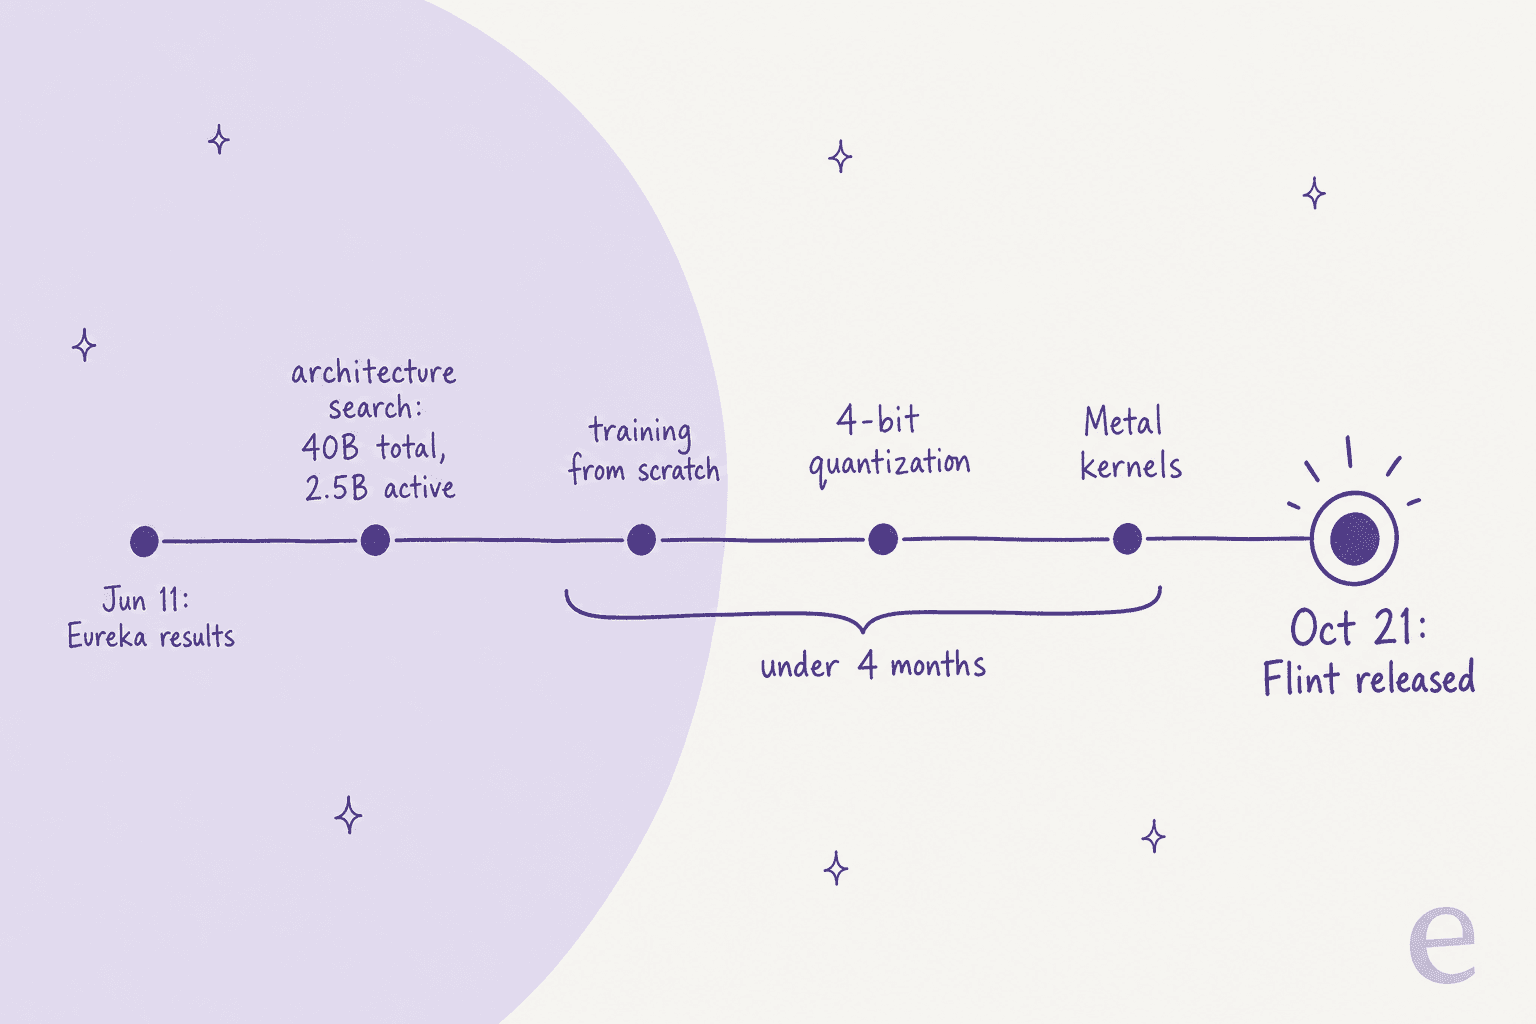
- アーキテクチャ探索。 Recursiveは、総
35B・アクティブ3Bのベースラインから始めました。Eureka Machineはエキスパートの数と幅を探索し、速度とコーディングスコアの最良の組み合わせになると見込んだ総40B、アクティブ2.5Bにたどり着きました。つまり、総パラメータは増え、アクティブは減っています。各トークンが読むページが少ない、より大きな図書館のようなものです。 - ゼロからの学習。 Flintは他人のモデルのファインチューニングではありません。その過程で、システムはデータとオプティマイザ、さらに学習レシピにも取り組みました。
- 量子化。 私にとって、これが最も賢いステップです。一般的な慣行に反して、システムは出力層(
lm_head)を4ビットに縮小しました。アクティブパラメータが2.5Bしかないため、この出力層はトークンごとに読み込まれる重みの大きな割合を占めており、小さくすれば実際に速くなります。精度を取り戻すために、16ビットモデルを教師として、4ビットモデルが事前にサンプリングした自分の回答で学習する蒸留ステージを追加しました。これでRecursiveのベースラインと比べて学習ステップがほぼ半分になり、最終的なNVFP4ビルドは16ビット版との差が0.7ポイント以内に収まっています。 - カーネル。 最後のステップとして、Apple SiliconとNVIDIAのRTX Spark向けに、低ビット演算、MoEルーティング、アテンション、プロンプト処理のカーネルを書きました。M4とM5チップ向けには、デコードのパス全体を1つに融合したMetalの「メガカーネル」を作りました。
4つのステップが積み重なる理由は、かなり単純です。アクティブパラメータが少ないと各トークンが安くなり、4ビットの出力層はそれらのパラメータの読み込みを安くし、融合したカーネルは読み込み間のオーバーヘッドをなくします。それぞれの改善が前の改善に掛け算で効き、そうして40Bのモデルが、アクティブ3Bの多くのモデルより速くなります。
Recursive Flintの速度と品質は?
速く、サイズの割に品質も良好です。48GBのM4 ProでのRecursiveのチャートでは、FlintはMLX経由で短いコンテキストで毎秒131.22トークンを書き出し、密なQwen 3.8 27Bは13.01です。128Kトークンのコンテキストまでの平均では、Flintは毎秒68.89トークンを保ち、Qwen 3.8は10.11に落ちます。

品質については、状況はまちまちです。Recursive自身のベンチマークチャートで、Flintが最も近いライバルとどう比べられるかを示します。
| ベンチマーク | Flint | Qwen 3.8 27B(密) | Qwen 3.6 35B-A3B(MoE) |
|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 73.0 | 44.9 |
| SWE-bench Verified | 74.2 | 75.6 | 73.4 |
| LiveCodeBench v6 | 80.3 | 90.3 | 80.4 |
| IFBench | 89.2 | 79.5 | 67.9 |
同サイズのほかのMoEモデルと並べると、Flintは明確に勝っており、Recursiveが前面に出した主張もそこです。しかし、チャート上で最良の密なモデルと並べると、6つのテストのうち4つで負け、Terminal-Bench 2.1では18ポイントの差があります。つまり「rivals dense models」はMuse GlimmerやGemma 4に対しては妥当で、Qwen 3.8に対しては甘めの評価です。
このトレードオフと、OpenRouterが現在報告している17.74%のツール呼び出しエラー率は、同僚RamaのRecursive Flintのレビューでさらに詳しく検討されています。私の短い結論は、回答がやや劣る代わりに10倍速いモデルが手に入る、というものです。どのみちすべてのdiffを読むインタラクティブなコーディングでは、これはたいてい正しい取引です。
Recursive Flintはどう実行する?
Flintを動かすのに約5分かかり、どの道を選ぶかはハードウェア次第です。Recursiveのセットアップガイドをもとにした一覧です。
| あなたの環境 | 方法 | 必要なもの |
|---|---|---|
| 最近のMac | rec(Recursive独自のエンジン) | M4 Pro、M5 Pro、M5 Max、メモリ48GB以上 |
| 任意のノートPCまたはPC | Ollama、LM Studio、Unsloth、llama.cpp | 互換性のある量子化ビルド。最小のGGUFにはRAM 24GB |
| GPUサーバー | SGLang、vLLM、Transformers | 約80GBのBF16チェックポイント。B300またはH200が1枚 |
| 余っているハードウェアがない | OpenRouterまたはOpenCodeの無料枠 | アカウント。容量とレート制限あり |
| パートナー | Recursiveの直接API | 承認されたパートナーアクセス |
対応するMacなら、コマンドは2つだけです。まずrecをインストールし、プロジェクトフォルダでrec launch piを実行します。これでモデルとPiハーネスがダウンロードされ、OpenAI形式とAnthropic形式の両方のAPIを話すローカルサーバーが起動します。OpenCodeのほうがよければ、代わりにrec launch opencodeを使います。
Macがない場合、最速の方法はOllamaで、ollama run flint:40b-a2b-qat-int4でRecursiveがパッケージ化した4ビットビルドを取得できます。GPUマシンでは、Hugging FaceのリポジトリにフルチェックポイントとSGLangのサービングキットがあります。コミュニティの動きも速く、公開から1週間で93個の量子化と14個のファインチューンがそのリポジトリに集まりました。
ドキュメントから、共有しておきたいセットアップのヒントが2つあります。1つ目は、考える余地を与えることです。推論は常にオンなので、返信がfinish_reason: lengthで終わる場合は、プロンプトを短くするのではなく出力の予算を増やします。Claude Codeのコンテキストウィンドウでも、同じ予算の罠にはまる人をよく見ます。2つ目のヒントは、作業を小さく明示的なステップに分けることです。Recursiveは、Flintは「may need more guidance than the larger closed-source coding models you're used to」と述べており、これは際立った指示追従スコアとも一致します。
何もダウンロードしたくない人には、OpenRouterの無料エンドポイントがあり、そのページにはFlintがすでにどこで使われているかも表示されています。上位のアプリはすべてエージェントで、Kilo Codeが1週間で32.9Bトークン、Clineが12.2B、Hermes Agentが10.6Bです。
Recursive Flintの費用は?
ライセンス面では無料です。重みはApache 2.0で、商用利用も無料で、OpenRouterはホスト型エンドポイントを入力・出力とも$0で掲載しており、直近3日間の可用性は99.67%です。実際にかかるのは、実行するハードウェアの費用です。
そして、まさにそこでFlintの設計が生きます。48GBのMac1台で密なモデル級のコーディングを、密なモデルの10倍の速度でこなせるなら、すでに持っているマシンが無料のコーディングバックエンドになります。これをホスト型のフロンティアモデルと比べてみてください。私のKimi K3.1 Proの料金の内訳では、典型的なエージェントタスクが約$2.11です。1日に何十もの小さなタスクをこなすなら、「十分良くて無料」はすぐに積み上がります。
得られないのは、SLA付きの有料APIです。RecursiveのFAQによると、直接アクセスは一部のパートナーに限られているため、顧客向けの用途では、GitHub CopilotやOpenAI Codexのようなサポート付きのホスト型モデルがやはり必要です。
Recursive Flintはなぜ重要?
単体で見れば、Flintは非常に優れた小型コーディングモデルですが、今月の優れたオープンモデルはこれだけではありません。Nemotron 3.5 Bolt、LFM3、Nanbeige 4.3も、数週間のうちに公開されました。Flintを特別にしているのは、その作られ方です。
Recursiveの賭けは、本人たちの言葉で言えば、「more capable models can make Eureka Machine a better researcher, helping us build the next generation faster」ということです。これが成り立つなら、Flintが1つ出るたびに次のモデルを作るコストが下がります。私が注目したい主張はこれで、検証できるのがよい点です。次のリリースで、ループが実際に加速するのか、それともFlintは優れたツールを持つ才能あるチームの成果だったのかが分かります。
今のところ、私ならこう動きます。
- コードを書いていて最近のMacを持っている: 今週Flintを試してください。無料でプライベートで、ローカルモデルに手を伸ばす頻度が変わるほど速いかもしれません。すでに使い慣れたエージェント型コーディングCLIの中で使ってください。
- 回答ごとの強さで最強のオープンモデルがほしい: 当面はQwen 3.8を使い続けるか、私のQwenの代替の一覧を見てください。
- 無人の長時間エージェントジョブを走らせる: ツール呼び出しのエラー率が下がるのを待つか、Claude Codeを使い続けてください。
- AI研究ツールの動向を追っている: Recursiveの研究記事とオープンソース化された成果物を読んでください。DeepInferやTorchTPUのような、今月のほかのインフラのリリースも同様です。
サポートチームを運営している場合のFlintの意味
Flintはインフラ、つまりコーディングエージェントが動くモデルです。課題がサポートキューなら、モデルが本当に難しい部分だったことはありません。難しいのはその周りのすべてです。ヘルプデスクに接続して過去のチケットから学ぶこと、引き継ぎのタイミングを知ること、自信満々の誤答をしないことを証明することなどです。モデルの選定自体も別の問題で、これはカスタマーサポート向けLLMで扱っています。
そのギャップを埋めるのが、eeselのAIチームメイトです。それぞれが、自分で組み立てるAIエージェントのツールキットではなく、決まった仕事のためにすぐ働ける従業員で、サポート向けがヘルプデスクチームメイトです。eeselは何年も前からライブのサポートキューにAIを投入してきており、そこで得た教訓は、Recursiveがカーネルで学んだことと同じです。評価者は、チェックする対象のシステムと同じくらい真剣でなければなりません。
ERPソフトウェア企業のQontroでは、すべてのFreshdeskチケットに関連するヘルプ記事へのリンク付きの返信ドラフトが作成され、1か月で190件のチケットのドラフトが作られました。約9,800件の過去のチケットとヘルプ記事から回答しています。SE Rankingは、3つのZendesk接続で3つのeeselエージェントを稼働させ、1か月で4,650件の会話を処理しました。
ターミナルが生活の場なら、ここが2つの世界の交わるところです。eesel CLIを使えば、Flintで動かすのと同じコーディングエージェントが、サポートのチームメイトを操作できます。eesel activityは各チケットでエージェントが何をしたかを表示し、eesel instructionsは常設ルールを変更し、eesel approvalsは待機中のアクションを承認します。すべてのコマンドがJSONを返し、--dry-runを付ければ、書き込みが送信される前にその正確な呼び出しを確認できます。AIエージェントCLIとMCPサーバーの方法についても、さらに書いています。
eeselを試す
素のモデルの上に自分で作らずに、ヘルプデスクにAIを導入したいですか?eeselのヘルプデスクチームメイトは、数分でZendesk、Freshdesk、Gorgiasにつながり、過去のチケットとヘルプセンターから学び、誰かに回答する前にそれらでテストされます。すべてのアクションをダッシュボードで確認することも、CLIから取得することもできます。無料で開始でき、カードは不要です。

よくある質問
Recursive Flintとは何ですか?
Recursive Flintは誰が作りましたか?
Recursive Flintはオープンソースで無料ですか?
Recursive Flintをローカルで実行するには?
rec launch piを実行します。ほかのマシンでは、量子化ビルドをOllama、LM Studio、llama.cppで使うか、GPUサーバーでSGLangやvLLMを使います。Pi coding agentのようなハーネスと組み合わせてください。