

なぜビジョンモデルが気になるのか
私はeeselのインテグレーション、つまりZendeskやFreshdeskのようなツールからチケット、添付ファイル、ヘルプセンターの記事を取り出すコードを作っています。そこを流れるデータの大半はテキストですが、すべてではありません。今年eeselの営業通話で何度も出た要望があります。技術製品のサポートチームが、PDF内の図や、顧客がチケットに添付する写真をAIに読ませたいというものです。月に約3,000件の複雑なチケットを扱う公共部門のIT企業は、技術文書の大半が画像だと話していました。
そこで、NVIDIAが「グラフ、表、ページレイアウト、動画を読み、ツールを呼び出す1つのモデル」を売りにしたオープンモデルを出したとき、モデルカードを1行ずつ読みました。実際に何が入っているのか、公開時の主張がどこで成り立ち、どこに但し書きが必要かをまとめます。
Nemotron 3.5 Super VLとは?
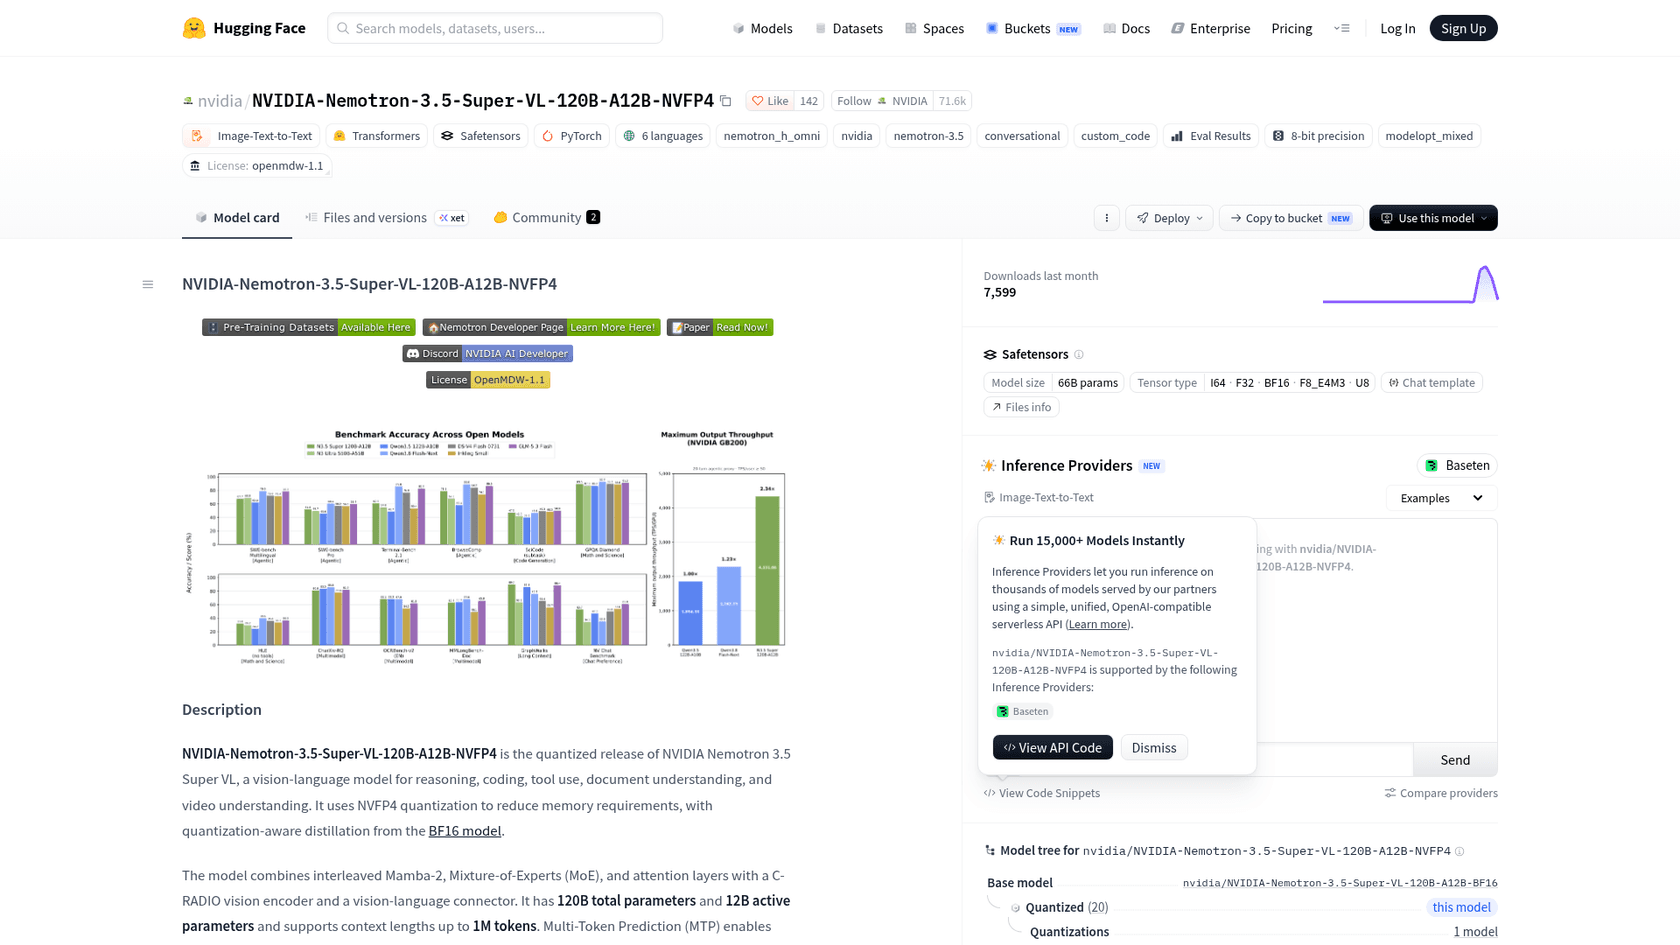
Nemotron 3.5 Super VLは、NVIDIAのNemotron 3.5ファミリーのビジョン言語モデルです。BF16モデルカードは、これを「reasoning, coding, tool use, document understanding, and video understanding」のためのモデルと説明しており、重要なのは1つという点です。テキストモデルを別のビジョンモデルとつなぎ、間でコンテキストを受け渡す代わりに、同じウェイトが両方を扱います。
小さな兄弟モデルが2つ同時に公開されました。NVIDIAの発表によると、Bolt 74B-A9Bはネイティブ2ビット量子化でローカルエージェント向けに24GBに収まり、Bolt E4B(4GB)は音声や組み込み用途向けに10月23日に登場します。
重要な仕様は次のとおりです。
| 仕様 | Nemotron 3.5 Super VL |
|---|---|
| 公開日 | 2026年10月15日 |
| パラメータ | 総計120B、トークンごとのアクティブ12B |
| アーキテクチャ | Mamba-2とTransformerのハイブリッドMixture-of-Experts、MoE層ごとに512のルーティングされたエキスパート |
| ビジョン | C-RADIOビジョンエンコーダとビジョン言語コネクタ |
| 入力 | テキスト、画像(JPEG、PNG)、動画(2分までのMP4) |
| 出力 | テキスト |
| コンテキストウィンドウ | 最大1Mトークン(OpenRouterでは最大出力262,144) |
| 推論 | オフ、中、オン。チャットテンプレートで設定 |
| チェックポイント | Base、ポストトレーニング済みBF16、NVFP4 |
| ライセンス | OpenMDW-1.1 |
モデルカードには「ready for commercial or non-commercial use」とあり、NVIDIAは学習データとレシピも公開しています。ファインチューニングを考えているなら、この点は重要です。Kimi K3やMistral Large 4を含むほとんどのオープンウェイトモデルと違い、何が入っているかを確認できます。
内部の仕組みは?
要点はこうです。GPUあたりで多くの仕事をこなすために作られた中規模モデルです。いくつかの設計上の選択が、速さの理由を説明します。
- ハイブリッド層。 ネットワークは、Mamba-2層(長いシーケンスを低コストで扱うステートスペース設計)を、Mixture-of-Expertsブロックと少数のアテンション層と交互に配置しています。これにより長いコンテキストでのメモリが抑えられ、1台で1Mトークンのウィンドウを保持できます。
- より大きなモデルからの蒸留。 NVIDIAによれば、バックボーンはNemotron 3 Super Baseから始まり、Nemotron 3 Ultra Baseから1Tトークンの蒸留を受けました。120Bのモデルが、一部のエージェントベンチマークで550Bの教師を上回るのはこのためです。
- 組み込みのドラフト生成。 マルチトークン予測ヘッドが複数のトークンを一度に提案し、メインモデルが検証するため、高コストなパス数が減ります。DGX Sparkでは、NVIDIAの別のLiLiCorrドラフターが「up to 2.3x faster token generation」を実現します。
- 大きな損失のない4ビット。 NVFP4チェックポイントは、フル精度モデルに合わせて学習されました。Artificial Analysisの調べでは、指数でBF16と0.1ポイント以内のスコアです。
学習パイプラインはエージェント重視の理由も説明します。256Kコンテキストでの67Bトークンのソフトウェアエンジニアリング中間学習、最大524,288トークンのパックされたシーケンスでの教師ありファインチューニング、その後に強化学習とマルチティーチャー蒸留です。AIエージェントがどう作られるかを追ってきた方なら、長時間でツールを多用する作業向けのモデルに期待される典型的なレシピだとわかるでしょう。
NVIDIAのモデルラインナップでの位置づけ
NVIDIAは、Super VLがすべてをこなすためのものではないと明確にしています。開発者向け投稿では「system of models」を説明しています。Nemotron 3.5 Lightningが大量のテキストタスクを担当し、Nemotron 3 Ultraが計画とオーケストレーションを担当し、Super VLはその中間で、ビジョンとツールが必要な専門的で複数ステップの作業を行います。
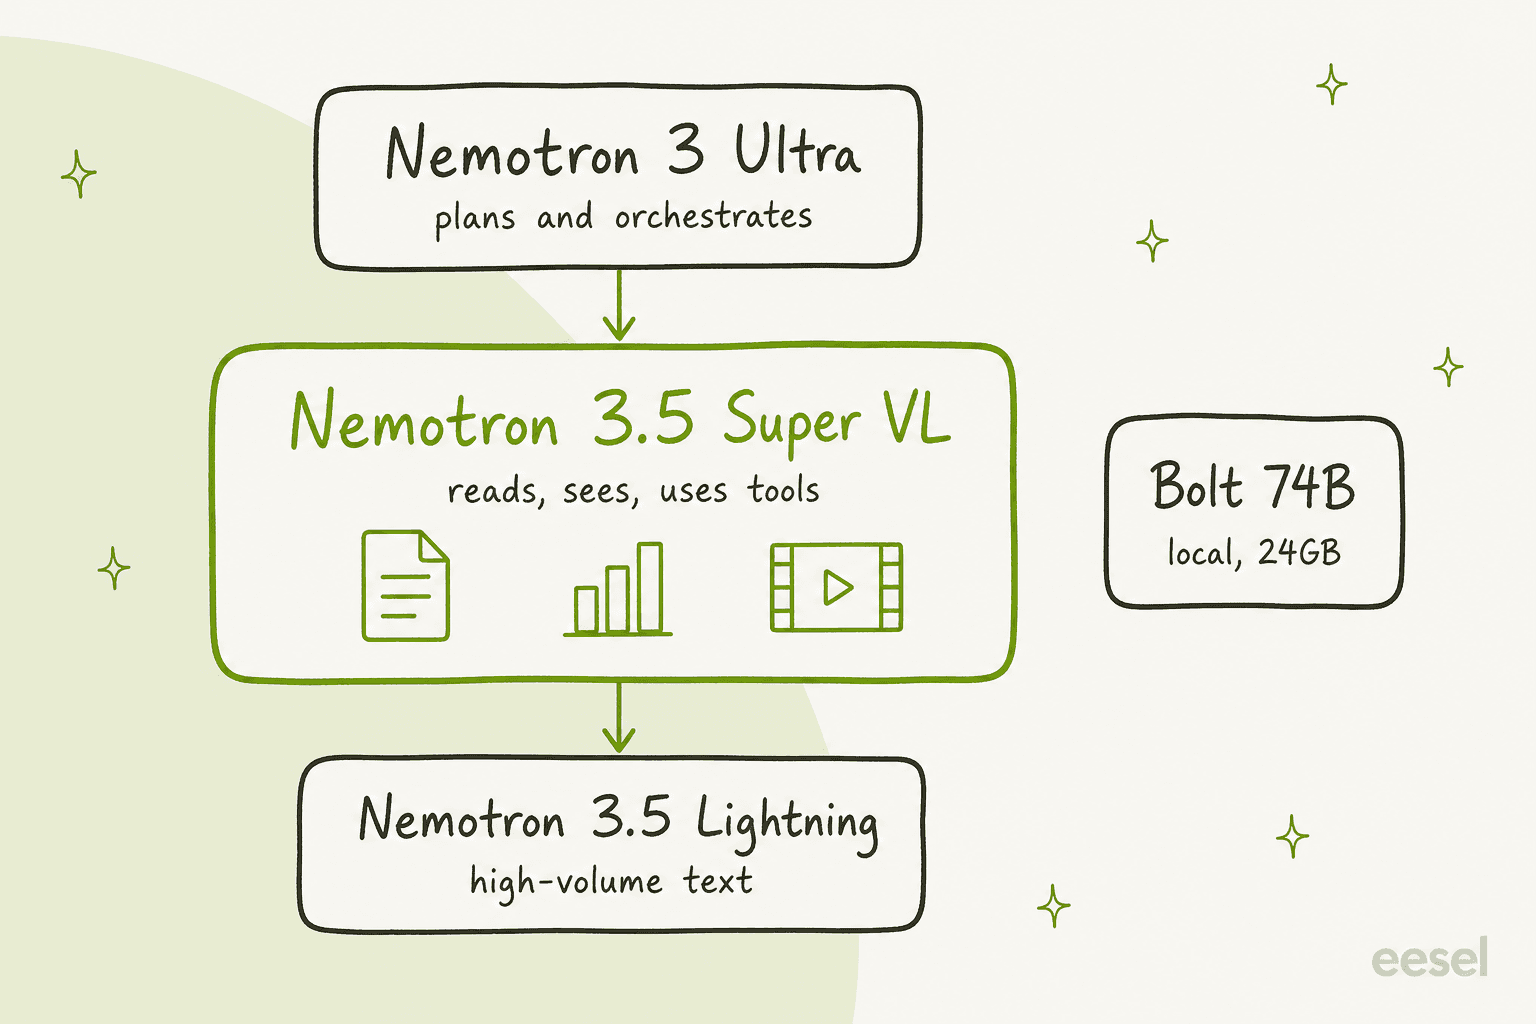
この位置づけは、NVIDIAが想定する使い方を示すので役立ちます。Super VLは、40ページのPDFとスプレッドシートを渡す相手であり、100万件の短いメッセージを分類するための最安モデルではありません。そのようなチケット分類なら、コスト面ではLightningや、Claude Haiku 5.5のような小さなクローズドモデルのほうが適しています。
実際の性能は?
ここでは2つのスコアボードを並べて読む必要があります。
独立したベンチマークサイトのArtificial Analysisでは、Nemotron 3.5 Super VLはIntelligence Indexで26.5、40Bから150Bのサイズ帯のオープンウェイトモデル67個中1位です。前身のNemotron 3 Super(13)の2倍で、Nemotron 3 Ultra(22.9)を上回り、Thinking MachinesのInkling Small(25.7)をわずかに上回ります。出力速度も毎秒409トークンで、同クラス最速でした。
しかし視野を広げると状況は変わります。トークンあたりの価格がほぼ同じで、より大きなオープンモデルのほうがスコアははるかに高いのです。
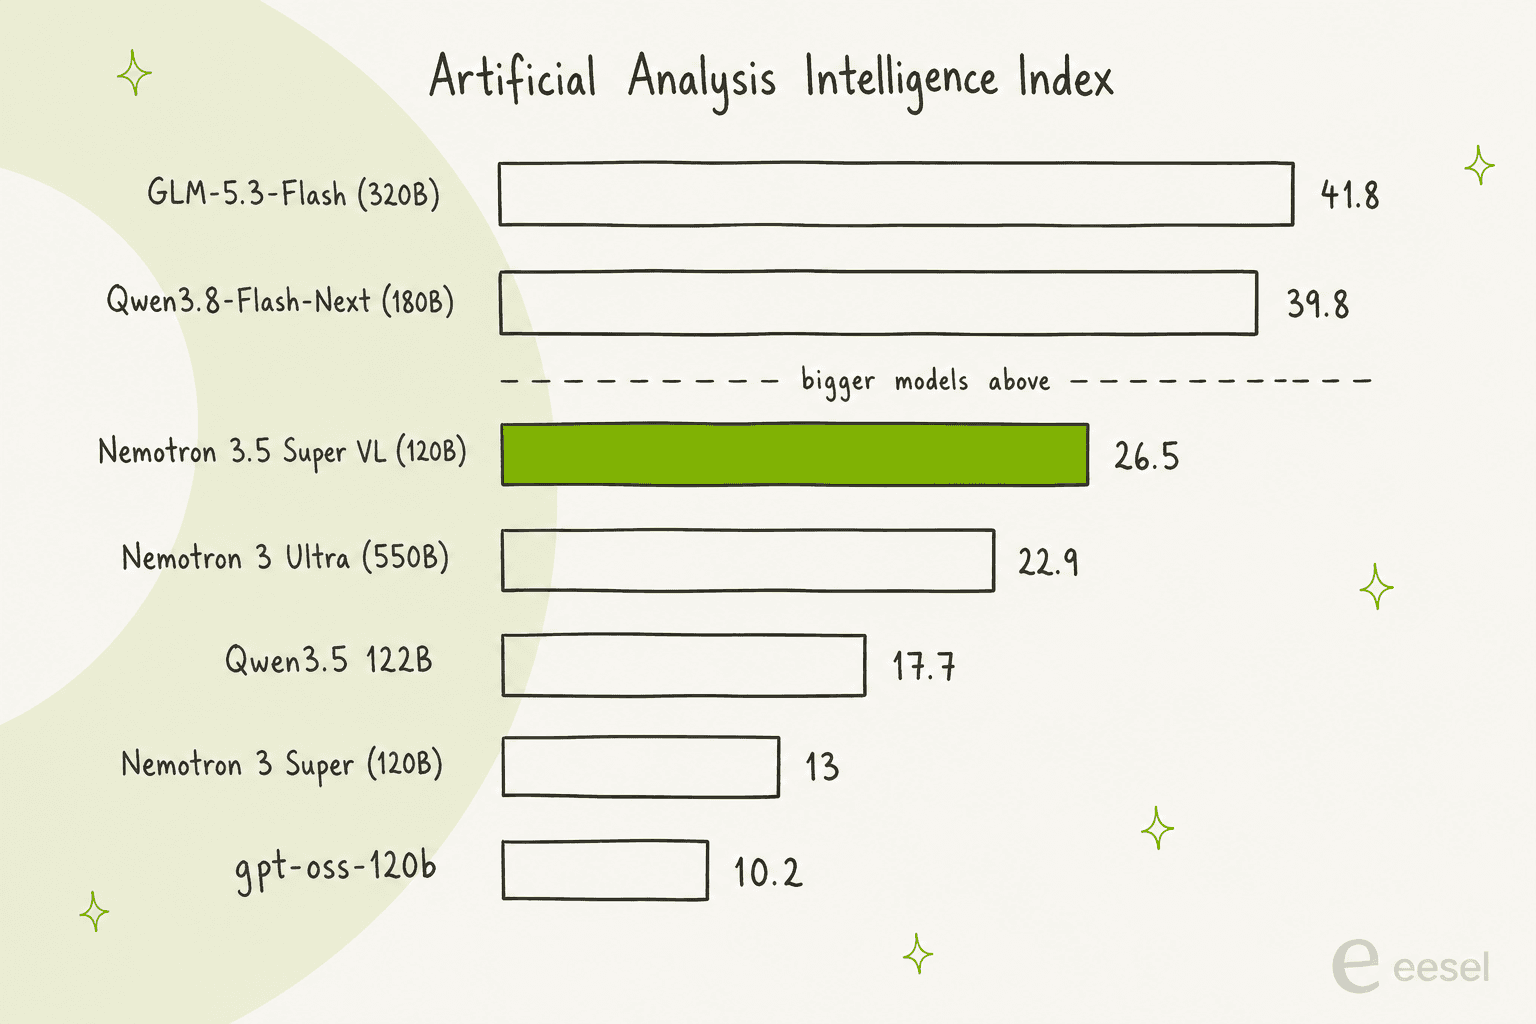
GLM-5.3-Flash(総計320B)は41.8、Qwen3.8-Flash-Next(総計180B)は39.8です。NVIDIA自身のモデルカードの表には両方が載っており、SWE-bench Verified(71.10に対して78.7と79.10)やTerminal-Bench 2.1(60.67に対して85.80と82.70)など、ほとんどの行でSuper VLを上回っています。Artificial Analysis自身も、オープンウェイトの知能では米国が中国のMiMo-V2.6-Pro(46)に依然として及ばないと指摘しています。
では、Super VLは何で勝っているのでしょうか。速度と、精度とスループットが交わるNVIDIAのグラフの「最も魅力的な象限」です。
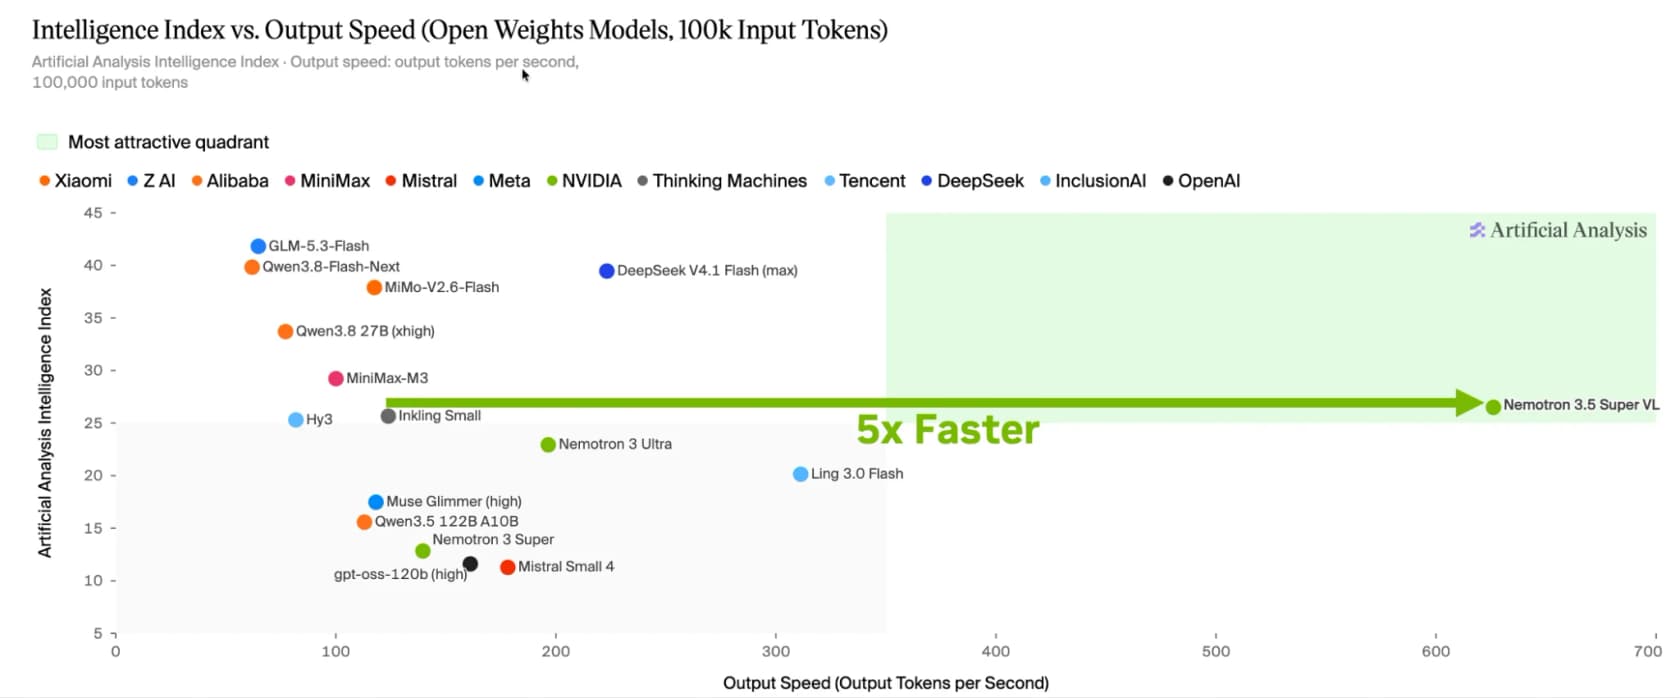
エージェントハーネスについては、NVIDIAはHermes Bench(63.44%対56.33%)とLangChainのビヘイビア評価(87.05%対84.3%)でUltraを上回ると報告しています。文書にも強く、グラフ推論ベンチマークのCharXivで80.8%(Pythonコードインタープリタ使用で84%)、OCRBench v2の英語で68.12です。
私の見方はこうです。Super VLは最も賢いオープンモデルではなく、見ることができる最速の優れたモデルです。エージェントが主にコードを書くなら、追加のメモリを払ってでも大きなflashモデルに価値があります。1日中文書を読み、GPUあたりのスループットを重視するなら、まずSuper VLを試すべきです。
NVIDIAが前面に出すポストトレーニングの話
NVIDIAの主な主張は、ほとんどの公開時報道で取り上げられたとおり、ポストトレーニング後のSuper VLが専門タスクでClaude Opus 5、GPT-6.1 Solなどのフロンティアモデルを上回るというものです。グラフは本物です。ただ、よく見てください。
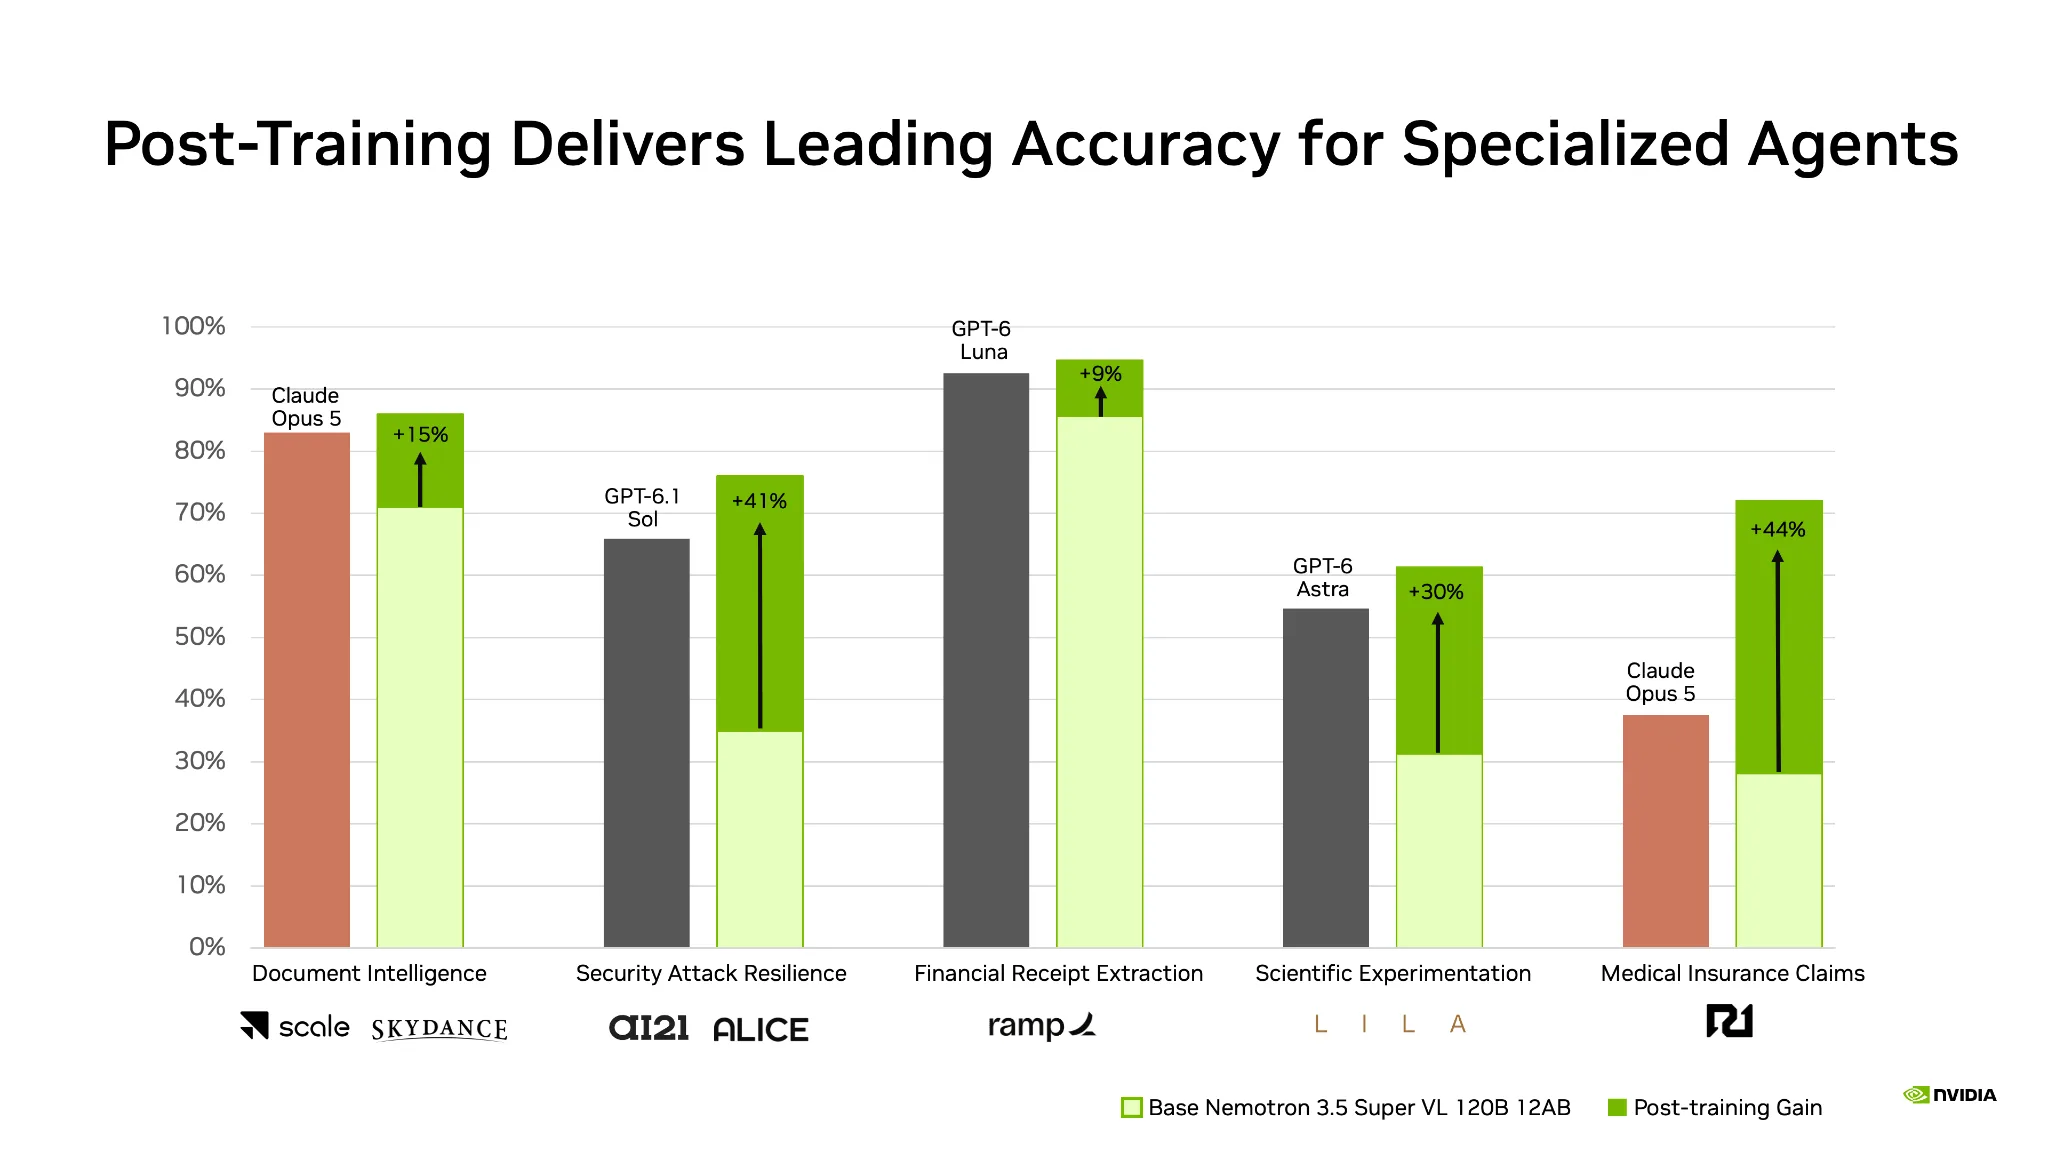
5つのタスクすべてで、薄い緑のベースモデルはフロンティアモデルより下から始まります。セキュリティ攻撃への耐性では、GPT-6.1 Solの66%に対し約35%から始まり、AI21とAliceによる+41%のポストトレーニング向上があって初めて上回ります。勝因は自分のデータで学習することであり、オープンなレシピを持つオープンモデルだからこそできることです。
パートナーの数字は具体的です。Scale AIはSkydanceのベンダークレジット処理向けにポストトレーニングし、推論コストが40分の1、レイテンシが5分の1になると見込んでいます。Rampはレシート画像を構造化JSONに変換しており、最大50%高いスループットと10分の1のレイテンシを見込んでいます。
購入者への教訓はこうです。既製のモデルを選んでプロンプトで使うなら、ベースのスコアを比べてください。NVIDIA NeMoでポストトレーニングするチームとラベル付きデータがあるなら、Super VLのオープンなレシピこそが本当の製品です。
Nemotron 3.5 Super VLの料金は?
ウェイトは無料です。ホスティングでは、市場で最も安い高性能モデルの1つです。
| プロバイダ | 入力 / 100万トークン | キャッシュ入力 / 100万 | 出力 / 100万 |
|---|---|---|---|
| DeepInfra | $0.10 | $0.08 | $0.40 |
| Crusoe(OpenRouter経由) | $0.10 | $0.08 | $0.40 |
| Together(OpenRouter経由) | $0.15 | $0.02 | $0.50 |
| CoreWeave(OpenRouter経由) | $0.15 | $0.02 | $0.50 |
| Venice(OpenRouter経由) | $0.25 | $0.125 | $1.25 |
| NVIDIA無料エンドポイント(OpenRouter経由) | 無料 | 無料 | 無料 |
OpenRouterの行は、10月18日時点のOpenRouterのモデルページによるものです。無料エンドポイントについては1点注意が必要です。OpenRouterの注意書きには、利用が「is logged for security purposes and to improve NVIDIA products」とあり、機密情報や個人情報をアップロードしないよう求めています。そのため、実際の顧客チケットには使えません。
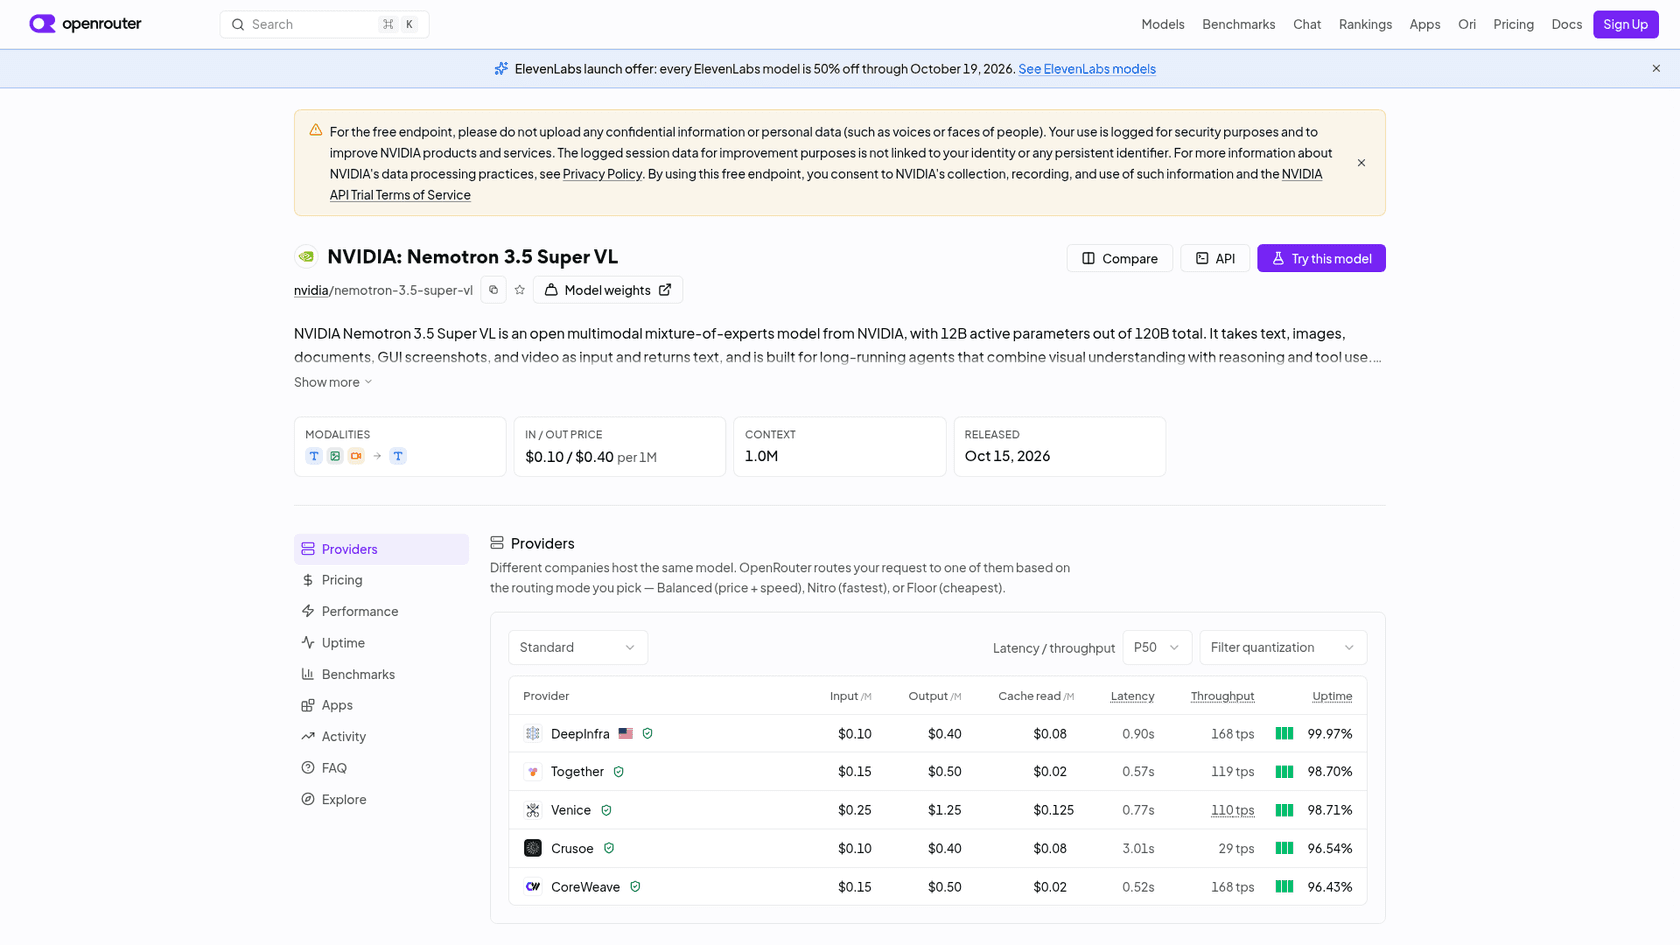
推論モデルは出力トークンを消費するため、定価がすべてではありません。Artificial AnalysisはIntelligence Indexのタスクあたり$0.19と測定しました。定価は近いのに、GLM-5.3-Flash($0.28)やQwen3.8-Flash-Next($0.37)より安いのは、Super VLがタスクあたり約46,000の出力トークンしか使わなかったからです。Nemotron 3 Superより約60%少ない量です。
サポート業務でこれが何を意味するか、ご自身の数字を入れて確かめてください。
デフォルト値では、10,000件のチケットのトークン費用はDeepInfraで月約$13です。サポートリーダーに持ち帰ってほしいのはこの点です。モデルの費用は小さな数字です。高くつくのは周辺のすべて、つまり検索、エスカレーションルール、テスト、回答を最新に保つことで、これはクローズドモデルについての私のサポート向けモデルガイドと同じ結論です。
自分で動かせる?
はい。そしてここがSuper VLの際立つ点です。NVIDIAはNVFP4チェックポイントをDGX Spark 1台に収まるように作り、公開当日のホスティング先リストは長いものでした。Hugging Face、ModelScope、NIM、そしてローカル実行向けのLM Studio、Ollama、vLLM、SGLang、Unslothです。
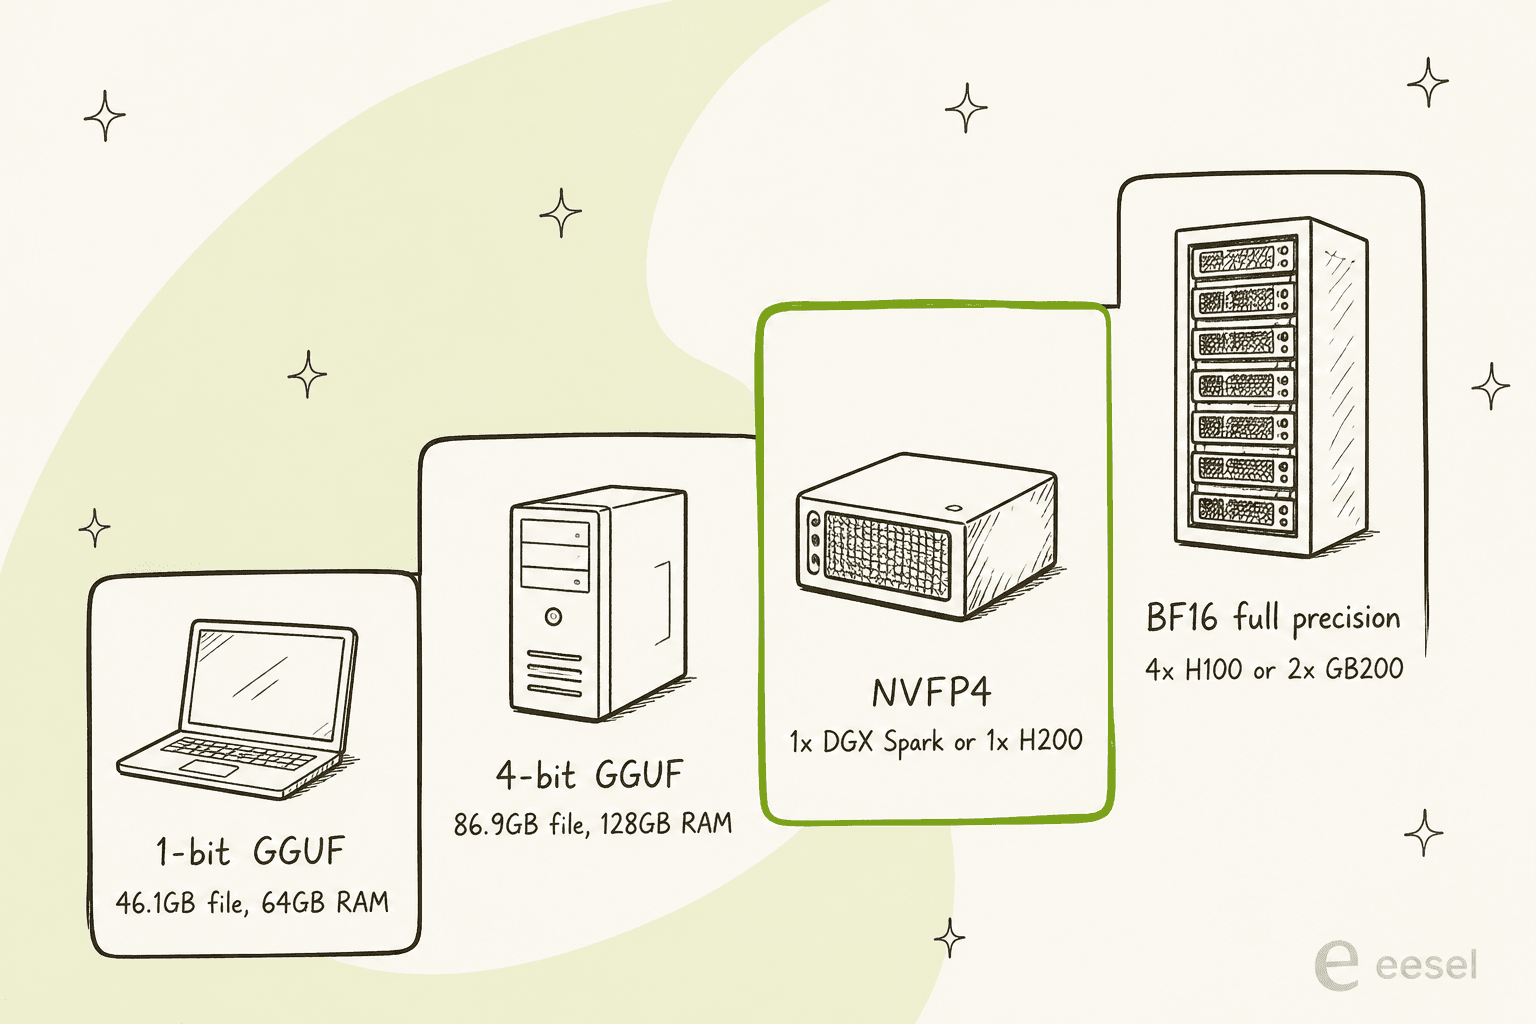
数字はNVFP4モデルカードとUnslothのガイドによるもので、後者は46.1GB(1ビット)から132GB(8ビット)までのGGUF版を挙げています。4ビットでも品質はよく保たれます。NVIDIAの比較表では、ほとんどのベンチマークでNVFP4はBF16と1ポイント以内ですが、WebVoyagerは77.72から66.31に下がるため、ブラウジングエージェントは量子化版でテストしてから信頼してください。
本番向けには、NVIDIAはNIMマイクロサービスとして提供し、16基のB200 GPU上のDynamoサービングレシピが「serves up to 8x as many users while reducing first-token latency by 85%.」と述べています。データレジデンシーのために自己ホストするなら、生のツールアクセスを与えるのではなく、NVIDIAのOpen Agent Safety PlatformやNemoClawランタイムのようなサンドボックスと組み合わせてください。
ライセンスは、この話の中で最もすっきりした部分です。OpenMDW-1.1は「without restriction」で権利を与え、再配布時にライセンスと表示を残すことだけを求め、出力に制限を課さないとしています。Muse Spark Openと違い、売上のしきい値も「Built with」表示の要件もありません。
初期のテスターは何と言っている?
最初の反応ははっきり分かれます。速度と米国での順位には感心し、Qwenと比べると慎重になる、というものです。
Artificial Analysisは、公開を国別順位の観点から位置づけました。
"Nvidia's Nemotron 3.5 Super VL is now the leading US open weight model, scoring 26 on the Artificial Analysis Intelligence Index"
Sentdexチャンネルを運営するHarrison Kinsleyは、ローカルのコーディング用にテストしていました。
"This one may very well be a solid choice for a speedy local coding agent model"
私が見つけた最も有用なテストは、Peter Dedeneによるもので、思考をオフにして、Super VLとQwen3.8-Flash-Nextを自作のエージェントベンチマークにかけました。ツール呼び出しと指示追従は近い結果でした。プロンプトインジェクションは違いました。悪意ある指示がツールの出力に隠れるAgentDojoで、Qwenは200回中2回、Nemotronは37回従いました。
"For an agent that touches untrusted input, I'd still pick Qwen. For long documents, Nemotron."
彼は、Nemotronは推論するために作られているのに推論をオフにしてテストしたので、モデルにとってベストの条件ではなく、2回目の実行を予定していると断っています。Hacker Newsでの反応はもっと短いものでした。
"this 3.5 Super is still below Qwen 3.8 next as they state themsleves"

これはNVIDIA自身の表と一致しており、妥当です。NVIDIAは生のスコアでQwenに勝つとは主張していません。速度、オープンさ、ポストトレーニングの伸びしろを主張しています。
カスタマーサポートに向いている?
私が最も気にしている問いで、答えは「向いているの意味による」です。
ビジョンは本当に向いています。 顧客はエラーメッセージのスクリーンショット、破損した商品の写真、請求書のPDFを送ってきます。テキスト専用モデルには「添付を参照」としか見えません。Super VLはチケットと同じ処理で添付を読み取ります。これは、あの技術サポートチームがeeselの通話で挙げ続けていたまさにそのギャップです。LangChainのようなもので自前のパイプラインを作るなら、サポートRAGパイプラインからまるごと1ステップを取り除けます。
サポート系ベンチマークは中程度です。 NVIDIAのモデルカードはtau2-benchを報告しています。これは、エージェントが会社のポリシーに従いながら模擬顧客と話す、カスタマーサービスのシミュレーションベンチマークです。
| ベンチマーク | Nemotron 3.5 Super VL | Qwen3.8-Flash-Next | GLM-5.3-Flash | Nemotron 3 Ultra |
|---|---|---|---|---|
| tau2-bench retail | 69.24 | 71.6 | 78.2 | 73.7 |
| tau2-bench airline | 76.50 | 80.8 | 81.8 | 79.8 |
| tau2-bench telecom | 73.19 | 90.4 | 98.5 | 83.0 |
| tau3-bench banking | 18.88 | 44.5 | 34.8 | 18.4 |
Super VLは、Ultraをわずかに上回るbankingを除くすべての行で、3つの比較対象に後れを取っています。AA-Omniscienceでのハルシネーション率(NVIDIAの実行で30.0%)は表の多くのモデルより良好で、自信満々の誤答が最悪の結果となるサポートでは意味があります。
プロンプトインジェクションが本当のリスクです。 顧客のメッセージはすべて信頼できない入力です。Dedeneの200回中37回という結果は、推論をオフにした1回のテストにすぎませんが、eeselが痛い思いをして学んだ教訓と一致します。実際のキューでは、どのモデルにも自己監視を任せられません。だからこそ、AIが実際の顧客に回答する前にすべてのロールアウトを過去のチケットでシミュレーションし、返金のようなアクションは承認ルールの背後に置いています。サポートにおけるAIハルシネーションのガイドでは、ガードレールをさらに詳しく説明しています。
サポートチームへの私の結論はこうです。エンジニア、NVIDIAのハードウェア、データを社内に置く理由があるなら、Super VLは土台にするのに面白いモデルです。月曜からZendesk AIエージェントのキューに向けられるものではありません。代わりに既製の選択肢を比べるなら、AIヘルプデスクソフトウェアのまとめのほうが出発点として適しています。
Nemotron 3.5 Super VLは誰が使うべき?
私ならこう判断します。
- 文書中心のエージェントを動かしている。 請求書、契約書、レシート、レポート内のグラフ。このために学習されており、RampとScale AIはすでに実践しています。
- 自社ハードウェア上でオープンウェイトが必要。 規制対象データ、デスクの下のDGX Spark、外部のAI処理事業者を禁じる契約。ライセンスと1台で動くNVFP4版により、大型のオープンモデルとして最も正当化しやすい選択です。
- ポストトレーニングする予定がある。 オープンなデータ、オープンなレシピ、初日からのNeMoサポート。NVIDIAの最良の数字はすべてファインチューニング後のものです。
- 最も賢いオープンモデルが欲しい。 まずGLM-5.3-FlashかQwen3.8-Flash-Nextを見るか、GPT-6 LunaやGemini 3.8 Flashのようなクローズドモデルに進みましょう。
- エージェントがツール付きで信頼できない入力を読む。 推論オンでのインジェクションテストがもっと出るのを待ち、いずれにせよサンドボックスに入れてください。
比較検討する方には、DeepSeek V4 Flashが最も安いテキスト中心の代替で、そのビジョン実験は画像で最も近いオープンの競合です。
eeselを試す
Nemotron 3.5 Super VLはインフラです。ウェイト、ライセンス、GPUの請求書。検索、エスカレーションルール、テスト、監査証跡は、自分で作る必要があります。eeselは従業員です。私たちのAIヘルプデスクのチームメイトは、Zendesk、Freshdesk、Gorgiasなどに接続し、過去のチケットとヘルプセンターから学習します。顧客に1通も回答する前に、数百件の過去チケットに対して実行できます。このリプレイで、プロンプトインジェクションされた返信や自信過剰な回答を、顧客より先に見つけられます。基盤のモデルが何であってもです。
自己ホストモデルを操作するように、ターミナルから操作したいなら、eesel CLIが対応します。eesel instructionsはチームメイトの常設ルールを読み書きし、eesel approvalsは人の確認待ちのアクションを一覧し、eesel activityは各実行とその理由を表示します。すべてのコマンドはJSONを出力し、書き込みは--dry-runに対応するため、Claude Codeのようなコーディングエージェントが、リポジトリを管理するのと同じようにサポートのチームメイトを管理できます。チケットに回答するのではなくコンテンツを書くなら、同じラインナップにAIブログライターがあります。

100クレジットでカード不要、無料で始められます。DGX Sparkの価格を調べる前に、先月のチケットでeeselを試して、何と答えていたかを確かめてください。プランは料金ページにあります。