


GPT-6 Astraは実質的に2つのリリースを兼ねています。エージェント作業(コンピュータ操作、コーディング、サイバーセキュリティ)における本物の飛躍と、価格だけが上がったチャットボットです。OpenAIは価格を100万トークンあたり$10/$50に設定し、これはGPT-5.6 Solの2.5倍ですが、Artificial AnalysisのIntelligence Index(61.2)はSol(60.9)からほとんど動いていません。ワークロードが自律エージェント中心であればAstraは価値があります。それ以外の大半のケースでは、より安価な選択肢があります。
実際に試す価値のあるGPT-6 Astraの代替候補8つ:
- Claude Opus 5($5/$25): 出力価格が半分で、最も近い性能の乗り換え先。
- Claude Fable 5.1($10/$50): Astraと同価格ながら、2026年9月時点では知能指標でトップ(〜65.7)。
- Claude Sonnet 5($2/$10): 大量生産向けのコストパフォーマンス重視の選択肢。
- Google Gemini 3.8 Flash($0.75/$3.75): ホスト型でフロンティア級に近いモデルの中で最も安価だが、最初のトークンまでが遅い。
- Kimi K3($3/$15): Moonshotによる強力なオープンウェイトモデル。
- Qwen 3.8 Max($2/$6): 寛容なオープンベースを持つAlibabaのフラッグシップ。
- DeepSeek V4 Flash(〜$0.22〜$0.44 / $0.66〜$1.32): 圧倒的に安く、MITライセンス。
- Grok 4.6($2/$6): 500Kコンテキストで高速、すでにxAIの世界にいるなら有力。
サポートチケットの回答用にモデルを評価しているなら、もう一つ知っておくべきことがあります。生のモデルはチームメイトではありません。モデルはあくまでエンジンであり、ヘルプセンターや統合、ガードレールに組み込む作業は依然として必要です。それこそがeeselが担う仕事であり、トークン単位ではなくチケット単位($0.40)で課金されるため、ルーティンな返信に$50/Mの出力コストを払わずに済みます。
なぜ人々はGPT-6 Astraの先を見ているのか
まずはGPT-6 Astraに対して公平でありたいと思います。これは本当に印象的なモデルです。OpenAIのモデルページによれば、1,050,000トークンのコンテキストウィンドウ、ホスト型シェル、apply-patch、コンピュータ操作、そして標準搭載のMCPサポートを備えています。エージェント系ベンチマークでの飛躍は本物です。OpenAIによると、Terminal-Bench 4.0はSolの37.3%から57.9%まで上昇し、Preparedness Frameworkのもとでサイバーセキュリティについて「Critical」と評価された初のモデルでもあります。自律的なコーディングエージェントや長時間のツール使用パイプラインを構築しているなら、これは大きな意味を持ちます。
ここに落とし穴があり、それがあなたがこの記事を読んでいる理由です。OpenAIはAstraの価格を入力100万トークンあたり$10、出力100万トークンあたり$50に設定しました。これはGPT-5.6 Solの$4/$20の2.5倍です。この金額であれば、それに見合う知能の飛躍を期待するでしょう。しかし、それは得られません。独立系のArtificial AnalysisのIntelligence Indexでは、AstraはSolの60.9に対して61.2と、誤差の範囲内です。Hacker Newsでの最も鋭い評価は、これが「6というより5.7のように感じる」というもので、この数字がそれを裏付けています(この点についてはGPT-6 Astraレビューで詳しく掘り下げています)。

チームが他の選択肢を探している理由は他にもいくつかあります。
- 無料プランには含まれない。 AstraはPlus/Pro/Business/Enterprise、そしてAPIでのみ利用可能で、Enterpriseではワークスペースごとにデフォルトで無効になっています。(より広いOpenAIのモデルラインナップを整理するなら、Astraはその頂点に位置します。)
- 監視可能性が低下した。 OpenAIはシステムカードで率直に述べている通り、このモデルは自身の思考の連鎖に影響を与えうるため、正当なツール使用を一時停止させることもある不整合モニタリングを追加しました。
- 長いプロンプトはより高くつく。 272Kトークンを超えるリクエストは入力2倍・出力1.5倍で課金されるため、一部の競合とは異なり、Astraの目玉であるコンテキストウィンドウは定額料金ではありません。
これらはAstraを悪いモデルにするわけではありません。フラッグシップ価格を払う専門家に仕立てているだけです。では、他に何があるのかを見ていきましょう。
GPT-6 Astraの代替候補一覧
各社の標準APIにおける100万トークンあたりの価格と、Artificial Analysis指標による知能スコアを並べた全体像です(スコアは週ごとに変動するため、絶対的な真実ではなく目安として扱ってください)。
| モデル | 入力 / 出力($/M) | コンテキスト | 知能指標(概算) | オープンウェイト? | 最適な用途 |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 / $50 | 1.05M | 〜61 | いいえ | 自律エージェント、コーディング、サイバー |
| Claude Fable 5.1 | $10 / $50 | 1M | 〜66 | いいえ | 測定上最高の性能 |
| Claude Opus 5 | $5 / $25 | 1M | 〜61 | いいえ | 最も近い乗り換え先、出力価格半額 |
| Claude Sonnet 5 | $2 / $10 | 1M | 〜53 | いいえ | 大量生産でのコストパフォーマンス |
| Gemini 3.8 Flash | $0.75 / $3.75 | 1M | 〜59 | いいえ | 最安のホスト型、バッチ処理向け |
| Kimi K3 | $3 / $15 | 1M | 〜57 | はい | オープンウェイトでの高い性能 |
| Qwen 3.8 Max | $2 / $6 | 1M | 〜58 | 一部 | オープンベース+人間評価での強さ |
| DeepSeek V4 Flash | 〜$0.22-0.44 / $0.66-1.32 | 1M | 〜50 | はい(MIT) | タスクあたり最安、自前ホスト向け |
| Grok 4.6 | $2 / $6 | 500K | 〜54 | いいえ | 高速、xAIネイティブなワークフロー |
この表の読み方について一言。定価とタスクあたりのコストは同じではありません。1つの仕事を終えるのに出力トークンを2倍消費するモデルは、1回のパスで完了する「より高価な」モデルよりも結局高くつくことがあります。ですから、この表で候補を絞り込んだうえで、実際のプロンプトを2〜3の最終候補に流し、実際の請求額を測ってください。サポートチケットに最適なAIモデルは、ベンチマークの数値が最も大きいものとは限らず、どのLLMが勝つかは結局のところデータ次第であることがほとんどです。

1. Claude Opus 5
最適な用途: Astra級の性能を、Astraの請求額なしで手に入れたいチーム。
Claude Opus 5はこのリストの中で最も自然な1対1の乗り換え先です。Astraの1Mコンテキストウィンドウに匹敵し、Anthropicはウィンドウ全体を標準料金で課金するため、長文コンテキストの割増がありません。900Kトークンのリクエストも9Kトークンのリクエストと1トークンあたり同じコストです。Artificial Analysis指標ではAstraのすぐ隣(どちらも約61)に位置し、一時期は単独で1位を保持していました。
興味深い特徴はエフォートダイヤルです。Opus 5はデフォルトで思考をオンにしており、推論エフォートをmaxまで上げられます。そこにこそ品質の多くが宿っている一方で、コストもそこにかかります。コミュニティの共通認識としては、Opus 5は同じエフォート設定でOpus 4.8のおよそ2倍の出力トークンを消費するため、定価は変わらなくてもタスクあたりのコストは上昇しました。

乗り換え後の開発者による実際の評価です。
"Opus 5 matched Fable 5 on my agent tasks, and it was faster and cheaper to run."

- メリット: Astraの出力価格の半分、1Mコンテキストの定額料金、トップクラスの推論力、専用のレート制限枠。
- デメリット: 思考はデフォルトでオンになっており、
highエフォートを超えるとオフにできず、タスクあたりのトークン消費が急速に増える可能性がある。 - 価格: 入力$5 / 出力$25(100万トークンあたり)。ファストモードは$10/$50。バッチは50%割引。キャッシュ読み取りは$0.50。
評価: 価格対性能比に不満があってAstraを離れるなら、まずここから検討すべきです。ほぼ同じ知能レベルを出力コスト半分で得られます。maxエフォートを常用する癖がつくと、その節約分が静かに消えてしまう点には注意してください。
2. Claude Fable 5.1
最適な用途: Astraと同じ価格帯で買える、最も高性能なモデル。
Astraの問題が「横ばいのスコアにフラッグシップ価格を課している」ことだとすれば、Claude Fable 5.1はそれへの的確な回答でした。まったく同じ$10/$50でありながら、2026年9月時点では知能指標で約65.7とAstraを数ポイント上回りトップに立っていました。当時のAnthropicの自社ラインナップの中でもOpus 5より上位に位置し、Terminal-Bench-Scienceを含め、ローンチ時にAnthropicが公表したすべての評価でトップに立ち、そのスコアは以前のスコアの2倍以上でした。
2つの点が、Astraとは本質的に異なる購入対象にしています。まず、キャッシュ読み取りが75%値下がりして100万トークンあたり$0.25となり、Opus 5の$0.50よりトークンあたり安く、大きなシステムプロンプトを何度も読み直すエージェント的なワークロードでは差が早く積み重なります。次に、Fable 5.1はEU AI Actへの準拠のため、出力に統計的な電子透かしを刻むようになりました。これを出所証明の観点で歓迎するチームもいれば、奇妙に感じるチームもいます。契約前に知っておく価値があります。
- メリット: Astraと同価格でリスト中最高の測定知能、非常に安いキャッシュ読み取り、1Mコンテキストの定額料金、優れた文章生成とコーディング。
- デメリット: Astraと同じ$50/Mの出力コスト(安さを求める選択肢ではない)、セキュリティ関連の自社コードで誤って拒否される報告あり、出力の電子透かしは誰にでも合うわけではない。
- 価格: 入力$10 / 出力$50。キャッシュ読み取り$0.25。バッチ$5/$25。無料プランなし。
評価: どのみちAstra相当の価格を払うつもりだったなら、Fable 5.1は同じ料金でより高い測定性能を提供してくれます。「同じ料金でより高性能なモデル」という代替です。
3. Claude Sonnet 5
最適な用途: 最大性能よりタスクあたりの価値を優先する、大量生産のプロダクション業務。
すべての仕事にフラッグシップが必要なわけではありません。Claude Sonnet 5はClaude 5ファミリーの働き者で、100万トークンあたり$2/$10、Astraの出力価格の5分の1です。Anthropicは2026年8月、これが期限付きのプロモーションではなく恒久的な標準価格であることを確認しました。知能指標では約53と、フラッグシップより低いスコアですが、分類、ルーティング、要約、そして日常的な生成作業のロングテールには十分すぎる性能です。
注意すべき落とし穴はタスクあたりのターン数です。トークンあたりの単価が安いからといって、必ずしもジョブあたりのコストが安くなるとは限りません。小さいモデルほど同じ結果に到達するまでにやり取りが増える場合があるためです。とはいえ、適切にスコープされたタスクであれば、Sonnet 5は本番トラフィックに投入できる、トークンあたりの価値が最も高いモデルの一つです。
- メリット: Astraのごく一部の価格、1Mコンテキストが定額、高速で、日常的なタスクに本当に強い。
- デメリット: フロンティア級の推論力はなく、曖昧な作業では余分なターンを消費することがある。
- 価格: 入力$2 / 出力$10(100万トークンあたり)。キャッシュ読み取り$0.20。バッチ50%割引。
評価: フラッグシップを必要としない80%のトラフィックに対して私が選ぶモデルです。難しい残り20%にはOpus 5やFable 5.1を組み合わせれば、Astraには到達できないコスト構造が手に入ります。
4. Google Gemini 3.8 Flash
最適な用途: 誰も返信を待っていない、安価で高スループットなバッチ処理。
Gemini 3.8 Flashは、フロンティア級の議論にまだ加わっているホスト型モデルの中で最も安価で、2026年末まで入力$0.75 / 出力$3.75です(2027年1月1日に$1.50/$7.50へと2倍になるため、予算に織り込んでおいてください)。知能指標では約59を記録し、Astraにはない無料プランも用意されています。
ほとんどの記事が見落としている正直な注意点があります。Artificial Analysisの計測によれば、最初のトークンまでの時間は13.30秒で、クラス中央値の約3秒と比べてかなり遅い一方、生のスループットではテスト対象モデルの中でも上位に入ります。スループットは応答性とは違います。これは夜間バッチパイプラインには非常に優れているものの、ライブチャットの返信のように人が能動的に待っているものには不向きです。Google自身も、3.8は「より頑張る」ため多くのトークンを使うことがあるとして、効率重視のワークロードには旧世代の3.7 Flashにとどまることを提案しています。
- メリット: 最安のホスト型オプション、無料プラン、巨大なマルチモーダル入力(テキスト、画像、音声、動画、PDF)、非常に高いスループット。
- デメリット: 最初のトークンまでが遅い、2027年1月に価格が2倍になる、2つの安全性指標が3.7に対してわずかに悪化した。
- 価格: 2026年12月31日まで100万トークンあたり$0.75 / $3.75、その後$1.50 / $7.50。バッチとFlexは50%割引。
評価: フラッグシップには真似できない価格で、バッチ処理とオフライン処理に非常に優れたモデルです。ただし、タイピングインジケーターを見ている顧客の前には出さないでください。
5. Kimi K3
最適な用途: 自前でホストできるオープンウェイトの強力な性能を求めるチーム。
Kimi K3はMoonshot AIのフラッグシップで、2.8兆パラメータ・アクティブ104BのMixture-of-Expertsモデルです。そのオープンウェイトは予定通り公開され、約束された日付を守ったのは、すべてのラボが達成できるわけではないことです。知能指標では約57を記録し、Opus 4.8のような旧世代のフラッグシップを上回り、ネイティブなビジョン機能も備えています(ただし、公開画像URLは受け付けず、base64かファイルIDのみ対応)。
驚きなのはその価格です。100万トークンあたり$3/$15は、K2時代に人々が期待するようになった底値戦略ではなく、Claude Sonnetと同じ価格帯に位置します。推論はどのエフォートレベルでも常にオンで無効化できないため、これはコスト階層ではなくレイテンシの制御と言えます。K3を求める理由が自前ホスティングであれば、オープンウェイトこそが全ての意味を持ちます。一方、ホスト型APIを使うだけなら、Sonnet 5に対する価値の計算はそれほど明確ではありません。
- メリット: 本当の意味でオープンなウェイト、堅実なベンチマーク、ネイティブなビジョン、1Mコンテキスト。
- デメリット: ホスト価格は予算級ではなくミドルティア、推論を無効化できない、公開画像URLは非対応。
- 価格: 入力$3 / キャッシュヒット$0.30 / 出力$15(100万トークンあたり)。
評価: オープンウェイトが絶対条件で、実際にそれを運用するつもりならこのリスト最良の選択です。単なるホスト型APIとしてなら、価値の面ではSonnet 5が勝つことが多いです。
6. Qwen 3.8 Max
最適な用途: 寛容なオープンベースを持ち、人間評価でも上位に入る強力なオールラウンダー。
AlibabaのQwen 3.8 Maxは2026年8月に一般提供が開始された、2.4Tパラメータ・アクティブ95BのMoEモデルで、価格は100万トークンあたり入力$2 / 出力$6です。知能指標では約58を記録し、LMArenaの人間評価ランキングでも本当に強く、テキストで上位5位、ビジョンで上位2位に入っています。つまり、自動化された指標と人間による盲検投票がわずかに異なる方向を示しているということです。両者が一致しない場合、私はどちらか一方の数値だけを信じることはせず、実際にテストします。

オープンウェイトの有無については「部分的にはい」です。重量級のチェックポイントであるQwen3.8-2.4T-A95Bは制限的なQwenライセンスの下で公開されている一方、実際に自由に再利用できるのは寛容なApache-2.0ライセンスの27Bモデルです。ホスト型のMaxも、ビジョン入力、思考なしモード、組み込みツールを追加しているため、オープンなベースモデルと機能的に同等ではありません。
- メリット: 低いホスト価格、人間評価で上位のランキング、1Mコンテキスト、寛容なライセンスの小型オープンモデル。
- デメリット: 大型ウェイトは制限的なライセンスの下にある、ホスト版とオープン版が異なる、ファーストパーティAPIではデータの所在地が中国。
- 価格: 入力$2 / 出力$6(100万トークンあたり)。暗黙のキャッシュ読み取り$0.25。
評価: ベンチマークスコアよりも人間評価による品質を重視するなら、正真正銘に強力で安価なオールラウンダーです。大型モデルを自前ホストする計画があるなら、ライセンスは注意深く読んでください。
7. DeepSeek V4 Flash
最適な用途: タスクあたりのコストがすべてを決める、大量のワークロード。
トークンあたりの支出をできるだけ抑えることが最優先なら、DeepSeek V4 Flashに匹敵するものはここにはありません。ライブ価格表によれば、ピーク時間帯かオフピーク時間帯かによって、入力は100万トークンあたり約$0.22〜$0.44、出力は約$0.66〜$1.32です。DeepSeekのピーク時間帯(協定世界時01:00〜04:00および06:00〜10:00)は中国の営業時間に対応しているため、米国やEUのキューは大半がより安いオフピーク料金で課金されます。これは知っておく価値のある本物の(ただし脆弱な)特徴です。

正直に見極めるべき点が2つあります。第一に、「安い」と「良い」は同じウェイトの別の実行結果です。DeepSeek自身の数値でも、非思考モードと最大エフォートの品質には大きな差があり、推論トークンは出力料金で課金されるため、節約設定はチャートの上位を占める設定ではありません。第二に、顧客データに関しては、有料APIの規約は学習利用について明示的に安全と謳うのではなく沈黙しており、公表されたゼロ保持オプションもなく、データは中国法の下、中国国内に置かれます。つまり、機密性のない大量のワークロードには素晴らしいコストエンジンですが、規制対象の顧客データにそのまま代替できるものではありません。
- メリット: 圧倒的に安価、MITライセンスのオープンウェイト(約167GB)、1Mコンテキスト、最大384Kの出力。
- デメリット: 節約設定は品質面で見劣りする、トークン消費が冗長、テキストのみ(画像入力の公式サポートなし)、機密データには不向きなデータ取り扱い規約。
- 価格: オフピーク/ピーク、100万トークンあたり: 入力 約$0.22 / $0.44、出力 約$0.66 / $1.32。キャッシュヒットの入力は1セント未満のごくわずかな金額。
評価: 大差をつけたコストパフォーマンスの王者です。機密性のないデータでの大量の分類、抽出、要約に使いましょう。規約とデータ所在地が自社の要件に合致するまでは、顧客の個人情報をファーストパーティAPIから遠ざけてください。
8. Grok 4.6
最適な用途: すでにxAIエコシステムにいて、高速な応答と大きなコンテキストウィンドウを求めるチーム。
Grok 4.6は、200K未満のトークンのプロンプトに対して100万トークンあたり入力$2 / 出力$6、コンテキストウィンドウは500Kでリストを締めくくります。高速であり、すでにxAI上で構築している、またはライブのX/Web検索を組み込みたいなら、理にかなった選択です。価格表が明確にしている一点は、ロングコンテキストのリクエスト(200K以上のプロンプト)は超過分だけでなくリクエスト全体が$4/$12に再計算される点で、大きなプロンプトは表示価格が示唆するよりも高くつきます。
Grokはトークン以外の面でも課金します。ウェブ検索、X検索、コード実行は1,000回あたり$5、ファイル添付検索は1,000回あたり$10です。OpenRouterが計測した実効価格は、ここでの最も鋭い実世界のデータで、約90%というキャッシュヒット率のおかげで入力の平均は表示価格の$2を大きく下回る一方、一部のトラフィックがロングコンテキスト階層に入るため出力はわずかに表示価格を上回っています。調達の都合でクラウドマーケットプレイスを使わざるを得ない場合、AzureとBedrockではGrokの古い世代までしか利用できず、4.6はそこでは入手できない点に注意してください。
- メリット: 高速、500Kコンテキスト、ネイティブなライブ検索、良好なキャッシュにより実効価格が表示価格を下回ることが多い。
- デメリット: ロングコンテキストのリクエストはプロンプト全体を再計算する、検索やツールに追加の呼び出し課金がある、4.6にはバッチ割引がない。
- 価格: $2 / $6(100万トークンあたり、200K以下)。200K以上のプロンプトは$4 / $12。ツール/検索の課金は別途。
評価: 組み込み検索が欲しい、あるいはすでにxAIの世界にいるなら、本物の強みを持つ堅実で高速なモデルです。ロングコンテキストの再計算と呼び出し課金があるため、安価な選択肢だと決めつける前に、実際の使用状況をモデル化しておくべきです。
どのモデル比較も見落としている点: モデルはチームメイトではない
一週間かけてベンチマークをする前に、誰かに教えてほしかったことがあります。サポートチケットへの回答、ブログ記事の執筆、あるいはどんな実際のビジネスワークフローであれ、それを担うモデルを選んでいるなら、モデルはあくまでエンジンにすぎません。それは、あなたの返金ポリシーが何か、どのZendeskビューを見るべきか、いつ立ち止まって人間に確認すべきかを何一つ知らない、生の知能です。
Astraを含め、このリストのすべてのモデルは同じギャップを抱えています。Artificial Analysisの知識スコアは100点満点で50点をはるかに下回っており、これは要するに、ここに挙げたどのモデルもあなたのビジネスを知らないということを上品に言い換えたものです。モデルを実際に仕事をこなす存在に変えるには、ヘルプセンターや過去のチケットに組み込み、ツールと連携させ、ガードレール、テスト、承認フローで取り囲む必要があります。それこそが、本物のカスタマーサービス向けAIの裏にある作業であり、どのモデルがベンチマークで勝とうと変わらない同じ作業です。

そしてここで価格の話が逆転します。100万トークンあたり$50の出力コストが最も痛むのは、ミドルティアのモデルでも処理できるルーティンな80%のチケットにそれを費やしているときです。より賢い構造は、本当にフラッグシップが必要な難しい質問がいつ発生するかを別の仕組みに判断させ、トークンではなく結果に対して支払うことです。それが、エンジンをレンタルすることとAIチームメイトを雇うことの違いであり、人間のエージェントと比較したコストも変えるものです。
eeselを試してみる
「エンジン対チームメイト」という枠組みに私が何度も立ち返る理由は、それこそが私たちが作っているものだからです。eeselはAIチームメイトのプラットフォームです。生のモデルとAPIキーを渡すのではなく、特定の仕事のためにすぐ働けるチームメイトを雇うイメージです。サポートキューに加わるAIヘルプデスクのチームメイトや、AIブログライターなどがその例です。それぞれがモデルの使い方、あなたの統合、そして会社のコンテキストをすでに知った状態で到着するため、深夜2時にGPT-6 AstraをZendeskに接続する作業をするのはあなたではありません。

モデルコストを比較する誰にとっても重要な点が2つあります。第一に、eeselはチケット単位で課金され1件あたり$0.40なので、この記事のテーマである価格競争そのものから隔離されます。最良のモデルがAstraであろうと、Opus 5であろうと、あるいは来月登場するより安い何かであろうと、解決した会話あたりのコストは変動しません。第二に、Astraが本質的にエージェントとAPIの話である以上、eeselが同じチームメイトを本物のコマンドラインインターフェースとMCPサーバーを通じて公開していることも知っておく価値があります。ターミナルから操作したり、CIでスクリプト化したり、MCP経由で接続してClaude Codeのようなコーディングエージェントからヘッドレスで操作したりできます。ドキュメントには文字通り、ダッシュボードでできることはすべてターミナルからもできると書かれています。
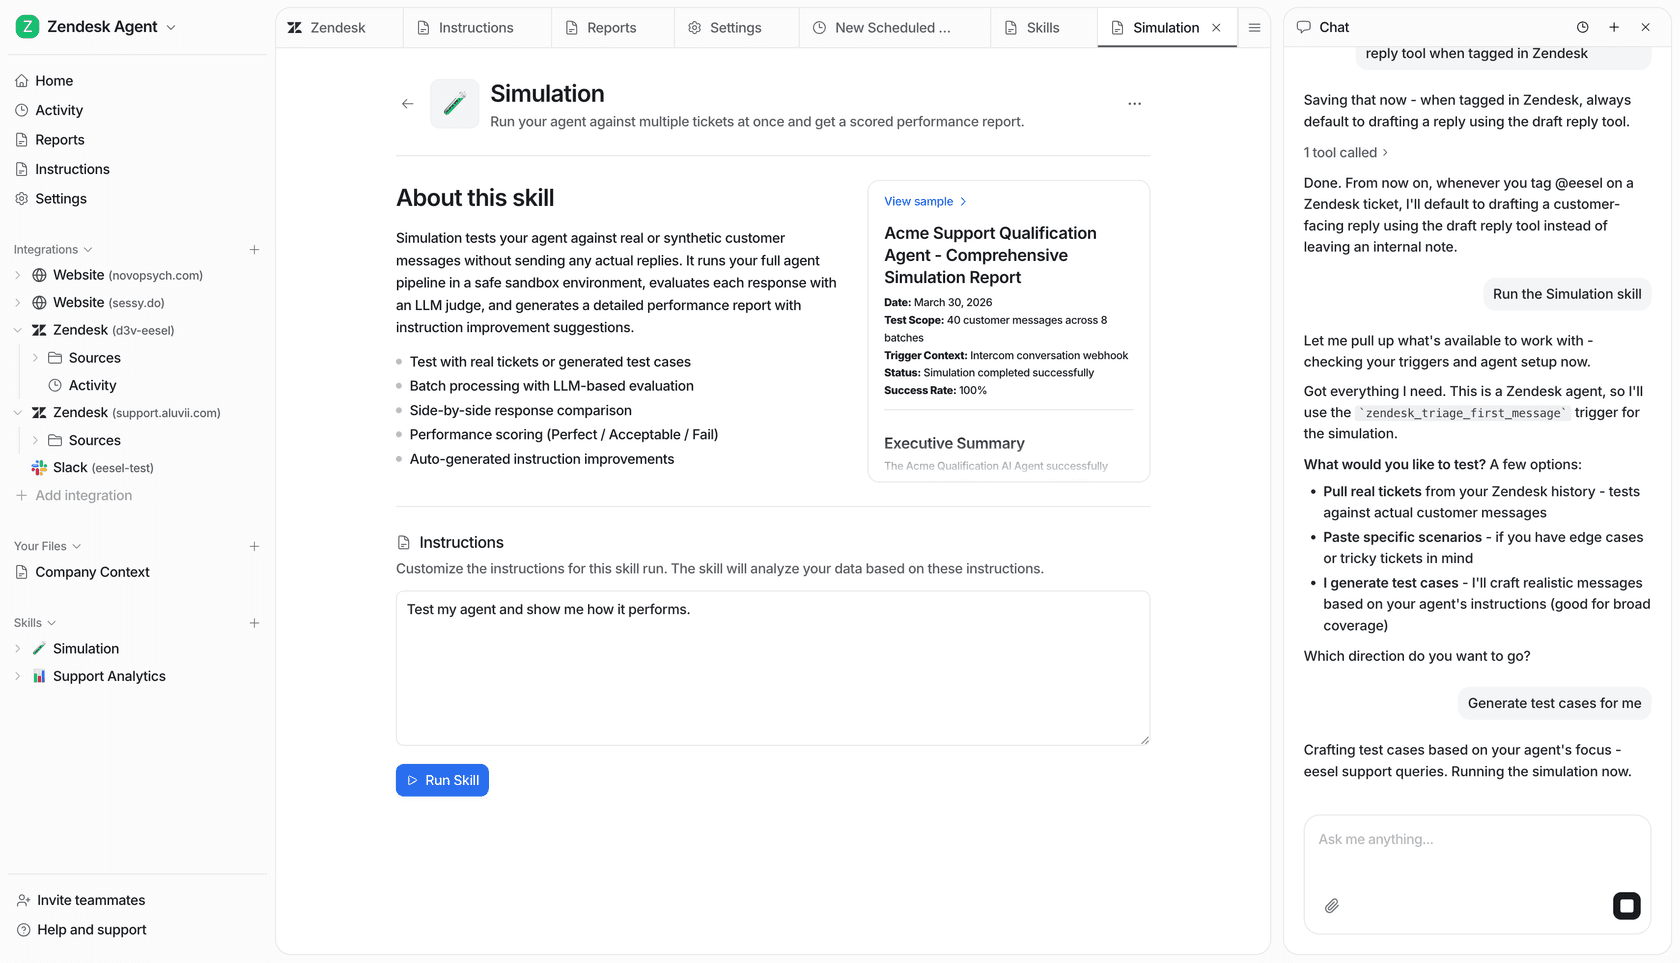
本番稼働の前に、eeselは過去のチケットに対してチームメイトをシミュレーションさせ、実際にチームが送った内容と回答を照らし合わせて採点できます。そのため、顧客の前ではなく、安全なテスト実行の中でギャップを見つけられます。$50分の無料利用枠から、クレジットカードなしで始められます。どのモデルの上にサポートを構築するか迷っているなら、このレイヤーこそがモデル選びの重要性をぐっと下げてくれます。eeselを試す のは無料です。