Claude Mythos 5.1に実際にアクセスできるのか?
まずはここから始めましょう。多くの読者にとって、これがすべての疑問だからです。
Claude Mythos 5.1 アクセスチェック
自分のチームに最も近い説明を選んでください。すべての回答は、2026年9月時点のAnthropic自身のアクセスページに基づいています。
あなたはどのタイプですか?
可能性はあるが、今はまだ無理
Cyber Verification Programがその経路です。すでにOpusおよびSonnetクラスのモデルでサイバー関連の安全策が緩和されており、AnthropicはMythosクラスへのアクセスも近い将来加わると述べています。申請はCVPポータルから行います。
今すぐ使うなら: Fable 5.1。ソースコード内のソフトウェア脆弱性を特定できるようになり、Claude Codeユーザーはセッションあたりのサイバー安全策の介入がFable 5と比べて約60%減少しています。
招待がある場合のみ
Life Sciences Verification Programは、米国政府と共同で構築された招待制のベータプログラムで、専門的な研究開発向けに生物学の安全策を緩和します。最初の参加者はすでに登録済みで、より広範な登録拡大が約束されていますが、スケジュールは未定です。
今すぐ使うなら: Fable 5.1。無害な初等生物学や医学の質問に対する生物学の安全策の発動が85%減少しています。研究レベルのライフサイエンスに関する問い合わせは、引き続きOpusに振り分けられます。
アカウントチームに確認を
Claude Mythos 5.1はClaude API、Amazon Bedrock、Google Cloud、Microsoft Foundryに掲載されており、ドキュメントではAnthropic、AWS、Google Cloudのアカウントチームを通じてアクセスを申請するよう案内されています。利用可能な範囲は引き続き一部の米国内組織に限られています。
今すぐ使うなら: 同じプラットフォーム上のFable 5.1。Enterprise Frontier Safeguardsはこの秋から段階的に展開され、それまでは対象顧客がゼロデータ保持を利用できます。
いいえ、当面変わりそうにありません
Mythos 5.1にはセルフサービスでアクセスする方法はありません。どちらのプログラムも組織単位で審査され、米国内に限定されています。クレジットカードや利用ティアで入れるようなものではありません。
今すぐ使うなら: 上限を狙うならFable 5.1、あるいは入力5ドル・出力25ドルのOpus 5。Anthropic自身のドキュメントも、ほとんどのワークロードはここから始めるよう案内しています。
いいえ、そもそも必要ありません
Mythos 5.1の余力はサイバーセキュリティと生物学にあります。どちらも返金依頼や「注文はどこ?」(WISMO)チケットには出てきません。さらに、このモデルファミリーの中で最も遅く最も高価であり、顧客が体感するのはレイテンシであるようなキューには向きません。
今すぐ使うなら: 自社製品を実際に理解しているレイヤーの後ろに置いたSonnet 5またはOpus 5。サポートキューにおける差はモデルの生の階層ではなく、グラウンディングとテストです。
Claude Mythos 5.1の実体
Claude Mythos 5.1はAnthropicのMythosクラスのフロンティアモデルで、2026年9月1日にモデルID claude-mythos-5-1としてリリースされました。ドキュメント上のステータスは「Active (invite only)」で、廃止は2027年9月1日より前には行われないとされています。
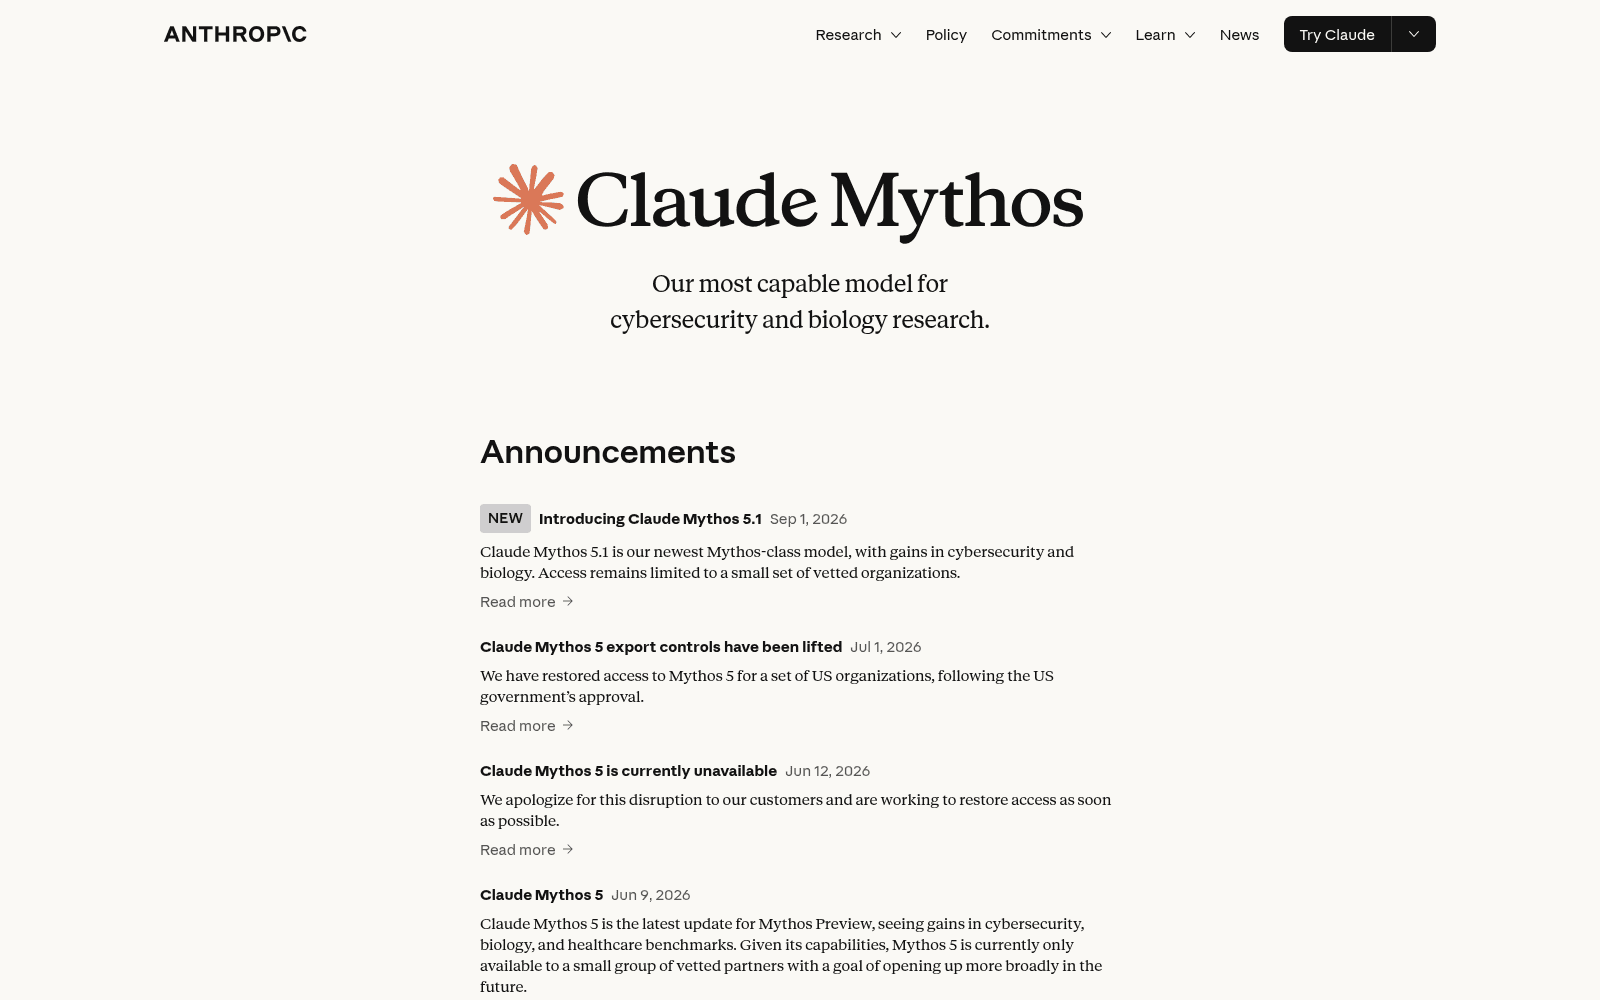
Mythosシリーズは、Anthropicが2026年4月にProject Glasswingを立ち上げる際に使用した未リリースのモデル、Claude Mythos Previewから始まりました。Mythos 5がそれに続いて6月9日に登場し、6月12日には利用不可となり、米国政府の承認を経て7月1日に輸出規制が解除されました。Mythos 5.1はこのシリーズ3番目のモデルであり、一般提供される双子モデルと同時に登場する初めてのケースです。
以下は、マーケティング資料ではなくモデルページから抜粋したスペックシートです。
| 項目 | Claude Mythos 5.1 |
|---|---|
| モデルID | claude-mythos-5-1 |
| リリース日 | 2026年9月1日 |
| ステータス | アクティブ、招待制 |
| コンテキストウィンドウ | 100万トークン |
| 最大出力 | 128Kトークン |
| Thinking | 適応的、常時オン |
| デフォルトのエフォート | high |
| 知識のカットオフ | 2026年6月 |
| 相対的なレイテンシ | 遅い |
| 入力 / 出力 | テキストと画像、テキストへ |
| 入力価格 | $10 / MTok |
| 出力価格 | $50 / MTok |
| キャッシュ読み取り | $0.25 / MTok |
| プラットフォーム | Claude API、Bedrock、Google Cloud、Microsoft Foundry |
| 廃止予定 | 2027年9月1日より前ではない |
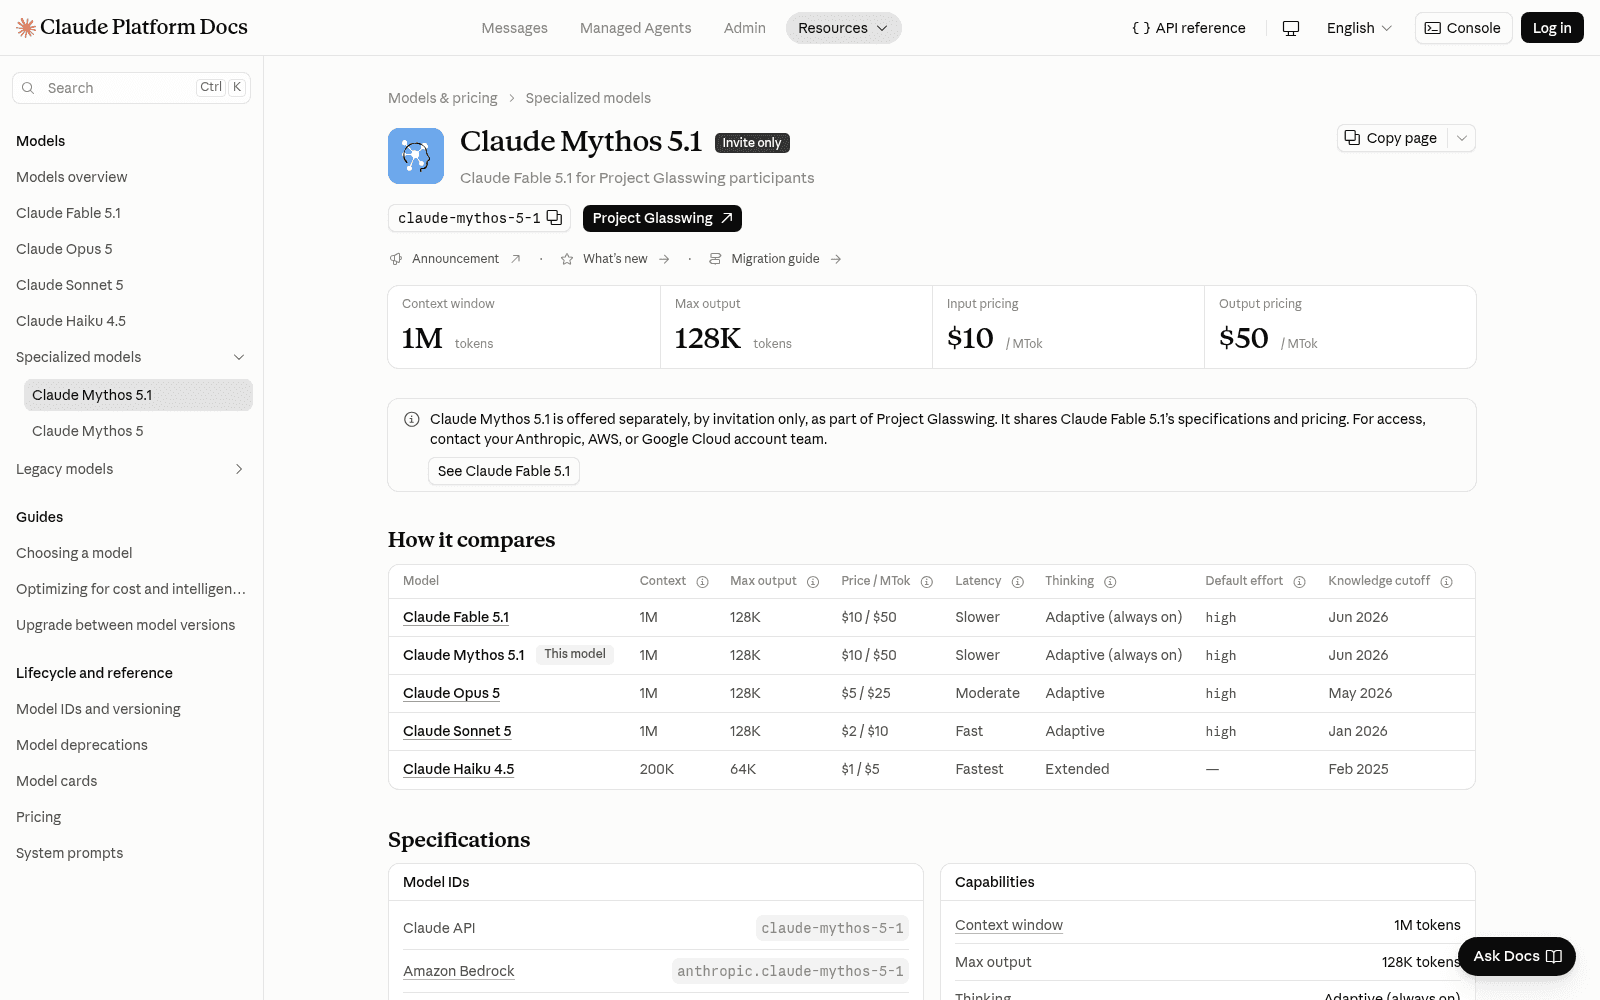
もう一つ、二度読む価値のある一文があります。Mythos 5.1を使用するには、デフォルトで安全性モニタリングのための30日間のデータ保持ポリシーに同意する必要があります。これは調達面での現実的な事実であり、AnthropicがFable側で語っているゼロ保持の話とは鏡写しの関係にあります。
Mythos 5.1とFable 5.1は、2つの鍵を持つ1つのモデル
これは、リリース当日のHacker Newsのスレッドを含め、ほぼ全員を混乱させた部分です。
"Claude Mythos 5.1 is identical to Fable 5.1, but it offers more permissive safeguards for vetted individuals and organizations"
Then why does it have separate datapoints for Terminal Bench, and score higher? Something doesn't add up here??

実際には辻褄が合っており、その答えは謎めいたものではなく、機械的なものです。Anthropicは本番の安全策を有効にした状態でFable 5.1を評価しています。ベンチマークタスクでこれらの安全策が発動すると、そのタスクは単に失敗するのではなく、別のモデルに引き渡されます。サイバーセキュリティのタスクはOpus 4.8が、生物学のタスクはOpus 5が完了しており、OSWorld 2.0では介入されたタスクは一律ゼロ点になりました。つまり、公開されているFable 5.1のスコアは、重みそのものではなく、安全策を含むシステム全体としてのスコアなのです。
Mythos 5.1は、サイバーと生物学の分類器を緩めた、まったく同じ重みです。違いはそれだけです。
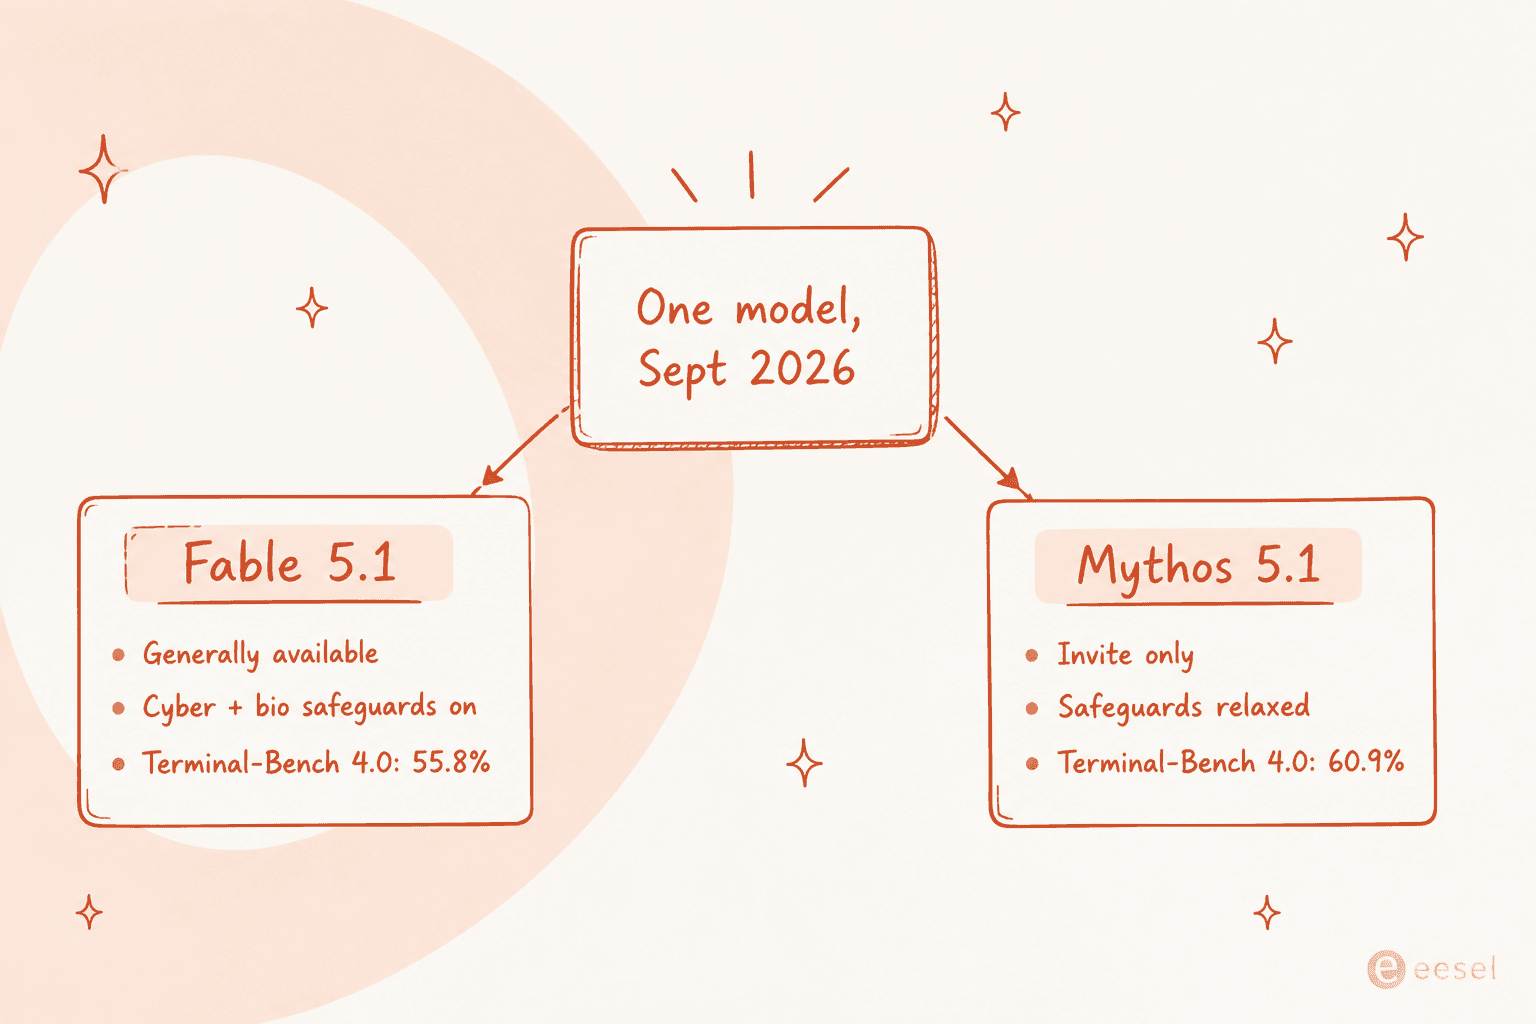
Anthropicは、このギャップが今後縮小していくと明言しています。リリース記事では、Terminal-Benchでの差は以前の、精度の低いサイバー安全策を反映したものであり、同日にリリースされたFable 5.1の改善によって、両モデルの差ははるかに小さくなるはずだとしています。
Mythosに触れることがなくても、Fable側で実際に何が変わったのかは知っておく価値があります。
- Fable 5.1は、以前の安全策がブロックしていたソースコード内のソフトウェア脆弱性の特定に、今では使えるようになりました。
- Claude Codeユーザーは、セッションあたりのサイバー安全策の介入が約60%減少するはずです。
- 生物学の安全策は、Fable 5で導入されたものと比べ、無害な初等生物学・医学の質問に対する発動が85%減少しています。
- デュアルユースの作業は引き続きOpusモデルに振り分けられます。ペネトレーションテスト、エクスプロイトの生成、バイナリベースの脆弱性スキャンなどです。
最後の一点が、正直な境界線です。Fable 5.1はあなたのソースコードを読み、バグの場所を教えてくれます。しかし、エクスプロイトを書いてはくれません。
ベンチマーク、そして本当に重要な1つ
AnthropicはFable 5.1とMythos 5.1の数値を、Fable 5、Opus 5、GPT-5.6 Solと並べて公開しました。特に記載がない限り、以下のスコアはFable 5.1のものです。
| ベンチマーク | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% (60.9% Mythos 5.1) | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 (strict) | 41.7% | 36.1% | 39.6% | not published |
| Humanity's Last Exam (tools) | 65.0% | 63.8% | 63.6% | not published |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
際立っているのはTerminal-Bench-Scienceで、Fable 5に対して2倍以上のスコアになっています。それ以外はより小幅な伸びにとどまり、リリース時のスレッドもそれに気づいていました。
The price reduction comes from the cache read pricing falling from $1/M to $0.25/M, which means that Fable 5.1 now costs half of Opus's cache read costs ($0.5/M).
この見方はコーディング関連の行については妥当ですが、27.9ポイントの跳躍が誤差の産物とは言えないサイエンスの行についてはあまり当てはまりません。Anthropicはこのベンチマークについて、モデルごとに3.5から4.5ポイントの標準誤差があると脚注で述べていますが、それでもこのギャップは十分にノイズの範囲を超えています。
その裏にあるサイエンスのデモこそ、私が実際にスクリーンショットに残しておきたい部分です。Mythos 5.1は、Adaptyv Bioのコンペティションにおいて、3つのターゲットに対する結合親和性で最高スコアの10倍という結果を出すタンパク質バインダーを設計し、12ターゲットにおけるヒット率は通常10〜15%のところ、ほぼ50%に達しました。また、7つのオープンソースのゲノミクス・タンパク質モデルを、出力を変えずに最大2.5倍高速化するGPUカーネルを書き上げ、ゲノム全体解析の推定GPUコストを30〜60%削減しました。それとは別に、Fable 5.1は30年前のMagellanレーダーデータから、金星の3分の1を対象とした新しい高解像度の高度マップを作成しました。
そのどれもがサポート用途ではありません。しかし、そのすべてが、このモデルが扉の向こうにある理由です。
料金:本当のニュースはキャッシュ読み取りの値下げ
Mythos 5.1とFable 5.1は同じ料金表を採用しています。入力は100万トークンあたり10ドル、出力は100万あたり50ドルで、これはFable 5から変わっていません。
変わったのはキャッシュ読み取りの行で、その変化は大きなものでした。
| 項目 | Fable 5 / Mythos 5 | Fable 5.1 / Mythos 5.1 |
|---|---|---|
| ベース入力 | $10 / MTok | $10 / MTok |
| 出力 | $50 / MTok | $50 / MTok |
| 5分間キャッシュ書き込み | $12.50 / MTok | $12.50 / MTok |
| 1時間キャッシュ書き込み | $20 / MTok | $20 / MTok |
| キャッシュ読み取り | $1.00 / MTok | $0.25 / MTok |
| バッチ入力 / 出力 | $5 / $25 | $5 / $25 |
他のすべてのClaudeモデルは、キャッシュヒットの料金をベース入力の0.1倍に設定しています。Fable 5.1とMythos 5.1はそれを0.025倍に設定しており、Anthropicのドキュメントも脚注でこれをモデルファミリー内唯一の例外だと明記しています。また、上記のスレッドが指摘しているように、これはベース価格が2倍であるにもかかわらず、Opus 5のキャッシュ読み取りコストの半分に相当します。
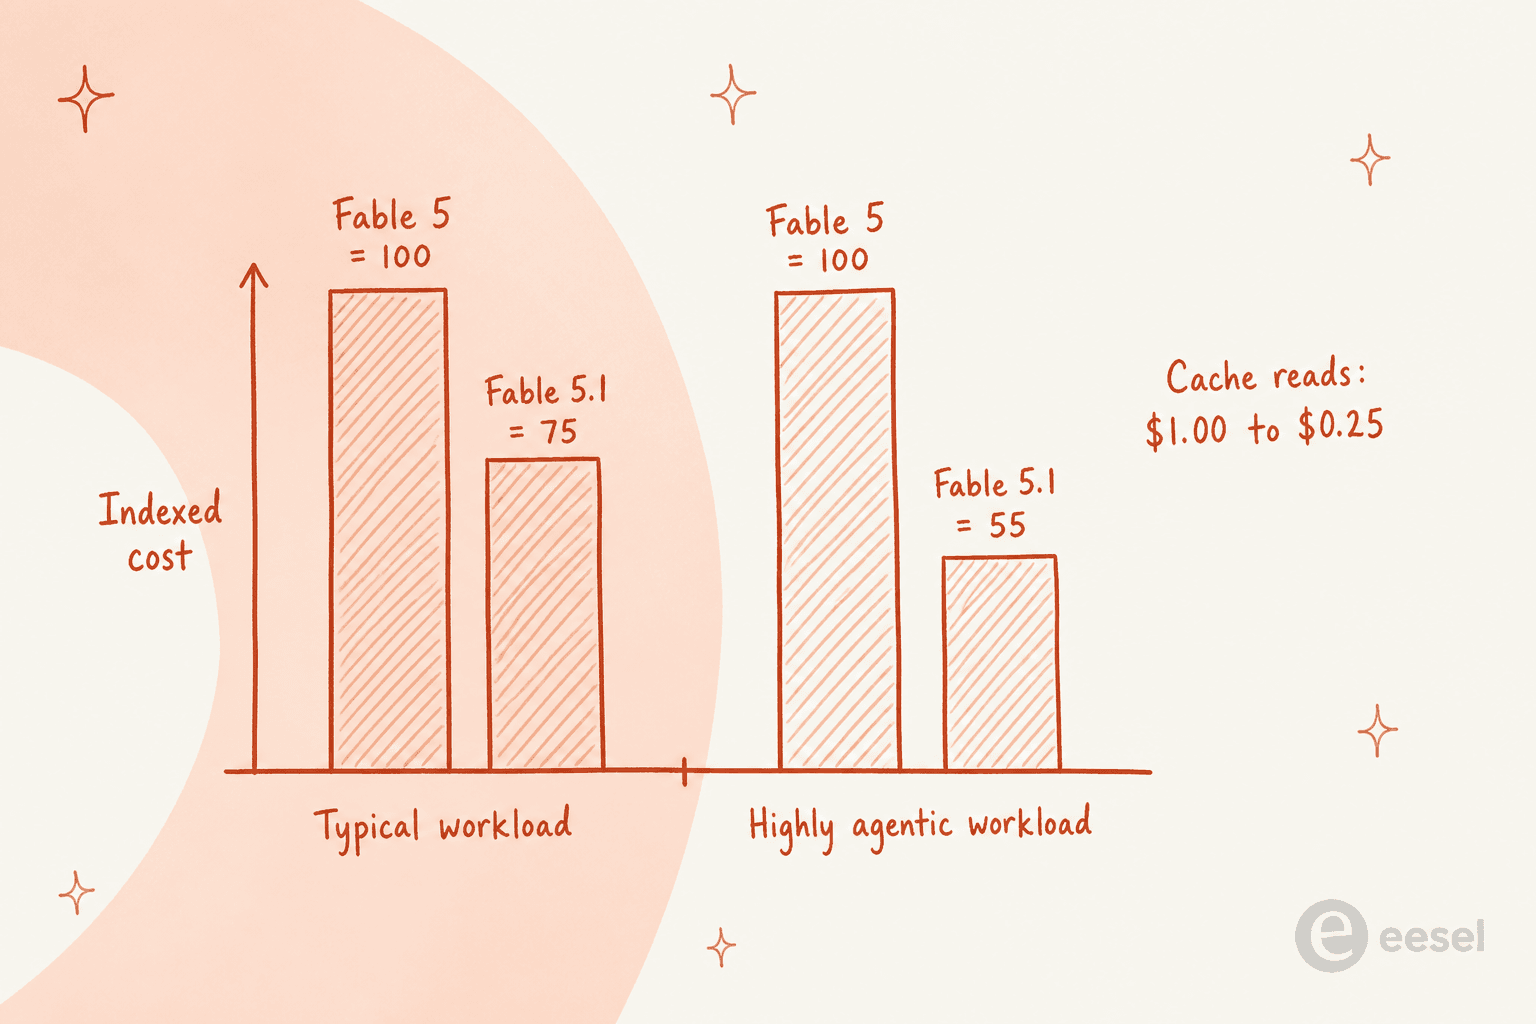
Anthropicは、2026年8月の実際の利用状況をデフォルトのエフォートで4週間にわたって計測しました。Claude Enterprise、Claude Code、APIにまたがる典型的なワークロードでは約25%安くなり、キャッシュ読み取りが請求の大半を占めるような、コンテキストとツールを多用するエージェント的な作業では約45%安くなります。
実務上の影響は、請求額が小さくなるだけでなく、計画の立て方そのものの変化です。
"Cache reads now cost 75% less, or $0.25 per million tokens." For me, at a typical 95% cache hit rate, I think my optimal context window size before autocompaction goes from ~200K to ~400K tokens. Great for longer horizon tasks.
それこそがこの変更の核心です。長いエージェント的な実行では、トランスクリプトはターンごとに読み直されるため、積み上がっていくのはキャッシュ読み取りの計測値です。請求額を抑えるためにコンテキストを積極的に圧縮してきたのであれば、その計算はまさに今変わりました。モデルファミリー全体の料金表は私のAnthropic API料金の解説に、サブスクリプション側についてはClaude料金にまとめています。
この値下げが変えないことが一つあります。長いコンテキストは依然として一律料金で課金されるという点です。Claude 4.6以降のモデルは、100万トークンのウィンドウ全体を標準料金に含めているため、90万トークンのリクエストも9千トークンのリクエストも、トークンあたりの単価は同じです。
アクセスの仕組み
2つのプログラムがあり、どちらも審査制で、現時点ではどちらも米国内に限定されています。
Cyber Verification Program。 CVPは現在、防御的なセキュリティ業務向けに、特定のOpusおよびSonnetクラスのモデルでサイバー関連の安全策を緩和しています。Anthropicは、近い将来Mythosクラスへのアクセスも加わると述べていますが、これは日付ではなく約束にすぎません。申請はAnthropicのプログラムポータルから行います。
Life Sciences Verification Program。 LSVPは、米国政府と共同で開発された招待制のベータプログラムで、専門的な研究開発向けに生物学の安全策を緩和する一方、他のすべての安全策はそのまま維持されます。最初の参加者はすでに登録済みで、Anthropicはより広いライフサイエンスコミュニティへの拡大を計画していると述べています。
既存の企業顧客には3つ目の入り口があります。ドキュメントでは、Anthropic、AWS、Google Cloudのアカウントチームに連絡するよう案内されています。また、Anthropicのコードベーススキャン製品であるClaude Securityは、今ではMythos 5.1上で動作しており、これが直接招待されなくてもこのモデルを利用できる唯一の方法です。
この背景にあるのが、2026年4月のGlasswingの発表です。Mythos Previewは、主要なオペレーティングシステムとブラウザのほぼすべてで数千件のゼロデイ脆弱性を発見しました。その中には、OpenBSDにおける27年前からのリモートクラッシュや、自動テストが500万回もヒットしながら検出できなかったFFmpegの16年前からの欠陥も含まれます。Anthropicは1億ドルの利用クレジットと400万ドルの寄付を約束し、12のローンチパートナーに加え、さらに40のインフラ関連組織を招き入れ、6月までに15カ国以上、約150組織にまで拡大しました。
安全性の面では、Anthropic自身の評価によると、Mythos 5.1はこれまでリリースしたどのモデルよりも強力なサイバー能力を持ちながらも、Frontier Compliance Frameworkの中では依然として低リスクのカテゴリーにとどまり、Responsible Scaling Policyにおける次のリスクレベルには達していないとされています。生物学に関する安全策は、Mythos 5と同じものが適用されています。
誰かの連携を壊すことになる3つの変更
Mythos自体に手が届かないとしても、これらの変更はFable 5.1にも及ぶため、知っておく価値があります。
- 強制的なツール使用はエラーを返す。 コードで
tool_choiceをanyや名前付きツールに設定している場合、その呼び出しは今後失敗します。誰かに障害通知が飛ぶ可能性が最も高い変更です。 - Thinkingブロックは、それを生成したモデルに紐づく。 以前のモデルはFable 5.1やMythos 5.1のthinkingブロックを読み取れず、以前のターンを編集するとそのブロックは無効になります。
- 蒸留対策がマルチターン編集を変える。 リリース日以降に作成された新規APIアカウントは、以前のthinkingのトランスクリプトを保持したまま、Claudeの過去のコンテキストを手動で編集することができなくなりました。既存のアカウントは今のところ影響を受けませんが、この変更は今後のモデルリリースではすべてのユーザーに適用されます。
長く尾を引くコンプライアンス上の変更もあります。EU AI ActのAI生成コンテンツの透明性に関する実践規範を満たすため、2026年8月2日以降にリリースされたモデルにはテキストの電子透かしが埋め込まれ、規制当局、研究者、義務対象企業向けに検出APIがプライベートプレビューとして提供されています。Anthropicによれば、検出APIなしでは目に見えず、ユーザーやその会話に関する情報も含まれていないとのことです。これはリリース時のスレッドで最も物議を醸したトピックであり、コンテンツパイプラインが出所に関するポリシーを持っているなら知っておく価値があります。私のAIコンテンツとE-E-A-Tに関するノートでは、公開面についてまとめています。
用途別に見る、代わりに使うべきモデル
これを読んでいるほぼ全員が、実際に呼び出せるモデルの中から選んでいるはずです。私ならこう振り分けます。
- 今すぐ使えるフロンティアの上限。 Fable 5.1。Mythos 5.1と同じ重み、同じ価格で、待機リストもありません。背景についてはClaude Fable 5とは何かとFable 5の再リリースをご覧ください。
- デフォルトの主力モデル。 入力5ドル・出力25ドルのOpus 5。Anthropic自身のドキュメントも、ほとんどのワークロードはここから始め、評価結果が不十分な場合にのみ上位モデルへ移行するよう案内しています。Opus 5のレビューには私の評価を、Opus 5の料金には料金表をまとめています。
- レイテンシに敏感な作業向け。 入力2ドル・出力10ドルのSonnet 5。コンテキストウィンドウは同じ100万トークンです。詳しくはSonnet 5の料金とSonnet 5のレビューをご覧ください。
- コーディングエージェント向け。 請求額はモデルの階層よりもエフォートレベルの方が大きく動きます。読むべきなのはClaude Codeのモデル選択とClaude Codeの料金の2本です。
- 長時間のオーケストレーション向け。 Claude Managed Agentsはトークンに加えてセッションの実行時間を課金しますが、これはキャッシュ読み取りの値下げの対象外です。
- 選択肢全体を比較検討したい場合。 Anthropicに縛られていないならClaudeの代替やOpus 5の代替、直接比較したいならGPT-5.6とClaudeの比較をどうぞ。
コードや研究ではなく顧客対応が仕事であれば、モデルの階層の話はほとんど関係ありません。私がまとめたサポートチケットに最適なモデルでは実際のトレードオフを解説しており、カスタムAIモデルでは自前でモデルを訓練する価値がある場合について扱っています。
フロンティアモデルではサポートキューの何が解決しないのか
ここは慎重に言いたいところです。Mythos 5.1の結果は本物であり、そのサイエンスに異論を挟むのは難しいからです。しかし、私が何度も目にしてきた、名前をつけてもいいほどの失敗パターンがあります。
あるチームがリリース記事を読み、サポートボットの背後にあるモデルをアップグレードして、解決率が動くことを期待します。しかし、動きません。解決率を動かすのは、モデルが正しいナレッジを参照できているか、いつ止めてエスカレーションすべきかを分かっているか、そして顧客が目にする前に実際のチケットに対してテストされていたかどうかです。そのどれもがモデルの階層の問題ではありません。
この中で「信頼」に関わる半分こそが、お金のかかる部分です。あるDTCサプリメントブランドのCX責任者は、営業の商談でこう述べています。
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
これはスコープと制御の問題であり、Terminal-Benchで60.9%というスコアはそれについて何も語りません。今回のようなリリースの後、多くのチームが行き着く「自分たちで作る」という選択肢も同様です。GENERAL BYTESのKarel氏は、そのトレードオフを率直に語っています。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
APIキーは安い部分です。検索(retrieval)、権限の境界線、エスカレーションのルール、評価用のハーネス、そして製品が変化するのに合わせてこれら4つをメンテナンスし続けることこそが、コストのかかる部分です。この作業は、キャッシュ読み取りが安くなったからといって安くなるわけではありません。
eeselが担う役割
eeselが販売しているのはモデルではなく、AIチームメイトです。AIヘルプデスクチームメイトは、あなたが既に運用しているキューに加わり、既にあるヘルプセンターや過去のチケットを読み込み、あなたが設定したスコープの範囲内で回答します。AIブログライターも、コンテンツについて同じ役割を果たします。どちらも、その役割に必要な連携と企業のコンテキストを備えた状態で提供されます。これはまさに、素のフロンティアモデルには付いてこないレイヤーです。

この記事のテーマを踏まえて特に指摘したいのは次の点です。eeselのチームメイトは、たった一人の実際の顧客に応答する前に、あなた自身の過去のチケットに対して実行され、実際に何と答えていたかを確認できるようにします。これは、モデルのリリースからは決して得られないドライランであり、アップグレードを出荷することと、単なる推測を出荷することの違いです。Zendesk、Freshdesk、Gorgias、Front、Help Scout、HubSpotと数分で連携でき、試すのは無料です。
サポートキューのためにMythos 5.1を追い求めるのは、そもそも制約になったことのない変数を最適化しているにすぎません。Claudeをヘルプデスクに接続する方が、午後の時間をよほど有意義に使えますし、サポートにClaudeを使うことは、そこから何が得られるかについての正直なバージョンです。
Claude Mythos 5.1に対する私の結論
これはAnthropicがこれまでにリリースした中で最も高性能なモデルであり、あなたには利用できず、しかもあなたが利用できるバージョンは同じモデルなのです。これはなかなか書ける機会のない、珍しい事実であり、この記事の中で最も役立つ一文でもあります。
サイバー防御担当者やライフサイエンス研究者であれば、申請してください。サイエンスの成果が、その手続きの手間に見合うものだからです。それ以外の人にとって重要なリリースは、Fable 5.1のキャッシュ読み取り価格です。これは静かに、長いコンテキストを使うエージェント的な作業を約45%安くしました。今四半期、これは施錠されたモデルよりもはるかに多くの本番システムを変えることになるでしょう。
よくある質問
Claude Mythos 5.1とは何ですか?
claude-mythos-5-1としてリリースされました。Fable 5.1と同じ基盤モデルですが、サイバーセキュリティと生物学の安全策が緩められた形で提供され、Project Glasswingを通じて招待制でのみ利用できます。以前のClaude Mythos解説記事では、このモデルファミリーの始まりを扱っています。Claude Mythos 5.1の料金はいくらですか?
Claude Mythos 5.1へのアクセスはどうすれば得られますか?
Claude Mythos 5.1とClaude Fable 5.1の違いは何ですか?
Claude Mythos 5.1はBedrockやGoogle Cloudで利用できますか?
claude-mythos-5-1というIDでClaude Mythos 5.1が掲載されています。プラットフォームに掲載されていることと、実際に呼び出せることは別問題で、招待は依然として必要です。Claude Mythos 5.1の代わりに何を使うべきですか?
Claude Mythos 5.1は100万トークンのコンテキストウィンドウを持っていますか?
highです。Anthropicはこのウィンドウ全体を標準料金で課金するため、90万トークンのリクエストも9千トークンのリクエストも、トークンあたりの単価は同じです。Claude Codeのコンテキストサイズの記事では、これが日々の運用で何を意味するかを解説しています。Claude Mythos 5.1を顧客データに使っても安全ですか?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.