
Claude Sonnet 5.5とは何か
Claude Sonnet 5.5はAnthropicのミドルクラスのモデルで、Opus 5.5の6日後に出たClaude 5.5ファミリーの2番目のリリースです。Anthropicはこれを、Opusの"a faster, lower-cost complement"と位置づけています。Opusは慎重な判断が必要な複雑な作業向けに残し、Sonnetは範囲の明確な日常タスクを担当します。Haiku 5.5も"in the coming weeks"と予告されています。
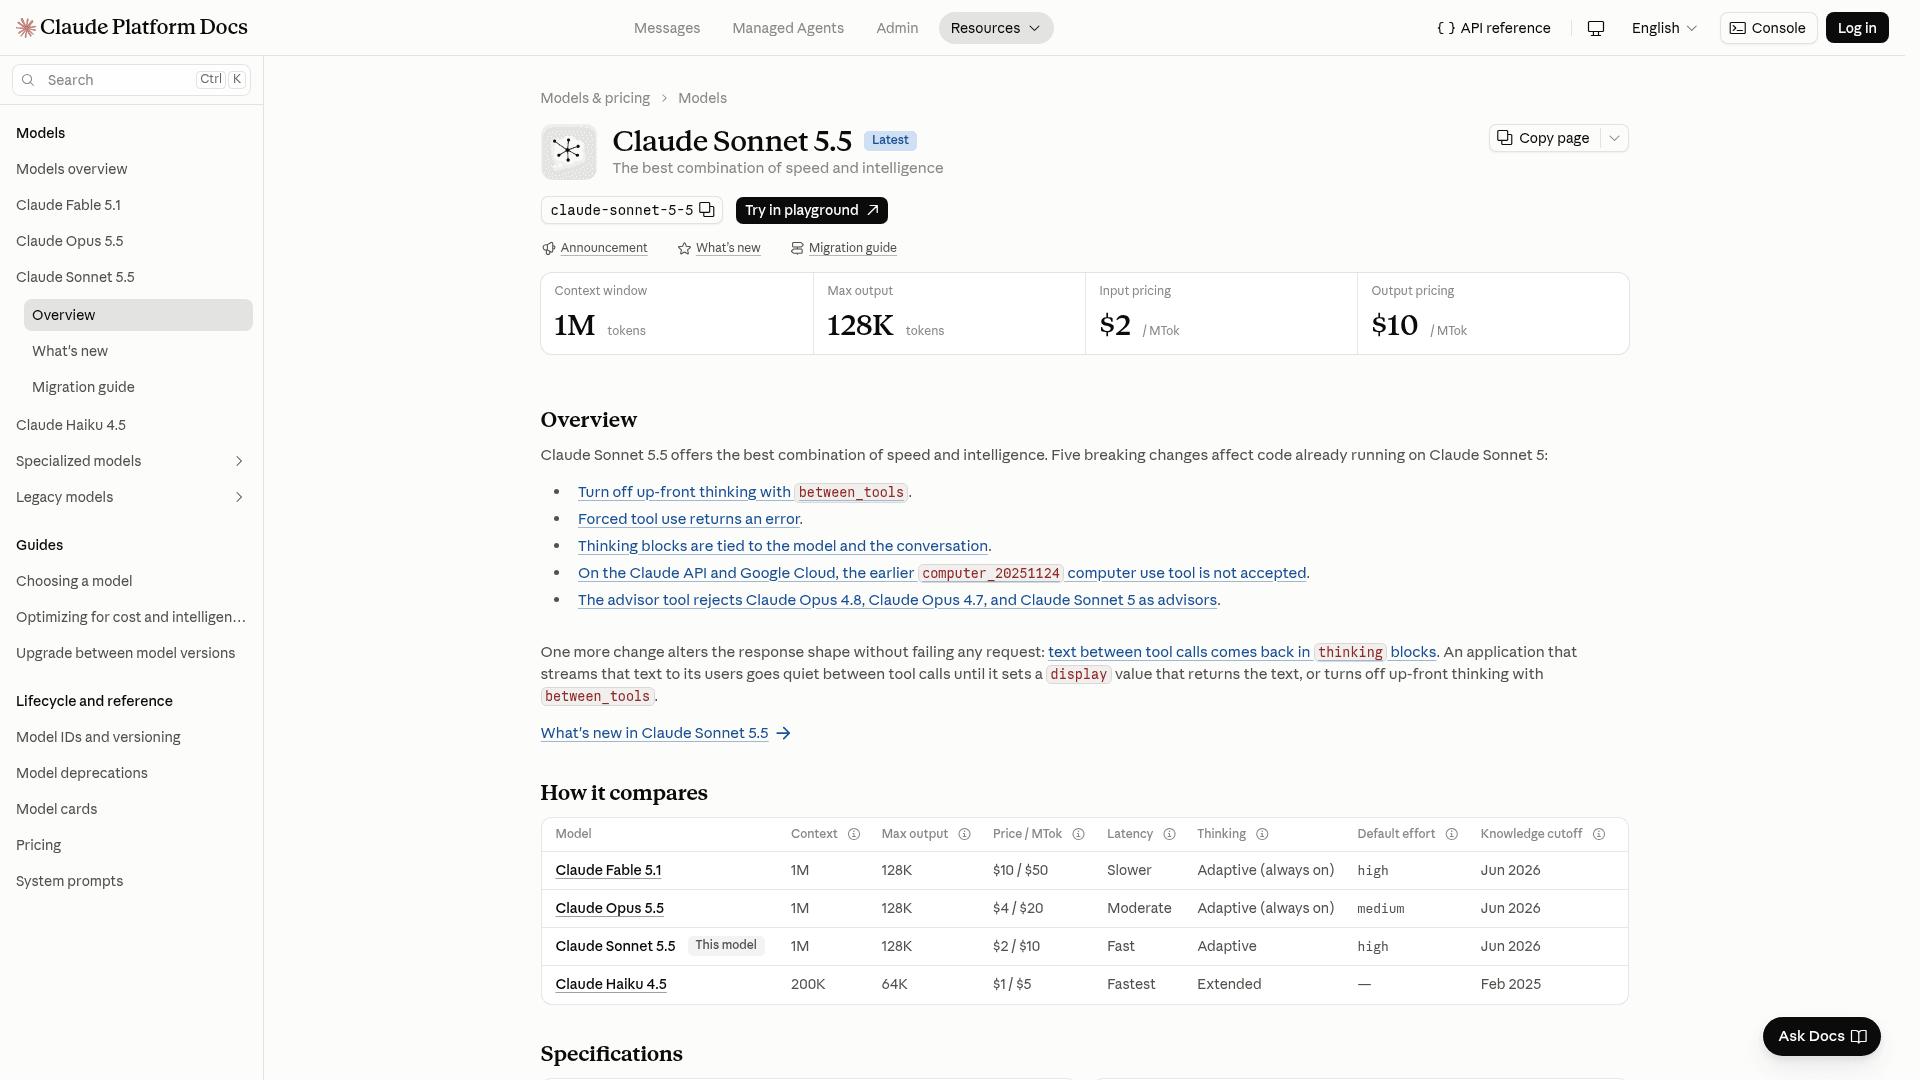
モデル概要ページに記載されているスペックは次のとおりです。
- モデルIDは、Claude API、Google Cloud、Microsoft Foundry、Claude Platform on AWSでは
claude-sonnet-5-5、Amazon Bedrockではanthropic.claude-sonnet-5-5です。 - コンテキストは入力100万トークン、出力128Kで、Batch APIではベータヘッダー付きで出力300Kです。
- 信頼できる知識カットオフは2026年6月で、Opus 5.5やFable 5.1と同じです。
- thinkingは適応型で、デフォルトのエフォートはAPIでは
high、ClaudeアプリとClaude CodeではMediumです。 - 提供終了は"not sooner than September 28, 2027"で、次の移行までに少なくとも1年あります。
what's newページによると、トークナイザーはClaude Sonnet 5と同じで、同じテキストなら同じトークン数になります。この点は見た目以上に重要です。Anthropicが主張する節約はすべて、数え方が有利になったからではなく、モデルが書く量が減ったことから来ているということです。
本当の話:価格は同じ、請求は小さく
定価は何も動いていません。Sonnet 5.5の料金はSonnet 5の料金とまったく同じで、入力$2、出力$10、キャッシュ読み取り$0.20です。変わったのは、1つの仕事を終えるまでに使うトークン数です。
ローンチ記事にある早期アクセスの数字は、普段あまり見ないほど具体的です。
- Balyasny Asset Managementは2,441件の金融タスクを実行し、Sonnet 5.5が1回答あたり約121kトークン、Sonnet 5は497kトークンで、しかもスコアは高かったと報告しています。
- Slackは、オフラインのSlackbot評価の"almost all"で"with about 14% fewer output tokens"という、より良い結果を得ており、プロンプトは一切変更していません。
- Base44では、アプリのビルドが平均3.6回のイテレーションで終わり、Opus 5では7.7回でした。
- Lovableは"a third fewer tool calls and roughly half the shell runs to finish a task"を計測しました。
Anthropic自身の並べての比較も、視覚的に同じことを示しています。1つのHTMLファイルで400羽のムクドリの群れを作るよう両モデルに頼んだところ、Sonnet 5は4,520トークンの時点でまだコードを書いていました。
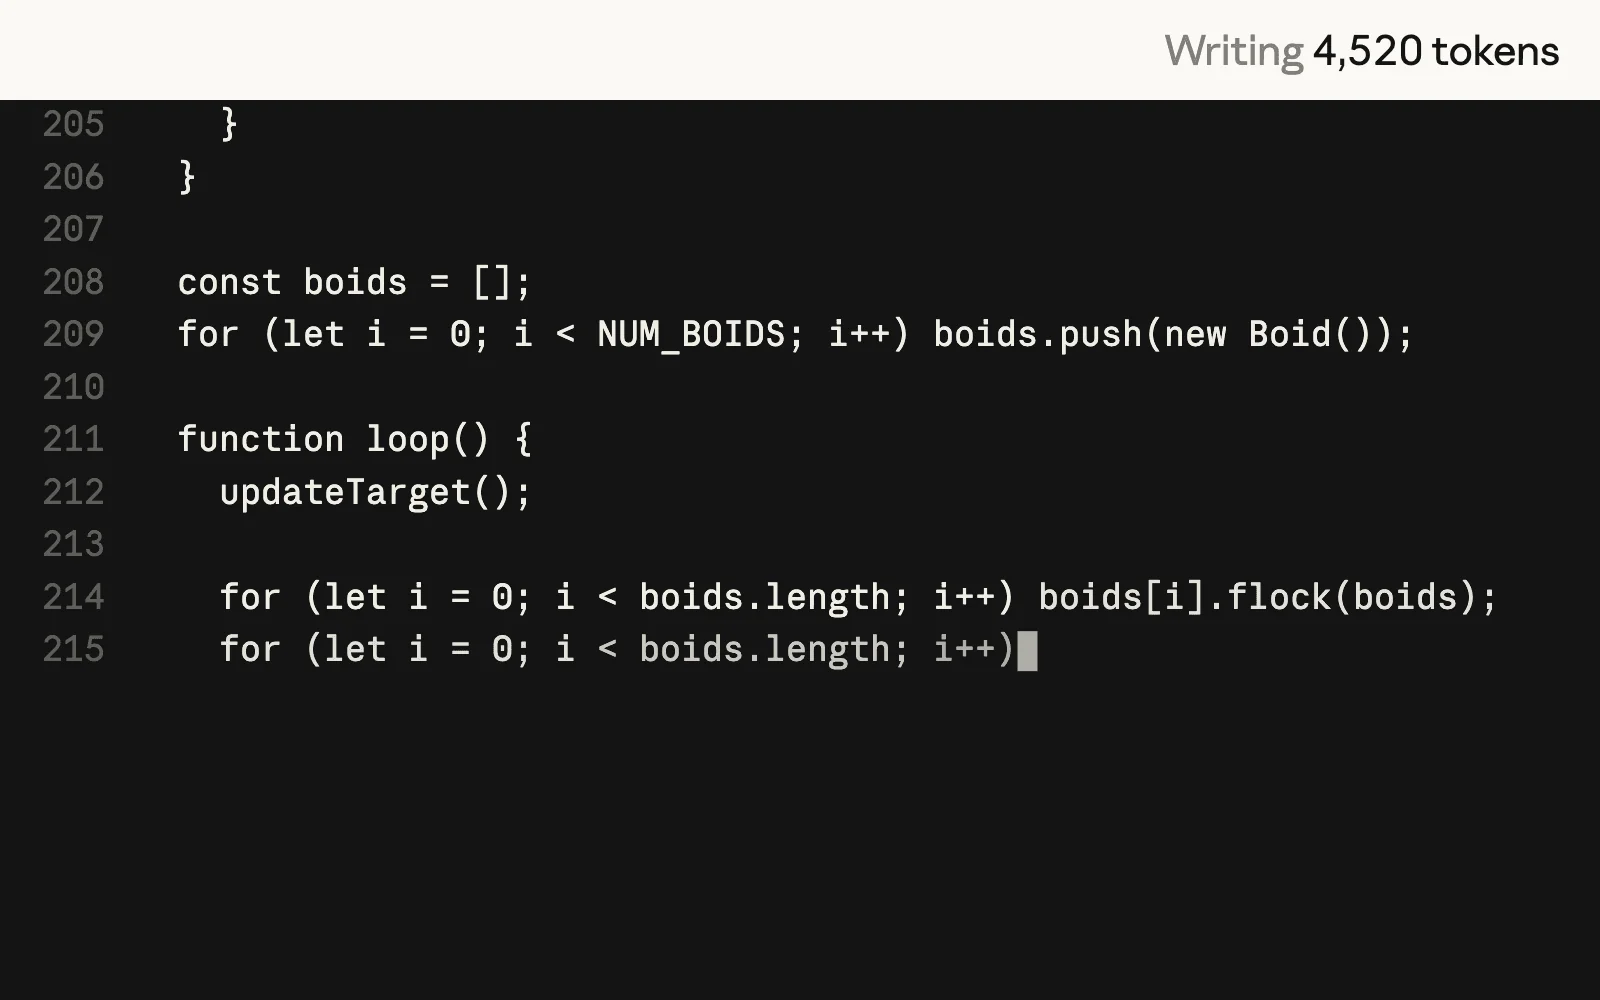
Sonnet 5.5は4,158トークンですでに完成しており、その時点で群れは12.5秒間飛んでいました。
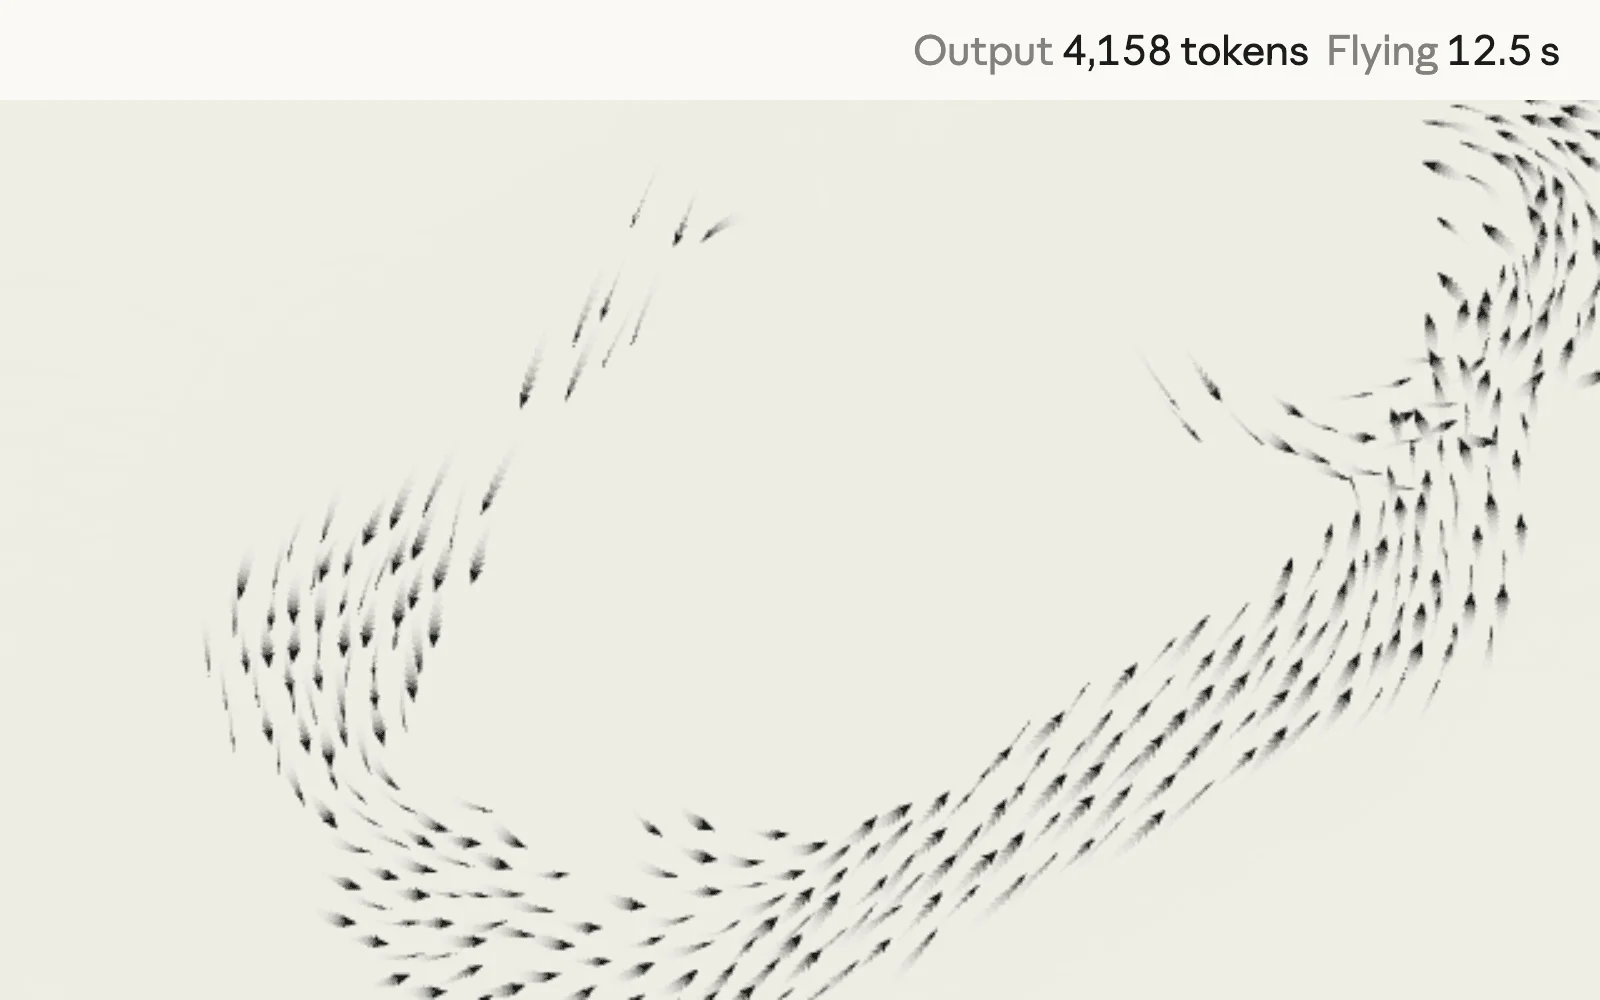
顧客ごとの差にこそ、正直な読み方があります。Balyasnyのトークン4分の1とSlackの14%削減はどちらも本物で、節約幅は、そもそもSonnet 5の実行がどれだけ膨らんでいたかに大きく左右されることを示しています。Anthropicの見出しは"up to 30% less per task"で、この文では"up to"が大きな役割を果たしています。Sonnet 5には長くなりがちな癖があり、Artificial Analysisのテストでは、最大エフォートでタスクあたり183ターンかかり、グラフ上で最悪でした。自社のワークロードがそうだったなら大きい数字が期待でき、プロンプトですでに回答を短く保っていたなら、Slackに近い数字になるでしょう。
Opus 5.5にどこまで迫るか
Opusの価格を払っている人にとって、ここがこのリリースの面白いところです。Anthropicのローンチ時のベンチマーク表では、Sonnet 5.5は、トークンあたり2倍の価格のモデルとの差の大部分を埋めています。
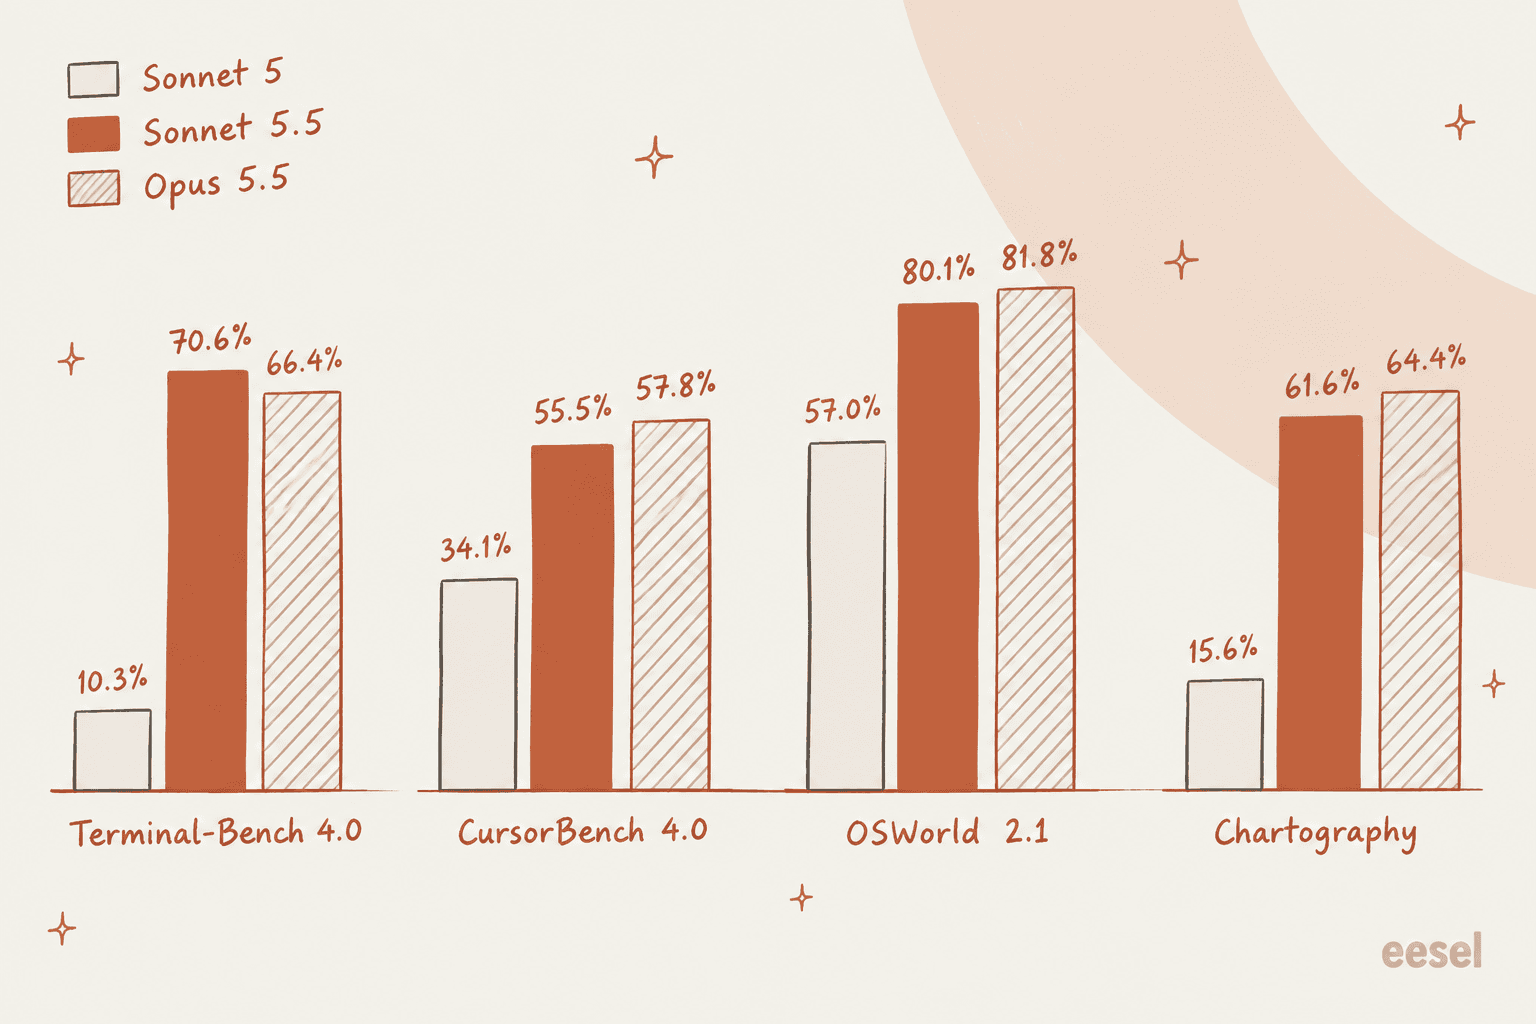
| ベンチマーク | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0(エージェント型コーディング) | 70.6% | 10.3% | 66.4% | 未報告 |
| FrontierCode 1.1(マージ可能なコード) | 52.1%(Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | 未報告 |
| GDPval-AA v2.1(ナレッジワーク、Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1(長期的な作業、Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam(ツールあり) | 64.5% | 54.9% | 67.7% | 未報告 |
| OSWorld 2.1(コンピューター操作) | 80.1% | 57.0% | 81.8% | 未報告 |
| Chartography(グラフ読み取り) | 61.6% | 15.6% | 64.4% | 53.6% |
目を引く点がいくつかあります。まず、Terminal-Benchで10.3%から70.6%への跳ね上がりは非常に大きく、このテストではSonnet 5.5がOpus 5.5を実際に上回っています。44職種の実務を測るテストであるGDPval-AAでは、Opus 5.5とのEloの差はわずか2ポイント、Sonnet 5とは約400ポイントの差です。さらに、Anthropicが比較対象に選んだライバルのGPT-6 Solに対して、最高エフォート設定のSonnet 5.5は、OpenAIのモデルにスコアがあるすべての行でリードしており、Highエフォートでは、GPT-6 SolのFrontierCode最高結果に、タスクあたり約5分の1のコストで並びます。
Anthropicが限界について率直なのはありがたい点です。ローンチ記事には"in our own testing, and in that of external testers, Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment"とあります。ベンチマークは、明確な正解があるタスクを評価しがちです。怒っているエンタープライズ顧客に返金が必要か、謝罪か、あるいはエスカレーションかを決めるような自由度の高い判断こそ、Opusの追加コストが今も見合う場面です。この最上位クラスについては、Opus 5.5 vs GPT-6 Solの比較でさらに詳しく扱っています。
読む価値のある脚注がもう1つあります。FrontierCodeのスコアは、Xhigh(52.1%)よりMaxエフォート(46.2%)のほうが下がります。Anthropicの説明では、Maxではコードレビューをサブエージェントに分割することが増え、それがタイムアウトやタスクの範囲を超える編集につながったとのことです。考える量が多いほど良いとは限らず、これはOpus 5のエフォートガイドでも見られたパターンです。
Sonnet 5.5がサポートチームにとって意味すること
ローンチ記事から1つだけ引用をサポートリーダーに見せるなら、これを選びます。ZendeskのDirector of AIが、実際のチケットでモデルを試しました。
"We fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions and resolved tickets faster than the Claude models we use in production today. Tickets were processed 20% faster, getting our customers the help they need without the wait."
Abhinay Kathuria、ZendeskのDirector of AI、Anthropicの発表より
ここで重要なのは"Fewer wrong decisions"の部分です。速さは良いことですが、サポートキューでは、速くて間違った回答は、遅くて正しい回答よりコストがかかります。2件目のチケットと怒りのフォローアップが生まれ、場合によっては返金まで発生するからです。Zendesk AIはすでにClaudeモデルを本番で動かしているので、現在の構成と比べてエスカレーション判断が良くなったという主張には重みがあります。Atlassianは規模に関する関連した指摘として、チームはRovoエージェントを"up to 30% faster than they could with Sonnet 5"で動かせると述べ、Slack AIもすでにSlackbot向けに試験しています。
キューの側から見て、Claudeのラインナップをサポート業務に当てはめるなら、次のようになります。
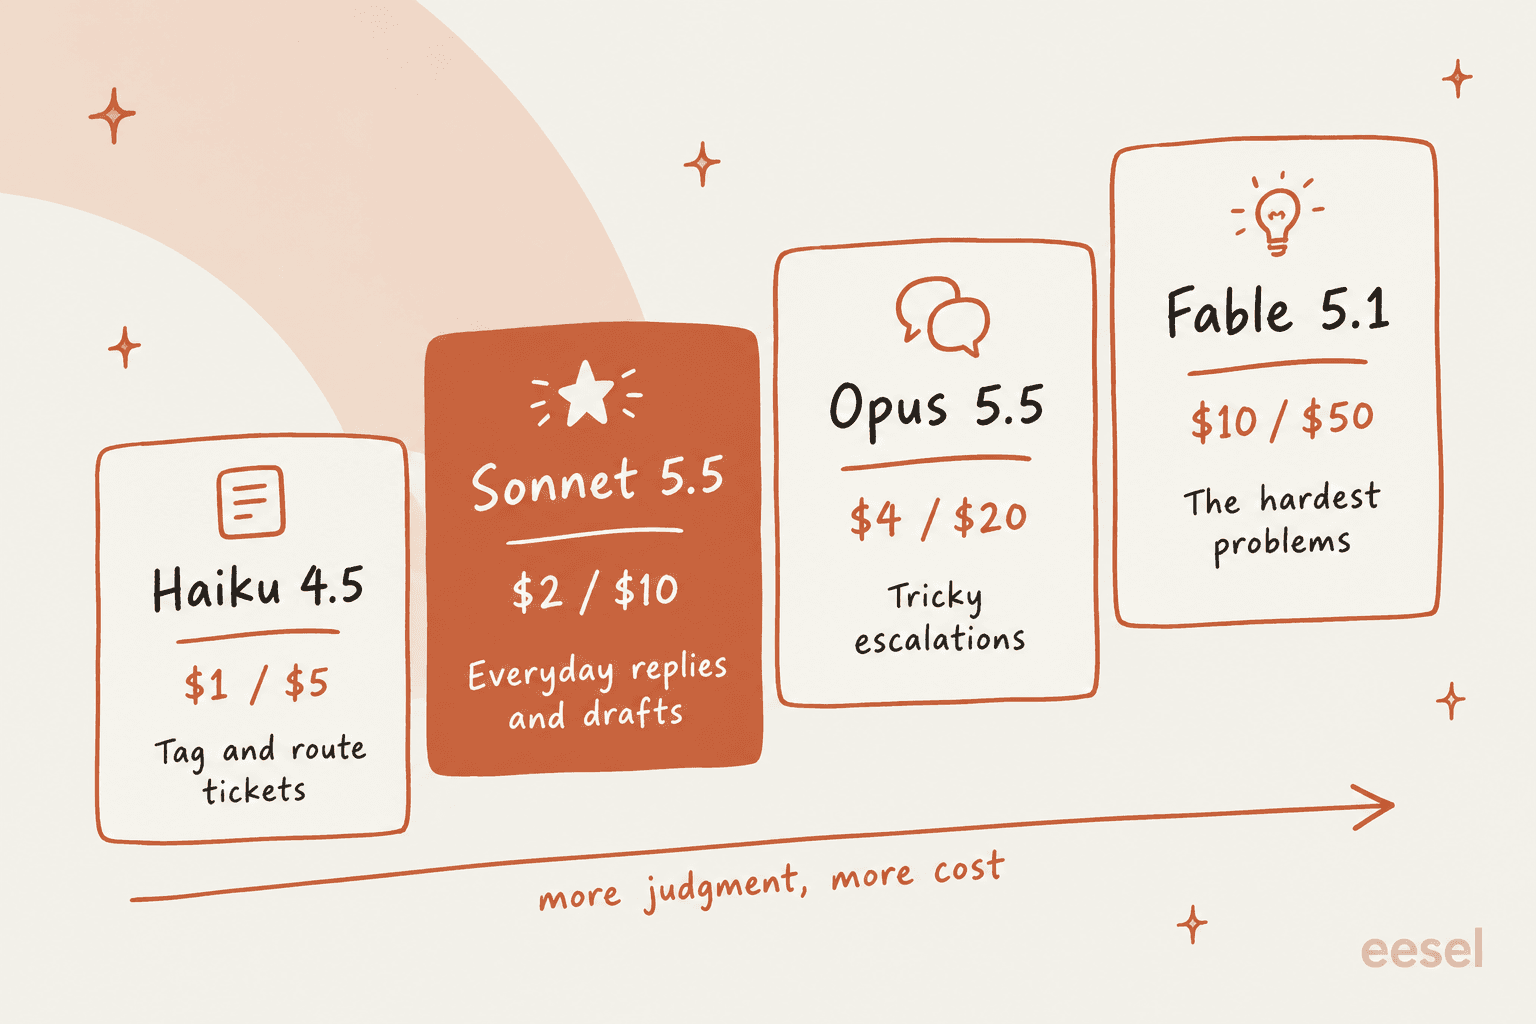
Sonnet 5.5は、キューの大半、つまり注文に関する質問、使い方の回答、ポリシーの確認、担当者が承認する最初の下書きの自然なデフォルトです。Haikuはチケットのトリアージとタグ付け向けの安価な選択肢のままです。Opus 5.5は、判断が必要なチケット、つまりシニア担当者がどのみち引き受けるチケットに回します。30%以上の速度向上が最も効くのはライブチャットです。顧客が入力中インジケーターを見つめているからです。
正直な注意点です。より良いモデルでも、欠けている答えは直りません。ヘルプセンターに"we support all models"と書かれていたせいで、ボットが顧客に製品が対応していると自信満々に伝えた例や、検索結果が空のときに回答をでっち上げた別のボットを見たことがあります。どちらもモデルの品質の問題ではありませんでした。どちらも根拠づけ(グラウンディング)の問題で、賢いモデルはむしろ、自信に満ちた誤答をいっそう説得力のあるものにしかねません。だからeeselは、下でどのモデルが動いていても、AIが誰かに返信する前に、過去のチケットですべてのロールアウトをシミュレーションします。
移行前に:いまエラーを返す5つのこと
ローンチ関連の記事の多くはこのセクションを飛ばしますが、実際にあなたの午後を潰すのはここです。claude-sonnet-5をclaude-sonnet-5-5に変えるのは1行です。その裏で、what's newページには5つの破壊的変更が載っており、同じチェックリストに入れるべきルールがもう1つあります。
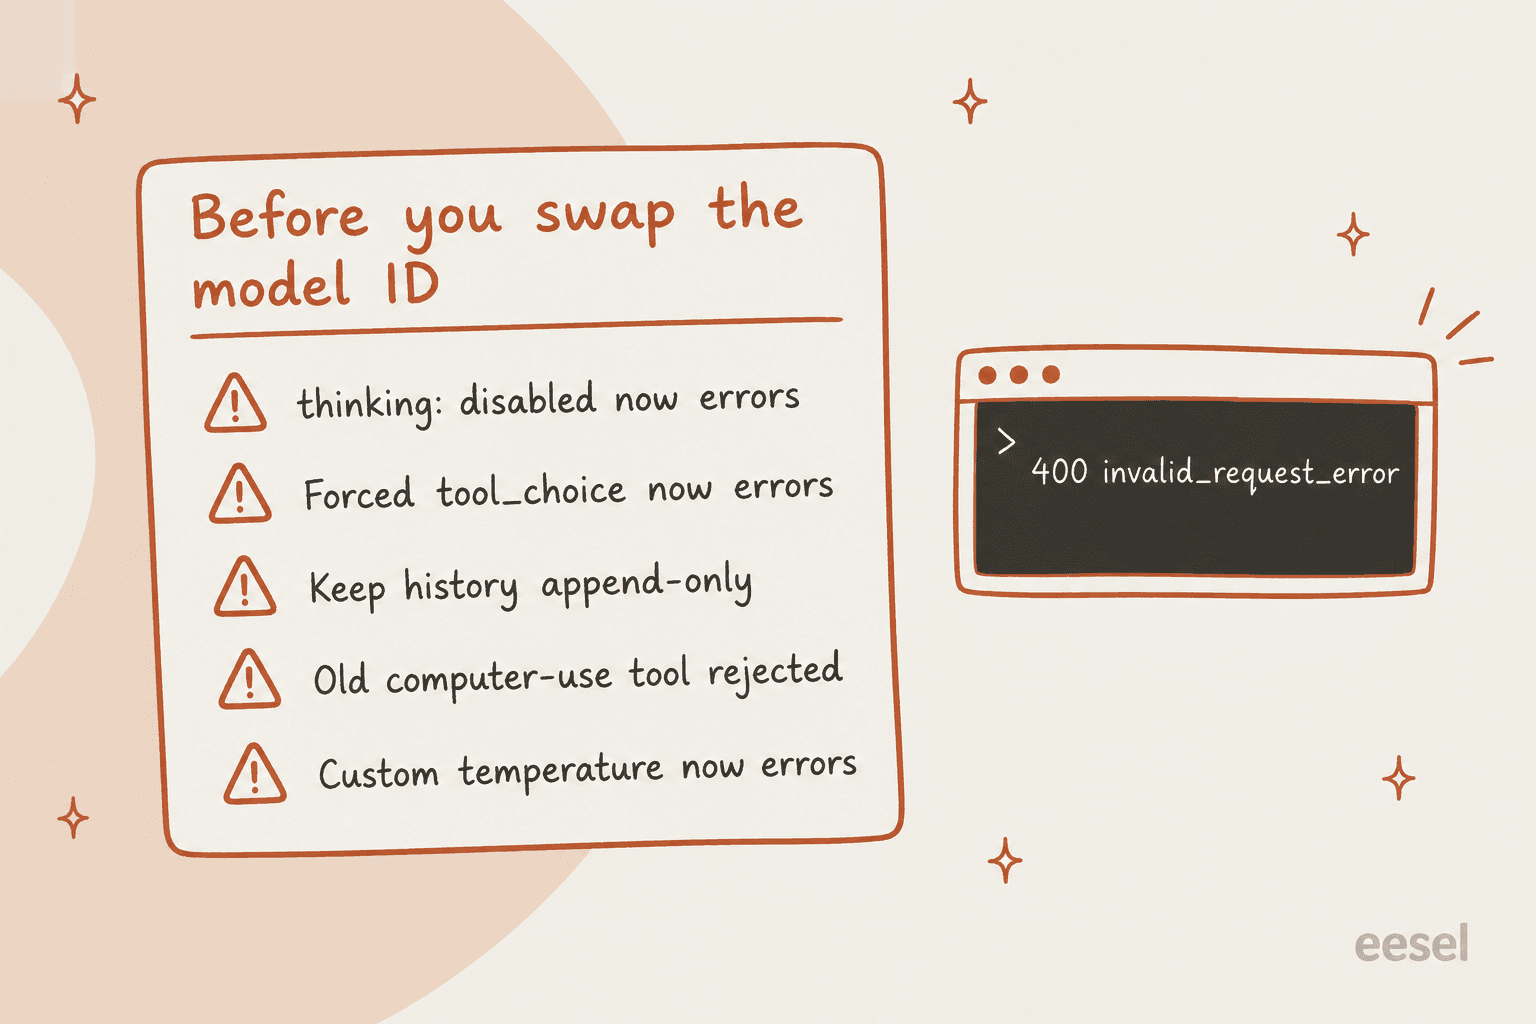
thinking: disabledは400を返します。 代わりにthinking: {"type": "between_tools"}を送ると、最初のthinkingがオフになります。これはhighエフォート以下でのみ動作し、xhighやmaxではやはりエラーになります。- ツール使用の強制がなくなりました。
tool_choiceをanyまたは名前付きのtoolに設定するとエラーになります。対処はautoとstrict tool useの組み合わせです。 - thinkingブロックはモデルとアカウントに紐づきます。 以前のメッセージ、システムプロンプト、ツールを編集したうえでSonnet 5.5のthinkingブロックを再生すると、新しいアカウントでは400になります。会話は追記のみにしてください。
- 旧
computer_20251124ツールは拒否されます。 Claude APIとGoogle Cloudでの話で、Bedrockではまだ受け付けます。 - 一部のadvisorの組み合わせは拒否されます。 Opus 4.8、Opus 4.7、Sonnet 5は、Sonnet 5.5のexecutorをもうadviseできません。
追加のルールについて、ドキュメントには、このモデルでtemperature、top_p、top_kをデフォルト以外の値に設定すると400が返ると記載されています。
サポートにとっての落とし穴は2番目です。多くのヘルプデスクボットは、構造化出力を保証するためにツール呼び出しを強制しています。"always call classify_ticket"、"always call draft_reply"のようにです。Sonnet 5.5では、そのリクエストはあっさり失敗します。Anthropic API上で独自の連携を作っているなら、モデルIDを触る前に、まずtool_choiceをgrepしてください。
エラーにはならないものの、ユーザーを混乱させる、もっと目立たない変更もあります。ツール呼び出しの間にモデルが書くテキストは、thinkingブロックの中で返るようになり、デフォルトのdisplay: "omitted"ではそのテキストは空です。エージェントの作業中に"Checking your order status..."をストリーミング表示しているチャットウィジェットは、displayの値を設定するまで無言になります。Anthropicはエフォートのレベルも再調整しているので、Sonnet 5の設定を引き継がず、エフォートのテストをやり直してください。モデルの入れ替えでボットのエスカレーションのタイミングが変わる場合は、AIエージェントの引き継ぎガイドも読む価値があります。
最後に安全性です。Sonnet 5.5は、サイバー能力がOpus 5に匹敵するため、サイバー保護策付きで公開された最初のSonnetです。リスクの高いサイバーセキュリティのリクエストは"visibly fall back to Sonnet 5"し、拒否されたリクエストはHTTP 200とstop_reason: "refusal"を返します。サポートボットでこれが発動することはまれでしょう。ただしセキュリティやIT関連の顧客に対応しているなら、空の返信を表示するのではなく、拒否のケースを処理しておく価値があります。
Claude Sonnet 5.5の料金と利用方法
Anthropicの料金ドキュメントにある、100万トークンあたりの料金表です。
| 100万トークンあたりの料金 | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|---|
| 入力 | $2 | $2 | $4 | $1 |
| 出力 | $10 | $10 | $20 | $5 |
| 5分キャッシュ書き込み | $2.50 | $2.50 | $5 | $1.25 |
| 1時間キャッシュ書き込み | $4 | $4 | $8 | $2 |
| キャッシュ読み取り | $0.20 | $0.20 | $0.20 | $0.10 |
| Batch入力 / 出力 | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| コンテキストウィンドウ | 1M | 1M | 1M | 200K |
この表について補足が2つあります。Thinkingは出力トークンとして課金されるため、highエフォートの実行では、推論の分も100万トークンあたり$10がかかります。また、モデル概要によれば、キャッシュ可能な最小プロンプトは512トークンになり、安定したサポート用システムプロンプトをキャッシュしやすくなりました。
これらの料金をサポートの言葉に置き換えるために、公開価格だけを使った例示的な計算を示します。チケット返信で入力6,000トークン(チケットと取得したヘルプ記事)を送り、出力800トークンが返ってくるとします。入力が$0.012、出力が$0.008で、チケット1件あたり約2セントです。その入力のうち5,000トークンがキャッシュ済みのシステムプロンプトなら、入力側は約$0.003に下がり、返信全体では約1.1セントになります。月10,000チケットなら、thinkingトークンを除いて、キャッシュなしで約$200、キャッシュありで約$110です。実際の数字はエフォートや検索サイズで変わりますが、AIサポートエージェントの請求書で、モデルの行が大きなコストになることが少ない理由は見て取れます。
利用できる場所は次のとおりです。
- Claude API:
claude-sonnet-5-5として、プロンプトキャッシュとBatch APIつきで利用できます。ゼロデータリテンションも利用可能です。 - Claudeアプリ:Anthropicは、Web、iOS、Androidで"anyone can chat with Claude using Sonnet 5.5 on Claude.ai"としています。有料プランはClaude Proの料金ガイドで扱っています。
- Claude Code:デフォルトのエフォートはMediumです。サブスクリプションとAPIの費用比較はClaude Codeの料金ガイドで扱っており、モデルの固定は設定1つで済みます。
- クラウド:Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWSで、いずれも初日から利用できます。
比べているのがティアではなくプロバイダーなら、3社APIの比較とGPT-6 Solの料金内訳が最も手早い確認になります。
開発者の声
Hacker Newsのローンチスレッドは1日で550件を超え、反応はかなりきれいに分かれています。速さは好評で、ベンチマークも評価されている一方、反論の多くはOpus 5.5との位置づけに向けられています。
"Playing around with it for a few minutes, Sonnet 5.5 feels very fast, much quicker than Opus 5.5. Can't tell yet if it's a lot worse but the speed is definitely welcome."

最も鋭い批判は、高いエフォート設定に関するものです。Simon Willisonは、いつものSVGテストをすべてのエフォートレベルで計測し、lowは1.6セント、mediumは1.8セント、highは2.3セントだったのに対し、maxはthinkingの予算を使い切ったと報告しました。
"Sonnet 5.5 has the same problem as Opus 5.5: on "max" thinking effort it burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG."
Redditのユーザーは、Artificial Analysisから同じパターンを引き出し、"sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98"と報告しています。Sonnetはタスクあたり193kトークン、Opusは119kトークンです(u/ex-procrastinator, Reddit)。別のコメント投稿者は、チャートが示唆することをこうまとめました。
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
Anthropicも自社のローンチ記事でほぼ同じことを述べています。Sonnet 5.5は"complements Opus 5.5 best when running at lower effort settings"であり、"at higher settings, it can perform comparably at a similar cost"です。ですから実践的な結論、そして切り替えるチームに私が伝えたいことは次のとおりです。節約が実際に出るLowかMediumのエフォートでSonnet 5.5を動かしてください。APIのデフォルトはhighなので、このモデルの安く使う方法は、自分から指定するものです。サポート返信は、Mediumがうまくこなす、範囲の明確な作業そのものです。
知っておく価値のあるリグレッションが1つあります。敵対的ベンチマークを運用している開発者は、Sonnet 5.5のスコアがSonnet 5より低かったと述べ、その理由を"mainly because it is more reluctant to keep going to get an answer, instead it returns to ask the user questions"としています(dom96, Hacker News)。コーディングエージェントなら厄介ですが、サポートボットにとっては、推測せずに立ち止まって確認するのは、まさに望ましい動きであることが多いです。
速いモデルにも、周りを固めるチームメイトが必要
モデルがリリースされるたびに、技術系の顧客と同じ会話になります。安くて十分に良いのだから、生のAPIで自前のサポートボットを作ればいいのでは、という話です。もっともな疑問で、Sonnet 5.5はそのモデル側の半分をこれまでになく楽にします。
料金表が触れないのは、モデルの周りのすべてです。Sonnet 5.5は優れたエンジンですが、誰かがヘルプセンターと過去のチケットに対する検索を作り、エスカレーションのルールと拒否の処理、エフォートの調整、そして今回は5つの破壊的変更の移行作業まで整えない限り、サポートエージェントにはなりません。モデルはインフラであり、従業員はその上に築くものです。
eeselは、その部分を作り込み済みで提供します。AIヘルプデスクのチームメイトは、Zendesk、Freshdesk、Gorgiasなどの既存キューに参加します。過去のチケットとヘルプセンターから学び、フロンティアモデルを土台に、返信を下書きまたは送信します。Anthropicがこうしたモデルを出したとき、切り替えと破壊的変更に対処するのはあなたではなくeeselです。

プログラムで制御したい場合、eeselには、ダッシュボードと同じチームメイトとワークスペースを操作するCLIがあります。ターミナルから操作したりスクリプト化したりでき、Claude Codeのようなコーディングエージェントに実行させることもできるので、グラウンディングやリトライの基盤を自分で持たずに、生のモデルの上に人々が組むエージェント型のワークフローが得られます。AIエージェントCLIとMCPサーバーについての記事で、その組み合わせ方を紹介しています。
料金は月ごとの固定クレジット制です。処理したチケットまたはチャット1件が1クレジットで、無料プランにはカード不要で100クレジットが含まれ、有料プランは500クレジットで$299から始まります。チームメイトが顧客に1件も返信しないうちに、自社の過去のチケットでシミュレーションできます。Zendeskのキューでeeselをぜひ無料で試して、すでに答えを知っているチケットで、Sonnetクラスの速度向上を確かめてください。
Claude Sonnet 5.5は価値があるか
いまSonnet 5を使っているなら、はい。Anthropicがこれまでに出した中でも楽なアップグレードの1つです。同じ料金で、はるかに高いスコアを出し、より少ないトークンで終わるモデルが手に入り、しかも速く動きます。実質的なコストは移行作業だけで、それも謎ではなく、5項目の既知のリストです。
日常業務でOpus 5.5を使っているなら、その習慣を更新する前に、自社のトラフィックでMediumエフォートのSonnet 5.5を試してください。範囲の明確なタスクなら、ベンチマークの差は数ポイントで、トークン単価の差は2倍です。highエフォートを超えるとその優位は消えるので、最大限の推論が必要なタスクはOpusに回してください。Anthropic自身が依然として明確に強いとしている、自由度の高い判断にはOpusを取っておきましょう。Hacker Newsのコメント投稿者が"80% Sonnet 5.5, Opus 5.5 to finish the last 20%"というパターンを挙げており、これはキューの分け方としても理にかなっています。より広い選択肢については、Sonnet 5のレビューとOpus 5.5の代替まとめが次の読み物です。
よくある質問
Claude Sonnet 5.5とは何ですか?
Claude Sonnet 5.5の料金はいくらですか?
Claude Sonnet 5.5はSonnet 5より安いですか?
Claude Sonnet 5.5はOpus 5.5より優れていますか?
Claude Sonnet 5.5はカスタマーサポートに向いていますか?
Sonnet 5からSonnet 5.5に切り替えると何が壊れますか?
Claude CodeでClaude Sonnet 5.5を使えますか?
Claude Sonnet 5.5の最良の代替は何ですか?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.