一目でわかる私の結論
ローンチの翌日は、Anthropic の発表とモデルドキュメント、続いて移行ガイド、そして約 550 件のコメントが付いた Hacker News のローンチスレッドを読んで過ごしました。私の仕事は eesel のヘルプデスクチームメイト向けの AI エージェントを作ることなので、「明日このモデルを実際のサポートキューの下に置くか」という一点を念頭に読み込みました。
実際に導入するときに重要な項目でつけた採点の要約です。
| 確認した項目 | スコア | 理由 |
|---|---|---|
| コーディング品質 | 9/10 | Terminal-Bench 4.0 で 70.6%、Opus 5.5 を上回る |
| ナレッジワーク | 8/10 | GDPval-AA は 1844、Opus 5.5 の 1846 に 2 ポイント差 |
| トークン効率 | Low/Medium で 9/10、Max で 4/10 | Balyasny では 1 回答あたり約 121k 対 497k トークン、ただし Max では 1 タスク 193k |
| 速度 | 8/10 | Sonnet 5 より 30% 以上高速な出力 |
| 移行の手間 | 5/10 | 破壊的変更が 5 つ、うち 1 つはサポートボットにとって厄介 |
| サポートへの適合 | 8/10 | Zendesk はチケット処理が 20% 速くなったと確認 |
| 総合 | 8/10 | ラインナップで最高のコスパ。ただし避けるべき高額な設定が 1 つある |
これらのスコアの根拠を明確にするため、方法について簡単に触れます。モデルはまだ公開 1 日目なので、数か月に及ぶ本番運用の検証は行っていません。スコアは、Anthropic が公表した数値、ローンチ時の発表にある実名の顧客結果、公開されている独立したベンチマーク結果、そして API ドキュメントを eesel がチケットワークフローにモデルを組み込む方法と照らして読んだ私自身の見方から成り立っています。数値が Anthropic 由来の場合は、その旨を書きます。
Claude Sonnet 5.5 とは
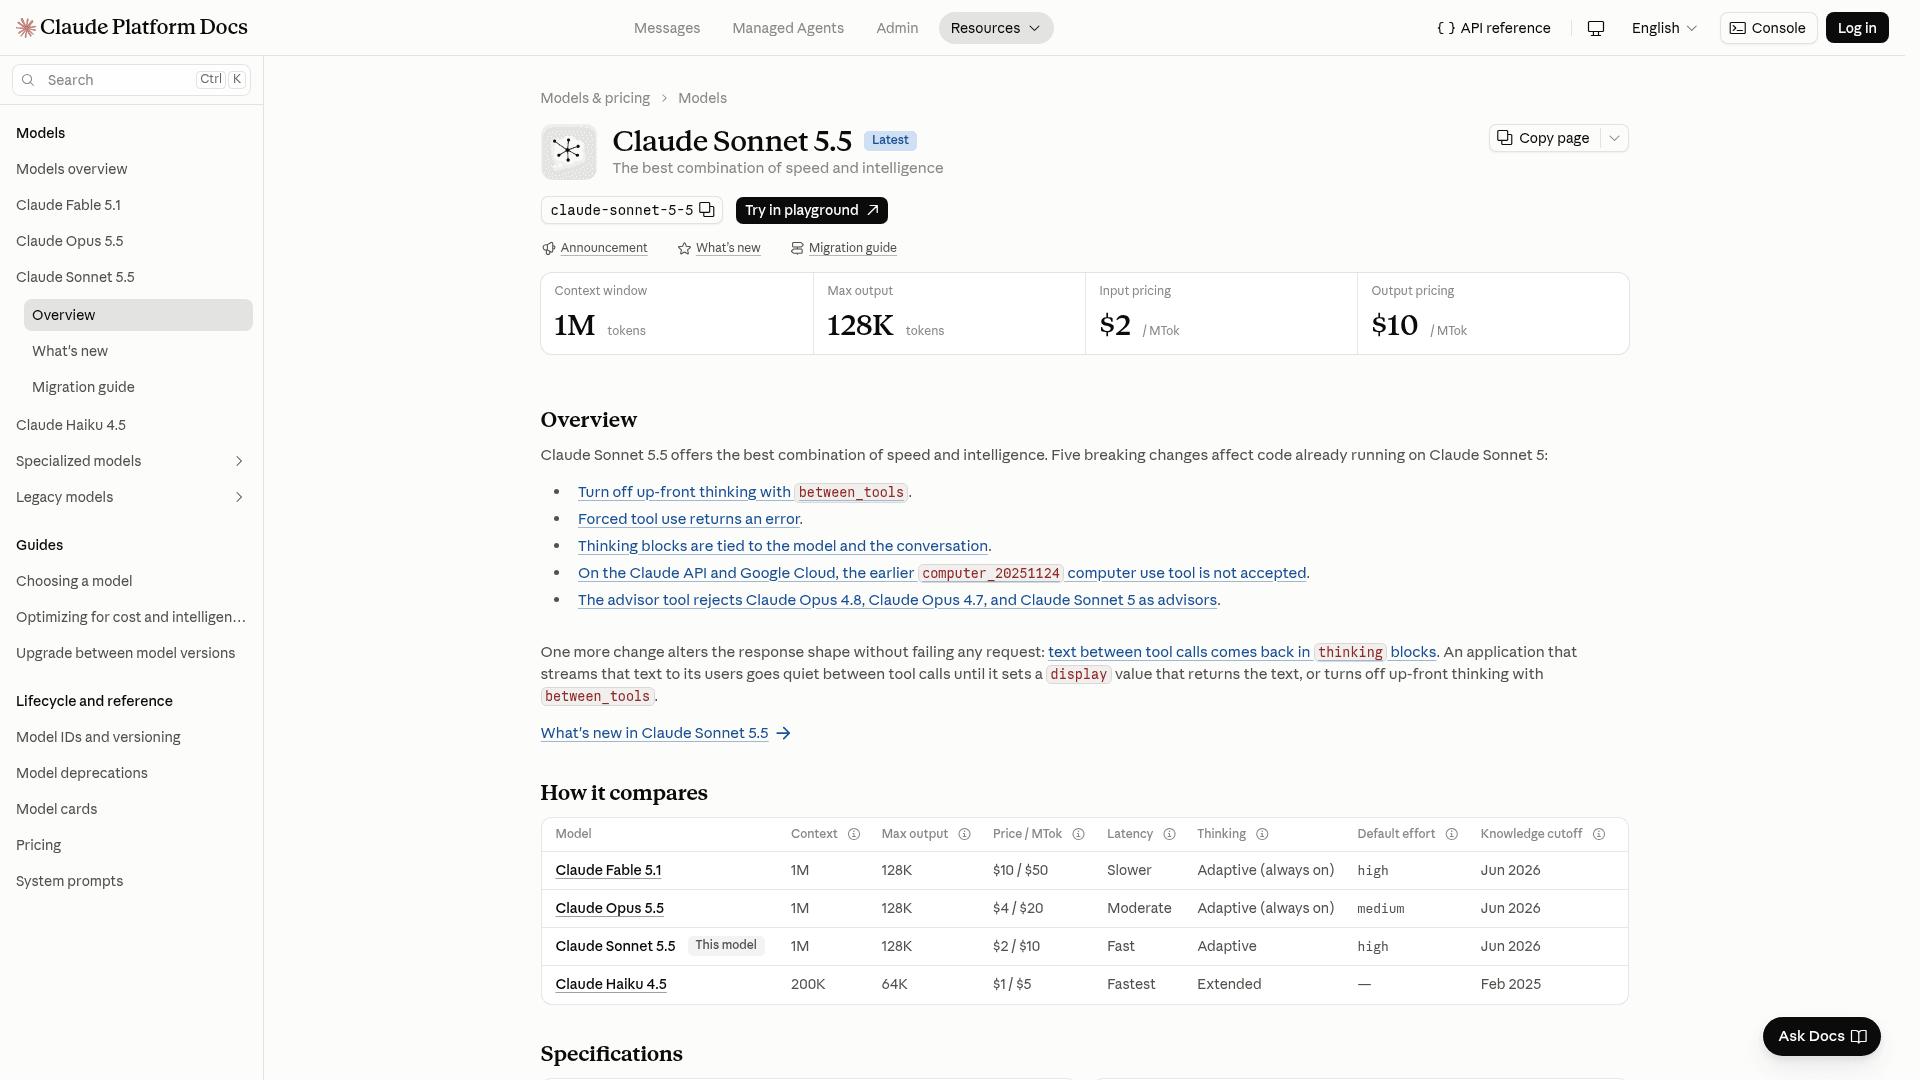
Claude Sonnet 5.5 は Anthropic の Claude 5.5 ファミリーの中位モデルで、2026 年 9 月 28 日にリリースされました。位置づけは Claude Opus 5.5 の下、Haiku 4.5 の上で、Claude Fable 5.1 がラインナップの最上位です。Anthropic は Opus の "a faster, lower-cost complement" と位置づけ、"well-scoped everyday tasks, fixing bugs, and creating polished documents, slides, and spreadsheets." に最も強いとしています。
仕様面では、モデル概要に 1M トークンのコンテキストウィンドウと 128K の最大出力(Batch では 300K)、2026 年 6 月の知識カットオフ、Claude Sonnet 5 と同じトークナイザーとあります。ローンチの詳細は同僚の Sonnet 5.5 の概要がよくまとめています。この記事は、どちらかといえば結論を扱います。
Claude Sonnet 5.5 が強い点
ローンチ時のデータで目立った点が 3 つあり、そのすべてが Anthropic 自身のグラフだけでなく、実名の顧客結果にも表れています。
Opus クラスのモデルのようにコードを書く
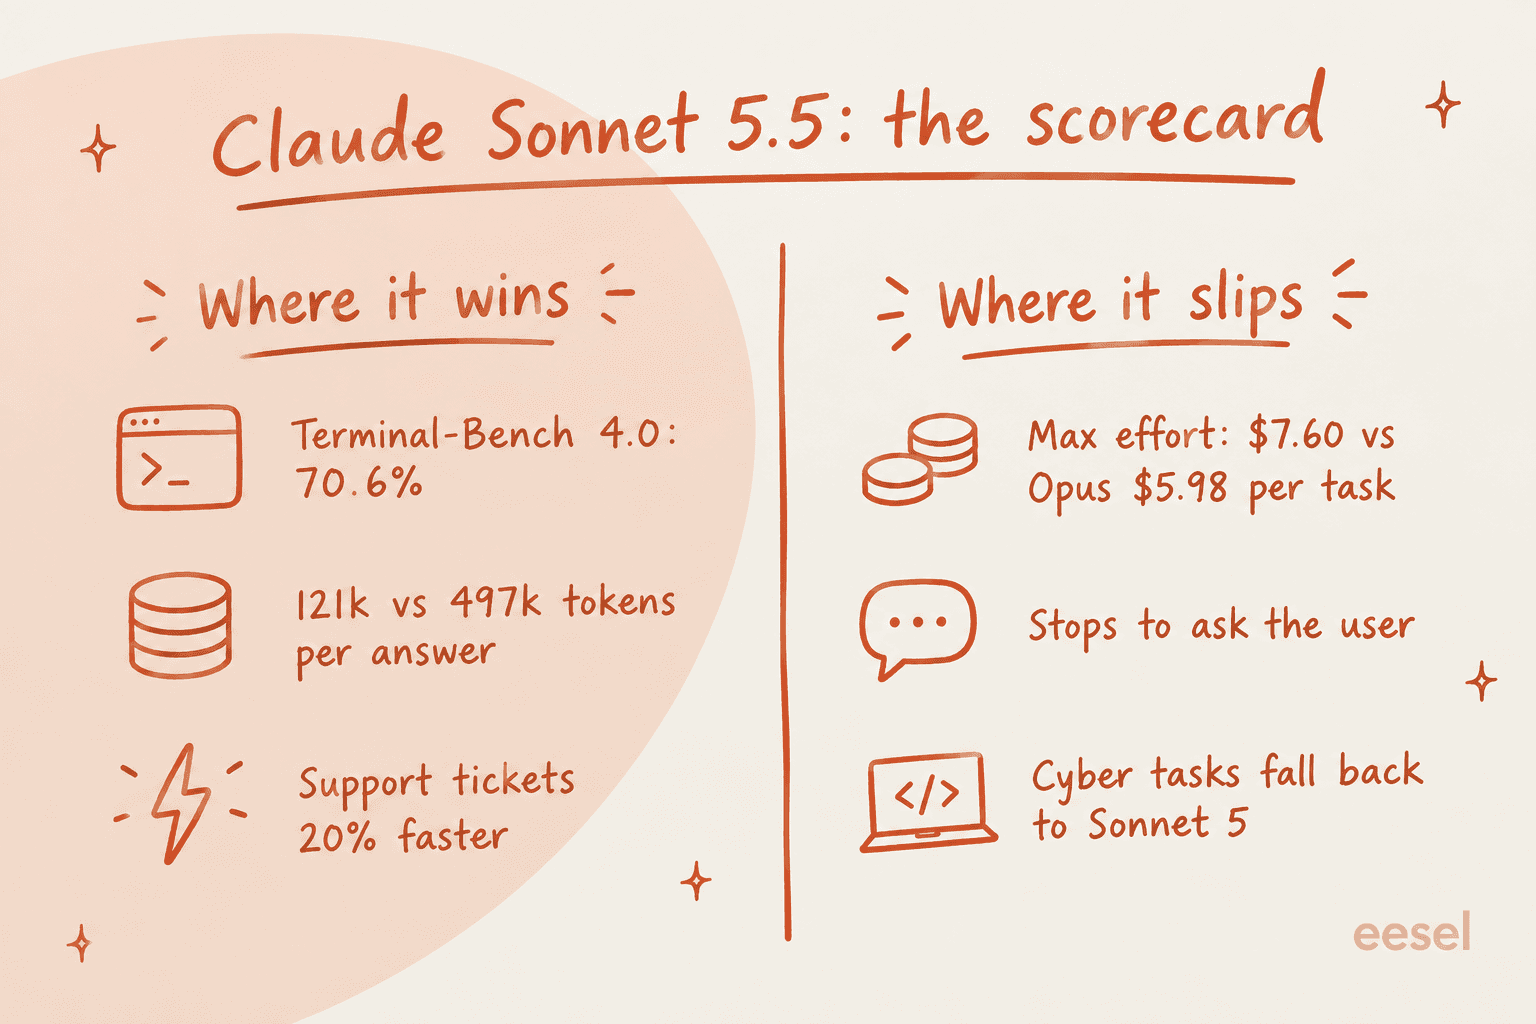
目玉はコマンドライン上で動くエージェント型コーディングテスト、Terminal-Bench 4.0 です。Sonnet 5 は 10.3% でしたが、Sonnet 5.5 は70.6% で、Opus 5.5 の 66.4% を上回ります。誤植ではありません。これまで見た Sonnet モデルの世代間の伸びとしては最大です。
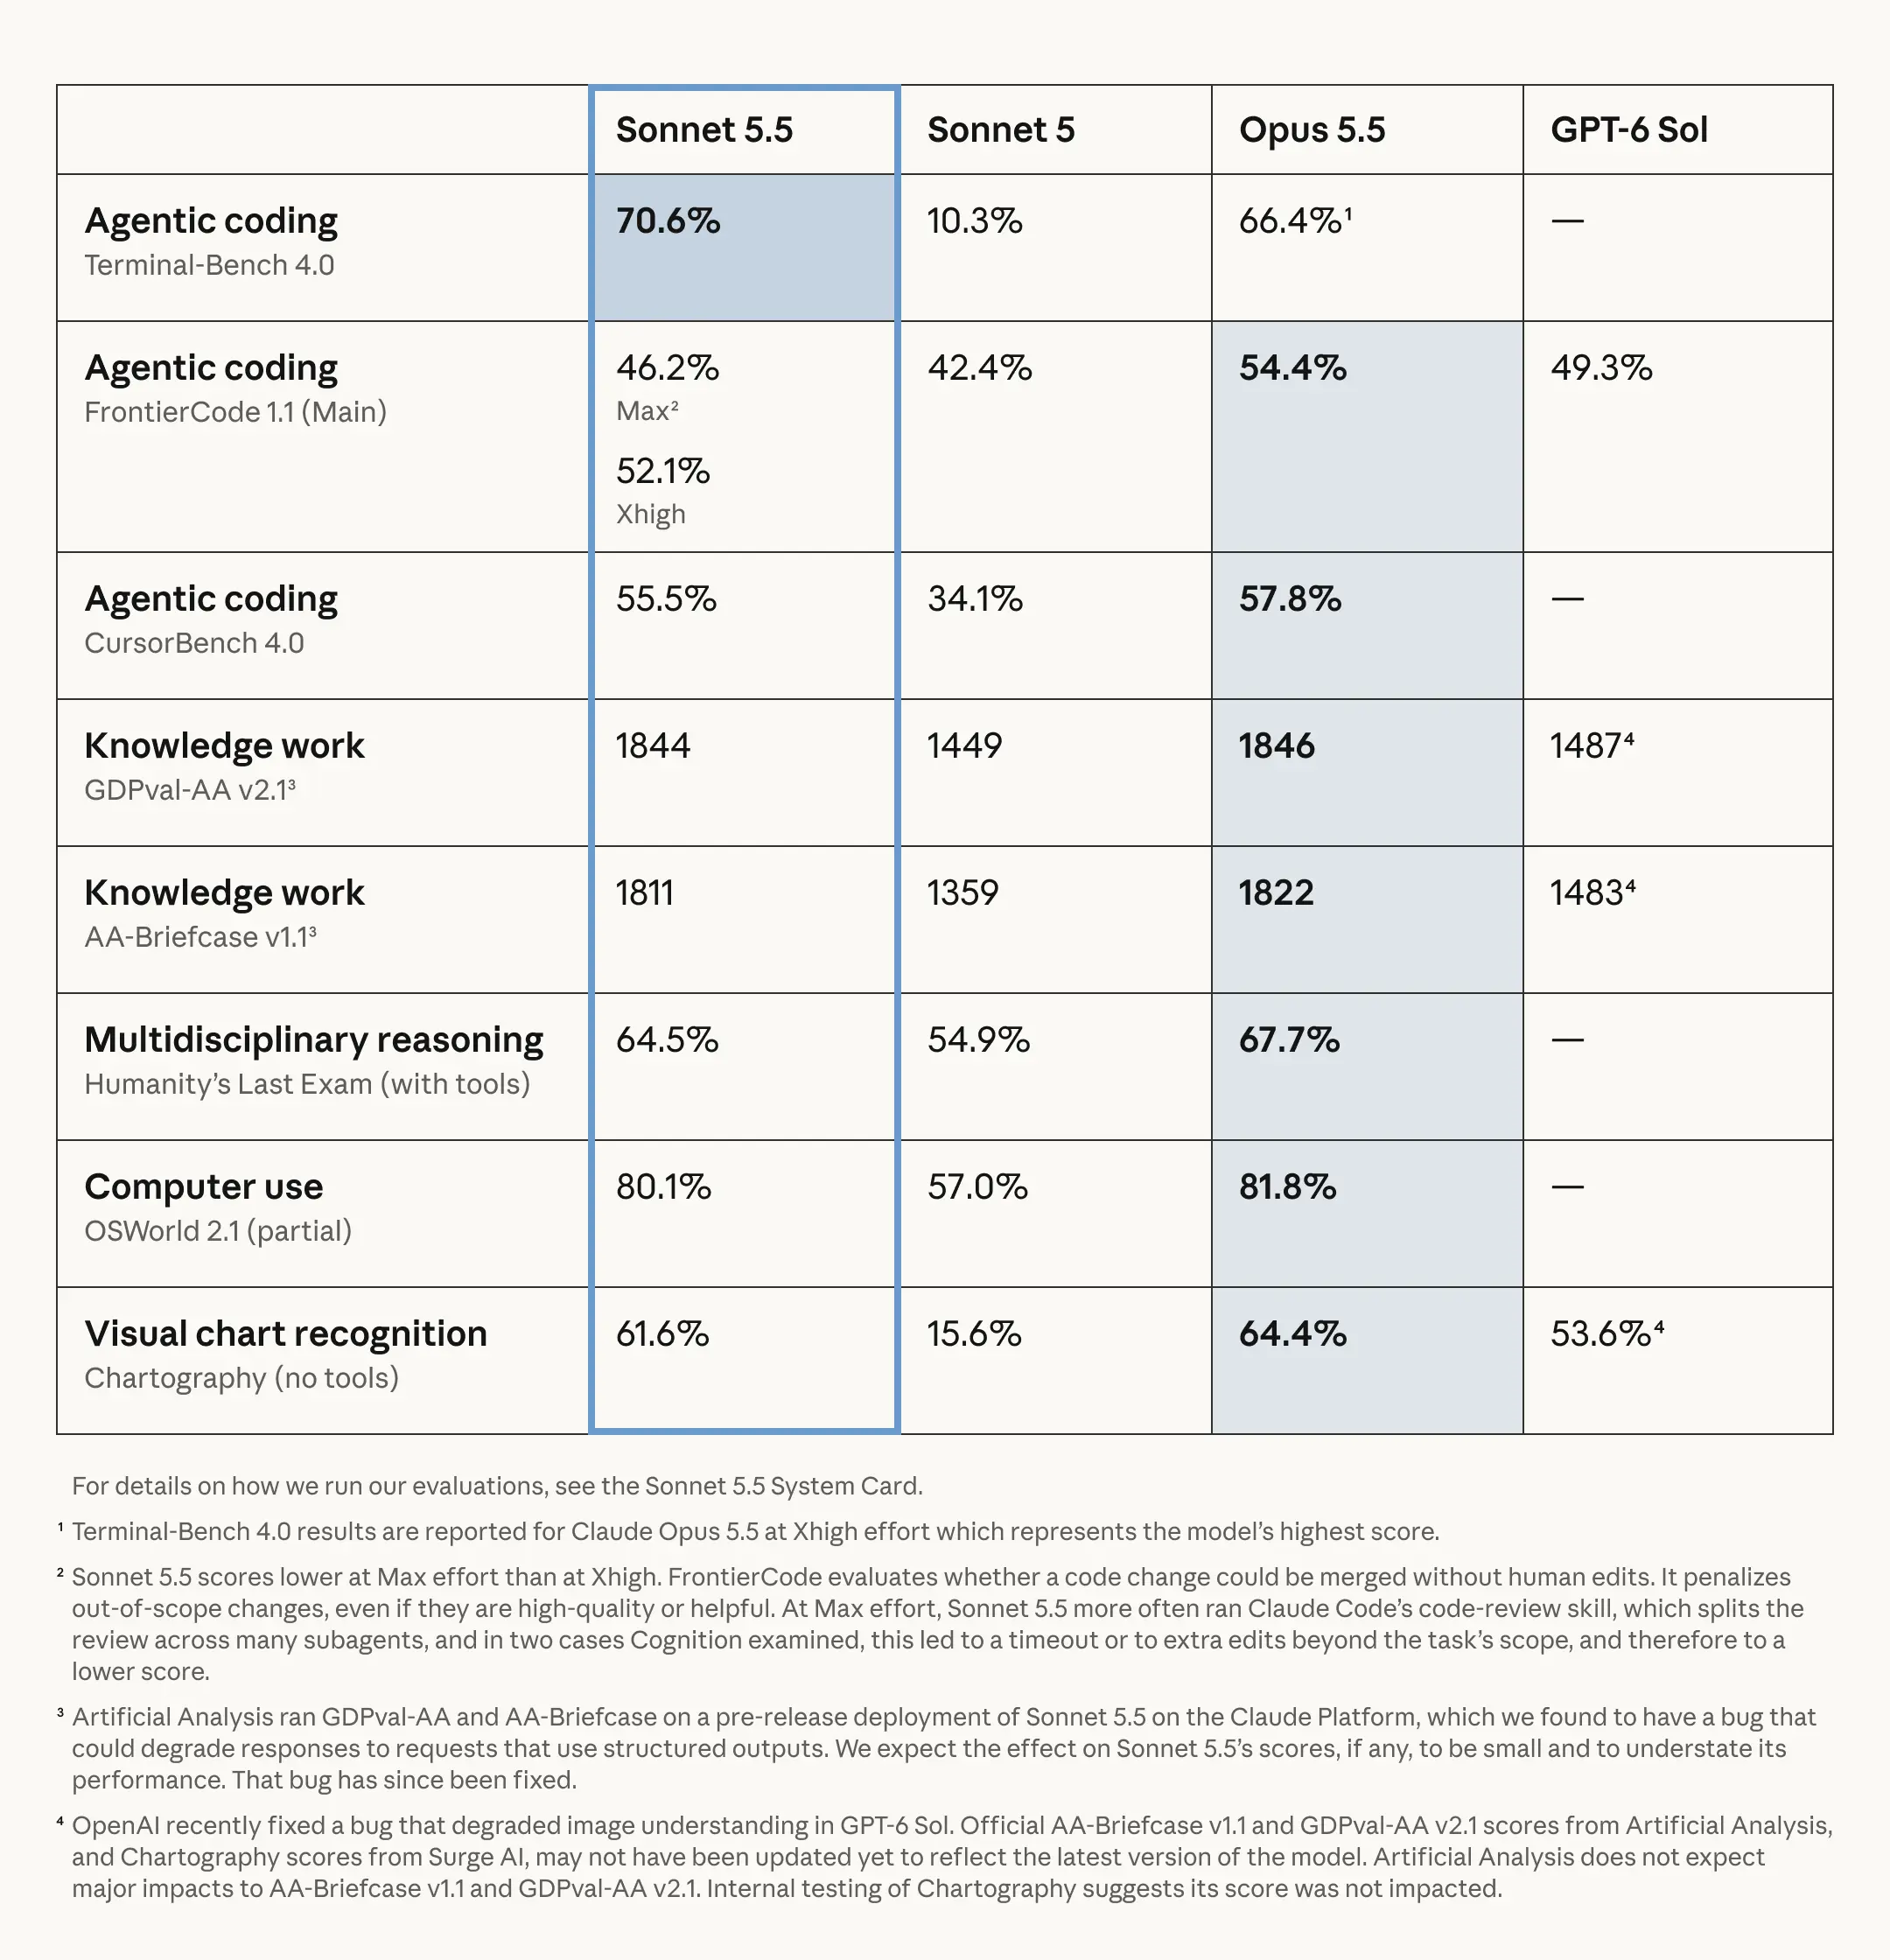
ほかのコーディングテストでは Opus にやや及びません。CursorBench 4.0 は 55.5% 対 57.8%、FrontierCode は Xhigh で 52.1% 対 54.4% です。トークン単価が半分のモデルなら、2 ポイント差は正直お買い得です。だからこそ、Opus と Sonnet の議論では、多くの人が品質の議論をやめてコストの議論に移りました。
顧客の数字もこれを裏付けています。Base44 は、118 件の実際のアプリ構築で、Sonnet 5.5 が "produced apps that scored level with Opus 5" を 1 ビルドあたり 3.6 回の反復で達成し、Opus 5 は 7.7 回だったと述べました。Unity は、複数ステップのエディタベンチマークでタスクの 90% を完了したと主張しています。そして Claude Code でコードを書くなら、Medium effort で既定として目にするのはこのモデルになります。
はるかに少ないトークンで目的に到達する
トークンあたりの価格は変わっていません。変わったのはトークンの数です。Balyasny Asset Management は 2,441 件の金融タスクを実行し、Sonnet 5.5 が1 回答あたり約 121k トークンを使い、Sonnet 5 は 497k だったと報告しました。Slack は Slackbot の評価でプロンプトを変えずに出力トークンが約 14% 減り、Lovable はツール呼び出しが 3 分の 1 減ったと報告しています。
Anthropic 自身のデモも同じことを示しています。"wind shaping sand dunes" というプロンプトで、Sonnet 5.5 がすでに動くアニメーションを出しているとき、Sonnet 5 はまだコードを書いていました。
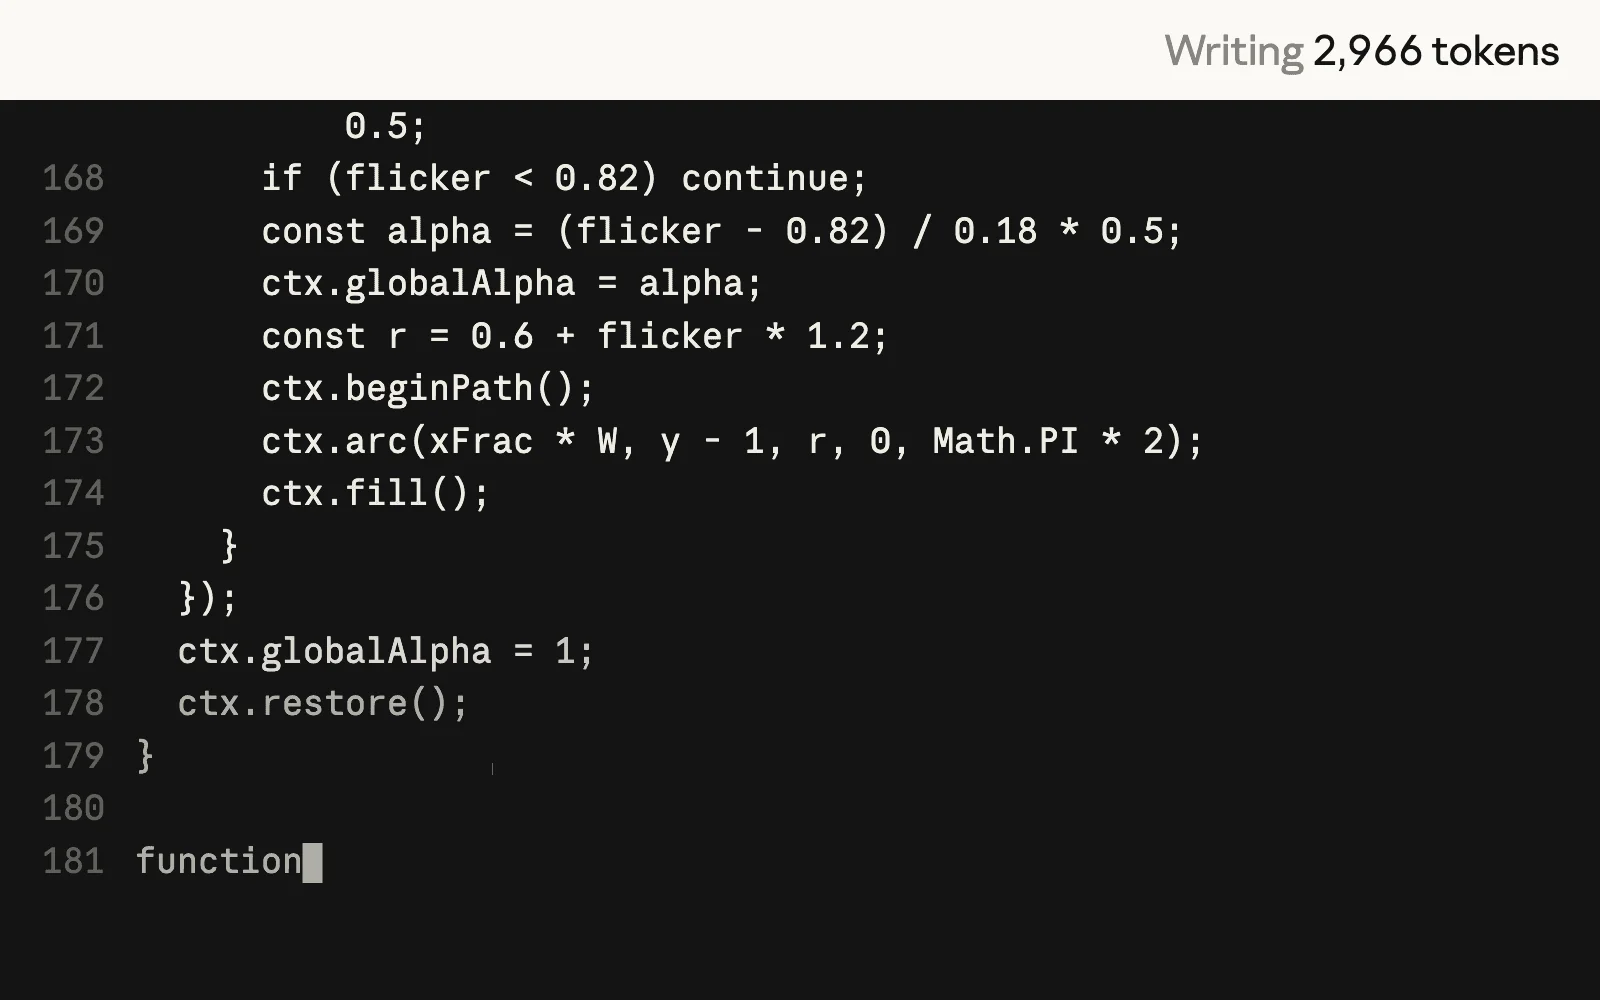
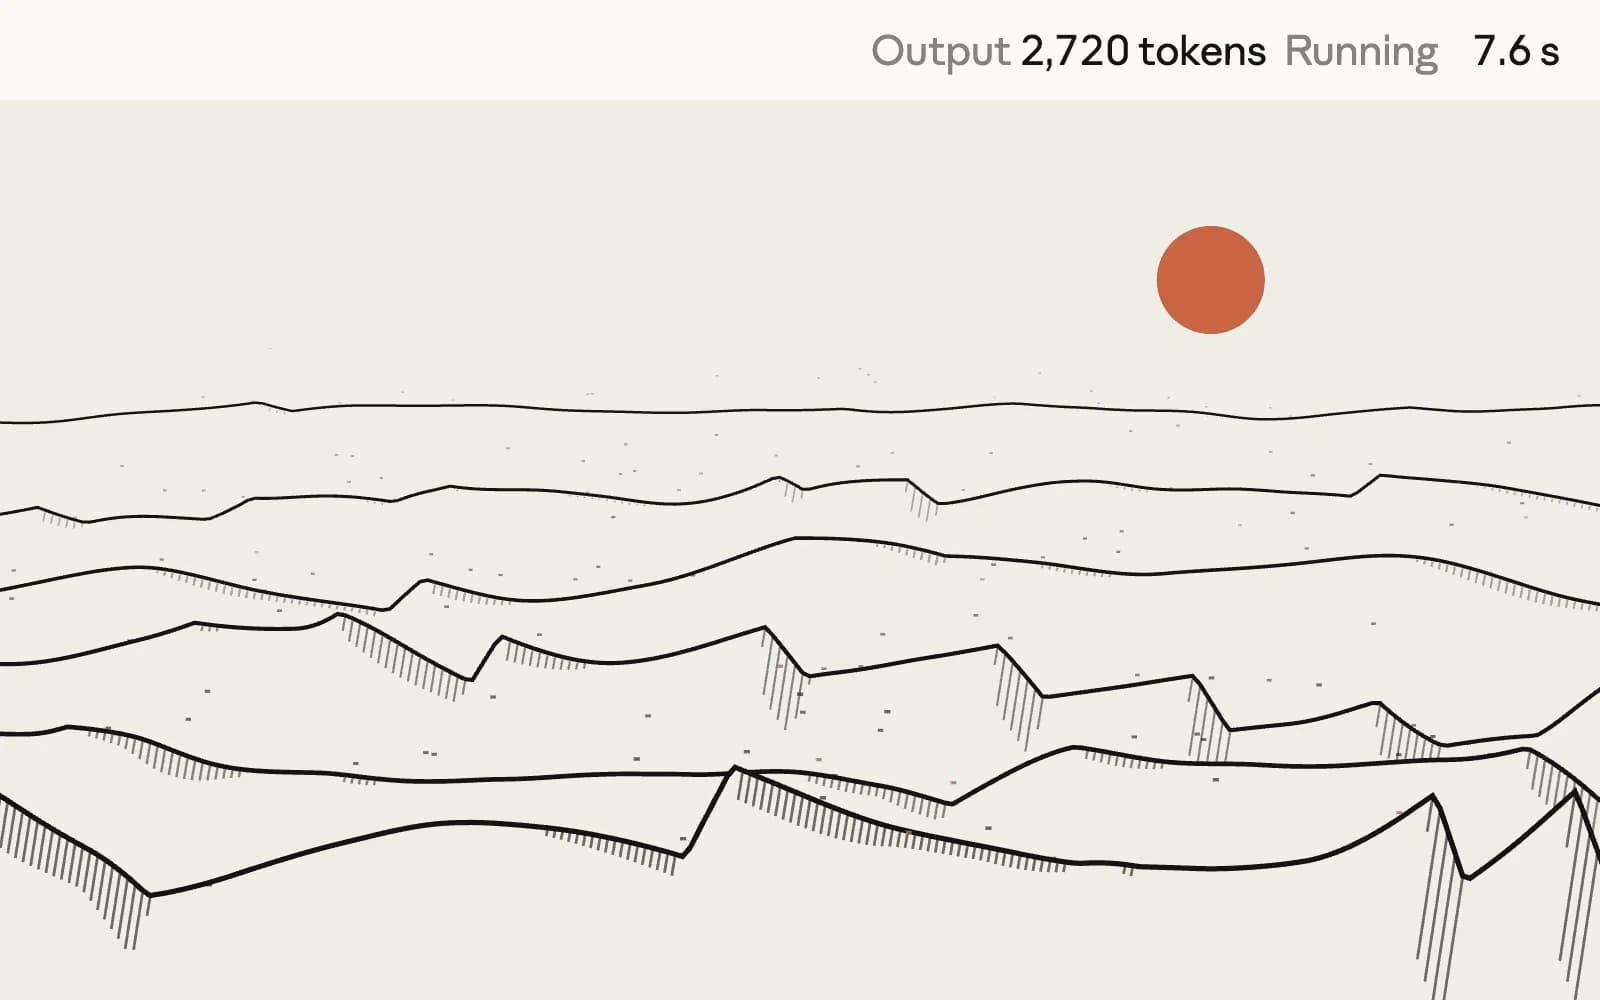
この効率こそが製品の本質です。Anthropic によれば、Sonnet 5 に比べて "up to 30% less per task" になります。私が話を聞くチームにとっては、トークンが減ればお客様が返信を待つ秒数も減り、そちらのほうが請求額より重要です。
サポートチケットをうまく処理する
私が最も重視する部分です。Zendesk の Director of AI はローンチ時の発表で、"fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions," と語り、チケットは 20% 速く処理されました。Atlassian 側では、Rovo エージェントが Sonnet 5 より最大 30% 速く動くとしています。
Zendesk AI のような業務では、この 2 つがモデルの良し悪しを決める数字です。誤ったエスカレーション判断が減ること、そして待ち時間が減ること。どちらも良い方向に動きました。
Claude Sonnet 5.5 の弱点
弱点は懐疑派が言うほど広くありませんが、そのうち 1 つはモデルの動かし方を変えます。
Max effort は Opus より高い
私の結論を変えた発見です。Anthropic 自身のローンチ発表も、Sonnet 5.5 は "complements Opus 5.5 best when running at lower effort settings" であり、"at higher settings, it can perform comparably at a similar cost." と認めています。独立した検証はそれをさらに一歩進めています。
Artificial Analysis では、ある Reddit ユーザーが指摘したとおり、Max での Sonnet 5.5 は 1 タスク $7.60、Max での Opus 5.5 は $5.98 です。Sonnet 5.5 は 1 タスクあたり 193k トークンを使い、Opus は 119k だったためです。Simon Willison はローンチ当日、同じ SVG プロンプトをすべての effort レベルで実行しました。Low は 1.6 セントで 10 秒。Max は $1.28 で 15 分 40 秒かかり、128,000 の思考トークンをすべて使い切ったうえで画像を生成できませんでした。
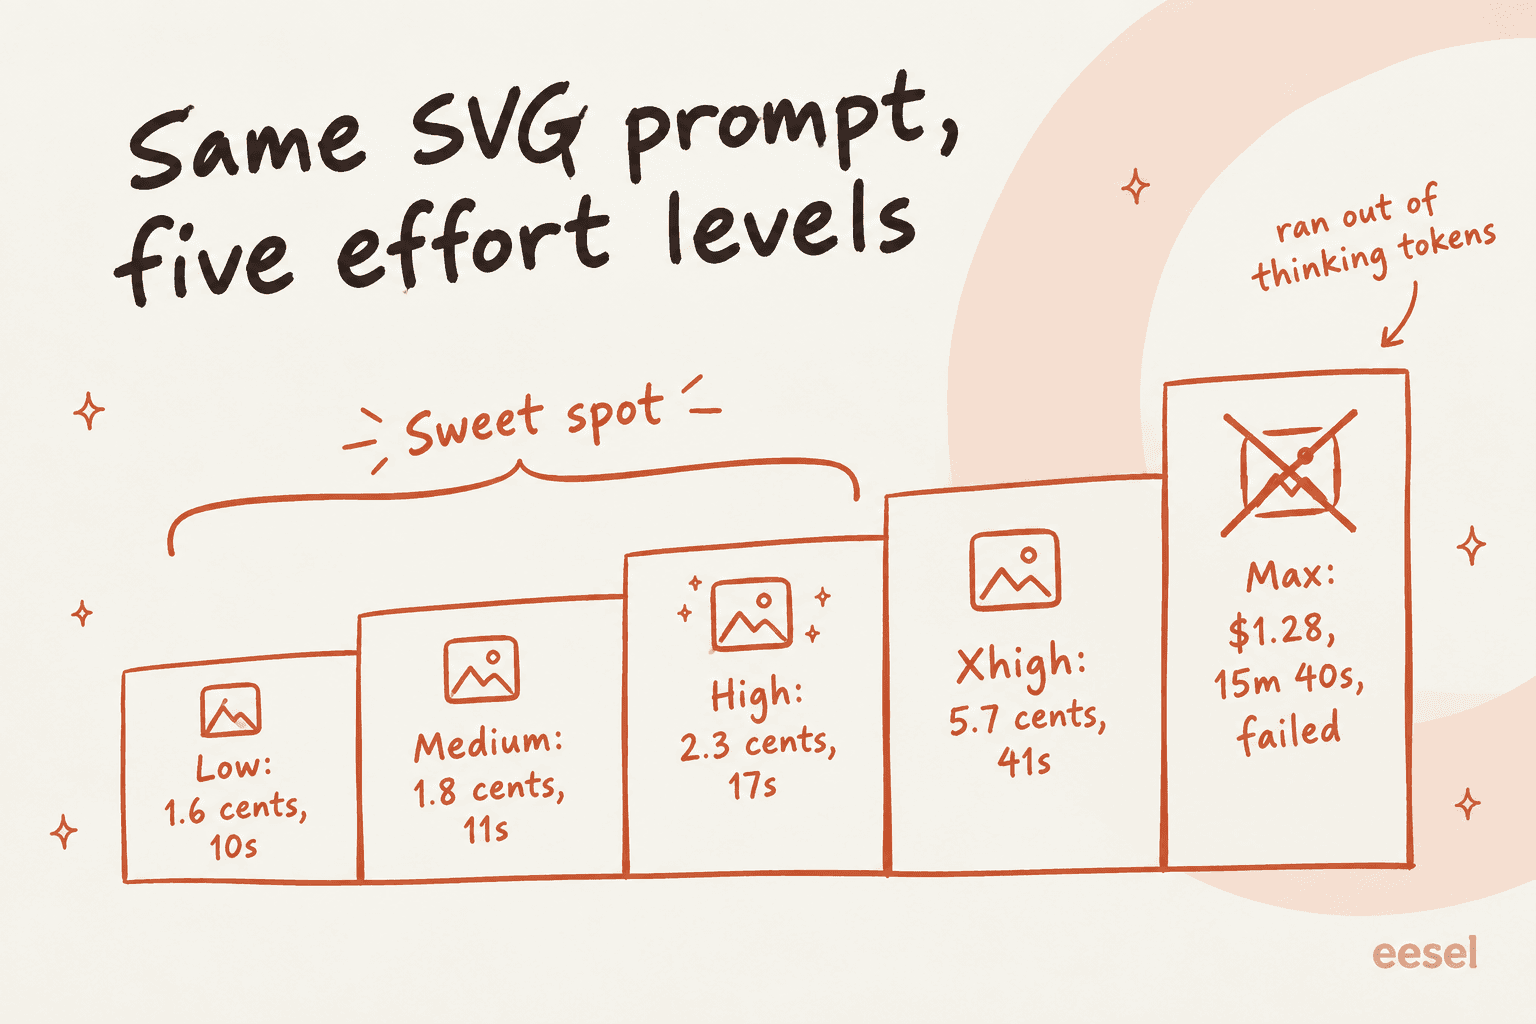
Anthropic の FrontierCode の脚注も同じ形をしています。Sonnet 5.5 は Xhigh で 52.1% ですが、Max では 46.2% にとどまります。Max では "more often ran Claude Code's code-review skill" となり、タイムアウトやタスク範囲を超えた編集につながったためです。この場合、より多く考えることが結果を悪化させました。
つまり、ルールは単純です。Sonnet 5.5 では Max を使用禁止にしてください。それほどの推論が必要なタスクは、より少ないトークンで目的に到達する Opus 5.5 向きです。
オープンエンドな判断は Opus が依然として上
Anthropic はこの点でかなり率直です。"Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment." 初期の使用報告もこれに同意しています。
"Tried Sonnet 5.5 but worse than OPUS for thinking for sure, less error/inconsistency check. I used Opus 5.5 med vs. Sonnet 5.5 High on hermes with the same agent.md, and soul.md"

サポートに置き換えるなら、請求トラブルを抱え、過去に 3 件のチケットがある怒った法人顧客です。そのチケットは、監督なしでは Sonnet 5.5 に任せません。パスワードのリセットや注文状況の確認、「データをエクスポートするには」という質問なら、一日中任せます。
質問のために止まる
エソテリックなプログラミング言語を基にした敵対的ベンチマークを動かしているある開発者がいます。そこで Sonnet 5.5 は Sonnet 5 の 17.8% に対して 7.4% で、その説明は "is more reluctant to keep going to get an answer, instead it returns to ask the user questions whether to keep going." でした。これに対して Base44 は、"rarely stopped mid-build to ask the user a question." と述べています。
私の見方では、対話的な作業なら、確認のために止まるのはむしろ望ましいことが多いです。無人のパイプラインでは事情が違い、質問して止まるモデルはジョブを一晩止めてしまう可能性があります。ヘッドレスで信頼する前に、自分のエージェントループで試してください。
サイバー保護機能と 5 つの破壊的変更
Sonnet 5.5 は Opus 5.5 と同様のサイバー保護機能つきで登場した最初の Sonnet であり、"higher-risk cybersecurity tasks will visibly fall back to Sonnet 5." となります。通常のバグ修正は影響を受けません。それでも、Hacker News で最大のサブスレッドは、認可されたセキュリティ作業をしているのにフラグを立てられた人々からのものでした。
移行ガイドには 5 つの破壊的変更が挙げられており、いずれも 400 エラーを返します。
| 変更点 | 壊れるもの | 対処 |
|---|---|---|
thinking: disabled | thinking を完全にオフにしたリクエスト | 新しい between_tools 設定を使う |
強制的な tool_choice(any または tool) | 分類ツールを強制するボット | モデルに選ばせ、その後で検証する |
| thinking ブロックより前の履歴の編集 | 過去のターンを書き換えるアプリ | 履歴を追記のみにする |
computer_20251124 | API と Google Cloud の旧コンピューター操作ツール | computer_toolset_20260801 を使う |
| 一部のアドバイザーツールの組み合わせ | Sonnet 5.5 のエグゼキューターに Sonnet 5 や Opus 4.8 のアドバイザー | Opus 5.5 または Sonnet 5.5 と組み合わせる |
サポートチームにとっての落とし穴は、強制的な tool_choice です。多くの AI ヘルプデスク連携は、チケットのトリアージのためにすべてのリクエストで「このチケットを分類する」ツールを強制します。これを直さずにモデル ID を替えると、すべてのチケットがエラーになります。もう 1 つ目立たない変更もあります。ツール呼び出しの間のテキストが thinking ブロックの中に入って届くようになったため、「ご注文を確認しています...」とストリーミングするチャットウィジェットが無言になることがあります。その沈黙がお客様にとって重要な理由は、AI エージェントのハンドオフのガイドで説明しています。
開発者たちの声
ローンチ当日の反応は賛否入り混じっていましたが、有益な形でした。ベンチマークを疑う人はいません。議論は、Opus と並べたときに Sonnet 5.5 がどこに収まるかに集まっています。
"It appears, at least from a quick look, to be noticeably faster than Opus. If true, and you don't need xhigh/max reasoning for your use case (like a well-defined set of code changes), Sonnet might get the job done much more quickly."
懐疑派は価格に注目しており、特にキャッシュ読み取りが Opus 5.5 と同じ $0.20 である点を指摘しています。
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
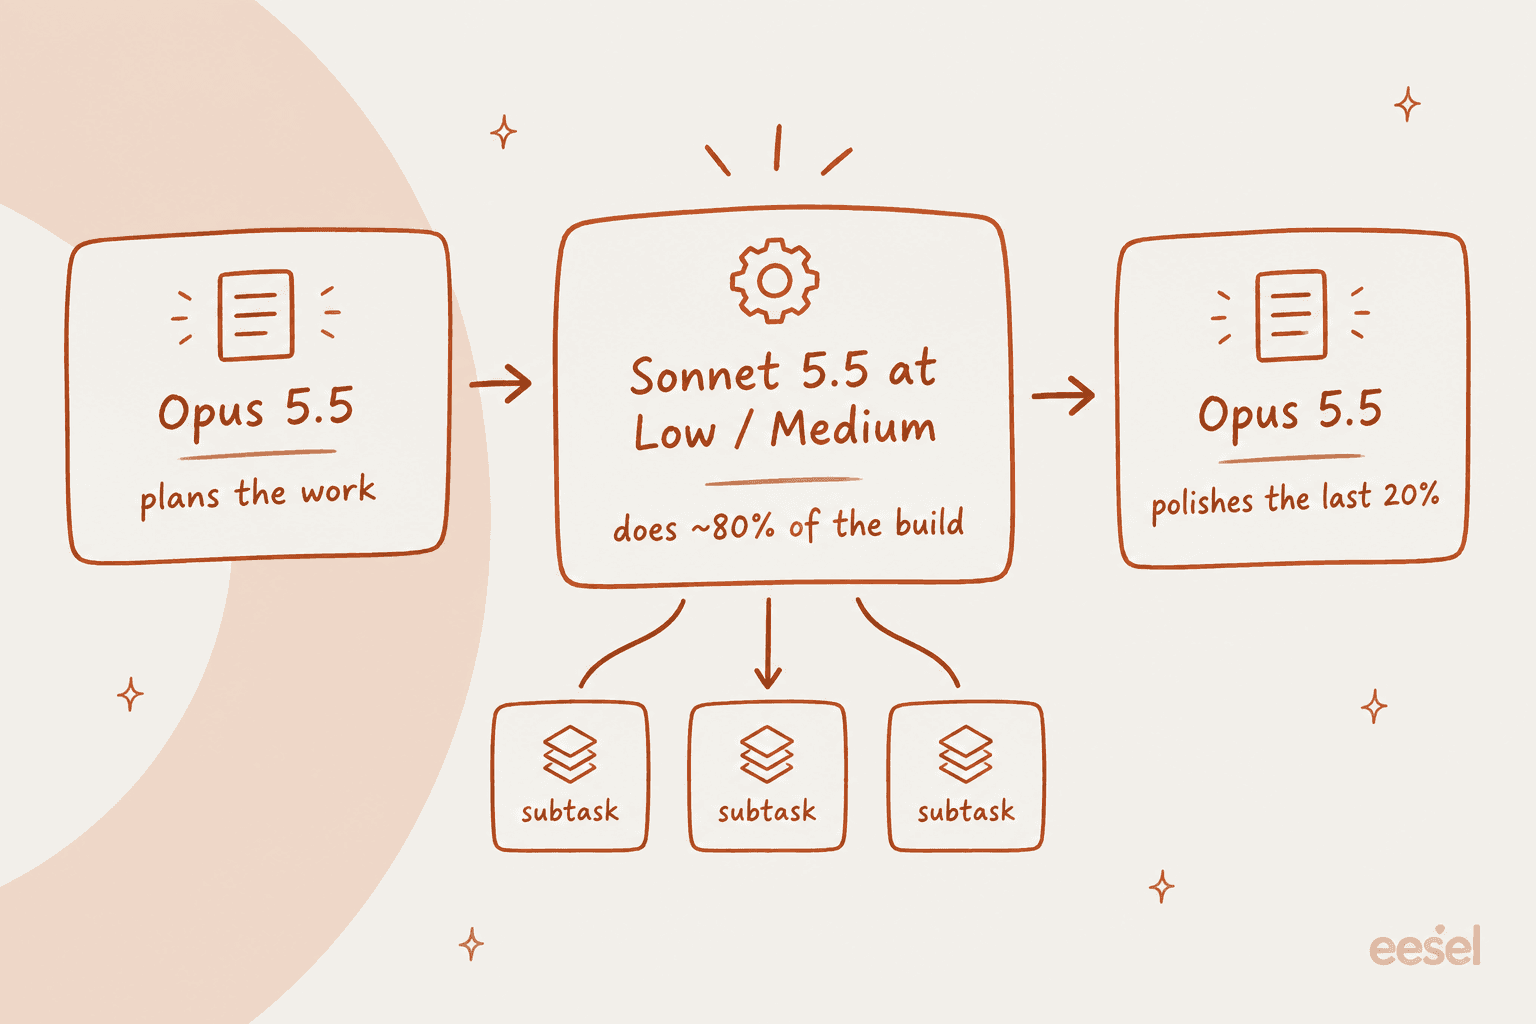
人々が繰り返し戻ってくるユースケースは、Opus のプランナーの下で動く高速な実装役としての Sonnet です。
"Firmly places itself as a solid subagent for opus, great work from anthropic, for once I'm interested in what haiku turns out as."

別のコメント投稿者は、自分の使い分けを "80% Sonnet 5.5, Opus 5.5 to finish the last 20%." と表現しました。このパターンは Claude Code のサブエージェントにきれいに当てはまり、私自身がまねたい構成です。
Claude Sonnet 5.5 の料金を 1 つの表で
100 万トークンあたりの料金は、Anthropic の料金ドキュメントによるものです。
| 100 万トークンあたりの価格 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | Haiku 4.5 |
|---|---|---|---|---|
| 入力 | $2 | $2 | $4 | $1 |
| 出力 | $10 | $10 | $20 | $5 |
| 5 分キャッシュ書き込み | $2.50 | $2.50 | $5 | $1.25 |
| キャッシュ読み取り | $0.20 | $0.20 | $0.20 | $0.10 |
| Batch 入力 / 出力 | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| コンテキストウィンドウ | 1M | 1M | 1M | 200K |
思考トークンは出力として課金され、そのために effort 設定がこれほど重要になります。Medium でのサポート返信は数百トークンしか考えないかもしれませんが、同じ返信を Max で行うと数万トークン考えることがあり、そのすべてが 100 万あたり $10 で課金されます。モデルの行が AI サポートエージェントのコストの最大の部分になることはめったにありませんが、effort ダイヤルはそれを最大にする最速の方法です。
一般向けのアクセスは簡単です。Anthropic によれば、誰でも Claude.ai で Sonnet 5.5 とチャットでき、有料プランは私の Claude Pro 料金ガイドにあります。初日から Amazon Bedrock、Google Cloud、Microsoft Foundry でも利用できます。プロバイダーを比較検討するなら、まず 3 社 API の比較から始めてください。OpenAI との直接対決は、GPT-6 Sol 対 Opus 5.5 の解説をお読みください。
切り替えるべき人、待つべき人
現在使っているものに応じた、私の判断は次のとおりです。
| 現在の利用環境 | 私の判断 | Effort 設定 |
|---|---|---|
| 本番で Sonnet 5 | 移行対応の修正後、今週中に切り替え | Medium |
| 日常のコーディングに Opus 5.5 | 定型タスクを Sonnet 5.5 のサブエージェントに移す | Low または Medium |
| オープンエンドな計画に Opus 5.5 | Opus のまま | n/a |
| ツール呼び出しを強制しているサポートボット | tool_choice を直すまで待つ | Medium |
| セキュリティやペンテストのワークフロー | 待ち、Cyber Verification Program に申請する | n/a |
| 大量のタグ付けとルーティング | Haiku 5.5 が出るまで Haiku 4.5 のまま | n/a |
Anthropic は Claude Haiku 5.5 が "in the coming weeks" にファミリーに加わると述べているので、チケットあたりのコストが最大の懸念なら、待つ価値があります。選択肢をより広く見たい場合は、私の Claude カスタマーサービス代替まとめがサポート向けの選択肢を扱っています。一般的なモデルの入れ替えについては、Sonnet の代替の一覧をご覧ください。
賢いモデルでも間違ったナレッジベースは直らない
モデルのレビューでは見せられないことが 1 つあります。私が見てきたサポートボットの失敗の大半は、モデルとは無関係だということです。月に約 200 件の Zendesk チケットを扱う B2B の車両テレマティクスチームは、ボットがデータベースにない自動車ブランドに対応していると顧客に伝えていることに気づきました。ただし、モデルが幻覚を起こしていたわけではありません。ナレッジベースが「すべてのモデル」に対応していると書いていて、ボットはそれをそのまま信じただけです。Sonnet 5 から Sonnet 5.5 に替えても、同じ誤った答えが 30% 速く返ってくるだけでした。
だからこそ、サポート向けのモデルをベンチマークだけで評価することはありません。eesel では、チームメイトが顧客と話す前に、すべての導入を過去のチケットに対してシミュレートします。より良いモデルでも直せないナレッジの問題を見つけられるのは、そこだからです。
Claude クラスのモデルで eesel をキューに試す
移行を自分で抱え込まずに、チケット対応で Sonnet 5.5 の速度を得たいなら、eesel が近道です。AI ヘルプデスクチームメイトは、Zendesk など、すでにお使いのヘルプデスクに参加し、過去のチケットとヘルプセンターから学習して、内部で最先端モデルを使って返信を下書きまたは送信します。このレビューで挙げた effort の調整と破壊的変更への対応は、すべてあなたではなく eesel の仕事になります。

ターミナルでの作業がお好きなら、eesel CLI はダッシュボードと同じチームメイトとワークスペースを操作します。スクリプト化することも、Claude Code のようなコーディングエージェントに操作させることもでき、それは先ほどの「Opus が計画し、Sonnet が構築する」パターンを、そのままサポート環境に当てはめたものです。AI エージェント CLI の記事でさらに詳しく、MCP サーバーの記事でコネクター側を扱っています。
無料プランには 100 クレジットが付き、カードは不要です。有料プランは 500 クレジットで $299 から始まります。実際のチケットの一部で eesel を試し、速いモデルが本当に速い回答として表れるかどうかを確かめてください。
Claude Sonnet 5.5 は価値があるか
はい、ただし 1 つのルールつきです。Low または Medium の effort なら、Claude Sonnet 5.5 は Opus に迫るコーディングとナレッジワークを半額のトークン単価で提供し、30% 以上高速で、トークンもはるかに少なくて済みます。範囲の明確な作業やサブエージェント、そして日常的なサポート返信の新しい既定になります。
Max では Opus より高くつき、それでも失敗することがあるので、そこでは使わないでください。難しくオープンエンドな判断には Opus 5.5 を残し、移行前に強制ツール呼び出しを直してください。そのあとは、請求額を決めるのをモデル名ではなく effort ダイヤルに任せましょう。
よくある質問
Claude Sonnet 5.5 は優れていますか?
Claude Sonnet 5.5 は Sonnet 5 より優れていますか?
Opus 5.5 より Claude Sonnet 5.5 を選ぶ価値はありますか?
Claude Sonnet 5.5 の料金はいくらですか?
Claude Sonnet 5.5 ではどの effort レベルを使うべきですか?
Claude Sonnet 5.5 はカスタマーサポートに向いていますか?
Claude Sonnet 5.5 の欠点は何ですか?
Claude Sonnet 5.5 の代替は何ですか?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.