

私の評価を一目で
私は毎日 eesel のサポートキューを担当しているので、モデルが出るたびに「お客様の待ち時間が減るか、より良い回答になるか」という一つの問いで読みます。Haiku 5.5 は、チケットのかなりの部分ではっきり「はい」と言える初めての小型 Claude です。全体の評価表は以下のとおりです。
| 確認した項目 | 評価 | 裏付けの数字 |
|---|---|---|
| 100k トークン未満の価格 | 非常に良い | 入力 $0.10 / 出力 $0.50、Haiku 4.5 より 90% 安い |
| 100k トークン超の価格 | 平凡 | $0.50 / $2.50、ここでは Luna のほうが安い |
| 知能 | クラス最高 | AA で 43、GPT-6 Luna は 38 |
| 速度 | 非常に良い | AA でエフォート別に 137-243 トークン/秒 |
| エージェント型コーディング | 弱い | Terminal-Bench 4.0 で 39.2%、Sonnet 5.5 は 70.6% |
| トークン効率 | 高エフォートでは悪い | Max で AA タスクあたり約 162k 出力トークン、Luna の約 3 倍 |
| ハルシネーション | ライバルより良いが現実的な問題 | AA-Omniscience で 40%、Luna は 77% |
| 移行の手間 | 中程度 | temperature や prefill を含む 6 件の破壊的変更 |
Claude Haiku 5.5 とは
Claude Haiku 5.5 は Anthropic の小型で高速なモデルで、2026 年 10 月 7 日にモデル ID claude-haiku-5-5 でリリースされました。Anthropic は、要約、コンパクション、分類、データベースクエリなどの「high-volume, cost-sensitive tasks」向けとして、またコーディング作業で Opus 5.5 や Sonnet 5.5 のサブエージェントとして位置づけています。
スペックは Haiku 4.5 から大きく進歩しました。コンテキストウィンドウは 200k から 1M トークンへ、最大出力は 64k から 128k へ、知識のカットオフは 2026 年 6 月になりました。調整可能なエフォートとアダプティブ thinking を備えた初めての Haiku でもあり、その thinking はデフォルトで Medium でオンになっています。
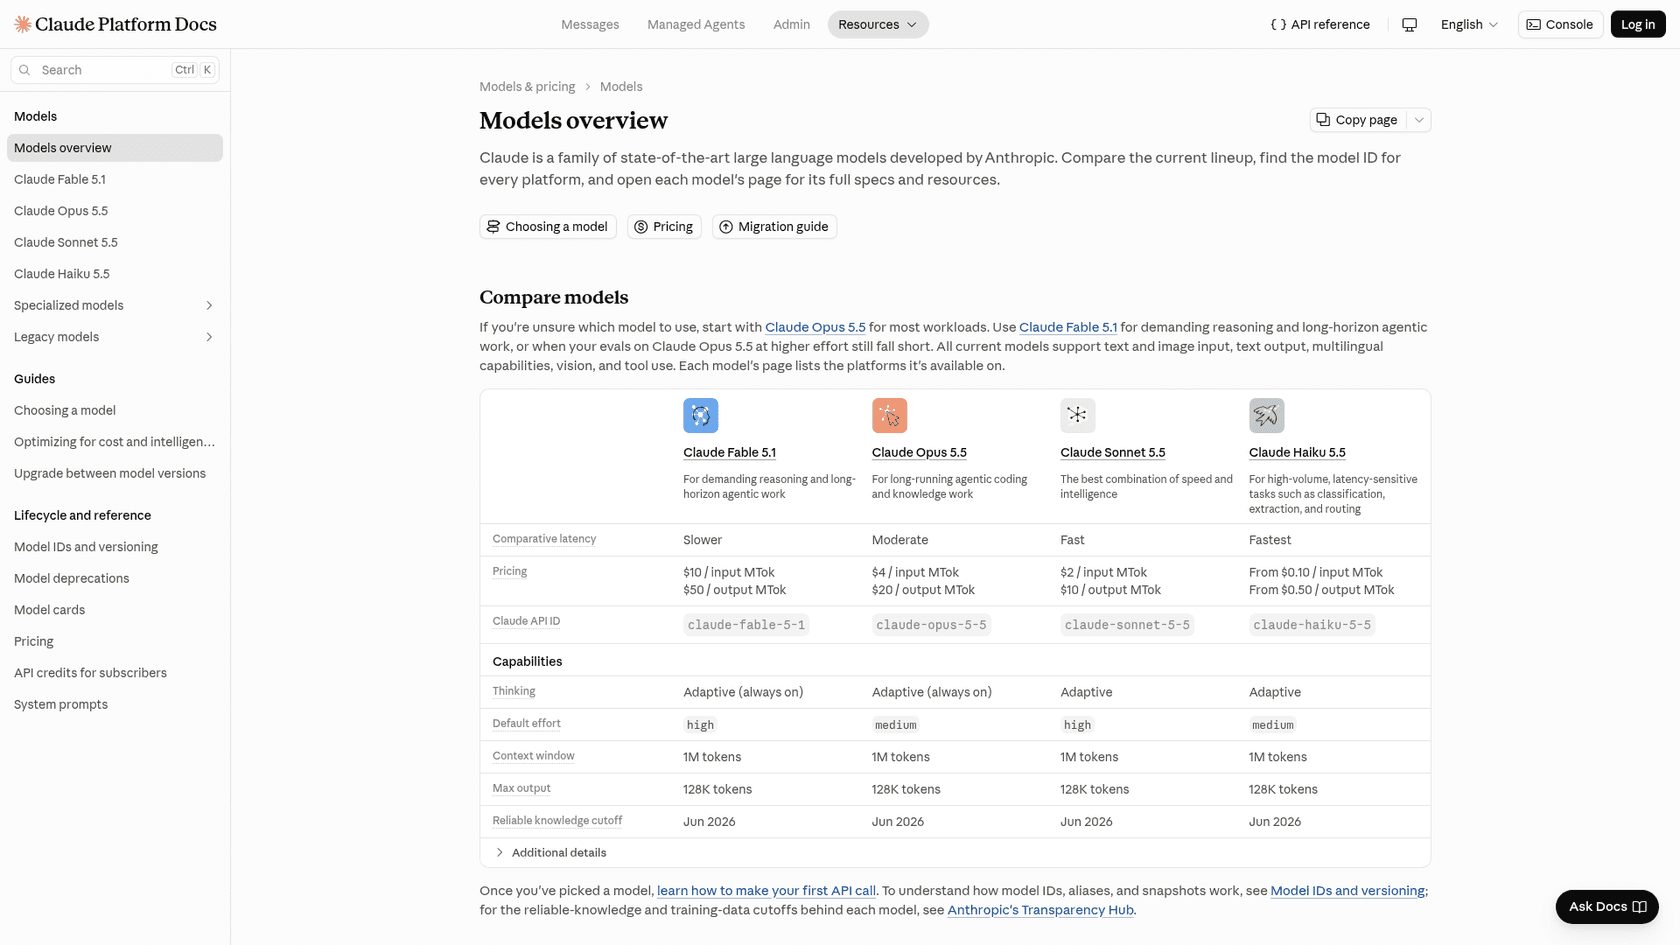
モデル概要では、このモデルを「for high-volume, latency-sensitive tasks such as classification, extraction, and routing.」向けと説明しています。この一文は、得意なところと苦手なところをうまく言い表していると思います。
Claude Haiku 5.5 の強み
良い点はたくさんあり、Haiku 4.5 からの進歩は小さくありません。それではどこでその価値を発揮するのか見ていきましょう。
ほとんどの作業で Sonnet 5.5 に近い
Anthropic 自身のローンチ時ベンチマークでは、Haiku 5.5 は GDPval-AA で 1620(Sonnet 5.5 は 1840)、OSWorld 2.1 で 72.4%(Sonnet 5.5 は 83.9%)に達しています。入力価格が Sonnet の 20 分の 1 のモデルとしては、驚くべき結果です。
| ベンチマーク | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1(ナレッジワーク) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1(コンピューター操作) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam、ツールなし | 45.9% | 10.2% | n/a | 56.9% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 | 46.4% | n/a | 42.4% | 52.1%(Xhigh) |
| Chartography、ツールなし | 46.4% | 6.4% | 29.1% | 61.6% |
Haiku の各スコアを Sonnet のスコアで割ると傾向がはっきりします。下のグラフがそれを示しています。
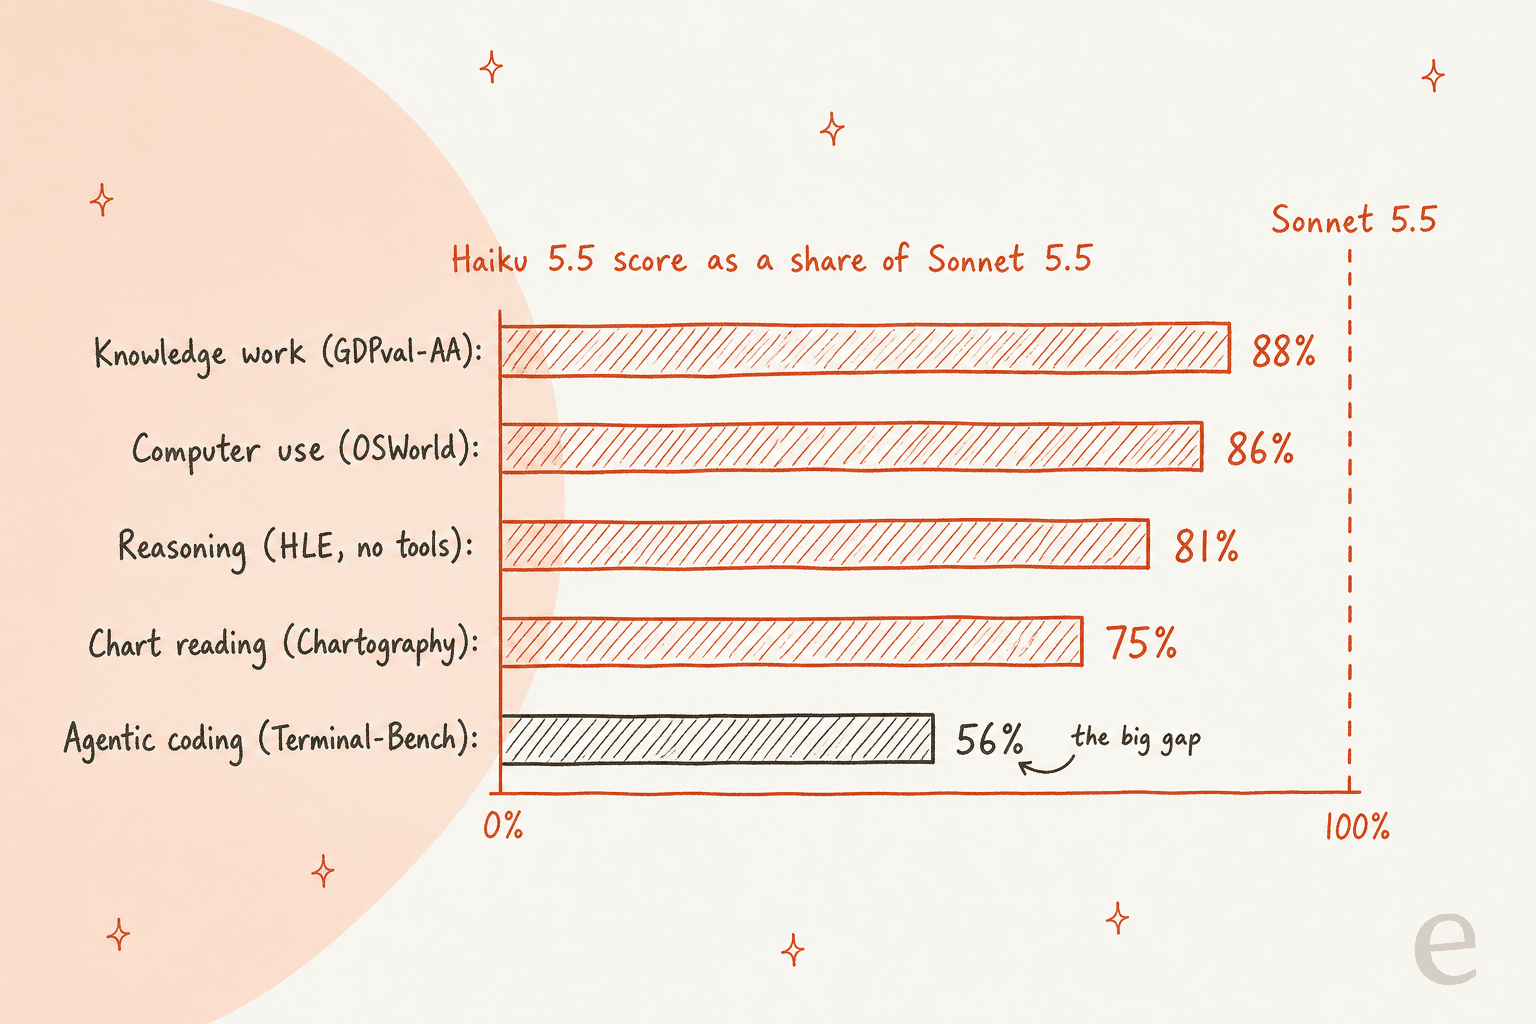
ナレッジワークとコンピューター操作では、Haiku 5.5 は Sonnet 5.5 の 86-88% に達します。エージェント型コーディングでは 56% です。この差が、どの仕事を任せるべきかをはっきり教えてくれます。
知能とハルシネーションで GPT-6 Luna に勝つ
Artificial Analysis は、Max エフォートの Intelligence Index で Haiku 5.5 を 43 とし、GLM-5.3 Flash(42)、Gemini 3.8 Flash(41)、GPT-6 Luna(38)を上回っています。また、Haiku は「わからない」と言うことに前向きで、AA-Omniscience のハルシネーション率は 40%、Luna は 77% でした。
"Haiku 5.5 is noticeably smarter than GPT-6 Luna, so I can see their pricing strategy here. For a while Anthropic has lacked a cost effective "cheap" LLM for summarisation, compacting, RAG helpers, etc."

速い
Anthropic は標準速度で「our fastest model to date」と呼んでいます。Artificial Analysis はエフォートによって毎秒 137 から 243 出力トークンを測定し、Max の Luna は 128、Haiku 4.5 は 90 でした。顧客の報告も一致しています。Asana は AI Teammates の評価で「over a 30% reduction in latency for task completions」を確認し、Box は Haiku 4.5 より 11 ポイント高く「at about half the latency」と測定しました。
サポートにおいて速度は見栄えだけの指標ではありません。私が話したある購入者は、AI チャットの 67 項目の丁寧な評価を行い、回答は堅実だと判断しましたが、チャットウィジェットが本人の言葉で「slow and often gets stuck」だったため結局離脱しました。遅れて届く優れた回答は、壊れた製品のように感じられるだけです。
短くて根拠のある作業に強い
ローンチ時の顧客コメントで一番良いものは、どれも狭く繰り返される仕事に関するものです。HubSpot は CRM 評価スイートで 92.8% を報告し、「the best score we've seen on this suite yet」とし、古いレコードの監査では誤検出率が最も低くなりました。AlphaSense は週 800 万回の文書 Q&A で、0.76 から 0.84 へと統計的に有意な向上を確認しました。
コミュニティも、検索負荷の高い作業で同じ傾向を見ています。
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
これはほとんどのサポートチケットの形です。ヘルプ記事を数本とチケットを読んで、質問に答える。だからこそ、Haiku 5.5 はコーディングよりも AI チケット分類やチケット要約で重要になると私は考えています。
相棒モデルとして機能する
Anthropic 自身の売り込みは、より大きなモデルのサブエージェントとしての Haiku で、初期の報告もそれを裏付けています。Rogo は Haiku 5.5 のサブエージェントで 10-K から売上行を抜き出し、その間に大きなモデルがスライドを組み立てます。Cognition は、Opus 5.5 をリード、Haiku 5.5 を相棒とする Devin Fusion 構成が「holds a top-tier FrontierCode score of 66.2 while cutting cost and latency」と述べています。
Hacker News のあるテスターは、複雑な UI 構築を自分から Opus に委任するのを見て、「at least knows what it isn't good at」と述べていました。すでに Claude Code サブエージェントを使っているなら、Claude Code での Haiku の構成が最初に試す場所として最適です。
Claude Haiku 5.5 の弱点
これらはどれも単独では致命的ではありませんが、合わせると Haiku 5.5 でお金を節約できるのか、それとも知らないうちに予定より高くつくのかが決まります。
100k トークンの価格の崖
これが最大のポイントです。Haiku 5.5 は、コンテキストウィンドウ全体で価格が一定でない唯一の現行 Claude モデルです。料金ドキュメントによると、100,000 トークンを超えるプロンプトは、入力、出力、キャッシュのすべての項目で高い料金を払います。
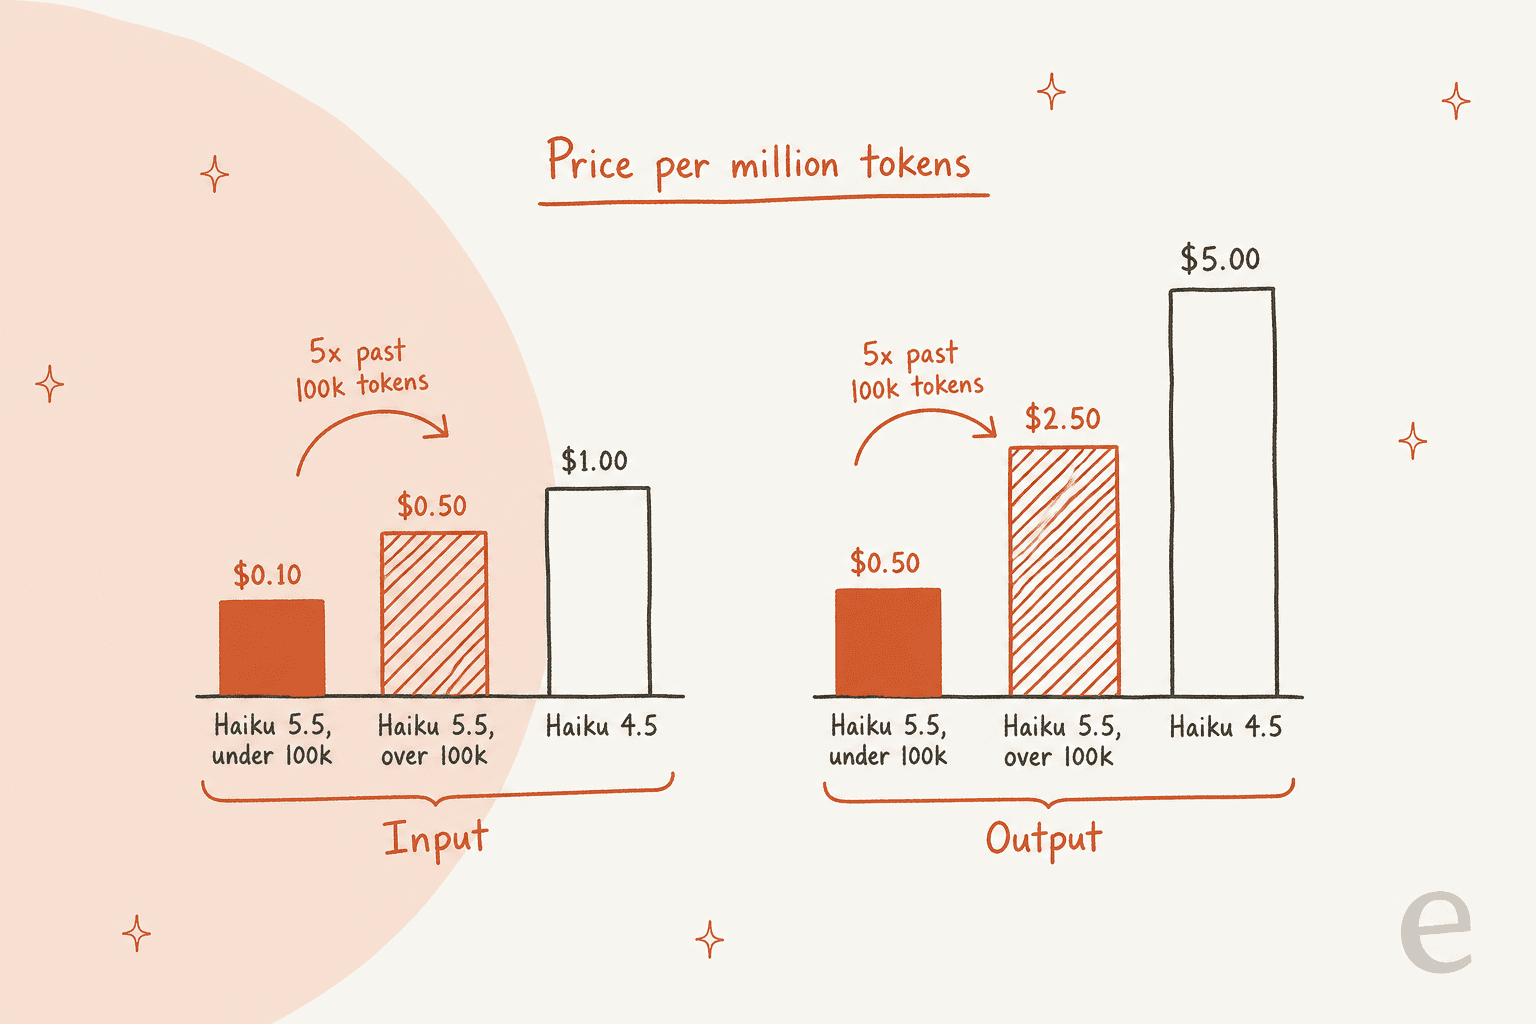
Anthropic によると、100k 未満のプロンプトは前の Haiku へのリクエストの約 90% を占めるので、従来の Haiku 向けの仕事のほとんどは安い層に収まります。ただしエージェントループは別の話で、会話履歴がすぐに積み上がります。
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value"
Simon Willison のローンチ記事はこのトレードオフをうまく整理しています。100k 未満なら Haiku は Luna と同価格でスコアが高いが、「Above 100,000 tokens, Luna looks like a much better deal.」。Luna 自身の価格の段差は 272k トークンで来て、$0.20/$0.75 にしか上がりません。
新しいトークナイザーは静かにトークンを増やす
移行ガイドによると、同じテキストが「approximately 30% more tokens than on Haiku 4.5」になります。Simon Willison は長いプロンプトで約 1.25 倍を測定し、これを「a hidden price increase」と呼びました。つまり、生の文字数から想像するより早く 100k のラインに到達することにもなります。
あるテスターが、分類ジョブで実際の数字を示しています。
| モデル | 入力トークン | 出力トークン | バッチコスト | 同期コスト |
|---|---|---|---|---|
| Haiku 5.5 | 11,893,643 | 240,451 | $0.21 | $0.42 |
| GPT-6 Luna | 7,903,468 | 177,602 | $0.16 | $0.31 |
これらの数字は Hacker News の Farmadupe によるものです。トークン単価は同じですが、同じジョブで Luna は約 26% 安く済みました。同じ内容を読み書きするのに必要なトークンが少なかったからです。
Max エフォートはトークンの溶鉱炉
エフォート設定は Haiku では新しく、上限は高くつきます。Artificial Analysis によると、Max の Haiku 5.5 は Intelligence Index のタスクあたり約 162k 出力トークンを使い、Max の Luna の約 3 倍です。Max での最初のトークンまでの時間は 415 秒でした。
| エフォート | AA Intelligence Index | 指数の実行コスト | 出力トークン | 最初のトークンまでの時間 |
|---|---|---|---|---|
| Low | 29.4 | $34.31 | 32M | 13.6s |
| Medium(デフォルト) | 34.5 | $56.36 | 54M | 14.2s |
| High | 37.8 | $94.07 | 97M | 26.2s |
| Xhigh | 41.2 | $157.58 | 180M | 86.8s |
| Max | 43.4 | $330.25 | 440M | 415.3s |
Medium から Max にすると、9 ポイントの上昇に対してコストは約 6 倍近くになります。Artificial Analysis は、これらのコストには 100k の価格段差がまだ含まれていないとも指摘しており、長いタスクは表より高くなります。Simon Willison のペリカンのテストも小規模に同じことを示しており、Low は 7 秒で 0.0936 セント、Max は 5 分 9 秒かかりました。
ライブチャットでは、このベンチマークでの Medium の最初のトークンまでの時間(約 14 秒)を自分のチケットでテストする価値があります。回答が始まる前にアダプティブ thinking が走るからです。ドキュメントによると、低めのエフォートなら簡単なリクエストで thinking を省略でき、High 以下では thinking を完全にオフにすることもできます。
読む資料がないと事実を間違える
Anthropic のシステムカードはこの点で率直です。クローズドブックの AA-Omniscience テストで、Haiku 5.5 は 44% が正解、32% が誤答、24% は回答を控えました。正味では Haiku 4.5 より良いものの、調べられない質問で約 3 回に 1 回間違うというのは、サポート用モデルの前にナレッジベースが必要な理由そのものです。
システムカードは、自動化された挙動監査で他のどのモデルよりも過剰に拒否したことも指摘しており、Artificial Analysis は AutomationBench のスコア 35% について、Anthropic が修正中のリリース前の過剰拒否の問題があるため「likely understated」だと述べています。
自社の評価では違う結果になるかもしれない
初日のテストがすべてうまくいったわけではなく、本番の切り替えスイッチを入れる前に聞いておく価値があると思います。
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
別のコメント投稿者は、自分の評価と人間によるペアワイズテストでも Haiku 4.5 が 1 位だったため、その結果を受けてプロンプトを作り直していると返信しました。Haiku 4.5 はまだアクティブと表示されており、廃止は 2026 年 10 月 15 日以降なので、両方を並べて動かす期間があります。
移行で壊れるもの
新機能ページには、いくつかの破壊的変更が載っています。サポートボットや分類器に影響するのは次のものです。
| 変更点 | 現在の挙動 | 対処法 |
|---|---|---|
| 手動の thinking 予算 | budget_tokens は 400 を返す | アダプティブ thinking と effort を使う |
| サンプリングパラメーター | top_k、または 1 以外の temperature は 400 を返す | 削除し、プロンプトで制御する |
| アシスタント prefill | thinking オフでも 400 を返す | messages をユーザーターンで終える |
| 追記のみの履歴 | system、ツール、過去のターンを編集してから thinking を再生すると 400 を返す | 履歴を追記のみにする |
| コンピューター操作ツール | computer_20250124 は API と Google Cloud で拒否される | computer_toolset_20260801 に移行する |
| トークナイザー | 同じテキストで約 30% 多いトークン | max_tokens と予算を再計算する |
サポートにとって temperature の変更が一番やっかいです。多くのチケットトリアージパイプラインは、ラベルを一貫させるため temperature 0 で動いていて、そのリクエストは今や完全に失敗します。prefill ももう一つの一般的な手法(JSON の開き波括弧を強制するためによく使われる)で、これもなくなりました。
強制 tool_choice は引き続き動作し、Sonnet 5.5 がそれを廃止した後では朗報です。ただし移行ガイドによると、強制ツール呼び出しは thinking ブロックなしで返ってきます。返金やルーティングのツールを呼ぶ前にモデルに考えてほしいなら、auto を使い、プロンプトでそう指示してください。
Claude Haiku 5.5 の料金を 1 つの表で
Claude 料金ドキュメントの完全な料金表です。参考として Haiku 4.5 と Sonnet 5.5 も載せています。価格はすべて 100 万トークンあたりです。
| 項目 | Haiku 5.5、100k まで | Haiku 5.5、100k 超 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| 入力 | $0.10 | $0.50 | $1.00 | $2.00 |
| 出力 | $0.50 | $2.50 | $5.00 | $10.00 |
| 5 分キャッシュ書き込み | $0.125 | $0.625 | $1.25 | $2.50 |
| 1 時間キャッシュ書き込み | $0.20 | $1.00 | $2.00 | $4.00 |
| キャッシュ読み取り | $0.01 | $0.05 | $0.10 | $0.10 |
| バッチ入力 / 出力 | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 | $1.00 / $5.00 |
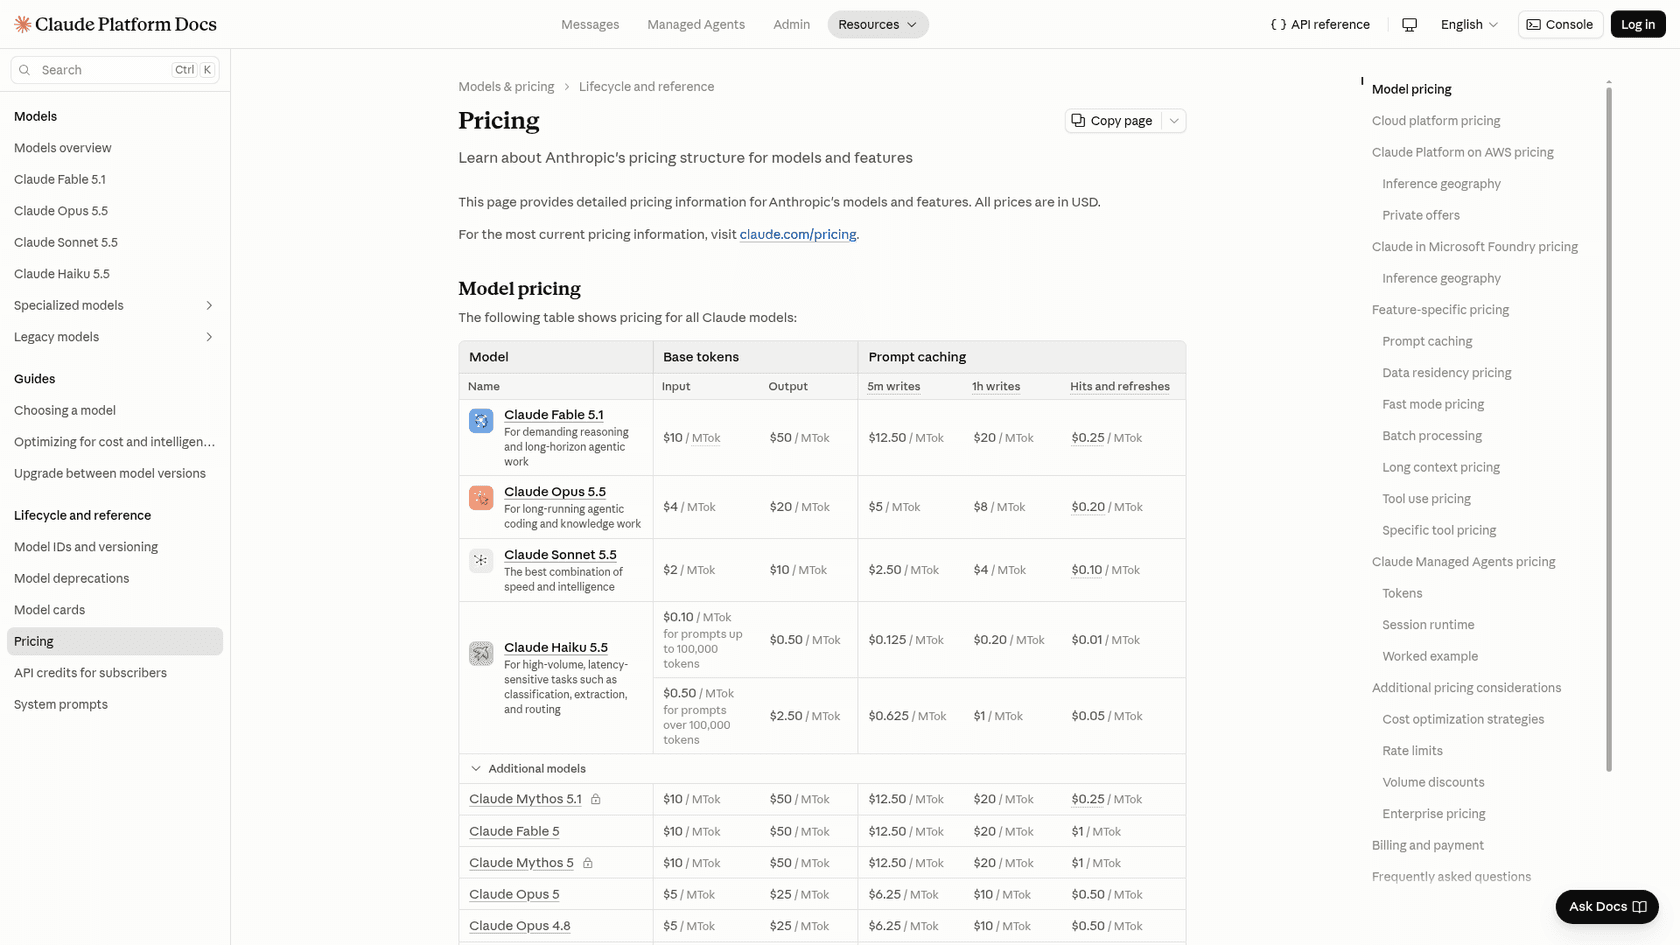
具体的に考えてみましょう。8,000 トークンのプロンプト(指示、いくつかのヘルプ記事、チケット)と、thinking を含めて 600 出力トークンのサポート返信です。Haiku 5.5 なら 1 チケットあたり約 $0.0011、10,000 チケットで約 $11 です。同じ会話が 150,000 トークンのプロンプトに育つと、入力だけで $0.075 かかり、ラインの下の場合の 5 倍になります。Haiku 5.5 には Fast モードがなく、Anthropic は同じ日に Sonnet 5.5 のキャッシュ読み取りも半額の $0.10 にしたため、キャッシュを多用するエージェントでは差が縮まります。そちらについてはSonnet 5.5 の料金ガイドで扱っています。
サポートキューでの私の使い方
サポートで Haiku 5.5 をどう動かすかは、上の強みと崖からほぼ直接導かれます。速くて短くて大量の仕事をすべてのチケットで任せ、難しいものは上に回します。
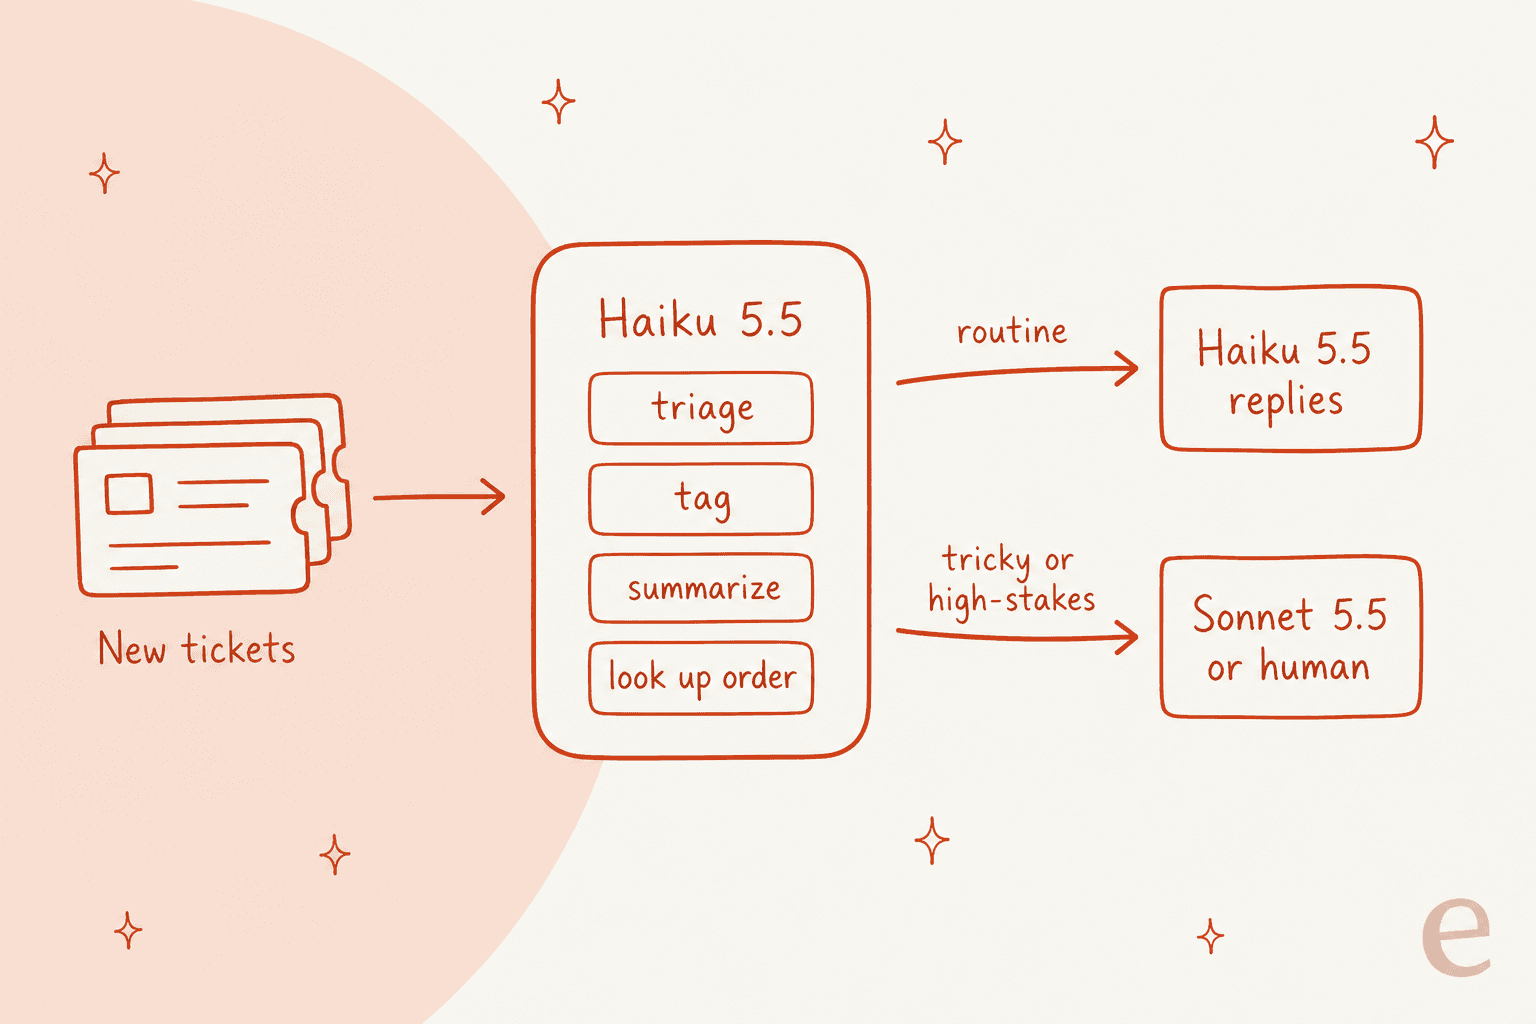
実際には次のようになります。
- Low エフォートでのトリアージとタグ付け。 短いプロンプト、固定のラベル一覧、長い履歴なし。100k 層はこの仕事のために作られており、チケットの優先順位付けにも向いています。
- Medium での要約と引き継ぎメモ。 誰もコストに気づかずに、すべてのチケットで動かせる速さです。
- ヘルプセンターに基づく定型返信。 注文状況、パスワードリセット、返品期間など。取得するコンテキストを絞って、プロンプトを 100k 未満に保ちます。
- 残りはエスカレーション。 返金の争い、複数ステップのトラブルシューティング、長いスレッドのものは Sonnet 5.5 か人に回します。
これは、実際のトライアルがうまくいくときの姿でもあります。実際の Zendesk トラフィックを使った EC のトライアルでは、トリアージが AI の最も強い仕事で、精度 93%、スパム検出 100% でしたが、完全な下書きにはチーム自身の過去の返信からの助けがより必要でした。小さくて速いモデルは、その最初の仕事によく合うと思います。
開発者の声
Hacker News のローンチスレッドは 770 ポイント超、380 コメント超となり、反応は一本の線で分かれました。短くて範囲の明確な仕事を持つ人は気に入り、長いエージェントセッションを回す人は 100k の崖の計算をしました。
"Ran our DataAnalyticsBench benchmark on it: 9x cheaper than Haiku 4.5 and 2 letter grades better. It's also now the fastest model (using the default speeds, not trying any of the other models "Fast" mode) to complete the exam."
同じテスターは、分かりやすい分析の質問にはすべて対応したが、より深い統計的な掘り下げが必要なものでは力不足で、GPT-6 Luna のほうが約 30% のコストで少し良かったと付け加えています。
"With that said, the real reason to use Haiku is that it's faster than all of these models. OpenRouter is showing an average so far of 93 tokens/sec, and AA got at least 137 in each of their benchmarks. So it might be valuable for speed at lower thinking levels."
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
Artificial Analysis のチームは「notably fast, however very verbose」とまとめており、ここまでの内容と一致します。
乗り換えるべき人、待つべき人
ベンチマークのグラフではなく、仕事の内容で判断するなら、私はこう決めます。
| 運用内容 | 私の判断 | 理由 |
|---|---|---|
| 分類、タグ付け、ルーティング | 短い評価の後に乗り換え | 最安の層、最速のモデル、小さなプロンプト |
| ヘルプセンター上の RAG 回答 | 乗り換え、プロンプトは 100k 未満に | 根拠ある結果が強い、必要なら 1M ウィンドウ |
| Sonnet や Opus がリードするサブエージェント | 乗り換え | Anthropic と初期顧客が示すユースケース |
| 100k トークンを超える長いエージェントループ | 待つか Luna を選ぶ | 5 倍の価格段差と重いトークナイザー |
| 複雑なエージェント型コーディング | Sonnet 5.5 のまま | Terminal-Bench 4.0 で 39.2% 対 70.6% |
| temperature 0 や prefill に頼るパイプライン | 移行の時間を確保 | どちらも 400 エラーを返す |
外部の選択肢と比べるなら、GPT-6 Luna の代替、Gemini 3.8 Flash、Kimi K3 の記事で、小型から中型モデルの残りの分野を扱っています。
サポートに絞るなら、サポートに合う LLMのガイドがさらに広く扱っています。
速いモデルでも間違った回答は直らない
モデルのレビューでは見えないことがあります。私が見るサポートボットの失敗のほとんどは、モデルとは関係がないということです。BtoB の車両テレマティクスのチームは、ボットがデータベースにない車のブランドに対応していると顧客に伝えているのを見つけました。公平に言えば、モデルは何も作り話をしていませんでした。彼らのナレッジベースが「all models」に対応していると書いてあり、ボットはそれを信じたのです。Haiku 5.5 でも同じ間違った回答を、ただ速く安く出したでしょう。
だからこそ、eesel のすべての導入では、チームメイトがお客様と話す前に過去のチケットでシミュレーションを行います。そのステップが、どんなモデルのアップグレードでも直せないナレッジのギャップを見つける場所で、クローズドブックの事実を 32% 間違えるモデルではなおさら重要です。
速い Claude モデルを使った eesel をキューで試す
チケットで Haiku 5.5 の速さがほしいなら、eesel が近道です。AI ヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgias などの既存のヘルプデスクに参加し、過去のチケットとヘルプセンターから学び、フロンティアモデルを土台にトリアージ、タグ付け、返信を行います。100k の崖、エフォート調整、上の破壊的変更、そのすべてがあなたではなく eesel の問題になります。

ターミナル派なら、eesel CLI がダッシュボードと同じチームメイトとワークスペースを操作します。スクリプト化することも、Claude Code のようなコーディングエージェントに操作させることもでき、これはこのレビューのリードと相棒のパターンをあなたのサポート環境に当てはめたものです。
AI エージェント CLI と MCP サーバーに関する記事でさらに詳しく扱っています。
有料プランは 500 クレジットで $299 から始まり、まずは実際のチケットの一部で無料で試せます。eesel を試して、速いモデルが本当にお客様への速い回答として現れるか確かめてください。
Claude Haiku 5.5 は価値があるか?
はい、仕事が短く反復的なものなら価値があります。100k プロンプトトークン未満で Low か Medium エフォートなら、Claude Haiku 5.5 は私が Anthropic で見た中で最高の小型モデルです。同じ定価で GPT-6 Luna より賢く、Anthropic が売る他のどれより速く、ナレッジワークでは Sonnet 5.5 に十分近いので、サポートキューの大部分を引き受けられます。
どちらのラインを超えても計算は逆転します。長いエージェントセッションは 5 倍払い、Max エフォートはトークンを燃やし、新しいトークナイザーはその両方を早く来させます。Haiku 4.5 がまだ使えるうちに自分で評価を行い、プロンプトを絞り、Haiku 5.5 が上に回すものは大きなモデルに任せましょう。