Claude Mythos 5.1とは実際に何なのか
Anthropicは2026年9月1日に、モデルID claude-mythos-5-1 でClaude Mythos 5.1をリリースした。検証済みのセキュリティおよびライフサイエンス業務向けのフロンティアモデルであり、Anthropicは、Claude Security自体もこのモデル上で動いていると述べている。
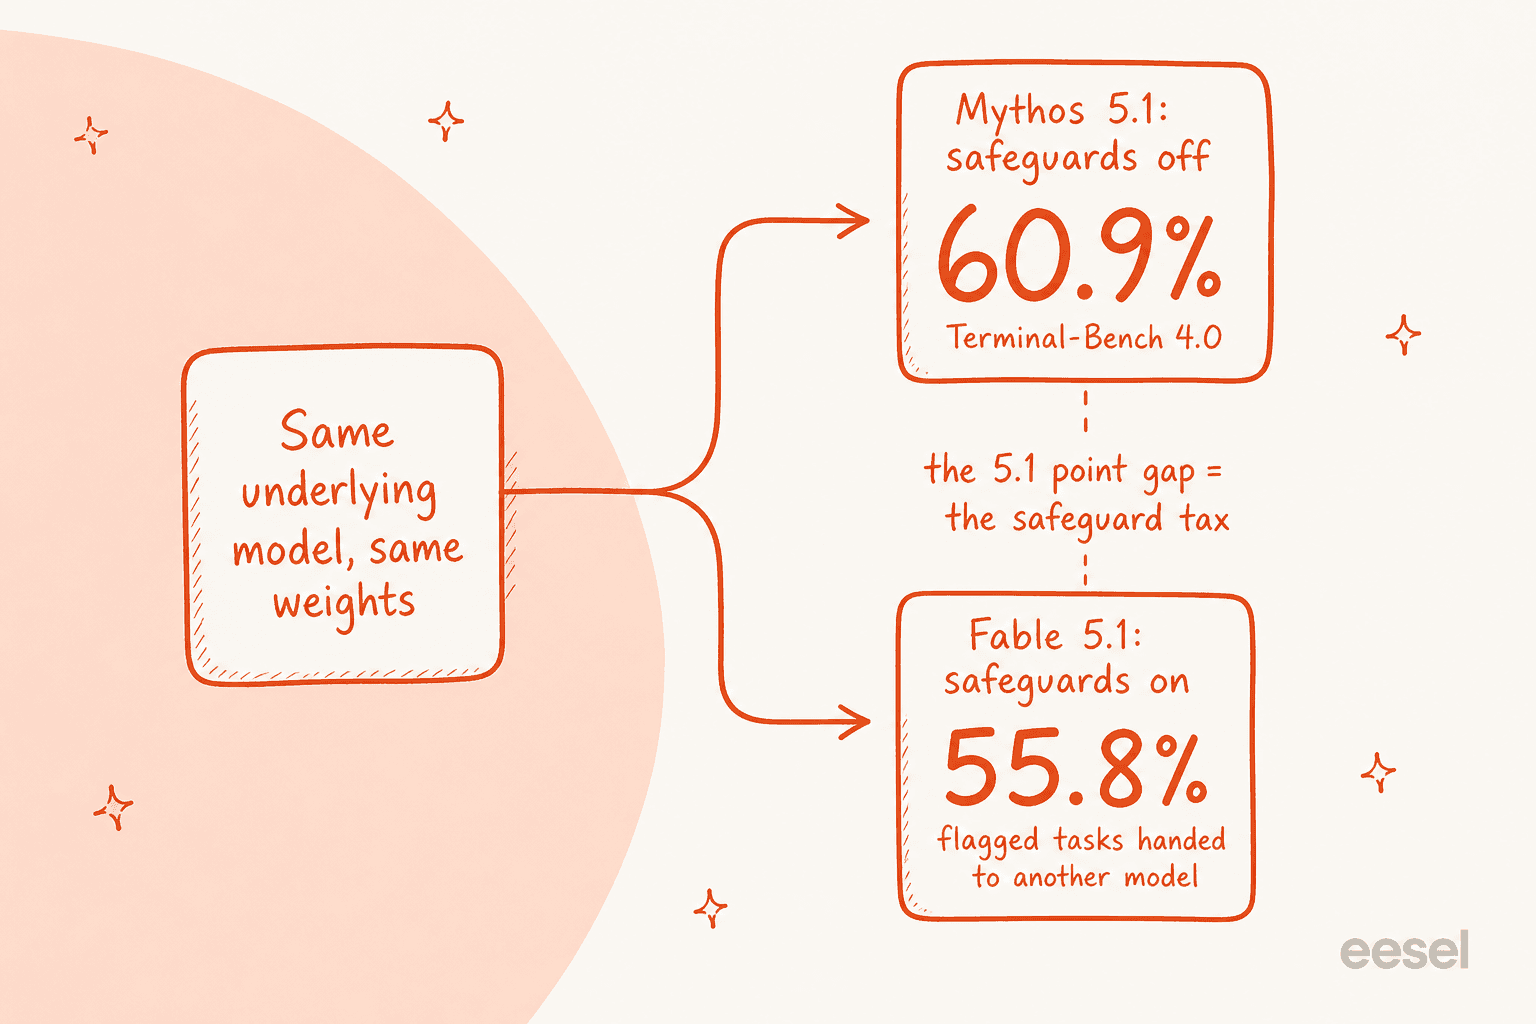
ベンチマークの話をする前に理解しておくべきことがある。Mythos 5.1とFable 5.1は同じ重みである。異なるのは保護レイヤーだけだ。Fable 5.1は本番用の保護機構をオンにした状態でベンチマークされ、リリースされたバージョンで、保護機構が作動するとタスクを別のモデルに渡す(サイバー関連の作業はOpus 4.8に、生物学関連はOpus 5にルーティングされる)。Mythosはその保護機構をオフにして測定した同じモデルだ。この関係性がすべての本質であり、この記事の中で何度も戻ってくることになる。
Mythos 5.1 対 Fable 5.1:その差は保護機構の「税金」
みんなが文脈を無視して引用する数字がここにある。Terminal-Bench 4.0では、Mythos 5.1が60.9%、Fable 5.1が55.8%を記録している。Mythosの方が賢いモデルのように見えるが、そうではない。Fableの低いスコアは、保護機構がタスクを検知して引き渡した際に起こる現象であり、介入されたタスクは完全にゼロ点になることもある。5.1ポイントの差は保護機構のコストであり、基盤となる脳の違いではない。
これはローンチ時に多くの読者を混乱させた。Hacker Newsのあるコメントにはこうある。
"待って、つまり文字通り同じモデルなのに、シートベルトを外したからスコアが高くなっただけ?それは新しいモデルじゃなくて、ベンチマークの脚注だよね。"

Anthropic自身も、保護機構がより精密になるにつれてこの差は縮まっていくと予想しており、これは差がモデルの品質ではなく安全レイヤーによるものだという暗黙の認めでもある。だから、MythosとFableを純粋な能力で比較しているなら、そこでやめてほしい。両者は同等だ。Fableが真に価値を発揮するのは、保護機構そのものの仕事だ。今ではソースコード内のソフトウェア脆弱性を特定できるようになり、Claude Codeのセッションあたりのサイバー保護機構の介入がおよそ60%減少し、生物学関連の保護機構は無害なリクエストに対して85%少なく作動する。ペネトレーションテスト、エクスプロイト生成、バイナリの脆弱性スキャンは今もOpusに回される。両モデルとも他のラインナップと並んでいるので、モデルファミリー全体を把握したいならClaude Opus 5とClaude Sonnet 5の記事が下位ティアをカバーしている。
参考までに、公開された数値に基づいてFable 5.1(Mythosの実用的な代役)が競合とどう比較されるかを示す。
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6 | 24.7 | 29.0 | 22.4 |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| AutomationBench | 31.4 | 17.1 | 26.9 | 19.6 |
| CursorBench 3.2.0 | 73.4 | 70.5 | 70.0 | 67.2 |
| HLE with tools | 65.0 | 63.8 | 63.6 | - |
Terminal-Bench-Scienceでの24.7から52.6へのジャンプは、購入者に実際に伝えたいポイントだ。OpenAI側との直接比較については、GPT-5.6 SolとGPT-5.6 vs Claudeの記事が、一行の表よりもさらに深く掘り込んでいる。
本当の見どころは0.25ドルのキャッシュ読み取り
このレビューから一つだけ数字を持ち帰るなら、これにしてほしい。Fable 5.1とMythos 5.1は、キャッシュヒットを100万トークンあたり0.25ドルという価格に設定しており、これは基本入力レートの0.025倍だ。他のすべてのClaudeモデルは0.1倍、つまり1.00ドルを課している。これはOpus 5の2倍の基本価格でありながら、Opus 5のキャッシュ読み取り価格(0.50ドル)の半分でキャッシュ読み取りを提供しているモデルということになる。
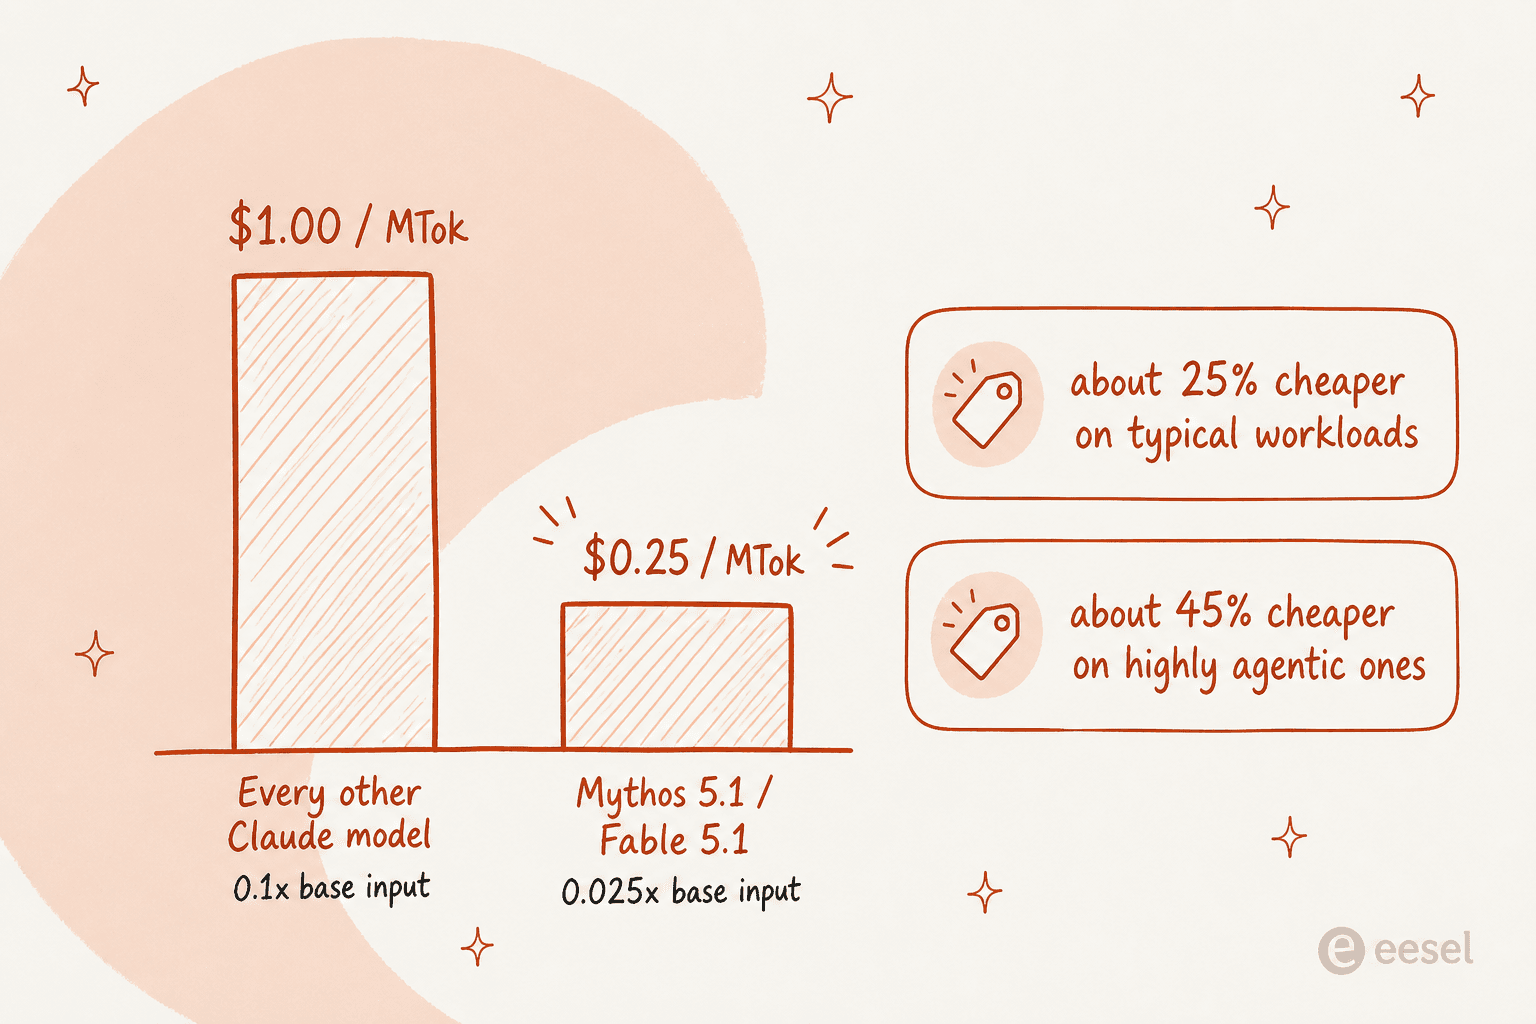
Anthropicは2026年8月の4週間分の利用データでこの効果を測定した。典型的なワークロードで約25%安く、エージェント性の高いワークロードで約45%安くなったという。基本レート(入力10ドル/出力50ドル)は変わらず、バッチは5ドル/25ドル、5分間のキャッシュ書き込みは12.50ドル、1時間の書き込みは20ドルだ。毎ターン同じナレッジベースを再読み込みするロングコンテキストのエージェントを運用しているなら、この数字こそが基本レートよりもはるかに料金を動かす要因になる。あるHacker Newsのコメント者は次のように計算を口にしていた。
"0.025倍のキャッシュ読み取りはやばい。ヒット率95%なら実質的な入力コストはほぼキャッシュ価格そのものになる。つまり巨大なコンテキストを温存しておくのに、たった数セントを払うだけになるということだ。"
実際のエージェントスタックでキャッシュの経済性がどう影響するかについては、Anthropic APIの料金ガイドとClaude Codeの料金の解説を次に読んでみることをお勧めする。
Claude Mythos 5.1を実際に使えるのは誰か
ここからレビューは実践的になり、少し気が滅入る話になる。Mythos 5.1はAPIキーひとつで使えるようなものではない。現時点でのアクセスは米国限定で、3つの入り口のいずれかを通る必要がある。Cyber Verification Program(Anthropicは、Mythosへのアクセスは「近い将来」提供予定と述べているため、まだ稼働していない)、米国政府と共に構築された招待制のLife Sciences Programベータ、あるいはAnthropic・AWS・GCPのアカウントチームとの直接のやり取りだ。さらに、Mythos 5.1の利用にはデフォルトで30日間のデータ保持への同意が必要になる。
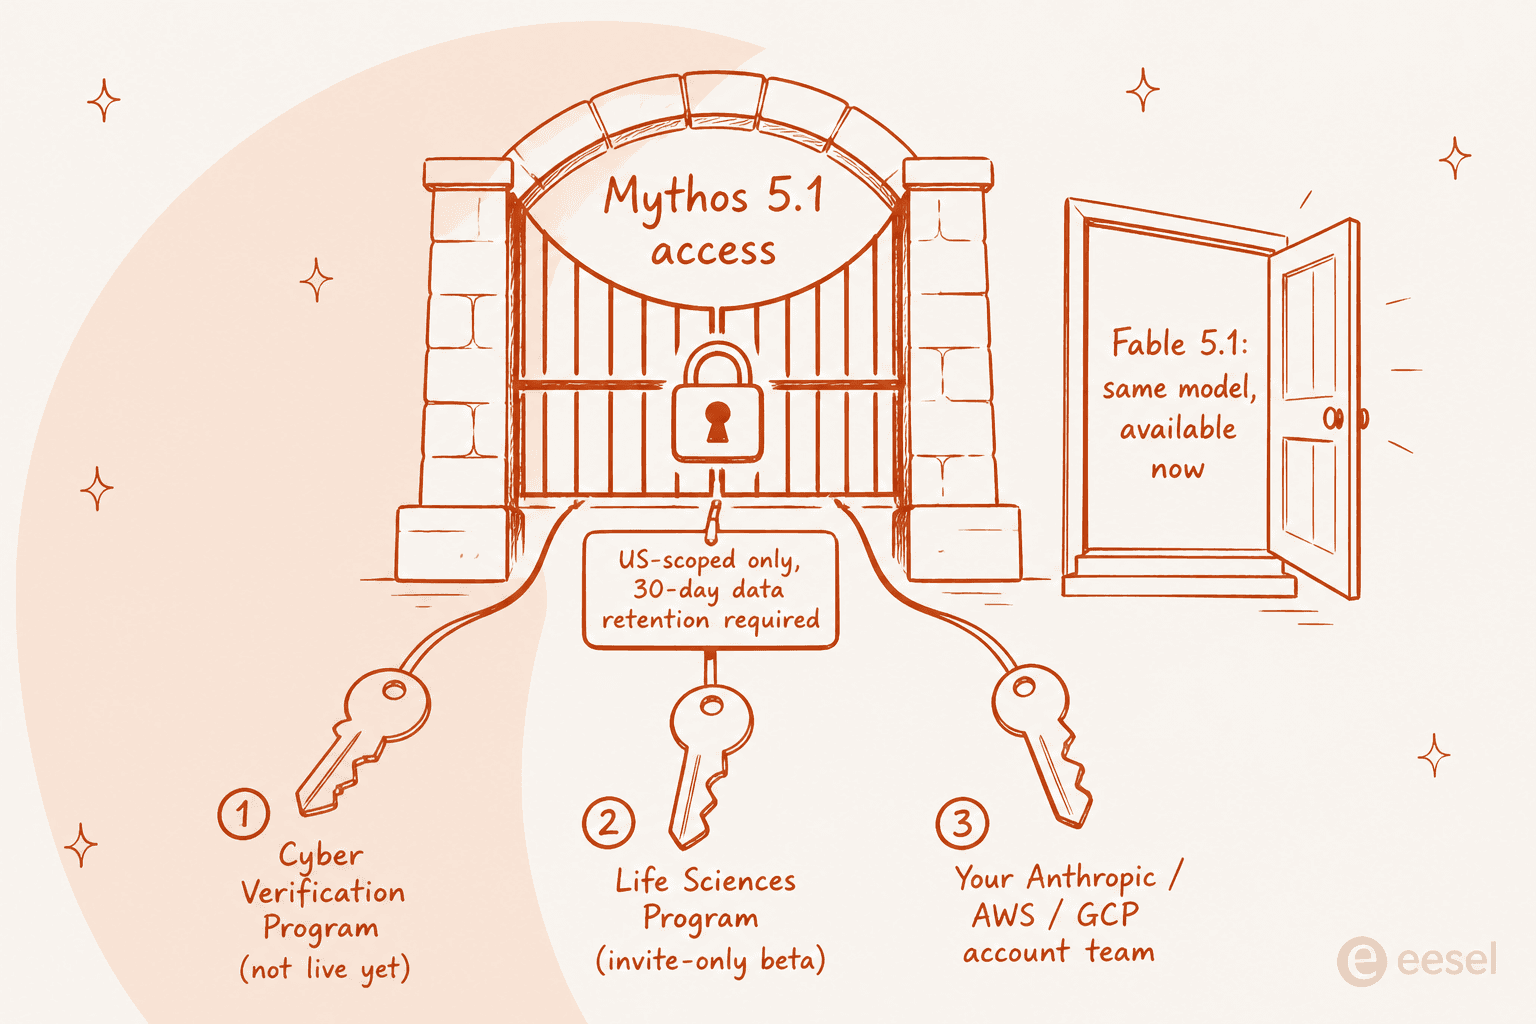
つまり「Mythos 5.1を使うべきか」という問いへの正直な答えは、ほとんどの人にとってそれは選択肢にすらないということであり、実際に使えるバージョンであるFable 5.1が同じモデルだということだ。これはモデルへの批判ではなく、実際に導入できる姉妹モデルの方に評価を向けるべき理由だ。今日、実際のワークロードのためにClaudeモデルを選んでいるなら、Claudeの代替モデルとサポートチケットに最適なAIモデルのガイドがより実用的な読み物だ。
スペック一覧
すべての数字を一箇所にまとめたい購入者向けに、Mythos 5.1(そしてFable 5.1)が備える内容をまとめる。
| Spec | Value |
|---|---|
| コンテキストウィンドウ | 1Mトークン |
| 最大出力 | 128Kトークン |
| Thinking | アダプティブ、常時オン。デフォルトのeffortはhigh |
| 知識のカットオフ | 2026年6月 |
| レイテンシ | より遅い |
| モダリティ | テキスト+画像からテキストへ |
| プラットフォーム | Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry |
| 引退予定 | 2027年9月1日より前にはない |
構築前に知っておくべき開発者向けの変更点が2つある。両モデルに影響する破壊的なAPI変更が3つある。強制的なツール使用は今後エラーを返すようになったこと、Thinkingブロックはそれを生成したモデルに紐づけられるようになったこと、そしてローンチ日以降に作成された新しいAPIアカウントは、Thinkingの文字起こしを保持したまま過去のコンテキストを編集できなくなったこと(蒸留対策の一環)だ。さらにEU AI Actに関する注意点もある。2026年8月2日以降にリリースされたモデルには、目に見えないテキストの電子透かしが埋め込まれており、検出用APIはプライベートプレビュー中だ。この電子透かしが、ローンチ後の議論で最も話題になった点だった。自社のスタックにClaudeモデルを組み込むなら、Claude Codeのモデル選択に関するノートとClaude Managed Agentsの解説が実践的な続きの読み物になる。
実際に何を使うべきか
このローンチをじっくり見た上での私の結論はこうだ。Mythos 5.1は、おそらく使えない優れたモデルであり、その周りに本当に優れた価格変更が一つ包まれている。取るべき行動は招待を追いかけることではない。Fable 5.1を使い、0.25ドルのキャッシュ読み取りを手にし、MythosとFableを比べるという構図全体を、それが実際にそうである保護機構の脚注として扱うことだ。
そして「モデルは簡単な部分だ」という言葉の裏には、もっと大きな論点が隠れている。フロンティアモデル、MythosであろうがFableであろうが、それはインフラだ。それ単独ではサポートエージェントでも、リサーチャーでも、チームメイトでもない。素のClaude APIキーをヘルプデスクの隣に置くだけでは、返金ポリシーを知らず、過去の1万件のチケットを見ることができず、顧客と話す前にテストする方法もない、非常に賢いテキストジェネレーターしか手に入らない。そのギャップを埋めることこそが本当の仕事であり、それは背後のモデルがMythosであれ、Fableであれ、Opus 5であれ、変わらない仕事だ。
モデルがやらない部分をeeselで試す
Claude Mythos 5.1のレビューを読んでいる理由が、サポートキューにより賢いAIを置きたいからだというなら、正直に伝えるべきことがある。ボトルネックはモデルではなく、その周りの配管の方だ。それこそがeeselが担う部分だ。
新しく採用した社員のようなものだと考えてほしい。eeselはAIチームメイトのプラットフォームであり、AIヘルプデスクのチームメイトは、過去のチケット、ヘルプセンター、マクロで既に学習済みの状態で既存のキューに参加する。そのため、モデルの生の知性はオープンなウェブではなく、実際の自社のコンテキストに向けられる。実際の顧客に答える前に、過去のチケットに対してシミュレーションすることができ、実際に何と答えていたかを正確に確認できる。これは私のチームが自信満々の誤答を出荷してしまうことから何度となく救ってくれた、たった一つの習慣だ。Zendesk、Freshdesk、Front、Gorgias、Help Scoutのいずれであっても、数分でヘルプデスクに接続できる。
そして、モデルのレビューを読む人の一定数はエンジニアであるため、eeselはダッシュボードだけではないということも伝えておく価値がある。本物のeesel CLIに加えてMCPサーバーもあるので、ターミナルから同じチームメイトを操作したり、自分のワークフローに組み込んだり、Claude Codeのようなコーディングエージェントに操作させたりすることができる。クリック操作であってもヘッドレスで実行するのであっても、同じチームメイトだ。eeselは無料で試すことができ、先に自分のチケットで確認したい場合はデモを予約することもできる。
よくある質問
Claude Mythos 5.1とは何ですか?
Claude Mythos 5.1は、2026年9月1日にリリースされたAnthropicのフロンティアモデルで、本番用の保護機構をオフにした状態でベンチマークされています。実際に多くの人が使っている保護機構オンのバージョンであるFable 5.1と同じ基盤の重みを共有しています。モデルファミリーの背景については、Claude Mythosの解説記事を参照してほしい。
Claude Mythos 5.1はFable 5.1とどう違いますか?
両者は保護レイヤーが異なるだけの同じモデルだ。私のClaude Mythos 5.1レビューで測定できた唯一の差は、Fableがフラグの立ったタスクを別のモデルに渡すことで、それによりベンチマークのポイントがいくつか下がる点だけだった。姉妹モデルについてより深く知りたい場合は、Claude Fable 5.1レビューを読んでほしい。
Claude Mythos 5.1の料金はどのくらいですか?
基本料金は入力100万トークンあたり10ドル、出力100万トークンあたり50ドルで、Fable 5.1と同じだ。今回の大きなニュースはキャッシュ読み取りが100万トークンあたり0.25ドルになったことだ。詳細はClaude Fable 5.1の料金の解説と、より広範なClaudeの料金ガイドでカバーしている。
Claude Mythos 5.1は誰でも使えますか?
まだ使えない。アクセスは米国限定で、Cyber Verification Program、Life Sciences Program、またはAnthropic・AWS・GCPのアカウントチームを経由する必要があり、利用には30日間のデータ保持への同意が必須だ。今すぐ使えるClaudeモデルを探しているなら、Claudeの代替モデルとサポートチケットに最適なAIモデルのガイドを見てほしい。
Claude Mythos 5.1はカスタマーサポートに向いていますか?
モデル自体は強力だが、素のモデルはインフラであってサポートエージェントではない。Claudeモデルを実際のキューに乗せるには、検索拡張、ガードレール、テストが依然として必要で、それを担ってくれるのがClaudeとヘルプデスクの連携や、eeselのようなAIカスタマーサービスソフトウェアだ。


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.