

なぜこれをスペックシートだけで答えないのか
価格表を鵜呑みにするな。それが、他人のサポートキューにAIエージェントを3年間投入し続けてわかった唯一の習慣だ。トライアルユーザーが12件のきれいなテスト会話を実行して、すべての回答を気に入るのを見たことがある。それなのに、その後請求ページを開いた途端に解約リクエストを出した。その二つの瞬間のあいだで、プロダクト自体は何も変わっていない。変わったのは、抽象的な単価が実際の請求額になったことだけだ。
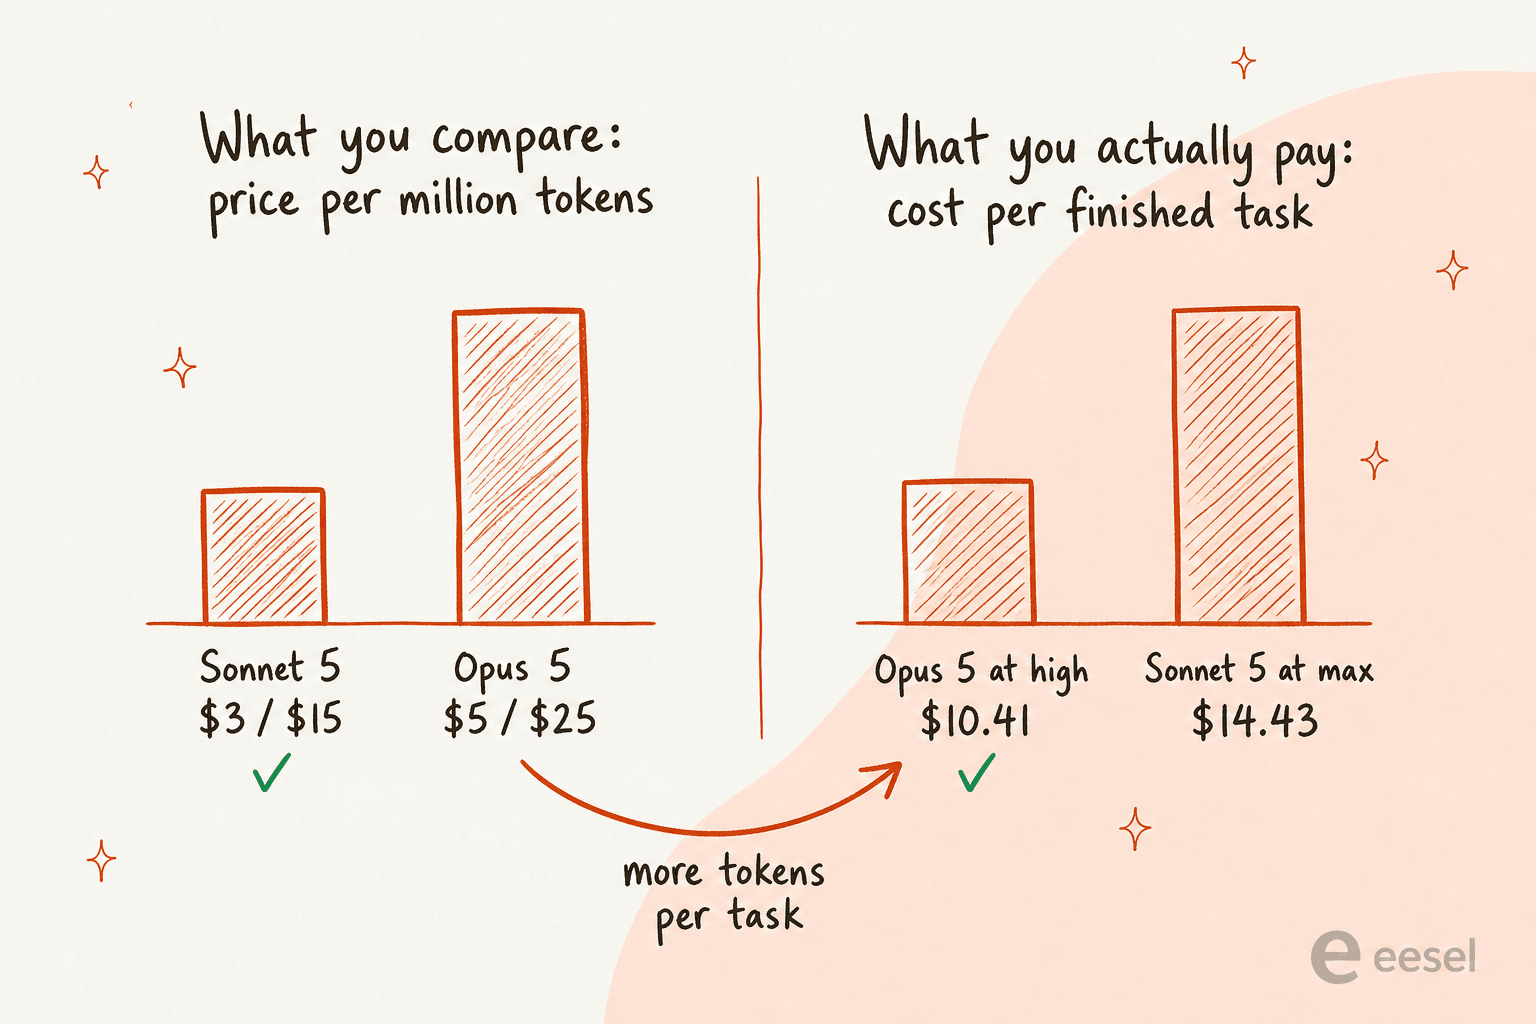
同じ罠が、Claude Opus 5 vs Sonnet 5という問いのなかにも潜んでいる。100万トークンあたりで見ると、Opus 5の価格は入力$5、出力$25だ。Sonnet 5は$3と$15。ここで読むのをやめればSonnetを選ぶことになり、そうする人のかなりの割合が結果的により多く払うことになる。
だからこの記事の順番はこうなっている。まず仕様、次にベンチマーク、そして実際の請求額がどう見えるか。最後は、今日の午後にでも使えるルーティングのルールで締めくくる。
Claude Opus 5とは何か
Claude Opus 5は2026年7月24日にローンチし、AnthropicはClaude Fable 5のフロンティア級の知能に、半額で近づいていると説明している。APIのidはclaude-opus-5で、100万トークンのコンテキストウィンドウと128kの最大出力を備え、信頼できる知識のカットオフは2026年5月だ。
ここでの立ち位置は珍しいほど直接的だ。Anthropicのドキュメントは、複雑なエージェント型コーディングやエンタープライズ向けの作業にはまずClaude Opus 5から始めるように案内していて、絶対的な上限が必要な場合にのみFable 5に引き上げるよう勧めている。指摘しておく価値があるのは、その推奨のなかにSonnet 5がまったく登場しない点だ。
価格はOpus 4.8から変わっておらず、依然として$5と$25のままだ。変わったのは振る舞いの方だ。Thinkingがデフォルトでオンになっており、これまでThinkingなしで動いていたリクエストも、指定しない限りは推論にトークンを使うようになる。このアップグレードの経緯全体は私のOpus 5レビューで詳しく掘り下げていて、Fable 5との対決は一段上のティアを扱っている。
Claude Sonnet 5とは何か
Claude Sonnet 5は2026年6月30日に出荷され、「これまでで最もエージェント的なSonnetモデル」と位置づけられており、Anthropic自身の言葉では性能面でOpus 4.8に近いながらも価格は低いとされている。100万トークンのコンテキストは同じで、128kの出力上限も同じだ。エフォートレベルもどちらも5段階ある。ClaudeのFreeプランとProプランのデフォルトモデルでもあり、つまり選んだ覚えのないまま最も多くの人が使っているClaudeということになる。
見落としやすい点が2つある。
まず、比較の基準となっているのはOpus 4.8であって、Opus 5ではない。Sonnet 5はOpus 5が存在するようになる3週間半前にローンチしているため、AnthropicはSonnet 5とOpus 5を直接比較した資料を一度も公開していない。読んでいるどの比較記事も、この記事も含めて、2つの別々のローンチから組み立てられたものだ。
次に、Sonnet 5の主要なベンチマークスコアはプロダクトページの画像として公開されていて、テキストではない。7月27日にローンチ投稿、プロダクトページ、ドキュメントをあらためて確認したが、数字はまだPNGのなかに閉じ込められたままだった。だから以下でSonnet 5の数値を引用する箇所はすべて、AnthropicのOpus 5システムカードか独立した評価から取ったもので、検証できない数字を使ってはいない。モデル自体の深掘りは私のSonnet 5レビューにあり、代替案まとめではそのポジションに合う他の選択肢を扱っている。
スペック比較
ここに載っている内容はすべてAnthropicのモデル比較表と価格ドキュメント、それに移行ガイドから取っている。
| Claude Opus 5 | Claude Sonnet 5 | |
|---|---|---|
| API id | claude-opus-5 | claude-sonnet-5 |
| 入力 / 出力(100万トークンあたり) | $5 / $25 | $3 / $15(導入価格 $2 / $10、2026年8月31日まで) |
| Batch APIレート | $2.50 / $12.50 | $1.50 / $7.50(導入価格 $1 / $5) |
| コンテキストウィンドウ | 1Mトークン | 1Mトークン |
| 最大出力 | 128k(Batchでは300k) | 128k(Batchでは300k) |
| Effortレベル | low〜maxの5段階 | low〜maxの5段階 |
| Adaptive thinking | あり、デフォルトでオン | あり、デフォルトでオン |
| 比較上のレイテンシ | 中程度 | 速い |
| 信頼できる知識のカットオフ | 2026年5月 | 2026年1月 |
| キャッシュ可能な最小プレフィックス | 512トークン | 1,024トークン |
| Fastモード | あり、$10 / $50 | なし |
messages内のrole: "system" | あり | なし |
| ロングコンテキスト追加料金 | なし | なし |
このうち4行は、支払う金額だけでなく、どう構築するかにも関わってくる。
知識のカットオフの差は4カ月あり、しかもおそらく予想とは逆の方向に効いている。値段が高い方のモデルの方が新しいのだ。Opus 5は2026年5月まで知っているが、Sonnet 5は1月で止まっている。
Opus 5の512トークンというキャッシュ下限は、Sonnet 5の半分だ。Sonnetでは静かにキャッシュ不可能だった短いシステムプロンプトが、Opusではキャッシュ可能になり、キャッシュヒットは基本入力コストの10%で済む。高頻度・短いプロンプトのワークロードでは、これが価格差を静かに縮める。
FastモードはOpus専用だ。$10 / $50で出力速度がおよそ2.5倍になるFastモードは、ファーストパーティAPI限定のリサーチプレビューのままで、Bedrockやパートナークラウドでは選択肢に入らない。
そして**messages配列内のrole: "system"**はOpus 5では動くが、Sonnet 5ではサポートされていない。もしインストラクションを途中で更新するためだけにメッセージ履歴全体を作り直していたなら、Opus 5はそれをやめさせてくれる。しかも、それ以前のターンのプロンプトキャッシュヒットを失わずに済む。実際のコードパスをシンプルにできる話であり、ベンチマークのグラフには決して出てこない類の詳細でもある。1つのベンダー内ではなくベンダーをまたいでAPIを選ぶ場合は、私の3社API比較がより広い分野をカバーしている。
能力面では、僅差ではない
AnthropicのOpus 5システムカードは、両モデルが同じ基準で測定されている唯一の場所で、そこに現れる差は大きい。
| 評価 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|
| Frontier-Bench v0.1(ターミナルタスク) | xhighで44.4% | 17% |
| BBQ disambiguated accuracy | 81.6% | 72.4% |
| タンパク質設計 | 42.5% | 21.2% |
| 有機化学V2 | 61.6% | 40.6% |
| プロンプトインジェクション(autoモードでのブラウザ利用) | 攻撃成功0% | 攻撃成功0% |
Frontier-Benchの行にはじっくり目を向ける価値がある。これはTerminal-Bench 2.1の後継で、コンテナ化されたターミナル環境で実行される74件の難しいタスクからなり、Opus 5はSonnet 5の2.5倍以上のスコアを出している。これはティアの違いという言葉では説明できない。この種の作業に関しては、まったく別のクラスのツールだ。
ここには正直に断っておくべき点が2つある。Anthropicはシステムカードのなかで、この評価においてOpus 5の安全分類器がAPI呼び出しの5%をフラグして拒否し、Opus 4.8にフォールバックしたと述べている。そしてセキュリティの行では両モデルとも互角で、Firefox 147の評価でどちらも動作するエクスプロイトを生成しておらず、autoモードを有効にした状態では129のブラウザ利用環境全体でプロンプトインジェクション攻撃はどちらに対しても成功しなかった。
ここからが決め手になる部分
そもそも能力は本当の論点ではなかった。予算が無制限なら、何でもFable 5で動かせばいい。本当の問いは、ひとつの仕事を完了させるのにいくらかかるかであり、ここが両モデルの振る舞いが価格表どおりではなくなる場所だ。
Artificial Analysisは両モデルをAA-Briefcaseで走らせた。これは何千ものソースファイルを扱う数週間規模のプロジェクトを想定した、長時間の知的作業向けベンチマークだ。Anthropicはその結果をOpus 5システムカードのなかで再掲している。
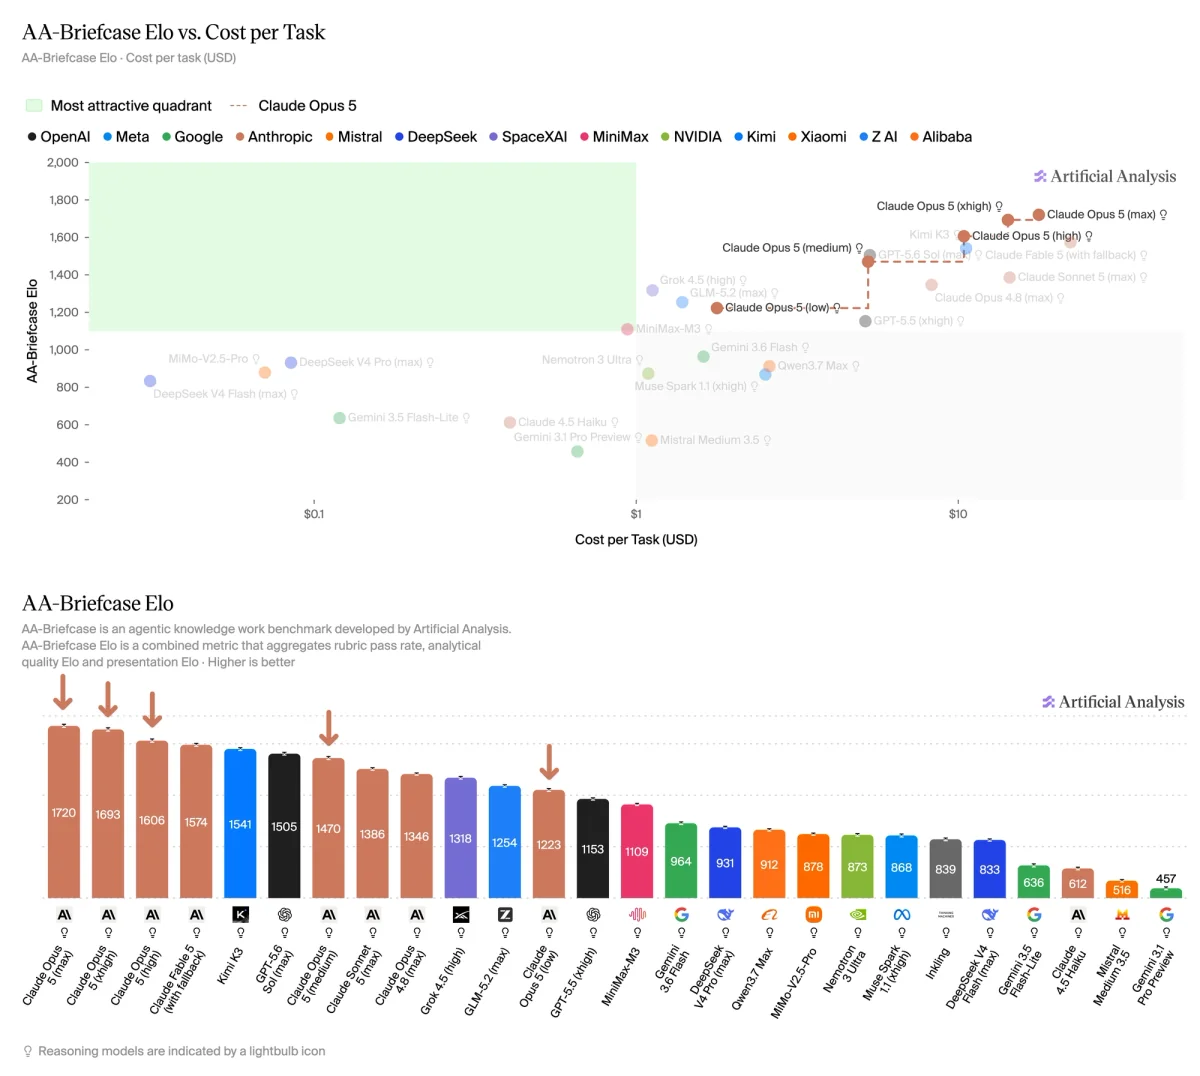
Opus 5は上位3枠を独占し、max・xhigh・highの順に1720、1693、1606のEloを記録している。Sonnet 5はmaxで1386にとどまり、これはOpus 5のmedium(1470)よりも低い。続いてコストのグラフだ。
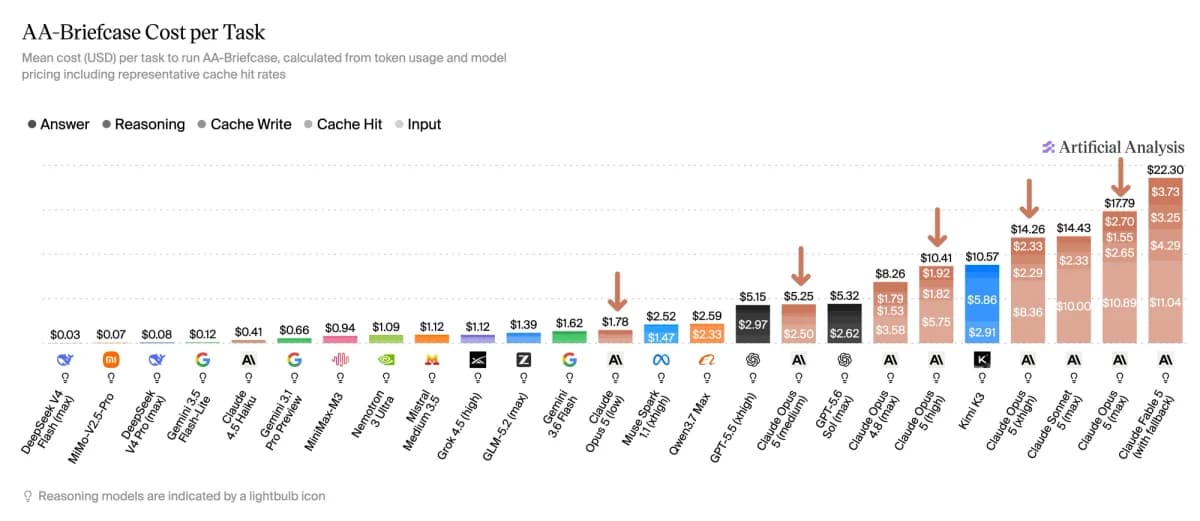
この2つを並べると、安い方のモデルにとって都合の悪い結果が見えてくる。
| 設定 | AA-Briefcase Elo | タスクあたりのコスト |
|---|---|---|
Opus 5(max) | 1720 | $17.79 |
Opus 5(xhigh) | 1693 | $14.26 |
Opus 5(high) | 1606 | $10.41 |
Opus 5(medium) | 1470 | $5.25 |
Sonnet 5(max) | 1386 | $14.43 |
Opus 5(low) | 1223 | $1.78 |
Opus 5のhighは品質でSonnet 5のmaxを上回りながら、タスクあたり$4安く済んでいる。Opus 5のmediumですら、およそ3分の1の価格でまだ上回っている。その理由を説明するのがターン数だ。Sonnet 5のmaxは1タスクあたり平均183ターンで、チャート中どのモデルよりも多く、Opus 5のmaxの103ターンと対照的だ。
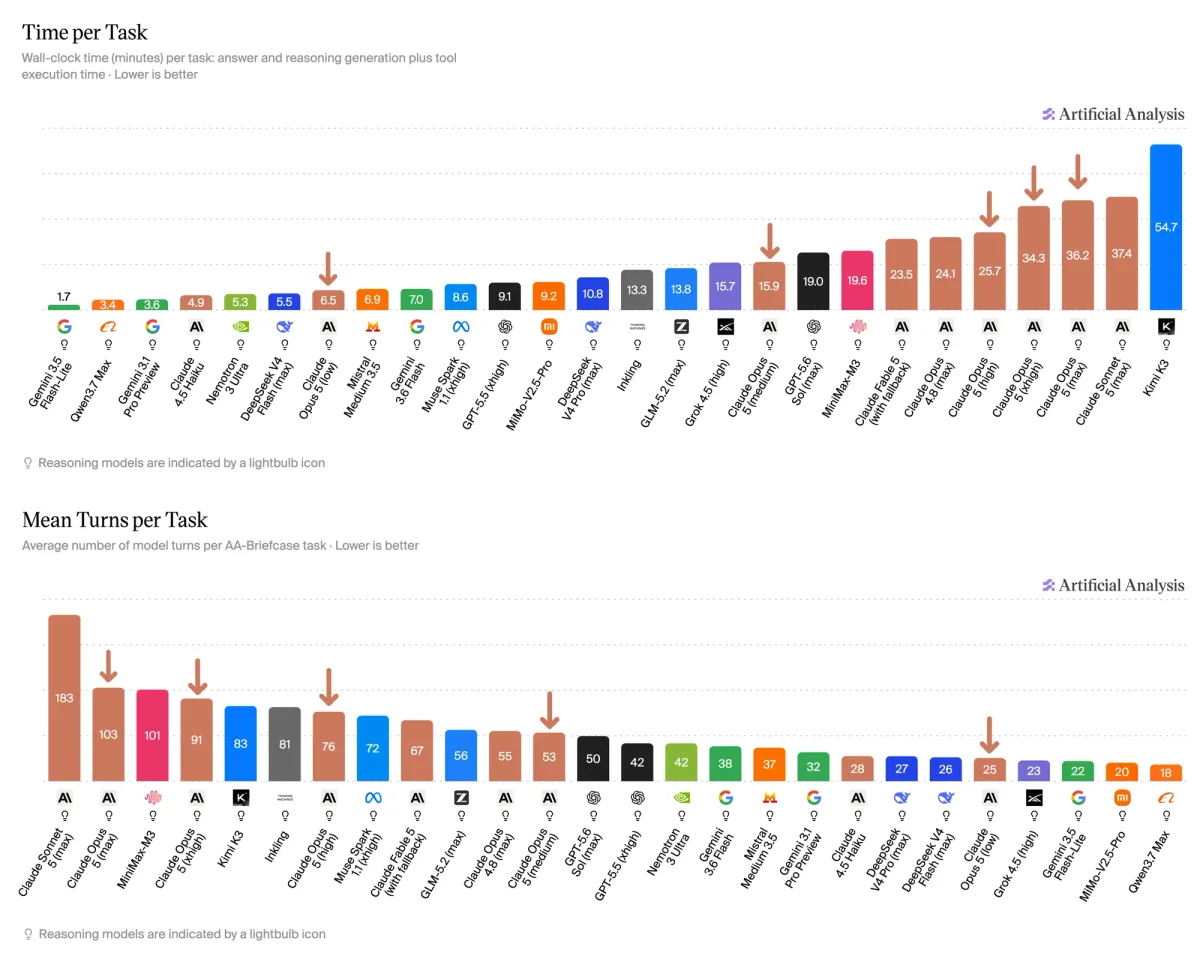
逆転が起きる場面
これは後から見つけてがっかりされるより、先に指摘しておきたい。短いタスクでは順序が逆転する。Artificial AnalysisのIntelligence Indexの実行結果は、それをはっきりと示している。
"Frontier intelligence with reduced cost: Claude Opus 5 (max) costs $2.03 on average per Intelligence Index task, below Claude Fable 5 (with fallback) at $2.75, but still above Claude Opus 4.8 (max) at $1.80 and Claude Sonnet 5 (max) at $1.53. However, at high and xhigh reasoning efforts Opus 5 can outperform both Opus 4.8 and Claude Sonnet 5 at a lower cost per task"
つまりインデックス規模のタスクでは、Sonnet 5のmaxの方が安いモデルになる。$1.53対$2.03だ。数時間にわたるエージェント型の作業になると、同じモデルがボード上でほぼ最も高価な存在になる。タスクの長さが分かれ目だ。短く浅い作業はSonnetに有利で、長く深い作業はOpusに有利。そのどちらにも通用する「どちらが安いか」という単一の答えは存在しない。
自分の数字で計算してみる
料金表を見るのは簡単な部分にすぎない。人が省きがちなのは乗数であり、だからこの電卓はそれを自分で設定させるようにしている。安い方のモデルが同じ仕事を終えるのに何倍多くの出力トークンを必要とするかを反映するまでドラッグして、2本の線がどこで交差するかを見てほしい。
正直に述べておくべき点が2つある。乗数は出力にしか適用されていないため、実際のギャップをやや過小評価している。ターン数が増えるということは、より多くの入力を読み直すことも意味するからだ。そしてこれはリストプライスに基づく算数であって、ベンチマークではない。プロンプトキャッシュやBatch APIの割引、そして自分のプロンプトの形も、実際の数字を動かす。
それがコード化しているメカニズムは、決して理論上の話ではない。ある開発者は実際に測定している。
"Sonnet is supposed to be the cheaper model, but on the harder task it:
Cheaper per token does not always mean cheaper per completed task."
took longerwrote more codeused more than twice the output tokensneeded more fixesstill cost more than Fableshricodev, Reddit

Effortダイヤルこそが本当の決め手
これが、私自身が渡されたかった再構成だ。あなたが選んでいるのは2つのモデルのどちらかではなく、5段階のeffortダイヤルのどこかであり、モデル名はその選択の下流にある。
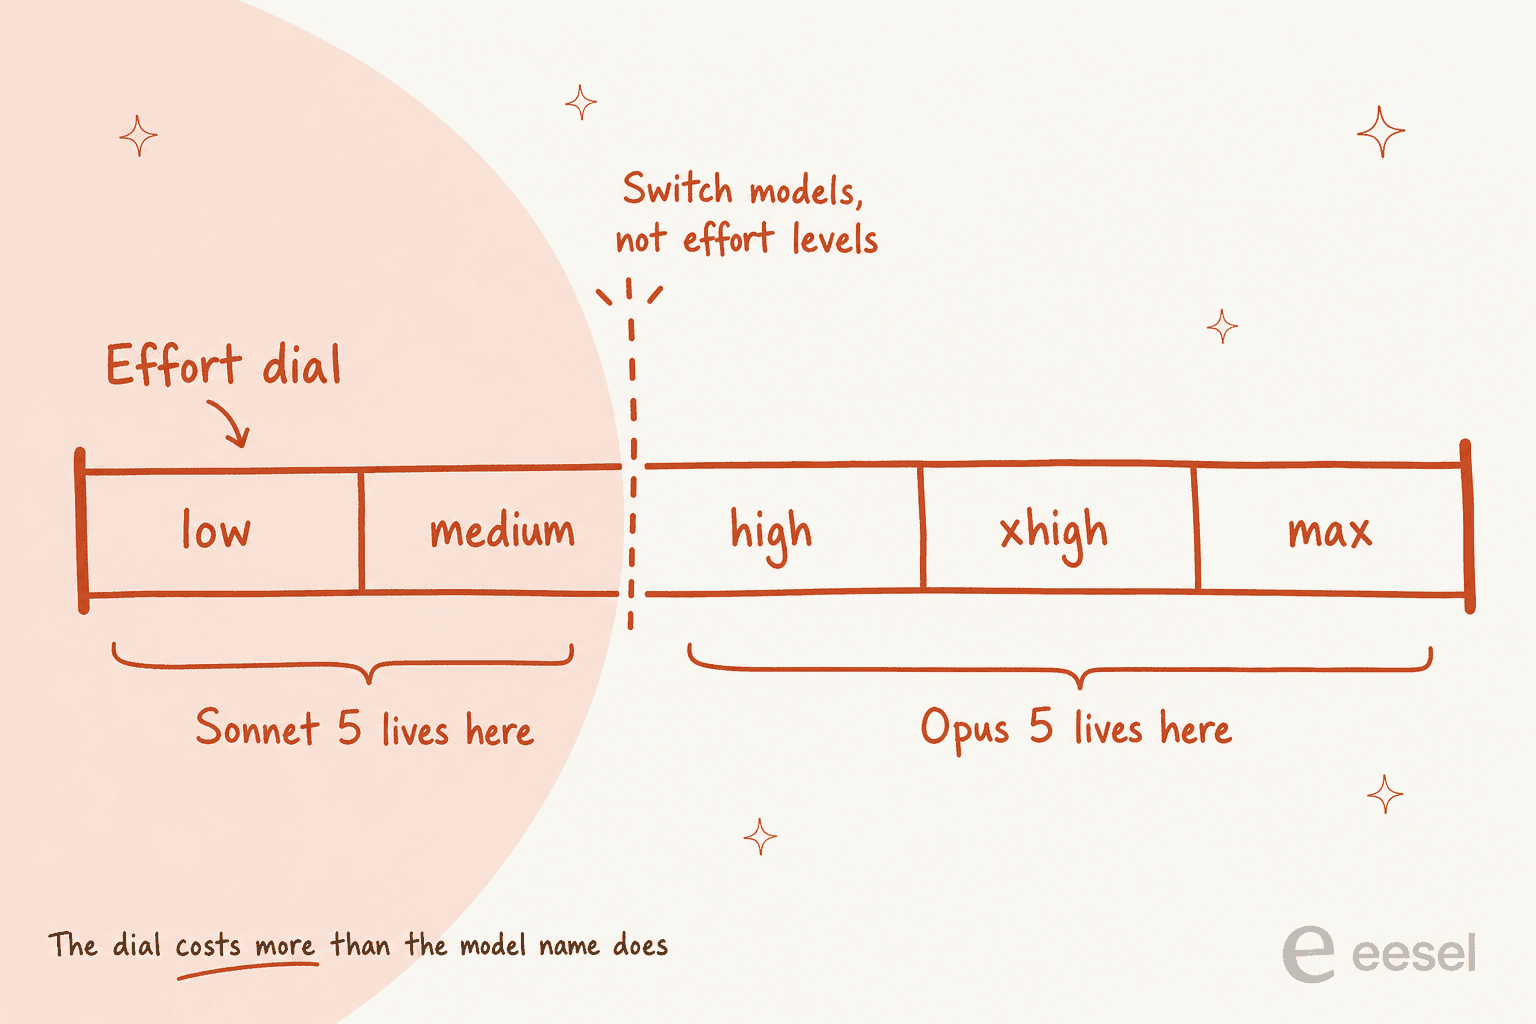
どちらのモデルもlow、medium、high、xhigh、maxを取り、どちらもAPI上のデフォルトはhighだ。この設定が生む幅は膨大だ。AnthropicのAA-Briefcaseの実行結果を見ると、Opus 5はlowの1223Eloからmaxの1720Eloまで広がり、コストは$1.78から$17.79まで広がる。1つのモデルidの中に10倍のコスト幅がある。「Claude Opus 5」とひとくくりに呼ぶのは、まるで単一の性能プロファイルしか持たないかのような誤りだ。
だからこそ、最初の1週間から出てきた最も鋭いルールは、ティアではなくダイヤルについてのものだ。
"The cost per task chart is telling me that I should never use Sonnet 5 above medium effort level - Opus always performs better for a given cost. So I guess the takeaway is that if Sonnet 5 medium isn't good enough for you, switch models, not effort levels."

他の開発者たちも、独立して同じ方針にたどり着いている。
"If I'm using medium or low reasoning, I use Sonnet 5. If high or above, I use Opus 4.8. (Before 5, I was never using Sonnet. This is a Sonnet 5 vs Opus 4.8 comparison.)"
今のラインナップに当てはめるなら、こうなる。**Sonnet 5はlowかmediumで、Opus 5はhigh以上で、Sonnet 5のmaxは絶対に使わない。**Sonnetのeffortを上げたくなったら、それはモデルを切り替えるべきだというサインだ。effortのドキュメントもこれを裏付けている。Opus 5に対するAnthropicのガイダンスは、4.xの時代の「xhighから始める」という考え方から離れ、highから始めてlowやmediumを主要なコストコントロールとして使う方向に転じている。
これをワークフローに組み込むなら、実践的な関連記事として私のモデル選択ガイドとコンテキストウィンドウの解説がある。より広くClaude Codeの概要も参考になる。
実際にみんなどうしているか:Opusが計画し、Sonnetが実行する
開発者にどちらを選んだか尋ねると、多くはその問いそのものを拒否する。最初の1週間で最も支配的だったパターンは、2つのモデルによるパイプラインだ。
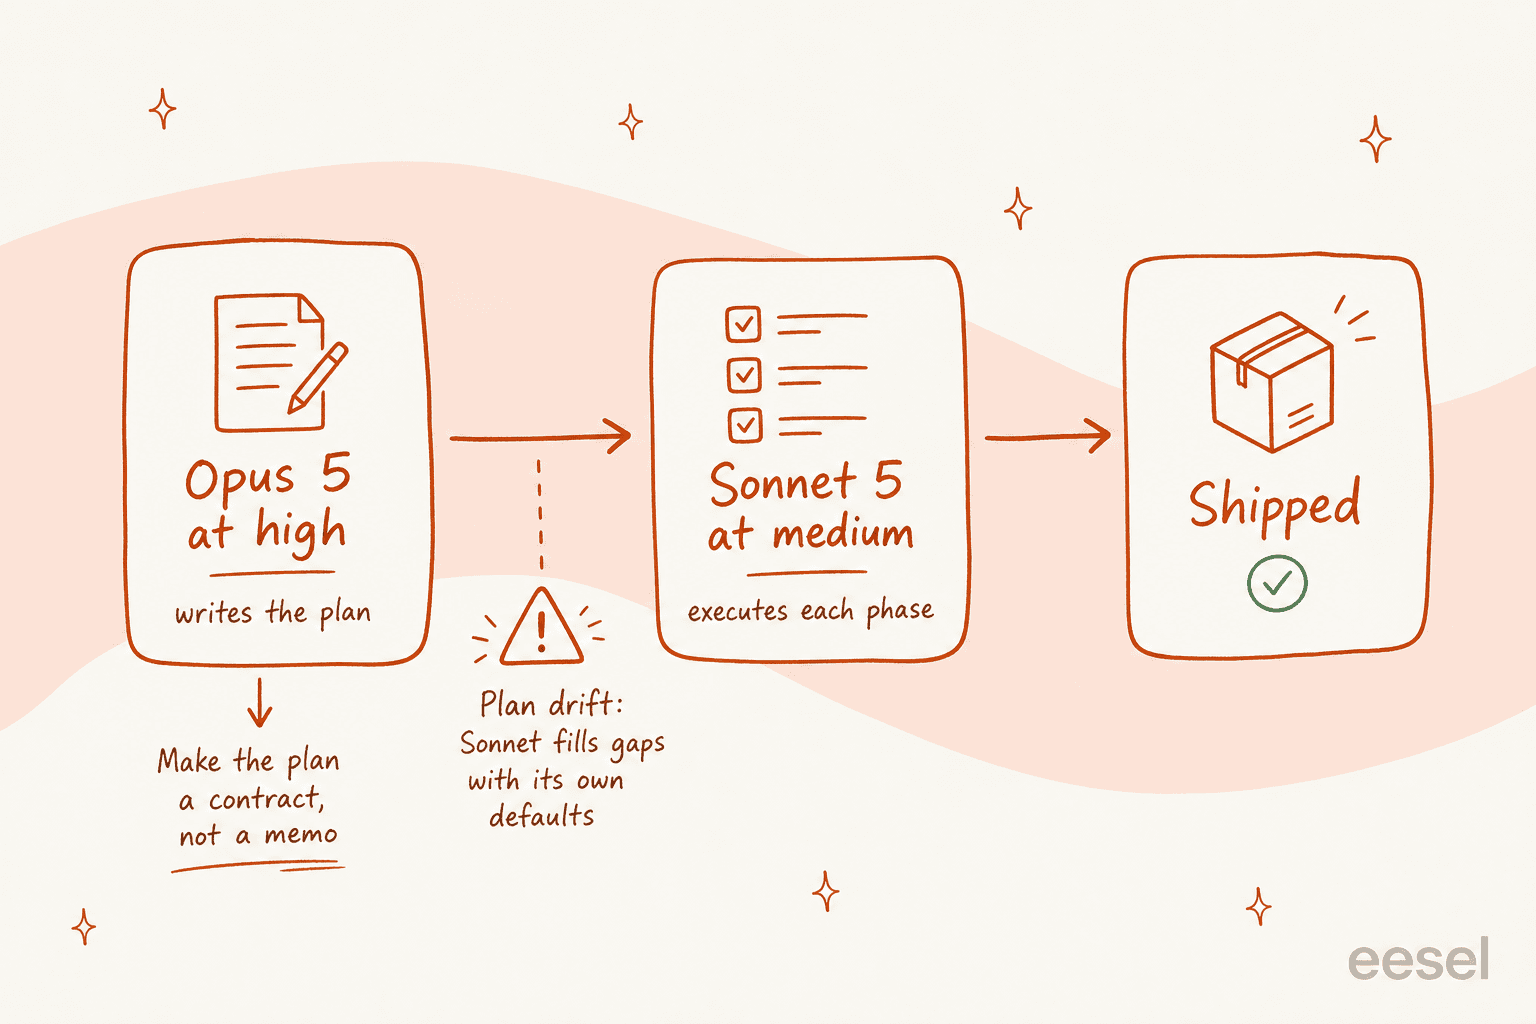
これは、Opus 5に対する最もよくある不満であるプラン制限の消耗に対する解決策も兼ねている。
"Control which subagents get spawned on your workflows. Opus 5 is spawning Opus 5 (most probably) and eating up your usage. Get a grip of the promo and use Opus 5 to orchestrate and Sonnet 5 to implement and that's it."
この消耗は実在しており、繰り返し報告されている。$20プランのあるユーザーは、逆方向のスワップにも数字をつけている。「これまでSonnet 5にやらせていたのと同じ1つのことをやらせようとしたら、Proの使用上限の15%くらいを使ってしまった、というのは確かにある」。別のユーザーはその逆で、Maxクォータをまったく削れないとも言っている。だからプラン制限に関する報告は、確定した話ではなくワークロード依存として扱うべきだ。
このパターンには正直な失敗モードが1つあり、それには名前までついている。
"Sonnet 5 is great at following concrete specs but will fill in gaps with reasonable-sounding defaults that quietly diverge from what Opus intended."
ここでの修正はより良いモデルではなく、より厳密な仕様だ。そのスレッド内のある返信が言うように、実装が機械的になるほど詳細なプランであれば、どのモデルが動かしていてもずれは生じない。このパイプラインを正しく組み立てるなら、Claude Skillsとsubagentsがそのための入れ物であり、skillsとsubagentsの比較がどちらが何をするのかを整理している。
構築する前に知っておく価値のある、実際に起きているひとつの落とし穴がある。r/ClaudeCodeの開発者たちは、最近のClaude Codeバイナリの内部に、Opus 5に対してだけsubagentへの委任を思いとどまらせるハードコードされた指示があると報告しており、それはOpusが計画しSonnetが実装するという構成を静かに損なう可能性がある。自分のバージョンでルーティングが実際に起きているか検証しておく価値がある。MCPツールとClaude Codeのベストプラクティスに関する私のノートは、その周辺の仕組みをカバーしている。
Sonnet 5を公平に擁護すると
この記事のほとんどを、高い方のモデルがなぜしばしば安い方なのかの説明に費やしてきたので、もう一方の側にもきちんと分を与えたい。その主張には実質があるからだ。
"I daily drive Sonnet 5/medium because it gets most things right most of the time at first try, while costing a lot less than Fable.
Opus can give better results on architectural/concept tasks and I use it sparingly, but it still costs more than Sonnet 5. Opus 5 seems to achieve results very close to Fable 5 while costing less (keeps Opus 4.8 pricing IIUC), but still more than Sonnet 5 then."
Sonnet 5がはっきり勝つ場面が4つある。Anthropic自身のレイテンシ評価によれば速い方のモデルであり、これはユーザーの目の前で動くものにとって非常に重要だ。ClaudeのFreeとProのティアでは無料でデフォルトになっている。短く浅く高ボリュームな作業では実際に安く、これは本番トラフィックの大半を占める。そしてlowかmediumできちんと仕様の決まったタスクでは、品質の差が出力にほとんど表れないことが多い。
中間ティアはそもそも存在すべきではないと主張する一定の勢力もいて、Opus 5のローンチはその議論を先鋭化させた。
"Seeing Opus 5 vs Sonnet 5 or even Sol vs Terra, I really think it doesn't make sense having mid tier models, just train top tier and low tier, AI labs saves money and users have 1 less model to choose/try/discard, no?"
私はその意見には同意しない。理由は上で述べたルーティングのパターンにある。本番システムはマルチエージェントであり、単一の知能のはしごよりも直交した強みの方が勝る。とはいえこれは今も生きている議論であり、少数派の意見というわけでもない。Anthropicの外まで視野を広げたいなら、私のGPT-5.6 Solの代替案やKimi K3の代替案のまとめが最も近い競合をカバーしていて、Gemini 3.6 Flashレビューも同様だ。
では、どちらを使うべきか
選び方は好みではなく、仕事の内容で決まる。
| あなたの状況 | 選ぶモデル | Effort |
|---|---|---|
| 高ボリューム・浅い・仕様が固まったタスク | Sonnet 5 | lowまたはmedium |
| レイテンシが重要なユーザー向けの用途全般 | Sonnet 5 | lowまたはmedium |
| FreeプランまたはProプラン($20)を使っている | Sonnet 5 | medium |
| 無人で走らせるマルチステップのエージェント作業 | Opus 5 | high |
| 計画立案・アーキテクチャ設計・曖昧な問題 | Opus 5 | highまたはxhigh |
| 多数のファイルにまたがる長期的なリサーチ | Opus 5 | xhigh |
Sonnet 5のmediumで失敗したタスク | Opus 5 | high |
| コストを問わず絶対的な上限を求める場合 | Fable 5 | max |
明確に述べておきたい、2つの逆推奨がある。**Sonnet 5をmaxで動かしてはいけない。私が見つけたすべてのデータセットが同じ方向を指している。その設定では、Sonnet相当の結果にOpus相当の金額を払うことになる。そしてOpus 5をデフォルトでmaxにもしてはいけない。**ここに載せたどのグラフでも、それが最も高くつく設定であり、highやxhighはその何分の一かのコストでほとんどの相手に勝っている。
どちらもしっくり来ないなら、Claudeの代替案と私のベストAIエージェントまとめが、より広い市場をカバーしている。
モデルの周りのツールについては、ベストAIコーディングアシスタントがこれらのモデルが組み込まれるエディタをカバーしていて、エージェント型コーディングCLIがターミナル側の対になる記事だ。
コンシューマー向けティアの費用は、私のClaude Codeの価格とCoworkの価格の解説にまとまっている。Sonnetより下にはさらに安いティアがもう1つあり、それはClaude CodeにおけるHaikuで扱った。
モデルが実際に顧客対応をするなら
ここまでの話はすべて、effortダイヤルを握っているのがあなた自身であることを前提にしている。計画がサポートキューだとすると、その前提は崩れ、フレーミング全体が変わる。
顧客は、あなたが返金の質問をmediumでルーティングしたことなど気にしない。気にするのは、その答えが正しかったかどうかだ。そしてそれを決める2つの数字は、上のどのリーダーボードにも載っていない。エージェントが人間なしで解決するチケットの割合と、それがどれくらいの頻度で自信満々に間違ったことを言うか、だ。Anthropic自身のシステムカードは、Opus 5が全体としてはより正確でありながら、Opus 4.8よりもわずかに幻覚が多いと記しており、これはまさにサポートにおける幻覚の防止がモデルの問題ではなくプロダクトの問題になる、その典型的な形だ。
地味な作業は、どのClaudeを選んでも変わらない。まずはナレッジベースでの学習から始まる。そのあとに、確信度で返信をゲーティングし、解決率を、自動クローズされたスパムを数えるのではなく正直に追跡することが続く。
そして人間をループに残すこと、それにAIがいつ引き継ぐかを設計して、顧客が継ぎ目を感じないようにすることも重要になる。これらのどれも、APIキーと一緒には出荷されない。
残りについては実践的なガイドとして、私のチケットデフレクションの解説と引き継ぎのベストプラクティスがある。エージェントと人間のコスト比較もある。
この分野についてさらに詳しくは、テックサポート向けAIに関する私のノートにまとめている。
eeselを試す
もしサポートキューが目的地でここに来たのなら、Claude Opus 5 vs Sonnet 5への正直な答えは、その決断自体があなたの仕事であるべきではない、というものだ。eeselは、あなたに代わって基盤となるモデルを選び、切り替える。しかもライブの会話に触れる前に、あなたの過去のチケットに対してすべてのロールアウトをシミュレーションし、課金は解決件数ベースであってトークンベースではない。だからこの記事全体のテーマである、安いモデルが静かに大きな請求額を積み上げていくという失敗モードは、あなたのもとには決して届かない。

すでに運用しているヘルプデスクに接続し、あなたがすでに回答したチケットから学習する。実際の過去の会話に対して、それが何と答えていたかを、外部の誰かに一言も見られる前に確認できる。無料で試せる。