

2026年7月24日、Claude Opus 5が出荷された。価格は入力100万トークンあたり5ドル、出力100万トークンあたり25ドル。これはOpus 4.8とまったく同じで、多くの人を面食らわせた。続けてスペックシートの残りを手短に。モデルIDはclaude-opus-5。コンテキストは1Mトークン、最大出力は128k、知識のカットオフは2026年5月あたり。Anthropicのドキュメントは今、まずここから始めることを勧め、本当に上限が必要な場合にだけFable 5にステップアップするよう案内している。
ほとんどの記事はその次のポイントを飛ばしている。「Claude Opus 5」は1つのモデルではなく、実質5つのモデルだ。effortパラメータはlowからmaxまで動き、Artificial Analysisはそれぞれの設定を別々のエントリとしてベンチマークしている。これは実態に即していて理にかなっている。長期にわたる知識労働で497 Eloポイントもの差が生じる。出力トークン数は下から上まででおよそ8倍。だからオンラインでOpus 5が「ばかばかしいほど安い」のか「トークンを食い尽くす化け物」なのかが議論になるとき、実際に論争されているのは、その5つのうちどれをたまたま誰かが動かしたかという話でしかない。
早めに触れておくべき制約がひとつある。私自身、ほぼ毎週この壁にぶつかる。このモデルはmax effortで最初のトークンを出すまでに63秒かかる。バックグラウンドワーカー。これがこのモデルの本来のカテゴリだ。ライブチャットの画面に置いたら、その待ち時間だけで会話は終わってしまう。長年eeselで実際のサポートキューにAIエージェントを載せてきた経験から、何度も学び直しているのは、モデルはこの仕事のいちばん難しい部分ではないということだ。
Claude Opus 5とは実際には何なのか
約2ヶ月の間にAnthropicはClaude 5世代のリリースを4回出しており、Opus 5はその4番目だ。Opus 4.8の真上に位置づけられ、価格は動いていない。ローンチの謳い文句は「半額でClaude Fable 5のフロンティア級の知性に迫る」というものだ。ローンチ時のうたい文句としては珍しく、独立系のベンチマーク数値はおおむねそれを裏付けている。
以下はモデル概要ページから拾ったスペックだ。
| スペック | Claude Opus 5 |
|---|---|
| Claude APIモデルID | claude-opus-5 |
| AWS Bedrock ID | anthropic.claude-opus-5 |
| Google Cloud ID | claude-opus-5 |
| コンテキストウィンドウ | 1Mトークン、ベータヘッダー不要、長コンテキストの追加料金なし |
| 最大出力 | 同期128k、Batch APIでは300k |
| 価格 | 100万トークンあたり5ドル / 25ドル |
| アダプティブシンキング | あり、既定で有効 |
| effortレベル | low、medium、high、xhigh、max |
| 知識カットオフ | 2026年5月 |
| Web fetch | 非対応 |
| Priority Tier | 非対応 |
このうち2行は意外に思われることが多い。まず1Mコンテキストウィンドウは標準料金で提供されるため、90万トークンのリクエストも9千トークンのリクエストと同じレートで課金される。これは料金ドキュメントにも明記されている。次に、Priority Tierがまったく用意されていない点。Opus 4.8にはPriority Tierがあるため、キャパシティのコミットメントを結んでいる場合はこの部分だけ別途計画する必要がある。
このファミリーを最後に見たのが数リリース前だという場合、このペースの速さは頭に入れておく価値がある。私のOpus 4.5レビューはまだ数ヶ月前の記事だが、すでに別次元のツールのように読める。その間にOpus 4.6がどこかに挟まっている。
「Claude Opus 5」は1つの名前をまとった5つのモデル
この記事の他の部分はすべてこの1点によって見え方が変わってくるので、ここにしっかり時間をかけて説明したい。
effortパラメータは好みで軽くいじる品質スライダーではない。API全体の中で、コストとレイテンシ、そして出力品質にいちばん大きく影響するレバーであり、その両端の差は競合するモデル同士の差よりも大きい。
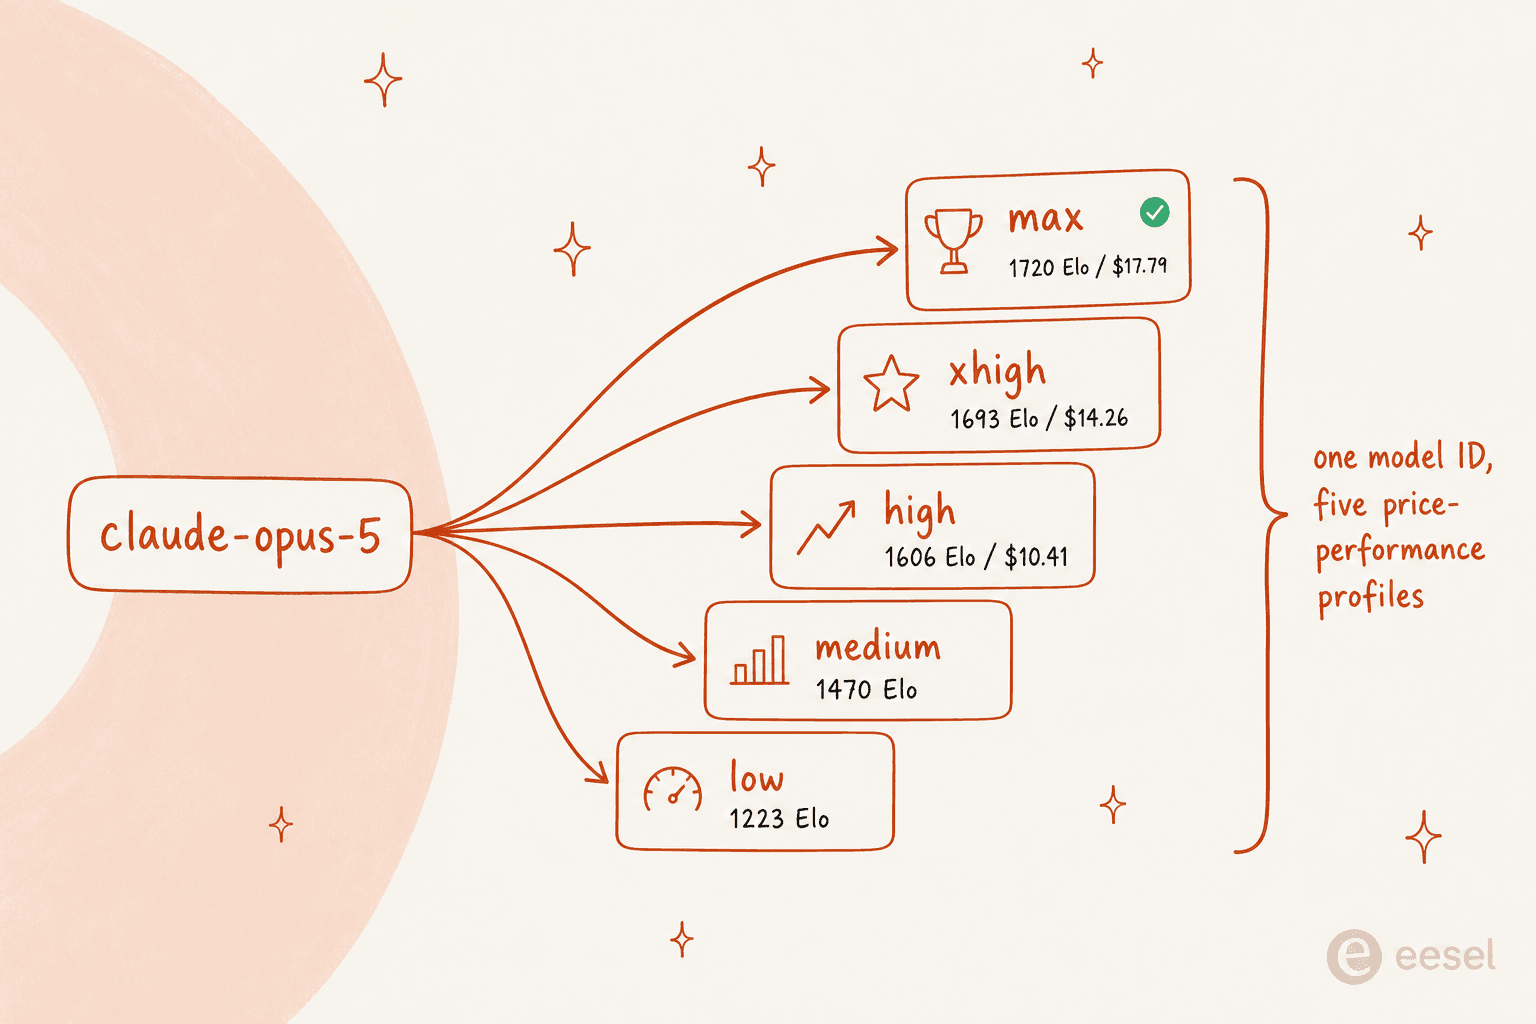
Artificial Analysisはすべての設定をAA-Briefcaseにかけて検証した。このベンチマークは、数千件のソースファイルを抱える数週間規模のプロジェクトを基にした、長期の知識労働を対象にしている。ここでの見どころはその差の広がり方だ。
| effort設定 | AA-Briefcase Elo | タスクあたりのコスト | タスクあたりの所要時間(分) | タスクあたりのターン数 |
|---|---|---|---|---|
max | 1720 | 17.79ドル | 36.2 | 103 |
xhigh | 1693 | 14.26ドル | 34.3 | 91 |
high | 1606 | 10.41ドル | 25.7 | 76 |
medium | 1470 | 未公開 | – | – |
low | 1223 | 未公開 | – | – |
| 参考: Claude Fable 5 | 1574 | 22.30ドル | – | – |
Fable 5の行をhighの行と並べて読むと、データセット全体で最もお得な組み合わせが浮かび上がる。high effortでは、Opus 5はFable 5を32 Elo上回り、しかもタスクあたり10.41ドルというFableの半額以下で実現している。ところが同じ行をlowと比べると1223で、GLM-5.2よりも低い。同じモデルID、同じ週の話で、しかもどちらも本当のことだ。
GDPval-AA v2でも同じ形が見られ、effortレベルは407 Eloポイントにわたって広がり、出力トークンの消費量はlowからmaxまでで約8倍になる。
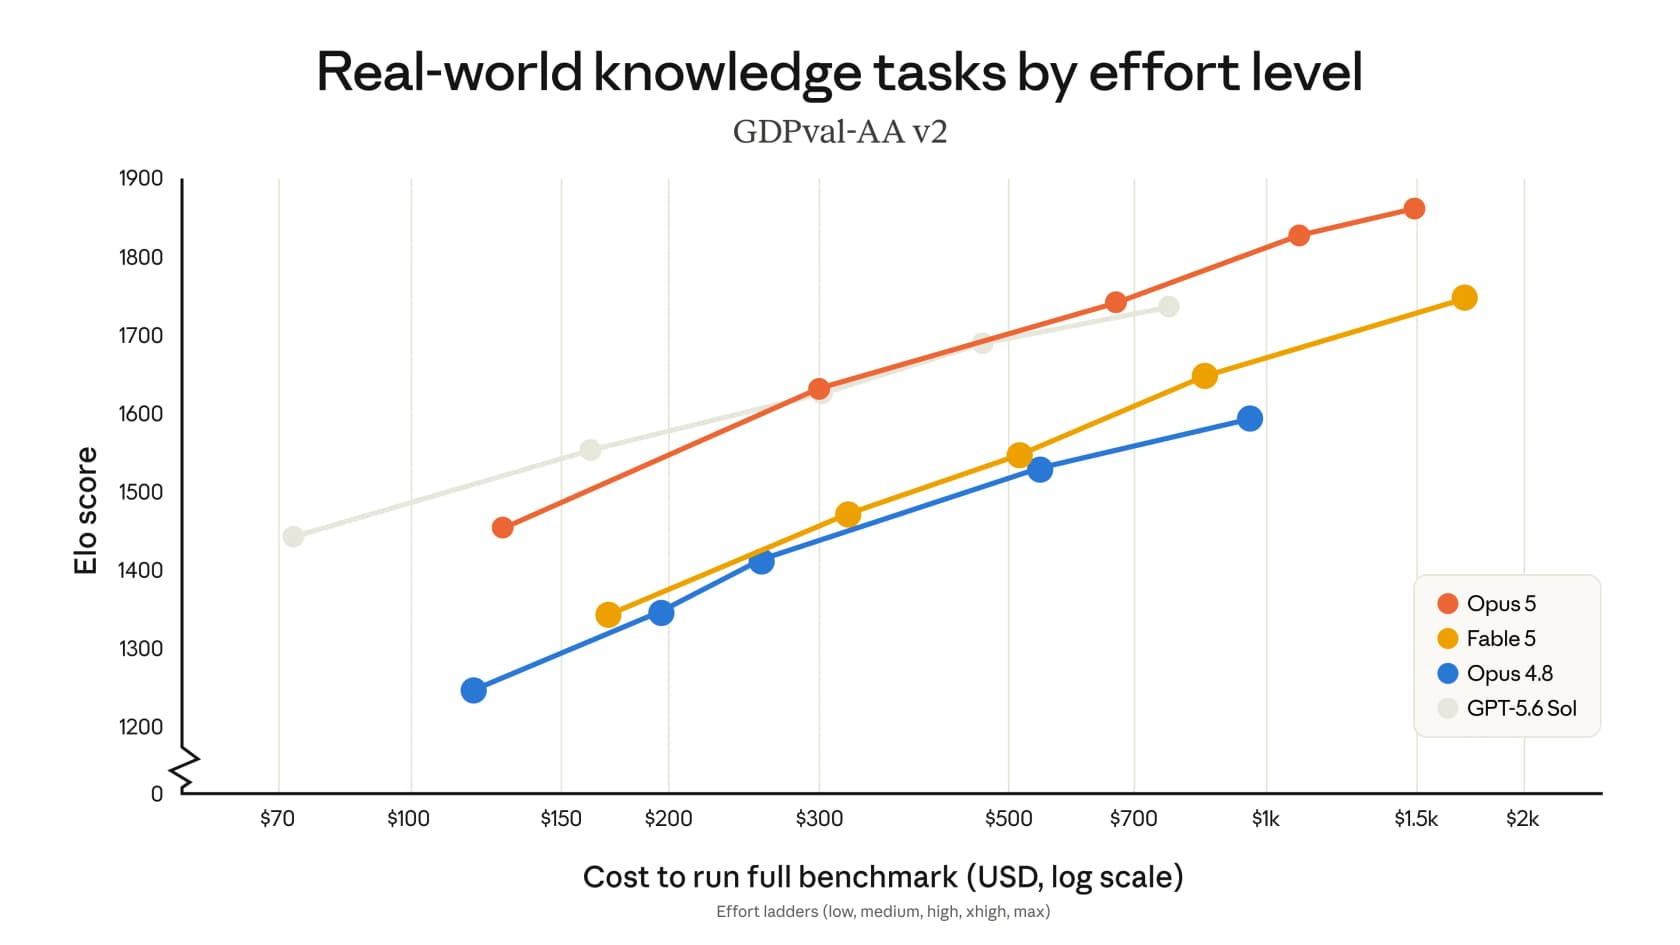
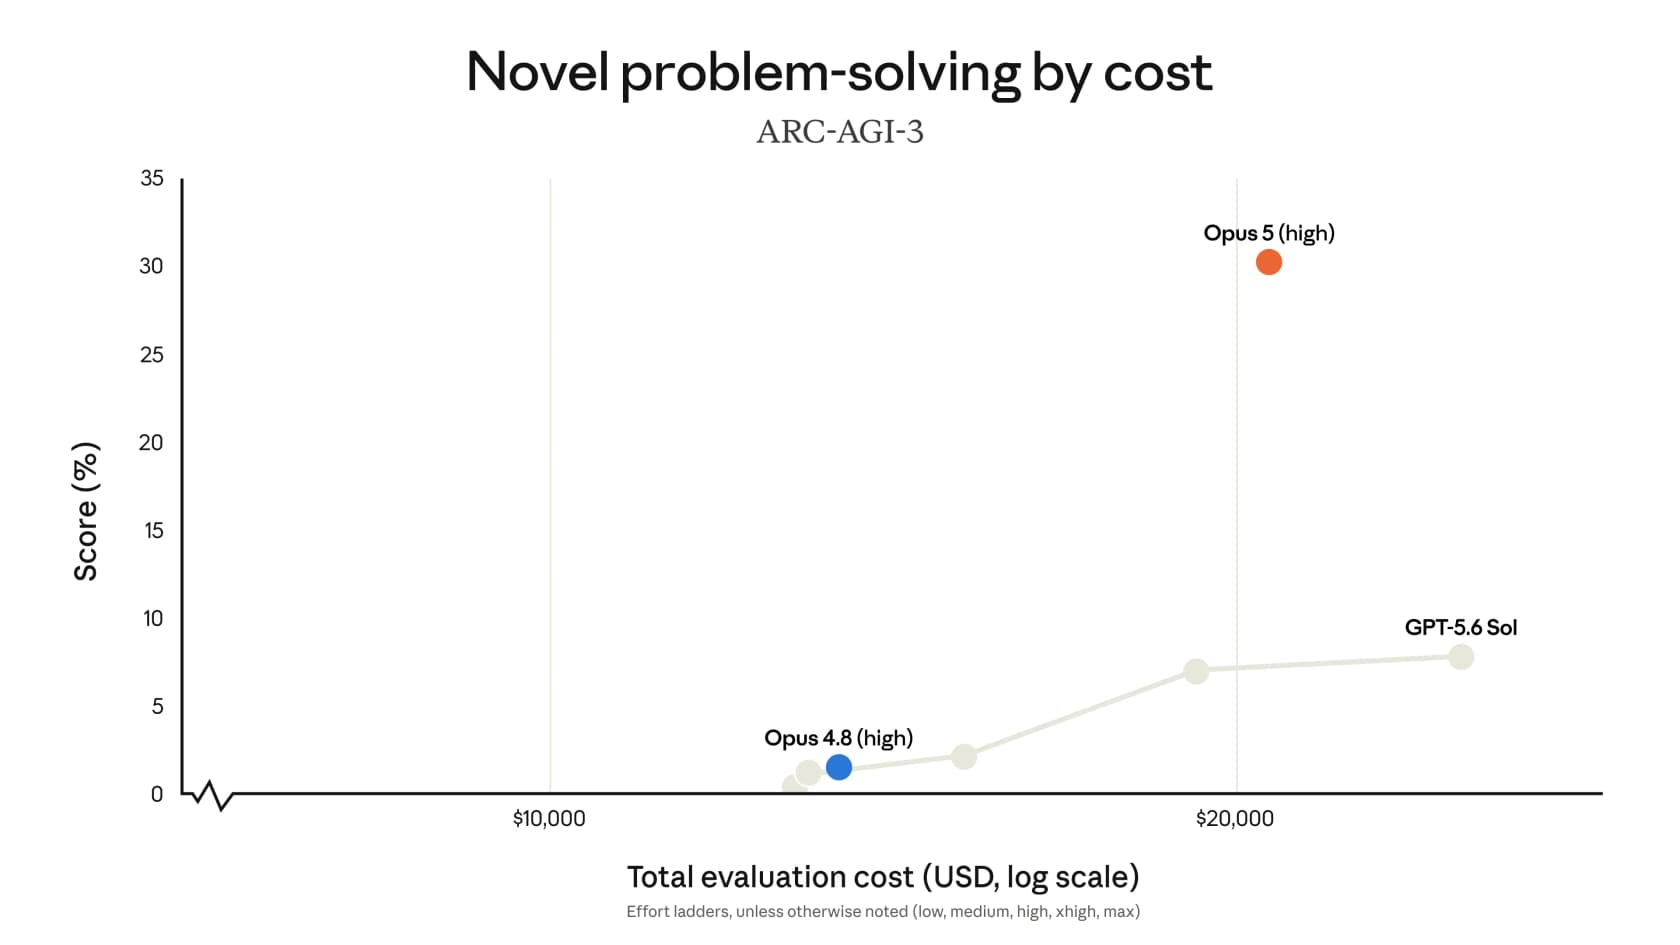
このチャートが認めていることにも注目してほしい。ラダーの安価な側では、GPT-5.6 SolがOpus 5の下ではなく上に位置している。タスクあたりで実際に高い金額を払って初めて、Anthropicの線が前に出る。ヘッドラインの単一ランキングだけでは、こうした細部はまったく見えない。
もうひとつ、今回のローンチでいちばん奇妙な数字がある。CognitionのFrontierCode 1.1では、Opus 5の最高スコアはmediumeffortで出ている。maxではない。Anthropicはシステムカードでその理由をはっきり説明していて、effortが高いほどモデルは「タスクが求める以上の変更を行ってしまう」ため、スコープ外の編集が採点で減点されるという。スコープを守るよう短い指示を加えると「ほとんどのタスクで性能が回復した」とのことだ。つまり、思考量を増やすことが単調に良くなるとは限らず、少なくともこの実コーディングベンチマークではむしろ悪化することもある。
effortレベルを選ぶ
上のテーブルまでスクロールし直す代わりに、同じ判断をピッカー形式で並べておく。自分が使おうとしていた設定を選び、それが何をもたらすかを見てほしい。
なぜ誰も「安いかどうか」で意見が一致しないのか
effortダイヤルが頭に入ってしまえば、ローンチ直後の混乱はまったく不思議に見えなくなる。
同じ48時間の中で、Redditでは互いに正反対のことを言う2つの人気スレッドが立った。ある陣営はトークン消費量が素晴らしいと投稿し、r/ClaudeCodeのある投稿者は8時間分の作業が週間クォータのわずか5%で済んだと報告している。もう一方の陣営は5時間の利用制限を10倍の速さで使い果たしていると投稿していて、以前は6時間かかっていた上限に2時間足らずで到達すると述べている。そして「結局どっちなんだ」と文字通りのタイトルが付いたスレッドには、この振れ幅を尋ねる人たちのコメントが150件以上ついた。
Hacker Newsの方がベンチマークの網羅的な検証よりも早く答えにたどり着いていた。
「あのチャートはmax effortを示していて、主に価格に鈍感なエンタープライズユーザーが使う設定だ。medium effortならK3のほぼ半分のコストに収まり、コーディングタスクの95%にはおそらくそれで十分だ。」

「mediumより上ではかなり考えすぎる。あれを使ってみるといい。」
その最初の原因の下にはもうひとつ別の原因があり、こちらはeffortパラメータをまったく触っていない人まで巻き込む。Opus 5では思考(thinking)が既定で有効になっており、Opus 4.8ではそうではなかった。つまり、何も変更していないリクエストが、以前はスキップしていた推論にトークンを費やすようになったということだ。ローンチから数時間のうちに、移行ノートの中でこれに気づいた人がいた。
「Opus 4.8との破壊的変更は興味深い。1. 思考が既定で有効: Claude Opus 4.8ではthinkingフィールドのないリクエストは思考なしで実行されるが、Claude Opus 5では同じリクエストがアダプティブシンキング付きで実行される。2. 思考の無効化はhigh effortまでに制限される」
つまり、両陣営とも本当のことを言っていたわけだ。ただ、同じモデルの異なる設定について話していただけで。それがこの論争の正体だ。
移行時に壊れる2つのこと
Anthropicは Opus 5を「同じ料金でのClaude Opus 4.8向けドロップイン・アップグレード」と呼んでおり、移行ガイドではちょうど2つの破壊的変更を挙げている。
**思考が既定で有効になった。**4.8では、thinkingフィールドのないリクエストは思考なしで実行されていたが、Opus 5では同じリクエストがアダプティブシンキング付きで実行される。そしてmax_tokensは推論を含む総出力を上限とするため、以前は軽量に動かしていたワークロードは、値を切り詰め始める前に上限を見直しておく必要がある。
思考の無効化はhighまでに制限される。thinking: {type: "disabled"}を送ること自体はまだ可能だが、それをxhighやmaxと組み合わせると400が返る。このチェックはリクエストごとに行われるため、思考をオフにしたまま会話の途中でeffortを上げようとすると、それまでのターンが問題なく通っていても拒否される。Anthropicはまた、思考がオフの状態では、モデルが「ツール呼び出しをプレーンテキストとして出力したり、内部のXMLタグを可視出力に含めたりすることがある」とも警告している。
アップグレードの残りの部分はおおむね良い話で、意識して有効にする価値のある要素がいくつかある。
- **プロンプトキャッシュの最低ラインが512トークンまで下がった。**Opus 4.8の1,024トークン、Opus 4.6の4,096トークンから下がっており、以前はキャッシュ対象にできなかった短いシステムプロンプトが、コードを変更しなくてもキャッシュ可能になった。
- 会話途中でのツール変更が
mid-conversation-tool-changes-2026-07-01ベータヘッダーの背後で利用可能になり、ターンとターンの間でツールを追加・削除できるようになった。これを行っても、それまでのターンのキャッシュヒットは失われない。 fallbacksパラメータは、サイバー分類器の拒否をエラーとして返す代わりにOpus 4.8に振り分けるもので、リクエストが「ブロックされるのではなく、既定で最も適した利用可能なモデルへ常にルーティングされる」ようにする。ただし利用範囲には制約があり、Batch APIでは使えず、Bedrockでも使えず、Google CloudやMicrosoft Foundryでも使えない。- Opus 5には専用のレートリミットバケットがある。レートリミットのページには、Opus 4.xの統合プールには含まれないと明記されており、このバケットは1,000 RPM、1分あたり200万入力トークンとされている。
見落としやすいプロンプト面の変更点が2つある。Anthropicは、以前から引き継いでいる検証指示は取り除くよう勧めている。「Claude Opus 5は指示されなくても自分の作業を検証する」からだ。また、サブエージェントの生成にも上限を設けるよう勧めていて、このモデルは前世代よりも気軽にタスクを委譲する傾向があるという。Claude Codeはその2点目を真剣に受け止め、Opus 5にサブエージェントを使わないよう指示するハードコードされた命令を出荷するに至った。HNでの反応は、予想通り賛否に分かれた。
どこで先んじていて、どこでそうでないか
見出しの数字自体は本物だ。Intelligence Indexでは、Artificial AnalysisはOpus 5をmax effortで61と評価し、クラス中央値32に対して第1位としている。ただ、興奮する前に次点を見てほしい。Fable 5が60、GPT-5.6 Solが59、Kimi K3が57、そしてOpus 4.8が56だ。Artificial Analysis自身の言葉を借りれば、Opus 5は「わずかな差で最も知的なモデル」であり、フロンティア全体がわずか5ポイントの帯の中に収まっている。
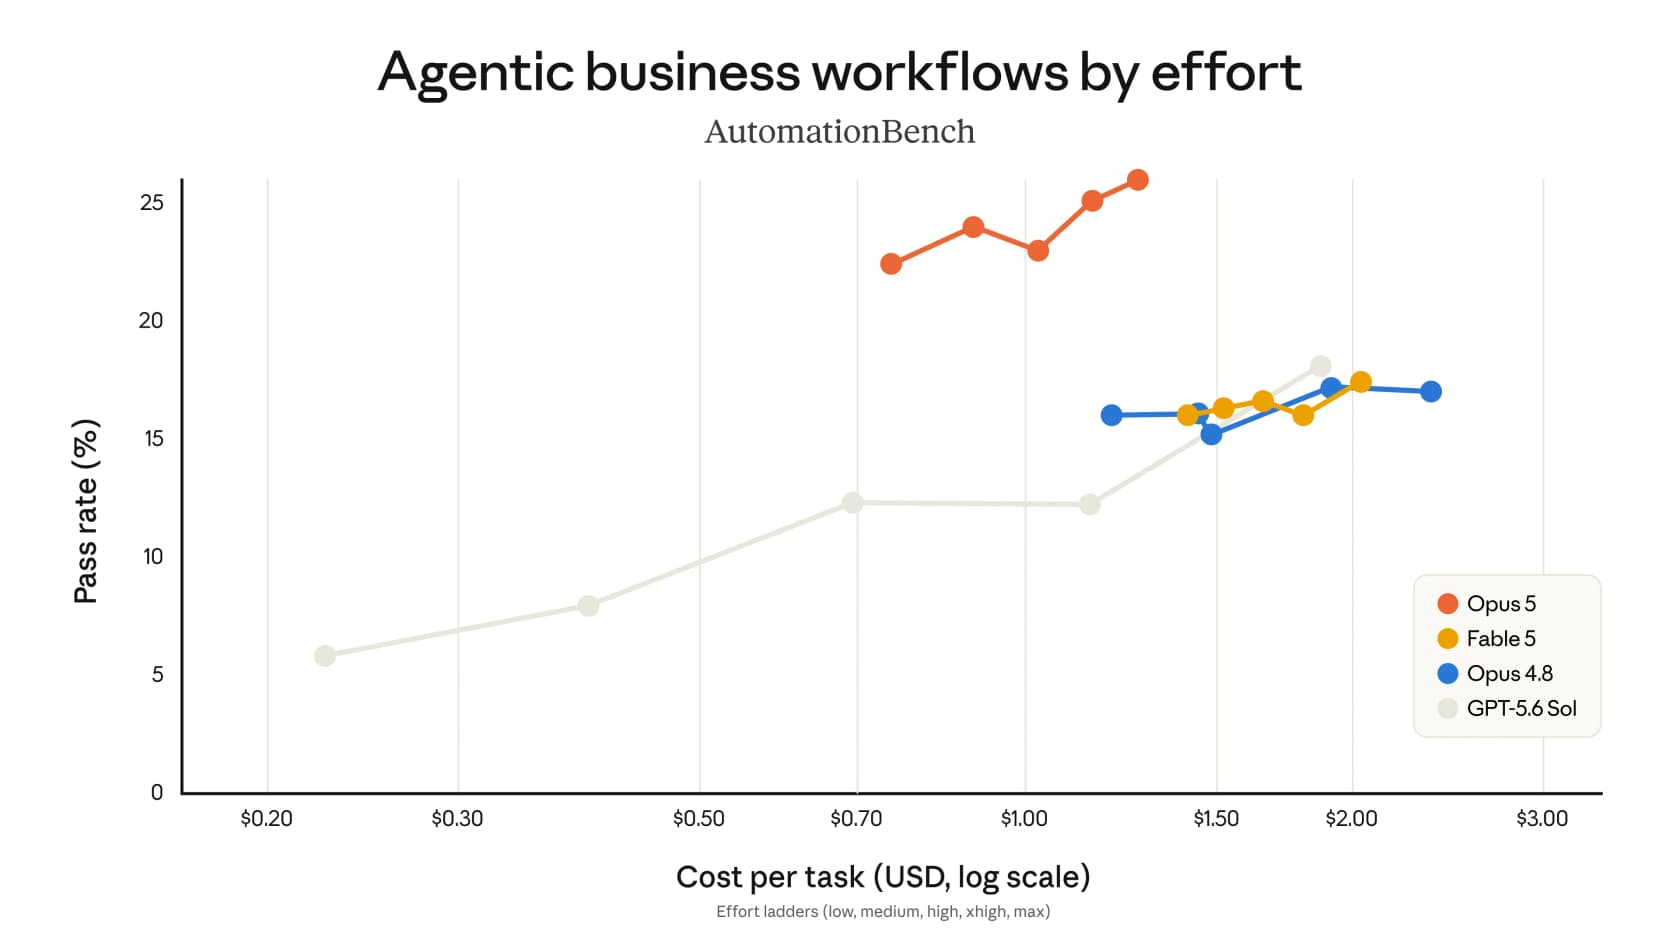
大差のある明白な勝利がまとまって存在する場所はひとつだけで、それはエージェント型の作業だ。ZapierのAutomationBenchは、47個のアプリにまたがる数十のREST APIエンドポイントを持つシミュレートされた企業にエージェントを送り込むもので、そこでOpus 5は26.0%のスコアを出し、Opus 4.8の17.0、Fable 5の17.4、GPT-5.6 Solの18.1を上回っている。
もうひとつの本物の飛び抜けた結果はARC-AGI-3で、Relative Human Action Efficiencyが30.16%となり、GPT-5.6 Solの7.78%を大きく上回った。そしてこの記事の論旨にとって重要な点として、このスコアが出たのはhigheffortであり、maxではない。
ここからは正直に、もう片方の側面を見てみよう。Artificial AnalysisはHumanity's Last Examで53%と計測し、これは「Fable 5と同水準」、つまり勝利ではなく引き分けだ。フロンティア物理学のCritPtではFable 5と並んでおり、OpenAIの3つのモデルの後塵を拝している。Terminal-Bench v2.1では89%を記録し、これは首位と「ほぼ同水準」。Anthropic自身も、生物学研究とオフェンシブなサイバーセキュリティの両分野では、Opus 5はMythos 5に後れを取っていると述べている。
さらに、ついにデータが出そろったリーダーボードがある。ローンチ時点では、LMArenaにOpus 5のエントリはなく、人間がこのモデルをどう評価するかは誰にもわからなかった。8月初旬になり、ようやく一覧に載った。その答えは、Intelligence Indexが予測するものとは違っていた。
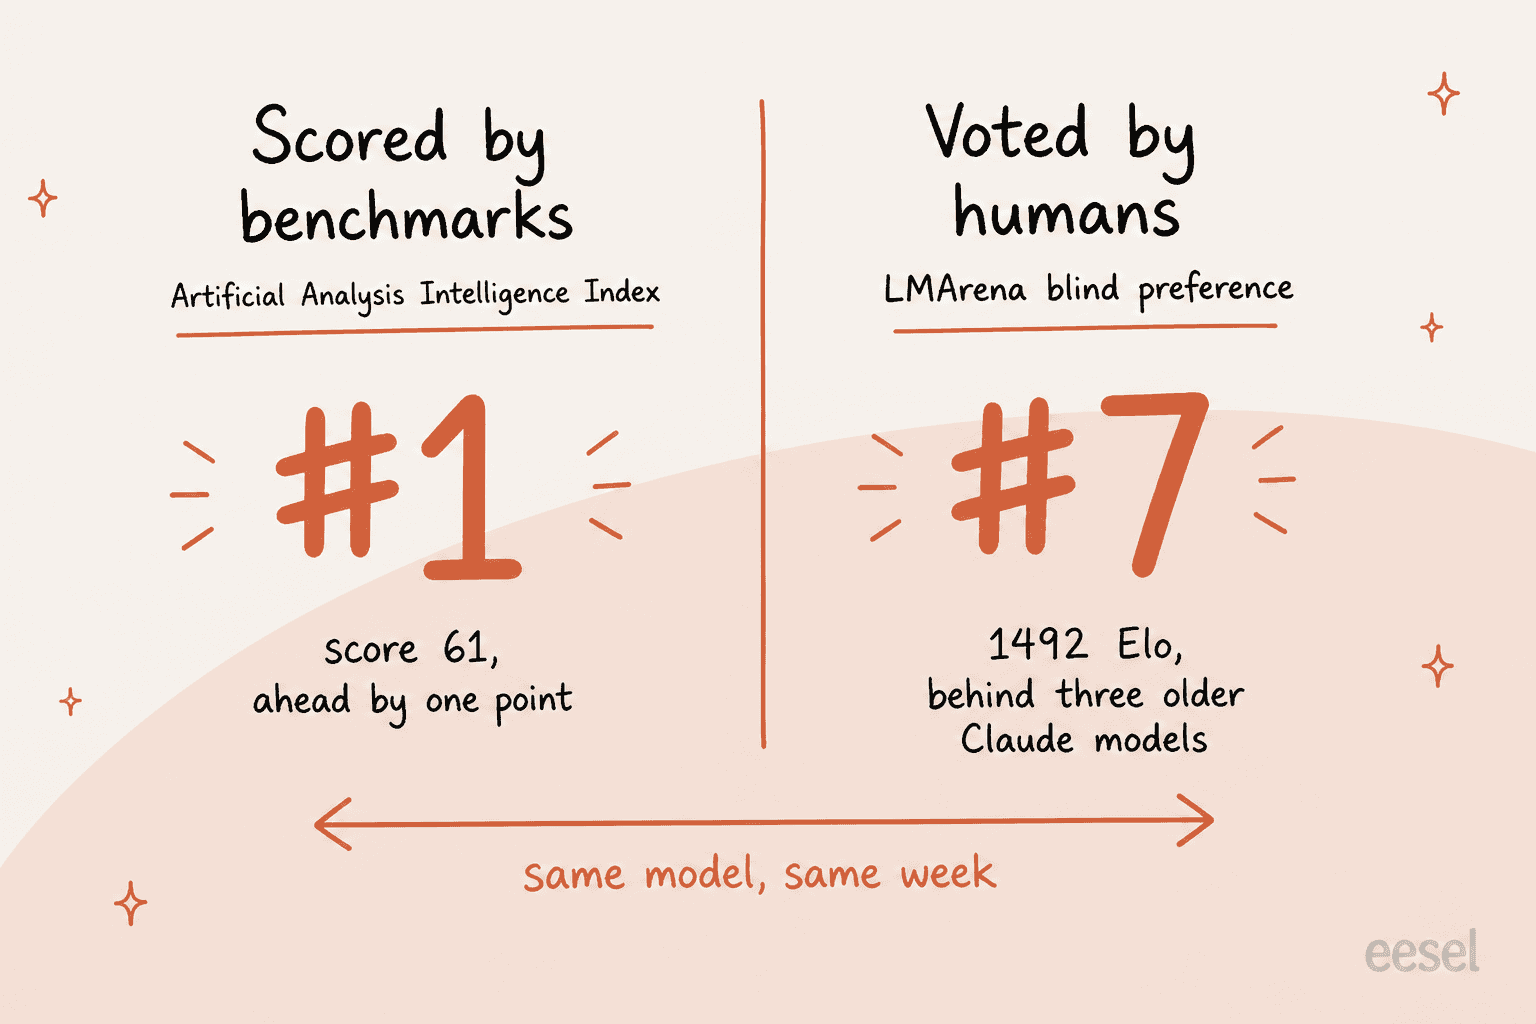
LMArenaのテキストリーダーボードでは、claude-opus-5-highは7位、1492 Eloに位置し、claude-opus-5-maxは8位、1490 Eloだ。この2つより上には、Fable 5が1509、そして旧世代のClaudeモデルが3つ並ぶ。タスク完了を測るベンチマークと、人間がどちらの回答を好んだか投票する評価は、まったく異なる2つのものを測っており、Opus 5はその差をくっきりと示している。コミュニティはそれをもっと平易な言葉で表現していた。
「Opus 5とFable 5の文章スタイルを比べてみたが、Opus 5は前身の4.8にあった『Claudeらしさ』を多く引き継いでいて、Fableはそこから抜け出していた。」
実際にどうやって手に入れるか
手に入れる方法は6通りあり、どれも同じものが手に入るわけではない。
| ルート | 手に入るもの | 補足 |
|---|---|---|
| Claude Free、0ドル | Opusはまったく使えない | SonnetとHaikuのみ、200kコンテキスト |
| Claude Pro、月20ドル | 利用可能な中で最も強力なモデルとしてのOpus 5 | 年払いなら月17ドル。Fableは利用クレジット経由 |
| Claude Max 5x、月100ドル | 既定モデルとしてのOpus 5 | Fableは週間上限の50%にキャップされる |
| Claude Max 20x、月200ドル | 同上、セッションあたりProの20倍の利用量 | メッセージ数ではなくセッション単位の上限 |
| Claude Team、シートあたり月25ドル | 4つすべてのモデルファミリー | 年払いならシートあたり月20ドル、2〜150名のチーム |
| Claude API | claude-opus-5、100万トークンあたり5ドル / 25ドル | Batchなら半額、キャッシュヒットは0.50ドル |
Claude Codeはすべての有料プランに付属し、同じプールから利用する。ピッカーがまだ4.8を出している場合は、/model claude-opus-5で直接切り替えられる。古いバージョンのCLIでは、/model claude-opus-5[1m]で1Mコンテキスト版が手に入る。もうひとつ知っておくべきなのは、Claude Codeが当初これに対して200Kのウィンドウしか公開していなかったという点だ。まさにこのためにあるのが私のClaude Codeのコンテキストウィンドウに関するノートだ。
クラウドプラットフォーム側では、BedrockとGoogle Cloudはパートナー運用となっており、それぞれが直接請求し、リージョンエンドポイントはグローバルエンドポイントに対して10%の割増料金がかかる。AWS上のClaude PlatformはClaude Consumption Unitで課金され、1CCUあたり0.01ドル。Microsoft Foundryも同様だ。トークン料金に加えて、Managed Agentsは稼働1セッション時間あたり0.08ドルが加算される。
Fast modeは、実際に条件が付いてくる唯一のルートだ。出力トークン/秒が最大2.5倍になる代わりに、価格はちょうど倍の10ドルと50ドルで、コンテキストウィンドウ全体に適用される。付帯条件としては、まだリサーチプレビュー段階であること、ファーストパーティのClaude APIのみ対応であること、ウェイトリストまたはアカウントマネージャーの背後に置かれていること、Batchでは動作しないことが挙げられる。トークンあたりで見ると、この料金は標準のFable 5と同じ水準に着地する。つまりここで買っているのはレイテンシであって、能力ではない。私のClaude Opus 5料金の内訳では、これが月間の請求額にどう影響するかを解説していて、Claude Codeの料金ではCLI側をカバーしている。
Opus 5と実際の顧客の間に立ちはだかる壁
ここまではすべて、どの設定を選ぶかという話だった。この章は、どの設定を選んでも解決しない場所についての話だ。
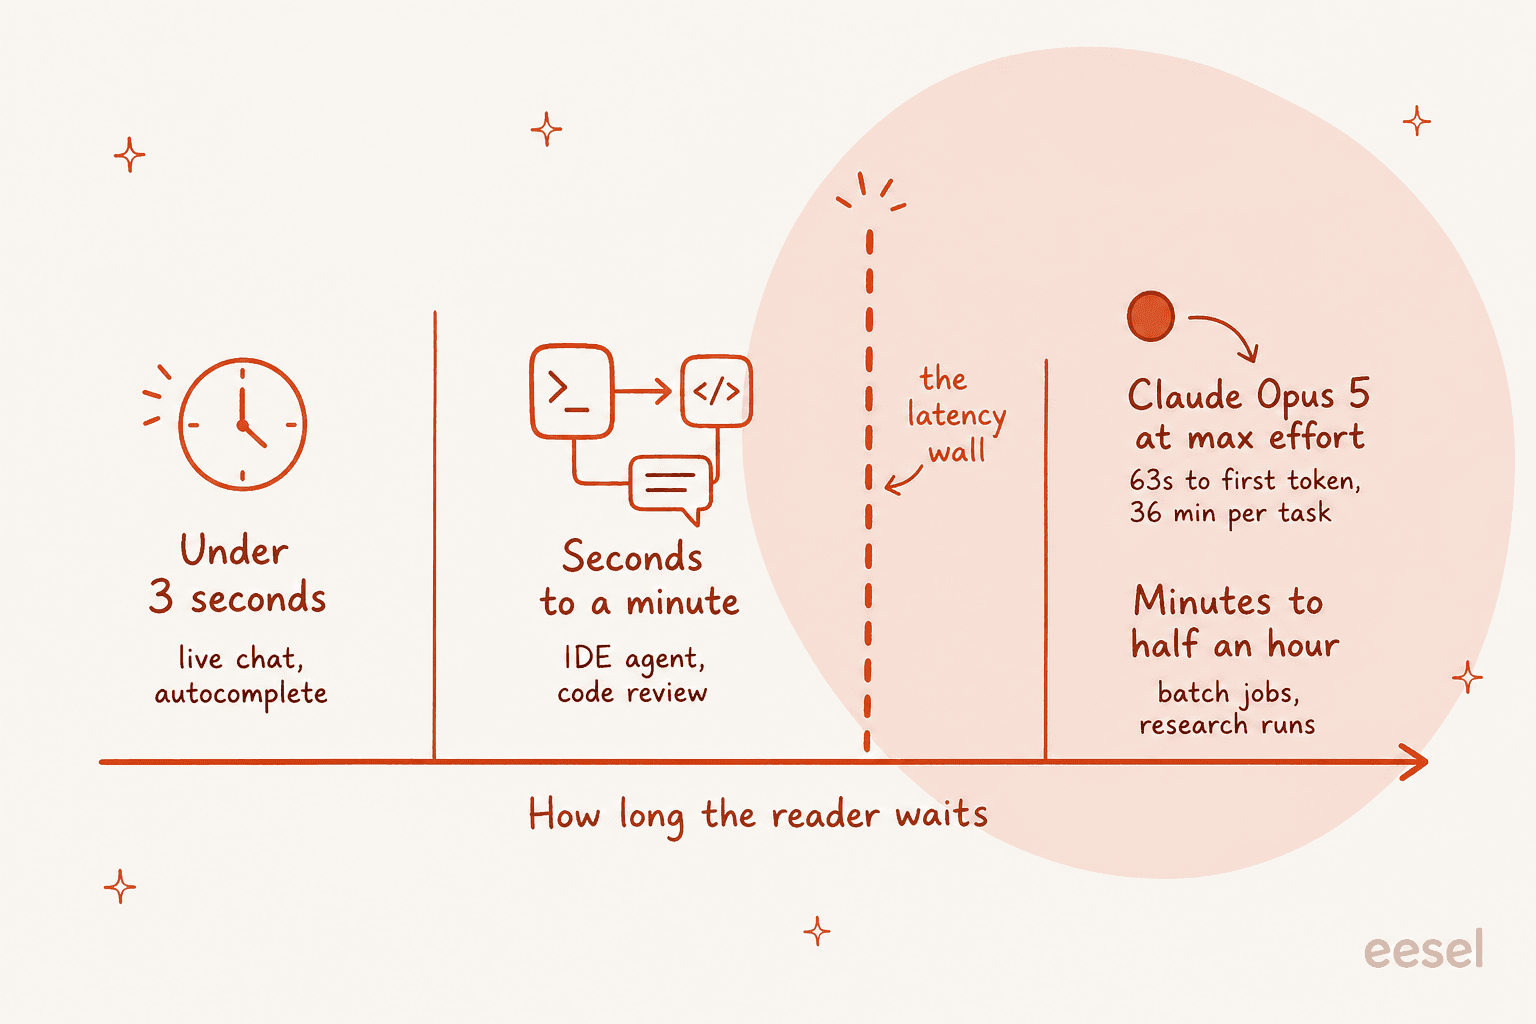
現時点でArtificial AnalysisはOpus 5を出力トークン/秒で55.7と計測しており、これは184モデル中111位。最初のトークンが出るまでの時間は63.43秒だ。effortを下げても速度はほとんど取り戻せない。AA-Briefcaseの上位3設定はすべて平均25分以上をタスクに要している。Artificial Analysisがこのモデルにつけた一言評は、「知性の面ではトップクラスに入るが、同価格帯の他のモデルと比べると特に高価。また、著しく遅く、非常に冗長でもある」というものだ。
もうひとつの数字の方が、私にとってはより気になるもので、マーケティングとは逆方向を指している。Opus 4.8と比べて、Opus 5はAA-Omniscienceで7ポイント精度が向上した一方で、ハルシネーション率は14ポイント上昇して50%になった。理由は、確信が持てない場面でもより頻繁に回答するようになったからだ。Anthropic自身のシステムカードもはっきりとこう述べている。「このモデルは全体としての精度は向上しているにもかかわらず、Opus 4.8よりわずかに事実面でのハルシネーションが多い」。
自分自身のテストを何度も回すコーディングエージェントにとっては、このトレードオフは問題ない。しかし同じトレードオフを、自社のロゴを付けて顧客に送るサポート回答に置いてみてほしい。そこで自信満々な誤答が出れば、それは顧客を失うレベルの失敗になる。だからこそ、サポートにおけるハルシネーションの防止は、モデル選定の問題ではなく、プロダクト設計の問題になってくる。
私はこの展開を何度も目にしてきたので、率直に言わせてもらう。実際に稼働するサポート導入のうち、モデルが占める割合はせいぜい10%程度だ。残りの90%は、常に最新の状態を保つナレッジリトリーバル、AIに触らせてよい範囲を決める確信度のしきい値、顧客が実際に見る前に解決率を把握できるようにする過去チケットへのシミュレーション実行、そしてコンテキストを取りこぼさない引き継ぎといった要素だ。ある暗号通貨ATMネットワークを運営するeeselの顧客が、自社構築か購入かという判断について、私よりも的確に言い表していた。
「自分たちで独自のLLMアプリケーションを作ろうとすることもできましたが、それに時間を投じたくはありませんでした。メンテナンスし続ける必要のないものが欲しかったのです。」
Karel, GENERAL BYTES
あるDTCサプリメントブランドのCXリードは、その後、私の中に何年も残り続けている一文でコントロールの問題を言い表した。AIは決して100%の質問に答えることはできないので、彼女が本当に必要としていたのは、AIが自信を持てるチケットだけを処理し、それ以外には手を出さないことだったという。effortパラメータはそれをもたらしてくれない。それはルーティングの判断であり、モデルの外側で行われるものだ。
eeselを試す
サポートキュー向けにモデルを選ぼうとしてここにたどり着いたのなら、正直なアドバイスはこうだ。Opus 5は優れたエンジンであり、そのエンジン自体がボトルネックになったことは一度もない。eeselは、そのエンジンを包み込む部分だ。すでに使っているヘルプデスクにそのまま組み込まれ、貼り付けたプロンプトではなく自社の過去チケットとヘルプセンターをもとに学習し、自社の実際のチケット履歴に対してシミュレーションを実行するので、顧客がエージェントを目にする前に解決率を確認できる。導入は四半期単位ではなく数分で済み、料金は解決したチケット数に基づくため、冗長なモデルが知らないうちに請求額を膨らませることもない。
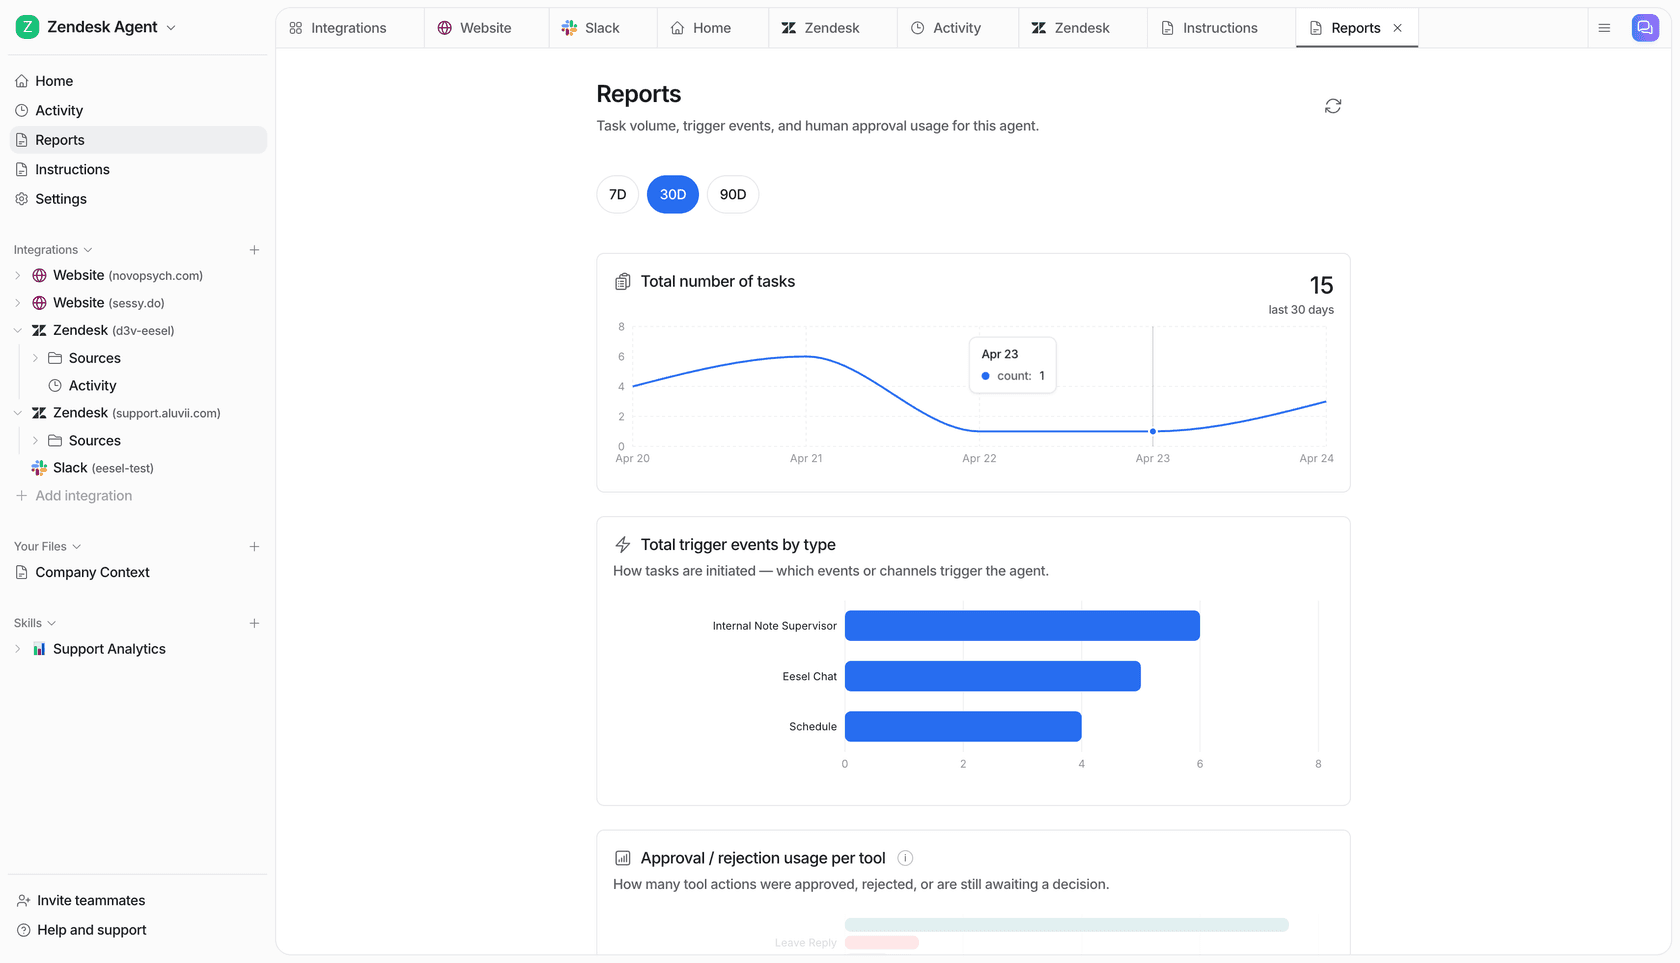
このレポート画面こそ、素のAPIキーだけでは決して手に入らない部分だ。エージェントが実際にどのチケットを対応したか、何がその実行のきっかけになったか、どの場面で人間が引き継いだか。自分自身の数値がどうなるかを見てみたい場合はeeselを試すことができる(無料)。あるいは、この判断が今年のサポートツールやAIサポートエージェントのコストの観点でどう変わるかを読んでみてほしい。
Opus 5に関する残りの全体像については、フルレビューにアップグレードすべきかどうかの結論を、Opus 5対Fable 5には一段上の階級、Opus 5対Sonnet 5には一段下の階級をまとめている。またSonnet 5の料金は今まさに重要で、その導入価格である2ドルと10ドルは2026年8月31日に終了する。
よくある質問
Claude Opus 5とは何ですか?
claude-opus-5で、1Mトークンのコンテキストウィンドウと128kの最大出力を持ち、価格は入力100万トークンあたり5ドル、出力100万トークンあたり25ドル。Anthropicのドキュメントでは、エージェント型コーディングやエンタープライズ用途はまずこのモデルから始め、上限が必要な場合のみFable 5にステップアップするよう案内している。私のOpus 5レビューに詳しい評価をまとめている。Claude Opus 5の料金はいくらですか?
Claude Opus 5はClaude Fable 5より優れていますか?
Claude Opus 5のeffortレベルの違いは何ですか?
low、medium、high、xhigh、maxだ。Artificial AnalysisのAA-Briefcaseでは、これらは497 Eloポイントもの差を生み、GDPval-AA v2では出力トークン消費量がlowからmaxまでで約8倍に広がる。API既定値はhighだ。Sonnet 5のような安価なモデルを検討する前に、まずeffortを主要なコスト管理手段として扱うべきだ。Opus 4.8からアップグレードする際、コードを変更する必要はありますか?
max_tokensの一部を使うようになる。さらに、thinking: disabledをxhighまたはmaxのeffortと組み合わせて渡すと400エラーが返る。それ以外はすべて同じ価格でそのまま置き換え可能だ。CLIで使っている場合は、私のClaude Codeモデル選択の記事にピッカー側の情報をまとめている。