Claude Fable 5.1の料金一覧
Claude Platformの料金ドキュメントから、料金表全体をそのまま掲載します。すべての数値は100万トークン(MTok)あたりのUSD表記です。
| メーター | Claude Fable 5.1 | Claude Fable 5(旧) |
|---|---|---|
| 基本入力 | $10 / MTok | $10 / MTok |
| 出力 | $50 / MTok | $50 / MTok |
| キャッシュ読み取り(ヒットとリフレッシュ) | $0.25 / MTok | $1 / MTok |
| 5分間キャッシュ書き込み | $12.50 / MTok | $12.50 / MTok |
| 1時間キャッシュ書き込み | $20 / MTok | $20 / MTok |
注目すべきパターンは、5つの数値のうち4つがFable 5と同一であることです。これは新しい価格ティアではなく、同じモデル料金表の1行だけが書き換えられたものです。つまりFable 5を基準に予算を組んでいた場合、入力と出力の計算はまったく変わりません。
計算する前に押さえておきたいことがもう一つあります。Fable 5.1はFable 5と同じトークナイザー(Opus 4.7で導入されたもの)を使用しています。Opus 4.7より古いモデルと比較すると、同じテキストでも約30%多くのトークンが生成されるため、4.7以前のモデルからのトークン推定値を調整なしに使い回してはいけません。
変わった唯一の数値:キャッシュ読み取り
一箇所だけ読むならこのセクションです。キャッシュ読み取り価格は100万トークンあたり$1から$0.25に下がり、75%のコストカットとなりました。
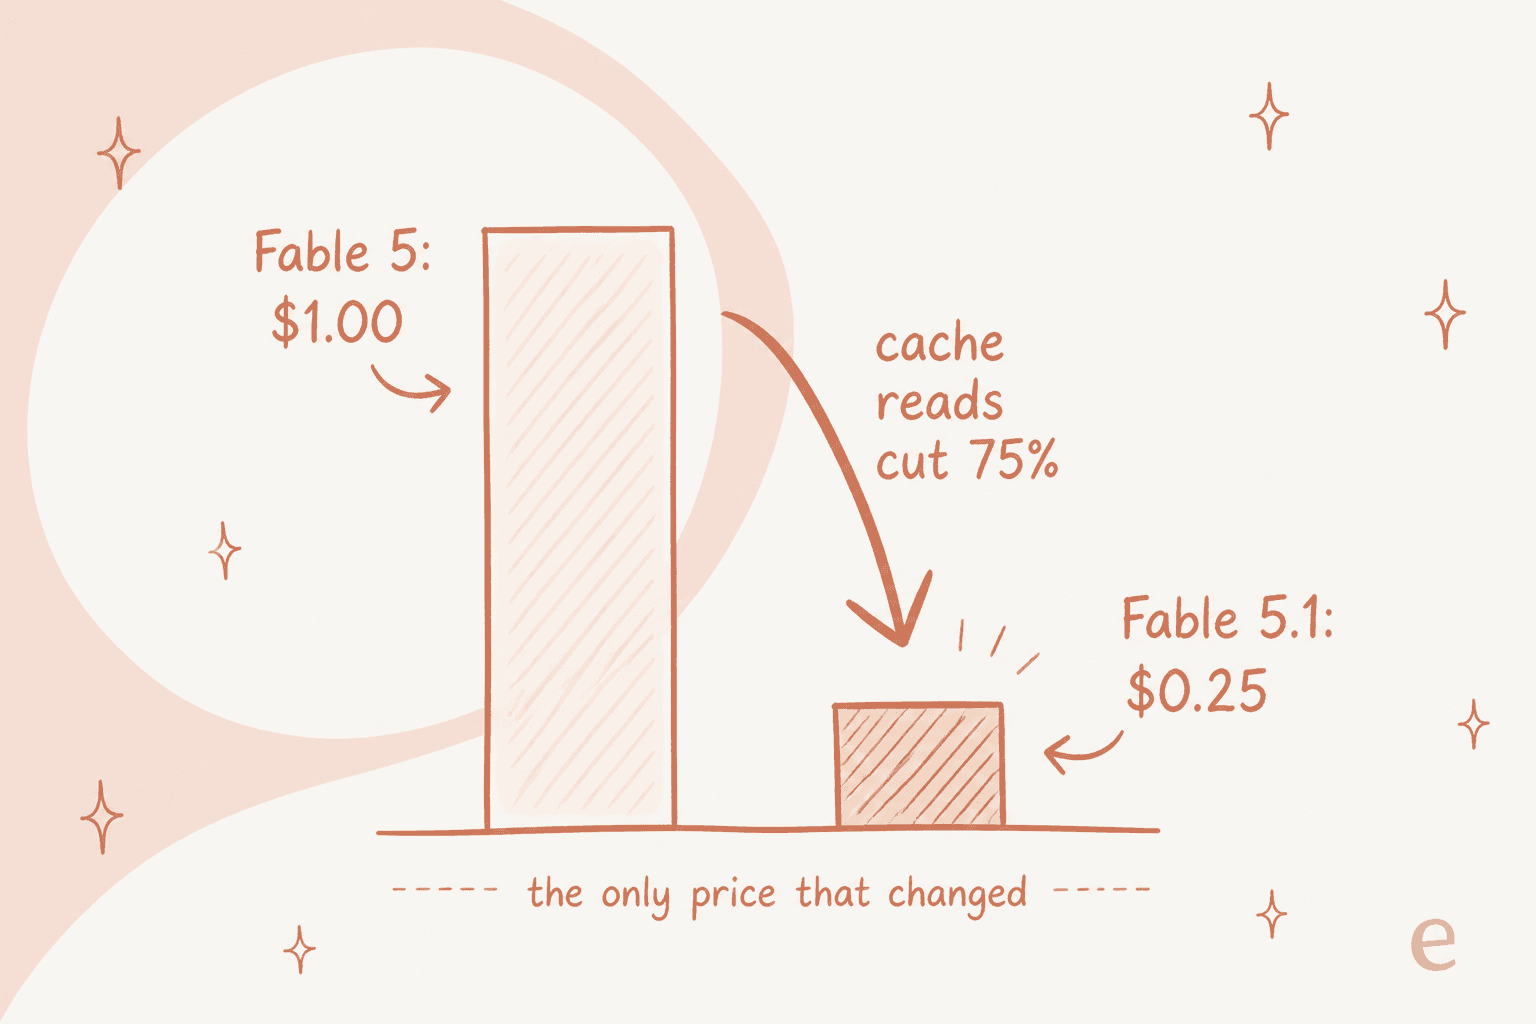
なぜこの一つのメーターがこれほど重要なのでしょうか。プロンプトキャッシュを使うと、プロンプトの一部(システムプロンプト、大きなドキュメント、ツール定義など)を一度保存し、以降の呼び出しでは毎回フルの入力価格を払う代わりに再読み込みできます。Fable 5.1では、キャッシュ読み取りは基本入力価格の0.025倍になりました。他のClaudeモデルでは0.1倍です。キャッシュ可能な最小長である512トークンは変わっていません。
これがエージェント的な作業にこれほど強く効く理由は、長時間動くエージェントがステップごとにコンテキストを再読み込みするからです。エージェントがタスクを終えるまでに40回のツール呼び出しを行うなら、そのキャッシュされたプレフィックスを40回読んでいることになります。その読み取り価格を4分の3カットすれば、見出しの$10/$50自体は変わらなくても、合計金額は大きく動きます。この変更はまさにFable 5.1が作られた目的の作業を報いるものです。
「実質的な節約」が本当に意味すること
Anthropicは2つの節約率を示していますが、これは1つの数値として扱うのではなく、注意深く読む価値があります。キャッシュ読み取りのコストカットにより、一般的なワークロードのコストは約25%、エージェント処理が多いワークロードのコストは最大45%、Fable 5と比較して下がるとされています。
これらの数値には2つの注意点があります。パーセンテージはその基準次第でしか意味を持たないからです。
- これらはFable 5と比較して測定されたものであり、Opus 5や競合他社と比較したものではありません。同一モデル内での比較です。
- これらは2026年8月の実際の使用4週間分、デフォルトのeffortで、Claude Enterprise、Claude Code、APIにわたって測定されました。キャッシュされたトークンと新規トークンの比率によって、この25〜45%のどこに落ち着くかが決まります。キャッシュをほとんど使わないワークロードでは、この効果もほとんど感じられません。
実際に運用している実践者たちも、おおよそ同じ傾向を報告しています。あるチームはマルチエージェントループを1週間運用した後、率直にこう述べています。
"One team ran Claude Fable 5.1 for 7 days straight on multi-agent coding loops and cut token spend 25%"
これはこの範囲の下限に近い数値で、キャッシュを最大限活用していないコーディングループとしては予想通りの結果です。
バッチ、米国限定、その他の項目
メインの料金表には含まれない2つの料金があり、特定のセットアップでは計算に影響します。
バッチ処理は標準料金から50%オフで、100万入力トークンあたり$5、出力100万トークンあたり$25です。レイテンシに敏感でない作業(夜間のドキュメント処理、一括分類、オフライン評価など)であれば、これは料金表全体で最も大きなレバーであり、非対話型のジョブに関してはキャッシュカットよりも効果が大きくなります。
米国限定推論は、データレジデンシー要件があるワークロード向けに提供され、入力・出力価格の1.1倍です。つまり、すべてのリクエストを米国内で実行する必要がある場合、100万トークンあたり入力$11/出力$55になります。
Claude Mythos 5.1は、安全対策が軽めの同じ基盤モデルで、Fable 5.1と同一料金です。より安価なティアではなく、Project Glasswingの参加者(審査を受けたサイバー防衛担当者や生命科学者)に限定されているため、ほとんどの人にとってはそもそも購入対象になりません。
Fable 5.1 対 Opus 5 対 Sonnet 5
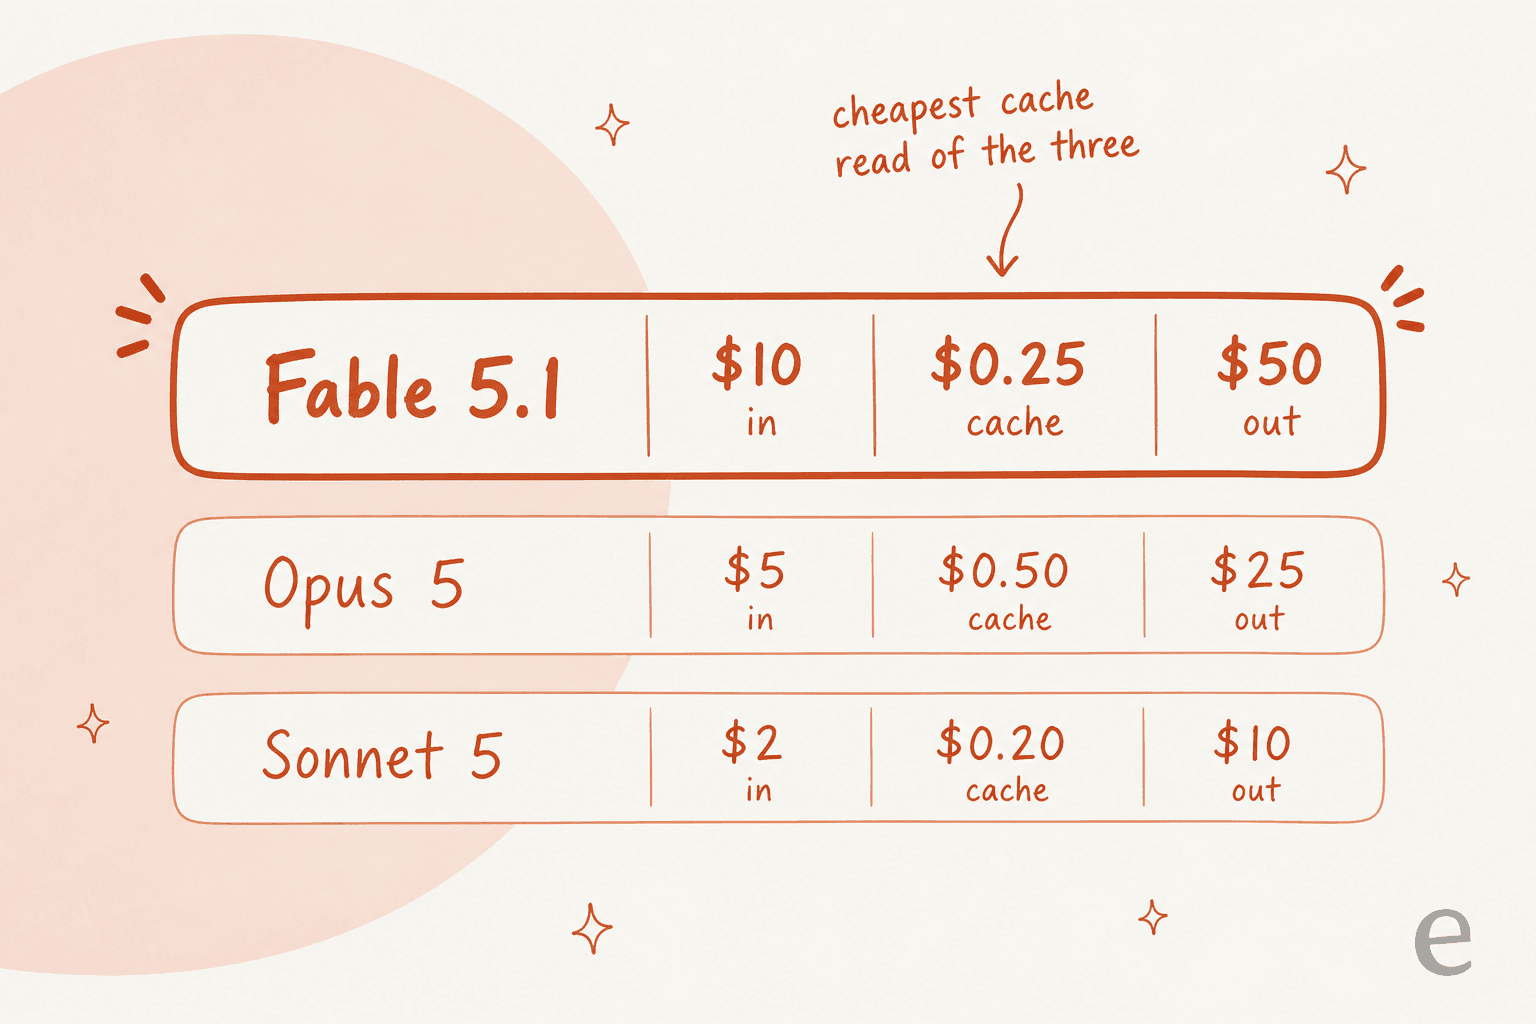
単一モデルだけを見て価格を判断すると、本当に重要な判断—どのClaudeにお金を払うべきか—が見えなくなります。プラットフォームの料金表から、現行モデルファミリーの100万トークンあたりのAPI料金を並べました。
| モデル | 入力 | キャッシュ読み取り | 出力 |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $10 |
直感に反する点は、Fable 5.1は基本の入力・出力においてClaudeの中で最も高価で、Opus 5の2倍、Sonnet 5の5倍でありながら、$0.25のキャッシュ読み取りは3モデル中最も安く、Opus 5の$0.50よりも下回っていることです。これは偶然ではありません。Anthropicは長時間のエージェントセッションが最も頻繁に使うメーターに価格を付けたため、ワークロードがエージェント的であるほど、この差はFableに有利に働きます。
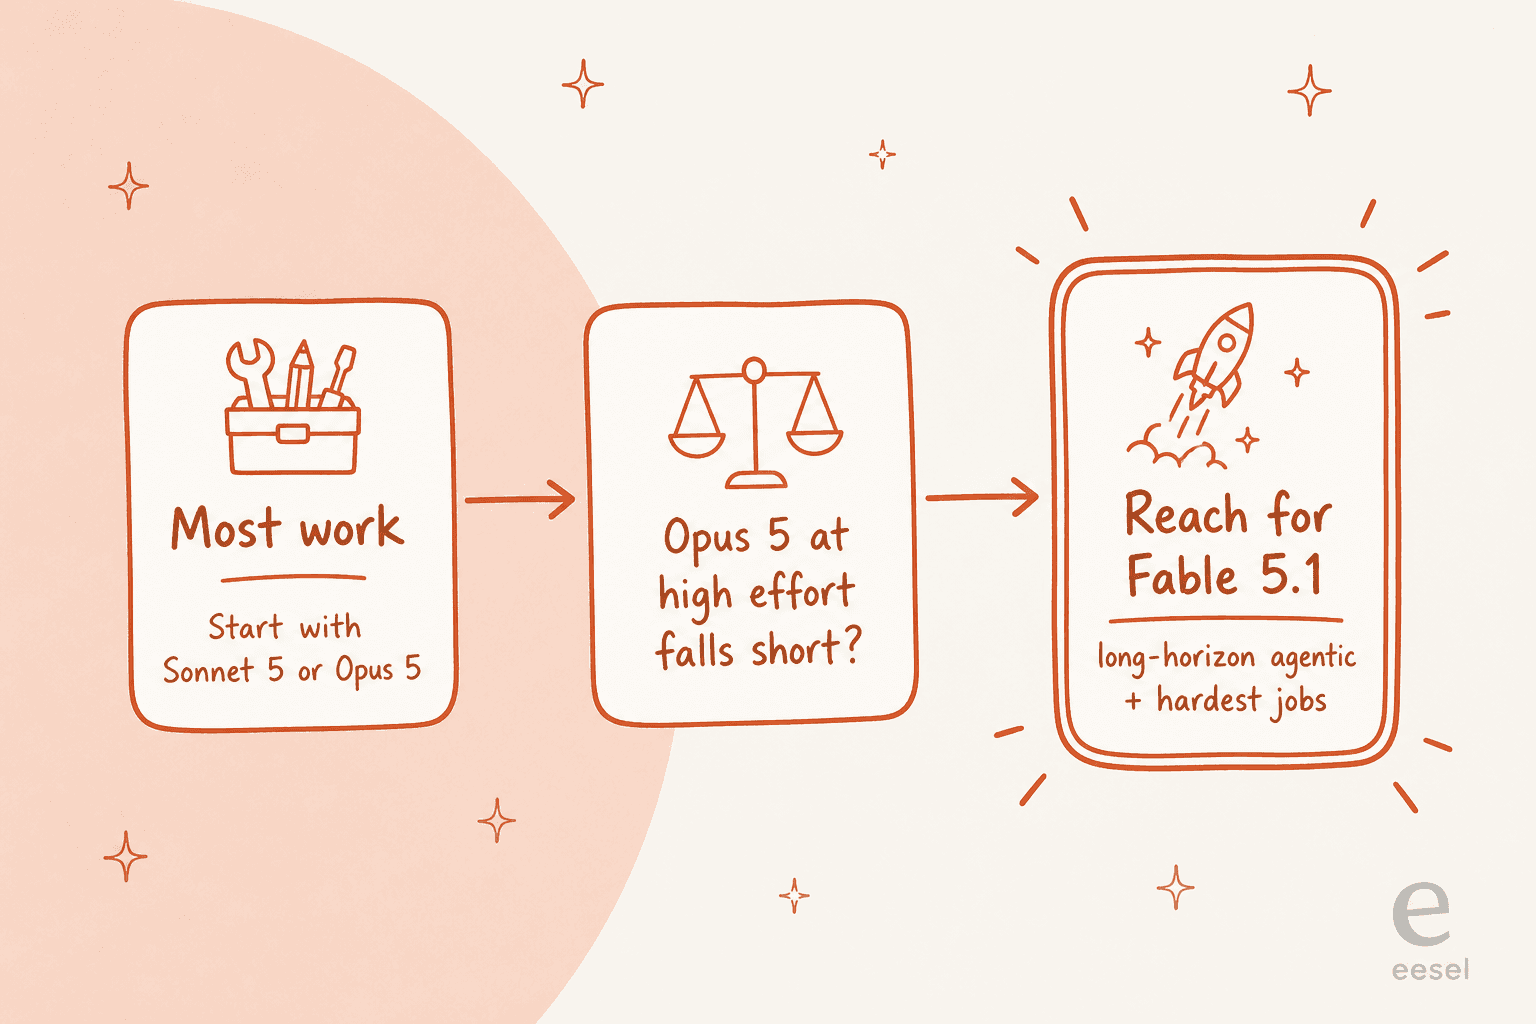
Anthropic自身のガイダンスは、いつFableに本当にお金を払うべきかについて驚くほど率直です。ドキュメントではほとんどのワークロードはOpus 5から始め、Opus 5をより高いeffortで使っても不十分な場合、あるいは最も野心的な長時間実行プロジェクトの場合にのみFable 5.1に手を伸ばすべきとしています。
少なくとも1人の開発者は、低effortでの計算単体でも説得力があると感じています。
"Fable 5.1 at low effort is often competitive with Opus and Sonnet on $ / task while scoring higher. on CursorBench 3.2.0, Fable 5.1 at low effort is at parity w/ Fable 5 at high effort at a third of the cost."
effortは、料金表を比較する際に多くの人が見落とすレバーです。effortが低いモデルは思考量が少なくトークン消費も少ないため、「高価な」モデルのタスクあたりコストが表示上のレートよりも低くなることがあります。Fable 5.1の適応的思考は常にオンで、effortパラメータによって制御され、デフォルトはhighです。
お金を払わなくていいもの
Claude Fable 5.1の料金の中で小さいながら実際に重要な部分は、以前は拒否のたびにお金がかかっていたものが今は無料になっていることです。
Fable 5.1は一部のリクエストに回答せず、安全対策用のモデルへ振り分けます。サイバー関連でフラグが立った問い合わせはOpus 4.8へ、生物学関連でフラグが立った問い合わせはOpus 5へフォールバックしますが、重要なのは、振り分けられたリクエストについてFableの料金は課金されないことです。また、拒否されたリクエストでモデルを切り替える際のプロンプトキャッシュコストを返金するフォールバッククレジットもあり、出力が一切生成される前に届く拒否については課金されません。
この課金の仕組みは重要です。なぜなら拒否は現に多くの不満の声が上がっているからです。開発者たちは自分自身のコードで誤検知に遭遇しています。
"Fable is useless. Me: "Find my security problems in my own code. This is code I own. I'm doing this under authorization of the CEO/CTO of our company." Fable: "yeah, no.""

Anthropicを公平に評価するなら、この点の方向性は悪化ではなく改善しています。Claude Codeのユーザーは、Fable 5と比較してセッションあたりのサイバー安全対策による介入が約60%減少すると見込まれ、Fable 5.1は防御的にソフトウェアの脆弱性を識別できるようになりました。予算にとって重要な点はもっと狭いところにあります。拒否は煩わしいものですが、少なくとも請求書には載らないということです。
プランごとの利用可否と呼び出せる場所
トークン料金表はAPIの話です。コンシューマー向けでは、Fable 5.1はPro、Max、Team、Enterpriseユーザーが利用できますが、無料プランでは使えません。月額サブスクリプションの正確な金額については、Anthropicはclaude.com/pricingを案内しており、これはProやMaxの数値を引用する前にライブで確認すべき正しい情報源です。これらは上記のAPI料金とは独立して変動するためです。
APIではなくサブスクリプションを使っている場合の注意点として、デフォルトのeffortは利用する場所によって異なります。Fable 5.1はClaude Codeでは高effortがデフォルトで、Claude CoworkとClaude.aiでは中effortがデフォルトです。effortが高いほどトークン消費が増えるため、MaxユーザーでもFable系モデルで利用制限にすぐ達すると報告される理由の一つになっています。
APIでは、claude-fable-5-1を主要な全プラットフォームで呼び出せます。Claude API直接、AWS上のAmazon BedrockおよびClaude Platform、Google Cloud Vertex AI、Microsoft Foundryです。どこから呼び出しても料金表は同じです。
Claude Fable 5.1のコストを見積もる
料金表は自分の数値を当てはめるまでは抽象的なままです。この計算ツールはトークン量と新規入力・キャッシュ入力の比率を受け取り、Fable 5.1料金での月額を、比較用のOpus 5とSonnet 5と並べて返します。すべてブラウザ内で実行され、どこにも送信されません。
キャッシュ率をいじってみると、5.1アップデートの本質がよくわかります。入力をより多くキャッシュ経由にすれば、Fableの合計は急速に下がります。それがまさにAnthropicが大幅に下げた唯一のメーターだからです。
モデルはインフラ、eeselはチームメイト
料金表が教えてくれないことがあります。トークン価格は問題を解決するコストではなく、原材料一つ分のコストにすぎません。Claude Fable 5.1はモデルです。実際に顧客のチケットを解決するものに変えるには、ヘルプドキュメント上の検索(リトリーバル)、返金ポリシーを自信満々に作り話しないためのガードレール、人間へのエスカレーション経路、そして実際の顧客に触れる前にテストする仕組みを自分で構築する必要があります。本当のコストとリスクはそこにあり、$10対$50の行にあるわけではありません。
そのギャップを埋めるのがeeselです。eeselはAIチームメイトのプラットフォームで、そのAIサポートチームメイトは仕事の進め方を最初から知った状態で導入されます。既存のヘルプデスクに接続し、過去のチケットとナレッジベースで学習し、新入社員のようにキューに加わります。モデルとグルーコードの山から自分で組み立てる必要はありません。そしてClaude Code、Codex、Cursorのようなコーディングエージェントがeesel CLIを通じて同じチームメイトを操作できるため、構築する自動化はダッシュボードの中に閉じ込められるのではなく、最初から最後までスクリプト化できます。
この料金表を全部読んだ人にとって重要なのは価格の違いです。トークン課金は設計上変動するもので、よくしゃべるエージェントの実行は寡黙なものより高くつき、それは事後にわかります。eeselは代わりに解決済みチケットごとに課金するため、裏側のモデルが何度コンテキストを再読み込みしようとも、サポート自動化は予測可能な費目のままです。実際の顧客に対応する前に、eeselを無料で試して、まずは自社の過去のチケットに対して実行し、解決率とコストを確認できます。
よくある質問
Claude Fable 5.1は100万トークンあたりいくらですか?
Claude Fable 5.1は無料で使えますか?
Claude Fable 5.1の料金がOpus 5やSonnet 5より高いのはなぜですか?
Claude Fable 5.1のキャッシュ読み取りの割引はどのくらいですか?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.