要点
Claude Fable 5.1はAnthropicの最も有能なモデルであり、自社のベンチマークでは首位に立つ。同時にこのリストの中で最も高額な、100万トークンあたり入力10ドル/出力50ドルでもあり、多くの作業にとっては必要以上のモデルだ。それこそが他の選択肢を検討する理由のすべてだ。
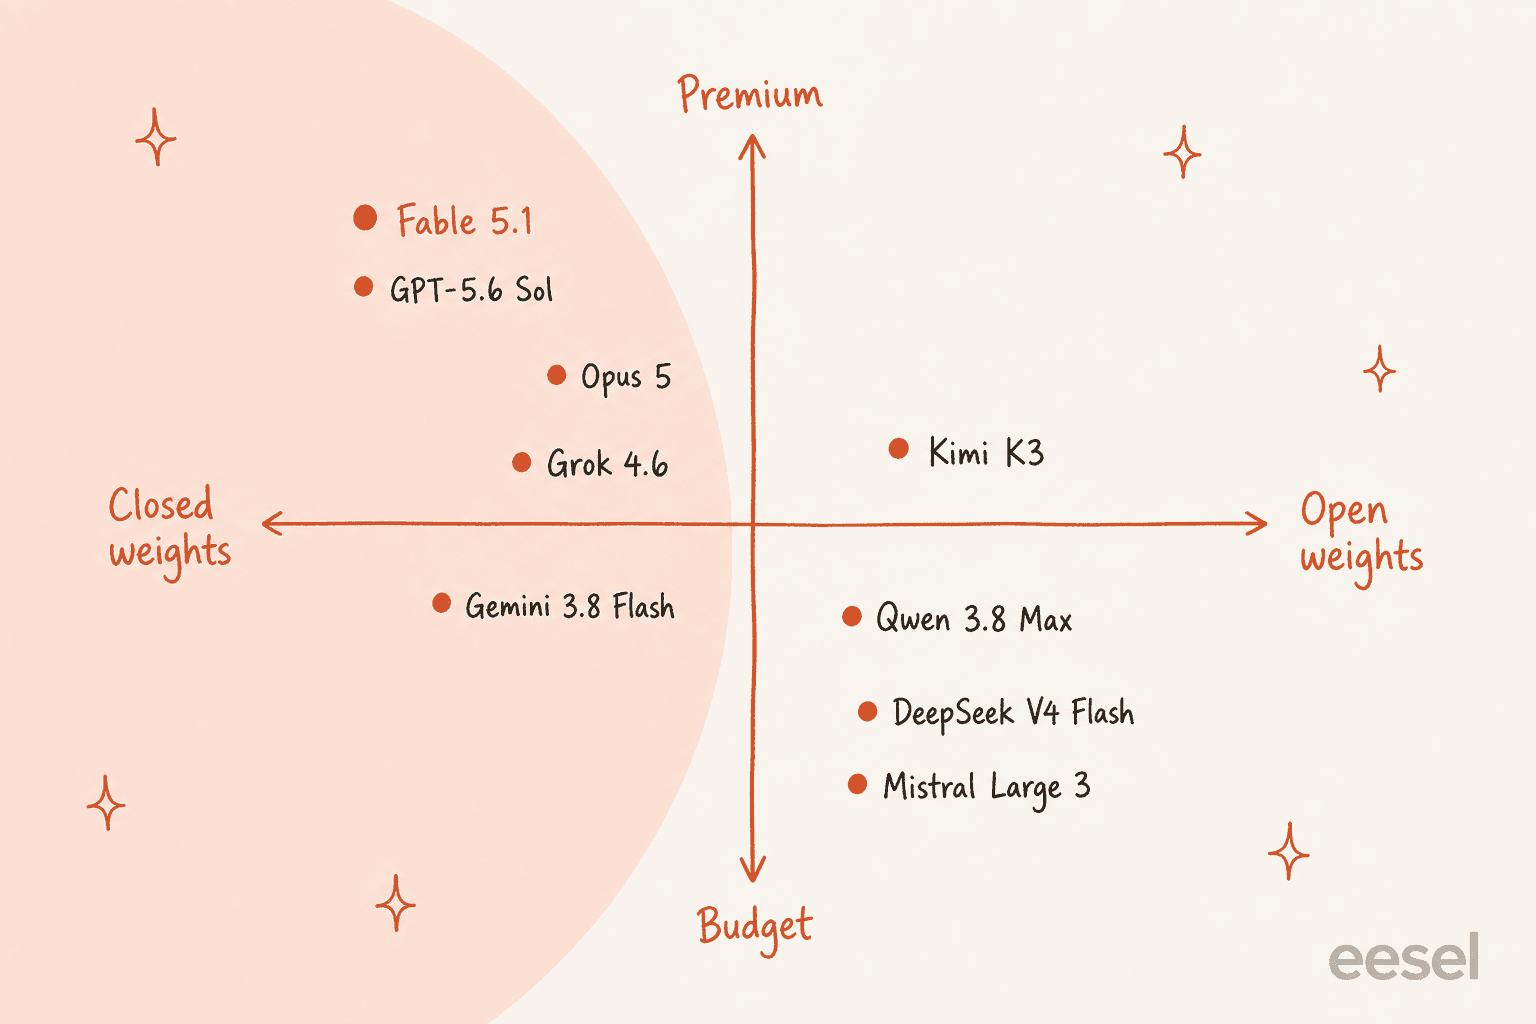
最も近い同等の乗り換え先を求めるなら、Anthropic自身のOpus 5が半額(5ドル/25ドル)で、そもそもAnthropicが最初に試すよう勧めているモデルだ。OpenAIやGoogleのスタックには、GPT-5.6 SolとGemini 3.8 Flashが対応する存在になる。オープンウェイトと低コストを求めるなら、Kimi K3、Qwen 3.8 Max、DeepSeek V4 Flashが、有能かつ安価から底値の予算まで幅広くカバーする。価格とおすすめを含む詳細な内訳は以下の通りだ。
ここで持っておくべき視点の転換がある。これらのどれも完成した働き手ではない。フロンティアモデルはエンジンだ。実際に欲しいのが仕事をこなすサポートエージェントやライターであれば、モデルは投資すべき層として間違っている。そのためにあるのがeeselのようなチームメイトプラットフォームだ。
そもそもFable 5.1以外を検討する理由
まずは現職に公平でありたい。Fable 5.1は強力なモデルだからだ。2026年9月1日にローンチし、Claude 5ファミリーの頂点に位置し、Anthropic自身の評価では公開されているすべてのベンチマークで首位に立つ。長期にわたるエージェント型作業や科学的作業で最大の飛躍を見せている。ウィンドウ全体で一律の料金体系による100万トークンのコンテキストウィンドウ、最大12万8千トークンの出力、常時オンの適応的思考を備える。2026年に行われた唯一の価格変更は良いものだった。キャッシュ読み取りが75%下がり、100万トークンあたり1ドルから0.25ドルになったことで、一般的なコストは約25%、エージェント作業が多い場合は最大45%削減される。
それでもなぜ人々は他を検討するのか。いくつかの具体的な理由が繰り返し挙げられている。
- 価格。 基本料金は依然として10ドル/50ドルで、このまとめの中で最も高い価格だ。あなたのワークロードがFableが作られた前提である長く複雑なマルチツールの種類でなければ、使わない余裕分に対して割高な料金を払っていることになる。
- 拒否。 Hacker Newsの複数の開発者が、自分自身のコードのセキュリティレビューを含め、誤検知による拒否を報告している。AnthropicはClaude CodeユーザーがFable 5と比べて約60%少ないサイバーセーフガードの介入を体験するはずだと述べているが、これは現在進行中の実際の不満だ。
- ウォーターマーク。 すべてのFable 5.1の出力には、EU AI法対応のための統計的テキストウォーターマークが付く。これは大半の人には問題ないが一部には信頼性の懸念であり、ローンチ時に最も注目を集めた点だ。
- 生のモデルが必要ないかもしれない。 これが大きな論点であり、後で改めて触れる。最終目標がサポートエージェントやコンテンツライターであれば、フロンティアモデルを購入しても、その周りに働き手を構築する作業は依然として必要だ。
eeselで実際のプロダクトにモデルを組み込む日々を過ごすエンジニアとして気づくのは、「どのモデルか」という問いは大抵、人々が省略した「どの層か」という問いの下流にあるということだ。詳しくはリストの後で述べる。
これらの代替をどう選んだか
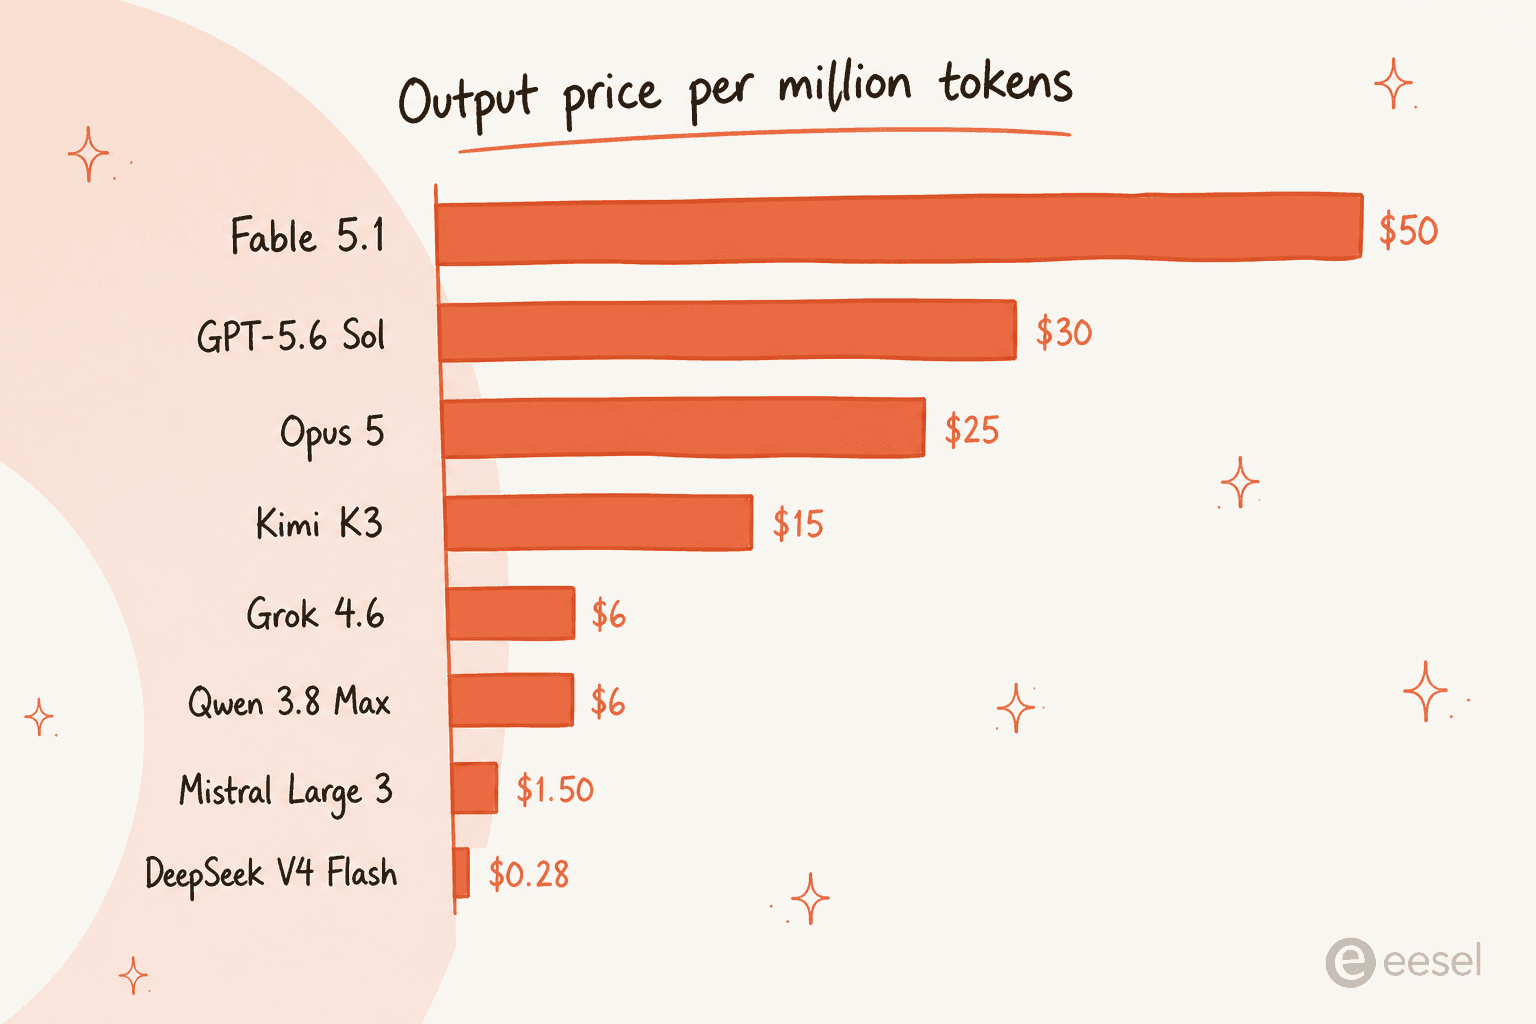
唯一の「最良の」モデルというものは存在しないため、このリストは実際に行っている作業別に構成されている。それぞれの選択肢について4つの点を検討した。実際に公開されている価格(マーケティング上の「〜から」ではなく基本料金)、存在する場合の独立系スコア(主にモデルに依存しないArtificial Analysis Intelligence Index)、ウェイトがオープンかどうか、そしてリーダーボードが隠す正直なトレードオフだ。ここに挙げたモデルはすべて、プレビューではなく今日実際に呼び出せる、一般利用可能な選択肢だ。
数字についての注記。価格は100万トークン(MTok)あたりで、入力と出力は別々に記載している。生成的な作業ではコストの大部分は出力にかかるためだ。すべての数字は各ベンダー自身の一次情報ページに基づいている。
2026年のClaude Fable 5.1の最良の代替8選
まずは一目で分かる短いリスト、その後に各モデルの詳細を示す。
| モデル | 最適な用途 | 価格(入力/出力、$/MTok) | コンテキスト | オープンウェイト? | Fable 5.1との比較 |
|---|---|---|---|---|---|
| Claude Opus 5 | デフォルトの乗り換え先 | 5ドル / 25ドル | 1M | いいえ | 半額、Anthropic推奨の出発点 |
| OpenAI GPT-5.6 Sol | OpenAIネイティブなスタック | 5ドル / 30ドル(短コンテキスト) | 400k | いいえ | 基本価格は安いが、20万を超えるロングコンテキスト帯は2倍の価格に |
| Google Gemini 3.8 Flash | 安価な高スループットのバッチ処理 | 0.75ドル / 3.75ドル | 1M | いいえ | 大幅に安いが、初回トークンまで13.3秒、2027年1月に価格倍増 |
| Kimi K3 | オープンウェイトのフラッグシップ | 3ドル / 15ドル | 1M | はい | ほぼ最上位のスコア、セルフホスト可能、Fableの半額の出力価格 |
| Qwen 3.8 Max | 多言語対応+人間による評価が高い | 2ドル / 6ドル | 1M | ベースウェイト | LMArena Textでトップ5、出力コストは5分の1 |
| DeepSeek V4 Flash | 低予算向けの選択肢 | 0.14ドル / 0.28ドル | 128k | はい(MIT) | 出力が約180倍安い、MITライセンス |
| xAI Grok 4.6 | リアルタイム+Xデータ | 2ドル / 6ドル(短コンテキスト) | 500k | いいえ | 基本価格は安いが、呼び出しごとの課金と20万トークンの壁がある |
| Mistral Large 3 | EUのデータレジデンシー、安価 | 0.50ドル / 1.50ドル | 256k | はい | 欧州のベンダー、ここではプレミアム帯で最も安い出力価格 |
1. Claude Opus 5
最適な用途: Fableクラスの請求額なしにFableクラスのClaudeを求めるすべての人。
Fable 5.1に対して最も誠実な代替は、Anthropic自身の製品ラインナップでその直下に位置するモデルだ。Opus 5は2026年7月24日にローンチし、100万トークンあたり5ドル/25ドルで動作する。Anthropicのガイダンスは異例にはっきりしている。多くの作業でまずOpus 5を使い、より高い努力レベルのOpus 5でも不十分な場合にのみFable 5.1に手を伸ばすようにと。これはベンダー自身が、安価なモデルこそデフォルトだと言っているということだ。
Fableの最良の構造的特徴を共有している。一律価格の100万トークンウィンドウ、ロングコンテキストの追加料金なし、キャッシュ読み取りは0.50ドル(Fableの0.25ドルではないが、それでも安い)。独立系のArtificial Analysis Intelligence Indexでは、集団の最上位に位置し、最新リリースからわずかに後れを取るのみだ。
知っておくべき注意点がある。コミュニティのテストでは、同じ努力レベルにおいて、Opus 5は以前のOpusのおよそ2倍の出力トークンを消費する傾向があることが分かっている。そのため価格表示は下がってもタスクごとのコストは上がる可能性があり、独立系のあるセットではハルシネーション率が旧世代のClaudeに比べて著しく上昇した。優れているが少しおしゃべりだ。しかし、すでにClaudeを使っていて、ファミリーを離れずにコストを本当に下げたいチームにとっては、明白な一手だ。
我々の見解: デフォルトの選択肢。「念のため」Fable 5.1を使っているなら、まずOpus 5を試してみるとよい。日常業務では差にほとんど気づかないだろう。
2. OpenAI GPT-5.6 Sol
最適な用途: スタックがすでにOpenAI上に構築されているチーム。
GPT-5.6 SolはOpenAIの高推論フラッグシップであり、Fableに対する自然な他社製の対抗馬だ。基本料金は短コンテキスト帯で入力5ドル/出力30ドルで、入力ではFableを下回り、出力では近い水準になる。OpenAIは同じファミリーでより安価な兄弟モデルも提供している。GPT-5.6 Terraは2ドル/12ドル、Lunaは0.20ドル/1.20ドルで、1つのAPI内でコストを調整できる。
Anthropicにはないトレードオフがここにある。OpenAIはロングコンテキスト帯に課金する。20万トークンを超えると、Solは10ドル/45ドルに再価格化され、これはオーバーフロー分だけでなくリクエスト全体に適用される。そのため、大きなプロンプトを使うエージェント的な実行は、静かに表示価格の2倍のコストになることがある。FableとOpusはウィンドウ全体を一律価格で課金するため、ロングコンテキスト作業においては本当の優位性がある。
我々の見解: OpenAIネイティブで、プロンプトが20万トークン未満に収まるなら正しい選択だ。作業がロングコンテキスト中心なら、切り替える前にその壁の計算をしておこう。
3. Google Gemini 3.8 Flash
最適な用途: 誰も返答を待っていない、安価で高スループットなバッチ処理。
Gemini 3.8 Flashはこのリストの価格面の主役だ。入力0.75ドル/出力3.75ドルで、Fableより1桁以上安く、100万トークンのウィンドウを備え、Artificial Analysis Indexで立派な59というスコアを獲得している。夜間のエンリッチメント、分類、大量生成には、この組み合わせは非常に強力だ。
正直な注意点が2つある。第一に応答性だ。Artificial Analysisは、クラス中央値2.99秒に対し、初回トークンまで13.3秒であることを測定している。スループットは優秀(出力速度は上位3位以内)だが、モデルは開始が遅く、これはライブチャットの返信など人間が待つあらゆる用途には向かないが、バッチエージェントにとっては問題にならない。第二に、価格が倍増する。0.75ドル/3.75ドルの料率は2026年12月31日まで維持され、2027年1月1日から1.50ドル/7.50ドルに上昇する。Google自身も、3.8は「性能を最大化するためにより多くのトークンを使う可能性がある」ため、効率重視のワークロードには旧世代の3.7 Flashを使い続けることを提案している。
我々の見解: オフラインの大量処理におけるコストパフォーマンスの選択肢。チャットウィジェットの裏には置かないこと、そして1月の価格変更をカレンダーに入れておくこと。
4. Kimi K3(Moonshot AI)
最適な用途: 実際にダウンロードできるオープンウェイトでトップクラスのスコアを求めるチーム。
Kimi K3はMoonshot AIのフラッグシップで、2.8兆パラメータ(アクティブ104B)のMixture-of-Expertsモデルで、100万トークンのコンテキストウィンドウを持つ。入力3ドル/出力15ドルで動作するため出力コストはFableの3分の1未満であり、Artificial Analysis Intelligence Indexで第4位に位置し、前世代のClaudeやGPTを上回っている。差別化要因は、Moonshotがオープンウェイトを公開し、期限どおりに提供したことで、自分でホストできることだ。
計画に入れておくべき癖が一つある。推論をオフにできない。K3にはreasoning_effortのレベル(低、高、デフォルトの最大)があるが、低設定でも依然として推論を行い、すべてのレベルが同じ料率で課金されるため、このダイヤルはレイテンシーを制御するだけでコストは変わらない。そのため、安価なモデルで十分な単純な非推論呼び出しでは、見出しの価格よりも割高になる。
我々の見解: コンプライアンスや管理上の理由でセルフホストが必要なチームにとって、最も強力なオープンウェイトのフラッグシップだ。ホスト型APIだけを求めていてウェイトにこだわらないなら、QwenとDeepSeekの方が価格面で優れている。
5. Qwen 3.8 Max(Alibaba)
最適な用途: 多言語対応の作業、そして自動化されたスコアより盲目的な人間の好みを信頼する人。
Qwen 3.8 Maxは2026年8月2日に一般利用可能になった。2.4兆パラメータ(アクティブ95B)のMoEで、100万トークンのウィンドウを持ち、入力2ドル/出力6ドル、暗黙のキャッシュ読み取りは0.25ドルだ。これは、人間による好み評価のボードで上位に位置するモデルにとって、Fableの出力コストのおおよそ5分の1に相当する。
興味深いひねりは、自動評価と人間による評価がQwenについて一致しないことだ。LMArenaではText部門で5位、Vision部門で2位、つまり人々はその回答を気に入っている。一方、自動化されたIntelligence Indexでは58前後の中位に位置する。どちらも間違いではなく、異なるものを測っているだけであり、単一の数字で結論を出すべきではない。Alibabaは寛容なライセンスの小型の兄弟モデルも公開しているが、ホスト版のMaxはオープンなベースには含まれないビジョン、ツール、より長いデフォルトコンテキストを追加している。
我々の見解: 多言語対応や消費者向けテキストに強く、人間の好みでの優位性が発揮される、強力で安価な選択肢。エージェント的なツール利用については、リーダーボードよりも自分のタスクで検証すべきだ。
6. DeepSeek V4 Flash
最適な用途: トークンあたりのコストが制約となる、低予算ライン。
価格が決定要因のすべてであれば、DeepSeek V4 Flashが議論を終わらせる。入力0.14ドル/出力0.28ドルで、出力はFableよりおよそ180倍安く、ここにあるどのモデルよりも寛容なMITライセンスで提供されている。2026年7月31日に再事後学習が行われ、この新しいビルドは、同社が公開するすべてのエージェント系ベンチマークで、実際にDeepSeek自身のより高価なV4 Proを上回っている。
最も難易度の高い長期推論や、巨大なコンテキストにわたる深い記憶の想起ではFableに及ばず、そのウィンドウ(128k)は上記の100万トークンモデルより小さい。しかしArtificial Analysis Indexでは、タスクあたり約0.03ドルで実質的なスコアを記録しており、これは「実行するには高すぎる」とされていた一群のアイデアを再び実現可能にする類の数字だ。
我々の見解: 大規模に何かを運用していて、フロンティア層が過剰な場合のデフォルトの選択肢。100万ドルの出力を要するモデルが必要だと思い込む前に、まずこれで試作してみるとよい。
7. xAI Grok 4.6
最適な用途: リアルタイムおよびXのデータで成り立つプロダクト。
Grok 4.6は、50万トークンの短コンテキスト帯で入力2ドル/出力6ドルで動作し、トークン全体を通じてFableより安価であり、強力なツール利用と、ここにある他のどのモデルにもないXのリアルタイムデータへのネイティブアクセスを備える。
ただし契約前にメーターをよく確認しよう。OpenAIと同様、xAIもロングコンテキスト帯に課金する。20万トークンを超えると、リクエスト内のすべてのトークンが4ドル/12ドルで課金される。またGrokは、トークン料率が隠す呼び出しごとの費用も追加している。WebおよびX検索は1,000回あたり5ドル、ファイル検索は1,000回あたり10ドルで、検索を頻繁に行うエージェントは表示価格が示すよりも高くなる。調達上の注意点として、クラウド利用が義務付けられている場合、AzureとBedrockでは最大Grok 4.3までしか提供されず、4.6をそこから購入することは一切できない。
我々の見解: リアルタイムやXデータが実際の目的の機能である場合には価値がある。そうでなければ、ツール呼び出しのメーターがあるせいで、単純なフロンティアモデルの方が予算管理は容易だ。
8. Mistral Large 3
最適な用途: 欧州のデータレジデンシーと低いプレミアム帯の料金。
Mistral Large 3は欧州の選択肢であり、このリストの中で最も安価な「フラッグシップクラス」モデルで、入力0.50ドル/出力1.50ドルだ。データレジデンシーや規制上の理由でEUに本拠を置くベンダーを必要とするチームにとって、これは調達を通過できる唯一のフロンティアに近い選択肢であることが多く、さらにオープンウェイトも提供している。
トレードオフは明快だ。Fable、Opus 5、GPT-5.6 Solのようにインテリジェンスボードの頂点を争っているわけではない。最も難しいエージェント的作業や推論作業では一歩劣り、25.6万トークンのコンテキストは100万トークンモデルより小さい。しかし多くの実用的な生成や抽出作業においては、この価格とEUホスティングを考えれば非常に妥当な下限となる。Mistralの消費者向けアシスタントは、現在Vibeというブランドで展開されており、チャットインターフェースを求める場合は同じモデル群の上で動いている。
我々の見解: 実利的なEU向けの選択肢。ベンチマークで勝つためではなく、レジデンシーとコストのために選ぶべきだ。
視点の転換:モデルはエンジンであり、従業員ではない
これはどの「最良のモデル」リストも隠していることだ。Fable 5.1とこの8つの中から選ぶことが正しい問いになるのは、モデル自体があなたが提供しているものである場合だけだ。多くのチームにとってはそうではない。あなたが欲しいのはトークンではなく、解決されたチケットや書かれた記事だ。
生のフロンティアモデルはインフラだ。あなたのプロダクトについて何も知らず、何にも接続されておらず、呼び出しの間に何も記憶していない状態で到着する。それをサポートエージェントに変えるには、依然としてヘルプセンター上に検索を構築し、ヘルプデスクに接続し、ガードレールを書き、エスカレーションロジックを追加し、慎重を期すなら、実際の顧客と話す前にテストする方法を見つける必要がある。それは数ヶ月の作業であり、モデルの選択はそのほんの一部にすぎない。
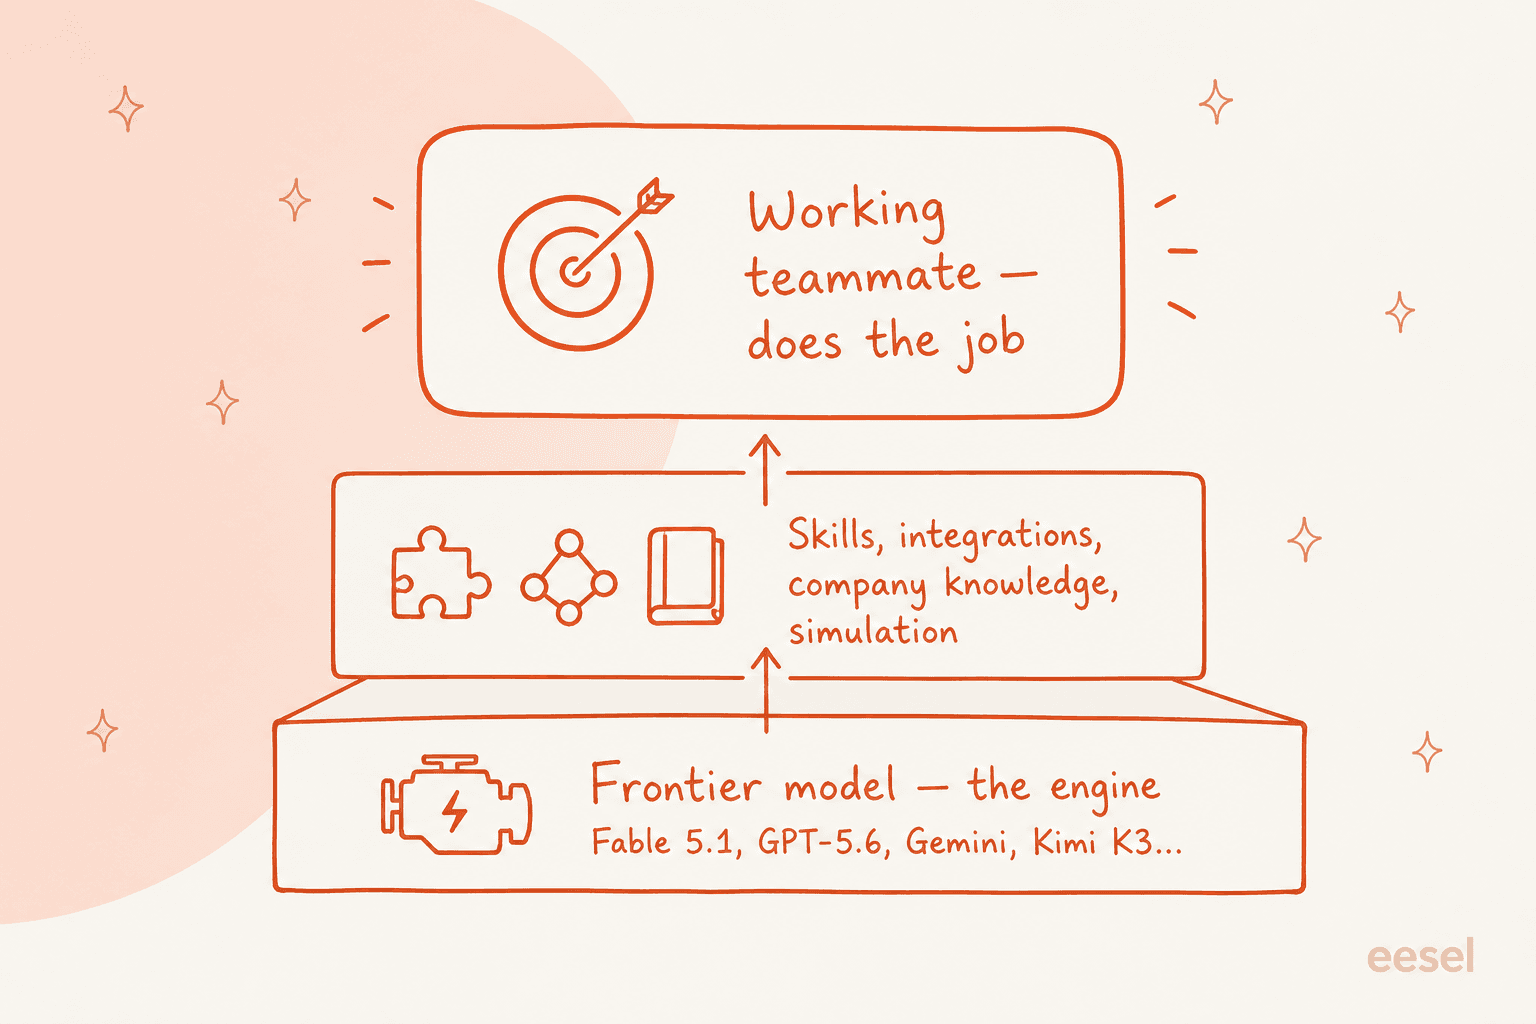
ここで私はいくつかの傷跡を得てきた。私はeeselで統合とAPIを構築し、過去3年以上にわたって、数千件の実際のチケットにわたるライブサポートキューにAIエージェントを導入してきた。身についた教訓はこうだ。壊れるのはモデルであることはほとんどない。壊れるのは、誰も先に現実に対してテストしなかったために間違った答えを自信満々に返すボットだ。だからこそ、あらゆる本番導入は、顧客に近づく前に企業自身の過去のチケットに対してシミュレーションされるようになっている。「Fableの方がOpusより良いか」という問いをどれだけ重ねても、それには答えられない。
だからモデルのベンチマークに1週間を費やす前に、実際にどの層を購入しているのかを問おう。プラットフォームを構築していて、モデル自体があなたのプロダクトであるなら、このリストはあなたのためのものだ。用途に応じて選べばよい。働き手が欲しいなら、働き手を買おう。
eeselを試す
本当にやりたい仕事がサポートやコンテンツであれば、eeselはこれらすべてのモデルの上に位置する層だ。eeselはAIチームメイトプラットフォームだ。モデルと白紙のキャンバスを渡す代わりに、定義された仕事のために即戦力のチームメイトを雇う形になる。現在の陣容には、既存のサポートキューに参加するAIヘルプデスクチームメイトと、AIブログライターがあり、それぞれの役割が必要とするスキル、統合、企業コンテキストを備えて着任する。
モデルのまとめにおいて重要なのはこの点だ。eeselは内部的にモデルに依存しないため、フロンティアモデルの能力を、自分で選択したり価格を調べたり接続したりせずに得られ、新しいFableやOpusが登場するたびにその作業をやり直す必要もない。実際の1件のチケットに回答する前に、過去のチケットでチームメイトをシミュレーションし、それをどう処理したかを正確に確認できる。これは、生のモデルによる構築の多くがスキップし、後で後悔するテストのステップだ。
そしてターミナルで作業する人には、eesel CLIが同じチームメイトとワークスペースをプログラムで操作する。エージェントフレンドリーに作られており、人間が手動で実行することもできれば、スクリプトで自動化することもでき、Claude Code、Codex、Cursorのようなコーディングエージェントが直接操作することもできる。そのため、指示を管理したり、シミュレーションを開始したり、エージェントを起動したり、その活動を読んだりすることを、ダッシュボードを一度も開かずに行える。同じチームメイトが、自動化やAIが操作できるインターフェースとして公開されている形だ。試すのは無料で、コミットする前に自分自身のデータでの動作を確認できる。
実際にどの代替を選ぶべきか
締めくくりに、用途別の短いまとめを示す。
- Claudeファミリーに留まり、支出を減らす: Opus 5。これはAnthropic自身のデフォルトだ。
- OpenAIまたはGoogleネイティブ: GPT-5.6 Sol(20万トークンの壁に注意)またはGemini 3.8 Flash(バッチ限定、1月に価格倍増)。
- オープンウェイト: セルフホスト可能なフラッグシップにはKimi K3、多言語対応にはQwen 3.8 Max、低予算の下限にはDeepSeek V4 Flash。
- リアルタイムまたはEU: XデータにはGrok 4.6、欧州のレジデンシーにはMistral Large 3。
- モデルではなく働き手が欲しかった場合: eesel。
モデルは互いに追い越し合い続け、表示価格は変動し続ける。変わらないのは層の問いだ。まずエンジンを買うのか従業員を買うのかを決めれば、残りの選択はずっと小さくなる。
よくある質問
Claude Fable 5.1の最良の代替は何か?
Claude Fable 5.1は代替モデルと比べてどれくらいの費用がかかるか?
Claude Fable 5.1より安価で、それでも有能な代替はあるか?
Claude Fable 5.1にオープンウェイトの代替はあるか?
AIサポートエージェントを構築するのにClaude Fable 5.1は必要か?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.