Fable 5.1の正体
何がローンチされたのかを正確に説明します。命名がすぐに紛らわしくなるからです。Claude Fable 5.1はFable 5の後継であり、Anthropicのラインナップの頂点です。APIのモデルIDはclaude-fable-5-1です。同じ基盤モデルでセーフガードを軽くしたMythos 5.1も存在しますが、これは審査を受けたProject Glasswing参加者(サイバー防衛担当者と生命科学者)にのみ提供されます。ベンチマークの数値を見るとき、Mythosと明記されていない限りそれはFable 5.1のものです。
スペックはフロンティア級です。100万トークンのコンテキストウィンドウがウィンドウ全体にわたって一律のトークン単価で提供され、最大出力は12万8千トークン、常にオンの適応的思考はeffortパラメータ(デフォルトは高)で調整されます。Anthropicはこれを「高度な推論と長時間のエージェント作業」向けと位置づけており、その公式ガイダンス自体が示唆的です。ほとんどの作業ではOpus 5から始め、Opus 5を高いeffortで使ってもまだ足りないときにのみFable 5.1に頼るべきだというのです。これは異例なほど正直な誘導であり、テストの間ずっと私が立ち返った枠組みでもあります。
実際の製品にモデルを組み込む仕事を日々している技術者として、私が気にするのはリーダーボードではなく、長く、雑然とした、複数ツールにまたがる実行の間、モデルを付きっきりで見ていなくても持ちこたえてくれるかどうかです。それこそがFable 5.1が狙っている領域です。
唯一動いた数字: 価格
ここで価格を示します。「10ドルから」としか言わないレビューは仕事をきちんとしていないからです。
| 項目 | Fable 5.1 | Fable 5 | 変化 |
|---|---|---|---|
| 入力(MTokあたり) | $10 | $10 | 変更なし |
| 出力(MTokあたり) | $50 | $50 | 変更なし |
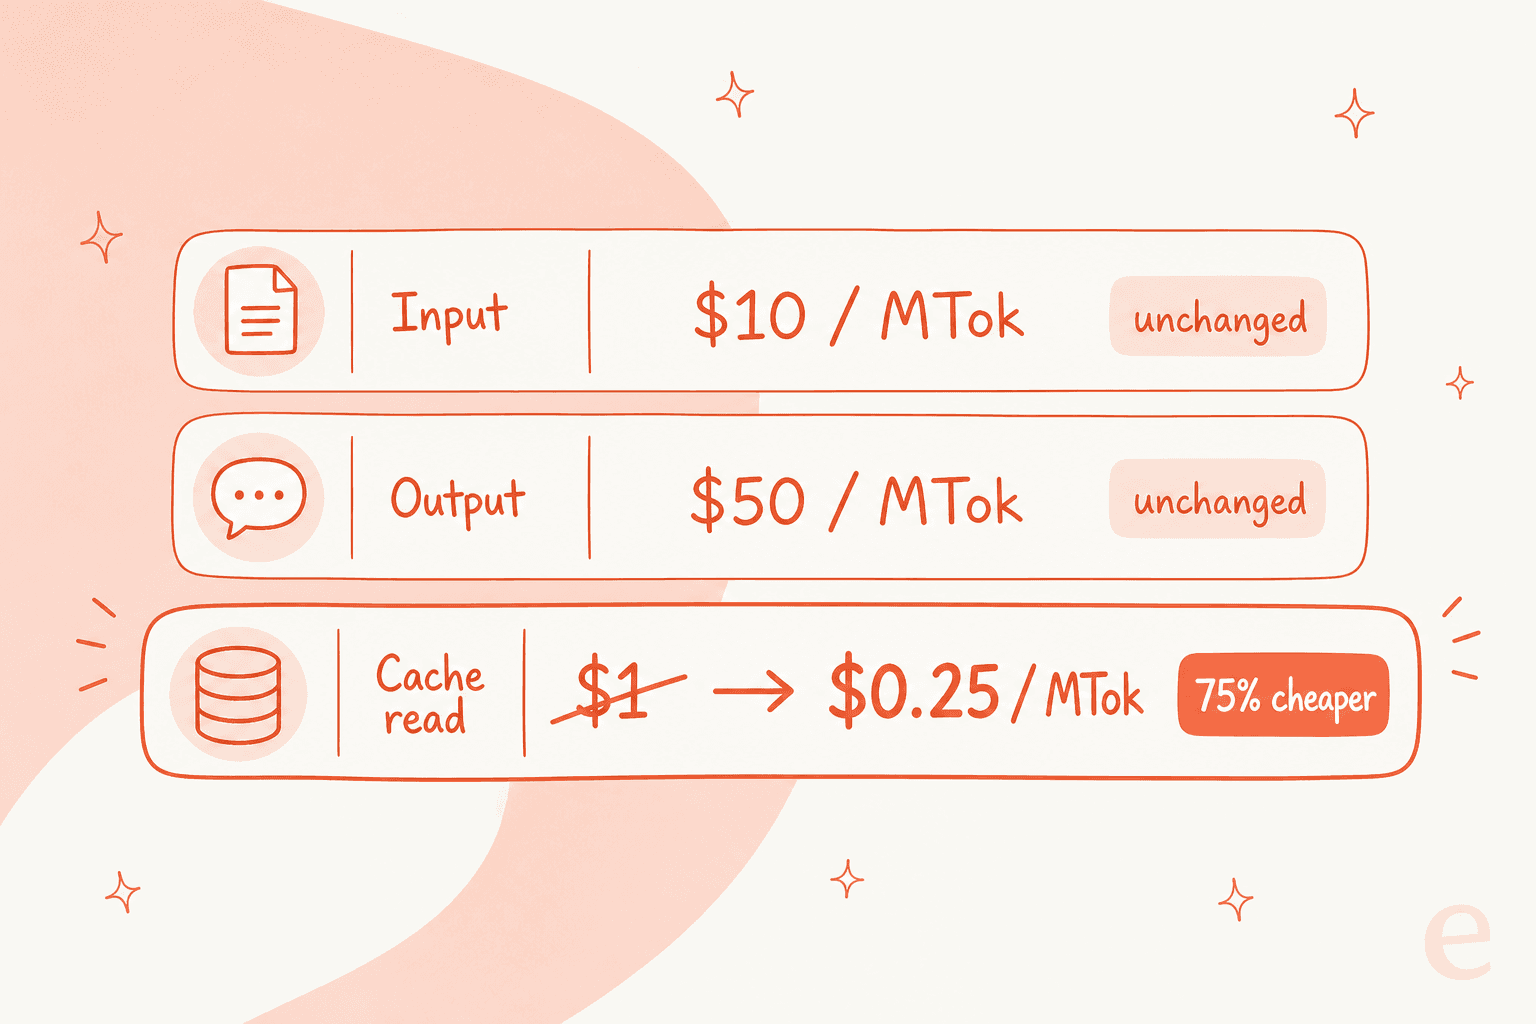
| キャッシュ読み取り(MTokあたり) | $0.25 | $1.00 | 75%安い |
| キャッシュ書き込み、5分(MTokあたり) | $12.50 | $12.50 | 変更なし |
| キャッシュ書き込み、1時間(MTokあたり) | $20 | $20 | 変更なし |
| バッチ入力/出力(MTokあたり) | $5 / $25 | $5 / $25 | 変更なし |
キャッシュ読み取りの値下げがコスト面のすべてです。Anthropicの試算によれば、典型的なワークロードのコストを約25%、高度にエージェント的なワークロードでは最大45%下げるとしています。エージェント的な実行はターンごとに同じキャッシュ済みコンテキストを読み直すためです。参考までに、Fable 5.1の0.25ドルのキャッシュ読み取りは、Opus 5の0.50ドルよりトークンあたりで実際に安く、Opus 5の基本入力価格は半額であるにもかかわらずそうなっています。ワークロードがキャッシュに大きく依存しているなら、見出しの料金が示唆する以上にFableに有利な計算になります。
予算を立てる前に知っておく価値のある注意点が二つあります。米国限定の推論には1.1倍の乗数が課され、Fable 5.1は無料プランでは使えず、Pro、Max、Team、Enterpriseのいずれかが必要です。ローンチはモデル間の定番の皮肉も引き起こし、あるXアカウントは「Fable 5.1はGPT-5.6 Solより6倍高い」と指摘しました。それは表示価格としては事実ですが、トークン効率と成功率が実際の請求額を決める長時間のエージェント的な作業が目的なら、間違った比較です。
ベンチマーク、そしてどこまで信頼すべきか
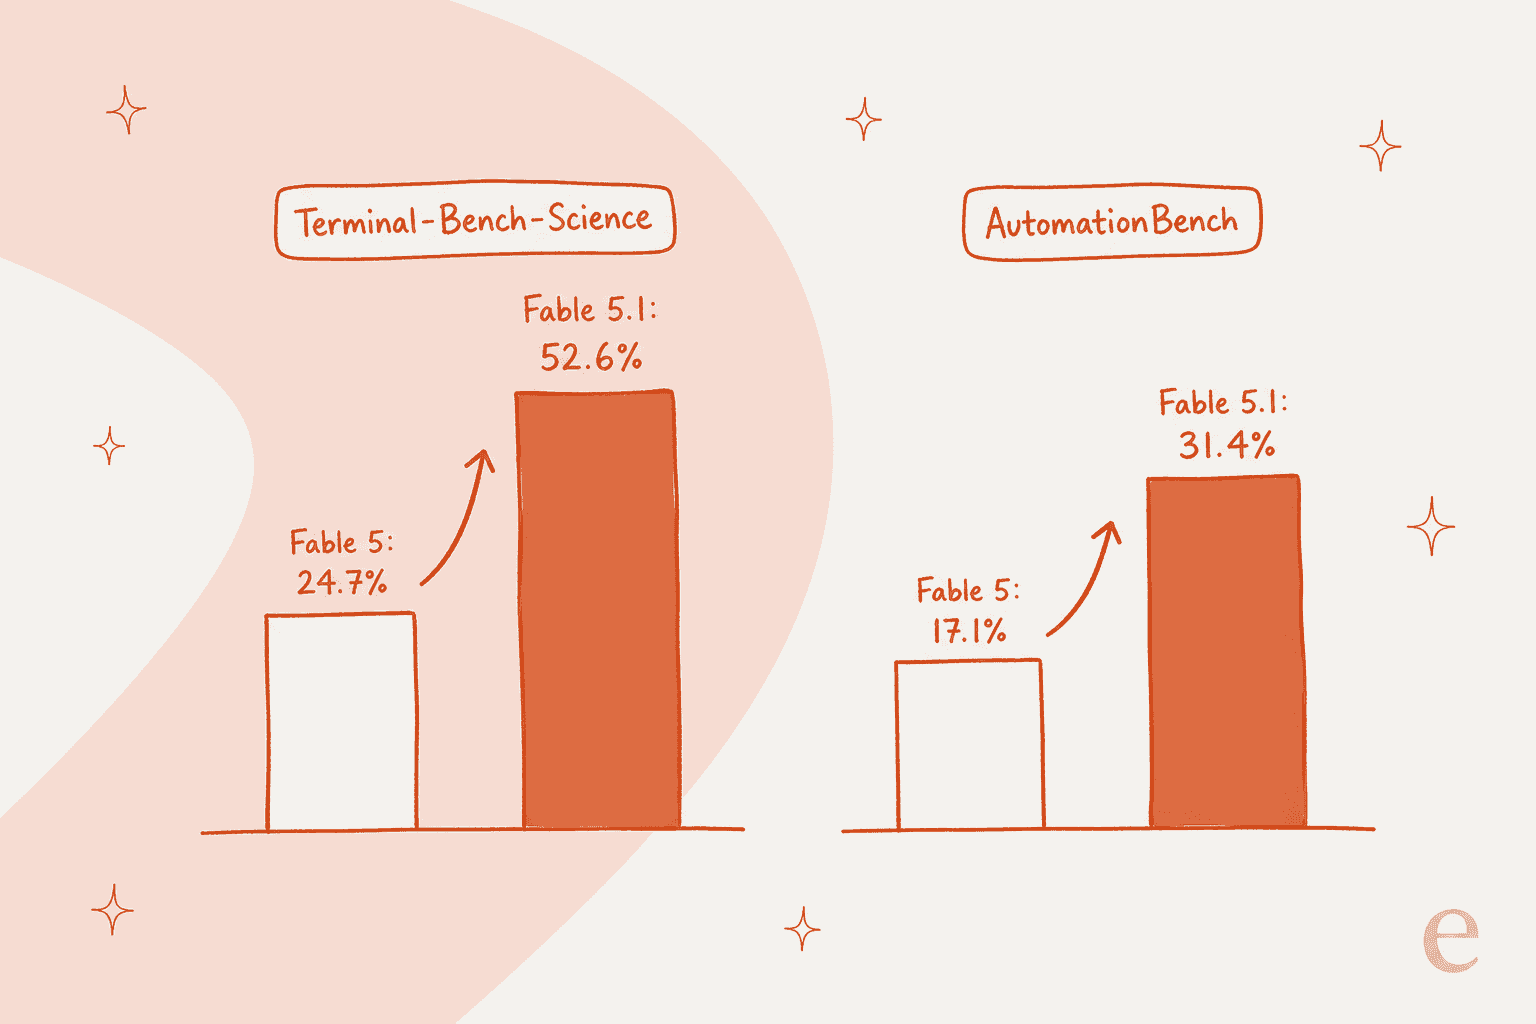
紙の上ではFable 5.1が総なめです。Anthropicは公開しているすべての評価で首位だと報告しており、Fable 5からの二つの最大の飛躍はじっくり見る価値があります。
| ベンチマーク | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science(エージェント型科学) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0(エージェント型コーディング) | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2(知識労働、Elo) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench(業務ワークフロー) | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0(エージェント型コーディング) | 73.4% | 70.5% | 70.0% | 67.2% |
| Humanity's Last Exam(ツールあり) | 65.0% | 63.8% | 63.6% | - |
| OSWorld 2.0 partial(コンピュータ操作) | 77.9% | 72.9% | 75.4% | - |
24.7%から52.6%へのTerminal-Bench-Scienceの飛躍は目を引きます。エージェント型の科学研究が倍以上になったのです。AutomationBenchがほぼ倍になったことは、平均的な購入者にとってより重要です。雑然とした業務ワークフローの代理指標だからです。
さて、マーケティングページが大部分を埋もれさせている正直な部分です。これらのFable 5.1の数値はすべて本番用セーフガードを有効にした状態で出されたものであり、Anthropicはセーフガードが介入した場合、Fable 5.1はそれらのタスクでゼロ点になったと注記しています。つまり実際の能力の上限(セーフガードが軽いMythos 5.1で近似され、Terminal-Bench 4.0で60.9%に達する)はもっと高いということです。また、科学ベンチマークにはおよそ3.5〜4.5ポイントの標準誤差があります。ベンチマークはここでは方向性を示すシグナルであり、定規ではありません。
コミュニティの懐疑的な反応は健全であり、私も同意します:
「xAI、OpenAI、Anthropic、Qwenなどのすべてのモデルが、リリースのたびにすべてのベンチマークで勝つなんてことがどうしてあり得るのか?明日には(もちろんAnthropicを除く)上記すべてがバージョン番号を上げて、HNのトップですべてのベンチマークに勝つだろう。」

だからこそ私は、リーダーボードよりもAnthropicが開示した顧客の実行結果を重視しています。Rampは、無人での38時間の実行が一つの悪いML結果をラベル付けの不具合だと診断し、一晩で6つの実験を開始したと報告しました。Millenniumは、どのエンジニアもモデルも4〜5年間解明できなかった百万分の一のクラッシュの原因を発見したと述べています。Browserbaseは、最も難しいブラウザエージェントベンチマークでタスクの82%を達成したとしており、Opus 5の74%、Fable 5の57%を上回り、しかもトークン使用量は少なかったとのことです。これらは、ベンチマークの一行では捉えられない類の長時間実行の成果です。
本当に優れている点
三つの点が際立ちましたが、リーダーボードに載っているのはそのうちの一つだけです。
文章力が意外な収穫です。 長年、Claudeについて最もよく聞かれた不満は、その文章がコンプライアンス文書のように読めるというものでした。Fable 5.1はそれが逆転した初めてのバージョンで、反応は即座にありました:
「読みにくい文章のせいでOpus 5からGPT 5.6 Solに乗り換えた熱心なClaude Codeユーザーとして、これは嬉しい。あなたたちの製品は大好きだけれど、頻繁にコンテキストを切り替える必要がある場合、今のモデルは非常に扱いづらい。簡潔さが鍵だ。」
Gleanは、日常的な知識やドラフト作成において、審査員がFable 5.1の回答をFable 5に対しておよそ2対1の割合で好んだと述べており、Canvaはその文章を「際立った点」と評しました。文章を書くことを生業にしているなら、これはどのコーディングスコアよりも重要なアップグレードです。
コーディングは長時間のセッションでも持ちこたえます。 これがうたい文句であり、おおむね実現しています。SpaceXAI(Cursor)は、これまで実行した中でCursorBench 3.2において最も高性能なモデルだとし、特に自分自身の作業を検証する点で優れていると評しました。Red Hatは、テストしたすべての壊れたビルドの根本原因を発見したと述べています。ローンチ当日には一発芸的なデモがXにあふれましたが、それらは楽しいものの、地味な作業(ビルド失敗の根本原因を突き止めること)ほどのことは証明しません。
エージェント的な実行は軌道を外れません。 Everyは効率面を「Fableの知能、Opusの価格、Sonnetの速度」とまとめ、Opus 5のおよそ2倍の速さを、トークン使用量はおよそ半分で達成したとしています。あるビルダーはその実践的な側面をこう表現しました:
「一つのプロンプト、43分、2.96ドル – claude fable 5.1が1,660行の世界を書いた」
弱点
公正なレビューは限界にも触れるべきであり、Fable 5.1には実際に二つの弱点があります。
拒否応答は依然として最大の痛点です。 これはローンチ当日繰り返し話題になり、よくある「AIは慎重すぎる」といった愚痴ではありません。開発者が自分自身のコードに対する正当なセキュリティ作業さえできないという話です:
「Fableは役に立たない。私: 『自分自身のコードのセキュリティ問題を見つけて。これは私が所有するコードで、会社のCEO/CTOの承認の下でやっている。』Fable: 『いや、無理』」
Anthropic自身の説明では、サイバーセーフガードは今やより精密になっており、Claude Codeユーザーが経験する介入はセッションあたりFable 5と比べて約60%減るはずで、Fable 5.1は今や脆弱性を防御的に特定できるとしています。しかし侵入テスト、エクスプロイト生成、バイナリスキャンは依然としてOpusモデルにリダイレクトされ、自分自身のコードに対する誤検知は実際に存在します。あるテスターは信頼の問題をこう率直に述べています。それは「いまだに自分自身のガードレールを理解できず、簡単にそれを発動させてしまう理屈をこねてしまう」ように見える、と。
透かしは信頼をめぐる火種です。 Fable 5.1はEU AI法への準拠のため、すべての出力に統計的なテキスト透かしを追加します。トークンや隠し文字は追加されず、あなたが誰であるかを符号化するものでもありませんが、Anthropicがモデルが生成したテキストを識別できることを意味し、一部のユーザーはそれに不安を覚えています:
「お知らせ: Claudeのフィンガープリンティング(透かし)がFable 5.1で稼働開始しました。これはAnthropicがそのモデルによって生成されたテキストを識別できることを意味します。」

出所の証明が組織にとって重要なら、これは利点です。検出不可能な出力を当てにしていたなら、これは致命的な欠点です。いずれにせよ、それが存在することを知っておいてください。APIの上に構築している場合に一読の価値がある、Fable 5からの破壊的なAPI変更もいくつかあります。強制的なツール使用はなくなり(tool_choiceをanyやtoolにすると400エラーが返るようになりました)、思考ブロックはモデルに紐づくようになり、並列ツール呼び出しはより不安定になりました。
本当に頼るべき人は誰か
正直な結論を、あなたのタイプ別に:
- 長時間の自律的なエージェント作業を実行している方。 はい。これはまさにこのモデルの得意分野であり、キャッシュ読み取りの値下げによって何時間もかかる実行が手頃になります。ぜひ使ってください。
- 文章を書く、あるいは高度な知識労働をする方。 品質面で強くお勧めします。文章力の飛躍は本物であり、資料やスプレッドシートの成果はAnthropicがこれまでに出した中で最良です。
- 日常的なコーディングやチャットを行う方。 おそらく違います。少なくともデフォルトではありません。Opus 5の方が安く、Anthropic自身もそこから始めるよう勧めています。Opus 5を高いeffortで使っても行き詰まったときにFable 5.1へと引き上げてください。
- セキュリティ研究をする方。 まずは実際のワークフローに対して拒否応答をテストしてください。精度は向上しましたが、自分自身のコードに対する誤検知は現在進行形の不満です。
- ただ機能するサポートエージェントやコンテンツライターが欲しいだけの方。 あなたは間違ったレイヤーで買い物をしています。それについては次で詳しく述べます。
モデルはチームメイトではない
ここで持ち帰ってほしい捉え直しを述べます。「どのモデルを買うべきか」という問いのほとんどがここで脱線するからです。Fable 5.1は素晴らしいエンジンです。働き手ではありません。あなたの製品が何をするか分からず、あなたのヘルプセンターも直近1万件のチケットも見えず、連携もなく、実際の顧客に触れる前に自社の履歴に対してテストする方法もありません。サポートやコンテンツの課題を解決するために生のモデルへのアクセスを買うのは、世界で最も賢い人を雇っておきながら、コンテキストもツールもオンボーディングもゼロで放り出すようなものです。
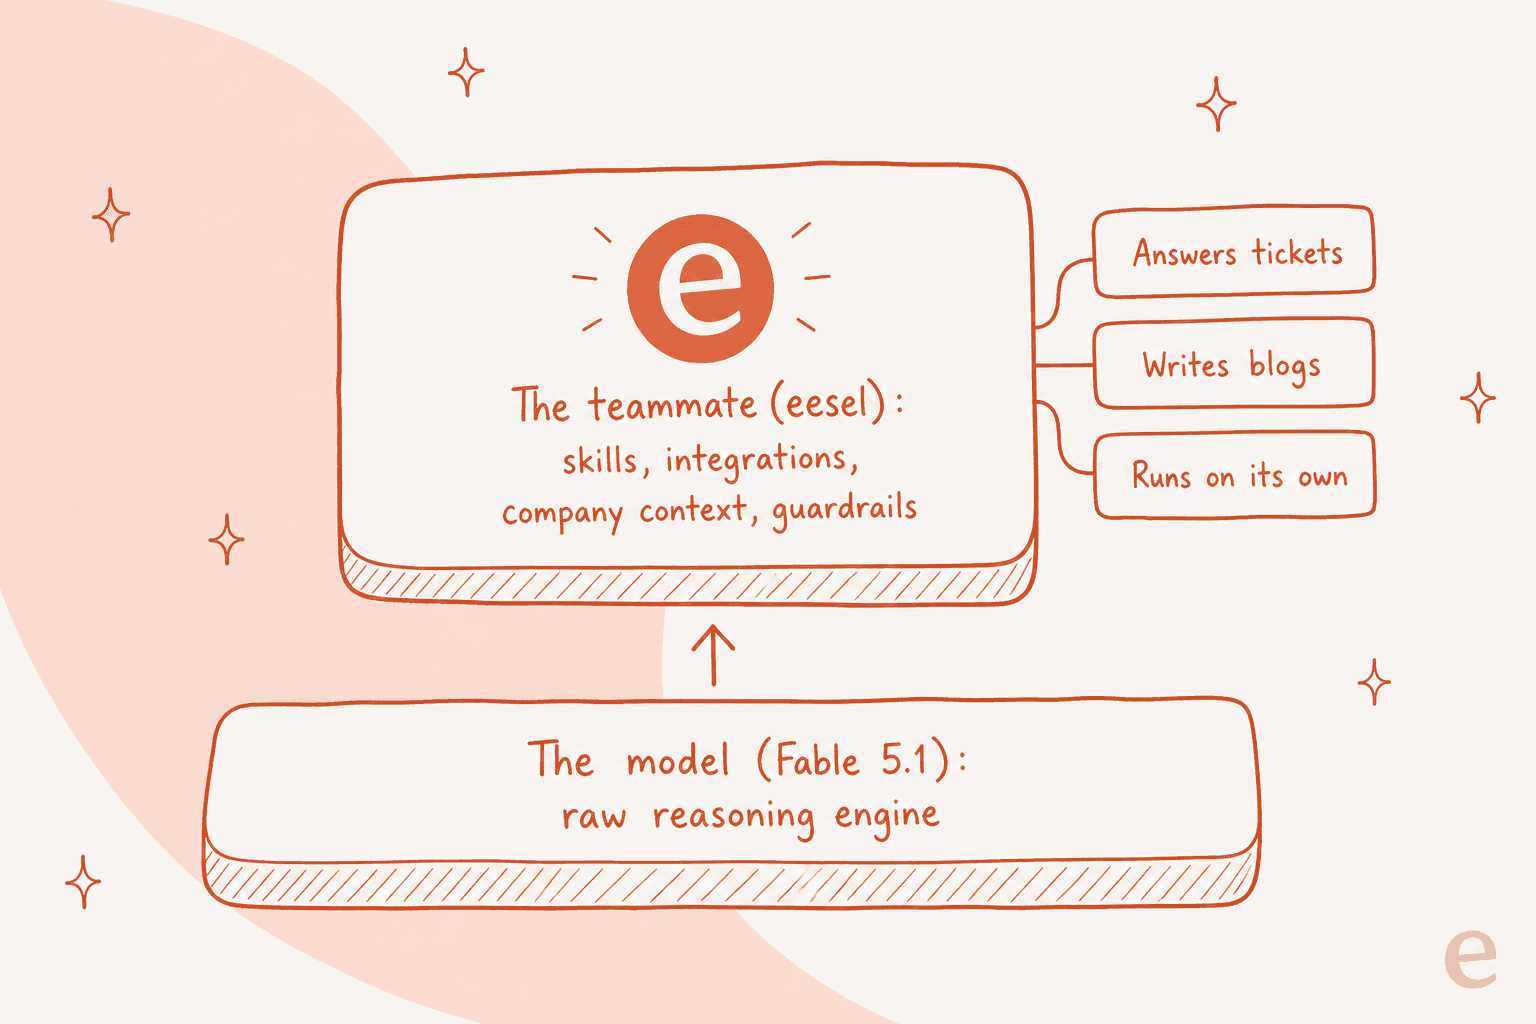
「生のモデル」と「完成したチームメイト」の間にあるこのギャップこそ、eeselが存在する理由のすべてです。考え方はシンプルです。モデルを雇うのではなく、特定の仕事のためにすぐ働けるチームメイトを雇うのです。現在のラインナップは、既存のサポートキューに加わるAIヘルプデスクのチームメイトと、AIブログライターであり、それぞれがその役割に必要なスキル、連携、企業コンテキストをすでに携えた状態でやってきて、その下ではフロンティアモデルが動いています。
そして、隅々までエージェントフレンドリーに作られているため、ダッシュボードに縛られることはありません。eeselのCLIを使えば、人がターミナルから同じチームメイトを操作でき、スクリプトによる自動化もでき、Claude CodeやCursorのようなコーディングエージェントがプログラム的に操作することもでき、MCPやウェブフックも併用できます。Claude Code内でのFable 5.1の働きが気に入ったなら、これは同じエネルギーを新しいリポジトリではなく、あなたのサポートワークスペースに向ける方法です。
eeselを試す
カスタマーサポートをどのモデルで動かすべきか調べようとしてここにたどり着いたなら、もっと良い問いは、どのチームメイトを雇うべきかです。eeselはAIチームメイトプラットフォームです。AIヘルプデスクのチームメイトは数分でZendesk、Freshdesk、Gorgiasなどのツールに接続し、過去のチケットやヘルプセンターから学習し、そして何より重要なのは、実際に顧客へ返信する前に過去のチケットでシミュレーションできることです。つまりスイッチを入れて祈るのではなく、事前に解決率と回答内容を確認できます。
このリリース前にシミュレーションするというステップこそ、Fable 5.1のような生のモデルが与えてくれないものであり、だからこそモデルを選ぶのは簡単な部分で、チームメイトを選ぶことこそが実際に結果を決めるのです。eeselは無料で試すことができます。
よくある質問
Claude Fable 5.1の料金はいくらですか?
Claude Fable 5.1はOpus 5より優れていますか?
Claude Fable 5.1はFable 5から何が変わりましたか?
Claude Fable 5.1は拒否応答が多すぎますか?
AIサポートエージェントを運用するのにFable 5.1が必要ですか?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.