Claude Fable 5.1とは何か
私はeeselでAIエージェントを構築しているので、新しいフラッグシップモデルは私にとって抽象的なベンチマーク競争ではなく、自分のチームメイトが動くエンジンそのものです。Anthropicが2026年9月1日にFable 5.1を発表したとき、まず最初にしたのは、マーケティングの裏で実際に何が変わったのかを読み込むことでした。そこには「新モデルがトップに立った」という以上の本当の話があります。
Claude Fable 5.1はAnthropicの一般提供モデルの中で最も高性能なモデルで、プロダクトページではコーディングと知的作業における世界最高峰のモデルと位置づけられています。Fable 5の後継であり、Claude Opus 5の上、Claude 5ファミリーの最上位に位置します。APIのモデルIDはclaude-fable-5-1です。
まず押さえておくべき仕様がいくつかあります。
- コンテキストウィンドウ: デフォルトも最大も100万トークンのウィンドウで、ウィンドウ全体にわたって均一なトークン単価が適用されます(長文コンテキストの追加料金なし)。
- 最大出力: 128kトークン。
- Thinking: アダプティブシンキングは常にオンで、
effortパラメータでその深さを調整します。デフォルトは高(high)です。 - 利用可能な場所: API、Amazon Bedrock、Google Cloud Vertex AI、Microsoft Foundry、加えてPro、Max、Team、Enterpriseの各プラン。無料プランでは利用できません。
Claude Mythos 5.1という、同じ基盤モデルでガードレールをより緩めたバージョンも存在しますが、これはProject Glasswingの参加者(審査を受けたサイバー防衛担当者や生命科学者)のみが利用できます。ほとんどの人にとって、実際に呼び出すことになるのはFable 5.1です。
Anthropic自身のガイダンスに埋もれている正直な注意点があります。ほとんどのワークロードではまずOpus 5から始めるべきで、Opus 5をより高いeffortで使っても不十分な場合、あるいは最も野心的な長期プロジェクトの場合にのみFable 5.1に手を伸ばすべきだとされています。これは「フラッグシップモデルに無駄な費用を払わないで」という清々しい姿勢であり、このモデルをどう捉えるかを左右するはずです。これは特化型のツールであり、デフォルトの選択肢ではありません。
Fable 5から実際に何が変わったのか
ここが本当に巧妙だと感じる部分で、ベンチマークの数字の話ではありません。Fable 5.1はFable 5の基本料金をすべてそのまま維持しつつ、エージェント的な請求額を支配する、まさにその一つの指標だけをひっそりと75%安くしています。
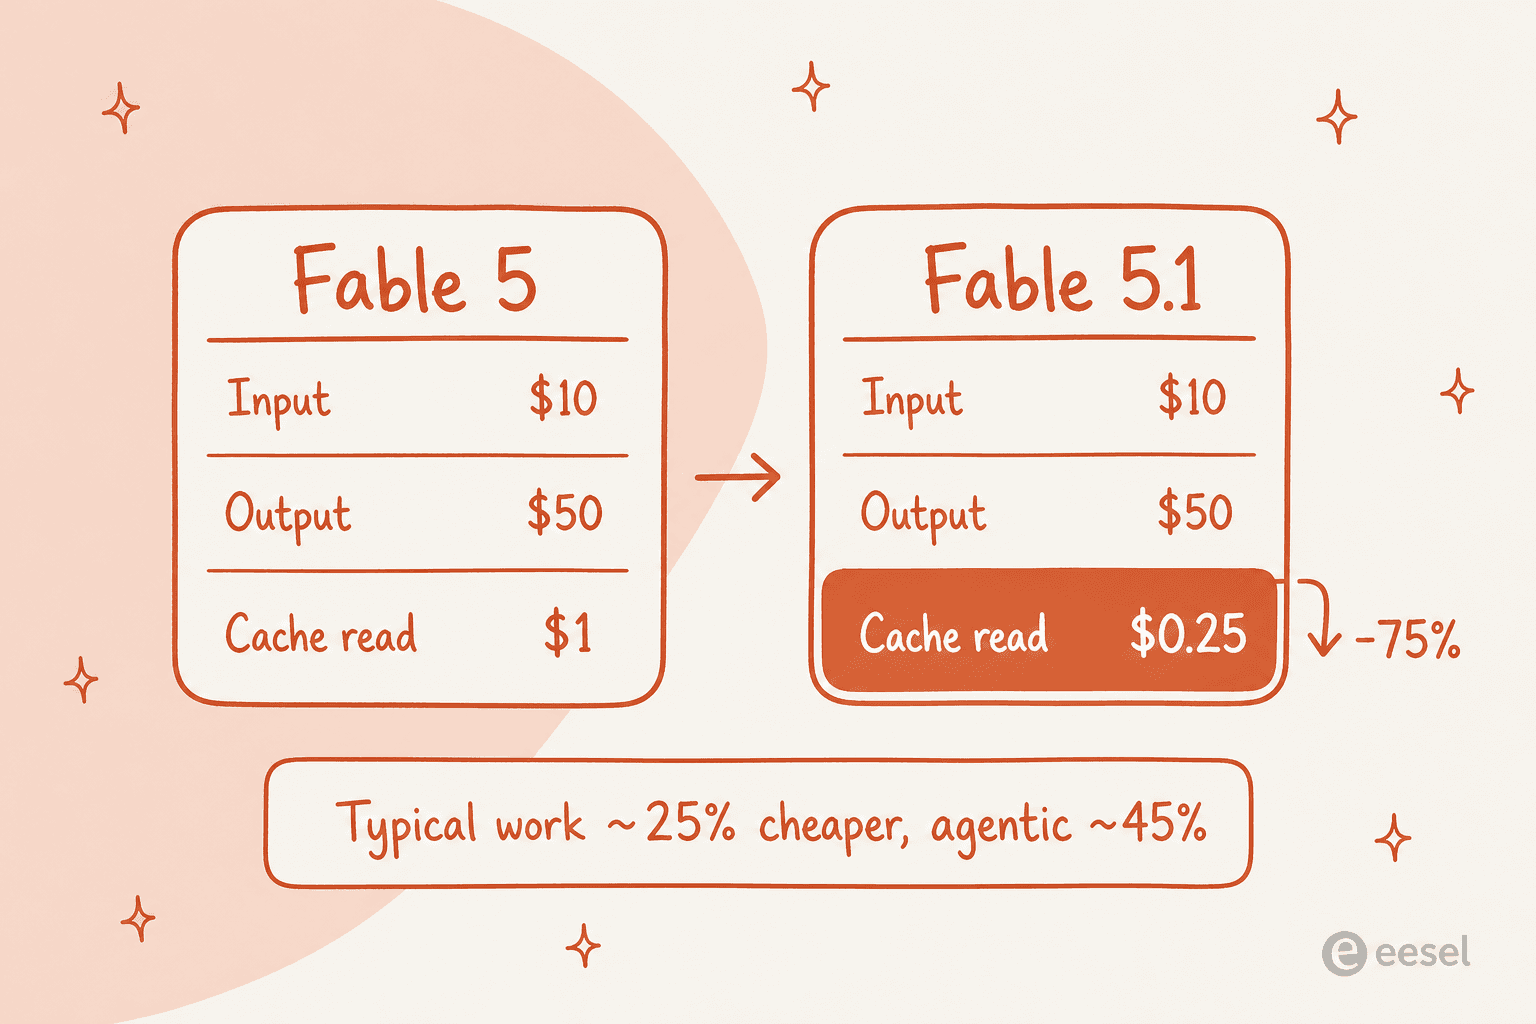
キャッシュ読み取りは100万トークンあたり1ドルから0.25ドルに下がりました。これは、実際に重要なエージェントループを動かしたことがなければ、単なる誤差のように聞こえるかもしれません。しかし違います。長時間のエージェント的セッションでは、システムプロンプト、コードベース、チケット履歴といった同じキャッシュ済みプレフィックスをステップごとに何度も読み直すため、キャッシュ読み取りは新規入力よりもはるかに速く積み上がります。Anthropicは2026年8月の実際の利用状況を4週間分測定し、実効的な節約効果を一般的なワークロードで約25%、非常にエージェント的なワークロードでは最大45%と見積もっています。
開発者のLance Martinは、発表当日にこの価値の観点を鋭く指摘しました。
"Fable 5.1 at low effort is often competitive with Opus and Sonnet on $ / task while scoring higher. on CursorBench 3.2.0, Fable 5.1 at low effort is at parity w/ Fable 5 at high effort at a third of the cost."
価格以外にも、ドキュメントによれば性能向上は6つの領域に集中しています。数時間規模のセッションにわたるエージェント的コーディング、知的作業(文書、スプレッドシート、プレゼンテーション)、多段階のリサーチ、密度の高いPDFやグラフに対するビジョン、100万トークンのウィンドウ全体にわたる推論、そしてコンピュータ操作です。多言語性能はFable 5と同水準で、向上した領域ではありません。すべてが良くなったと示唆するのではなく、Anthropicがそれを正直に述べている点は評価できます。
さらに、これを使って構築する人にとって重要な変更が2つあります。
- テキストの透かし(新規)。 すべてのテキスト出力には、EU AI Act準拠のためにAnthropicの統計的テキスト透かしが付与されるようになりました。追加のトークンや隠し文字は入りませんが、出力がClaudeによって生成されたものだと識別できるようになります。
- 破壊的なAPI変更。 強制的なツール使用は廃止され(
tool_choiceにanyまたはtoolを指定すると400エラーが返されるようになりました)、Thinkingブロックはモデルに紐づけられ、以前のターンを編集するとThinkingが無効になります。独自のエージェント的コーディングCLIやツールループを構築している場合は、アップグレード前に移行ノートを確認してください。
Claude Fable 5.1の料金
料金表を一箇所にまとめます。すべての価格は100万トークン(MTok)あたり、米ドル建てで、プラットフォームの料金ドキュメントからの引用です。
| 項目 | Claude Fable 5.1 | Claude Fable 5(旧) |
|---|---|---|
| 基本入力 | $10 | $10 |
| 出力 | $50 | $50 |
| キャッシュ読み取り | $0.25 | $1 |
| 5分キャッシュ書き込み | $12.50 | $12.50 |
| 1時間キャッシュ書き込み | $20 | $20 |
| バッチ(入力/出力) | $5 / $25 | $5 / $25 |
変わったのはキャッシュ読み取りの項目だけです。それ以外はFable 5と全く同じです。米国内に留まる必要のあるワークロード向けに、米国限定推論を1.1倍の料金で利用できるオプションもあります。
これは現行ラインナップの中でFable 5.1をどの位置に置くのでしょうか。
| モデル | 入力 | キャッシュ読み取り | 出力 |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $10 |
Fable 5.1は基本の入出力価格では依然として現行Claudeの中で最も高く、Opus 5の2倍、Sonnet 5の5倍です。しかし注目すべきは、そのキャッシュ読み取り価格0.25ドルが、Opus 5の0.50ドルよりもトークンあたり実際に安いという点です。これがこの変更の本質です。エージェント作業を特徴づける繰り返しの再読み込みにおいて、フラッグシップモデルを経済的にしているのです。
具体例で見てみましょう。 あるエージェントが1つの長いセッション内で、1,000回のツール呼び出しのたびに15万トークンのキャッシュ済みコンテキストを再読み込みするとします。これは合計1億5,000万のキャッシュ読み取りトークンになります。Fable 5ではこれに150ドルかかりますが、Fable 5.1では同じ作業が37.50ドルで済みます。一日中稼働するエージェントの集団全体にこれを掛け合わせると、「同じモデル、安いキャッシュ」というトリックはもはや誤差の話には見えなくなります。
コミュニティからの一つの注意点として、最上位の一般向けプランでさえ、Fableクラスのモデルではすぐに利用上限に達するという報告があり、これはトークン料金表とは別の問題です。Pro、Max、Teamの正確なサブスクリプション金額については、claude.com/pricingで直接確認するか、消費者向けの視点として弊社のClaude Proの料金の解説をご覧ください。
他社製品と比較検討する場合は、弊社のGeminiの料金、GPT-5.3 Codexの料金、Gemini概要のガイドも同じ視点で書かれています。
Claude Fable 5.1が実際にできること
Anthropicは、掲載しているすべてのベンチマークでFable 5.1が首位だと報告しています。ここでは意味のあるものを紹介します。いずれも本番環境のガードレールを有効にした状態で作成されています(この点については後述します)。
| ベンチマーク(測定内容) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1(エージェント的リサーチ) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0(エージェント的コーディング) | 55.8% | 42.0% | 52.3% | 37.3% |
| AutomationBench(業務ワークフロー) | 31.4% | 17.1% | 26.9% | 19.6% |
| OSWorld 2.0、partial(コンピュータ操作) | 77.9% | 72.9% | 75.4% | - |
| Humanity's Last Exam、ツール使用あり | 65.0% | 63.8% | 63.6% | - |
| CursorBench 3.2.0(エージェント的コーディング) | 73.4% | 70.5% | 70.0% | 67.2% |
特に目立つ伸びはTerminal-Bench-Science(24.7%から52.6%へと2倍以上)とAutomationBench(17.1%から31.4%)です。どちらも同じ方向を示しています。このモデルは、長時間の自律的な作業において大きく向上したということです。
ここからは正直な話です。発表当日のベンチマーク表は常に割り引いて見る必要があります。あるHacker Newsのコメント投稿者が本音をそのまま口にしています。
"There are hundreds of benchmarks. You just need to pick a favorable dozen on release day."

その通りです。表そのものよりも私の心を動かしたのは、発表内にあった本物の、検証可能な長期実行の事例です。Rampは機械学習の問題に対して38時間、無人でモデルを稼働させ続けたところ、モデルは以前の結果をラベルのアーティファクトだと診断して修正し、6つの並列的な夜間実験を開始しました。Millenniumは、100万回に1回しか発生しないクラッシュの原因を、これまで4〜5年間エンジニアもモデルも解明できなかったにもかかわらず突き止めたと報告しています。そしてBrowserbaseの最も難しいブラウザエージェントベンチマークでは、Opus 5の74%、Fable 5の57%に対して82%のタスクを、より少ないトークンで完了しました。これはベンチマークのスコアだけでは十分に伝えきれない種類の結果です。
実際に使ってみた実務者たちも、コーディングに関する評価に同調しています。
"I've tested Claude Fable 5.1 over the last week. Everyone should try this model... this model is delight to work with and has the depth of the Fable models. I really trust this model"
他のコーディングモデルと直接比較したい場合は、最高のAIコーディングアシスタント、トップAIエージェント、GPT-5.3 Codexの代替のまとめ記事が期待値を整理するのに役立ちます。
effort設定の仕組み
実務でFable 5.1を理解するうえで最も役立つのは、ベンチマークではなくeffortという調整つまみです。
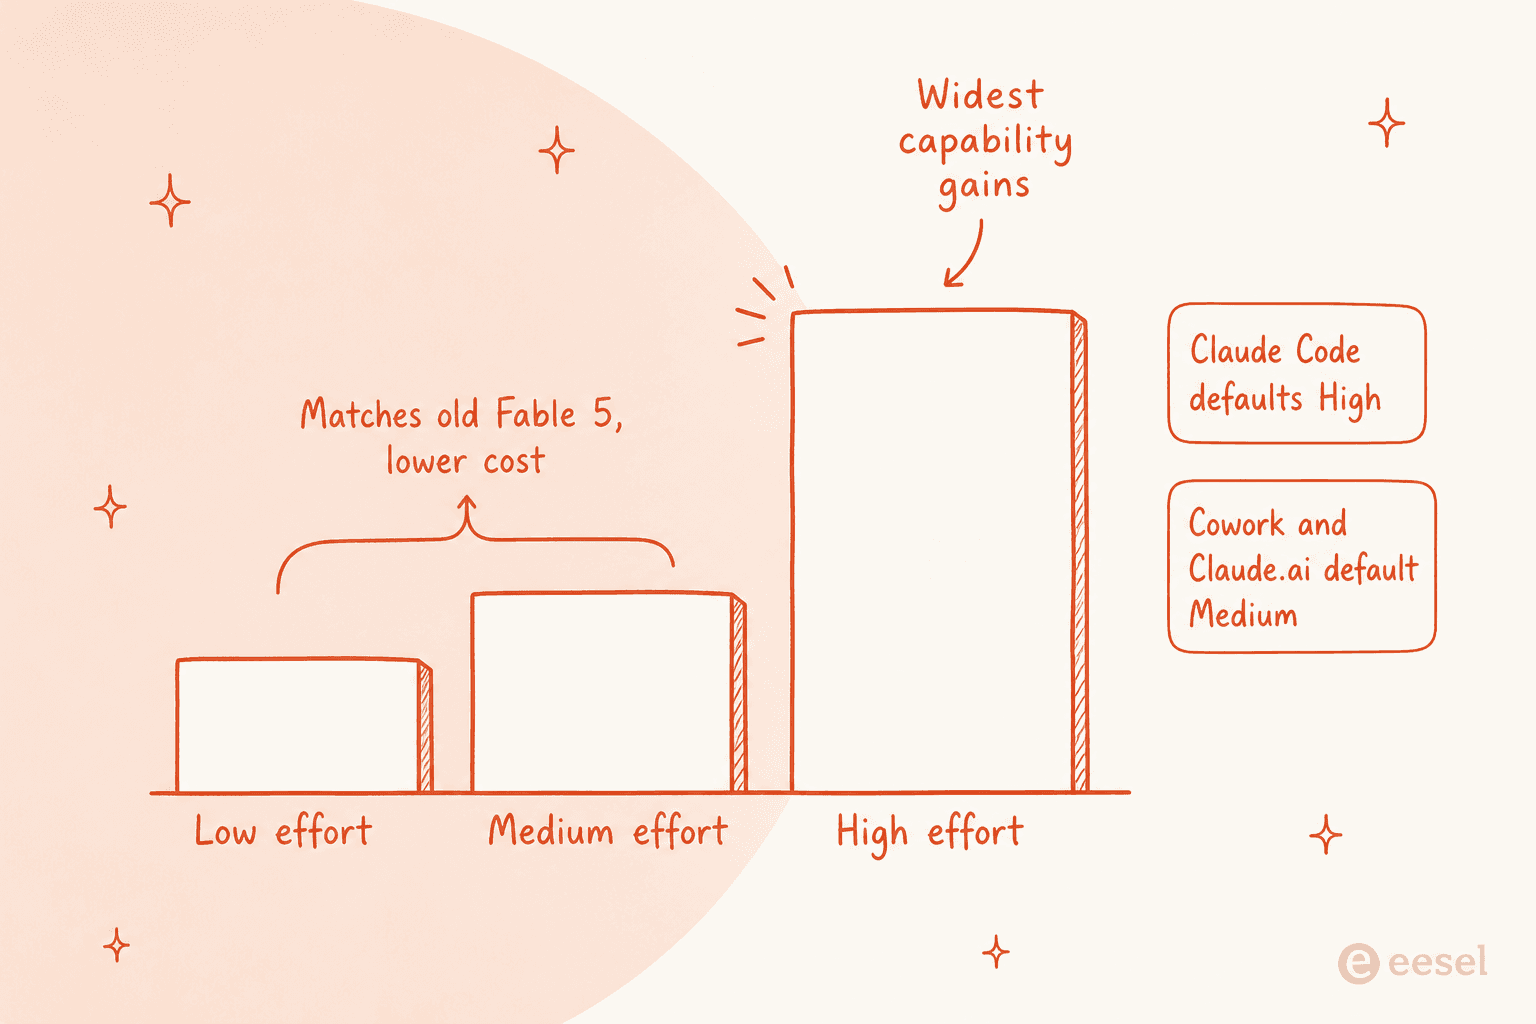
アダプティブシンキングは常にオンで、effortはその量をどれだけ得られるかを制御します。Anthropicが掲げる設計目標は、低または中程度のeffortであれば、Fable 5.1がはるかに低いコストでFable 5と同等かそれ以上の性能を発揮するというものです。Fable 5との差が最も大きくなるのは高effort時です。デフォルト値は利用面によって異なり、Claude Codeでは高、Claude Coworkおよびclaude.aiでは中です。つまり同じモデルが、たった一つのパラメータ次第で、コスト重視の働き手にも最大深度の専門家にもなり得るということであり、これこそが安くなったキャッシュ読み取りを本当に活かす仕組みです。
とはいえ、誰にとっても明確な勝利というわけではありません。あまり一般的でない言語で作業する開発者からは反論もありました。
"I write a lot of Rust and Lean, Fable 5 is in my experience better at both. Cost/performance is a different story."
これは有用な戒めです。「すべてのベンチマークで首位」というのはあくまで平均値であり、あなたのワークロードは、旧モデルの方が純粋な品質で勝るような裾野の部分に位置しているかもしれません。移行する前に、LLM最適化に関するあらゆる判断と同じように、自分のタスクでテストしてください。
落とし穴:ガードレールと信頼
私は取り上げるすべてのツールに対して公平でありたいと思っていますが、それは両方向に働きます。発表当日にFable 5.1について最も繰り返し寄せられた不満は、性能ではなく拒否についてでした。
Anthropicはガードレールをより精密にしたことは事実です。Claude Codeのユーザーは、Fable 5と比べてセッションあたりサイバー関連ガードレールの介入が約60%減少すると見込まれ、生物学関連のガードレールも、無害な初等教育レベルの質問に対しては85%少なく発動するようになりました。クエリが実際にフラグ付けされた場合は、Opusモデルにルーティングされ、その分についてFableの料金は請求されません。これらは実際に測定可能な改善です。
しかし開発者は依然として誤検知に遭遇しており、時には自分自身のコードに対してさえそうです。
"Fable is useless. Me: 'Find my security problems in my own code. This is code I own. I'm doing this under authorization of the CEO/CTO of our company.' Fable: 'yeah, no.'"
"The main issue was that Fable was unpredictable and prone to false positives by the safeguards... it still seems completely unable to understand its own guardrails and will readily reason itself into triggering them."
新しい透かしとモデルに紐づいたThinkingブロックも加わり、モデルが有能になるほどユーザーに対して疑い深くなっていると感じる人々の流れが実際に存在します。このトレードオフに見合う価値があるかどうかは、完全にあなたの業務内容次第です。防御的なセキュリティチームは、文書を書いている人よりもこれをはるかに強く感じるでしょう。これは考慮に値する事実ではありますが、ほとんどの人にとって致命的な欠点ではありません。
サポートやコンテンツ制作においてFable 5.1がどこに位置づくか
ここで提唱したい視点の転換は、3年以上にわたって実際のライブサポートキューにAIを導入してきた経験からeeselが学んだことです。あなたが雇うのはモデルではなく、モデルを使いこなすチームメイトです。
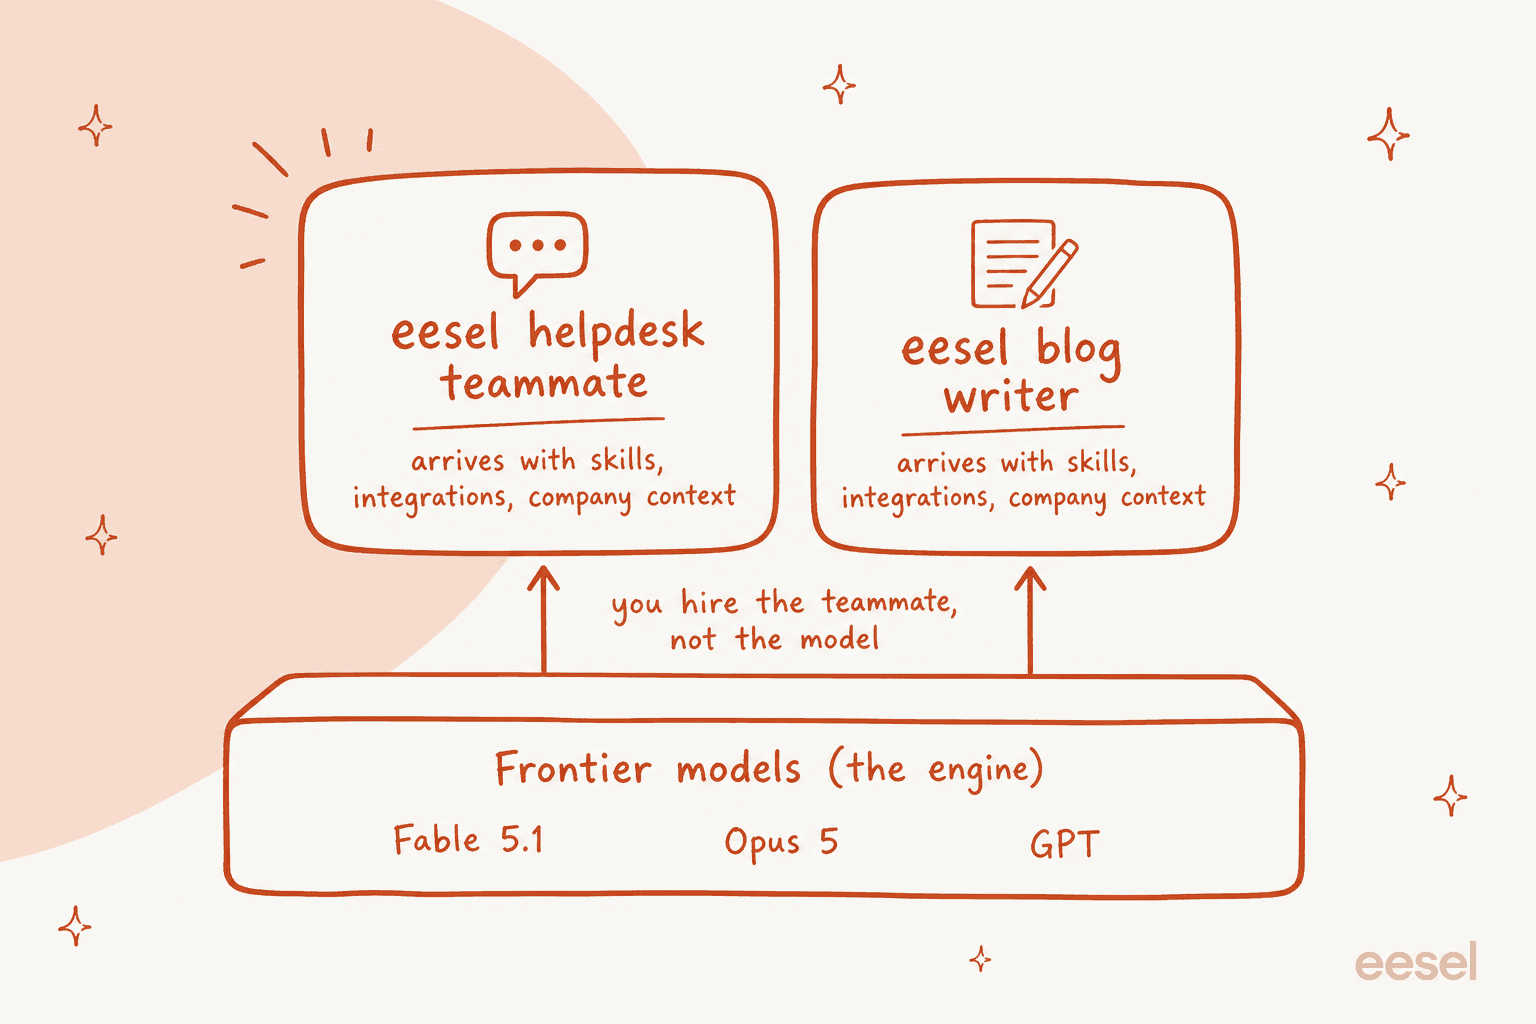
Fable 5.1はインフラであり、生のエンジンです。サポートマネージャーはツールループを書いたり、過去のチケットに対する検索を構築したり、拒否への対応や、トークン予算の管理をしたいわけではなく、単にチケットを解決したいのです。フラッグシップモデルと実際に機能するソリューションの間にあるこのギャップこそ、eeselのような製品が存在する場所です。弊社のAIヘルプデスクエージェントはこのようなフラッグシップモデル上で動作しますが、すでにあなたのヘルプセンターと過去のチケットで学習を済ませた状態で、既存のヘルプデスクに組み込まれて届きます。

そして、自信たっぷりに聞こえるボットが実は静かに間違った答えを返しているのを見てきたからこそ、すべてのeeselの導入は実際の顧客に触れる前に過去のチケットに対してシミュレーションされ、実際にどのようなパフォーマンスを発揮するかを確認できます。これはclaude-fable-5-1を自分で呼び出すのとはまったく異なる提案です。選択肢を検討しているなら、最高のカスタマーサービスAIやカスタマーサービス自動化のためのAIについての弊社ガイドが何を見るべきかを解説しており、自前で構築する道を選びたい場合はカスタムサポートGPTの構築方法がDIYの道筋を示しています。
まずカテゴリ全体を把握したい場合は、最高のAIヘルプデスクソフトウェア、AIカスタマーサービスチャットボット、サポート向けAIコパイロットについての弊社ガイドが全体像を整理しています。
コンテンツ面でも構造は同じです。Fable 5.1のライティングは本当に向上しており、Canvaは「際立っているのはライティングだ」と述べ、Gleanの評価者はFable 5に対しておよそ2対1の割合でその回答を好みました。しかし生モデルによる文章が良くなったとしても、キーワードリサーチをしたり、内部リンクを配置したり、実際の情報源を引用したりはしません。
その足場作りこそが本当の仕事であり、だからこそ単なるチャット画面よりもAIブログライターの方が公開作業において優れており、弊社のAIブログ執筆ツールのまとめ記事が存在する理由でもあります。
ワークフロー自体については、AIブログ自動化、ロングフォームAIライティング、そして実際のAIブログライターのコストについても掘り下げています。
サポートとコンテンツ向けにeeselを試す
eeselはAIチームメイトのプラットフォームです。生のモデルの代わりに、特定の職務向けにすぐ働けるチームメイトを採用します。AIヘルプデスクチームメイトはあなたのサポートキューに加わり、AIブログライターはSEOコンテンツをリサーチして執筆します。どちらもFable 5.1のようなフラッグシップモデル上で動作しますが、その役割に必要なスキル、連携、企業のコンテキストを備えた状態で届きます。
自分でモデルを組み込むこととの違いは、eeselがすでに使っているツール上で数分で稼働を開始し、既存のナレッジで学習し、実際の過去データでチームメイトをシミュレーションしてから本番導入できる点です。eeselを無料で試すことができ、クレジットカードも営業電話も不要で、実際に導入を決める前に、自分のチケットへの回答ぶりや自分の記事の執筆ぶりを確認できます。
Fable 5.1は驚くべきエンジンです。ほとんどのチームは、それが可能にする完成された仕事の成果だけを求めており、それこそが私たちが作っているものです。
よくある質問
Claude Fable 5.1の料金はいくらですか?
Claude Fable 5.1とFable 5の違いは何ですか?
Claude Fable 5.1はClaude Opus 5より優れていますか?
Claude Fable 5.1をカスタマーサポートに使えますか?
Claude Fable 5.1は文章に透かしを入れますか?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.