Claude Opus 5.5とは実際どんなものか
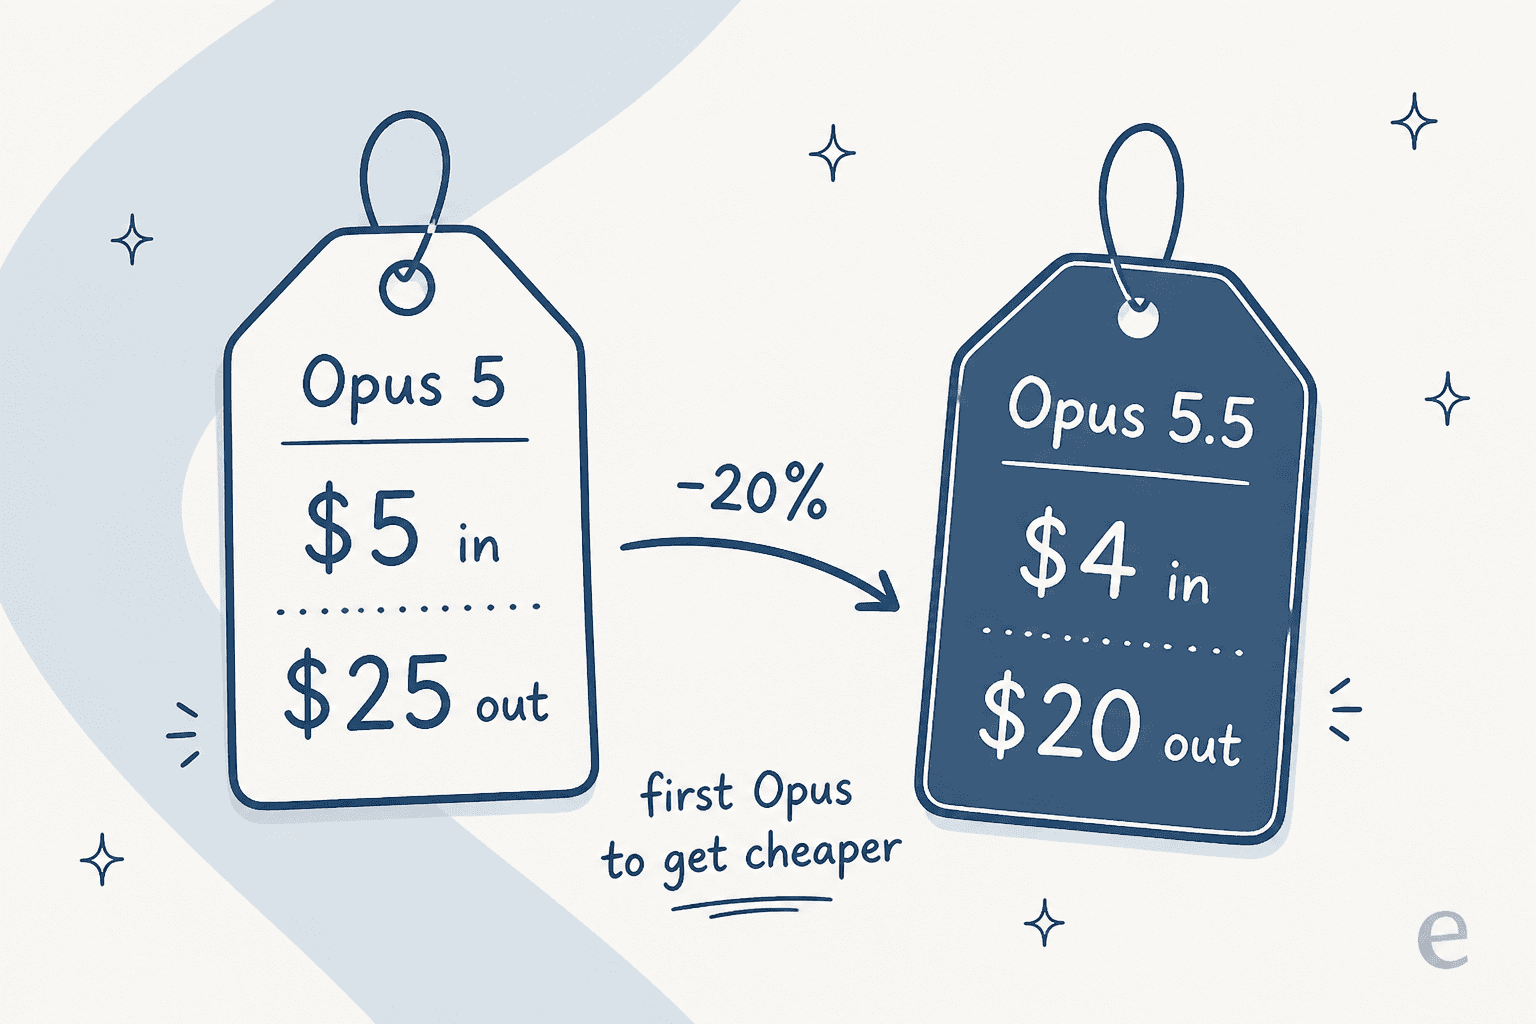
Anthropicは2026年9月22日にClaude Opus 5.5を発表した。これはゼロから作られた新モデルというより、Opus 5に対する効率化アップデートとして捉えるのが最も正確だ。注目すべきは逆転現象だ。これまでのすべてのOpusはプレミアム価格で登場してきたが、今回は置き換える対象のモデルより安く登場する初めてのケースとなった。
価格はOpus 5の$5/$25から100万トークンあたり$4/$20へと一律20%引き下げられた。これは小さく聞こえるかもしれないが、Opusが普段何のために使われているかを思い出せば話は別だ。長く、トークンを大量に消費する、自律的な作業であり、請求額は出力側が支配的になる。$20の出力単価が20%下がることは、多くのチームにとって実感しやすい部分だ。
価格とあわせて、内部でもいくつかの変化があった。デフォルトのエフォートはhighからmediumへ引き下げられ、思考は常時オンになり、AnthropicはOpusを最終手段のプレミアム階層として扱うのではなく、多くの作業でまずOpus 5.5から始めることを推奨するようになった。100万トークンのコンテキストウィンドウ、最大128Kトークンの出力(Batchでは300K)、ネイティブなビジョン機能、そして2026年6月の知識カットオフを備える。Claude Maxのデフォルトモデルであり、Claude Proで最も強力なモデルであり、エージェント的コーディング向けのClaude Codeを動かしているのもこのモデルだ。
エフォートダイヤルこそがこのレビューのすべて
私はeeselでAIエージェントを構築しているので、フロンティアモデルの新登場のたびに同じ作業をこなす。評価を再実行し、完了タスクあたりのコストを確認し、何を変えるかを決める。Opus 5.5について最も驚いたのは品質そのものではなく、エフォート設定が使い方全般をここまで支配している点だった。
その仕組みはこうだ。Opus 5.5はlow、medium(新しいデフォルト)、high、very high、maxという5段階のエフォート制御を公開している。エフォートを上げるということは、単に漠然と「より頑張る」という意味ではない。モデルがより長く推論し、回答前にはるかに多くのトークンを出力するということだ。難しいタスクで最大エフォートを使った場合、出力トークンはおよそ119kに達したが、低エフォートでのはるかに軽い実行と比べるとその差は大きい。出力は100万あたり$20で課金されるため、実質的にエフォートダイヤルは品質のラベルをかぶったコストダイヤルだと言える。
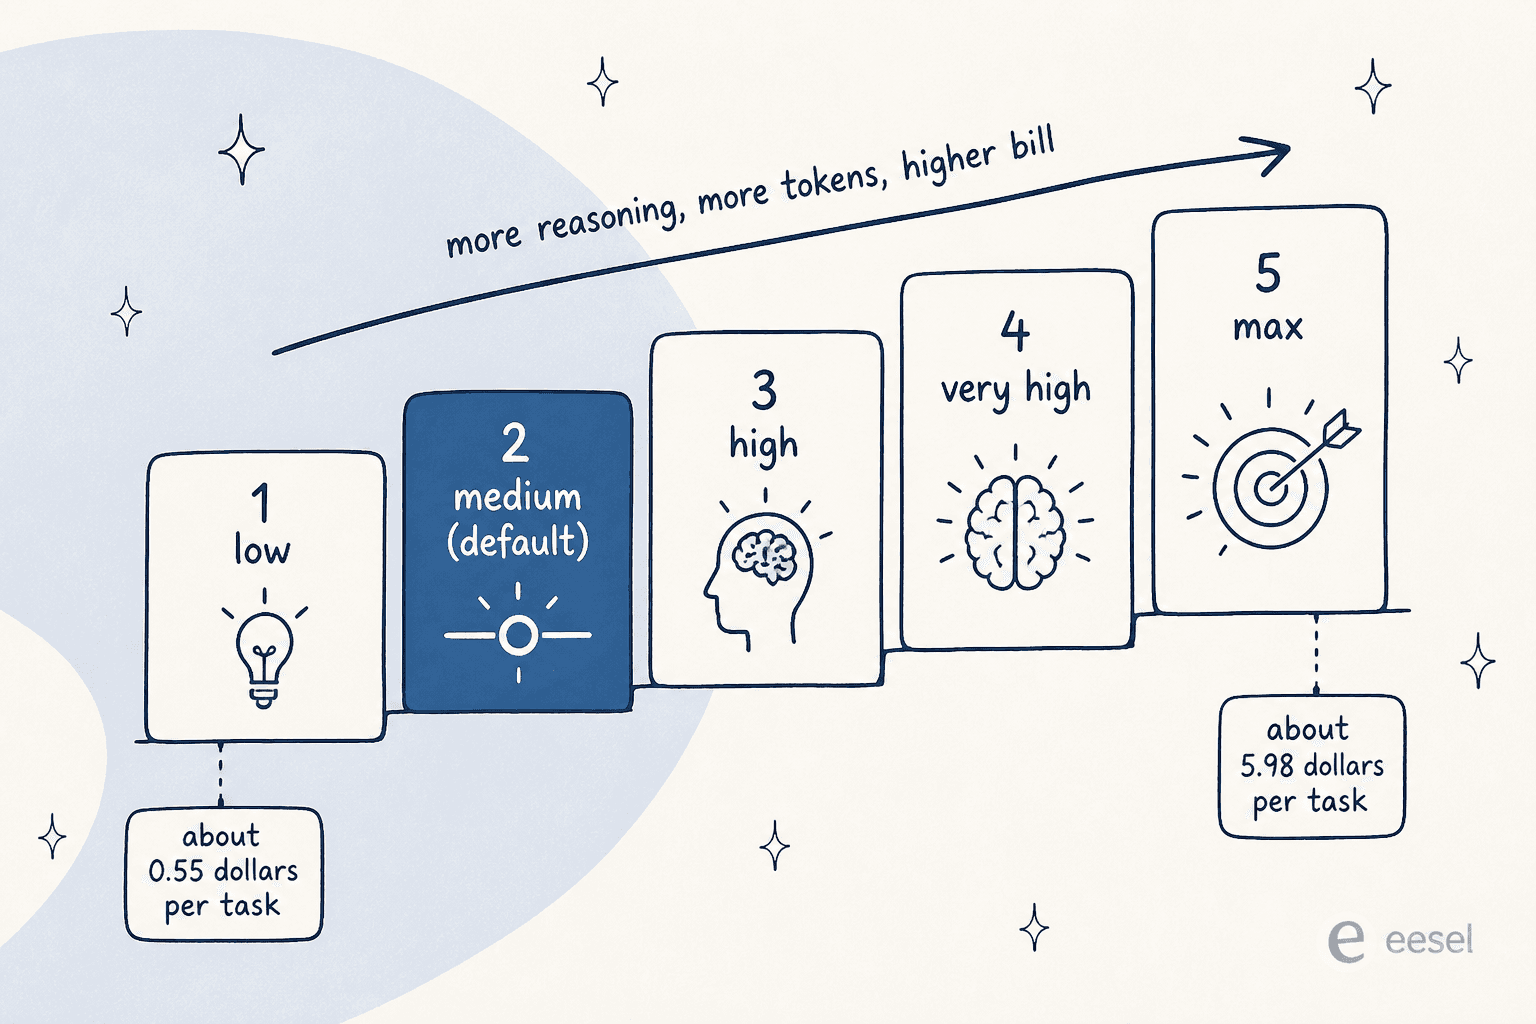
だからこそ、トークン単価はほとんど注意をそらす存在でしかない。Artificial Analysis自身の計測によれば、同じ難しいタスクは低エフォートで約$0.55、中エフォートで約$1.34、最大エフォートで約$5.98かかる。支払っている分だけ知能も上がる。低エフォートの実行はIntelligence Indexで42点、中エフォートは51点、そして最大エフォートでのみ見出しの58点に達する。つまりOpus 5.5を導入する際の本当の問いは「払えるかどうか」ではなく、「このタスクの基準をまだクリアできる最も低いエフォートレベルはどれか」だ。多くの場合、それはmediumになる。
これはOpus 5、つまりデフォルトのエフォートがhighだったモデルから移行する人にとって、最大の落とし穴でもある。同じワークロードを設定を変えずにOpus 5.5に移した場合、タスクあたりの請求額はむしろ下がる可能性がある。デフォルトが一段階下がっているためだ。これは実によく考えられたデフォルト設定だが、定価だけからコストを推測できないということでもある。
ベンチマーク:ほぼすべての項目で勝利
一旦価格を脇に置くと、純粋な能力においてOpus 5.5は明確なリーダーだ。Artificial AnalysisのIntelligence Indexでは58で1位に立ち、フロンティアモデル群の先頭を走る。単一のベンチマークだけのまぐれ当たりでもない。GDPval-AA(1846)、AutomationBench、そしてエージェントにとって最も重要な長期間のコーディング評価でも首位に立っている。
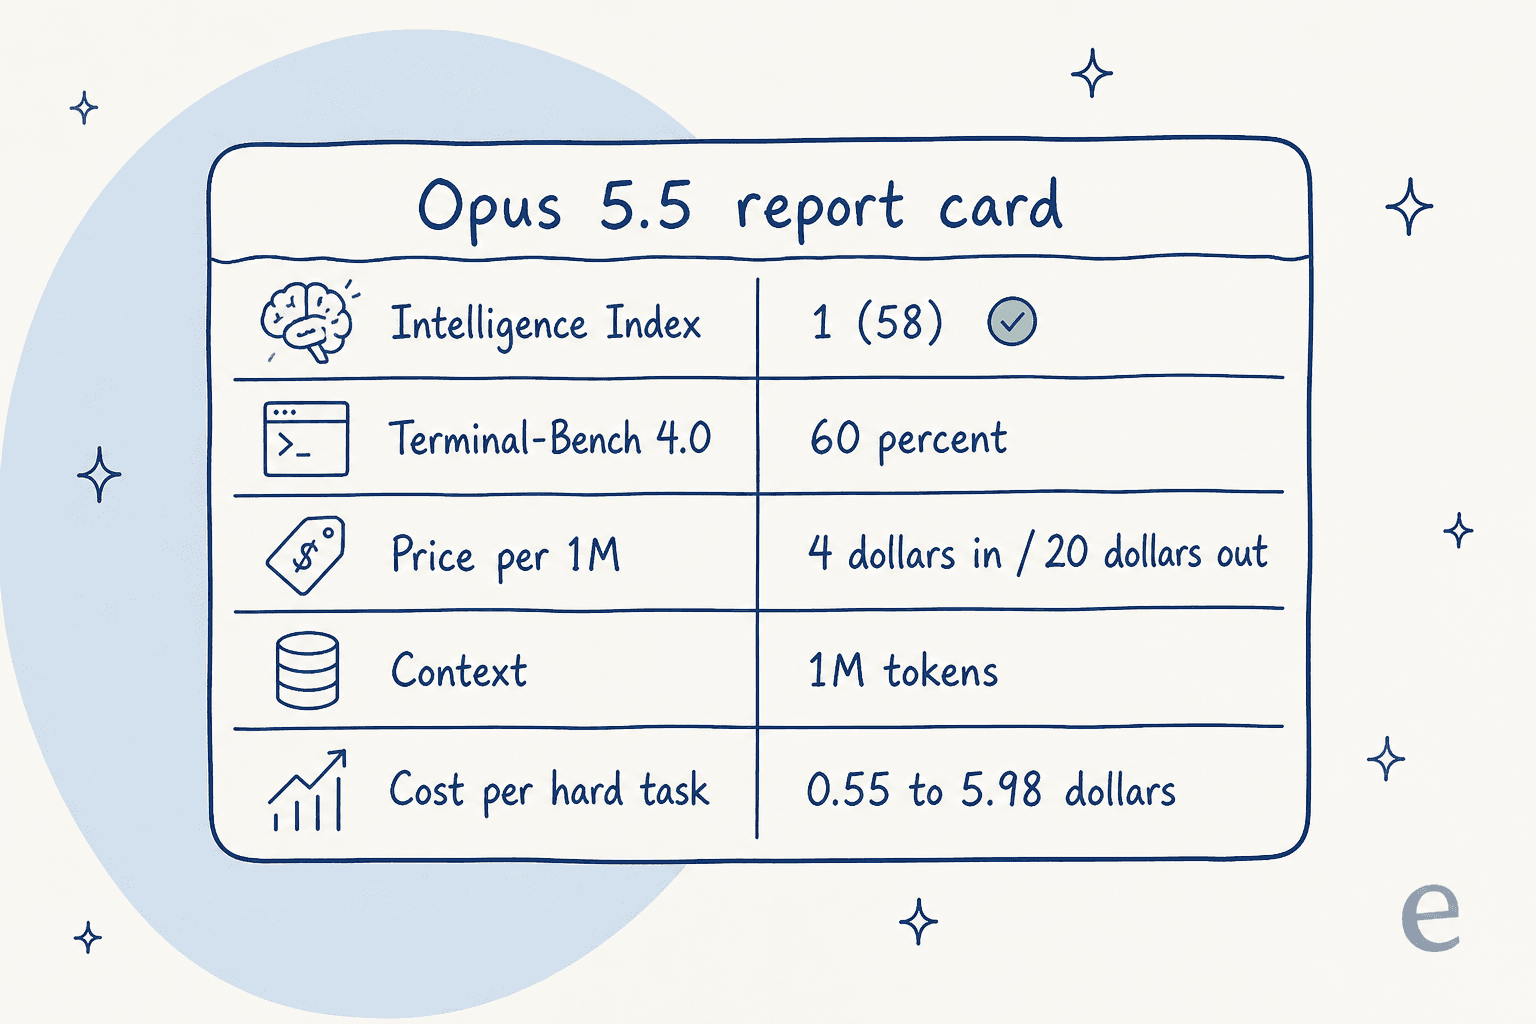
最も顕著に差がつくのがコーディングの物語だ。Artificial Analysisのハーネスを通じて最大エフォートで実行されたTerminal-Bench 4.0において、Opus 5.5は60%を記録し、価格帯が最も近い競合の44%を大きく上回った。これはまさに、長時間のエージェント的コーディングの実行で行き詰まりが減る種類の差であり、Anthropicがこのモデルを調整した対象そのものだ。難しく、自律的で、複数ステップにわたるエンジニアリング作業をこなすなら、これは他のモデルが行き詰まるタスクを完了させるモデルだ。
一点補足しておきたいのは、最高スコアが最大エフォート時の数字であり、最大エフォートはタスクあたり$5.98かかる設定だという点だ。Opus 5.5を王座に押し上げているベンチマークは、最も高くつく状態で測定している。それ自体は公平だ。どのモデルも上限性能で測定されるものだが、常にmaxに料金を払わない限り、リーダーボードでの勝利と日常的な体験は同じものではないということでもある。
Claude Opus 5.5の実際のコスト
「〜から」という価格表示はトークンを大量に消費する作業でこそ痛みを伴う部分を隠してしまうため、ここで料金表を完全に示す。
| 項目 | 料金 |
|---|---|
| 入力(100万トークンあたり) | $4 |
| 出力(100万トークンあたり) | $20 |
| キャッシュ読み込み(100万トークンあたり) | $0.20 |
| 長いコンテキストの追加料金 | なし |
| コンテキストウィンドウ | 100万トークン |
| 最大出力 | 128Kトークン(Batchでは300K) |
| 難しいタスクあたりのコスト(AA) | $0.55(low)〜$5.98(max) |
2つの項目は特に注目に値する。まず、長いコンテキストへの追加料金がない点だ。これは一定のしきい値を超えると入力単価が倍になる競合他社とOpus 5.5を分ける特徴で、巨大なコンテキストの作業ではこの一律料金がトークンあたりの差を静かに縮めている。次に、キャッシュ読み込みが100万あたり$0.20であることから、大きく安定したシステムプロンプトに短い質問が続くようなワークロードであれば、入力コストの大部分を安く抑えられる。
簡単な計算例を挙げよう。仮に1か月に1,000件の難しいエージェントタスクを実行するとする。中エフォート(1件$1.34)ではおよそ$1,340だ。同じ1,000件を最後の数ポイントの知能を求めて最大エフォートに移すと、およそ$5,980になる。この4倍の振れ幅はプラン変更ではなく設定の選択であり、Opus 5.5を大規模な用途に導入する前に黒板に書き出しておくべきタスクあたりのコストだ。BatchやリージョンごとのレートまでのフルなbreakdownについてはOpus 5.5の料金ガイドを、そしてもう一つのフロンティアプラットフォームとの比較についてはOpenAI API vs Anthropic APIの記事を参照してほしい。
Opus 5.5が価格に見合う場面、見合わない場面
適性について具体的に述べておきたい。「最高のモデルだ」という言葉は真実であると同時に、あまり役に立たないからだ。
価格に見合うのは、タスクが難しく、長く、失敗すると高くつく場合だ。実際のコードベースをリファクタリングする数時間規模のコーディングエージェント、巨大なコンテキストを保持しながらそれを横断して推論する必要のあるリサーチタスク、安価なモデルでは堂々巡りになる曖昧な問題などがそれにあたる。こうしたケースでは、追加のトークンはもっともらしく見えるだけの行き詰まりではなく、完成した成果を買うことになり、その請求額は節約できるエンジニアの工数に比べれば安いものだ。
適さないのは、タスクが明確に定義され、量が多い場合だ。分類、短い返信、翻訳、単純な検索など、ほとんどの本番ワークロードの退屈な80%がそれにあたる。中間層のモデルで難なくこなせる作業にOpusの料金とOpusのレイテンシを払うのは、取り戻せないお金と速度を失うことを意味する。Opusは設計上、意図的に慎重に考えるモデルであり、チャットの返信のように人間がリアルタイムで待っているものについては、Intelligence Indexの最後の数ポイントよりも応答性の方が重要になる。それこそが2モデル構成を採る理由だ。本当に難しいタスクはOpus 5.5に、それ以外はSonnet 5に振り分けるか、あるいはOpus 5.5の代替モデルのまとめ記事にあるより安価な選択肢を検討するのもいいだろう。
正直な一言でまとめるなら、Opus 5.5は最高のモデルであり、そして「最高のモデル」であることは「このタスクに正しいモデル」であることとはめったに一致しない。
実際に語られていること
ローンチスレッドの反応は私自身のテスト結果と一致していた。能力に対する率直な敬意と、リーダーボードよりもエフォートダイヤルのラベルの方が重要だという繰り返しの指摘だ。経験豊富なテスターの一人は、翌日にローンチされたフロンティア級の競合モデルと比較し、次のように結論づけている。
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

この「at medium」という一言が非常に大きな意味を持っており、それこそがこのレビュー全体の要点だ。もう一つ強調しておく価値のあるテーマは、2026年においては単一のベンチマークが選択を決めるべきではないということだ。
Only hands-on experience matters in the end, and these days it's very easy to switch models.
この最後の一節、「very easy to switch models」こそが今年の本当のテーマであり、そのままほとんどのモデルレビューが避けている問いへとつながっていく。
eeselを試す:どのモデルでも動くチームメイト
すべてのモデルレビューは、読者の仕事がモデルを選び、そのAPIを組み込み、プロンプトエンジニアリングをこなし、自社のツールに接続し、実際の顧客に対してハルシネーションを起こさないよう防ぐことだと暗黙のうちに想定している。しかし、ほとんどのチームにとってそれは本来の仕事ではない。本来の仕事は、より高い解決率であり、公開された記事だ。Opus 5.5のようなフロンティアモデルはインフラであり、エンジンであって従業員ではない。

私がeeselをそう位置づける理由はここにある。これはAIチームメイトのプラットフォームであり、特定の仕事のためにすぐ働けるチームメイトを雇うイメージだ。現在のラインナップには、既存のサポートキューに参加するAIヘルプデスクチームメイトと、調査済みの記事を執筆するAIブログライターがある。それぞれ最初から自分の仕事を理解した状態で到着し、あなたのツールに接続され、会社のコンテキストに根ざしているため、エフォートレベルの選択やプロンプトの世話をするのはあなたではない。モデルはチームメイトの下に位置するため、来月登場するより安価で賢いモデルは作り直しではなく無料のアップグレードとなり、AIヘルプデスクチームメイトはトークン単位ではなく解決したチケット単位で課金されるため、上記のエフォートダイヤルの計算はもはやあなたの問題ではなくなる。
モデルレビューを最後まで読むタイプの人なら、この部分も気に入るはずだ。すべてターミナルから操作できる。eesel CLI(npx @eesel/cli)は連携の接続、エージェントの恒常的な指示の編集、過去のチケットに対するロールアウトのシミュレーション、アクションの承認、そしてすべての実行のアクティビティログの読み取りをJSON形式で行え、書き込みが送信される前に実際に行われる呼び出しを表示する--dry-runフラグも備えている。各ワークスペースはMCPサーバーでもあるため、Claude Code、Codex、Cursorのようなコーディングエージェントも同じチームメイトを操作できる。これはダッシュボードと同じ製品であり、ターミナルで生活する人やエージェントに向けて公開されている。eeselを無料で試すことができる。
よくある質問
2026年、Claude Opus 5.5は導入する価値があるか?
Claude Opus 5.5の料金はいくらか?
Claude Opus 5.5のエフォートダイヤルとは何か?
Claude Opus 5.5はコーディングに向いているか?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.