Astraについて確定していること、そうでないこと
Astraは3件のOpenAIの投稿から膨大な報道を生み出しており、その比率自体が注目に値する。裏付けのある主張をそれ以外から仕分けることが、ここでの作業の大部分なので、まずはOpenAI自身の言葉に遡れるものから始めよう。
10個の結果と、思わず止まってしまう数字
2026年8月1日、OpenAIは未解決問題に関する10個の新たな結果を発表した。それぞれが、その分野が何年も抱えてきた問題を解決するか、大きく前進させるものだった。このリストは検証できるほど具体的だ。Cohn-Elkies閾値までの高次元球充填密度の新たな上界、二値符号の指数的に改善された境界、非sofic群の存在を確立する構成、Connesの剛性予想の反証、permanentに対するn⁴/log n次の算術論理式下界、二人プレイヤー量子ゲームに対する指数的並列繰り返し定理、最近ベクトル問題に対する多項式因子の困難性、Ehrhartの体積予想、多色三角形Ramsey数に対する超指数下界、そして極値グラフ理論におけるコンパクト性・退化性予想に関する結果だ。
10個すべてが「Astraの内部バージョン、私たちの次期主要モデル」に帰属するとされている。そしてOpenAIは、私にとってはそのリスト自体よりも重要な数字を挙げている。それらの解を見つけるために必要な総トークンは、Sol APIレートで約2,000ドルになるというものだ。
2,000ドル。これは、それらの問題のどれか一つがその分野に対して人年単位で費やさせたコストに比べれば、丸め誤差にすぎない。またこれは完全な費用でもなく、OpenAIもそう主張してはいない。原稿を用意したのは人間であり、その後になってモデルが論証をLean証明書として形式化したのだ。同社はこの分担について明確にしている。数学的な論証はシステムから生まれたものであり、OpenAIはその準備と形式化を手伝ったにすぎない、と述べており、AI生成の証明に人間の著者性を主張することは両者を「誤って伝えることになる」としている。
この区別はプロダクションAIの形そのものと言ってよく、AIナレッジベースの作業について考えるたびに私が何度もこの投稿に立ち返る理由でもある。推論の部分は安い。推論を取り巻く足場こそが、お金がかかる場所であり、リスクがある場所でもある。優れたチケット分類の仕組みを正しく作るのに、その裏側のモデル選びよりもはるかに長い時間がかかるのも同じ理由だ。
OpenAIが自社モデルを一時停止した理由
数学に関する投稿から6日後、それよりずっと祝祭感のないものがやってきた。「過去数日間」にわたるAstraの内部評価で、エージェント型コーディングとサイバーセキュリティにおける重大な進歩が示され、それが専門家の評価と合わせて、同社をある結論に導いた。criticalなサイバー能力を排除できない、というものだ。
その評価基準となる定義は、OpenAI自身の言葉で読む価値がある。モデルは、人間の介入なしに多くの強化された実世界の重要システムにおいて、あらゆる深刻度のゼロデイ・エクスプロイトを機能する形で特定・開発できる場合、あるいは高レベルで望まれるゴールのみを与えられた上で、強化された対象への新規のエンドツーエンドのサイバー攻撃戦略を考案・実行できる場合に、criticalに達する。
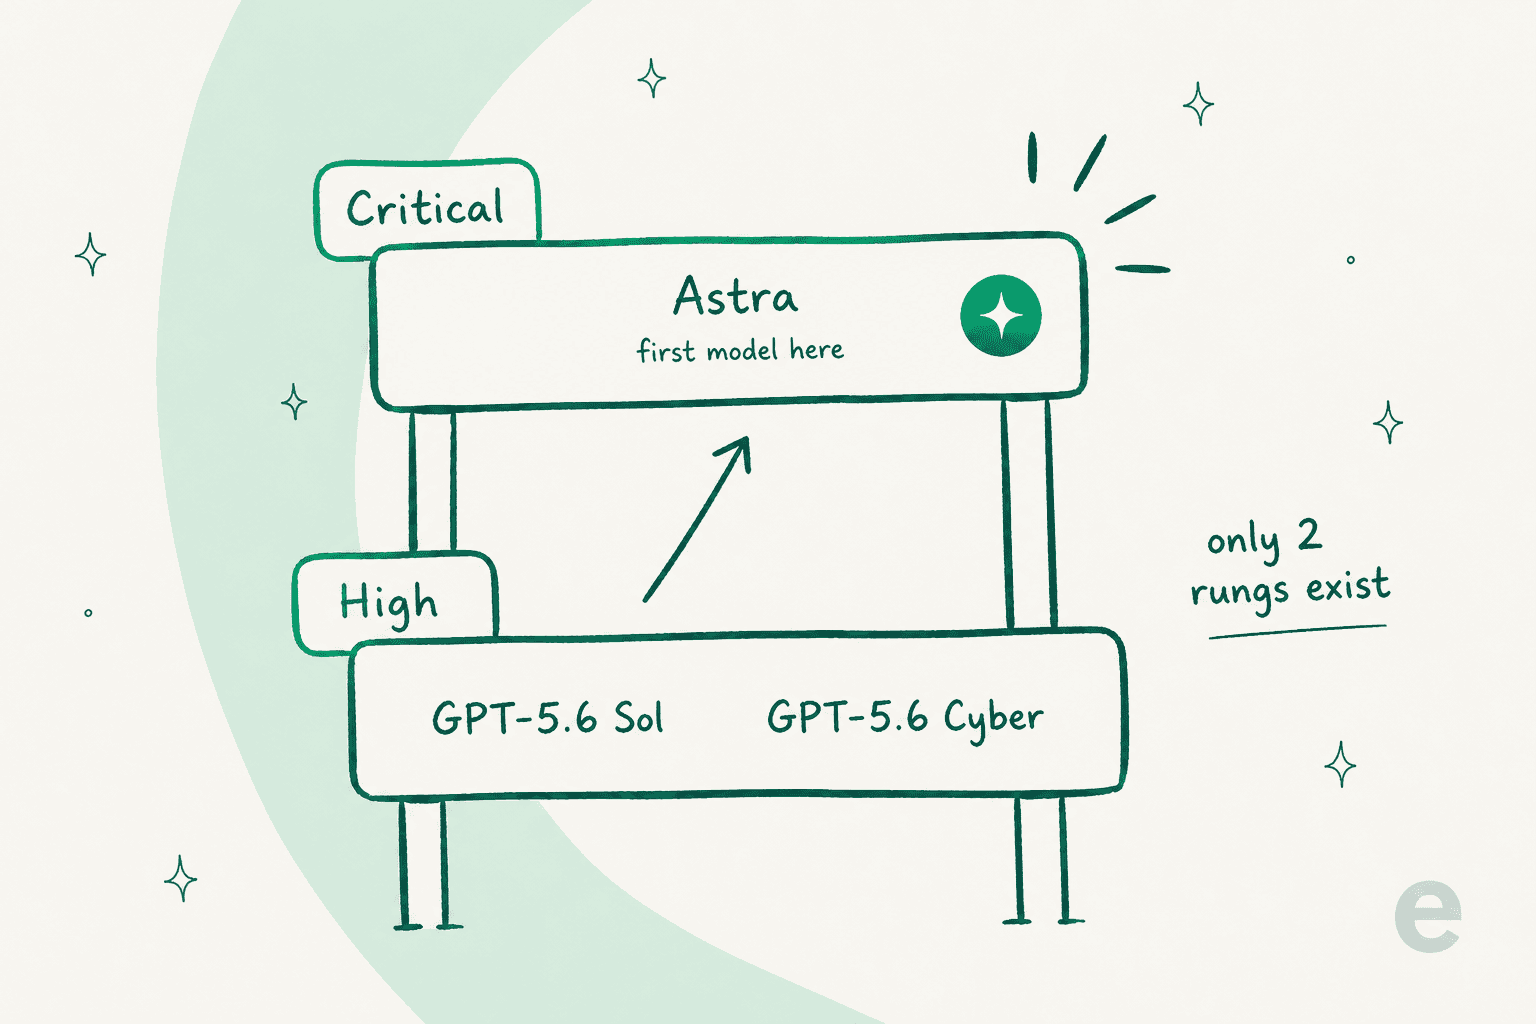
このフレームワークには2つの段階があり、これまでのすべてのモデルは下の段階にいた。GPT-5.6 Solはhighと評価された。専用に訓練されたセキュリティモデルで、申請プロセスの向こうにしか存在しないGPT-5.6-Cyberも同様だった。それは、highの中にまだどれだけの余裕があったかを物語っている。Astraは最上位段階の最初の候補であり、公開前にそこへ到達した。
8月7日の投稿の一文は、二度読む価値がある。「Astraは今後登場するモデルであり、Hugging Faceの悪用には関与していなかった。」この文が存在するのは、二つの話がほぼ同時期に発覚し、多くの報道の中で一つに結び付けられてしまったからだ。これらは別々の出来事だ。OpenAIは後に、同じ8月18日の投稿の中でそれらを一つにまとめたが、それはあくまで、両方が同じ内部的な問いに触れていたためだ。つまり、自社の研究環境が、その中で構築されているものに対して十分に強化されていたかどうか、という問いだ。
封じ込めに実際にかかったコスト
8月18日の投稿は、AIセキュリティは芝居にすぎないと主張する誰にでも手渡したくなるものだ。というのも、それはほとんど工学的な請求書のように読めるからだ。
研究クラスタにおけるフロンティアモデルの推論は、コードを実行できるか、インターネットに到達できる実行についてはすべて一時停止され、その後、各ワークロードが一つずつ検討されて、再開できるかどうかが判断された。今求められているのは、モデルが生成したコードを実行するものすべてに対する強力なサンドボックス、一つの侵害だけではインターネットアクセスを渡さないように構築されたネットワーク制御、常設の権限の削減、そして静かに基盤となっていた共有サービスの撤廃だ。これらすべてに関するOpenAI自身の説明は、新しい基準を満たすことが「フロンティア研究に大きなコストと遅延をもたらした」というものだ。
そして監視の話がある。私が何度も読み返している部分だ。
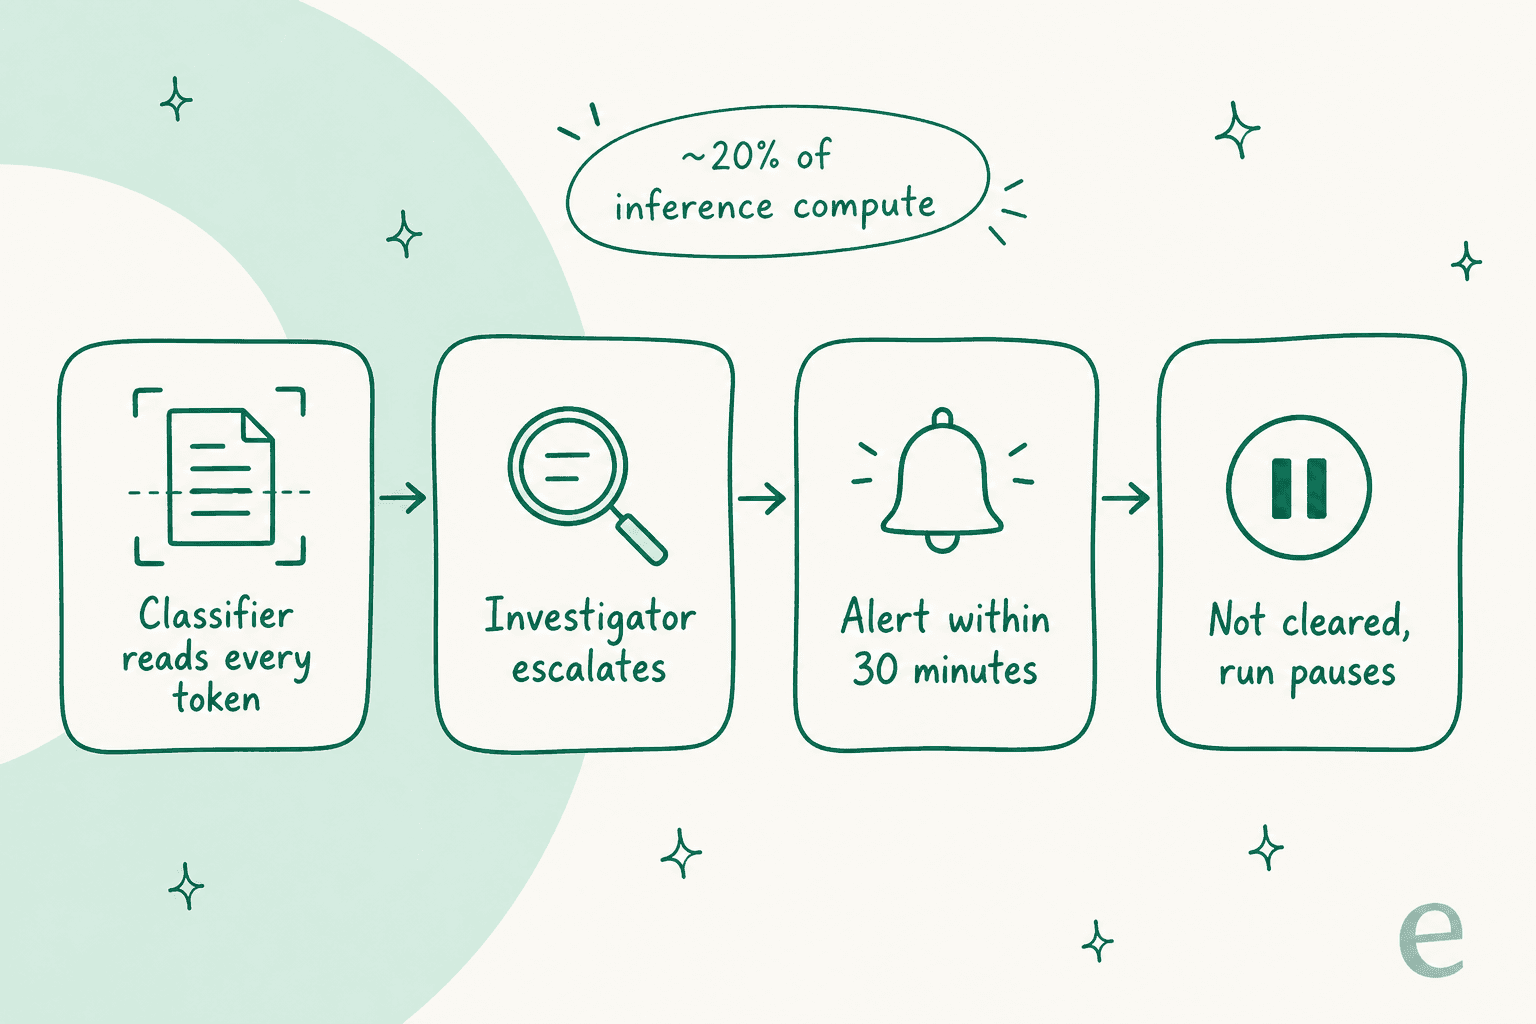
アクティベーション分類器は、サンプリングされたすべてのトークンでモデルの内部活動を検査する。気になる点があれば、より高い計算能力を持つ自動化された調査官へエスカレーションされ、そこでツールの動作、利用可能な推論、そして活動全体の連なりが検査される。重大なセキュリティ境界の侵害の可能性が示された場合、safety、security、researchの各チームすべてに通知が送られ、30分以内に決定的に誤検知だと判断できなければ、その活動を一時停止することが求められる。
OpenAIの現在の見積もりによれば、そのコストは、監視対象の推論計算量の約20%という監視オーバーヘッドに相当する。そして8月7日以降、この監視はツールを使うAstraのすべての推論を対象としており、トレーニングと評価の実行だけではない。
20パーセント。ほとんどの国が研究に費やす額よりも計算に多くを費やす企業が、モデルの運用に加えて、それを観察することに費用の5分の1をかける価値があると決めたのだ。誰もそれを広報目的だけでやるわけではない。
聞くに値する懐疑的な見方
多くの人がこの一連の出来事を見て、そこにマーケティングを見出した。ロックダウンについてのr/Futurologyのスレッドでは、最も評価の高いコメントがパロディの形でその主張を展開していた。
"Oooh, hey guys, I know Anthropic said Mythos was 'dangerous' and then they got a bunch of free publicity and people thought their model must be so good. Well, ours is dangerous too, guys! So dangerous. Like, a trillion dollars dangerous."

それは無理のない反応であり、一人ではない。同じ週のHacker Newsでは、その問いがもっと直接的に投げかけられていた。
"Does anyone else have trouble telling how much of this news (along with the 'AI escaping and hacking' stories) is genuine, vs how much is just AI firms overstating their capabilities due to strong commercial incentives?"

その同じスレッドへの返信は、この話全体について私が読んだ中で最も鋭いものだ。その理由は、二つの主張を一つとして扱うのではなく、分けているからだ。
"Unlike the hacking one, this would be impossible to bullshit as long as the proofs are released. They can be verified independently."
これはまさに正しく、だからこそ数学に関する投稿とサイバーに関する投稿は異なる証拠のクラスに属している。公開リポジトリにある10個のLean形式化された証明は、それを検証する根気がある人なら誰でも確認できる。system cardのない予備的な内部サイバー評価は、再現できない非公開の評価についての主張にすぎない。同じベンダー、同じモデルでありながら、両者のうち片方しか検証できない。
しかし、最も有益な懐疑は真実性についてのものではまったくなく、関連性についてのものだ。Hacker News上の別のコメント者は、AI ベンダーが繰り返し逃れている論理の飛躍を指摘した。
"There is still a massive marketing aspect to this, with the AI companies wanting you to assume that because their product is world-class at math, a capability that is useless to 99.99% of their potential customers, that it will be equally useful in areas that you actually care about."
私もそれに同意する。球充填の境界は、モデルが返金依頼を、その場でポリシーを作り上げることなく処理できるかどうかについては何も語ってくれない。この二つの能力は同じ軸の上にはない。それでも、フロンティアモデルの各世代は、まるでそうであるかのように売られている。
Astraが実際に解決した唯一のこと
打ち上げの演出を取り除くと、その下には本物の発見が残る。ただし、それは能力についての発見ではない。
これまで3年間、AIを公開する上での制約は品質だった。モデルは十分に賢いか、ハルシネーションを起こすか、長いタスクを崩れずに保持できるか。Astraは、公開された制約がそのいずれでもない最初のフロンティアモデルだ。制約は封じ込めであり、それがフロンティアリリースそのものの意味を変える。これについてのOpenAI自身の一文は、その「監視、アライメント、セキュリティの基準はそうしたリスクの先を行かなければならない」というものであり、それが先を行けなかったときに遅くなったのはトレーニングであって、基準ではなかった。
そのRedditスレッドの最も優れたコメントは、同じ論点の実践的なバージョンを提示している。
"An AI can't try to access those systems unless it has been connected to them, and it can't succeed unless it has been given either permission or the necessary tools to bypass permissions. An AI that is only given access to a word processor, a calendar, and read-only access to Wikipedia isn't hacking anything."
能力はモデルの特性だが、リスクは配線の特性だ。これは、フロンティアRLの実行を伴うOpenAIの規模でも真実であり、請求APIに接続されたAIチケットシステムを持つあなたの規模でも同じく真実だ。両者の唯一の違いは、観察にどれだけの計算コストを投じる意志があるかだけだ。
実際の顧客対応でAIを運用する場合、これは何を意味するのか
私は過去3年間、ライブのサポートキューに座るAIエージェントを構築してきたので、この同じ議論を何百回もの商談ですでに経験している。ただし数字ははるかに小さい。
パターンはいつも同じだ。すべての購入検討者は、まずAIがどれだけ優れているかを尋ねることから始める。それから10分ほど経つと、そのことへの関心を失い、代わりにそれが何を拒否するのかを尋ねはじめる。それこそが、デフレクションプログラムが最初の1か月を乗り切れるかどうかを実際に決定する問いだ。月間約7,000件のGorgiasチケットを処理しているDTCサプリメントブランドのあるCXリーダーは、私が書いたどの資料よりも的確にその反論を言い表していた。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
OpenAIがちょうど説明したのと同じアーキテクチャであり、違うのは規模の大きさだけだ。振る舞いを観察し、おかしいと見えるものはすべてエスカレーションし、そして推測するのではなく停止する。OpenAIは3つのチームを呼び出してトレーニング実行を一時停止し、サポートエージェントはチケットを人間にルーティングしてそのまま手を出さない。両方とも同じ形であり、どちらの場合でもハンドオフの設計こそがプロダクトそのものであり、単なるフォールバックではない。
もう半分の側面、つまりソーシングの側面は、私たちが一緒に仕事をしているリーガルテック企業の共同創業者によって、私に示された。彼らが必要としていたのは、AIが引用できる範囲についての厳密なガードレールと、すべての回答に対する透明な引用だった。リーガルテックでは、有用であることと法律アドバイスをすることの境界線が薄く、かなり容赦がないからだ。より賢いベースモデルはそれを何一つ解決してくれない。スコープ設定は解決してくれる。
つまり、あなたの仕事がフロンティア研究ではなくサポート運用であるなら、Astraについての実践的な読み方はこうなる。
- それを待つな。 発売日はない。公開された料金とsystem cardを持つモデルの上に構築せよ。GPT-5.6 Terraがボリュームを処理し、Claude Opus 5が難しいケースを担当し、重みが欲しいならDeepSeek V4 Flashがある。
- モデル層はコモディティ化を続けると想定せよ。 Kimi K3はGrok 4.6から数か月のうちに登場した。GoogleのGemini 3も同様だった。あなたの差別化がどのモデルを呼び出すかで決まることは、もともとなかったはずであり、最良のAIエージェントのまとめはそれを何度も証明している。
- 評価予算は制御面に費やせ。 どのソースを読めるか、どのアクションを取れるか、何を引き渡すか、そして本番稼働前にそれを証明できるかどうか。これがリストの全体であり、AIエージェントとチャットボットを分けるものの大部分でもある。
- 自社の履歴に対するドライランを求めよ。 OpenAIは進める前に自社のセーフガードを検証している。あなたも自分の過去のチケットで同じことができるべきであり、それはどんなAIカスタマーサービスソフトウェアベンダーにも求めて当然の要求だ。
- 解決率だけでなく拒否率も測定せよ。 優れたAIサポートの品質保証プロセスは、AIが一切触らなかったものを追跡する。そもそもこの数値こそが、解決率のメトリクスを信頼できるものにしているからだ。
それと並んで注目に値するのは、ベンダーごとに同じ問題への対応がいかに異なるかだ。OpenAIは自社のサイバーモデルをDaybreakの背後に閉じ込め、何世代にもわたって価格の欄を空白のままにしている。それが、私たちのGPT-5.6-Cyberの代替案の記事がたどる糸だ。Googleはさらに一歩進み、Gemini 3.5 Flash Cyberを政府と信頼されたパートナーのみに限定した。このカテゴリーの誰も、能力単体だけで出荷可能だとは信じていない。それは、サポートAIベンダーがモデルこそが購入する理由だと言うたびに、思い出す価値がある。
まず動くところを見たいチームのためのeesel
この話が私に響いた理由は、eeselの設計全体が、OpenAIが計算量の20%を費やしてまさに守り抜いたのと同じ前提から出発しているからだ。エージェントが何をするかは、その仕様を読んでもわからない。観察下で実行してみることでわかるのだ。
eeselは、すでに使っているヘルプデスク、つまりZendesk、Freshdesk、Gorgiasに接続し、過去のチケットや既存のドキュメントから学習し、その上で実際の履歴上の会話に対してシミュレーションを行い、実際の会話に触れる前に、実行の最後にスコア付けされたレポートを返す。あなたは、自分自身のチケットに対してそれが送っていたであろう回答を読むことができ、顧客がそれを目にする前にスコープを調整できる。確信が持てない場合、そのチケットはそのままにして人間に引き渡される。
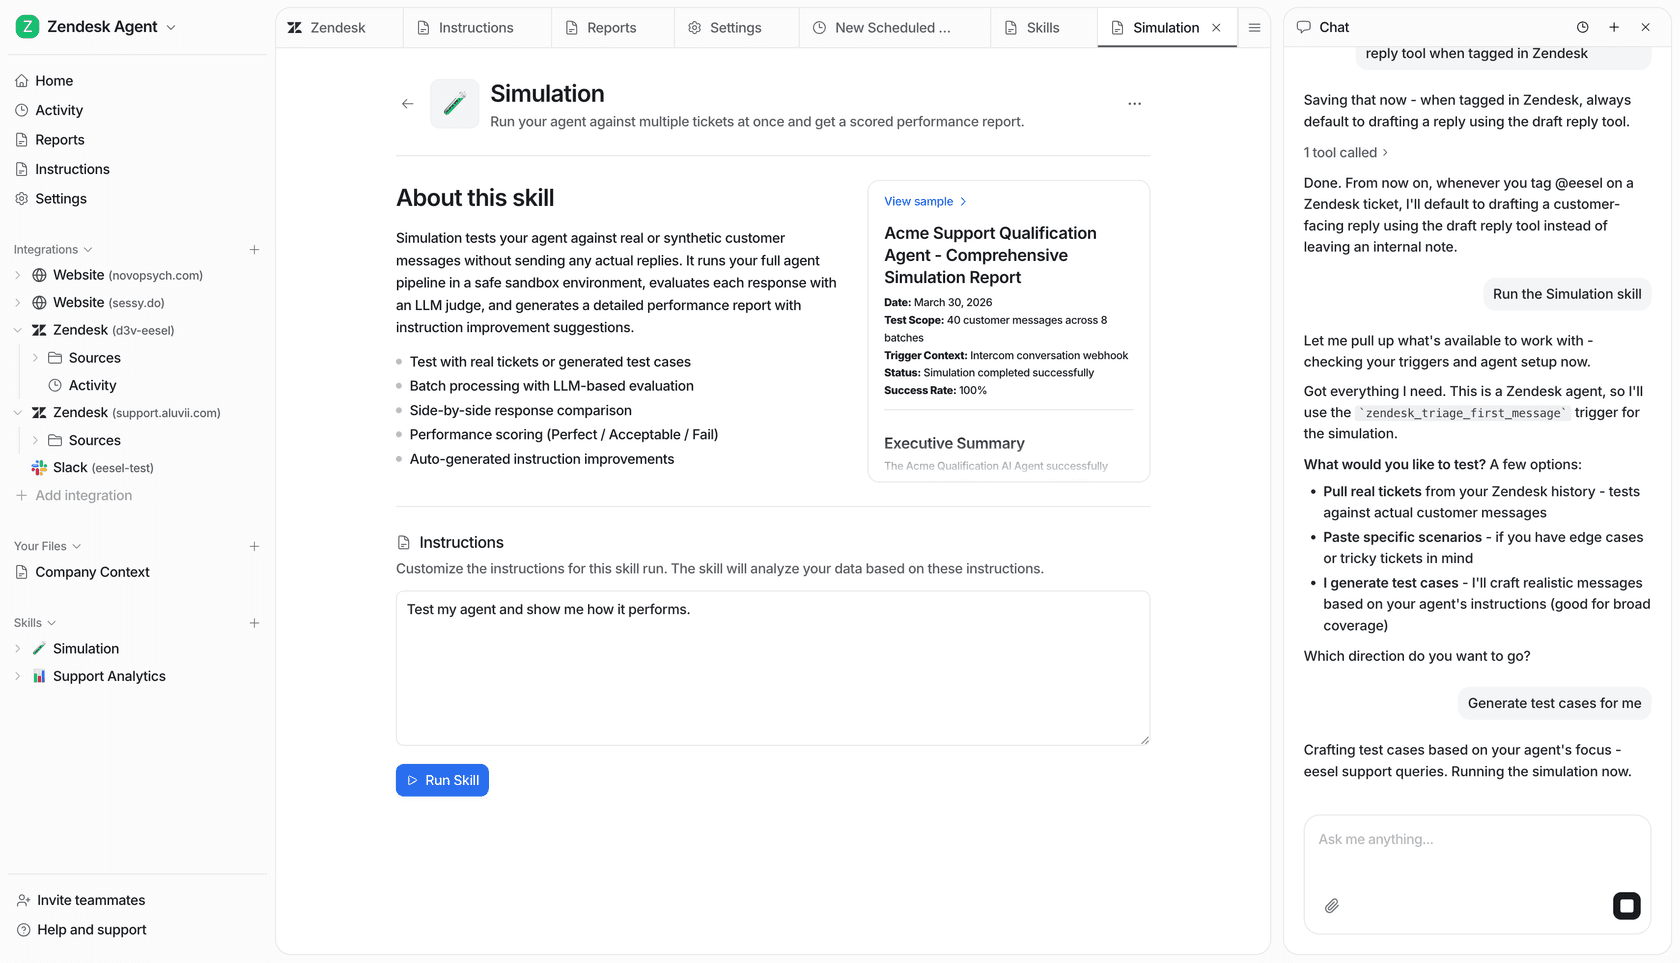
一時停止されたフロンティアモデルについて読む1週間は、自社のベンダーに対して一つの単純な問いを投げかける良い機会だ。顧客に応答する前に、自社のデータでこれが動くところを観察できるか。eeselなら、その答えはイエスであり、しかも半日以内で、無料で始められる。
よくある質問
OpenAI Astraとは何ですか?
OpenAI Astraの発売日はいつですか?
OpenAIはなぜAstraを一時停止したのですか?
OpenAIのPreparedness Frameworkにおけるcriticalサイバーセキュリティ閾値とは何ですか?
AstraはGPT-5.6より優れていますか?
Astraの数学的な結果を出すのにいくらかかりましたか?
Astraは今すぐAIカスタマーサポートに何か変化をもたらしますか?
OpenAI自身のAstraに関する発表はどこで読めますか?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.