

Mistral Large 4とは?
私はeeselでAIエージェントを作る仕事をしているので、フロンティアモデルが発表されるたびに、同じ質問が机に届きます。eeselのエージェントはこれで動かすべきか、という質問です。Mistral Large 4については、正直な答えは「まだ早いが、注視すべき」で、その理由はベンチマークのグラフが示すものより興味深いです。
Mistralはこれを「largest and most capable model to date」と呼んでいます。ローンチ記事によると、Mistral自身のヨーロッパのデータセンターにある3,800基のNVIDIA Grace Blackwell GPUで学習され、Mistralの€30億のシリーズDが支えるロードマップの最初のマイルストーンでもあります。会社そのものを復習したい方は、Mistral AIの概要で歴史を、Mistral AIのレビューのまとめで旧モデルに対するユーザーの評価を紹介しています。
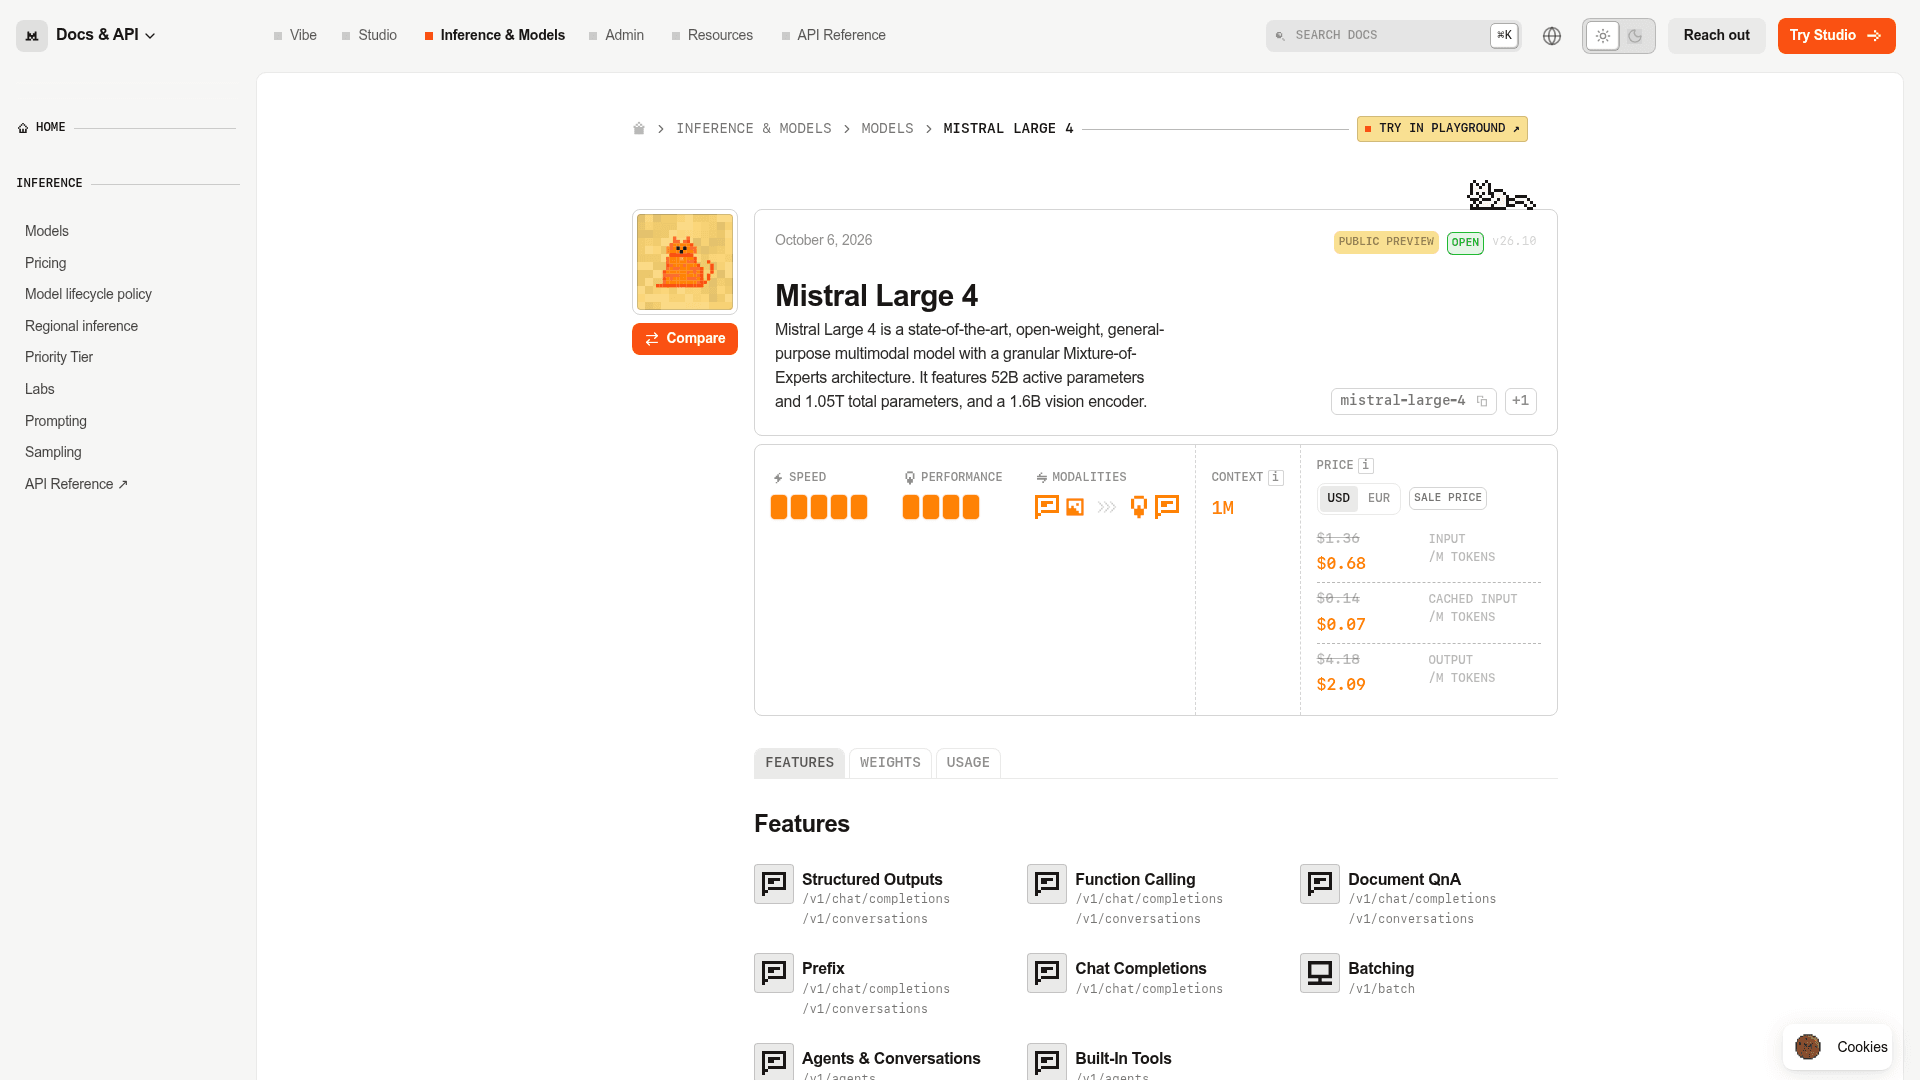
重要なスペックを、ドキュメントのモデルカードから直接まとめます。
| 項目 | Mistral Large 4 |
|---|---|
| リリース | 2026年10月6日、パブリックプレビュー(v26.10) |
| アーキテクチャ | 細粒度のMixture-of-Experts、インストラクトと推論のハイブリッド |
| パラメータ | 合計1.05T、アクティブ52B、加えて1.6Bのビジョンエンコーダ |
| コンテキストウィンドウ | 100万トークン |
| 入力 | テキストと画像 |
| APIモデルID | mistral-large-4 |
| 機能 | 関数呼び出し、構造化出力、document QnA、バッチ処理、Agents API、組み込みツール |
| ウェイト | 2026年10月末までに公開予定、ライセンスは未発表 |
| 学習言語 | 160以上、EUの全公用語を含む |
数字には小さな食い違いがあります。ドキュメントのカードではアクティブパラメータは52Bですが、Mistral自身のXでのローンチ投稿では49Bとなっています。Artificial Analysisもコンテキストウィンドウを524,288トークンと記載しており、カードの100万の半分です。Mistralが明確にするまでは、小さいほうの数字で計画するのがよいでしょう。
Mistral Large 4の仕組み
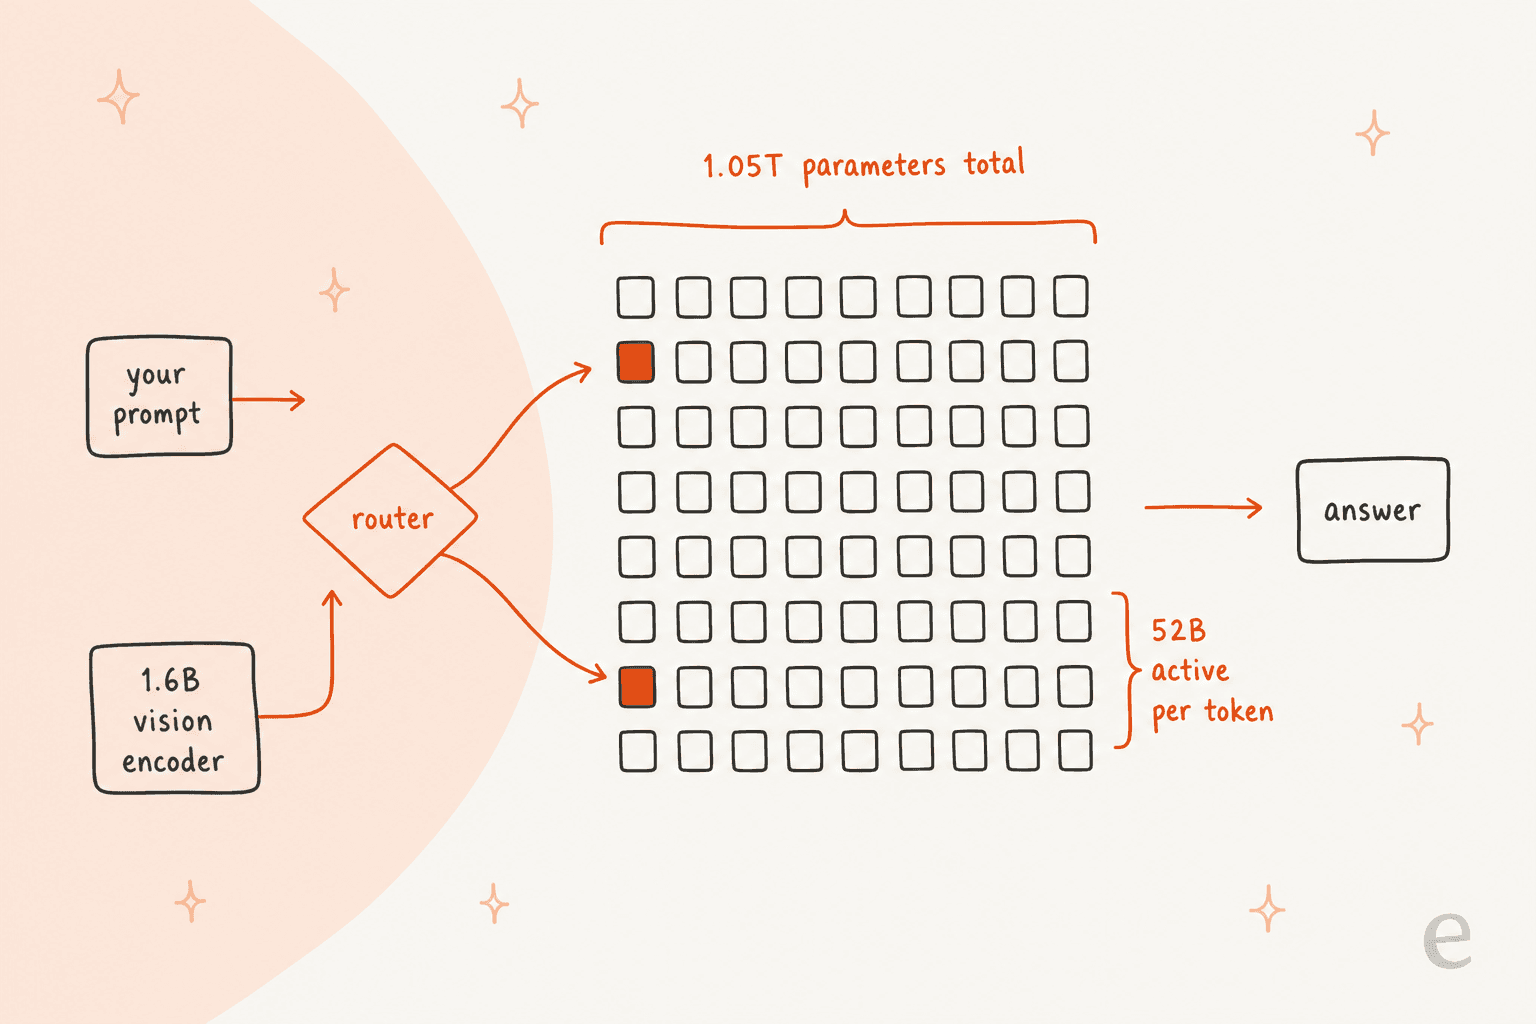
見出しの数字である1.05Tパラメータは、それだけを見ると少し誤解を招きます。Mistral Large 4はMixture-of-Expertsモデルで、ルーターがトークンごとにネットワークの小さな一部を選ぶため、あるトークンで実際に働くのはウェイトの約5%(52B)だけです。だからこそ、モデルが巨大でありながら、そこそこ速いのです。Artificial AnalysisはMistralのAPIで毎秒116.1出力トークンを計測しました。同程度の価格帯の推論モデルの中央値77.0を大きく上回ります。
ハイブリッドモデルでもあるため、通常のインストラクトモデルとして使うことも、ドキュメントの例にあるreasoning_effortパラメータで推論をオンにすることもできます。コストとレイテンシが潜んでいるのは推論です(思考の各ステップは出力トークンとして課金されます)。これについては後ほど触れます。お客様の前に出す前に理解しておくべき最も重要な点だからです。
もう一つ知っておく価値のある設計上の選択は、Mistralが自社のインフラで学習し、同じ場所からプレビューを提供していることです。「a European deployment that Mistral operates end-to-end」も含まれます。EUのデータ規則の下で働くチームにとって、これはどのベンチマークよりも大きな意味を持ちます。また、SOC 2とGDPRのレビューでも重要で、最初の質問の一つはたいてい、モデルがどこで動いているかです。
Mistral Large 4の料金
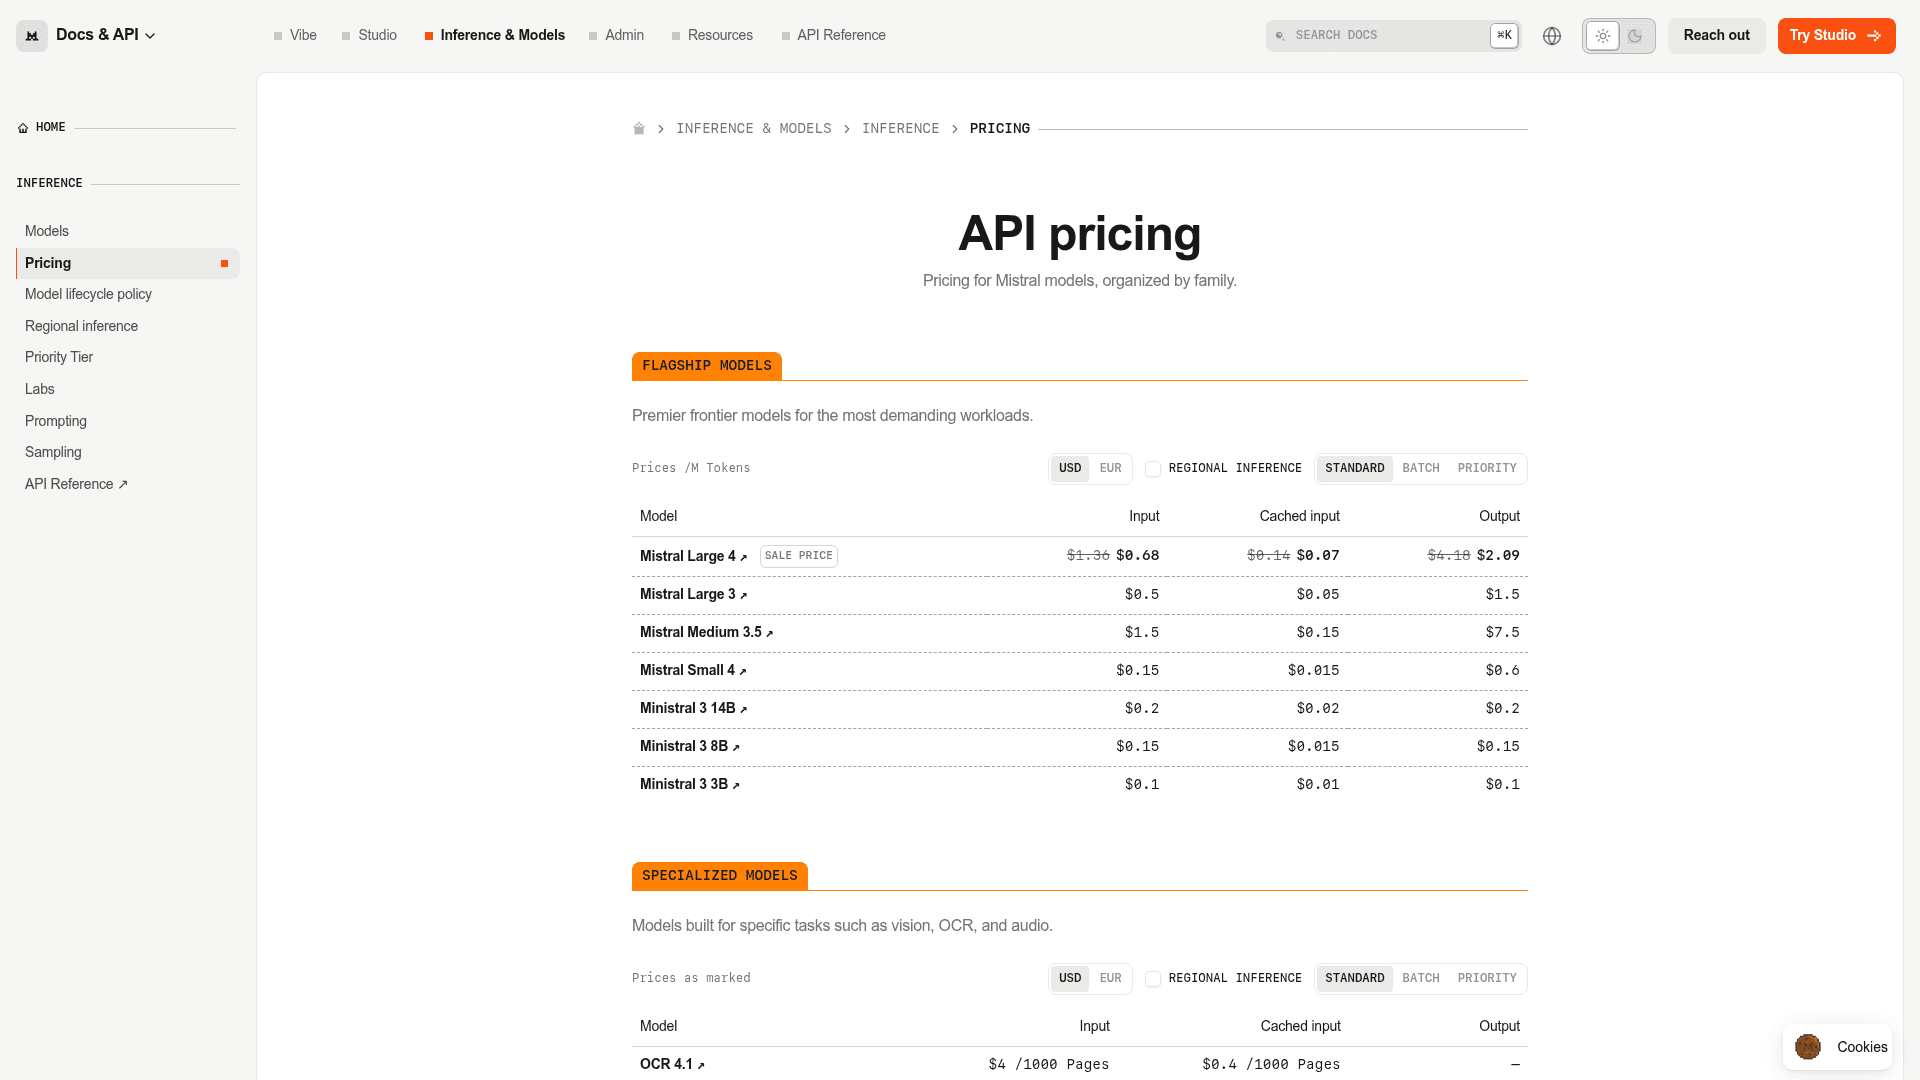
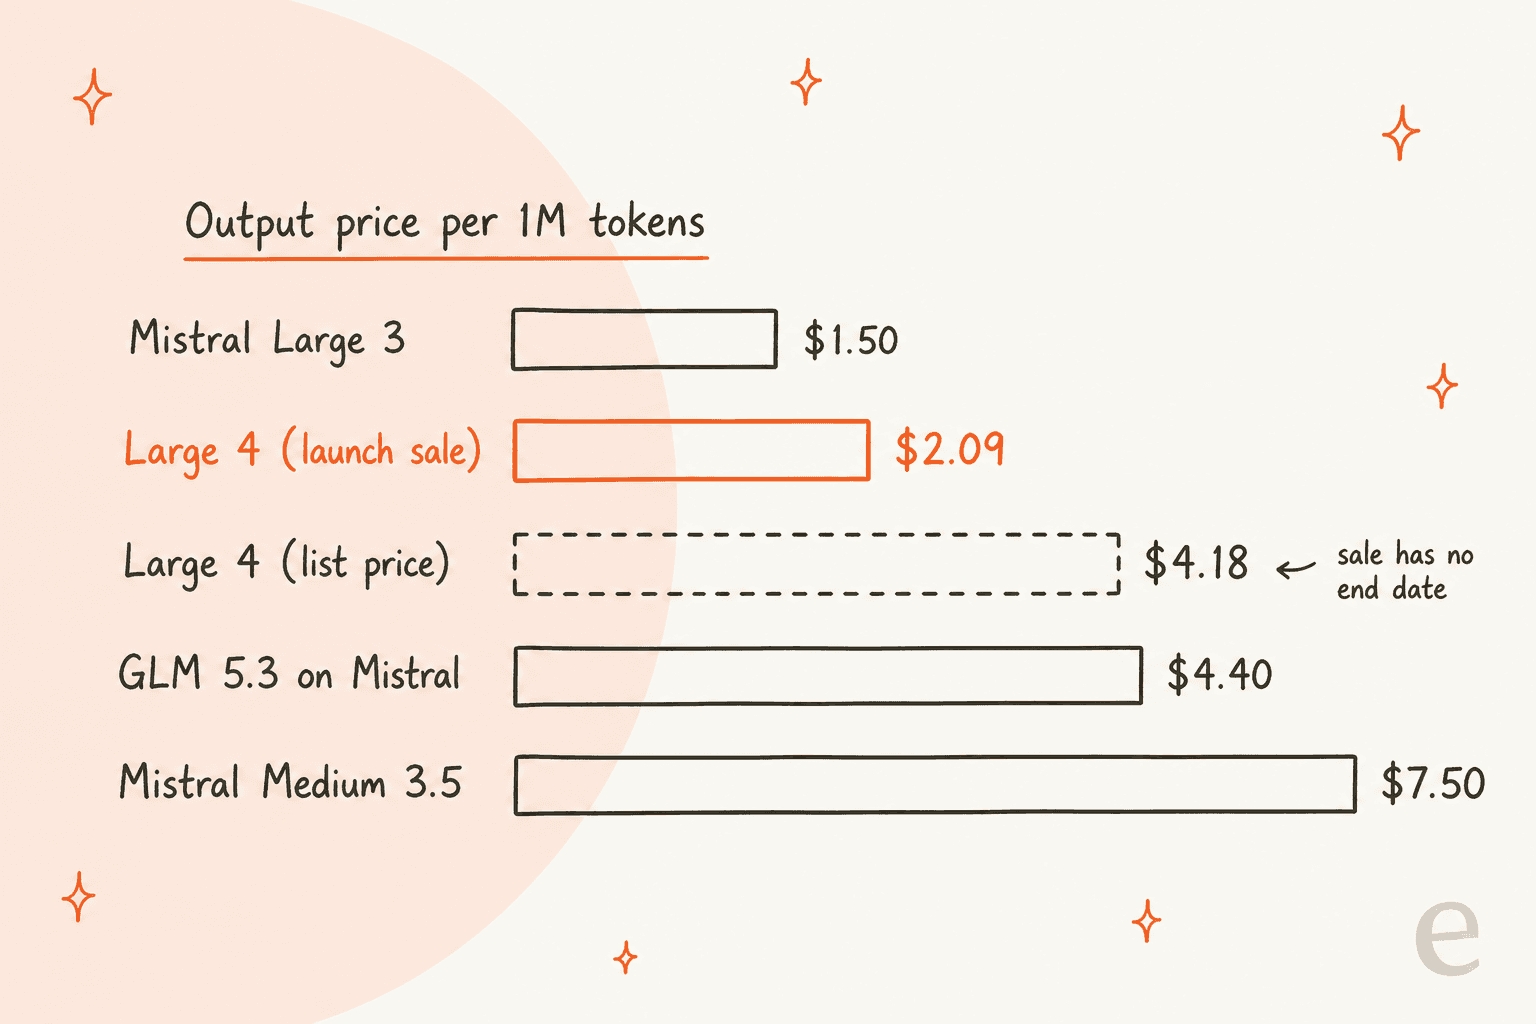
Mistral Large 4はAPI経由でトークン単位の課金で、現在は定価のちょうど半額のローンチセールが行われています。APIの料金ページには両方が載っています。
| モデル(100万トークンあたり) | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| Mistral Large 4(ローンチセール) | $0.68 | $0.07 | $2.09 |
| Mistral Large 4(定価) | $1.36 | $0.14 | $4.18 |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 |
| GLM 5.3(Mistralがホスト) | $1.40 | $0.14 | $4.40 |
気になる点は3つあります。
- セールに終了日がありません。 定価では、出力はLarge 3の2.8倍です。予算は$1.36 / $4.18で組み、セールはおまけとして考えてください。
- Mistral自身のMedium 3.5より安くなります。 セール中のLarge 4の出力は$2.09で、Medium 3.5の$7.50に対して、新しい用途でMediumに留まる理由はほとんどありません。
- バッチはさらに安くなります。 Mistralの料金FAQによると、バッチリクエストは50%安く、キャッシュ入力は最大90%安くなります。
APIではなくチャットアプリとして使いたい場合は、現在Vibe(旧Le Chat)と呼ばれるMistralの一般向け製品の中にあります。Freeは$0、Proは月額$14.99、Teamはユーザーあたり月額$24.99、Enterpriseは要問い合わせです。料金ページにはどのVibeプランにLarge 4が含まれるか書かれていないため、そのために席を購入する前に確認してください。プランの詳細は、Mistral AIの料金の完全ガイドをご覧ください。
Large 4でのサポート返信1件のコスト
トークン価格は、具体的な作業量があるほうが判断しやすくなります。サポートの返信1件が、入力8,000トークン(チケットのやり取りに、RAGで取り込んだヘルプセンター記事数件を加えたもの)を読み、推論を含めて出力3,000トークンを書くとします。セール価格では1返信あたり約$0.012、定価では約$0.023になります。
安いです。だからこそ、ほとんどのサポートチームには、AIサポート導入の成否を決める費目は、トークン価格であることはまれだとお伝えします。間違った回答や、ボットの面倒を見る時間のほうがはるかに高くつきます。これはAIサポートエージェントのコストの解説と同じテーマです。
Mistral Large 4のベンチマーク:Mistralのグラフと独立テスト
Mistralは今回のローンチで多くのグラフを公開しており、少し珍しい形で正直なので、注意深く読む価値があります。Mistral自身のグラフでは、私が読み取れた6つのベンチマークのうち4つで、競合がLarge 4を上回っています。
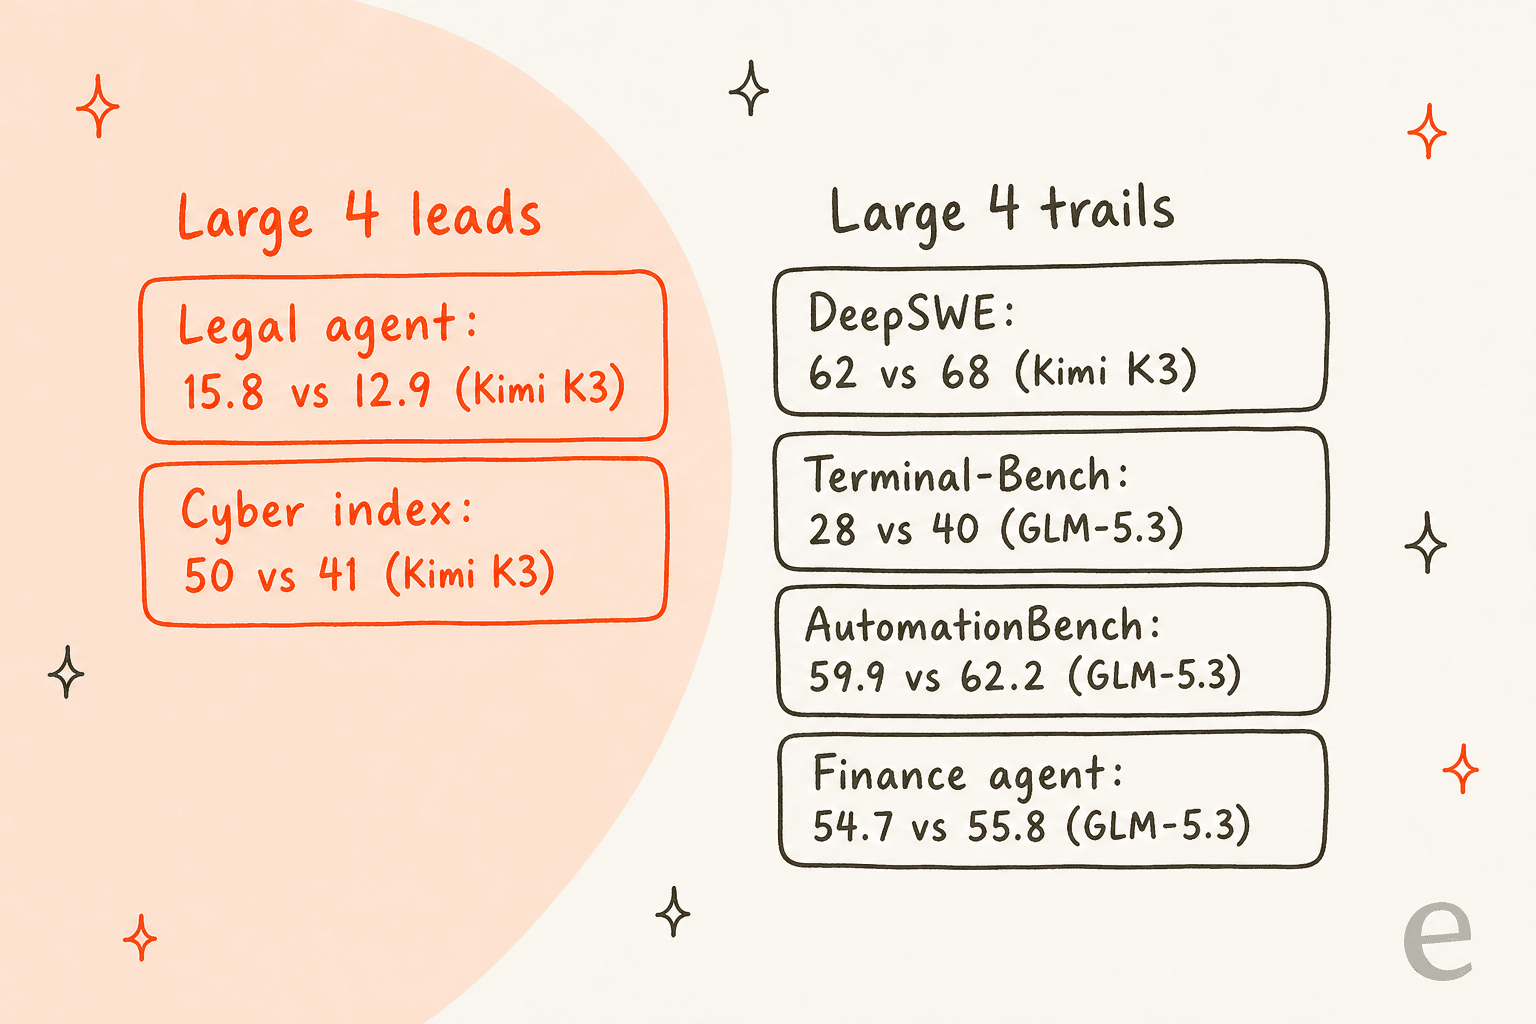
コーディングでは、DeepSWE v1.1で61.7%、Terminal-Bench 4で28.3%です。DeepSWEではKimi K3が上(68)、Terminal-BenchではGLM-5.3が上(40)で、どちらもMistral自身のグラフによるものです。
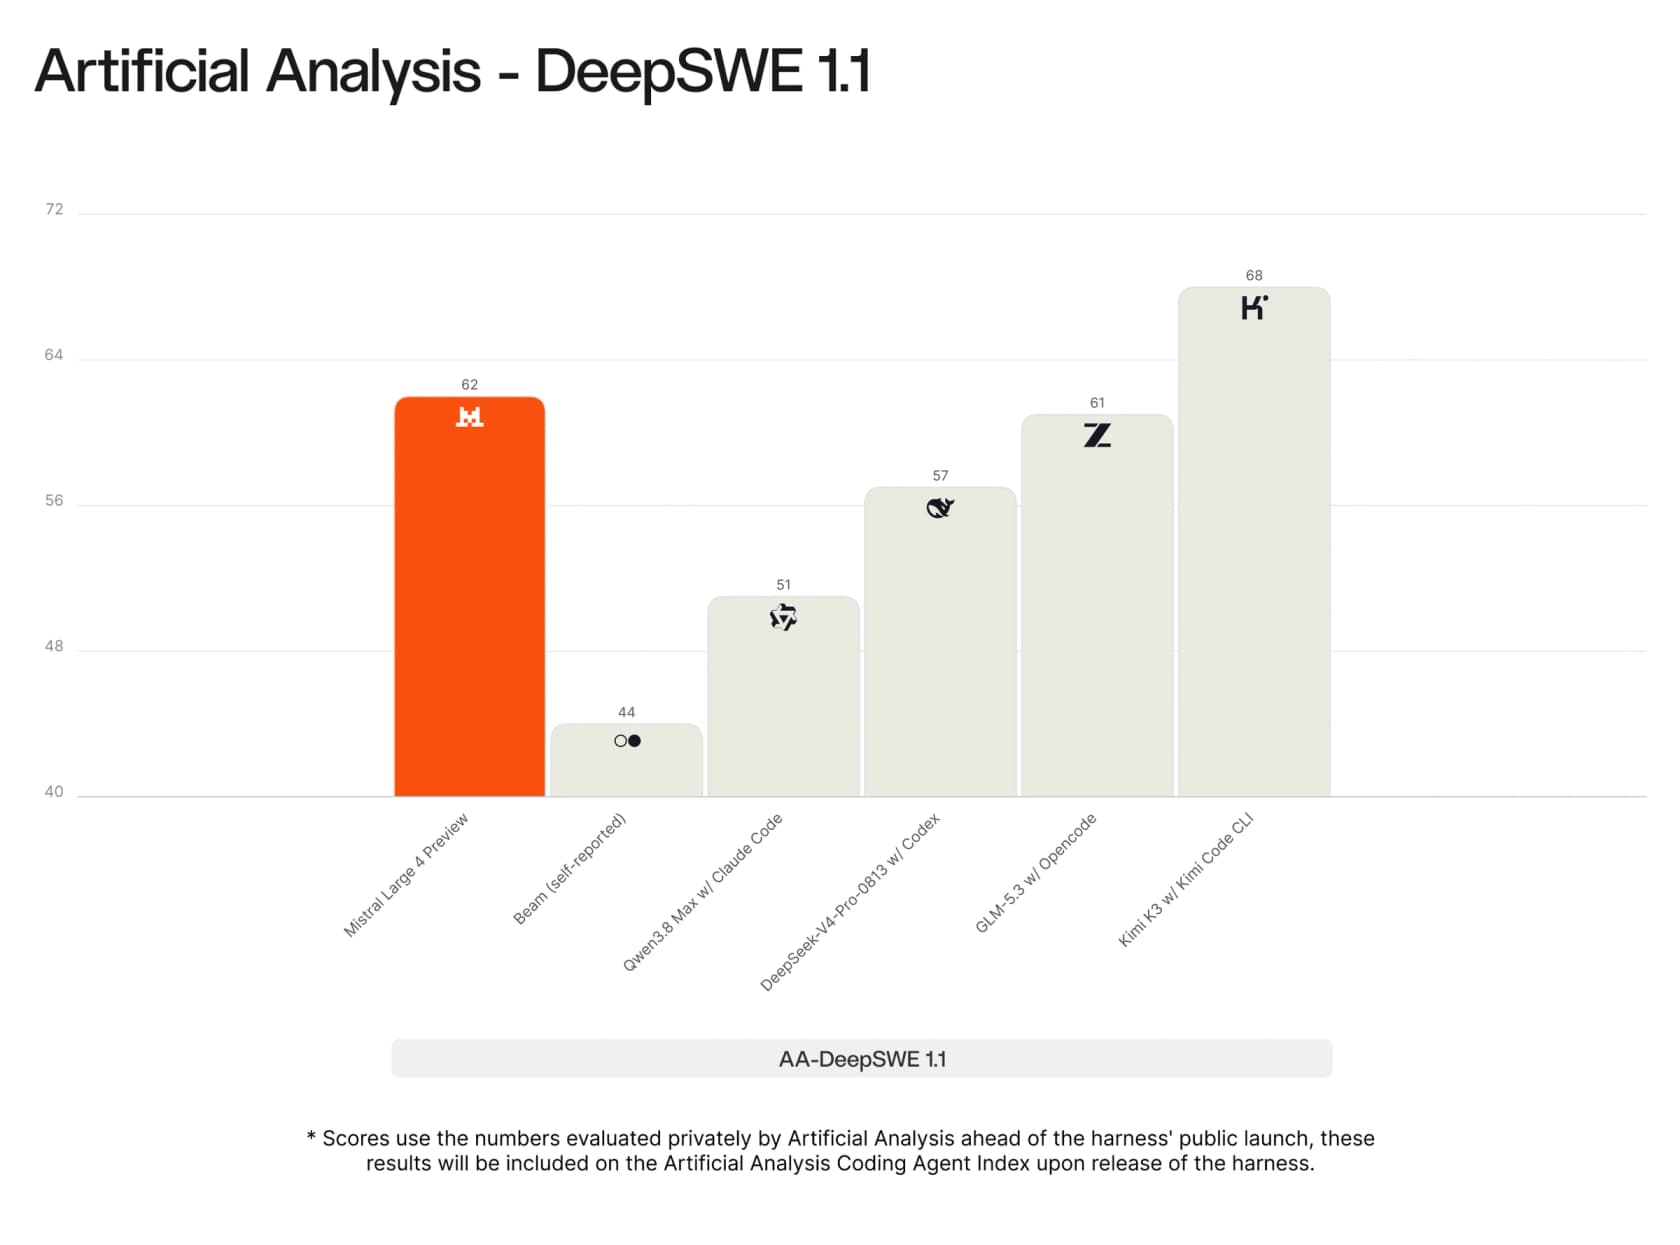
Artificial Analysisによる独立した評価もこれと一致します。同社のIntelligence IndexでのLarge 4の位置と、ベンチマークの1タスクを完了するコストは次のとおりです。
| モデル | AA Intelligence Index | 100万トークンあたりの入力 / 出力価格 | タスクあたりのコスト |
|---|---|---|---|
| Claude Sonnet 5.5(Max) | 56.0 | $2 / $10 | $5.46 |
| Qwen 3.8 Max | 45.4 | $2 / $6 | $5.41 |
| Kimi K3(Max) | 43.6 | $3 / $15 | $2.00 |
| Claude Haiku 5.5(Max) | 43.4 | $0.10 / $0.50 | $0.21 |
| Gemini 3.8 Flash(High) | 40.9 | $0.75 / $3.75 | $1.24 |
| DeepSeek V4.1 Flash(Max) | 39.5 | $0.30 / $1.20 | $0.27 |
| Mistral Large 4 Preview | 38.4 | $1.36 / $4.18 | $1.13 |
| GPT-5.6 Luna(Max) | 37.3 | $0.20 / $1.20 | $0.18 |
| DeepSeek V4 Pro(Max) | 36.0 | $1.32 / $3.96 | $0.67 |
| Mistral Large 3 | 9.3 | $0.50 / $1.50 | $0.03 |
同じ表には2通りの読み方があり、どちらも正しいです。Mistral自身の過去と比べれば、Large 4は世代を超えた飛躍で、スコアはLarge 3の4.1倍です。現在の顔ぶれと比べると、Kimi K3とQwen 3.8 Maxに及ばず、DeepSeek V4.1 Flashのすぐ下、GPT-5.6 Lunaのすぐ上に位置します。後者の2つはタスクあたりのコストがごくわずかです。
理由はトークンの消費量です。Artificial AnalysisはLarge 4で1タスクあたり69,330出力トークンを計測し、そのうち52,011が推論でした。Large 3は5,566でした。これほど深く考える推論モデルは、控えめなトークン単価を、高いタスク単価に変えてしまいます。
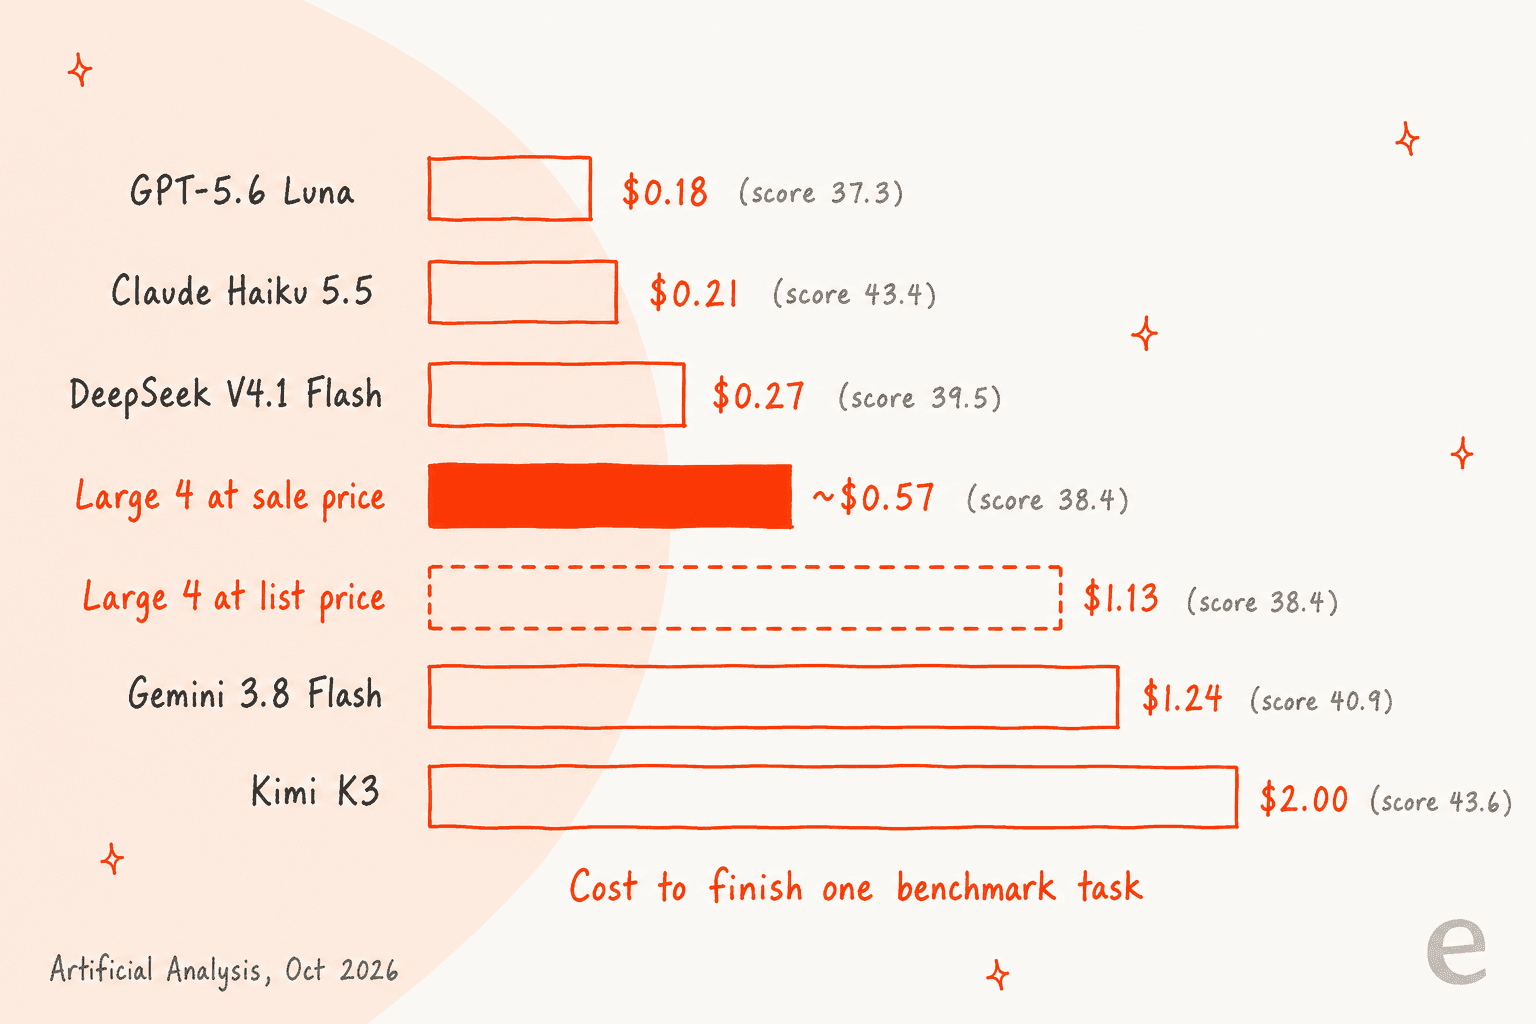
Artificial Analysisは定価で計算しており、セールはキャッシュ入力を含むすべてのレートを半額にするため、セール価格ではタスクあたり約$0.57になります。それでも、スコアがわずかに低いDeepSeek V4.1 Flashの約2倍です。オープンモデルをコストで比較するなら、DeepSeek V4 Flashの料金とKimi K3の料金の記事に、料金表の全体があります。
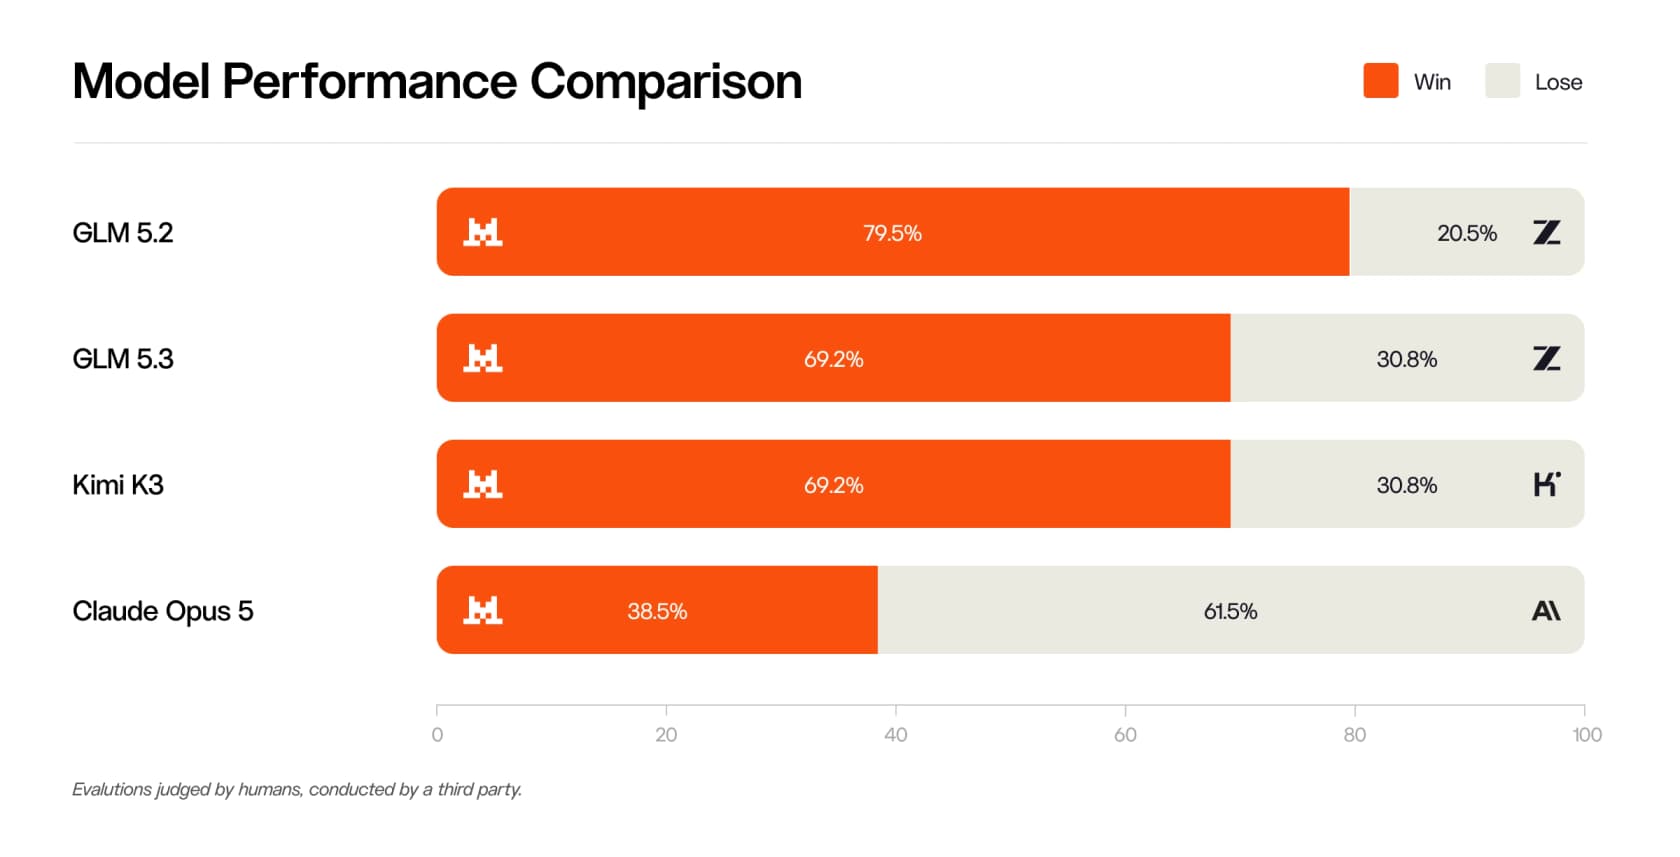
人間の評価者は、指数より好意的な結果を示しています。第三者が実施したMistralの人間評価では、Large 4はGLM-5.3とKimi K3のどちらに対しても直接対決の69.2%で勝ち、Claude Opus 5に対しては38.5%でした。
Mistral Large 4が最も強い分野
総合指数を外すと、はっきりした形が見えてきます。Large 4は最高のオールラウンダーではありませんが、いくつかの特定の分野では首位です。
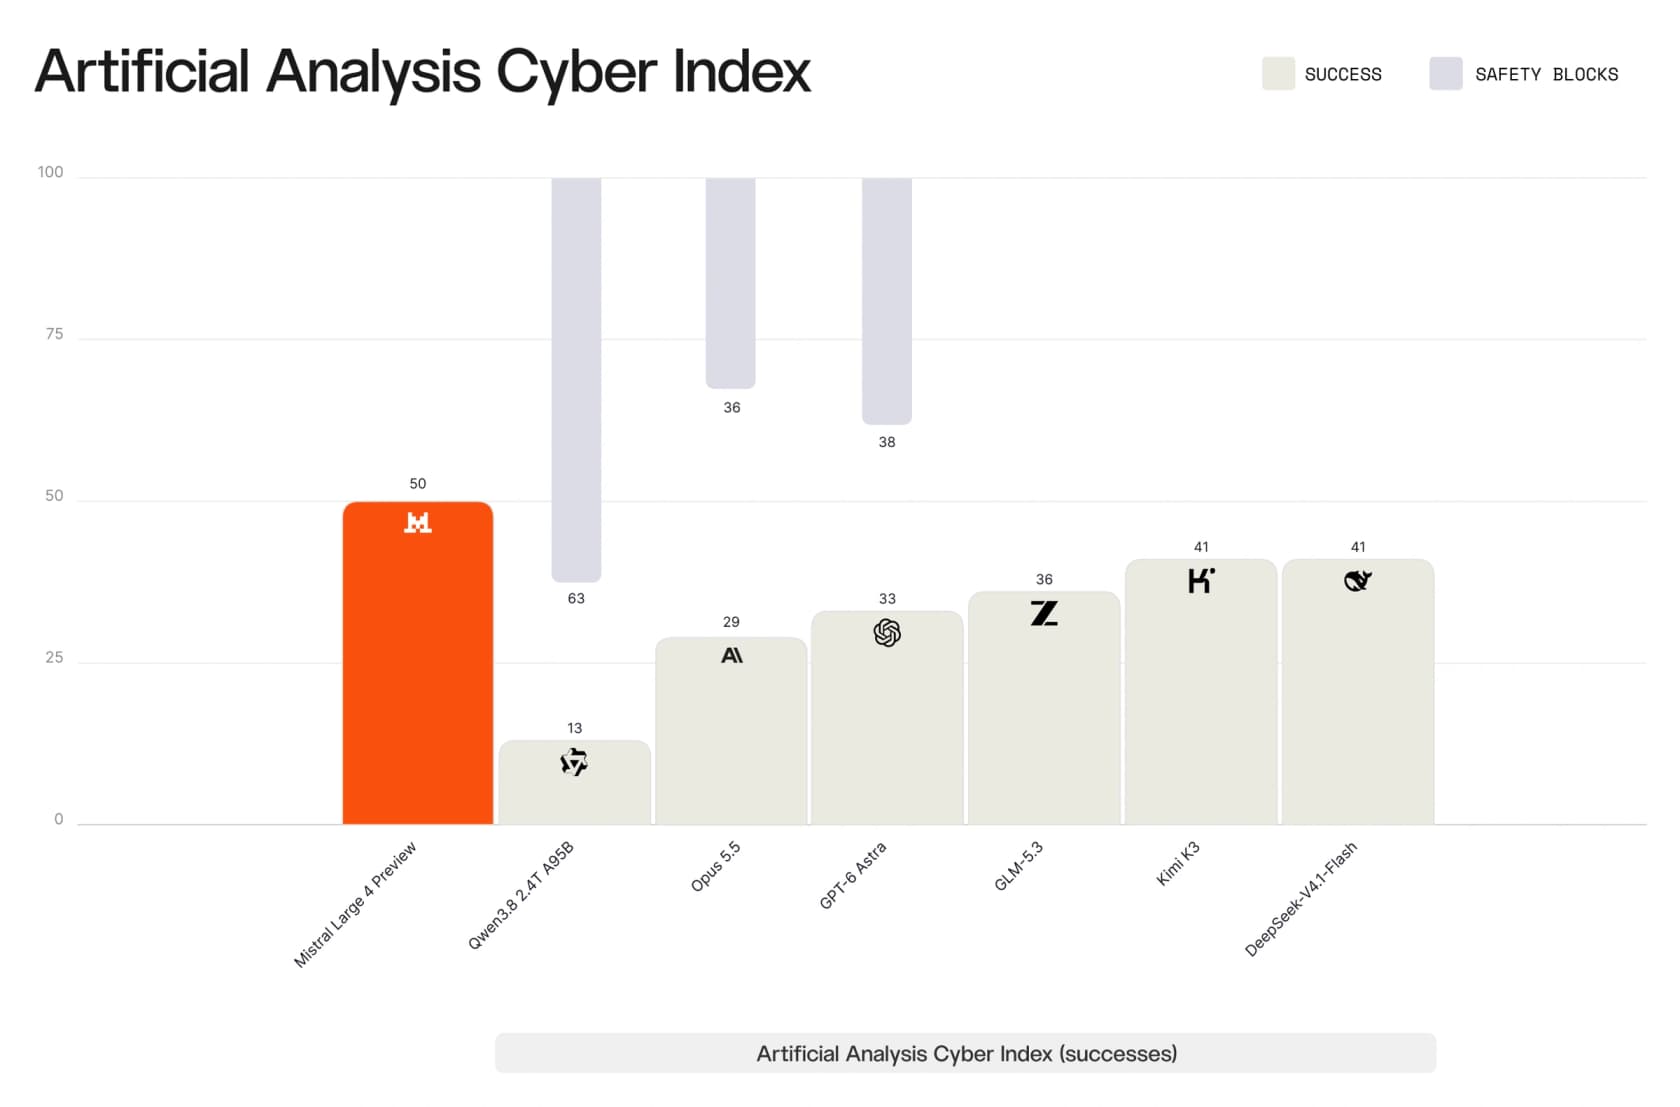
サイバー防御。 これが目玉の主張で、数字もそれを裏付けています。Mistralのローンチ記事によると、Large 4はArtificial AnalysisのCyber Indexで50を記録し、Kimi K3の41、GPT-6 Astraの33、Claude Opus 5.5の29を上回りました。再現してからパッチを当てるテストで82%、Cybenchで93%を達成しています。このパッチのテストについて、Mistralはクローズドなフロンティアモデルが「score near zero on the same test because they refuse」と述べており、そこでの優位の一部は能力ではなく、応じる姿勢の違いによるものです。
Mistralの共同創業者Guillaume Lampleは、この主張を直接語りました。
"Open models are the best defense for enterprises today: capable, auditable, self-hosted and governed under enterprise policies -- and more importantly, they do not refuse to help."
法務エージェントの業務。 Vals.aiのHarvey Legal Agentベンチマークで15.8を記録し、Kimi K3の12.9、GPT-6 Astraの5.4を上回りました。絶対値は低いものの、優位ははっきりしています。
長い文書とグラフ。 Artificial Analysisの長文脈推論テスト(AA-LCR)で81.3%、Dense 200のビジュアルグラウンディングで42%を記録し、GPT-6 Astraの41%をわずかに上回りました。Plotlyのデータチームも実際に同じ結果を見ています(後述)。
攻撃に対する安全性。 Lakera B3のエージェントセキュリティベンチマークで攻撃の93.3%に耐え、Mistralが報告した競合の中で最高のスコアでした。
Mistral Large 4についてのコミュニティの声
Hacker Newsのローンチスレッドは1,990ポイント、1,144コメントに達し、反応はベンチマーク表が示すのとほぼ同じように分かれています。飛躍には感心しつつも、他を上回るとは確信していない、というものです。
最も参考になった実地テストは、Plotlyの人が自社のデータ分析ベンチマークで動かしたものでした。
"It's 10x cheaper than Mistral Medium 3.5 from April and goes from 58% to 74% correct. Definitely a generational shift. It's not on the Pareto curve yet, but it's good enough for data analytics"

返信では価格の話がたびたび出ました。あるコメント者は、より安い「flash」クラスのモデルと並べました。
"So, I think it would have to be significantly better than GLM 5.3-flash to be worth it. GLM 5.3-flash is already very good."
クローズドモデルとの直接比較については、Claude vs MistralとChatGPT vs Mistralの比較記事が次に読むのに適しています。
Redditはもっと厳しい反応でした。r/LocalLLaMAでは、自分でチェスのベンチマークを動かしているユーザーがこう書いています。
"Played around with it a bit, for code analysis, image classifications, and chess capability. Feels quite dated and far behind what I usually utilize."

それでも主権の議論は繰り返し出てきます。これは、企業の購入者にとって私が最も真剣に受け止める点です。
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."
XでのMistralのローンチ投稿に付いた、最も「いいね」の多い返信は、「オープンウェイト」という枠組みについて多くを物語るジョークでした。"me with 12 GB of VRAM reading 'open weights, 1.05T parameters'"(An XuanのX投稿)。そこで、今のところまだ約束にすぎない部分の話になります。
オープンウェイト:現時点で「オープン」が意味すること
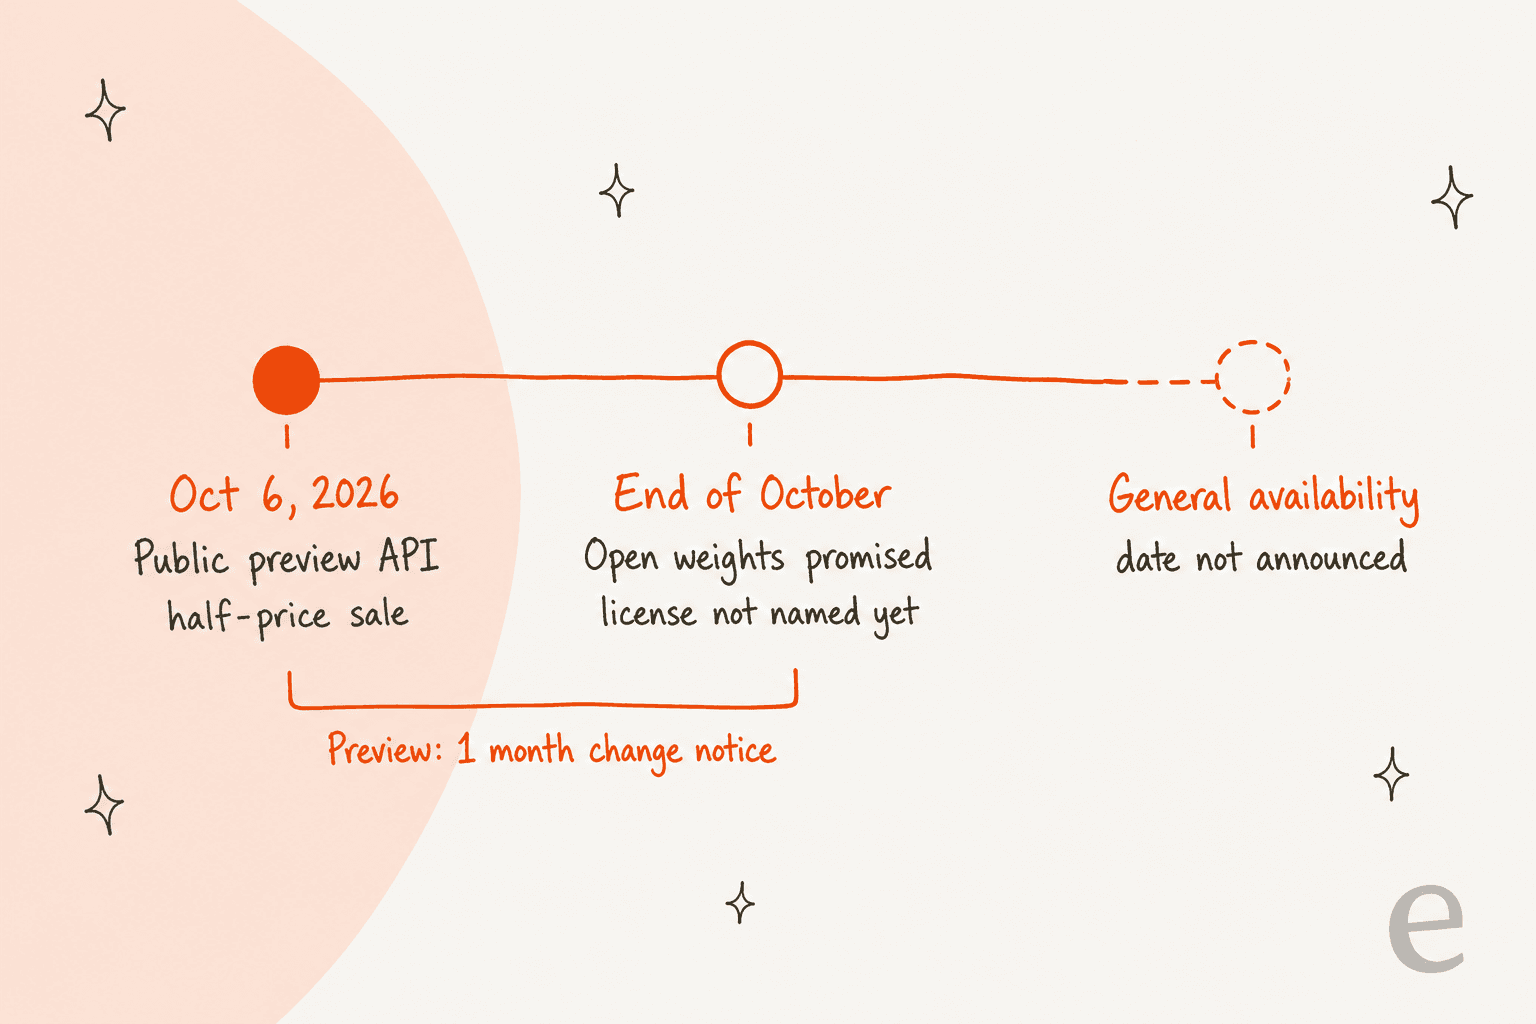
MistralはLarge 4をオープンウェイトとしていますが、2026年10月8日時点ではダウンロードできません。MistralのHugging FaceページにMistral Large 4のリポジトリはなく、ライセンスも発表されていません。Lampleは、RLの実行は「is still in flight」で、最終版は月末までにウェイトとともに公開されると述べています。
これには、実務上の影響が2つあります。
- ベンチマークは動く可能性があります。 今日テストするモデルはプレビュー版で、Mistralのライフサイクルポリシーでは、パブリックプレビューのモデルは変更の1か月前にしか告知されず、一般提供の6か月と差があります。最終版が出たら評価をやり直してください。
- ライセンスがすべてを決めます。 Large 3はApache 2.0で公開され、Medium 3.5は修正版MITライセンスを使っています。MistralがLarge 4のライセンスを発表するまで、「オープン」は方向性であって、契約ではありません。
ウェイトがあっても、ほとんどのチームは自分では動かさないでしょう。1.05TパラメータではマルチGPUサーバーの領域だからです。現実的な道は、MistralのAPI、Mistral経由のヨーロッパでのデプロイ、あるいは登場後のホスティング事業者です。今日自分のハードウェアで動かせるものが欲しいなら、Mistralの代替のリストに、より小さなオープンモデルがあります。
カスタマーサポートにMistral Large 4を使うべきか?
最もよく聞かれる質問なので、率直に答えます。Large 4は良いサポート返信を書けますが、自分の記憶だけで回答させてはいけません。
Artificial Analysisの知識テスト(AA-Omniscience)では、質問の25.8%に正しく答え、ハルシネーション率は41.9%でした。つまり、答えを知らないとき、しばしば単に推測していたということです。ヘルプデスクで、返金ポリシーや製品の互換性について自信満々に推測することは、最悪の回答です。
この失敗パターンは、私自身も間近で見ました。あるeeselの営業電話で、Zendeskを使い月に約200件のチケットを扱うデンマークのB2B車両テレマティクスのチームが、ナレッジベースに"we support all models"と書かれているため、ボットが未対応の車種を肯定してしまうのではと心配していました。より良いモデルでも解決しなかったでしょう。モデルはドキュメントを正しく読んでおり、間違っていたのはドキュメントのほうだったからです。だから、私が関わるすべての導入は本番前に過去のチケットでテストされ、ハルシネーションを止めるためのガイドは、モデルではなくナレッジベースから始まります。
約7,000件のチケットを扱うDTCサプリメントブランドのCXリードは、どんなベンチマークよりも的確に本当の要件を言い表しました。
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
レイテンシは、確認が必要な2つ目の点です。推論をオンにすると、Artificial Analysisは長いプロンプトで最初の回答トークンまで約18.7秒を計測しました。メールやチケットへの返信なら問題ありませんが、ライブチャットには遅く、より低いreasoning_effortか、より速いモデルが欲しくなるでしょう。このトレードオフは、チケット向けの最適なAIモデルの比較でさらに掘り下げています。
サポートチーム向けにまとめると、次のようになります。
| ユースケース | Large 4の適合度 | 理由 |
|---|---|---|
| オペレーターが確認する返信の下書き | 良い | 文章が強く、返信あたりが安く、人が介在するので出力を確認できる |
| メールやチケットへの自動返信 | ガードレールがある場合のみ | 自社ドキュメントでの裏付け、信頼度スコア、人へのフォールバックが必要 |
| ライブチャット | 推論オンでは弱い | 最初の回答トークンまで約18.7秒 |
| EUのデータ所在地要件 | 強い | Mistralがヨーロッパで構築・提供 |
| お客様が添付するスクリーンショットやPDFの読み取り | 強い | ネイティブの画像入力、文書やグラフのスコアが良好 |
サポートスタックのモデルを選ぶなら、サポート向けの最適なLLMのガイドで主な選択肢を比較しており、RAGとファインチューニングの記事では、ヘルプセンターでは学習よりも根拠付けが優れている理由を説明しています。
モデルはインフラ、eeselは従業員
ここで、考え方を切り替えていただきたいのです。Mistral Large 4のようなモデルはインフラ、つまりテキストを予測するエンジンです。サポートチームが本当に必要としているのは、製品を理解し、ヘルプデスクの中で働き、いつ引き継ぐかを知っていて、お客様と話す前に検証できるチームメイトです。エンジンを選ぶのは、仕事の簡単なほうの半分です。
GENERAL BYTESのKarelは、自分のチームが自作しなかった理由を、こうはっきり語りました。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
それがeeselの役割です。eeselは、特定の仕事に就ける即戦力のチームメイトを採用できるAIチームメイトのプラットフォームです。
サポートでは、それがAIヘルプデスク・チームメイトです。Zendesk、Freshdesk、Gorgiasに接続し、過去のチケットとヘルプセンターから学習し、過去の数百件のチケットでシミュレーションを実行するので、オンにする前にどう回答したかを確認できます。コンテンツチームには、AIブログライターが長文記事で同じことをします。
ヘルプデスク組み込みのAIと比較しているなら、eesel vs Zendesk AIを別記事で比較しています。
限界についてははっきりさせておきます。eeselはセキュリティページにあるとおり、OpenAI、Anthropic、Googleのモデルで動いているため、現時点でeesel内でMistral Large 4を選ぶことはできません。要件が具体的に「ヨーロッパでホストされたMistralのモデル」なら、MistralのAPIを直接呼び出すほうが近道です。
APIレベルの制御が欲しくてLarge 4に辿り着いたなら、eesel CLIでチームメイト自体に対してそれができます。npx @eesel/cli init chat-bubble --site <your-site>で、アカウント不要であなたのサイトで学習したチャットバブルが立ち上がります。すべてのコマンドがJSONを返すので、Claude Code、Cursor、Codexがセットアップを操作でき、eesel mcp tokenでワークスペースをMCPサーバーにできます。ダッシュボードと同じエージェントなので、ターミナルで設定したことはダッシュボードにも反映されます。それが重要な理由は、AIエージェントCLIの記事で解説しています。
eeselを試す
AIにサポートチケットへ回答させたくてMistral Large 4を評価しているなら、私は一段上から始めます。eeselのヘルプデスク・チームメイトは、数分でZendesk、Freshdesk、Gorgiasのキューに参加し、チームがすでに回答したチケットから学習し、誰かに返信する前に、その過去のチケットでスコア付きのシミュレーションを見せます。間違った回答は、お客様の受信トレイではなく、レポートで確認できます。

無料プランにはカード不要で100クレジットが含まれ、有料プランはeeselの料金によると、500件のチケットまたはチャットで月額$299からです。先月のチケットの一部でeeselを試して、どうなるか見てみてください。
よくある質問
Mistral Large 4とは何ですか?
Mistral Large 4の料金はいくらですか?
Mistral Large 4はオープンソースですか?
Mistral Large 4はKimi K3やQwen 3.8 Maxより優れていますか?
Mistral Large 4はカスタマーサポートに向いていますか?
Mistral Large 4のAPIモデル名は何ですか?
mistral-large-4で、reasoning_effortパラメータを受け付けます。関数呼び出し、構造化出力、バッチ処理、Agents APIに対応しています。プレビューモデルは変更の1か月前に告知されるため、AIエージェントを構築する前に、テストをこのモデルに固定してください。