

Claude Fable 5.2は2026年11月9日に、入力100万トークンあたり8ドル、出力100万トークンあたり40ドルで登場しました。Fable 5.1の10ドルと50ドルから20%の値下げです。Fable 5.1を使っているなら乗り換えるべきです。より安く、速く、Anthropicが公開したすべてのベンチマークで高いスコアを記録しています。Opus 5.5を4ドルと20ドルで使っているなら、高いeffortでの自社の評価が物足りなくなるまでそのまま使い続けてください。Fable 5.2はトークンあたりの料金が2倍で、早期ユーザーはタスクあたりのトークン消費がはるかに多いと報告しています。
これが私が組み立てたい前提です。フロンティアモデルはインフラであり、実際の仕事はその上のレイヤーで行われます。サポートやコンテンツ業務では、eeselがそのレイヤーで、その月に最も優れたモデル上で動くAIヘルプデスクのチームメイトとAIブログライターを提供します。eesel CLIを使えば、コーディングエージェントが承認済みの知識をアップロードし、何かが本番に出る前にテストの質問をすることもできますが、ヘルプデスク接続自体は依然として管理者の承認が必要です。
Anthropicは実際に何をリリースしたのか?
Anthropicは11月9日にFable 5.2とMythos 5.2という2つのモデルを出し、「同じ基盤モデル」だとしています。Fableは強力なサイバーセキュリティと生物学の安全対策を備えており、誰でも利用できます。Mythosは安全対策が軽いバージョンで、CyberおよびLife Sciences Verification Programに参加する組織に公開されています。Mythos 5.1は以前取り上げましたし、Mythos 5.2にも専用記事があります。
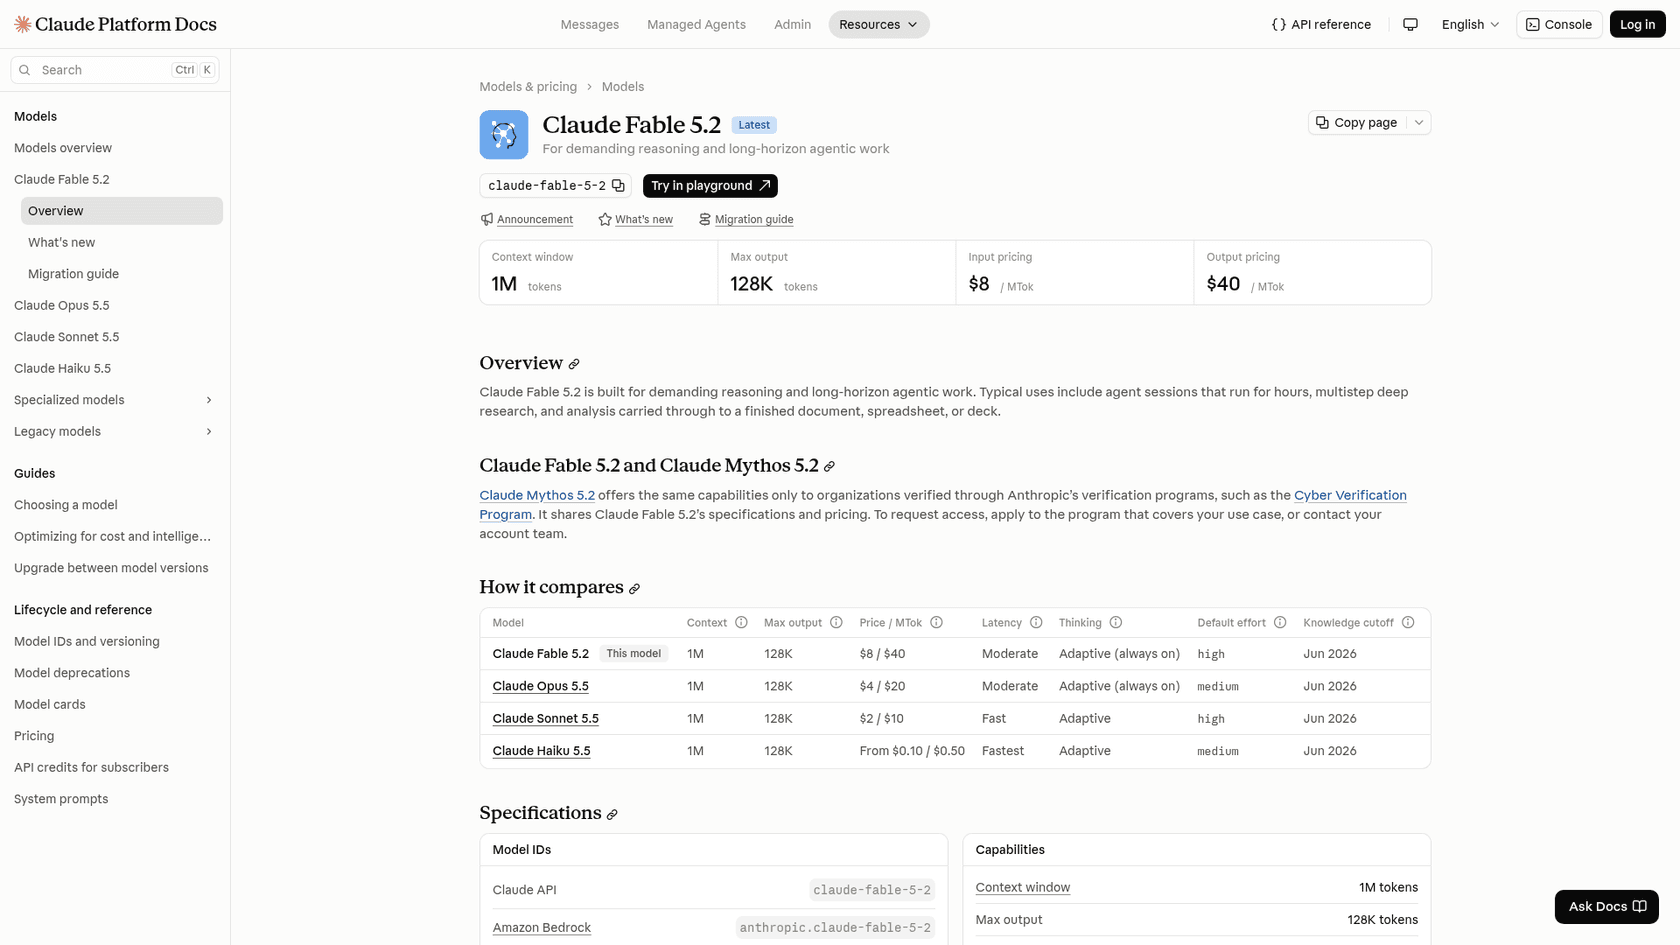
モデルページによるスペックは次のとおりです。
| スペック | Claude Fable 5.2 |
|---|---|
| APIモデルID | claude-fable-5-2(Bedrockではanthropic.claude-fable-5-2) |
| リリース日 | 2026年11月9日 |
| MTokあたりの料金 | 入力8ドル、出力40ドル |
| キャッシュ読み取り / 5分間書き込み / 1時間書き込み | 0.20ドル / 10ドル / 16ドル |
| Batch API | 入力・出力ともに50%割引 |
| Fastモード | 入力16ドル、出力80ドル、出力は最大2.5倍速い |
| コンテキストウィンドウ | 1Mトークン |
| 最大出力 | 128Kトークン |
| Thinking | 適応型、常時オン |
| デフォルトのeffort | APIではhigh |
| 知識のカットオフ | 2026年6月 |
予算にかかわる重要な事実がもう2つあります。Fable 5.2は30日間のデータ保持が必須で、Anthropicが明示的に許可しない限りゼロデータ保持では利用できません。また、Priority Tierでは対応していません。料金の詳細な内訳は、私のFable 5.2料金ガイドにまとめています。
Fable 5.2はFable 5.1より本当に安いのか?
トークンあたりで見れば、はい。タスクあたりで見ると、effortのダイヤル次第です。Anthropicの料金ページと移行ガイドから、定価の比較は次のとおりです。
| 指標(MTokあたり) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| 入力 | 8ドル | 10ドル | 4ドル |
| 出力 | 40ドル | 50ドル | 20ドル |
| キャッシュ読み取り | 0.20ドル | 0.25ドル | 0.20ドル |
| バッチ入力 / 出力 | 4ドル / 20ドル | 5ドル / 25ドル | 2ドル / 10ドル |
私の計算では、入力100万トークンと出力20万トークン、キャッシュなしという例示的なタスクの場合、Fable 5.1は20ドル、Fable 5.2は16ドル、Opus 5.5は8ドルになります。つまり定価ではFable 5.2がFable 5.1より20%安く、Opus 5.5はFable 5.2の半額です。
落とし穴はタスクあたりのトークン数です。Anthropic自身のグラフでは、Fable 5.2はeffortが低いほどトークンあたりの成果が大きいとされていますが、あるHacker Newsの読者はサードパーティのArtificial Analysisの数字を調べ、effort最大では逆の結果を見つけました。
"Forget about the scores... look at the Cost Per Task. Fable 5.1 was already the most expensive by a good margin, and now Fable 5.2 doubles it! This is with the price cut. The output tokens per task just exploded. From 118k tokens (46k Answer/71k Reasoning) in 5.1 to 274k tokens (81k Answer/192k Reasoning) in 5.2."

別のコメント投稿者は、Anthropic自身のモデルの説明とも一致する公平な反論を返しました。
"The Artificial Analysis charts are great, but be warned that they show max effort by default. [...] Fable 5.2 on medium looks quite attractive compared to Opus 5.5 high/xhigh. Fable 5.2 on max (the default) looks like a good way to light your money on fire."
私の見立てはこうです。Fable 5.2はeffort設定で操縦すべきモデルであり、最大設定のまま放置するものではありません。ローンチ記事によれば、Claude AppsとClaude CodeではMediumがデフォルトなので、そこで目にする請求額はグラフにあるMax effortの請求額ではありません。
ベンチマークは何を語っているか、どこまで信用できるか?
Anthropicは長い表を公開しました。以下は、ほとんどの購入者にとって重要な行で、すべてローンチ記事から、各モデルの利用可能な最高effortで安全対策を有効にした状態のものです。
| ベンチマーク | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0(エージェント型コーディング) | 49.1%(Xhigh) | 32.4% | 45.5% | 42.8% |
| FrontierSWE v2(エージェント型コーディング) | 69.9% | 56.3% | 62.3% | 65.5% |
| AutomationBench(業務ワークフロー) | 51.4% | 31.4% | 42.5% | 41.4% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% |
| Remote Labor Index | 41.3% | 17.9% | 21.3% | 20.8% |
| Humanity's Last Exam(ツールあり) | 74.2% | 65.6% | 67.7% | 57.2% |
| OSWorld 2.1(コンピュータ操作、部分) | 89.3% | 83.5% | 87.2% | 79.5% |
Fable 5.1からの最大の飛躍は、ロボティクス(RoboDojo Sim、27.6%から64.9%)と、有償のフリーランス的な仕事をテストするRemote Labor Indexです。業務ワークフローを自動化しているなら、AutomationBench(31.4%から51.4%)が注目すべき行です。1つの行だけはFableに不利です。AutomationBenchではGemini 4 Carbonが53.9%でわずかに上回っています。
より有用なグラフは、スコアとコストを対にしたものです。High effortでは、Fable 5.2はタスクあたりおよそ半分のコストでOpus 5.5の最高時とほぼ同等のスコアを出し、Xhighでは Anthropicがテストした中で最高のスコアに達します。
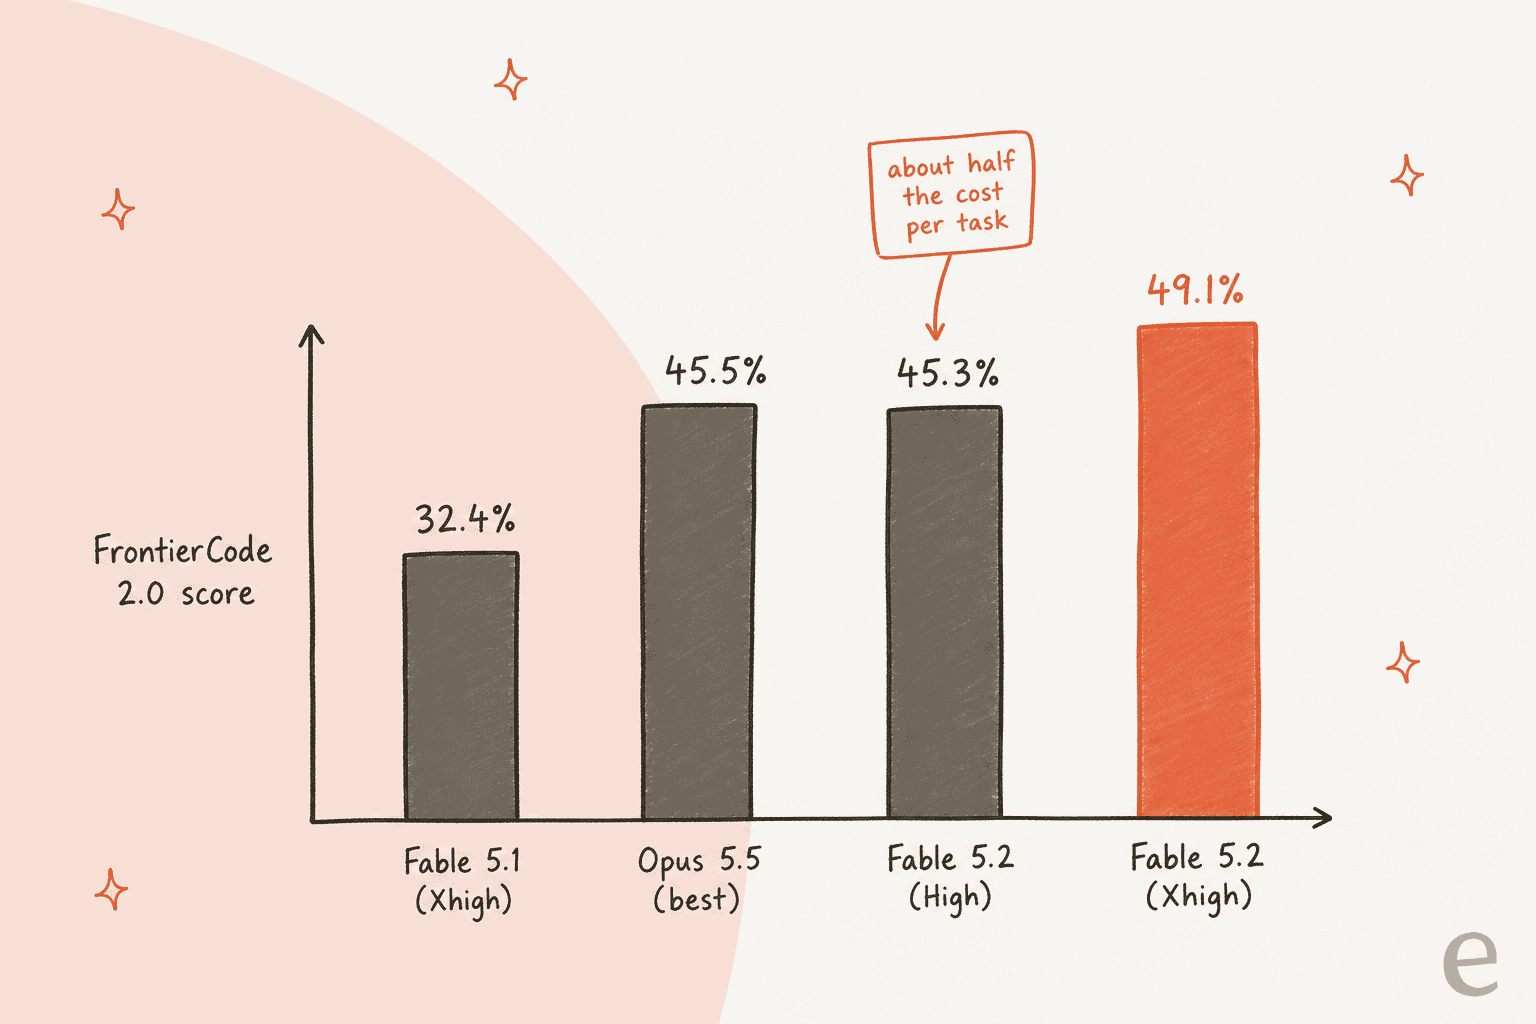
これが何を意味するか注目してください。Fable 5.2は、Xhighに料金を払わない限り、このコーディングテストでOpus 5.5に大差で勝つわけではありません。正直な総括としては、日常の作業を劇的に改善するのではなく、上限を引き上げ、Opusレベルへの道を安くする、というものです。これらすべてはベンダー自身が実施した数字として扱ってください。Anthropicが安全対策を有効にした状態で実施したものであり、懐疑的なコメント投稿者は、競合のGeminiのスコアが異なるテストハーネスを使っていると指摘しています。そのため私は、下記の顧客の報告のほうを表より重視しています。
実際に使っている人は何と言っているか?
Hacker Newsのローンチスレッドは、1日で750ポイント、400コメントを超えました。私が読んだ中で最も参考になった意見は、すでに使ってみた人からのものでした。
"Fable is good, but you really have to push the ambition of your prompt in order to see proper separation from Opus 5.5. I personally have a hard time telling the difference between Fable 5.2 and Opus 5.5 for ordinary coding tasks."
同じコメント投稿者は、Fable 5.2は5.1より「way faster and more reliable」だと述べており、5.1は以前、最大出力トークンのオーバーフローに悩まされていました。これはAnthropicの出力が最大30%速くなったという主張や、Cognitionのエンジニアの発言である「says it doesn't know things instead of hallucinating」とも一致します。
最も鋭い警告はサブエージェントに関するものです。Anthropic自身の移行ノートによれば、xhighとmaxのeffortでは、Fable 5.2はFable 5.1がしなかった、自分の作業をレビューするためにサブエージェントを使う様子が確認されており、サブエージェントがセッションのコストの大部分を占めることがあります。あるユーザーはそれを実際に経験しました。
"Asked it to review a 80 kLoC codebase, something Opus does just fine, while asking it "max 4 subagents". Fable 5.2, like the well-aligned model it supposedly is, decided to spawn 6+ nested subagents, because these aren't subagents, apparently - resulting in 100% of 5hr usage being drained in less than 20min (on $100)."
Claude Codeのサブエージェントやマルチエージェント構成を使っているなら、明示的な上限を設定し、最初の数回の実行を注意深く観察してください。Anthropic自身が名前を挙げたテスターは、その反対側にいます。Uberは約170体のレビューエージェントを動員する10〜12時間のセキュリティ監査を実施し、Oracleは、他の2つのモデルが金額を5〜8倍も多く合計してしまう中、正しいSQLを生成したと報告しています。ローンチ当日にXやRedditで使える一次情報のスレッドは見つけられなかったため、ここでのコミュニティの声はHacker Newsのみです。
Fable 5.1から移行すると何が壊れるか?
Anthropicはこの移行を「おおむねそのまま差し替え可能」と呼びつつ、4つの破壊的変更を挙げています。
- Thinkingブロックのプレフィックスチェックが、すべてのアカウントに適用されるようになりました。 コードがシステムプロンプト、ツール、以前のメッセージを編集してから古いThinkingブロックを送り返す場合、400エラーになります。Fable 5.1ではこれは2026年8月31日以降に作成されたアカウントにしか影響しなかったため、古いアカウントはこれまで経験していない可能性があります。
- Fable 5.1はFable 5.2のThinkingブロックを読めません。 Fable 5.2は5.1のものを読めますが、逆はできません。そのため会話の途中で5.2から5.1にフォールバックすると、その推論は失われ、コストが上がることがあります。
- 古いComputer Useツールの
computer_20251124は、Amazon Bedrockを除くすべての場所で400エラーを返します。computer_toolset_20260801に切り替えてください。 - Fable 5.2のexecutorには、advisorツールでFable 5.2またはMythos 5.2のadvisorが必要です。 5.1のadvisorは400エラーを返します。
5.1から変わっていない、覚えておくべき点もあります。適応型Thinkingは常にオンで、prefillと強制的なツール使用(tool_choiceがanyまたはtool)は400エラーになり、temperature、top_p、top_kは省略すべきです。Fable 5.2にはFable 5と5.1が共有するプールとは別の独自のレート制限もあるため、本番トラフィックを移す前に確認してください。もう1つの動作変更として、「answer directly without thinking」のようなプロンプトの指示は、medium以上のeffortでは思考を止めなくなったため、代わりにeffortの設定を下げてください。max_tokensが小さい場合、テキストが出力される前にThinkingがそのすべてを使い切ることがあります。
実際にはどのモデルを使うべきか?
Anthropic自身のアドバイスは、Opus 5.5から始めて、作業の範囲と複雑さに応じてFableやMythosに上げるか、Sonnet 5.5やHaiku 5.5に下げることです。私もこれに同意しますし、あるHNのコメント投稿者は、デフォルトが変わった理由をこうまとめています。
"Anthropic is finally well balanced across models. Meaning: Opus 5.5 is so good that I do not feel Fable FOMO as I did when it was Fable 5/5.1 vs Opus 4.8/5."
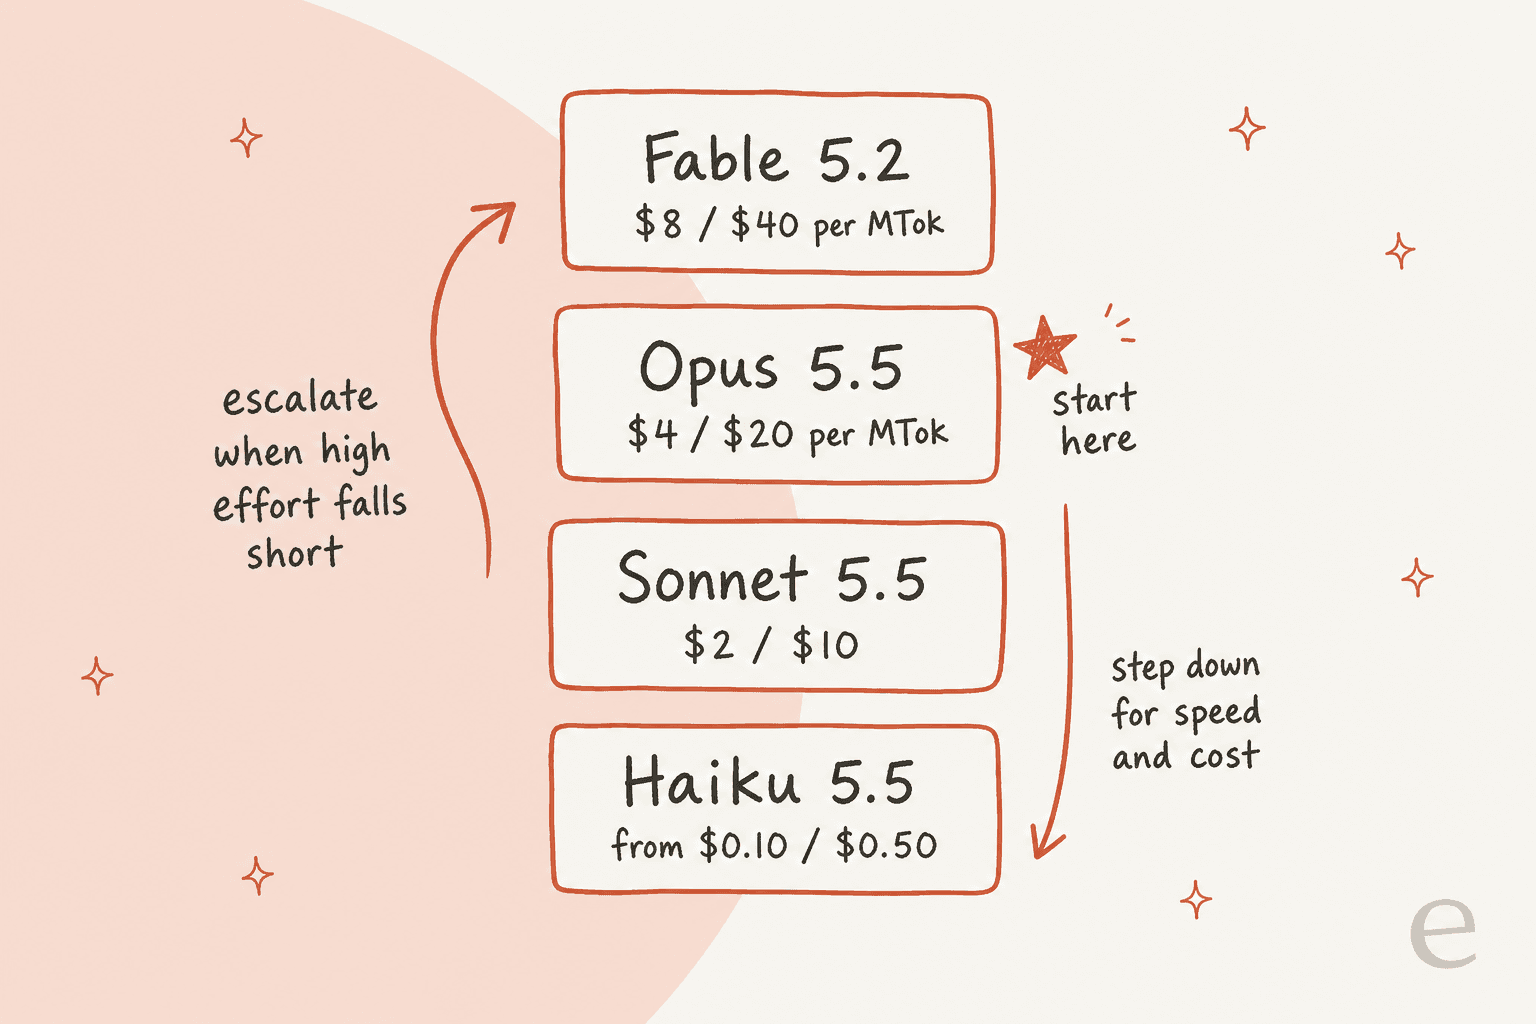
私なら次のように振り分けます。
- 現在Fable 5.1を使っている場合。 自分のリクエストビルダーでプレフィックスチェックのテストを行ったうえで乗り換えましょう。モデルIDを1つ変えるだけで、トークンあたりの請求額が下がり、出力が速くなり、スコアも上がります。
- Opus 5.5を使っていて、うまくいっている場合。 そのまま使い続けましょう。価格差はトークンあたり2倍で、Opus 5.5はそれ単体でも好評です。effortのダイヤルが請求額をどう動かすかはOpus 5.5の料金ガイドを参照してください。
- 高いeffortでのOpus 5.5の評価がまだ物足りない場合。 これはまさにFable 5.2が作られたケースです。数時間に及ぶエージェントの実行、深い調査、完成したドキュメントやスプレッドシート、スライドまで仕上げる作業などです。
- サブスクリプションでClaude Codeを使っている場合。 Fable 5.2をmedium effortで試し、使用量を観察してください。Claude Codeのモデル選択に関する私のノートでトレードオフを解説しています。
- ベンダー間で選んでいる場合。 GPT-6 SolやGPT-6 Astraを自社のタスクで比較し、ファミリーがどう変化してきたかについては以前のOpus 5対Fable 5の比較記事を読んでください。
- サポートエージェントやコンテンツライターが欲しい場合。 それは間違ったレイヤーで買い物をしています。次の節で説明します。
このレビューが何であるかを正直に言っておきます。私はAnthropicのローンチ記事、モデルページ、料金と移行のドキュメント、そして公開されているHacker Newsでの議論を読みました。自分自身の本番ワークロードで実際に動かしたわけではないので、何か推奨をする場合、それはこれらの出典から来ているのであって、独自のベンチマークからではありません。
モデルはチームメイトと同じものか?
いいえ、そしてこれはFable 5.2についてのほとんどの報道が見落としている視点です。モデルはインフラです。eeselは従業員です。フロンティアモデルは、あなたの製品が何をするのか見当もつかず、あなたのヘルプセンターや直近10,000件のチケットを見ることもできず、ヘルプデスクへの統合もありません。モデルを雇うのではなく、特定の仕事のために働く準備ができたチームメイトを雇うのです。
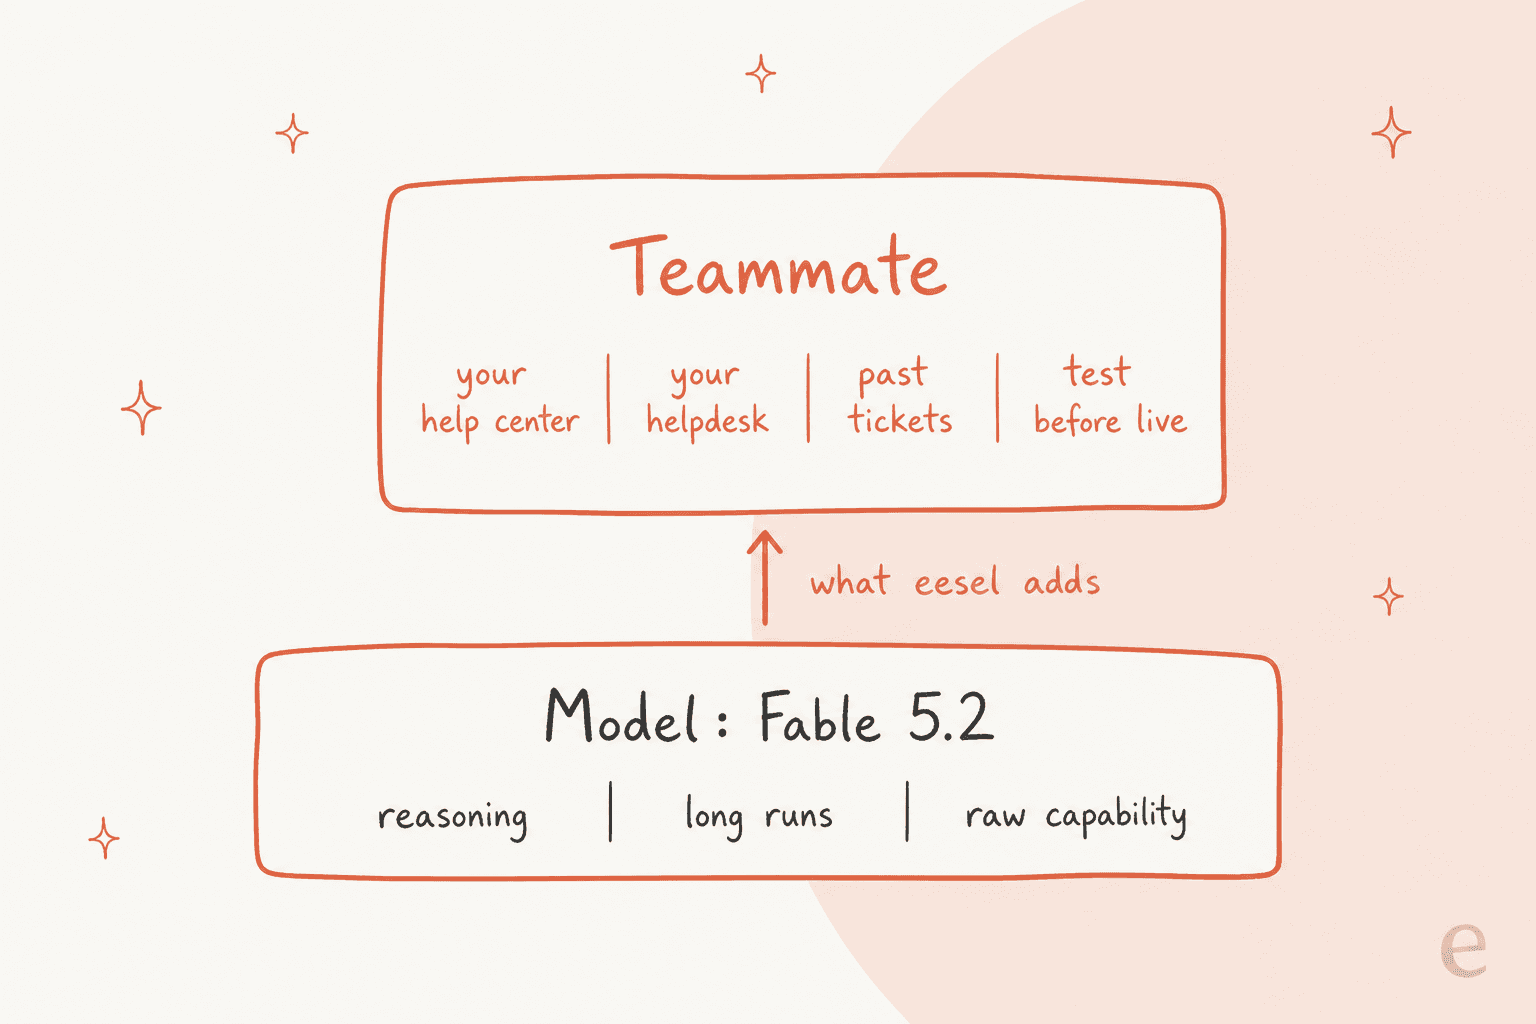
eeselの現在の布陣は、既存のサポートキューに加わるAIヘルプデスクのチームメイトと、コンテンツ用のAIブログライターです。それぞれが、その仕事に必要なスキル、連携、会社の文脈を備えて登場します。より広いAIチームメイトという考え方を追っている読者なら、この分離に気づくでしょう。モデルは四半期ごとに変わりますが、職務内容は変わりません。
その証拠は、実際のチームの運用方法にあります。SE RankingはZendesk上で3つのプロダクトを運用し、プロダクトごとに1体のeeselエージェントを配置しています。1か月間(2026年8月8日から9月8日)で、エージェントは4,650件のやり取りを処理しました。Zendeskチケット2,554件とライブチャット2,102件で、約16,800ページの知識から回答しています。SamCartは、Freshdeskのチケットとウェブサイトのチャットにそれぞれ別のエージェントを使い分け、それぞれ異なるトーンを持たせています。これらはどれも、FableかOpusかという選択に依存していません。エージェントがまずヘルプセンターを検索し、返金や難しいケースを人に引き継ぎ、ヘルプデスク上で測定可能であることに依存していたのです。それはまた、AI解決率を正直な数字に保ち、サポートにおけるAIの幻覚を防ぐことにもつながります。
eesel CLIは、Fable 5.2のようなフロンティアモデルがそのチームメイトにとって役立つようになる場所です。Claude Codeのようなコーディングエージェントは、ターミナルから同じワークスペースを操作できます。エクスポートしたヘルプ記事やマクロをアップロードし、エージェントの指示を調整し、回答が顧客に届く前にテストの質問をして確認できます。ヘルプデスク接続自体は依然として管理者権限を持つ人の承認が必要で、アップロードされた知識は、テストの回答が正しく見えるまで「準備完了」にはなりません。より広い視点が欲しければ、カスタマーサポート向けのClaude、最高のAIカスタマーサポートエージェント、そしてコストの視点についてはAIカスタマーサービスのコストをご覧ください。
eeselを試す
Fable 5.2についての調査の裏にある本当の問いが「どのモデルに自社のサポートを任せるべきか」であるなら、より良い問いは「どのチームメイトを雇うべきか」です。eeselは、AIヘルプデスクのチームメイトをあなたのZendesk、Freshdesk、Gorgiasのキューに組み込み、ヘルプセンターと過去のチケットから学習し、本物の顧客に返信する前に過去のチケットでシミュレーションできるようにします。コードからこれを操作したい開発者はeesel CLIを使えますし、裏側のモデルは、あなたが何も作り直す必要なく変更できます。eeselを試すことは無料です。
よくある質問
Claude Fable 5.2は買う価値がありますか?
Claude Fable 5.2の料金はいくらですか?
Claude Fable 5.2のモデルIDは何ですか?
claude-fable-5-2、Amazon Bedrockではanthropic.claude-fable-5-2です。Claude Mythos 5.2は安全対策が軽い同じモデルで、IDclaude-mythos-5-2です。